关于 statecore-mcp
StateCore 是面向编码 Agent 和 AI 系统的可自托管长期记忆运行时,以带证据和版本链的受治理状态取代松散文本。其确定性整理管线记录事实变更与丢弃原因,并可通过嵌入式 SQLite MCP 服务免部署运行。
主要功能
- 01记录事实证据、版本链和丢弃原因
- 02确定性摘要与一致性检查管线
- 03混合检索并报告预算及降级情况
- 04支持提醒与多层记忆状态
- 05嵌入式 SQLite MCP 服务
适用场景
- 01跨编码会话追溯决策及其依据
- 02检查记忆更新中保留或丢弃的内容
- 03在同一项目的不同 Agent 间交接上下文
MCP 相关
statecore-mcp 通过 MCP 提供记忆能力,可使用单个 SQLite 文件嵌入式运行,无需启动服务器或提供密钥;也可通过 --url 连接 StateCore 部署。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y statecore-mcpSTATECORE_SCOPEOverride the memory scope name (defaults to the git repository root, else the working directory)FEATURE_LLMSet to 'true' together with MODEL_* variables to enable background distillation of conversational events; everything else works without itMODEL_API_KEY密钥OpenAI-compatible API key for background distillation (DeepSeek, OpenAI, Ollama, ...); not required for core memory, audit, and recallMODEL_BASE_URLOpenAI-compatible base URL for the distillation model (e.g. https://api.deepseek.com/v1)MODEL_NAMEModel used for background distillation (e.g. deepseek-chat)本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
StateCore


面向编码 Agent 和 AI 系统的可审计记忆。 StateCore 保存的每条事实都附带证据、版本链,以及每次丢弃时记录的原因——因此,对于“你为什么相信这件事?之前又相信什么?”,总能给出答案。
StateCore 是一款可自托管、低漂移的长期记忆运行时,适用于本地模型或自带模型。它将记忆从累积文本转变为受治理的状态:事件经过摄取,通过确定性的摘要流水线处理,再合并到受保护的稳定状态中。大模型负责提议;流水线负责决策。
30 秒快速体验
无需服务、无需注册、无需模型密钥——通过 MCP 使用一个 SQLite 文件:
claude mcp add statecore -- npx -y statecore-mcp # Claude Code
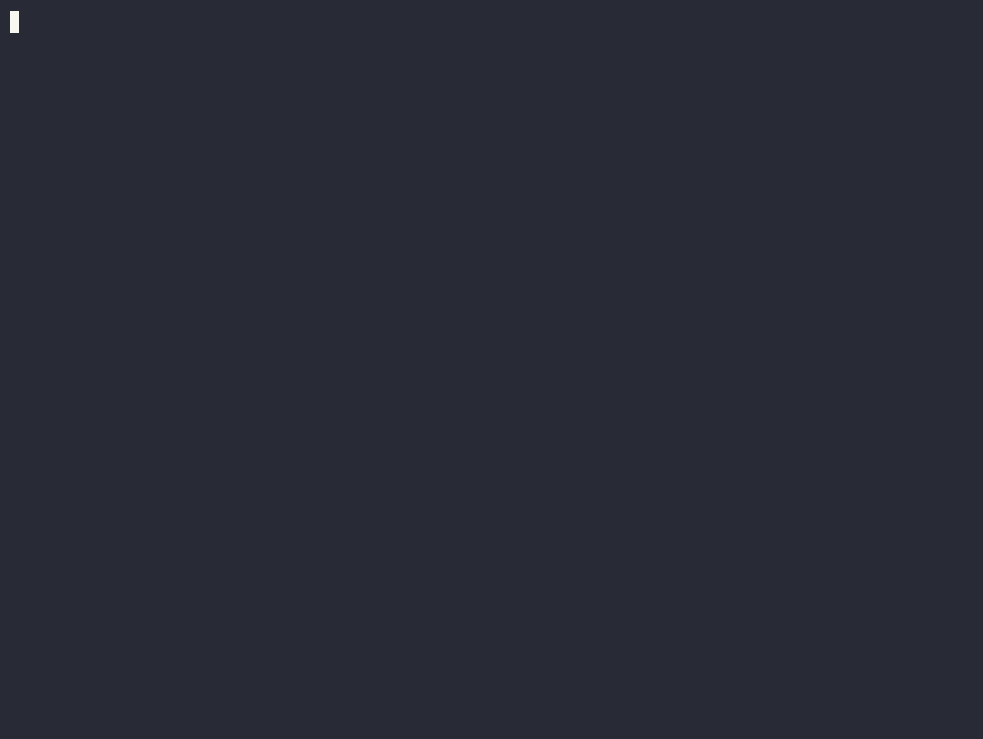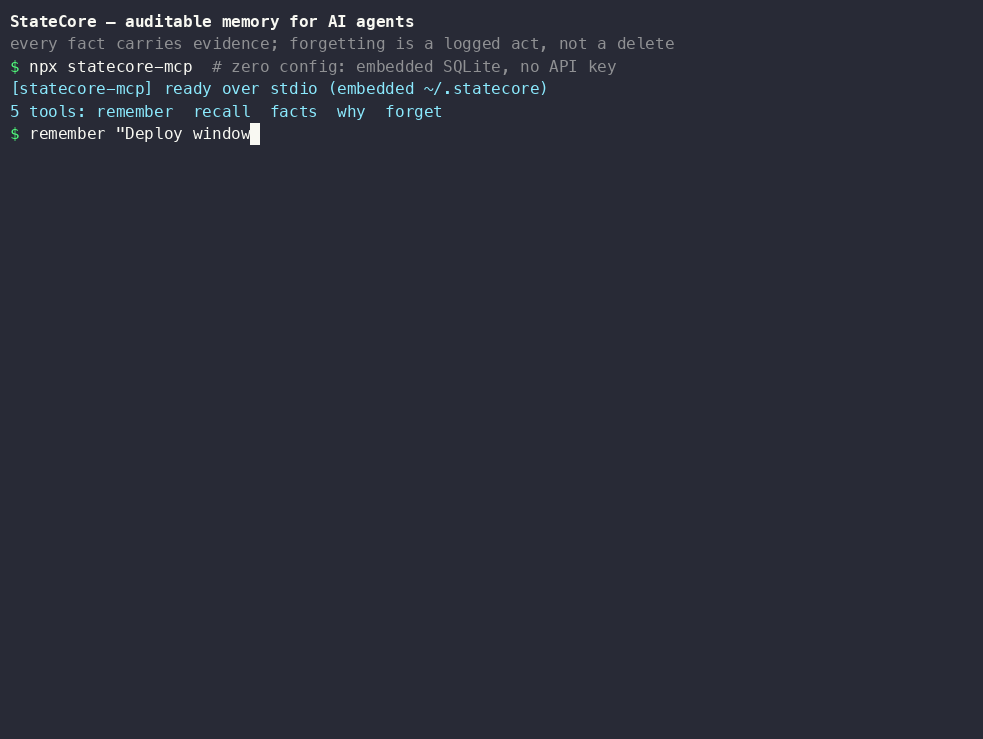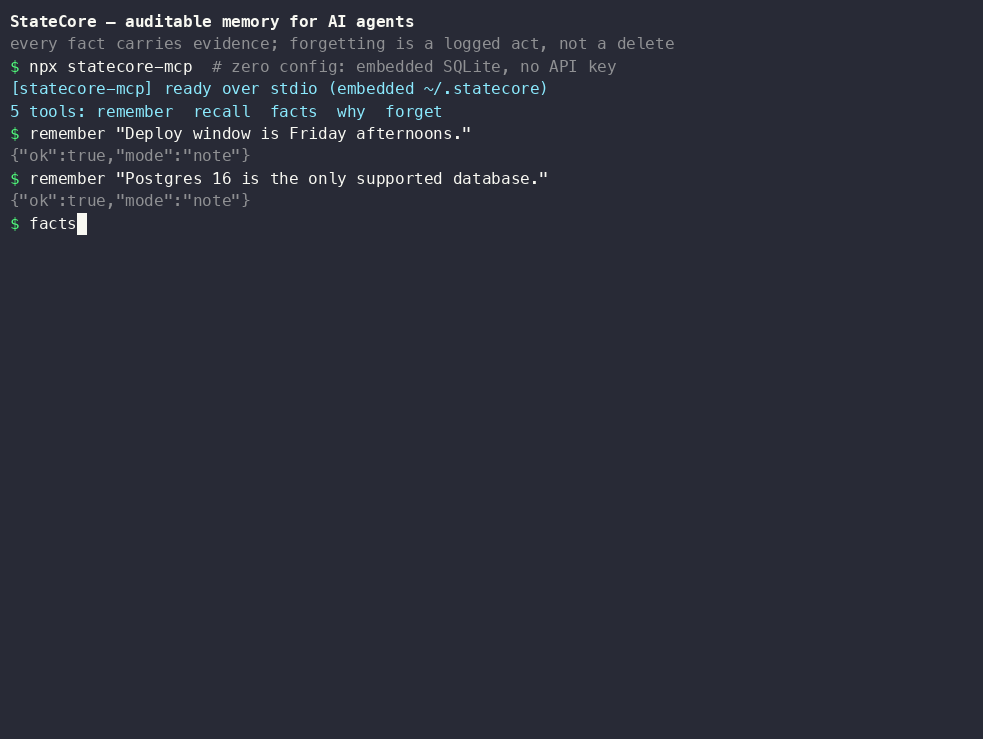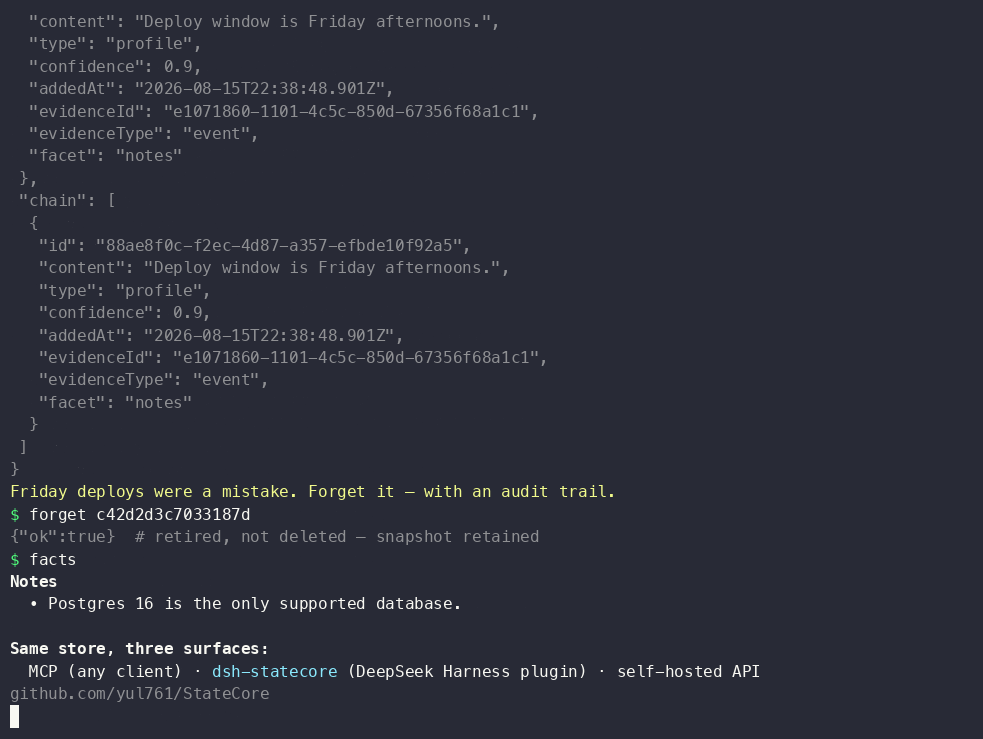
在一个会话中用 remember 记录决策,在下一个会话中询问 why:你会得到事实、背后的证据及其版本历史——被取代和退役的事实仍会保留在记录中,并做好标记,绝不删除。会话还可以跨供应商交接:handoff 会记录一个会话停在何处,下一个会话——Claude Code、Codex、Cursor,或同一项目中的任意 MCP 客户端——会在 recall 开始时收到这条记录;此前所有停止点也都会留在审计链中。Cursor、dsh 和其他所有 MCP 宿主的配置:apps/mcp/README.md。
采集很容易,信任很难。
大多数 Agent 记忆工具都在争相采集更多信息——为每个事件挂接钩子、压缩转录文本,再注入回去。采集是已经解决的问题。尚未解决的另一半问题,充斥在这些工具自己的问题跟踪系统中:记忆悄无声息地停止写入、过时的决策被注入并当作仍然有效、跨项目信息泄漏,以及无法审计或修复存储中的信念。这并非空谈——docs/prior-art-failure-modes.md 按编号列出了五个系统中经核实的问题。
StateCore 专为解决这另一半问题而构建:
- 没有任何内容会悄无声息地丢失。 每次丢弃都会根据固定的原因集合记录;每条被替换的事实都会保留
supersededBy链;退役事实会做好标记,绝不删除。 - 没有任何内容会在不知不觉中被采信。 写入必须经过带有一致性门控的确定性流水线——仅凭大模型的提议,无法将内容晋升为稳定状态。
- 没有任何降级会悄无声息地发生。 失败的摘要会标记为
degraded;预算报告会说明拒绝了什么;检索会报告哪些嵌入阶段失败,并根据实际运行的内容推导mode,而不是根据配置的内容推导。 - 一切都可以核查。
why会返回事实的证据和完整版本历史;摘要的选择报告会明确显示保留和舍弃了哪些内容。
各记忆系统的机制对比:docs/why-auditable.md。
功能
- 事件存储 — 将流事件和带键文档写入各个范围的记忆中
- 摘要流水线 — 后台工作进程通过筛选、合并、一致性检查和重试,将事件整合为稳定状态
- 受保护状态 — 目标、约束、决策和待办事项由一致性关卡把控;LLM 提出建议,流水线负责执行
- 可审计事实 — 每条事实都包含其证据和被取代链;离开活动集的事实会被标记为已退役,而非删除,因此始终可以回答“你为什么这么认为?之前又相信什么?”
- 已记录的舍弃项 — 摘要会记录舍弃了什么以及原因,并采用固定的一组原因;信息丢失尚可应对,悄无声息地丢失则不行
- 可替换本体 — 方面来自按租户和范围解析的包,因此引擎无需了解方面的含义,也能存储、保护和取代方面
- 检索 — 对事件和摘要进行混合关键字搜索与可选的 pgvector 语义搜索,并将结果打包在调用方声明的字符预算内,同时报告被拒绝的内容;固定事件和写保护事实会获得有限的排名加成(绝不会被用作筛选条件),嵌入失败会逐项记录在
retrieval.degraded中,而不会悄悄降低质量 - 提醒 — 每日提醒任务会从活动范围中提取后续跟进事项
- 基准测试 — 已发布的 LongMemEval 对比,在相同上下文预算下与 mem0 OSS 对比;另含内置合成回归测试套件,在各次提交中保障事实保留、目标稳定性、决策连续性和检索 MRR
- MCP 服务 —
statecore-mcp,面向编码 Agent 的零部署 Model Context Protocol 前端;默认无需密钥,仅需一个 SQLite 文件,无需基础设施
快速开始
1. 安装依赖
pnpm install
2. 配置环境
cp .env.example .env
必需的最少变量:
PORT=3002
LOCAL_USER_TOKEN=local-dev-user
DATABASE_URL=postgresql://postgres:postgres@localhost:5434/statecore
REDIS_URL=redis://localhost:6380
若要启用 LLM 功能(摘要、回答):
FEATURE_LLM=true
MODEL_PROVIDER=openai-compatible
MODEL_API_KEY=<your-key>
MODEL_BASE_URL=https://api.openai.com/v1
MODEL_NAME=gpt-5-mini
使用 OpenAI 时,请选择接受
reasoning_effort的模型。 运行时会话每次请求都会发送此参数——assistant-runtime.ts会将其默认设为low,而不是留空——因此,若使用会拒绝此参数的gpt-4o*模型,POST /v1/memory/runtime/turn会失败。除非设置了MODEL_STRUCTURED_OUTPUT_REASONING_EFFORT,否则摘要和回答不会发送此参数,所以使用gpt-4o*模型时,一直到首次运行时会话之前看起来都能正常工作。任何接受该参数或忽略未知参数的端点都可以。
3. 启动基础设施
docker compose -f docker-compose.local.yml up -d
这会启动 Postgres(带 pgvector)和 Redis。
4. 准备数据库
pnpm db:generate
pnpm db:migrate
pnpm seed
5. 启动服务
pnpm dev:api      # NestJS API on PORT (default 3002)
pnpm dev:worker   # background digest + reminder workers
API 可通过 http://localhost:3002 访问(也可以使用 PORT 设置的端口)。
API
身份验证
所有请求都必须包含 x-user-id 请求头。在本地开发时,请在 .env 中设置 LOCAL_USER_TOKEN=local-dev-user,并发送:
x-user-id: local-dev-user
公共接口(/v1)
/v1 前缀公开 API 中稳定、面向公众的子集。完整的 OpenAPI 架构:
GET /openapi.json
交互式 Scalar UI:
http://localhost:3002/docs
参考文档:docs/api.md
关键端点
| 方法 | 路径 | 描述 |
|---|---|---|
POST | /v1/memory/events | 接收流事件或文档 |
POST | /v1/memory/retrieve | 检索与查询相关的可信证据,可选使用 maxChars 预算限制长度 |
POST | /v1/memory/digest | 触发 State Layer 摘要任务 |
GET | /v1/memory/facts | 获取某个范围的分组记忆事实 |
GET | /v1/memory/facts/:factId/provenance | 查看事实的证据及其完整版本链 |
GET | /v1/memory/digests/:digestId/selection | 查看摘要保留了哪些内容、丢弃了哪些内容及原因 |
GET | /v1/facet-pack | 获取某个范围或账户当前生效的 facet 本体 |
GET | /v1/scopes | 列出范围 |
GET | /memory/stable-state | 当前稳定状态快照 ¹ |
GET | /memory/working-state | 当前工作记忆快照 ¹ |
GET | /memory/layer-status | 各层健康状态汇总 ¹ |
中间的三个审计读取端点使引擎的记忆变得可核查,而不只是被存储;docs/api.md 列出了完整的冻结接口。
API 稳定性:
/v1合约已冻结,且仅允许新增内容——详见 STABILITY.md。目前涵盖 20 个路径上的 22 项操作。合约在生成的 OpenAPI 文档中携带自身版本(info.version,当前为1.8.0),用于告知你手中的规范有多新;它既不是发行标签,也不是任何软件包版本。
¹ 内部读取模型端点——仅注册在 /memory/... 下,不属于冻结的 /v1 合约。
在编码 Agent 中使用(MCP)
statecore-mcp 是单独发布的 npm 软件包,可通过模型上下文协议连接此引擎——无需运行服务。默认情况下,它以无密钥方式嵌入引擎运行(单个进程、单个 SQLite 文件):
npx -y statecore-mcp --data ~/.statecore
将任意 MCP 客户端指向它即可使用;也可以通过 --url 连接完整的 StateCore 部署,以支持共享/多 Agent 记忆。完整文档、宿主配置以及无密钥/带密钥功能对照表:apps/mcp/README.md。
| 客户端 | 配置 |
|---|---|
| Claude Code | claude mcp add statecore -- npx -y statecore-mcp(配置) |
| dsh | 已提供固定可执行文件的 overlay 配置(配置) |
| Cursor | 已提供 .cursor/mcp.json 配置(配置) |
| Codex CLI、Gemini CLI、Windsurf、Zed、Cline、OpenCode、Claude Desktop、VS Code Copilot | 标准 MCP stdio 配置——命令为 npx -y statecore-mcp |
| 任何支持 MCP 的其他客户端 | 使用相同的 stdio 命令;连接部署时通过 --url 使用 HTTP |
团队记忆: 使用一个可自托管的部署作为共享项目大脑,供团队运行的每个 Agent 使用——包括 dsh 会话、Claude Code 和 CI——并在所有这些环境中共享一条审计轨迹:docs/team-memory.md。
架构
apps/api        NestJS HTTP server — ingestion, retrieval, runtime turns, diagnostics
apps/worker     BullMQ background workers — digest, working-memory updates, reminders
apps/mcp        statecore-mcp — MCP server, embedded or thin client against apps/api

packages/core       Memory engine (MemoryService, DigestService, RetrieveService, AssistantSession)
packages/contracts  Zod schemas for all API I/O
packages/db         Prisma schema, migrations, and client
packages/prompts    LLM prompt templates (digest, answer, runtime)
StateCore 位于客户端与模型端点之间。事件流入后,摘要流水线会将其整合为受保护的状态,检索则会提取可信证据,用于生成回答或处理运行时轮次。
三层记忆模型:
- Fast Layer — 同步运行;根据近期事件、工作记忆和稳定状态,为当前轮次组装提示词上下文
- Working Memory — 轻量、快速更新的结构化记忆;连接原始近期轮次与缓慢的稳定状态整合过程
- State Layer — 权威、可重放、低漂移的长期记忆;通过摘要控制流水线异步更新
分层模型设计和路线图请参阅 docs/vision-and-roadmap.md。
测试与基准测试
运行软件包测试:
pnpm --filter @statecore/core test
pnpm --filter @statecore/api test
运行完整的延迟与内存质量基准测试:
pnpm benchmark
运行合成回归测试套件(无需 LLM):
pnpm --filter @statecore/core eval
合成测试套件是回归防护,而非能力基准测试:当前引擎在每个场景中的得分都刻意设为 1.000——它的作用是在更改破坏记忆保持、稳定性或检索时及时发现问题,而不是给系统排名。用于给系统排名的比较基准是下文的 LongMemEval。
基准测试方法:docs/benchmarking.md
LongMemEval
在相同上下文预算下,将 StateCore 与 mem0 OSS 进行比较——也就是回答者提示词中的记忆字符数相同,而非检索条目数相同。共 194 个问题,由 gpt-5 作答,使用官方 gpt-4o 评判模型(2026-08-08):
| 系统 | 4,000 tok | 16,000 tok | 64,000 tok |
|---|---|---|---|
| StateCore | 51.0% ±7.0 | 80.9% ±5.5 | 87.6% ±4.6 |
| mem0 OSS | 61.3% ±6.9 | 59.8% ±6.9 | 61.3% ±6.9 |
| 无记忆(近期内容窗口) | 9.3% ±4.1 | 22.7% ±5.9 | 53.6% ±7.0 |
在 64k 下,StateCore 的表现也超过了直接将整个语料库粘贴到提示词中、完全不使用记忆层的 70.1% ±6.4 上限。在 4k 下,它比 mem0 低 10 个百分点——这是差异性质上的真实差距,完整说明见详细报告。
数据、注意事项以及基准测试未衡量的内容:
docs/longmemeval.md。测试框架、原始检索结果及逐题评判结果:
memory-budget-bench。
文档
docs/start-here.md— 新贡献者指南docs/repo-map.md— 仓库结构、代码归属及完整文档索引docs/philosophy.md— 引擎的用途,以及可审计性为何是核心docs/why-auditable.md— 与其他记忆系统的审计机制对比,以事实为依据docs/prior-art-failure-modes.md— 本设计旨在解决的已记录故障模式,并附有经核实的问题引用docs/glossary.md— 维度、打包、取代、退役、丢弃日志docs/api.md— 完整 API 参考及/v1契约规则docs/vision-and-roadmap.md— 定位与路线图,附状态图docs/technical-overview.md— 架构内部机制docs/digest-state.md— 摘要状态规范docs/protected-state-merge.md— 逐字段说明确定性合并docs/drift-definition.md— 漂移定义与指标docs/assistant-runtime.md— 助手运行时规范docs/benchmarking.md— 基准测试方法docs/longmemeval.md— LongMemEval 对比 mem0 OSS 的结果docs/evaluation-metrics.md— 评估指标规范
贡献
- Fork 仓库并创建功能分支。
- 提交 PR 前,运行
pnpm lint和pnpm --filter @statecore/core test。 - 遵循 Conventional Commits 规范。
许可证
MIT — 详见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。