关于 local-delegate
local-delegate 是一款 MCP 服务,可将文本处理任务交给本地 OpenAI 兼容大模型,帮助 Claude 用户节省订阅额度。它在服务端读取文件并仅返回精简结果,避免大型输入进入 Claude 上下文。
主要功能
- 01摘要、分类与字段提取
- 02翻译与代码说明
- 03服务端读取文件
- 04分块处理长文档
- 05stdio 与共享 HTTP 守护进程
适用场景
- 01总结大型日志而不占用 Claude 上下文
- 02从本地文件提取结构化字段
- 03分块翻译长文档
- 04根据规格生成样板代码
MCP 相关
通过 stdio 或共享 HTTP 守护进程提供 MCP 工具。MCP 客户端可将任务委托给 OpenAI 兼容端点。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx local-delegate-mcpLOCAL_DELEGATE_BASE_URLOpenAI-compatible endpoint (llama-swap, Ollama, LM Studio, vLLM). Default http://127.0.0.1:9292/v1LOCAL_DELEGATE_API_KEY密钥Bearer token for the endpoint, if it requires one.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
11收录的工具列表 · 更新于 今天
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| path | any | 否 | |
| text | any | 否 | |
| focus | any | 否 | |
| max_words | integer | 否 |
详细介绍
local-delegate
将机械性的文本到文本任务委派给本地 LLM,节省 Claude 订阅的额度。
一个 MCP 服务(stdio 或共享 HTTP 守护进程),可作为任意 OpenAI-compatible
端点的通用客户端 — llama-swap、Ollama、LM Studio、vLLM。


zahirinatzuke.github.io/local-delegate — 在一个页面中介绍
它的功能和设计缘由(西班牙语/英语)。源文件位于 site/。
演示
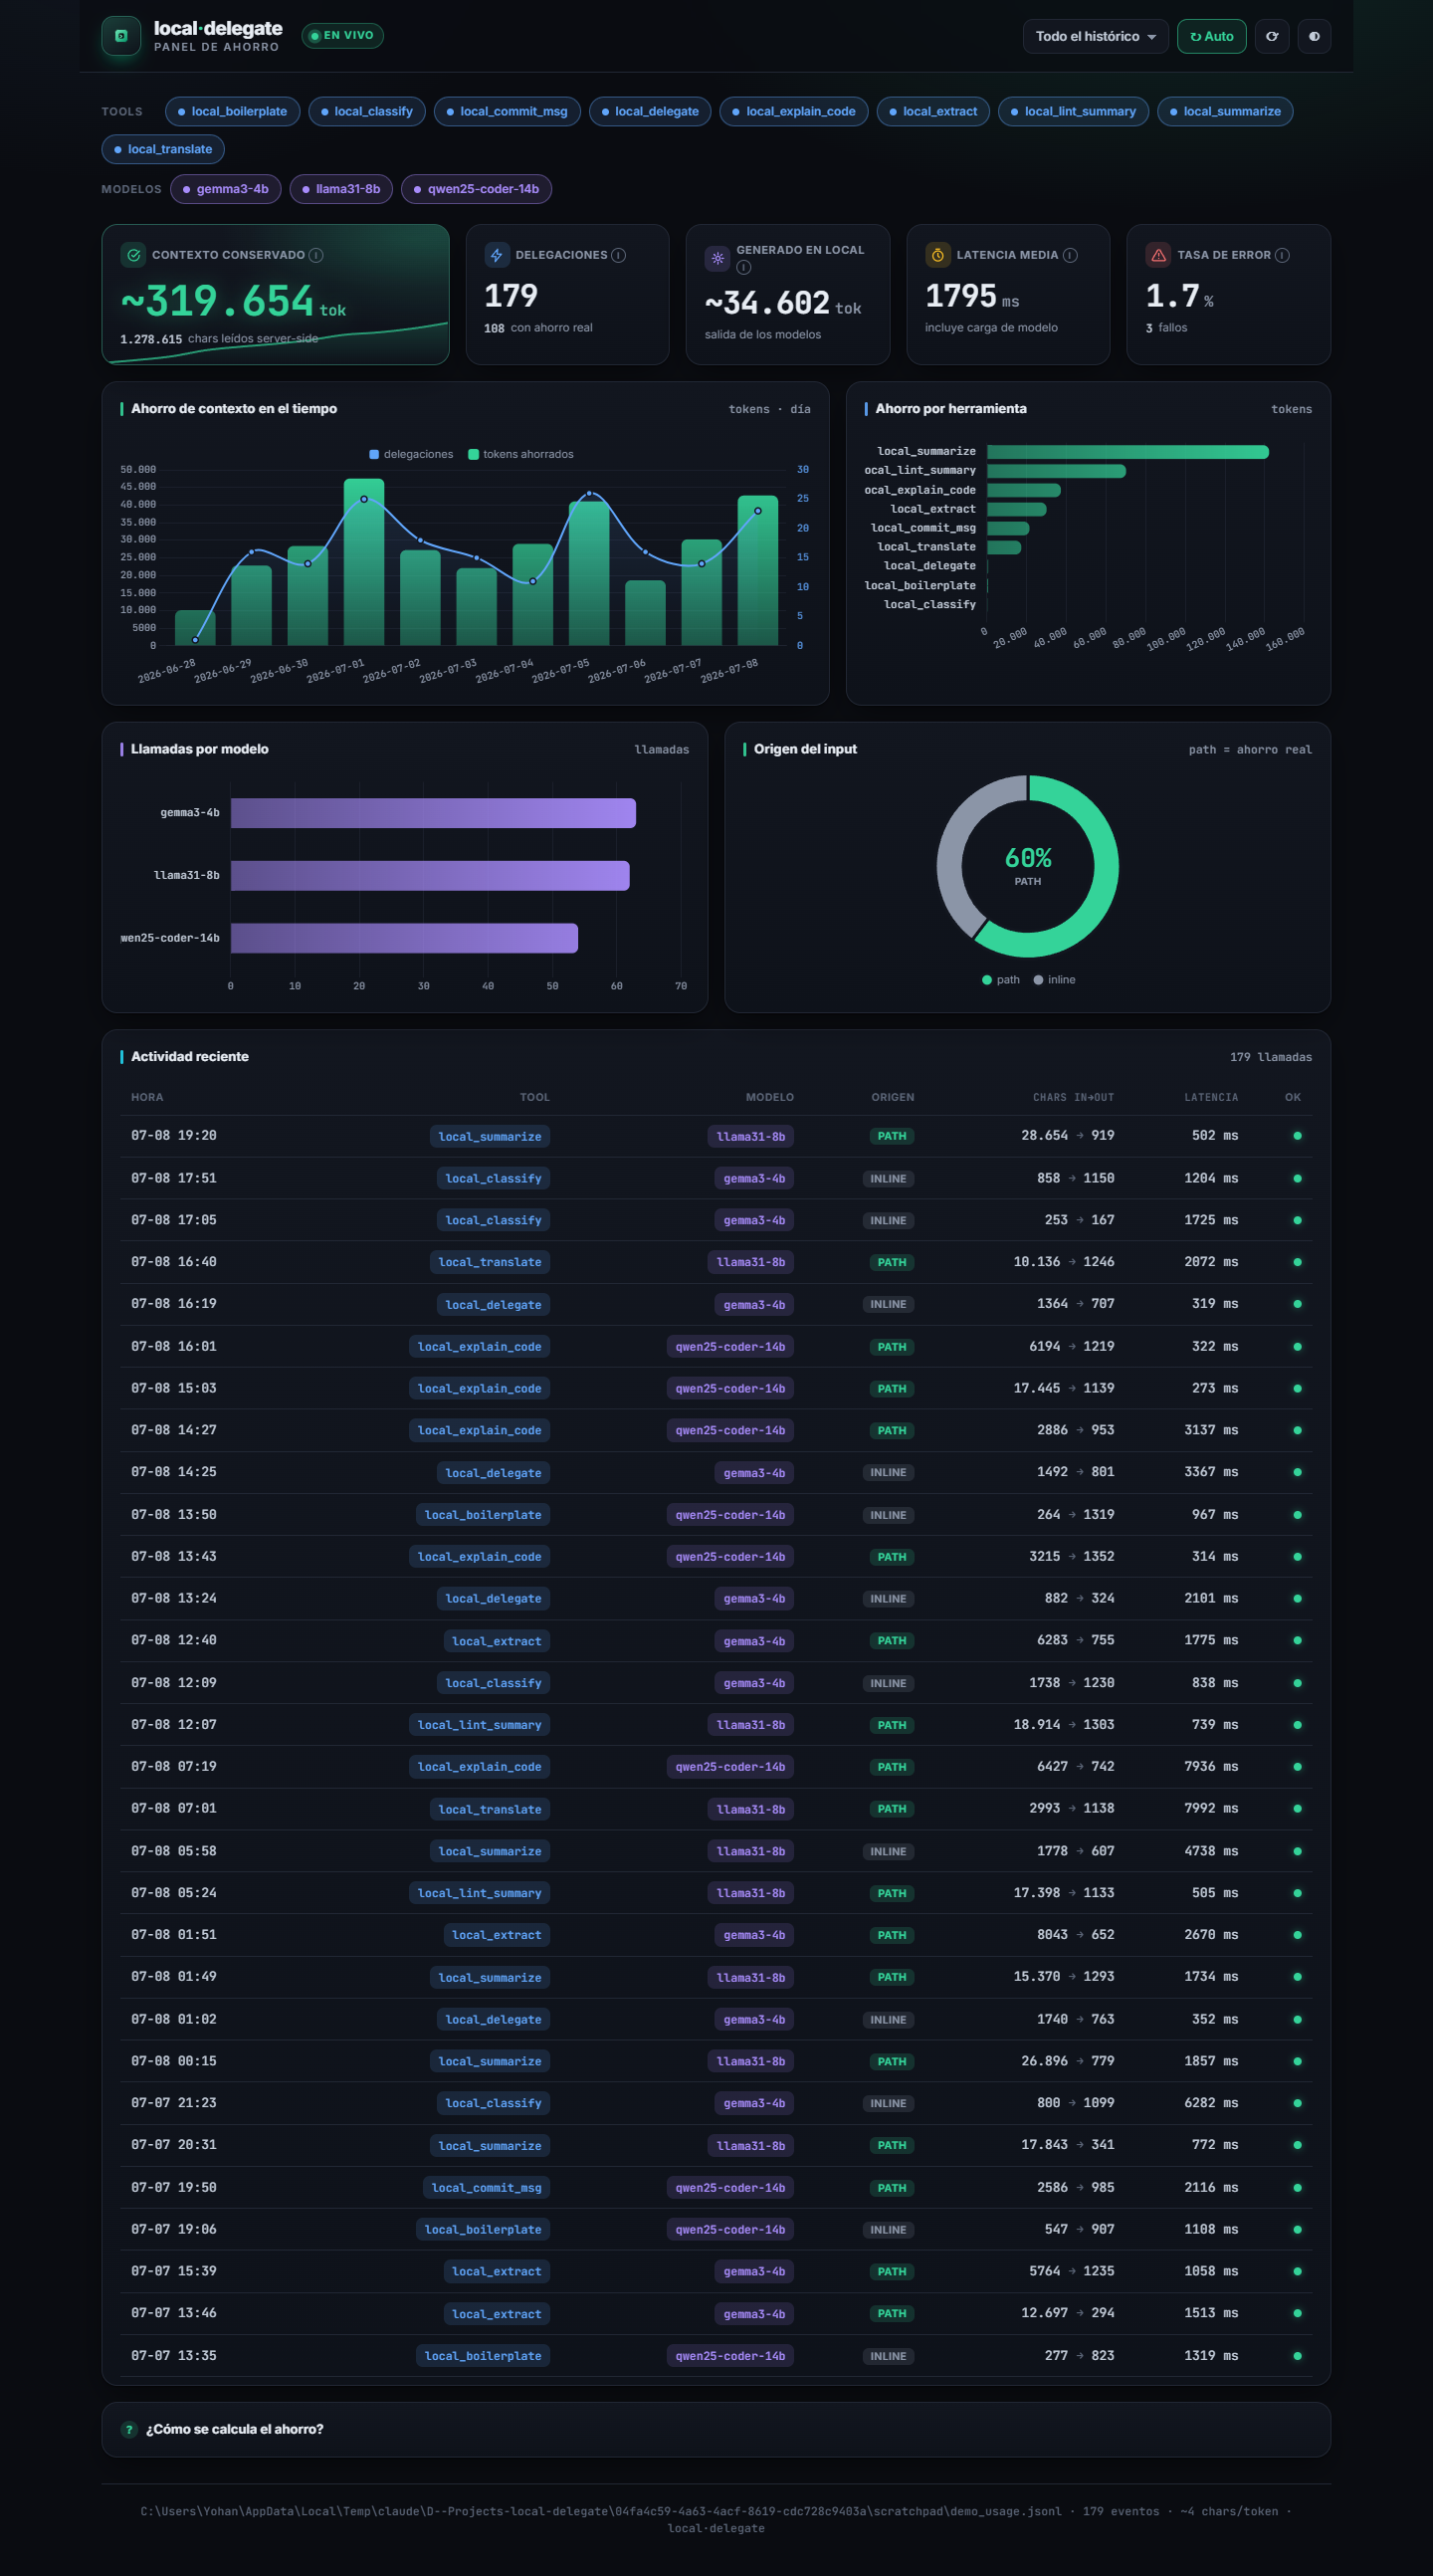
内嵌仪表板(示例数据):本地后端状态(已加载的模型、正在进行的委派及其分块进度、MCP 工具)、系统 RAM/VRAM 及各进程用量、节省的上下文令牌数、各工具和模型节省的用量、计算运行位置 — 本机或远程后端 — 以及按本地时间分页显示的近期活动。服务地址为 http://127.0.0.1:9393。
为什么要用?
当 Claude 需要总结大型日志、分类、提取字段或生成样板代码时,会把订阅额度花在机械性工作上。local-delegate 将这些任务作为运行在本地 LLM 上的 MCP 工具提供:传入 path 而不是 text,文件会在服务端读取,因此大型内容永远不会进入 Claude 的上下文。只有简短的结果会返回:文档不会占用你的上下文窗口,也不会由 Claude 处理。
快速安装
使用 uv 无需安装任何内容:uvx 会下载并在隔离环境中运行软件包。
将它以兼容 stdio 的模式添加到 MCP 配置中(Claude Desktop / Claude Code):
{
  "mcpServers": {
    "local-delegate": {
      "command": "uvx",
      "args": ["local-delegate-mcp"]
    }
  }
}
完整模板请参阅 examples/。
也可以用一条命令让软件包为你配置所有内容 — MCP 条目、hooks、skill,以及全局 CLAUDE.md/AGENTS.md 中的委派规则:
uv tool install local-delegate-mcp          # deja `local-delegate` en el PATH
local-delegate install --dry-run            # muestra exactamente qué tocaría
local-delegate install                      # aplica
也可以使用 uvx local-delegate-mcp install 进行试用,无需安装任何内容。但请注意,uvx 不会让命令持续可用:它会创建一个临时环境,并在结束后删除,因此之后运行 local-delegate doctor 会得到“command not found”。如果检测到这种情况,install 会提醒你。
此操作是幂等的,会为修改过的文件创建 .bak 备份,不会更改其他配置,并且可以通过 local-delegate uninstall 撤销。详情和选项请参阅集成安装。
想要为子命令、选项和值启用 Tab 自动补全?运行 local-delegate install --shell-completion,即可在 PowerShell、zsh 或 bash 的配置文件中启用补全(需主动选择,可通过
uninstall --shell-completion 撤销);运行 local-delegate completion powershell|zsh|bash 可输出脚本,
方便你自行加载。请参阅 Shell 自动补全。
如果你在同一台机器上使用多个会话或多个客户端,建议只运行一个守护进程:
uvx local-delegate-mcp serve
守护进程会在 http://127.0.0.1:9393/mcp 提供 MCP 服务,并在
http://127.0.0.1:9393/ 提供仪表板。Codex、Claude Code、opencode 以及任何兼容 Streamable HTTP
的客户端都可以共用该 URL,无需启动重复的 MCP 进程。使用本地 llama-swap 时,安装额外依赖
[llamaswap] 并将 LLAMASWAP_CONFIG 指向其 config.yaml 后,守护进程还会轮流分配后端:
两个模型会互相驱逐的委派任务不会冲突,第二个任务会等待(面板会将其显示为本地等待)。完整指南:共享守护进程。
一次委派可能会叠加排队等待和推理耗时,而有些客户端会更早超时:Codex 会在 60 s 后中止所有 MCP 工具调用(在 config.toml 的 [mcp_servers.local-delegate] 中设置 tool_timeout_sec 可延长超时时间,但每次 install/update 后都需要重新设置,因为这两个命令会重写该配置块);Claude Code 会在 5 min 无响应后中止 HTTP 调用(设置变量 CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT,单位为 ms,可延长超时时间,且该设置在 install 后仍然有效)。详情见集成安装。
若要使用另一台机器的 GPU,同时保留客户端的本地路径,请使用一个指向远程后端的本地 MCP:Mac → PC 指南和完整技术方案。
不要为了「稳定」固定到旧版本。 固定版本(
==X.Y.Z)也会冻结该 wheel 声明的依赖版本范围,而这些范围会随时间变得不合适:0.12.2 之前的版本要求mcp不设上限,因此如今会解析到 SDK 2.x,并且在导入时就会崩溃。如果需要固定版本,请固定到当前版本,并在新版本发布时升级。
在 Windows 上,如果将其注册为登录时启动的任务,请运行安装了软件包的环境中的 pythonw.exe,并传入 -m local_delegate serve --log-level warning。pythonw 不会创建控制台或任务栏按钮。任务归 Windows 用户所有,而非 Codex 或 Claude:所有本地客户端共用同一个 daemon。dashboard 会用 DAEMON MCP 徽章标识这个唯一进程;连接的会话是 HTTP 客户端,并非额外的 MCP 进程。
在 Windows 上更新时,请先停止 daemon,再运行 uv tool install --force。 daemon 运行时,重新安装可能会在中途失败(因为它打开着环境中的文件),并导致环境损坏;schtasks /End 不够用,因为启动器已脱离,因此请停止 daemon 的 pythonw 进程,完成安装后再重新启动。之后,local-delegate update 会重新写入 hooks、skill,以及过时的 CLAUDE.md/AGENTS.md 配置块。
0.36.0 支持西班牙语或英语,并会跟随系统语言。 如果系统语言为英语,你会看到英语;若要继续使用西班牙语,请运行
LOCAL_DELEGATE_LANG=es local-delegate install(或update)。_local_delegate中的键和工具标记会改为英语(这是一个不兼容变更);对照表见 CHANGELOG 和语言。
0.35.0 将命令、变量、skill 和数据文件重命名为英语。 旧名称自 0.35.0 起仍可使用,但会显示警告;在 0.38.0 中已移除,不再生效。
local-delegate doctor会列出仍在使用的旧名称(直到 0.40.x),而local-delegate update会迁移可迁移的名称。不支持回退到旧版本。完整对照表见 CHANGELOG。
要求
Python 3.11+ — 使用 uvx 时无需自行安装,它会处理;只有在自建环境中使用 pip 安装时才需要关心这一点。
此外,还需要一个已运行且可访问 LOCAL_DELEGATE_BASE_URL 的 OpenAI 兼容端点(默认值为 http://127.0.0.1:9292/v1)。以下任意一个都可以:
- llama-swap — 请参阅 Blackwell GPU 配置示例。
- Ollama —
http://127.0.0.1:11434/v1。 - LM Studio、vLLM,或任何支持 OpenAI API 的服务端。
默认情况下,软件包不会启动任何后端(LOCAL_DELEGATE_AUTOSTART=0)。llama-swap 自动启动为可选功能(请参阅配置表)。
要了解该使用哪些版本的 llama-server/llama-swap,以及如何安排工作区,请参阅后端版本和参考工作区(经过验证的建议,并非要求)。local-delegate doctor 会将你的安装与这些版本进行比较,同时检查其余基础设施——钩子、技能、记忆、MCP 条目和守护进程——且不会写入任何内容(每项检查的内容)。
工具
传入 path(而非 text)会让 MCP 在服务端读取文件:内容不会进入 Claude 的上下文,因此可以节省资源。
| 工具 | 功能 | 模型角色(默认) |
|---|---|---|
local_summarize | 总结文本或文件;可选的 focus 用于指定要保留的内容(例如「配置数值」) | 机械 / 长文本(自动) |
local_classify | 从列表中返回一个标签 | 机械 |
local_extract | 提取字段 → 经过验证的对象,而非需要解析的字符串 | 机械 / 长文本(自动) |
local_boilerplate | 根据规范生成代码并写入 target;仅返回回执 | 代码 |
local_delegate | 通用的文本→文本转交工具 | 机械(或你指定的角色) |
local_lint_summary | 总结 lint / 测试 / CI 日志 | 机械 / 长文本(自动) |
local_commit_msg | 根据 diff 生成提交信息 | 代码 |
local_translate | 翻译文本或文件 | 机械 / 长文本(自动) |
local_explain_code | 用文字解释代码 | 代码 |
local_describe_image | 描述图片或回答有关图片的问题(图片→文本) | 视觉 |
local_status | 只读诊断:后端、目录、日志、VRAM、系统 RAM | —(不调用聊天后端) |
本地模型不使用工具调用:服务端会构建提示词 + 安全防护规则,向端点发送 POST 请求,并且只返回文本。
长文档。 local_translate(以及输入较长时的 local_delegate)会按自然边界拆分文本——Markdown 标题、段落、行——每次调用处理一个片段,遵循 max_tokens 上限,按顺序拼接输出,并在拼接处保留格式。超过 20 000 个字符的文档也会完整返回,不会在中途截断。日志会记录 chunks: N,运行时仪表板会显示进度(片段 3/7)。从 0.43.0 开始,「进行中」还会显示阶段:合并部分结果时显示「正在合并 3 个片段……」,重新拆分被截断的片段时显示「正在重试片段 n/total」;活动信息还会区分片段数与后端调用数(3 +1:三个片段和一次合并)。
超长文档摘要。 当输入超出模型可处理范围时,local_summarize 和 local_lint_summary 会执行映射-归约:先总结每个部分,再总结这些摘要,必要时逐层处理。以前会截断输入——例如,对超长 CI 日志进行摘要时,只会总结开头部分,并静默丢弃其余内容,而错误往往就在被丢弃的部分中——现在则会读取完整内容。如果某个片段因 max_tokens 而被截断,结果会发出提示,日志会记录 finish_reason: length。从 0.43.0 开始,被截断的部分结果不再视为有效:系统会丢弃它,拆分片段(或重新分组后的组)并重试,最多处理两层;如果仍有片段被截断,提示会指出具体片段及其行号。
从 0.36.1 开始,当日志无法在一次调用中处理完时,local_lint_summary 只会输入提及次数最多的十个文件(并说明还有多少个文件),最终摘要中的数值由程序填写,而不是由模型生成。
从 0.36.0 开始,local_commit_msg、local_explain_code(按顶层 def / class 拆分,并在最后一步提供名称清单)和 local_extract(每个片段生成一个部分对象,再在最后一步通过 schema 将其合并)也会读取完整输入。
配置
所有配置都通过环境变量设置;没有硬编码值。默认模型 ID 仅供参考——请替换为你的后端所用的 ID。
| 变量 | 默认值 | 描述 |
|---|---|---|
LOCAL_DELEGATE_BASE_URL | http://127.0.0.1:9292/v1 | OpenAI 兼容端点 |
LOCAL_DELEGATE_API_KEY | (空) | Bearer 令牌;如果端点要求 |
LOCAL_DELEGATE_BACKEND_ORIGIN | auto | local/remote 强制指定计算来源;auto 根据主机推断。如果通过隧道(ssh -L、端口转发)访问后端,请设置此项:通过 loopback 访问时会被视为本地 |
LOCAL_DELEGATE_TIMEOUT | 180 | HTTP 超时时间(秒) |
LOCAL_DELEGATE_MAX_CONCURRENT_REQUESTS | 2 | 每个进程的最大背压;由守护进程的所有客户端共享 |
LOCAL_DELEGATE_ASK | 1 | 通过 elicitation 询问用户,而不是直接失败:后端不可用、模型不在目录中、output_format 为空。设为 0 可禁用 |
LOCAL_DELEGATE_ASK_TIMEOUT | 30 | 等待响应的秒数;超时后,工具会继续执行,就像没有询问过一样 |
LOCAL_DELEGATE_LOG_DIR | (用户数据目录) | 按月轮换的 usage-YYYYMM.jsonl 和 clients.jsonl 所在目录 |
LOCAL_DELEGATE_LOG | (空 = 启用轮换) | 如果设置,则指定一个不轮换的 usage.jsonl 路径(兼容性用途) |
LOCAL_DELEGATE_MODEL_MECHANICAL | gemma3-4b | 用于分类、提取和简短摘要的模型 |
LOCAL_DELEGATE_MODEL_LONG | gemma4-26b-a4b | 用于长文档的模型 |
LOCAL_DELEGATE_MODEL_CODE | qwen36-35b-a3b | 用于代码的模型 |
LOCAL_DELEGATE_MODEL_VISION | gemma4-12b | local_describe_image 使用的视觉模型 |
LOCAL_DELEGATE_MAX_IMAGE_MB | 8 | local_describe_image 的图像大小上限 |
LOCAL_DELEGATE_DUMP_CHUNK_NOTES | (空:关闭) | 本地目录;每个分块操作都会在此保存各步骤的输出。仅用于测量,不会离开本机 |
LOCAL_DELEGATE_LONG_INPUT_CHARS | 6000 | 机械型↔长文档的阈值 |
LOCAL_DELEGATE_CHUNK_CHARS | 3500 | 拆分长文档时的分块大小(local_translate、local_delegate) |
LOCAL_DELEGATE_CHUNK_MAX_TOKENS | 2048 | 每个分块的 max_tokens 上限 |
LOCAL_DELEGATE_CHUNK_MIN_CHARS | 400 | 最小分块大小:低于此值时不再拆分 |
LOCAL_DELEGATE_JSON_SCHEMA | auto | local_extract 中带 schema 的 response_format:auto/on/off |
LOCAL_DELEGATE_FEEDBACK | 1 | 当 source=path 时附加到结果中的节省信息行(设为 0 可关闭)。local_extract 不会将其附加到文本中——否则会破坏 JSON:它会放在 _local_delegate 中 |
LOCAL_DELEGATE_ALLOWED_DIRS | (空 = 不限) | path 的允许根目录,以 ; 分隔 |
LOCAL_DELEGATE_WEB | 1 | stdio 模式下的内嵌 Web 界面(设为 0 可禁用)。从 0.42.0 起,如果设置了 LOCAL_DELEGATE_WEB_TOKEN,则需要提供该令牌,与守护进程相同 |
LOCAL_DELEGATE_WEB_HOST / _PORT | 127.0.0.1 / 9393 | Web 界面或守护进程的主机/端口。留空视为未设置 |
LOCAL_DELEGATE_WEB_ALLOWED_HOSTS | (空) | 该端口允许在 Host 标头中使用的额外名称,以逗号分隔(例如 tailscale serve 使用的名称)。默认仅允许 loopback 和 WEB_HOST,以防 DNS 重绑定(从 0.42.0 起:未设置此项时,通过其他名称访问会返回 421);* 可禁用检查 |
LOCAL_DELEGATE_WEB_FONTS | 1 | 从 Google Fonts 加载品牌字体(0 = 不向第三方发送请求) |
LOCAL_DELEGATE_AUTOSTART | 0 | 自动启动 llama-swap(可选启用) |
LLAMASWAP_EXE / LLAMASWAP_CONFIG / LLAMASWAP_LISTEN | — | 仅当 AUTOSTART=1 时使用;LLAMASWAP_CONFIG 还会启用守护进程的轮转和亲和性(需安装额外项 [llamaswap]) |
LLAMASWAP_WATCH_CONFIG | 0 | 设为 1 时,会为自动启动的后端添加 -watch-config |
LOCAL_DELEGATE_FALLBACK | 1 | 模型间回退:如果某个角色的模型因自身原因失败,则由其链中的下一个模型响应(_MAX_HOPS=2;链使用 _<ROL>,见 wiki)。设为 0 可关闭 |
LOCAL_DELEGATE_COOLDOWN | 1 | 按模型冷却:连续失败 3 次(_FAILURES)后暂停 120 秒(_S),并逐步加倍,最长 900 秒(_MAX_S)。设为 0 可关闭 |
LOCAL_DELEGATE_BACKEND_BREAKER | 1 | 后端不可达时熔断:连续连接失败 3 次(_FAILURES)后,local_* 会立即响应“后端不可达,你来处理”,持续 60 秒(_S),并逐步加倍,最长 600 秒(_MAX_S),且不计为委派;到期后,下次调用会重试。设为 0 可关闭 |
LOCAL_DELEGATE_COST_FALLBACK | (空 = 子 Agent 中的 claude-opus-5-5) | 用于评估未指定模型的委派任务的模型和线程:模型 或 模型:main|subagent。无效值不会导致任何问题:面板会使用已声明的模型并说明原因 |
LOCAL_DELEGATE_COMMIT_LANGUAGE | (空 = 当前语言) | local_commit_msg 消息的语言:es、en、fr、pt、de、it 或自定义名称。留空:产品当前语言;diff:diff 文本中占主导地位的语言 |
LOCAL_DELEGATE_OUTPUT_LANGUAGE | (空 = 当前语言) | 自由文本工具(local_summarize、local_lint_summary、local_explain_code、local_describe_image)要求模型使用的回复语言:fr、pt、português……不会更改界面或 local_commit_msg |
LOCAL_DELEGATE_TURN_MAX_S | 600 | llama-swap 中发生冲突的模型之间的守护进程轮转:如果队列首个请求已等待这么多秒,且守护进程在同样长的时间内没有任何后端调用开始或结束,则仍会授予轮次(日志中显示 turn: "forced") |
LOCAL_DELEGATE_SLOW_THRESHOLD | 0.5 | 如果调用生成速度低于其模型正常速度的这一比例,就会被标记为“慢”(日志中为 slow,面板中显示“慢 ×0,37”) |
LOCAL_DELEGATE_AFFINITY_MARGIN_S | 5 | 亲和性:只有当已加载模型的 TTL 至少还剩这么多秒时,才会复用该模型 |
LOCAL_DELEGATE_BACKEND_PARAMS | (空) | 对 backend-params.json 中各角色参数(采样和推理)的逐键临时覆盖:角色.键=值;…,例如 code.top_k=20。需要重启守护进程;更改文件无需重启 |
每次发送到后端的请求中携带的按角色参数(top_k、temperature、enable_thinking 及其预算……)都保存在 backend-params.json 中,并通过 `local-delegate backend-params show | set | unset |
节省指标
MCP 会将每次调用记录到按月轮转的日志中,并在
http://127.0.0.1:9393 提供一个仪表板,支持范围选择器,并显示正在进行的委派。
保留的上下文 = 服务端读取的输入(source=path 且成功的调用)减去工具返回给你的内容;即使 MCP 将其拆分,也会按每次委派计数一次。
指标以字符数衡量,并通过按分词器系列和内容类型(散文、代码、日志、结构化数据、diff)测得的密度表换算成 Claude tokens:.md 和 .json 的计数方式不同,Haiku 4.5 和 Opus 5.5 的计数方式也不同。图片不计入该数值——没有图片尺寸,就无法知道它们会消耗多少 Claude tokens——而是单独显示。与之相对,本地成本 = GPU 实际消耗的 tokens 总数,包括所有调用:拆分后的委派会在每个片段中重复系统提示词,这种差异就是拆分的成本。这里使用后端报告的实际 token 数;当后端未提供时,chars ÷ 4 仅作为本地模型的后备估算。详情见 wiki。
面板还会显示一个按 API 定价估算的等值费用:如果 Claude 按标价读取同样的上下文,需要花费多少;结果介于一个下限和一个估算值之间,后者会计入因缓存而重新读取该内容的请求。这不是你省下的钱:你的订阅是固定费用。此估算会公开其假设(将每次委派归因于哪个模型、后续有多少请求、使用了哪种密度),且不会扣除对同一文件的重复读取。旁边还有一个配额区块;在收集到至少三次来自不同窗口的 statusline 测量值之前,它会显示“未校准”,且在完成校准前绝不显示百分比。若要为历史记录归因并填充这两个区块,请不时运行 local-delegate recompute-cost(它会在本地读取你的 transcripts,且只写入汇总数据);如果有委派即将失去对应的 transcript,doctor 会发出提醒。
测试不计入指标:脚本中 mcp 客户端发起的委派、基准测试的委派,以及发生在测试窗口内的委派,都会从面板和 local_status 中排除。在 MCP 或守护进程上进行实时测试之前,请标记时间段并保存打印出的 ID:
local-delegate test-window start --label "prueba del lunes"   # imprime el id
local-delegate test-window stop <id>
local-delegate test-window list                               # ventanas y filas en cada una
点击面板工具栏中的测试按钮即可重新显示这些委派;其 ⓘ 会说明排除了多少条记录。
面板会根据浏览器的语言显示西班牙语或英语;标题栏中的 ES/EN 选择器可以切换语言(设置会保存在该浏览器中)。参见
Savings & metrics。
范围、图表中的日期和表格中的时间均使用你的时区(日志以 UTC 写入,这是一个没有歧义的时刻;时区转换仅用于显示)。仪表板还会区分计算运行的位置:如果后端监听在 loopback 地址,则标为 local;如果推理任务发送到了另一台机器,则标为 remote——例如,这台 Mac 使用 PC 的 GPU。v0.11.0 之前的事件不包含此字段,因此会显示为 n/d。
范围/非目标
local-delegate 刻意限定为文本/图像→文本:组装提示词(或多模态负载),向 /chat/completions 发送 POST 请求,并且只返回文本。它不会刻意实现以下功能:
- 本地工具调用。 本地模型不会调用工具或执行代码;这些仍由 Claude 完成。添加此功能会让这个包变成一个并行的编排器,这不是它的目标。
- 图像生成或编辑。
local_describe_image仅用于图像→文本(描述、读取可见文本、回答特定问题);不用于生成或编辑图像。 - 音频。 转录请使用配套项目
whisper-transcribe-mcp, 而不是试图把音频处理塞进这里。 - 替代订阅。 目标是通过委派范围明确的机械步骤来节省配额,而不是把所有工作都路由到本地模型。
与客户端集成:hooks、skill 和记忆
local-delegate install 会在你的 HOME 中设置好完整集成:
| 组件 | 位置 | 功能 |
|---|---|---|
| MCP 入口 | Claude Code 配置/~/.codex/config.toml/~/.config/opencode/opencode.json[c] | 注册服务(通过 uvx 使用 stdio,或通过 HTTP 连接 daemon) |
| Hooks | Claude Code 插件 local-delegate@local-delegate(或 ~/.claude/hooks/local-delegate/ + settings.json) | 建议进行委派;如果启用,读取类 hook 还可以拒绝完整读取文档;其中一个 hook 会记录每次委派由哪个 Agent 发起 |
| Skill | ~/.claude/skills/local-delegation/ 和 ~/.config/opencode/skill/local-delegation/ | 黄金法则和工具目录 |
| 记忆 | ~/.claude/CLAUDE.md、~/.codex/AGENTS.md 和 ~/.config/opencode/AGENTS.md 中的托管区块 | 将规则保存在一条始终加载的简短备注中 |
默认只配置已安装的客户端;也可以使用
--clients claude|codex|opencode 手动选择。Hooks 仅适用于 Claude Code:opencode 通过 TypeScript 插件扩展,这是另一个扩展接口;Claude Desktop 则完全没有 hooks。每个组件都可以排除(--no-hooks、--no-skill、--no-memory、--no-mcp)。
所有内容均提供西班牙语或英语版本。install 和 update 会将运行时的会话语言(LOCAL_DELEGATE_LANG=es|en,或系统语言)保存到 language.json,供 daemon 和 hooks 使用,并以该语言写入 skill、记忆区块和子 Agent 目录。优先级以及如何恢复为跟随系统语言,请参阅:
语言。
只有三个 hook 会自动执行:UserPromptSubmit(机械性意图)、SubagentStart(提醒每个子 Agent 加载 local_* 工具并按范围读取)以及 record_call.py(针对 local-delegate 工具的 PreToolUse)。它不会提醒或阻止操作,而是记录每次委派由哪个 Agent 发起、使用了多少 effort,以便将等效成本归因到该 Agent 使用的模型。两个读取类 hook——PreToolUse/Read 和 PreToolUse/Bash|PowerShell——默认关闭;只有使用 --enable-read-hook 才会同时启用(--disable-read-hook 或 uninstall 会将它们关闭)。它们必须一起启用,因为它们是在两条路径上执行同一条规则:封锁 Read 工具,却放任 cat informe.md,只会让行为换个地方发生,并不会改变它。
这两个 hook 只会发出提醒;拒绝读取则是另一项功能,需单独启用,并且默认关闭(LD_HOOK_READ_BLOCK)。它只会拦截后端正常响应时对大型 .md 或 .txt 文件的完整读取;拒绝提示会指出适用的工具和紧急替代方案:按范围读取永远不会被拦截。之所以提供这项功能,是因为已经实测了四次:仅作提醒并不会改变行为。
参阅集成安装和
docs/recipes/claude-code-hooks.md。
Claude Code 插件、mod 命令和 Claude Desktop
从 0.40 版起,如果已通过 uv tool 安装 Claude Code 2.1.292 或更高版本,install 会将钩子作为一个插件(local-delegate@local-delegate)交付,而不是写入 settings.json,并自动迁移旧安装,同时保留读取锁定。如果不满足这些条件,则继续使用 settings.json 并说明原因;--claude-delivery settings 可手动切回,update 也会遵守该设置。MCP 不会包含在插件中。
插件还附带一个mod,可在 Claude Code 内运行,不消耗模型轮次:
/local-summarize <ruta>、/local-commit(根据git diff --cached提议提交消息;只会显示消息)和/local-lint <fichero|comando>会直接调用本地工具。- 将
local_summarize、local_extract、local_lint_summary和local_commit_msg固定为可用工具,让模型无需通过 ToolSearch 查找它们。 - 在提示词上方显示 local-delegate 在当前会话中的状态条:在终端中,是带背景的一行状态栏,包含状态标签(
● LISTO、◐ DELEGANDO、○ CAÍDO)、模型、正在运行的工具及其进度片段(7/9)和已用时长(3 min 16 s)、本次会话的委派次数和节省情况,以及读取模式(选项status_style:bar或line,即一条横线);在 Claude Desktop 中,则显示单行双色文本,没有药丸状标记或链接。委派运行期间每秒自动刷新。这里不显示 Claude 配额:它属于状态栏。 - 从 0.41 版起,读取 mod(默认开启,选项
read_mod_enabled)会使用local_summarize总结完整读取的大段文本,并将摘要作为该工具自身的结果返回;交互模式下会先询问。总结后,未经实际读取,不允许写入该文件。运行期间会暂时停用会话的读取钩子。它会向 daemon 查询每次调用读取的内容,不会启动进程(测得的每次Bash调用开销处于噪声范围内)。没有保存的值时,视为开启;如果你在 0.40.0 版中将其关闭,它会在插件的设置菜单中重新开启。 - 更新后,请开启一个新的 Claude Code 会话:mods 会在会话开始时加载。
在 Windows 上,install --desktop 会为 Claude Desktop 添加聊天功能:写入一个条目,用于启动 local-delegate desktop-bridge,这是一个通往 daemon 的 stdio 桥接程序,由它自行读取 token,因为 Desktop 不会将其环境传递给 MCP。若要降级到 0.39 版,请先运行 uninstall。详情请参阅Claude Code 插件交付。
llama-swap 分组(可选)
安装 pip install "local-delegate-mcp[llamaswap]" 后,即可使用用于管理 llama-swap 分组的 CLI(轮流使用的池,以及仅在你提出要求时才保持加载的模型),并内置 VRAM 和系统 RAM 防护机制(--ram-gb 是可选项:即使计算完全由 GPU 完成,llama-server 也会将 GGUF 映射到 RAM,因此在内存少于 32 GB 的机器上,即使目录中的模型都能放进 VRAM,也仍可能耗尽 RAM):
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --swap gemma3-4b,gemma4-26b-a4b,qwen36-35b-a3b --vram-gb 16 --ram-gb 32
local-delegate llamaswap residency            # qué se queda cargado y con qué TTL; no escribe
local-delegate llamaswap residency --none --ttl gemma3-4b=120   # volver a «ningún residente»
推荐不设置常驻模型:通过守护进程轮流调度,相互冲突的模型可以共享后端而不会争抢;如果某个工具有已批准的单元格,则会复用已加载的模型(见 工具)。常驻模式需主动启用:
init-llamaswap --resident ID 或 llamaswap residency --pin ID 会将该模型留在 persistent 分组中,并设置 ttl: 0,从而永久占用其 VRAM(--pin 会通过 --vram-model ID=GiB 请求每个模型的实测 VRAM,如果与其他模型最坏情况下的占用总和放不下,就会拒绝执行)。--ttl-resident 默认值为 0:如果使用 persistent 并设置大于 0 的 TTL,模型仍会被卸载,因此并非真正常驻。
该软件包绝不会自行修改你的 config.yaml——只有你主动调用这些命令时才会运行。init-llamaswap 会在写入前运行相应的防护检查(如果 VRAM 不足,或你指定了 --ram-gb 且 RAM 不足,则不会写入任何内容),并且除非指定 --force,否则绝不会覆盖文件(同时会创建副本 <config>.<AAAAMMDD-HHMMSS>.bak)。llamaswap residency 只编辑发生变化的行,保留同样的带日期副本,不会在有正在进行的委派任务时写入(除非指定 --now),并会说明 llama-swap 如何处理重新加载。完整详情、经 llama-swap 代码验证的 groups 语义,以及应用流程,请参阅 docs/recipes/llama-swap-groups.md。
链接
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。