关于 Personal Brain
Personal Brain 是将 LinkedIn 人脉导入 FalkorDB 图数据库的 MCP 服务,供 Agent 查询关系并记录新遇见的人。它还提供可离线查看的 2D/3D 网络可视化。
主要功能
- 01导入 LinkedIn 人脉构建图谱
- 02记录会面、备注与待办
- 03按姓名或主题查找联系人
- 04执行只读 Cypher 查询
- 05离线 2D/3D 网络视图
适用场景
- 01查找可引荐特定对象的人
- 02回忆活动中认识的人及其话题
- 03记录会面并跟进后续事项
MCP 相关
向 MCP 客户端提供 remember、find 和 ask 三种工具,用于写入会面记录、搜索关系图以及执行受限的只读 Cypher 查询。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
3收录的工具列表 · 更新于 4 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| on | string | 否 | |
| due | string | 否 | |
| name | string | 否 | |
| note | string | 否 | |
| string | 否 | ||
| event | string | 否 | |
| title | string | 否 | |
| company | string | 否 | |
| location | string | 否 | |
| follow_up | string | 否 | |
| new_event | boolean | 否 | |
| person_id | string | 否 | |
| ended_jobs | any | 否 | |
| new_person | boolean | 否 | |
| follow_up_done | string | 否 |
详细介绍
Personal Brain
一个 MCP 服务,让你的 AI Agent 记住你的职业人脉。




Personal Brain 会将你的 LinkedIn 联系人导入 FalkorDB 中的图谱。随后,Claude Code 或任何 MCP 客户端都可以查询你认识谁、寻找谁能为你引荐他人,并记住你见过谁。3D 查看器会将图谱呈现为一片星系。
claude mcp add personal-brain -- uvx personal-brain mcp
此命令需要一个已存入你的人脉数据的数据库。请参阅快速开始。
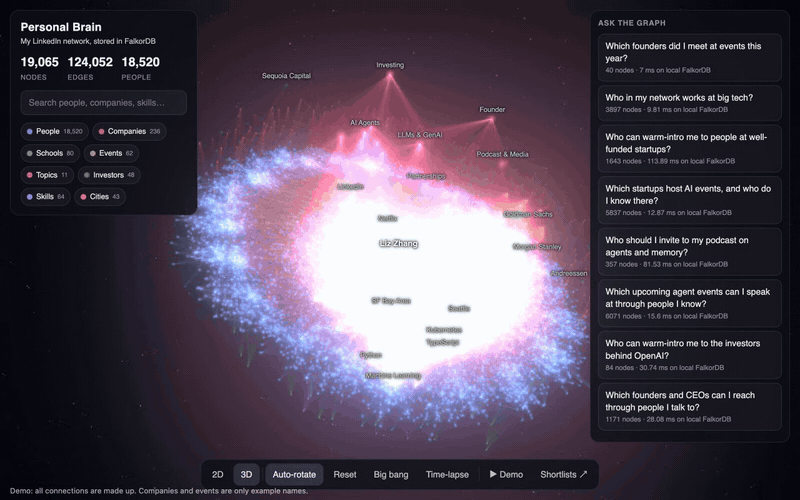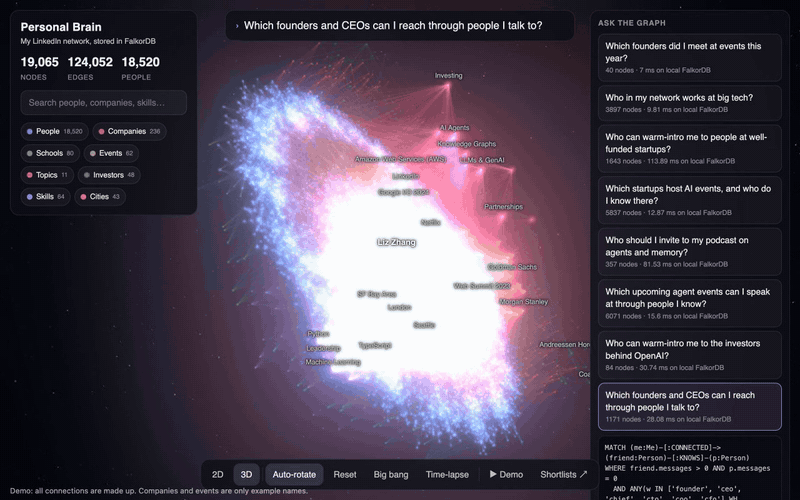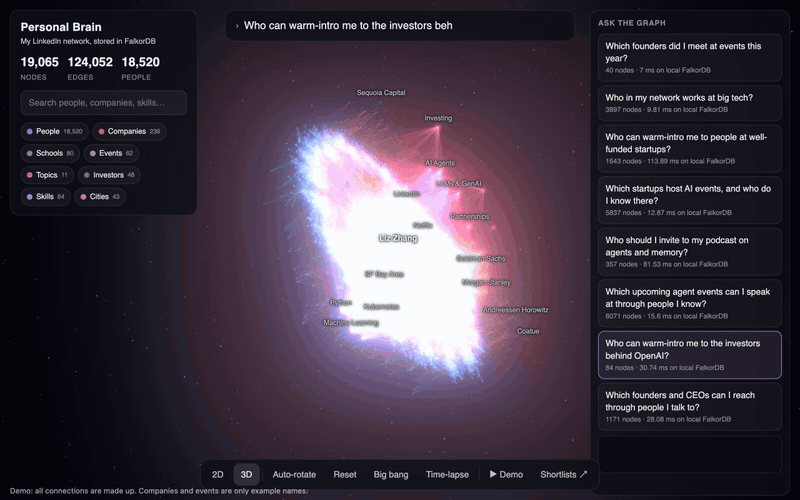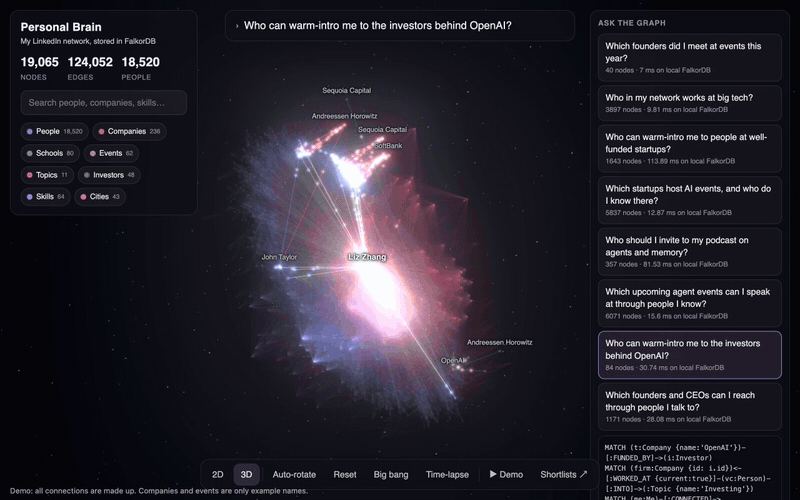
试用在线演示。其中的所有人脉都是虚构的,公司和活动也只是示例名称。
每次参加活动后,你都会认识一些人。两周后,你就会忘记他们是谁、从事什么工作,以及谁能为你引荐他人。现在,你的 Agent 可以替你记住这些信息。你的 Agent 无法删除任何内容:只有你可以使用 personal-brain forget 删除。
所有操作都在你的笔记本电脑上运行。
快速开始:5 分钟体验示例人脉网络
你需要 uv 和 FalkorDB。uvx 会为你下载合适的 Python 版本。
这个虚构的示例人脉网络包含 241 位虚构的人物、初创公司和活动,文件格式与真实的 LinkedIn 导出数据相同。下载自己的数据之前,你可以先试用所有功能。
1. 启动 FalkorDB。 在 Docker 中运行,或参阅 FalkorDB Cloud:
docker run -p 6379:6379 -p 3000:3000 -v falkordb_data:/var/lib/falkordb/data -it --rm falkordb/falkordb:v4.22.2
2. 加载示例数据,并将服务添加到 Claude Code:
uvx personal-brain load --sample
claude mcp add personal-brain -- uvx personal-brain mcp
试试这些问题:
- “我的人脉中有哪些人在 Kestrel Graph 工作?”
- “我和谁聊过 Agent 记忆?”
- “谁能为我引荐一家资金充足的初创公司的人?”
- “我在 Graph & RAG Meetup 上认识了 Oskar Mensah。他正在开发 Agent 记忆。”(有两位 Oskar Mensah,因此系统会询问你指的是哪一位。)
**其他 MCP 客户端:**该服务通过 stdio 运行。大多数客户端都使用以下配置:
{
  "mcpServers": {
    "personal-brain": { "command": "uvx", "args": ["personal-brain", "mcp"] }
  }
}
FalkorDB Cloud
免费的 FalkorDB Cloud 实例无需 Docker 即可使用。将其 URL 传给服务,并在 load 和 export 命令中添加 --cloud:
export FALKORDB_URL='falkors://user:password@host:port'
uvx personal-brain load --sample --cloud
claude mcp add personal-brain -e FALKORDB_URL="$FALKORDB_URL" -- uvx personal-brain mcp
或者,在 ~/.personal-brain/.env 中设置 FALKORDB_URL=...。
MCP 工具
uvx personal-brain mcp 会让你的 Agent 使用同一张图中的三个工具:
| 工具 | 功能 |
|---|---|
remember | 保存你见过的人、他们的工作单位、你们见面的地点,以及他们的职位、城市和电子邮件。要更正事实,只需说明:它会替换旧值。如果某家公司或活动名称与已知名称只差一个字母,它不会保存任何内容,并会询问你。它也会保留待办事项:“提醒我周五前把演示文稿发给 Jonas”会一直保持未完成状态,直到你说已经完成。“Kestrel”和“Kestrel Inc.”会被视为同一家公司,活动名称中的拼写错误也会匹配到同一活动。它会将姓名与图中已有的人匹配。如果不确定你指的是哪个人,就不会保存任何内容,而会询问你。新增公司会结束旧工作,并将其保留在历史记录中。如果此人目前有多份工作,它会询问你要结束哪一份。它也会记录某人离职但没有新工作的情况。同一次见面即使调用两次,也只会保存一条记录。如果不是今天见面,请说明见面时间。 |
find | 按姓名查找人物、公司和活动,支持任何文字系统,也能识别拼写错误和缺失的重音符号。使用 about 时,可根据笔记中的词语、话题、技能和简介查找人物,例如“我和谁聊过 Agent 记忆?”,并说明每个人符合条件的原因。 |
ask | 执行只读 Cypher 查询(FalkorDB 会拒绝写入),限制为 5 秒,最多返回 50 行和 40,000 个字符。它会拒绝 LOAD CSV,以免数据被发送到互联网。工具描述中包含架构。 |
没有任何工具能删除内容,因此,即使 LinkedIn 简介中藏有文本,也无法让你的 Agent 删除任何内容。不过,这仍可能导致 Agent 保存虚假笔记,所以每个工具都会告诉 Agent 将这类文本视为数据,而 personal-brain notes 会按时间从新到旧显示已保存的内容。没有任何指令能完全避免这种情况。要删除内容,请自行运行命令。除非添加 --yes,否则它会先询问;如果你有查看器文件,也会一并更新:
uvx personal-brain forget note <id>         # one note and everything it added. remember's reply gives this command
uvx personal-brain forget person "Name"     # a person and every note about them. They stay out of future rebuilds
uvx personal-brain forget all-notes         # every note and everything they added, to clear a live demo
每次写入都会关联到一个 Note 节点,因此你可以追溯每条事实对应的来源笔记。再次运行 personal-brain load 并导入新的 LinkedIn 导出文件时,你的笔记及其新增内容都会保留。如果新导入的内容包含相同事实,则以导入内容为准;你保存的人如果现在也出现在导入内容中,就会合并为同一个人。--force 会删除你的笔记。load --sample 会在替换真实网络前询问你,--yes 则跳过询问。PB_GRAPH 用于选择图(默认为 network)。如果 FalkorDB 未运行,服务仍会启动,并且每个工具都会说明如何启动它。它可在 macOS 和 Linux 上运行。不支持 Windows。
每次导入新的 LinkedIn 导出文件时,也会告知你发生了哪些变化。personal-brain load 会列出自上次导入以来更换工作的人,你之后也可以让 Agent 查询。如果导出文件包含消息日期,Agent 可以回答“我和谁失去了联系”。它只读取日期,不读取消息内容。personal-brain followups 会列出你仍需完成的事项。
3D 查看器
运行 personal-brain export,然后运行 personal-brain view,并打开 http://127.0.0.1:8765。它可以离线运行,因为其中包含 three.js。
- 在 WebGL 中将整个关系网络显示为一座银河(已使用 19k 个节点和 117k 条边测试),并可切换 2D / 3D。
- 时间回放:看着你的关系网络逐条连接、不断增长,同时弹出你的活动。
- 向图提问:问题会自动输入,接着显示对应的 Cypher 查询,然后答案会沿着路径以光脉冲的形式亮起。示例问题:
- 过去一年里,我在活动上见过哪些创始人?
- 我的关系网络里有哪些人在大型科技公司工作?
- 谁能帮我引荐资金充足的初创公司里的人?
- 哪些初创公司会举办 AI 活动?我在那里认识谁?
- 我应该邀请谁来参加我的 Agent 和记忆主题播客?
- 通过我认识的人,我可以去哪些即将举行的 Agent 活动演讲?
- 记忆:输入“在 AI Engineer Summit 认识了来自 Supabase 的 Maya,她负责开发者活动”,系统就会将其实时写入 FalkorDB,并显示在银河中。
- 实时视图:在你的 Agent 工作时保持
personal-brain view开启。它查找或保存的每个人都会在银河中亮起。 - 演示模式:全程自动演示(按
D)。
工作原理
LinkedIn data export ──┐
                       ├─> load_graph.py ──> FalkorDB ──┬─> mcp_server.py ──> your agent
data/enriched/ ────────┘   (graph "network")            ├─> export_graph.py ──> layout_graph.py ──> viewer
(optional)                                              ├─> export_stories.py ──> viewer
                                                        └─> server.py (live "Remember" API) ──> viewer
- 你的 LinkedIn 导出数据包含人脉(含建立联系的日期)、消息(只使用数量,从不读取文本)、帖子、工作经历和学校信息。
data/enriched/中的可选文件会补充每位人脉的完整工作经历、学校和技能、公司融资情况以及即将举行的活动。文件使用sample_data/enriched/中的 JSON 格式。此代码库不提供收集这些数据的工具;没有这些文件也能正常使用。- load_graph.py 构建图并推断:
- 如果两位人脉曾在同一家公司工作或在同一所学校就读至少 3 个月,且时间重合(大型学校仅要求入学年份相同),则在两者之间建立
KNOWS;如果没有工作经历数据,则在目前就职于同一家公司的人之间建立KNOWS;同一群聊中的人之间也会建立KNOWS。 Event节点:你在某一天新增了 5 位或更多人脉,那天可能举办过活动。请在my_brain.json中为活动命名。- 根据个人简介和技能推断
Topic兴趣(AI Agent、Agent 记忆、知识图谱、创始人、投资者、播客等)。 - 仅使用补充文件时:
- 根据职位名称和描述,计算每种技术的工作年限。
well_funded初创公司:非上市、仍在运营、员工人数不超过 5,000,且获得过一轮 Series 融资或有 8 位及以上投资者。- 根据个人资料中的所在地推断
City,精确到都会区级别(“Berlin Metropolitan Area”和“Berlin”视为同一城市;Palo Alto 和 San Jose 归为“SF Bay Area”)。 - 确定每项即将举行的活动的主办方:主办方是你的人脉(匹配 LinkedIn),或你认识相关人员的公司(主办方是该公司、某位主办方在该公司工作,或活动标题中提及该公司,例如“Notion x Clover”)。
- 如果两位人脉曾在同一家公司工作或在同一所学校就读至少 3 个月,且时间重合(大型学校仅要求入学年份相同),则在两者之间建立
- export_graph.py + layout_graph.py 将图导出为 JSON,并计算 2D 布局(igraph DrL)。在 3D 中,每种节点类型各自位于一个图层。
- export_stories.py 在 FalkorDB 上运行“向图提问”的 Cypher 查询,并保存答案和耗时,供查看器使用。
图模式
| 节点 | 边 |
|---|---|
Me、Person、Company、School、Skill、Topic、Event、Investor、City、Note | (Me)-[:CONNECTED]->(Person)、(Person)-[:WORKED_AT {title, start, end, current}]->(Company)、(Person)-[:STUDIED_AT]->(School)、(Person)-[:HAS_SKILL]->(Skill)、(Person)-[:HAS_EXPERIENCE {years}]->(Skill)、(Person)-[:INTO]->(Topic)、(Person)-[:KNOWS {via, place}]-(Person)、(Me)-[:ATTENDED]->(Event)、(Person)-[:MET_AT]->(Event)、(Company)-[:FUNDED_BY {lead, round}]->(Investor)、(Person)-[:LIVES_IN]->(City)、(Event {upcoming})-[:HOSTED_BY {via}]->(Person or Company)、(Event)-[:ABOUT]->(Topic)、(Event)-[:HELD_IN]->(City)、(Me)-[:MET]->(Person) 和 (Me)-[:WROTE]->(Note)-[:ABOUT]->(Person)(来自“记忆”) |
构建你自己的版本
1. 获取你的 LinkedIn 数据。 前往 LinkedIn > Settings > Data privacy > Get a copy of your data。 有两种选择:
- 仅限联系人:通常约 10 分钟就能准备好。你会获得联系人、他们当前的公司和职位,以及你们建立联系的日期。这些数据足以构建关系图、活动和 Agent 工具。
- 下载较大的数据档案:约一天后准备好。还会包含你的消息(仅使用数量)、帖子、职位和学校。
将其解压到 ~/.personal-brain(文件夹名称中包含 LinkedInDataExport)。如果有多个,load 会读取最新的那个。personal-brain --help 会显示你的数据文件夹。若要使用其他文件夹,请设置 PB_HOME。
或者从空白开始。 跳过导入。MCP 服务会在空关系图中创建你的节点,并随着你告诉 Agent 认识了谁,让关系图逐步扩展。
可选:将 my_brain.example.json 复制到 ~/.personal-brain/my_brain.json,用于命名活动并跳过公司。
2. 构建关系图和查看器数据。 使用 FalkorDB Cloud 时,请在两条命令中都添加 --cloud:
uvx personal-brain load
uvx personal-brain export
3. 打开它。
uvx personal-brain view
打开 http://127.0.0.1:8765。快捷键:`2` / 3 切换视图,T 播放时间流逝,B 显示大爆炸,D 演示,Esc 重置。
若要改用 FalkorDB Browser 探索,请参阅 docs/demo_queries.cypher。
开发代码
你需要 Python 3.10 或更新版本、uv 和 Docker。在克隆的代码仓库中,你的数据文件夹就是克隆目录,Claude Code 会从其中任意文件夹读取 .mcp.json。
git clone https://github.com/zhang-liz/personal-brain && cd personal-brain
python3 -m venv .venv && .venv/bin/pip install -e ".[test]"
docker run -p 6379:6379 -p 3000:3000 -v falkordb_data:/var/lib/falkordb/data -it --rm falkordb/falkordb:v4.22.2
然后,在另一个终端中运行测试。测试会使用临时关系图:
PATH="$PWD/.venv/bin:$PATH" .venv/bin/python -m pytest          # everything, on local FalkorDB
.venv/bin/python tests/test_memory.py --cloud                    # the memory tools on FALKORDB_URL
你的数据只属于你
- 你的数据保存在
~/.personal-brain中,位于程序包之外。只有你能打开该文件夹。在克隆的代码仓库中,导出文件、data/、.env和my_brain.json均已列入.gitignore。切勿提交这些文件。 - 永远不会将消息文本读入关系图,只会记录你与每个人交换的消息数量以及最后一条消息的日期。
- 你数据文件夹中的
data/viewer/graph.json包含真实姓名。请分享截图,而不是该文件。 - 本地服务仅监听
127.0.0.1,并且只提供data/viewer/中的内容。
文件
| 路径 | 用途 |
|---|---|
src/personal_brain/cli.py | personal-brain 命令 |
src/personal_brain/paths.py | 数据文件夹的位置 |
src/personal_brain/load_graph.py | 构建 FalkorDB 图谱及所有推断出的链接 |
src/personal_brain/export_graph.py | 将每个节点和边导出到 data/viewer/graph.json |
src/personal_brain/layout_graph.py | 预先计算布局 |
src/personal_brain/export_stories.py | “询问图谱”问题及其 Cypher 查询 |
src/personal_brain/server.py | 为查看器和实时 Remember API 提供服务,且仅供查看器自己的页面使用 |
src/personal_brain/memory.py | 记忆本身:remember、find、ask、forget(供 MCP 服务、查看器和 forget 命令使用) |
src/personal_brain/mcp_server.py | 为 Claude Code 和其他 Agent 提供的 MCP 服务 |
src/personal_brain/forget.py | personal-brain forget 命令 |
src/personal_brain/notes.py | personal-brain notes 命令 |
src/personal_brain/notes_backup.py | 在重建期间保留你的笔记 |
src/personal_brain/job_changes.py | 每次加载时报告哪些人换了工作 |
src/personal_brain/followups.py | personal-brain followups 命令 |
src/personal_brain/activity.py | 告诉查看器你的 Agent 刚刚做了什么 |
src/personal_brain/companies.py | 判断两个公司名称是否指同一家公司 |
.mcp.json | 告诉 Claude Code 如何在克隆版本中启动 MCP 服务 |
tests/ | 在临时图谱上端到端检查记忆工具、MCP 服务和构建后的软件包 |
src/personal_brain/sample_data/ | 虚构的示例关系网络 |
scripts/make_sample_data.py | 写入 sample_data/ |
src/personal_brain/viewer/index.html | WebGL 查看器(three.js r170,MIT,随项目附带) |
docs/demo_queries.cypher | 可粘贴到 FalkorDB Browser 中的查询 |
这是一个早期项目。它有测试和 CI,但在 1.0 版本发布前,命令和工具仍可能发生变化。
贡献
请参阅 CONTRIBUTING.md。如需报告安全问题,请参阅 SECURITY.md。
许可证
MIT,详见 LICENSE。src/personal_brain/viewer/vendor/ 中的 three.js 也采用 MIT 许可证(其自身的 LICENSE 文件)。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。