
关于 firecrawl-research-patterns
Firecrawl Research Patterns 是一套以 Firecrawl 公共 API 为基础的研究工作模式,面向需要搜索、抓取网页或获取论文的研究者与 Agent。它涵盖递归深度研究,并要求保存原始结果以供后续分析。
主要功能
- 01通过 API 搜索并抓取网页
- 02按来源选择论文获取方式
- 03递归执行搜索与综合
- 04保存原始研究结果及来源信息
- 05复查和重新分析研究语料
- 06处理含图表的论文内容
适用场景
- 01搜索主题并保存网页资料
- 02获取论文正文并整理研究发现
- 03递归拓展研究问题
- 04基于既有语料开展新一轮分析
安装
复制下面的命令,在终端中运行。
npx skills add https:/安装后在 Claude Code 中输入/firecrawl-research-patterns确认已加载。
包含的文件
除 SKILL.md 外,安装时一起下载的参考资料和脚本。
references/academic-paper-routing.mdapi-endpoint-reference.mdcorpus-persistence-format.mdevolution-log.mdrecursive-research-protocol.md详细介绍
Firecrawl 研究模式
在研究工作流中以编程方式使用 Firecrawl 的模式——搜索、抓取、将学术论文路由到相应位置、运行递归深度研究,并持久化原始结果,以便日后重新分析。
使用公开的 Firecrawl API。没有可自托管的实例。 POST https://api.firecrawl.dev/v2/scrape 无需 API 密钥即可响应,足以满足此仓库实际进行的低频、偶尔转换需求。速率限制和排队都可以接受;不要为了规避这些问题而搭建私有部署。
如需归档 AI 聊天对话(ChatGPT/Gemini 分享内容),请参阅 Skill(gh-tools:research-archival)。
自我演进的技能:此技能会在使用过程中不断改进。如果指令有误、参数发生偏移,或需要变通方法,请立即修复此文件,不要拖延。仅在遇到真实、可复现的问题时才更新。
首先 — TodoWrite 任务模板
必须:在开始任何研究工作前,选择并加载适当的模板。
意图路由 — AI 聊天分享 URL(chatgpt / gemini / claude)
AI 聊天分享 URL(chatgpt.com/share/*、chat.openai.com/share/*、gemini.google.com/share/*、g.co/gemini/share/*、claude.ai/share/*、claude.ai/chat/*)既可以由此技能处理,也可以由 Skill(gh-tools:research-archival) 处理。根据意图而非 URL 模式进行选择:
| 你的意图 | 技能 | 输出 |
|---|---|---|
| 一次性读取/提取对话文本以供分析 | 此技能 — 公共 API(第 1 节) | Markdown 在 data.markdown 中返回;由你自行保存。没有 frontmatter、没有 Issue、没有来源信息。 |
| 长期归档,并进行身份验证、添加 frontmatter 和 GitHub Issue 交叉链接 | Skill(gh-tools:research-archival) | docs/research/YYYY-MM-DD-{slug}-{type}.md + 带有 Discovery Provenance 的 issue。 |
| 已有文件,只需将额外内容抓取到同一语料文件中 | 此技能 | 由你控制的追加模式工作流。 |
两种路径共用同一个 Firecrawl 后端。
research-archival也会调用 Firecrawl——它在此基础上增加了归档层。两者的抓取能力没有差异;区别在于字节返回后如何处理。
无论意图如何,WebFetch 都有以下限制:Claude Code 会硬性阻止对 chatgpt.com 使用 WebFetch。请使用 Firecrawl。
聊天分享应优先使用 Firecrawl,而非 Jina Reader——Jina 会悄悄截断内容。 2026-08-13 对两个 chatgpt.com/share/* URL 进行测量,同一时间,两者均返回 HTTP 200 且没有错误:
| 链接 | Firecrawl v2/scrape | Jina r.jina.ai | Jina 覆盖率 |
|---|---|---|---|
| 1 | 57,616 个字符 · 76 个标题 · 128 行表格 | 9,397 个字符 · 12 个标题 · 22 行表格 | 17% |
| 2 | 136,590 个字符 · 85 个标题 · 69 行表格 | 15,960 个字符 · 13 个标题 · 9 行表格 | 12% |
Firecrawl 到达了两个页面的真正末尾(Sources / ChatGPT is AI and can make mistakes. 页脚)。Jina 则在句子中途停止——链接 1 的结尾是 "I would spend money on **Synol"。两者都没有遇到登录墙,而且 Firecrawl 多出的内容并非导航模板(重复次数最多的一行是空行)。Jina 截断后的结果看起来像是成功抓取了一个较短的页面,这是危险的失败情况:没有错误可供发现。
Jina 还必须添加 -H "x-timeout: 30" 才能使用——默认设置只会返回约 321 字节的登录页面内容("Log in to get answers"),并且只有一条轻量级的 Warning: 行。简单静态页面仍可将 Jina 用作备用方案;不要用它处理聊天分享或任何由 JS 渲染的内容。
模板 A — 单次 Firecrawl 搜索并保存
1. No health check needed — the public API has no self-hosted liveness concern. Handle per-request failures instead (Section 1).
2. Execute search — POST /v2/search with query, limit, scrapeOptions
3. Persist raw results — save each result page to docs/research/corpus/ with frontmatter
4. Update corpus index — append entries to docs/research/corpus-index.jsonl
5. Extract findings — summarize key learnings from raw corpus files
模板 B — 学术论文检索并保存
1. Identify source — classify URL/DOI per academic-paper-routing.md decision tree
2. Route to scraper — arxiv direct HTML, Semantic Scholar API, Firecrawl, or Jina Reader
3. Scrape content — execute fetch with appropriate method and timeout
4. Persist raw result — save to docs/research/corpus/ with academic-specific frontmatter
5. Update corpus index — append entry to corpus-index.jsonl
6. Summarize paper — extract key claims, methods, results from raw corpus file
模板 C — 使用语料进行完整递归深度研究
1. No health check needed — the public API has no self-hosted liveness concern. Handle per-request failures instead (Section 1).
2. Initialize parameters — set breadth (default 4), depth (default 2), concurrency (default 2)
3. Generate search queries — LLM generates N queries from topic + prior learnings
4. Execute searches — Firecrawl /v2/search for each query via p-limit(concurrency)
5. Persist raw results — save ALL scraped pages to docs/research/corpus/ with provenance
6. Extract learnings — LLM extracts key findings + follow-up questions per result set
7. Recurse — for each follow-up, recurse with breadth=ceil(breadth/2), depth=depth-1
8. Base case — depth=0, return accumulated learnings
9. Synthesize report — LLM generates final markdown from all learnings
10. Write session report — save to docs/research/sessions/ with corpus file references
11. Update corpus index — append all new entries to corpus-index.jsonl
模板 D — 语料审查/重新分析
1. Inventory corpus — read docs/research/corpus-index.jsonl, filter by session/topic/date
2. Read raw files — load matching corpus files from docs/research/corpus/
3. Re-analyze — extract new insights with current context/questions
4. Update session report — amend or create new session report in docs/research/sessions/
模板 E — 带内嵌图表的图像丰富型论文
适用于包含架构图、结果图、注意力图或任何关键视觉内容的论文。
1. Scrape text — use the public API (`/v2/scrape`, preserves absolute image URLs) or Jina fallback
2. Detect figures — scan scraped markdown for  patterns with .png/.jpg/.svg
3. Extract figure URLs — for arXiv: probe https://arxiv.org/html/{id}v{n}/x{N}.png until 404
4. Keep URLs inline — DO NOT rewrite to local relative paths (breaks GitHub rendering)
5. Ensure inline embedding — markdown body must have  for each figure
6. Catalog in frontmatter — add figure_count and figure_urls list (all absolute URLs)
7. Save corpus file — GFM markdown with inline absolute URLs renders on GitHub without hosting
8. Update corpus-index.jsonl — include has_figures: true, figure_count, figure_urls
第 1 节 — 以编程方式使用 Firecrawl
端点:https://api.firecrawl.dev 上的公共 API。无需 API 密钥、主机或隧道——无需身份验证即可访问。
curl -sS -X POST https://api.firecrawl.dev/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"<URL>","formats":["markdown"],"waitFor":8000,"timeout":60000}'
# -> {"success":true,"data":{"markdown":"..."}}
对于由 JS 渲染的页面(SPA、聊天分享、仪表板),务必发送 waitFor。否则,抓取可能返回尚未完成 hydration 的页面外壳——对于受登录墙限制的 SPA,这会返回登录界面,而非内容;即便如此,响应仍会返回 HTTP 200。HTTP 200 并不能证明内容已提取;请检查是否包含预期内容。
不要重新启用可自托管部署。曾有一个部署运行在 gpu-host-2:3002 上(5 个容器:api、playwright-service、nuq-postgres、rabbitmq、redis),已于 2026-08-13 停用,释放了约 18 GB 空间。公共 API 足以满足此仓库的用量。重新部署会耗费约 18 GB 空间并运行 5 个常驻容器,却只能换来没人遇到过的速率限制。
为什么使用 fetch() 而不是 @mendable/firecrawl-js SDK
官方 SDK 使用 jiti 进行动态导入,这与 Bun 的模块解析不兼容。直接调用 fetch() 更简单、更可靠,而且不依赖任何依赖项。
两个端点
| 端点 | 用途 | 使用场景 |
|---|---|---|
POST /v2/search | 搜索 + 抓取组合 | 研究查询——返回多个已抓取页面 |
POST /v2/scrape | 抓取单个 URL | 已知 URL——从一个页面提取 Markdown |
完整的请求/响应约定请参阅 api-endpoint-reference.md。
快速示例
使用公共 API 基础地址。如果项目设置了 $FIRECRAWL_BASE 环境变量,则从中读取;否则,直接写入 FQDN:
const FIRECRAWL_BASE =
  process.env.FIRECRAWL_BASE ?? "https://api.firecrawl.dev";
搜索(返回多个包含 Markdown 的结果):
const res = await fetch(`${FIRECRAWL_BASE}/v2/search`, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    query: "mixture of experts scaling laws",
    limit: 5,
    scrapeOptions: { formats: ["markdown"] },
  }),
});
const { data } = await res.json(); // data: [{ url, markdown, metadata }]
抓取(单个 URL):
const res = await fetch(`${FIRECRAWL_BASE}/v2/scrape`, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    url: "https://arxiv.org/abs/2401.12345",
    formats: ["markdown"],
    waitFor: 3000, // ms — for JS-heavy pages
  }),
});
const { data } = await res.json(); // data: { markdown, metadata }
错误处理
// Always set a timeout
const controller = new AbortController();
const timeoutId = setTimeout(() => controller.abort(), 15_000);

try {
  const res = await fetch(url, { ...opts, signal: controller.signal });
  if (!res.ok) throw new Error(`Firecrawl: ${res.status} ${res.statusText}`);
  const json = await res.json();
  if (!json.data || (Array.isArray(json.data) && json.data.length === 0)) {
    // Empty results — not an error, but no content to process
  }
} finally {
  clearTimeout(timeoutId);
}
第 2 节 — 学术论文路由
根据来源,将论文检索路由到最有效的方法。完整决策树请参阅 academic-paper-routing.md。
快速参考
| 来源 | 最佳方法 | 回退方法 |
|---|---|---|
| arxiv.org | 直接使用 HTML(/html/ID) | Firecrawl /v2/scrape |
| Semantic Scholar | API(api.semanticscholar.org) | 按标题使用 Firecrawl 搜索 |
| ACL Anthology | 使用 Firecrawl /v2/scrape | 直接下载 PDF |
| NeurIPS/ICML/ICLR | 使用带 waitFor 的 Firecrawl /v2/scrape | 按标题搜索 |
| IEEE Xplore | 使用 waitFor: 3000 的 Firecrawl | 作者网站 |
| ACM DL | 使用 waitFor: 3000 的 Firecrawl | 作者网站 |
| 作者博客 | Jina Reader(r.jina.ai) | Firecrawl /v2/scrape |
| Google Scholar | Firecrawl /v2/search | 直接搜索查询 |
DOI 解析
// DOI → publisher URL → route to appropriate scraper
const res = await fetch(`https://doi.org/${doi}`, { redirect: "follow" });
const publisherUrl = res.url; // e.g., https://dl.acm.org/doi/10.1145/...
// Then route publisherUrl through the decision tree above
第 3 节 — 递归研究协议
采用迭代式的“搜索 → 提取 → 递归 → 综合”模式。完整的分步协议请参阅 recursive-research-protocol.md。
算法概述
deepResearch(topic, breadth=4, depth=2, concurrency=2):
   1. Generate N search queries (N = breadth) from topic + prior learnings
   2. For each query (via p-limit concurrency):
      a. Firecrawl /v2/search → get results
      b. PERSIST each raw result to docs/research/corpus/
      c. Extract learnings + follow-up questions
   3. For each follow-up question:
      → Recurse with breadth=ceil(breadth/2), depth=depth-1
   4. Base case: depth=0 → return accumulated learnings
   5. Synthesize final report from all learnings
   6. Write session report to docs/research/sessions/
默认参数(来自可运行的实现)
| 参数 | 默认值 | 最大值 | 原因 |
|---|---|---|---|
breadth | 4 | — | 每层并行搜索查询的数量 |
depth | 2 | 5 | 递归层数(深度超过 5 时,收益递减) |
concurrency | 2 | — | 并行 Firecrawl 请求数(公共 API——请适度使用) |
limit | 5 | — | 每个搜索查询的结果数 |
timeout | 15000ms | — | 每次搜索的超时时间 |
Token 预算
每次搜索最多返回 5 个页面。在交由 LLM 处理前,将每个页面裁剪至约 25,000 个 token:
function trimToTokenLimit(text: string, maxTokens: number): string {
  if (!text) return "";
  const estimatedTokens = Math.ceil(text.length / 3.5);
  if (estimatedTokens <= maxTokens) return text;
  const maxChars = Math.floor(maxTokens * 3.5 * 0.8);
  return text.slice(0, maxChars);
}
部分失败原则
部分结果胜过彻底失败。 如果某个查询失败,请记录下来并继续执行其余查询。绝不要因为一个查询超时就中止整个研究会话。
第 4 节 — 原始语料持久化
核心原则:每个由 Firecrawl 抓取的页面都必须以原始 Markdown形式持久化,并附带来源元数据。综合报告应引用这些原始内容,而不能取而代之。
完整格式规范见 corpus-persistence-format.md。
目录布局
{project-root}/
├── docs/research/
│   ├── corpus/                              # Raw scraped pages (committed)
│   │   └── YYYY-MM-DD-{slug}.md             # One file per scraped URL
│   ├── sessions/                            # Research session reports (committed)
│   │   └── YYYY-MM-DD-{topic-slug}.md       # Synthesized report with corpus refs
│   └── corpus-index.jsonl                   # Append-only registry (committed)
语料文件 Frontmatter
---
source_url: https://arxiv.org/html/2401.12345
scraped_at: "2026-02-25T14:30:00Z"
scraper: firecrawl
firecrawl_endpoint: /v2/search
search_query: "mixture of experts scaling"
result_index: 2
research_session: "2026-02-25-moe-scaling"
depth_level: 1
claude_code_uuid: SESSION_UUID
content_tokens_approx: 4200
---
[RAW MARKDOWN FROM FIRECRAWL — NEVER MODIFIED]
关键规则
---下方的内容必须是 Firecrawl 返回的精确 Markdown,不得进行摘要、裁剪或重新排版- 每个 URL 每次抓取对应一个文件 — 如果在多个会话中抓取同一个 URL,每次抓取都应生成一个带时间戳的独立文件
- 文件命名格式:
YYYY-MM-DD-{slug}.md,其中 slug 根据页面标题或 URL 路径采用 kebab-case 格式(最长 60 个字符) - 会话报告位于
docs/research/sessions/,并通过相对路径引用语料文件
语料索引(JSONL)
{
  "url": "https://arxiv.org/html/2401.12345",
  "file": "corpus/2026-02-25-moe-scaling-arxiv-2401-12345.md",
  "scraped_at": "2026-02-25T14:30:00Z",
  "session": "2026-02-25-moe-scaling",
  "tokens": 4200,
  "scraper": "firecrawl"
}
重要性
- LLM 重新分析:未来的会话可以重新读取原始语料文件,并通过更好的提示词或更新的模型提取不同见解
- 不丢失信息:综合处理会舍弃细节;原始文件则保留 Firecrawl 捕获的所有内容
- 去重意识:JSONL 索引可让 Agent 跳过语料中已有的 URL
- 便于使用 Git:Markdown 文件可清晰地显示差异,JSONL 采用仅追加的方式
第 5 节 — 已弃用:自托管运维
自托管部署(gpu-host-2:3002,以及由 Caddy 代理的端口 3003/3004)已于 2026-08-13 弃用。其容器、镜像和构建缓存均已删除,并回收了约 18 GB 空间。请使用第 1 节中的公共 API。对于此仓库的使用量,不要重新引入私有部署。
第 6 节 — 图像和图示捕获
纯文本抓取工具(Jina、直接使用 Firecrawl)可以捕获正文内容,但会丢失架构图、结果图和注意力图。对于包含大量图像的论文,务必捕获图示。
何时捕获图像
论文包含以下任意内容时,捕获图示:
- 架构图(模型结构、注意力模式)
- 基准测试/结果对比图
- 定性示例(生成结果、可视化内容)
- 算法流程图或伪代码图示
发现 arXiv HTML 图像 URL
arXiv HTML 论文将图像存储在按顺序排列的绝对 URL 中(x1.png、x2.png 等)。通过探测发现所有图像 URL — 不要将它们下载到本地:
ARXIV_ID="2312.00752"
ARXIV_VER="v2"
BASE_URL="https://arxiv.org/html/${ARXIV_ID}${ARXIV_VER}"
FIGURE_URLS=()

# Probe sequential URLs until 404 — collect absolute URLs only
for i in $(seq 1 50); do
  url="${BASE_URL}/x${i}.png"
  status=$(curl -s -o /dev/null -w "%{http_code}" "$url")
  if [ "$status" != "200" ]; then
    echo "Stopped at x${i}.png (${status}) — found ${#FIGURE_URLS[@]} figures"
    break
  fi
  FIGURE_URLS+=("$url")
  echo "Found: $url"
done
收集到的绝对 URL 直接放入 Markdown 正文和 Frontmatter 中 — 无需本地副本。
内嵌图示(GFM)
每个图示都必须以内嵌形式出现在语料 Markdown 中,并使用绝对 URL,以便 GitHub 在原位置渲染:
## Key Figures
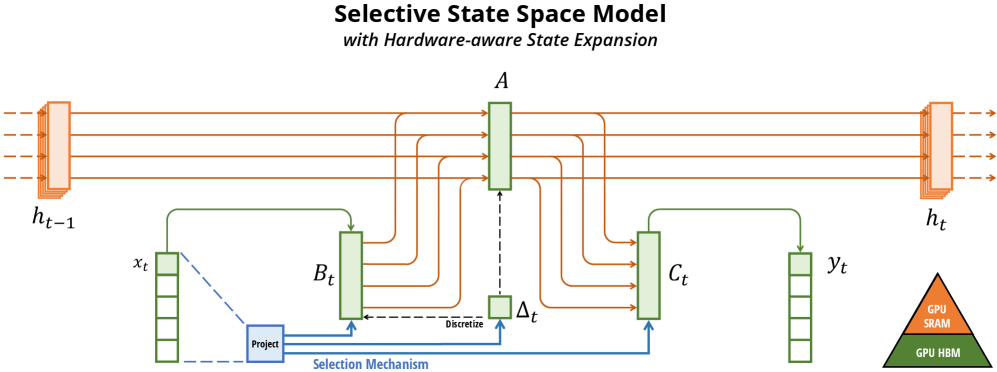


绝不要改写为相对路径,例如
./figures/x1.png— 除非图像也提交到同一仓库,否则相对路径会在 GitHub 上失效。
从抓取的 Markdown 中提取已有的内嵌 URL
Firecrawl 会在抓取的 Markdown 中嵌入绝对图像 URL。提取这些 URL,填入 Frontmatter 目录:
CORPUS_FILE="docs/research/corpus/2026-03-13-mamba-ssm.md"

# Extract all absolute image URLs already in the markdown
grep -oE 'https://[^)]+\.(png|jpg|svg|gif|webp)' "$CORPUS_FILE" | sort -u
这些 URL 已经内嵌 — 只需将其复制到 Frontmatter 的 figure_urls 列表中。
包含大量图像的论文的 Frontmatter
YAML Frontmatter 会列出所有图像源 URL,以记录来源。Markdown 正文则以内嵌形式呈现这些图像:
---
source_url: https://arxiv.org/html/2312.00752v2
scraped_at: "2026-03-13T00:00:00Z"
scraper: firecrawl
tags: [ssm, state-space-model, mamba, sequence-modeling]
content_tokens_approx: 4200
has_figures: true
figure_count: 12
figure_urls:
  - https://arxiv.org/html/2312.00752v2/x1.png
  - https://arxiv.org/html/2312.00752v2/x2.png
  - https://arxiv.org/html/2312.00752v2/x3.png
  - https://arxiv.org/html/2312.00752v2/x4.png
  - https://arxiv.org/html/2312.00752v2/x5.png
---
包含图示的语料索引条目
{
  "url": "https://arxiv.org/html/2312.00752v2",
  "file": "corpus/2026-03-13-mamba-ssm.md",
  "scraped_at": "2026-03-13T00:00:00Z",
  "session": "2026-03-13-mamba-ssm",
  "scraper": "firecrawl",
  "has_figures": true,
  "figure_count": 12,
  "figure_urls": [
    "https://arxiv.org/html/2312.00752v2/x1.png",
    "https://arxiv.org/html/2312.00752v2/x2.png"
  ]
}
Firecrawl 与 Jina Reader:实证比较(arXiv)
在 arXiv:2312.00752v2(Mamba 论文)上验证——两个抓取工具均在运行,使用相同 URL:
| 抓取工具 | 字节数 | 行数 | 单词数 | 图(绝对行内链接) | GitHub 上的数学公式 |
|---|---|---|---|---|---|
Firecrawl /v2/scrape | 99,104 | 1,267 | 13,182 | 13 ✅ | ❌ Unicode 和 LaTeX 重复,无 $...$ |
| Jina Reader | 84,832 | 596 | 10,761 | 12 ✅ | ❌ Unicode 和 LaTeX 重复,无 $...$ |
| 从 LaTeX 源文件使用 Pandoc | — | — | — | 通过 \includegraphics | ✅ $inline$ + ```math ``` 代码块 |
结论:在这篇论文上,Firecrawl 比 Jina 多获取 17% 的字节、2.1× 的行数、22% 的单词,以及 1 张图——与在聊天分享内容上测得的更大差距一致。两者都输出绝对行内图片 URL,因此无需通过任一抓取工具重建 URL。
推荐的 arXiv 工作流:
- Firecrawl
POST /v2/scrape(首选)——内容更完整,图片以内联方式呈现 - Jina Reader(备用,仅适用于静态页面)——内容少 17%,但仍能获取绝对图片 URL
- 无论使用哪种抓取工具,都运行探测循环来构建
figure_urls前置信息目录 - 如需在 GitHub 上以人类可读的方式呈现数学公式:从 arXiv LaTeX 源文件使用 Pandoc(见下文)
数学公式渲染:经实证验证的方法
于 2026 年 3 月在 arXiv:2312.00752v2(Mamba 论文)上验证。
Firecrawl/Jina 数学公式输出:在 GitHub 上无法阅读
Firecrawl 和 Jina Reader 都会以重复内容的方式提取数学公式——每个公式都先以 Unicode 渲染形式出现,紧接着是原始 LaTeX 源码;内容被塞进 Markdown 表格单元格,并带有 \displaystyle 前缀和 \\bm{} 转义。实证测试中的示例:
| | h′(t)\\displaystyle h^{\\prime}(t) | \=𝑨h(t)+𝑩x(t)\\displaystyle=\\bm{A}h(t)+\\bm{B}x(t) | | (1a) |
没有 $...$ 分隔符——GitHub 无法将其渲染为数学公式。大模型可以解析原始 LaTeX 部分(公式确实存在),但这种输出在 GitHub 上对人类来说完全无法阅读。
供大模型使用:Firecrawl 的重复内容足够使用——其中嵌入了 LaTeX 源码,大模型可以将其提取出来。
如需在 GitHub 上以人类可读的方式呈现:从 arXiv LaTeX 源码 tarball 使用 Pandoc(见下文)。
从 arXiv LaTeX 源文件使用 Pandoc(以人类可读的方式呈现数学公式)
会生成规范的 $inline$ 和 ```math ``` 显示块,GitHub 的 MathJax/KaTeX 可原生渲染:
ARXIV_ID="2312.00752"

# Download arXiv LaTeX source tarball
curl -L "https://arxiv.org/src/${ARXIV_ID}" -o "${ARXIV_ID}-src.tar.gz"
mkdir -p "${ARXIV_ID}-src"
tar xzf "${ARXIV_ID}-src.tar.gz" -C "${ARXIV_ID}-src/"

# Find main .tex entry point and section files
ls "${ARXIV_ID}-src/"*.tex
ls "${ARXIV_ID}-src/src/"*.tex 2>/dev/null  # some papers put sections in src/

# Option A: Convert individual section files (safer — avoids macro parse errors)
pandoc "${ARXIV_ID}-src/src/background.tex" \
  --to gfm+tex_math_dollars \
  --wrap=none \
  -o "${ARXIV_ID}-background.md"

# Option B: Convert full main.tex (may fail on custom macros like \iftoggle)
pandoc "${ARXIV_ID}-src/main.tex" \
  --to gfm+tex_math_dollars \
  --wrap=none \
  -o "${ARXIV_ID}-pandoc.md"
安装:brew install pandoc。适用于任何发布了 LaTeX 源码的 arXiv 论文(大多数论文都发布)。
Pandoc 输出质量(经实证验证):
- 行内数学公式:
$x(t) \in \R \mapsto y(t) \in \R$✅ GitHub 可渲染 - 显示数学公式:
```math\n\begin{align}\nh'(t) &= \A h(t) + \B x(t)\n\end{align}\n```✅ GitHub 可渲染 - 自定义宏(
\A、\B、\R、\dt、\dA、\dB):⚠️ 在 KaTeX 中未定义——宏会原样保留;如果缺少前言中的\newcommand定义,在 GitHub 上可能无法完全正常渲染
处理自定义宏:将 main.tex 前言中的 \newcommand 代码块添加到输出前面:
# Extract custom macro definitions from preamble
grep '\\newcommand\|\\renewcommand\|\\def ' "${ARXIV_ID}-src/main.tex" > macros.tex

# Pandoc does not read preamble macros — include them explicitly in a math block at the top:
echo '```math' > preamble-block.md
cat macros.tex >> preamble-block.md
echo '```' >> preamble-block.md

cat preamble-block.md "${ARXIV_ID}-pandoc.md" > "${ARXIV_ID}-with-macros.md"
arXiv LaTeX 中已知的 Pandoc 解析错误:
| 错误触发项 | 原因 | 解决方法 |
|---|---|---|
\iftoggle{arxiv} | 未定义切换宏(etoolbox 宏包) | 转换章节文件,而不是 main.tex |
\begin{figure*} | 双栏图片环境会破坏结构 | 使用 head -N 避免损坏的 \end 标签 |
\bm{}、\mathbf{} | 原样保留——可能无法在 KaTeX 中渲染 | 检查论文的宏文件,查找映射关系 |
反模式
| # | 反模式 | 失败原因 | 正确做法 |
|---|---|---|---|
| 1 | 使用 @mendable/firecrawl-js SDK | jiti 动态导入在 Bun 中会失效 | 直接调用 fetch() |
| 2 | 搜索付费墙网站时未设置 waitFor | JS 单页应用会返回空壳 | 对 IEEE、ACM DL 使用 waitFor: 3000 |
| 3 | 将深度设置为 > 5 | 查询数量呈指数级爆炸,收益递减 | 深度上限设为 5(clampDepth()) |
| 4 | 未为 fetch() 设置超时 | 无法访问的页面会导致请求无限期挂起 | 始终使用 AbortController,超时设为 15 秒 |
| 5 | 未截断过长的页面内容 | 超出大模型上下文窗口 | 对每个页面使用 trimToTokenLimit(text, 25_000) |
| 6 | 遇到部分失败就中止 | 丢失所有已完成的工作 | 记录失败信息,并继续处理剩余查询 |
| 7 | 以存活检查作为运行前提 | 公共 API 没有健康检查端点,也没有会发生宕机的主机 | 按请求处理失败:重试一次,然后回退。参见第 1 节。 |
| 8 | 仅保存综合结果,不保存原始内容 | 丢失源材料,无法重新分析 | 始终将原始 Firecrawl Markdown 持久化到语料库 |
| 9 | 将图表 URL 改写为本地相对路径 | ./figures/x1.png 这样的相对路径在 GitHub 上会失效——图片无法显示 | 在 Markdown 正文中保留绝对 URL();在 frontmatter 的 figure_urls 列表中编目——参见第 6 节 |
参考资料
- API 端点参考 —
/v2/search和/v2/scrape契约 - 学术论文路由 — 论文来源决策树
- 递归研究协议 — 递归模式的分步指南
- 语料库持久化格式 — 原始内容归档格式 + 目录布局
- 演进日志 — 此技能的变更历史(按日期记录)
执行后反思
此技能执行完毕后,关闭前请检查:
- 命令是否成功? — 如果没有,修复导致失败的指令或错误表。
- 参数或输出是否发生变化? — 如果底层工具的接口发生偏移,请更新 Usage 示例和 Parameters 表以保持一致。
- 是否需要变通方案? — 如果你不得不临时调整(更换标志、增加步骤),请更新此 SKILL.md,以便下次调用时无需采用相同的变通方案。
只有问题确实存在且可复现时才进行更新,不要基于猜测更新。