defluff について
defluff は、LLM の文章に含まれる冗長表現、決まり文句、曖昧表現、流行語を検出する決定論的な文章チェッカーです。執筆者やエージェント、CI 向けで、モデルや API キーなしで再現可能なスコアを返し、辞書も調整できます。
主な機能
- 01冗長表現や決まり文句を検出
- 02密度スコアと該当箇所を出力
- 03カスタム辞書とプロジェクト設定に対応
- 04分野別パックとカテゴリ指定
- 05CLI、Python API、CI で利用
- 06文章チェック用 MCP ツールを提供
活用シーン
- 01エージェントの回答前に下書きを確認
- 02CI で冗長な文書の公開を阻止
- 03削除候補の具体的な表現を編集者に提示
- 04下書き間の冗長表現の密度を比較
MCP 対応
MCP サーバーは slop_detect、slop_add、slop_ignore ツールを提供し、MCP エージェントによる文章の検査と、ユーザーまたはプロジェクト単位の辞書調整を可能にします。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
defluff
AI が生成した文章の定型的な冗長表現を、決定論的に検出します。変更履歴、ドキュメント、エージェント自身の出力を指定すると、削除すべき埋め草のフレーズと、CI の終了コード、固定可能なスコアが返されます。実行するたびに同じ結果になります。モデルも API キーも不要です。


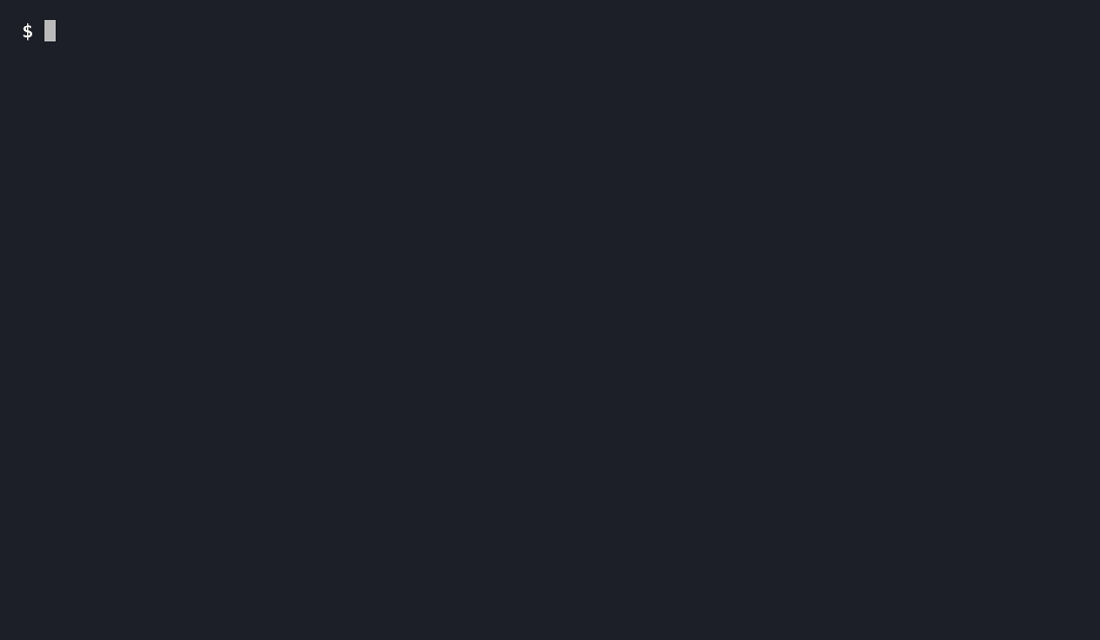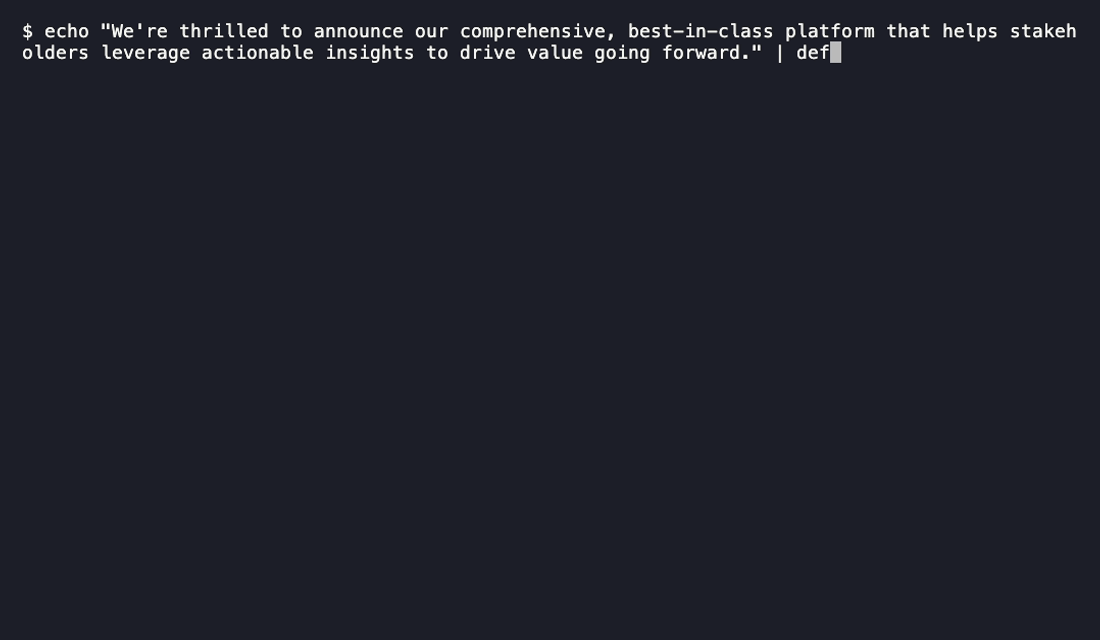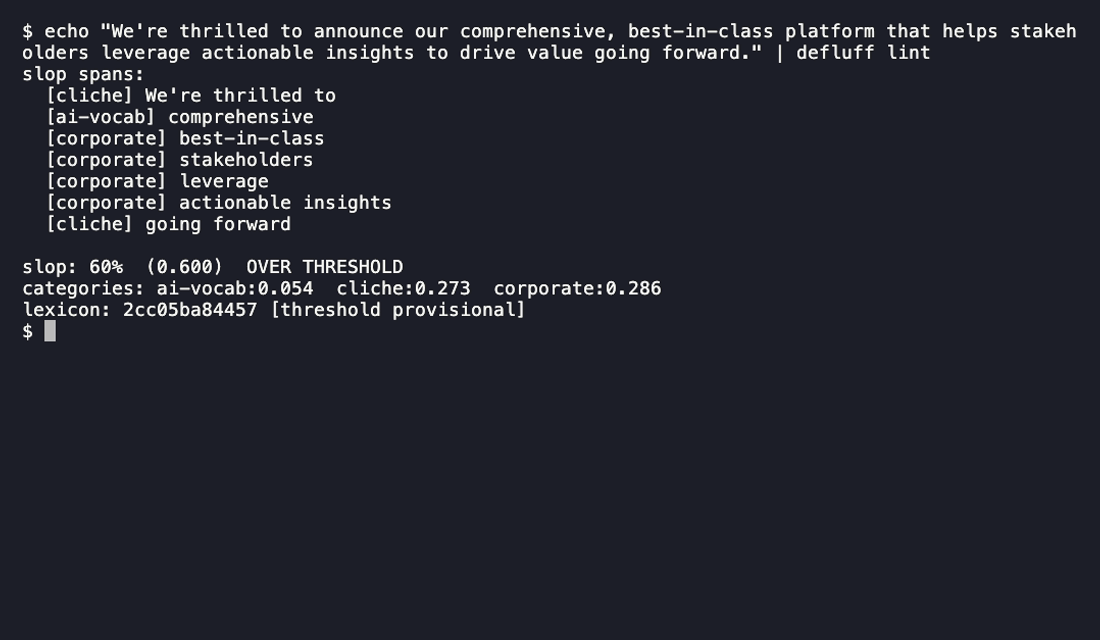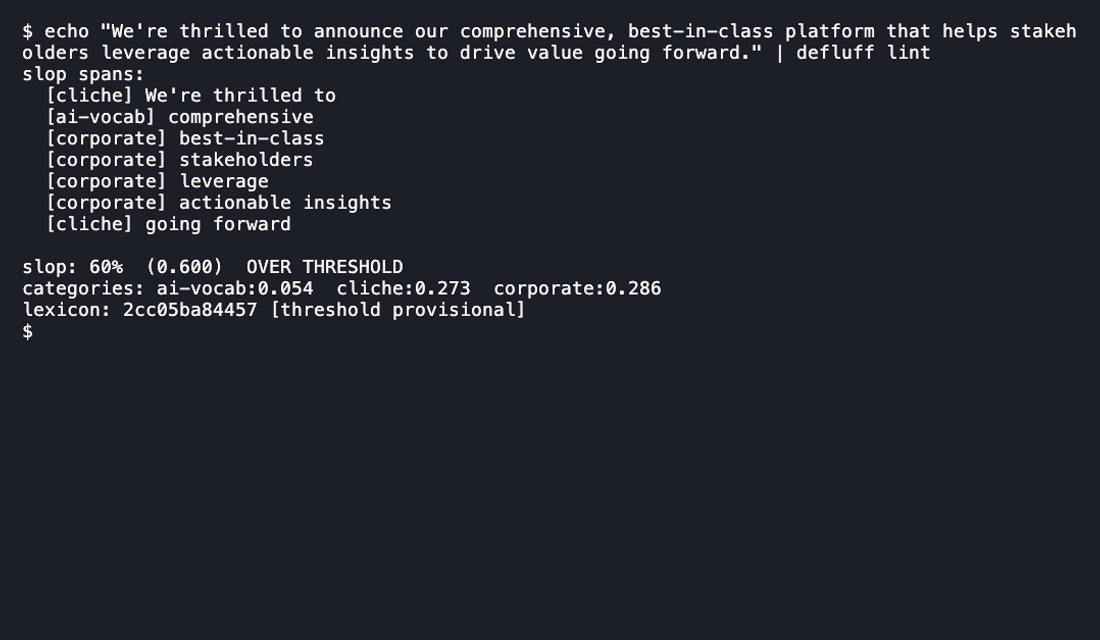
検出された箇所には情報が含まれていないため、削除しても何も失われません。すっきりした文章なら、同じツールに通すだけでそのままパスします。
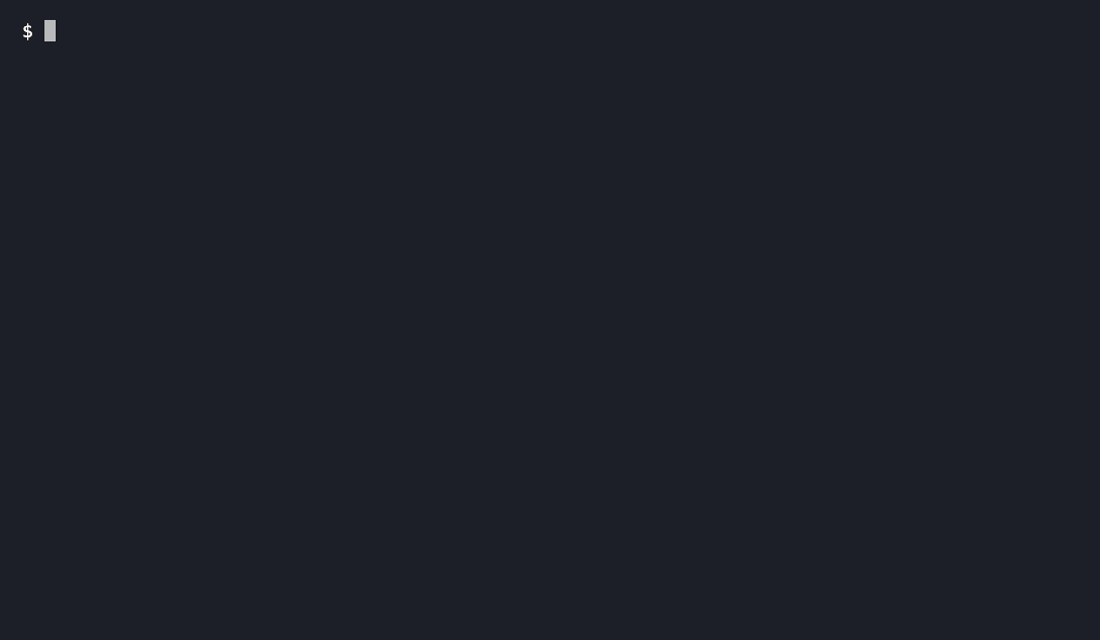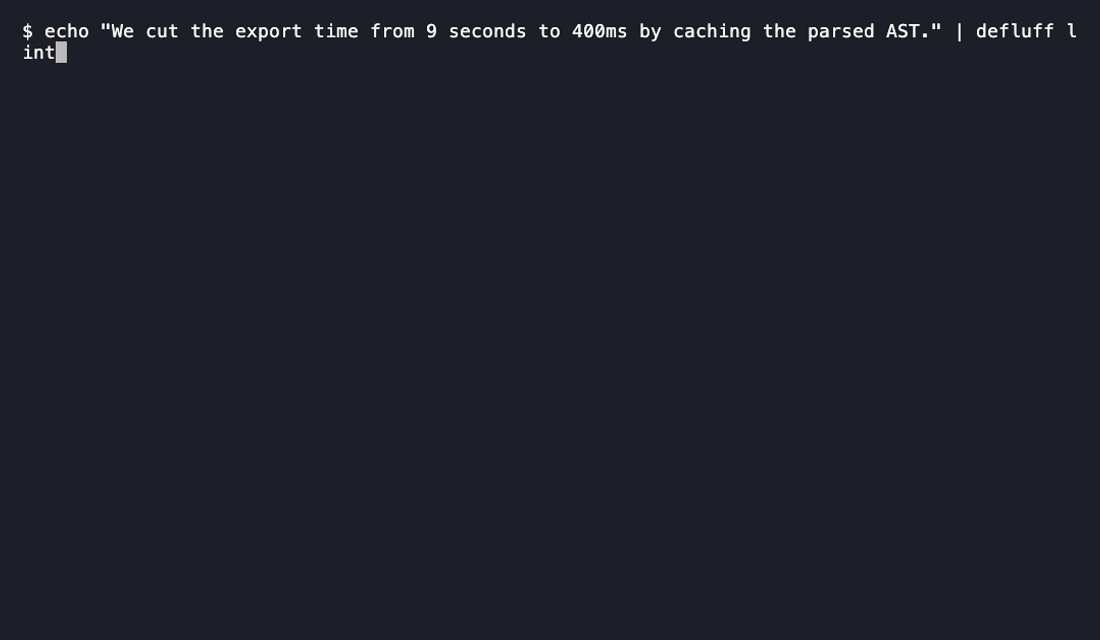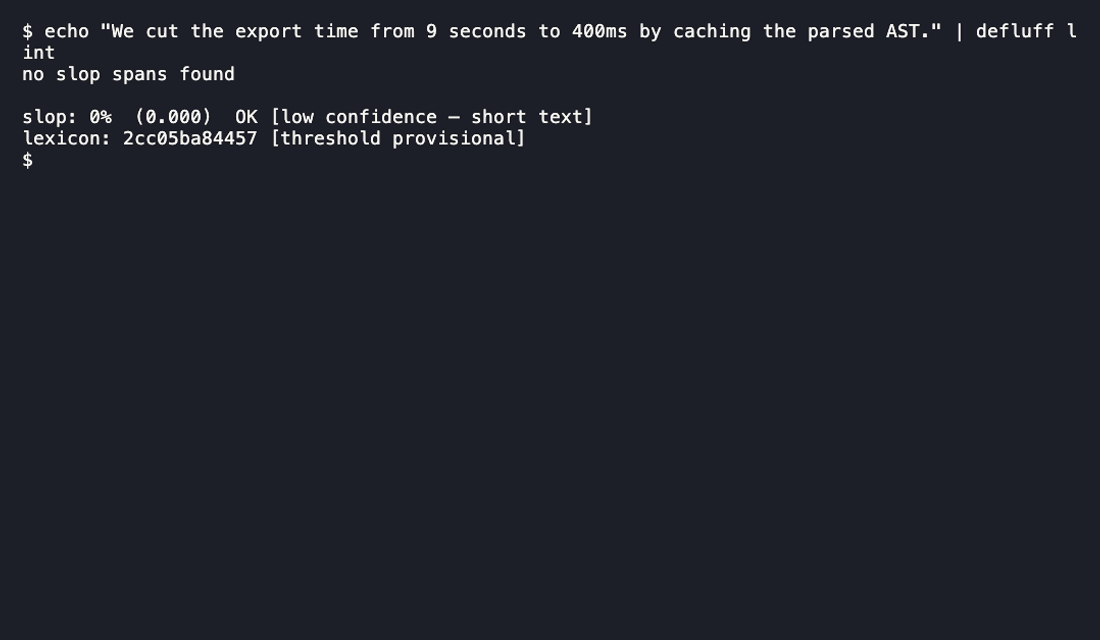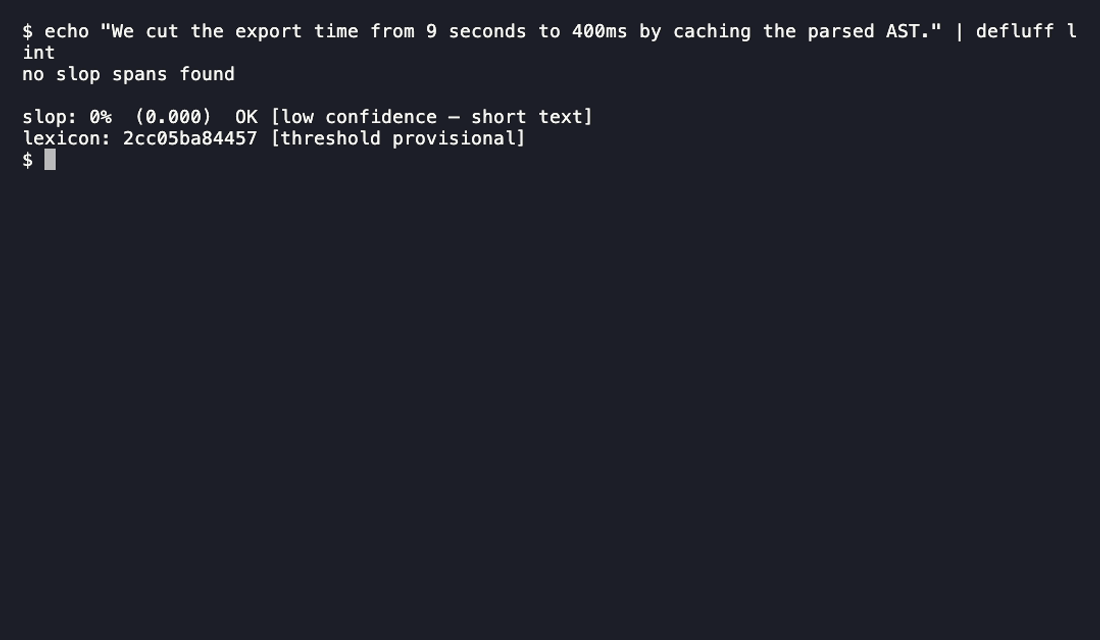
単発の grep より defluff をインストールする価値があるのは、リストを支えるエンジンです。独自のフレーズやプロジェクトごとのオーバーレイを追加でき、エージェントが設定なしで使える MCP サーバーも備えています。
インストール
pip install defluff
または、macOS/Linux では Homebrew を使用します。
brew install ahmedak/defluff/defluff
これで完了です。モデルのダウンロードも API キーも不要です。Python が動作する環境ならどこでも実行できます。
クイックスタート
# Lint a file — exit 1 on slop, 0 when clean
defluff lint essay.md

# Pipe text
cat draft.md | defluff lint

# Get a bare score for scripts (0.0 – 1.0)
defluff score essay.md

# Machine-readable JSON for downstream tooling
defluff lint essay.md --json
MCP サーバー
3 つのツールを公開するため、MCP 対応エージェントは、特別な設定をせずに文章を自己チェックできます。返す前の自身の下書きも対象です。
uvx を使えばインストール不要で実行できます(推奨)。初回実行時にパッケージと mcp エクストラを取得します。
{
  "mcpServers": {
    "defluff": {
      "command": "uvx",
      "args": ["--from", "defluff[mcp]", "defluff-mcp"]
    }
  }
}
または、インストールしてエントリーポイントを直接実行します。
pip install "defluff[mcp]"
defluff-mcp
{
  "mcpServers": {
    "defluff": { "command": "defluff-mcp" }
  }
}
io.github.ahmedak/defluff として MCP Registry に公開されています(server.json を参照)。
mcp-name: io.github.ahmedak/defluff
| ツール | 引数 | 戻り値 |
|---|---|---|
slop_detect | text: str | slop_score、spans(テキスト、カテゴリ、重み、オフセット)、categories、lexicon_version |
slop_add | pattern: str, category: str, scope: "user"|"project" | レキシコンのオーバーレイにフレーズを追加します |
slop_ignore | pattern: str, scope: "user"|"project" | フレーズ(例:専門分野の用語)を検出対象から除外します |
よくある使用例
- エージェントによる自己修正 — 下書きに対して
slop_detectを呼び出し、返す前に検出されたフレーズを修正します。設定不要で、1 つのセッション内で完結し、処理に別のモデルを加える必要もありません。 - 生成コンテンツに対する CI ゲート — AI が作成した変更履歴やドキュメントに「さらに」や「堅牢」といった表現が満載の場合、ビルドを失敗させます。決定論的な動作、終了コード、固定可能なレキシコンがそろっている点は、LLM による判定ゲートでは実現できません。
- ライティングアシスタントによるフィードバック — 「AI っぽい」という曖昧な指摘の代わりに、編集者が削除するであろうフレーズを正確に強調表示します。
- ファインチューニングの報酬 コンポーネント — 注意点については報酬ループを参照してください。単独では不正に利用される可能性があります。
なぜ defluff なのか?
あらゆる「AI 検出ツール」は、文章が AI によって生成されたかどうかを判定しようとします。これは難しく、信頼性に欠ける問題です。defluff は別の問いを投げかけます。この文章には取り除ける冗長表現が含まれているか? これは決定的に判定でき、「結局のところ」のような表現を人間が書いたか LLM が書いたかに関係なく当てはまります。
最も近い既存ツールは proselint です。モデルを使わず、決定的に判定しますが、調整可能な密度スコアではなく、はい/いいえの警告を出力します。また、入れ替えたり、重ねたり、固定したりできるリストを中心に設計されていません。
単語リストに対して grep を使えば、単純な一致結果が得られます。defluff は、そのリストを使って別途構築する必要がある機能を提供します。
- MCP サーバー — エージェントは設定作業なしで自己チェックできます。
- Markdown とコードを認識 — まずコードフェンス、インラインコード、URL を除外します。
- 単語全体で照合 —
"foster"は"fostering"内では検出されません。 - 検出件数ではなく正規化スコア — 冗長表現の 密度 なので、ツイートにも 5,000 語の文書にも同じしきい値を使えます。
- 重複の処理 —
"at the end of the day"と重複する"end of the day"は、各単語を一度だけ数えます(最長一致を優先)。 - 終了コード、JSON、文字オフセットの範囲 — CI、pre-commit、エディターツールに組み込めます。
- 固定可能なレキシコンハッシュ — 実行間で判定基準が変わっていないことを証明できます。
独自の冗長表現を追加
defluff lint draft.md --lexicon team-slop.md
# team-slop.md
- circle back
- low-hanging fruit
- boil the ocean
paradigm shift
1 行につき 1 つのフレーズを指定します(# コメントと -/* マーカーは無視されます)。これらは組み込みのデフォルト設定に重ねて適用され、中立的な custom カテゴリーとして報告されます。実際のカテゴリーやフレーズごとの重みを指定するには、.json リストを使用してください(レキシコンのオーバーレイを参照)。
すぐに使えるドメインパック
defluff lint post.md --pack marketing-growth
defluff lint post.md --pack marketing-growth,ai-llm   # stack several
| パック | 検出対象 | パック | 検出対象 |
|---|---|---|---|
corporate-linkedin | オフィス用語 | crypto-web3 | 暗号資産の誇大表現 |
startup-vc | ピッチ資料の言い回し | pr-press-release | プレスリリースの定型文 |
marketing-growth | 誇大な宣伝文句 | academic | 研究上の婉曲表現 |
ai-llm | LLM 特有の表現 | wellness-selfhelp | インフルエンサー風の言い回し |
social-media | X/Twitter のエンゲージメント狙い |
defluff packs で一覧表示できます。誤検出率の高い用語(例:pivot、detox)はコメントアウトされた状態で含まれており、明示的に有効にするまで動作しません。パックの READMEを参照してください。
すぐに使えるデフォルト設定
5 つの重み付きカテゴリーにわたる、約 130 個の厳選パターンを収録しています。大文字と小文字を区別せず、単語全体で照合します。
| カテゴリー | 検出対象 | 例 |
|---|---|---|
ai-vocab | LLM が不釣り合いに多用する単語 | delve, tapestry, nuanced, pivotal, robust, showcase |
cliche | 情報を加えない空虚な慣用句 | at the end of the day, move the needle, circle back, game changer |
hedge | 空疎な限定表現 | it should be noted that, needless to say, basically, essentially |
corporate | バズワードの多用 | leverage, synergy, actionable insights, cutting-edge, scalable |
transition | LLM が既定で使いがちな冗長なつなぎ表現 | furthermore, moreover, in conclusion, first and foremost |
レトリックのパターン(リスト以外)
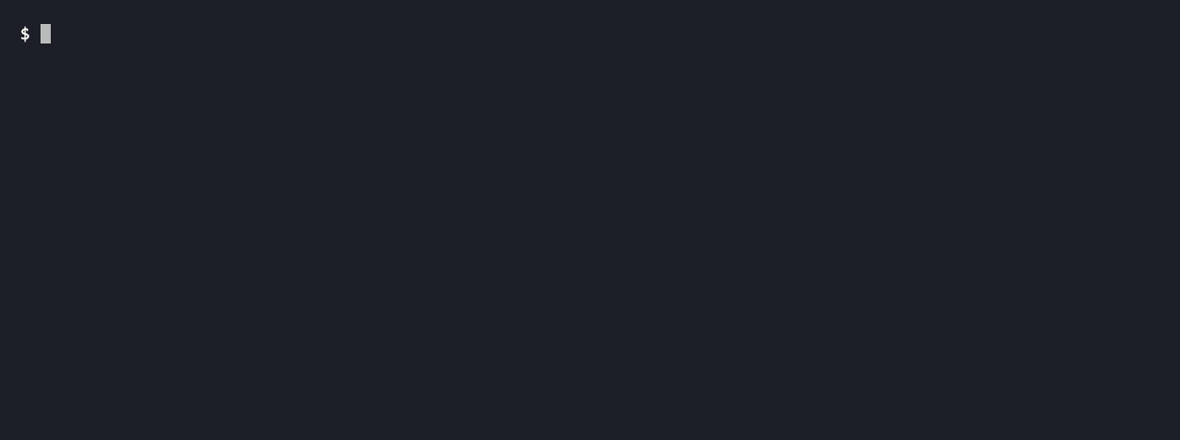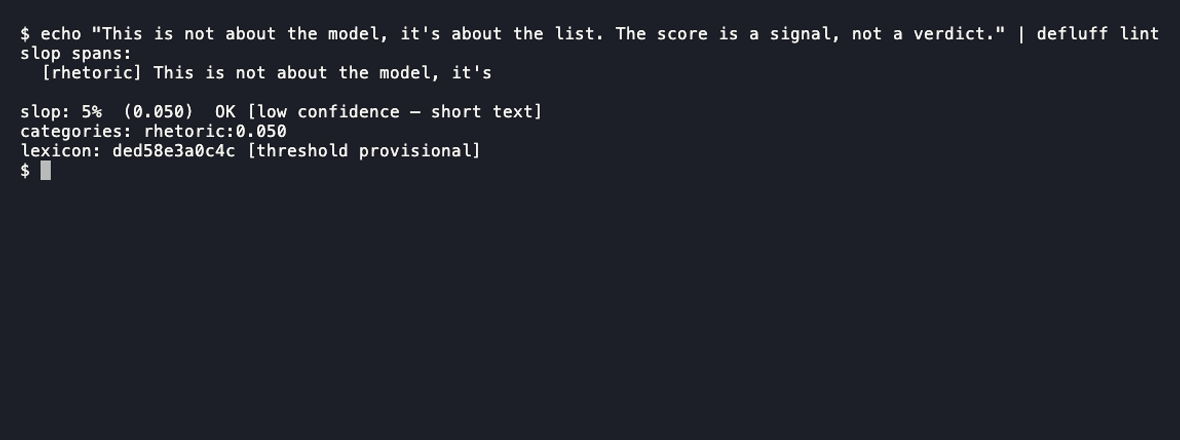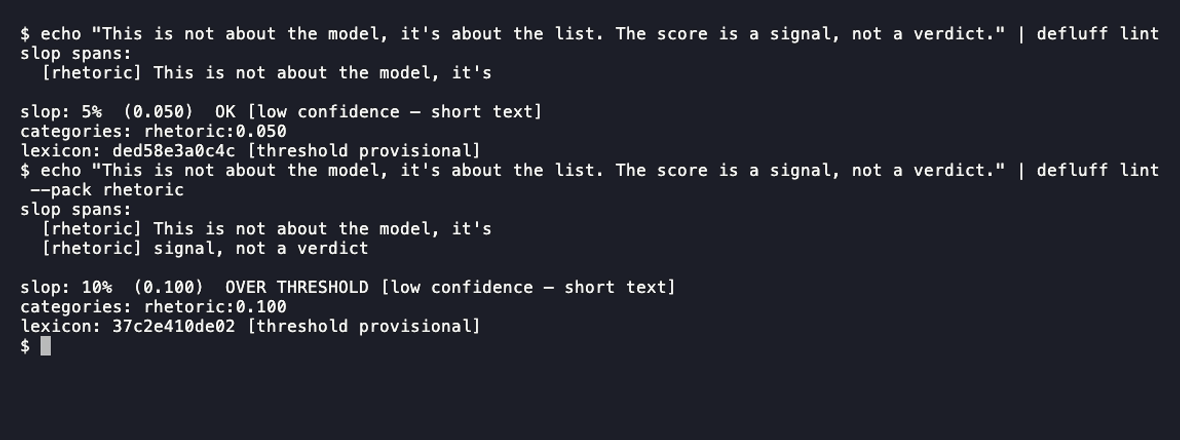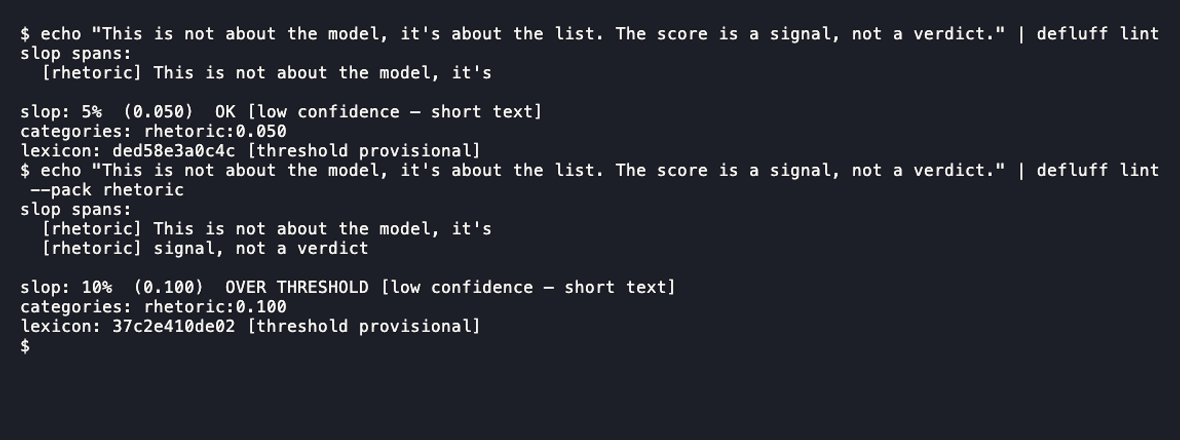
AI 特有の兆候には、決まったフレーズではなく、文の形で現れるものもあります。たとえば、対句の it's not X, it's Y や not just a list but a runtime です。正規表現パターンのレイヤーでは、これらを rhetoric カテゴリで検出します。
| モード | 検出対象 | デフォルト | 理由 |
|---|---|---|---|
| 複合 (確実) | 完全な形:it's not X, it's Y・not just X but Y | オン | 2つ目の節がレトリック上の動きを裏付けるため、誤検出はほとんどありません |
| 断片 (推測) | 単独の X, not Y — 例:a signal, not a verdict | オフ、--pack rhetoric | 単純な訂正(shipped Tuesday, not Wednesday)にも反応します |
各マッチは、長さにかかわらずスコアに1単位として加算されます。断片モードを有効にすると、レキシコンのハッシュが変わります。
defluff lint draft.md                  # compound antithesis caught by default
defluff lint draft.md --pack rhetoric  # also catch the punchy "X, not Y" fragment
defluff lint draft.md --category rhetoric   # gate CI on antithesis alone
Python API
import defluff

report = defluff.detect("It is worth noting that we should leverage synergies.")
print(report.slop_score)   # 0.0 – 1.0
print(report.spans)        # flagged phrase locations + categories

score = defluff.score(text)       # bare float
clean = defluff.is_slop(text)     # bool at default threshold

lex = defluff.load_lexicon()                # pin for reproducible runs
score = defluff.score(text, lexicon=lex)
SlopReport のフィールド:
| フィールド | 型 | 備考 |
|---|---|---|
slop_score | float | [0, 1] に制限されます — しきい値に使用します |
slop_density | float | 制限前の生の値 — 報酬ループでは、より滑らかな勾配が得られます |
spans | list[Span] | 検出ごとに、text、カテゴリ、重み、クリーニング済みテキスト内の文字オフセットを格納します(制限事項を参照) |
categories | dict[str, float] | カテゴリ別の密度 |
n_words | int | トークン数 |
low_confidence | bool | n_words < 20 の場合に True |
lexicon_version | str | 解決済みエントリーセットの SHA プレフィックス |
レキシコンのオーバーレイとバージョン管理
同梱のレキシコンがベースラインです。パッケージを編集せずに、その上にレイヤーを追加できます。
# "synergy" is slop on this machine
defluff lexicon add "synergy" --category corporate --scope user

# "leverage" is fine in this repo (finance context) — commit this with the repo
defluff lexicon rm "leverage" --scope project
git add .defluff/ignore.json && git commit -m "allow 'leverage' in finance context"
- ユーザーオーバーレイ(
~/.config/defluff/)— マシン全体に適用され、コミットされません - プロジェクトオーバーレイ(Git ルートの
.defluff/)— リポジトリ単位で適用され、チーム全体で使う場合はコミットします
書き込みはアトミックで、プロセス間ロックがかかります。オーバーレイが破損している場合は警告してスキップされ、detect() がクラッシュすることはありません。
解決済みの各レキシコン(同梱分 + オーバーレイ + パック)には短いコンテンツハッシュが付き、実行のたびに表示されます(lexicon: 2cc05ba84457)。また、SlopReport.lexicon_version から取得できます。lexicon=defluff.load_lexicon() を一度渡せば、すべての呼び出しで同じ基準に照らしてスコアを計算できます。CI のベースラインや RL 報酬のために固定でき、ハッシュは解決済みのエントリーセットが変わった場合にのみ変わるため、監査も可能です。各リリースには、日付付きのレキシコンと変更履歴(CHANGELOG.md)が含まれます。ai-vocab はリリースごとに入れ替わることが想定されていますが、cliche/hedge/corporate/transition はほぼ安定しています。
出力の読み方としきい値の設定
- スパン — カテゴリ付きで表示される、具体的な埋め草フレーズです。決定論的で信頼性があります。これを基に対処してください。
- スコア —
slop_score= フラグが付いた単語 ÷ 総単語数。カテゴリごとに重み付けされます(ai-vocabはやや大きく、transitionはやや小さくカウントされます)。0.20は「このテキストの5分の1が、リストに載った埋め草」という目安です。通常は0.0–1.0ですが、ほぼすべてが埋め草のテキストでは、わずかに1を超えることがあります。これは品質を定量化するものではなく、CI の終了コードを制御するトリップワイヤーです。
テキストにどの程度の埋め草が許容されるかに応じて、しきい値を選んでください。
--threshold | 意味 | 適した用途 |
|---|---|---|
0.05 | 埋め草約5% — 厳格 | マーケティングコピー、ランディングページ、顧客向けテキスト |
0.08 (デフォルト) | 埋め草約8% — トリアージ用のトリップワイヤー | 一般的な文章、ブログの下書き |
0.12–0.20 | 大量の水増しのみを検出 | robust、scalable、in order to を正当に使う技術文書 |
デフォルトの 0.08 は暫定値です。手動で選んだものであり、ラベル付きコーパスでの調整はまだ済んでいません(そのため [threshold provisional] タグが付いています)。CI で厳格なゲートとして使う場合は、独自のしきい値を設定し、まずドメイン固有の語彙を抑制してください(以下を参照)。
CI での使用
技術文書(API ドキュメント、ADR、RFC)では、
robust、scalable、in order toのような語が正当に使われます。まず、プロジェクト固有の用語を抑制します。defluff lexicon rm "scalable" --scope project defluff lexicon rm "in order to" --scope project git add .defluff/ignore.json && git commit -m "defluff: allow domain vocabulary"5 つすべてではなく、信頼できるカテゴリだけを対象にチェックします。
- name: Check AI-generated content for slop
  # --category ai-vocab,hedge gates only on the highest-precision categories
  run: cat generated_output.md | defluff lint --category ai-vocab,hedge --threshold 0.1
終了コード 1 はステップを失敗させ、0 は成功させます。
pre-commit での使用
# .pre-commit-config.yaml
repos:
  - repo: local
    hooks:
      - id: defluff
        name: defluff slop check
        entry: defluff lint
        language: system
        types: [markdown]
報酬ループでの使用(実験的)
フィラーの密度を示す決定論的で微分不可能なスカラー値は、報酬の組み合わせの小さな 構成要素 になり得ます。ただし、単独では攻略される可能性があります。固定されたフレーズリストだけを基準に最適化されたモデルは、フィラーを取り除くのではなく、言い換えることを学習します。実際の品質シグナル(人間または LLM による判定)と組み合わせてください。有効性を示す公開済みのトレーニング実行結果は、まだありません。
lex = defluff.load_lexicon()  # pin once
reward = lambda text: -defluff.detect(text, lexicon=lex).slop_density  # unclamped, better gradient

delta = defluff.compare(draft_v1, draft_v2, lexicon=lex)
# {"score_a": 0.31, "score_b": 0.18, "delta": -0.13,
#  "improved": [...], "regressed": [...]}  # set diff of flagged phrases, not a semantic diff
CLI リファレンス
defluff lint [FILE] [--json] [--threshold FLOAT] [--category CATS] [--lexicon PATH] [--pack NAMES] [--no-project-overlay]
defluff score [FILE] [--pack NAMES] [--no-project-overlay]
defluff packs          # list bundled domain packs

defluff lexicon list   [--category CATEGORY] [--scope SCOPE] [--json]
defluff lexicon add    PATTERN --category CATEGORY [--scope SCOPE] [--weight FLOAT]
defluff lexicon rm     PATTERN [--scope SCOPE]
--category— カンマ区切りで指定します。終了コードの判定にカウントされるのは、指定したカテゴリの範囲だけです(すべてのヒットは引き続き報告されます)。有効な値:ai-vocab、cliche、hedge、corporate、transition、custom、rhetoric。--lexicon PATH— デフォルトに独自のフレーズを追加します。.txt/.mdでは 1 行につき 1 フレーズを指定し、customに登録されます。.jsonではカテゴリと重みを明示的に指定できます。--pack NAMES— カンマ区切りで既製のドメインパックを指定します。rhetoricはパターンパック用に予約されており、オプトインでX, not Yの対句パターンを有効にできます。
defluff lint の終了コード:0 = 問題なし · 1 = 冗長な表現あり · 2 = 入力不正。
精度
defluff は学習済み分類器ではなく決定論的な照合ツールであるため、重要な指標は適合率です。フラグが付いた表現は、本当に削除可能なフィラーでしょうか。明らかな冗長表現、簡潔な文章、そして 専門用語が内容として使われているケース(例:「the robust standard errors」、「pivotal trials」)を含む、手作業でラベル付けした 50 件のサンプル(eval/validation.jsonl)で、デフォルトのしきい値を使った場合:
| 指標 | スコア | 見方 |
|---|---|---|
| 適合率 | 1.00 | 偽陽性は 0 件 — 簡潔な文章や正当な専門用語にはフラグが付かなかった |
| 再現率 | 0.65 | 辞書の網羅率による制限 |
再現方法:python eval/score.py eval/validation.jsonl
見逃されるのは、辞書がまだ把握していない新しい流行語(例:「operationalize the ideation funnel」)です。これはリストベースの照合ツールに固有の既知の限界であり、ノイズではありません。リストにあるフィラーに対する再現率は 1.00 で、辞書の拡充に伴って向上します。ただし、意味解析レイヤーがなければ、未知の専門用語を含む開かれた語彙に対して 1.00 には到達しません。
注意点:サンプル数は少なく、作者がラベル付けしたものです。これは適合率の妥当性を確認するものであり、独立した評価者によるベンチマークではありません。
制限事項
- 既知のリストとの照合を目的としており、テキストを 理解 するわけではありません。 新しい流行語は見逃されます。これは決定論的で、ローカルに実行でき、再現可能であること(モデル不要、API キー不要、ハッシュを固定可能)と引き換えです。新しいフィラーを意味的に検出する必要がある場合は、LLM による判定と組み合わせてください。
- 専門用語の適切さは文脈によって異なります。 金融文書における
"leverage"は、実質的な内容です。フラグが付いた範囲を確認し、defluff lexicon rmで偽陽性を抑制してください(バンドルされた辞書から削除するのではなく、無視リストに追加します)。 - 範囲のオフセットは、クリーニング後のテキストに対するものです。 defluff は照合前にコードフェンス、インラインコード、URL、Markdown のマークアップを取り除くため、オフセットは元の文書と一致しません。マークアップ付きのソースと照合する場合は、生のオフセットではなく
span.textを使ってください。 customはファイル経由でのみ読み取り可能です。--lexiconファイルのフレーズはcustomに登録されますが、defluff lexicon add --category customは拒否されます。addが受け付けるのは、厳選された 5 つのカテゴリだけです。- v0 では英語のみです。
- 短いテキスト(20 語未満)には
low_confidence: trueが設定されます。分母は最低でも 20 となるため、2 文の入力に含まれる 1 つのフレーズだけで、冗長度が 100% と判定されることはありません。
貢献
最も簡単な貢献は、見落とされているフィラー表現を追加することです。
- 適切なカテゴリを指定して
src/defluff/data/lexicon-v1.jsonに追加します pytest— スモークテストで境界の誤りを検出します- 実際に使われている例を1つか2つ添えて、PRを送ります
コードのセットアップとガイドラインについては、CONTRIBUTING.md をご覧ください。
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。