
Code Context Engine について
Code Context Engine(CCE)は、コードベースをローカルにインデックス化し、AI コーディングツールがファイルを繰り返し読み込む代わりに関連コードを検索できるようにします。Claude Code などのトークン使用量を減らしたい開発者や、セッションをまたいで判断を保持したいチーム向けです。
主な機能
- 01tree-sitter によるセマンティックなコード分割
- 02ベクトル検索と BM25 のハイブリッド検索
- 03セッションをまたぐ決定事項の記録と呼び出し
- 04クラウドにインデックスを送らないローカル保存
- 05トークン削減量の推定金額表示
活用シーン
- 01Claude Code の入力トークンの削減
- 02複数のエディターで単一のインデックスを共有
- 03後続セッションでのアーキテクチャ判断の呼び出し
MCP 対応
CCE は MCP サーバーで、context_search、session_recall、record_decision など 11 個のツールを MCP クライアントに公開します。cce init コマンドは複数のエディター向けに MCP 設定を書き込みます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Code Context Engine
コードベースをインデックス化。AI がファイルを読み直す代わりに検索します。
トークンを94%削減。再現可能なベンチマークで検証済み。
ウェブサイト · ドキュメント · CCE を選ぶ理由 · ベンチマーク · GitHub




Python 3.11+ · macOS · Linux · Windows





コマンドは1つ。エディターを自動検出。クラウドも設定も不要。
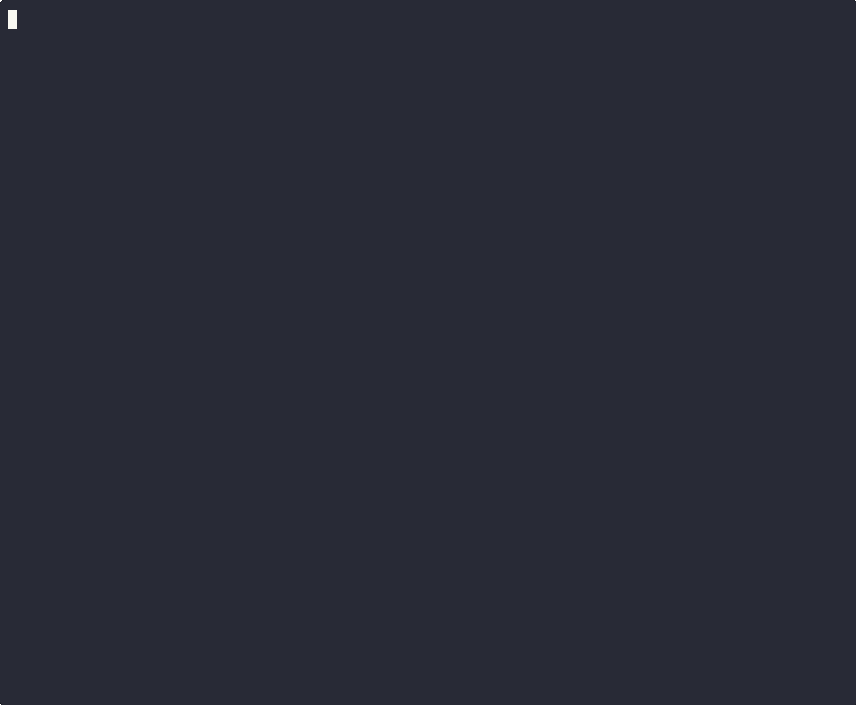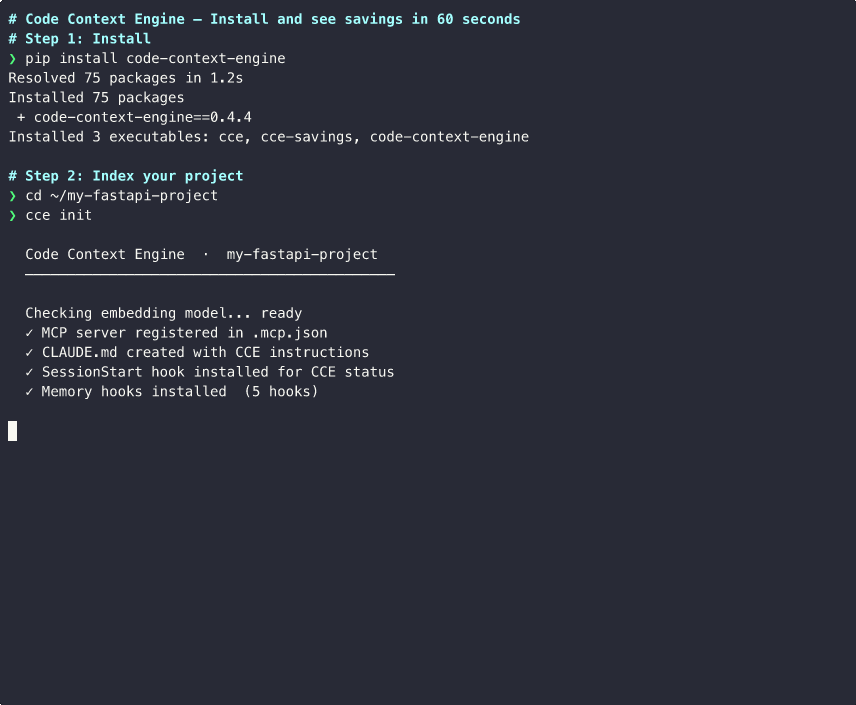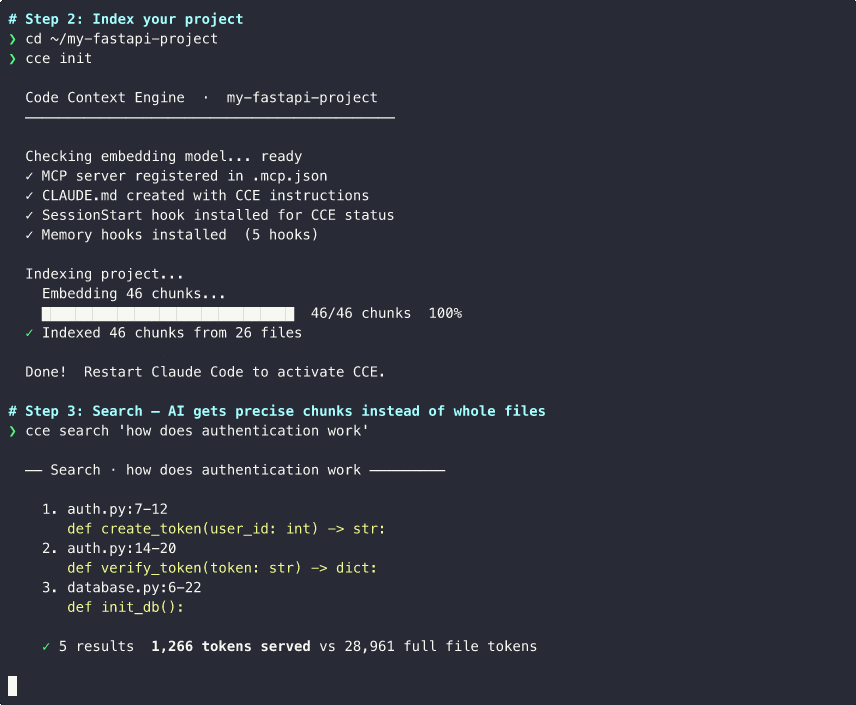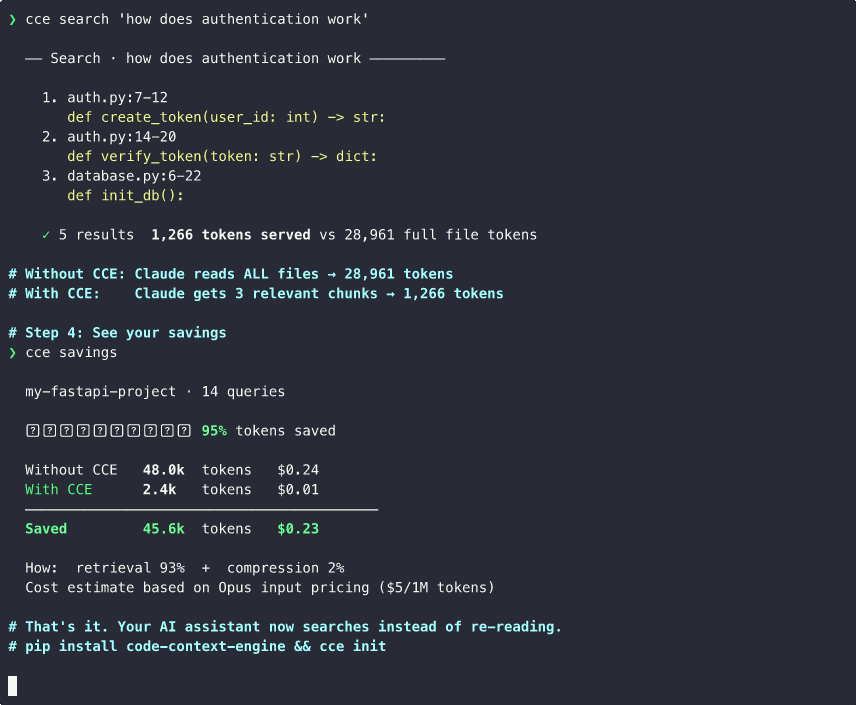
講演: AI コーディングのトークンを 94% 削減 — AI Engineer World's Fair 2026
ユースケース
| ユースケース | CCE による支援 | |
|---|---|---|
| 💰 | Claude Code のコストを削減 | セッションあたりの入力トークンを 94% 削減 |
| 🔒 | コードのプライバシーを維持 | すべてローカルで処理し、クラウドでのインデックス作成はありません |
| 🔄 | 複数エディターを使うチーム | Claude Code、Cursor、VS Code、Gemini CLI でインデックスを共有 |
| 🧠 | セッションをまたいだメモリ | 判断やコンテキストを再起動後も維持 |
| ⚡ | 応答を高速化 | コンテキストが少ないほど Claude の応答が速くなります |
| 📊 | 実際の節約額を追跡 | 推定値ではなく金額を表示 |
クイックスタート
1 つのコマンドで、30 秒で完了します。
uvx --from "code-context-engine[local]" cce init # install + index + configure, one shot
または、永続的にインストールする場合:
uv tool install "code-context-engine[local]"    # or: pipx install "code-context-engine[local]"
cd /path/to/your/project
cce init
エディターを再起動すれば完了です。以後、質問のたびにファイルを読み直す代わりに、インデックスが使われます。
Agent Plugin のサポート:
cce init --pluginを実行すると、VS Code、Cursor、Copilot、Codex、ChatGPT、Kiro で使えるポータブルな Agent Plugin ディレクトリが生成されます。このプラグインはuvxを使って必要に応じて CCE を起動するため、Python パッケージを事前にインストールする必要はありません。詳しくは、以下の Agent Plugin をご覧ください。
すでに Ollama をお使いですか?
[local]を省略し、代わりにuv tool install code-context-engineを使ってください。CCE は localhost:11434 の Ollama を自動検出し、nomic-embed-textを使用します。
システム要件
Python 3.11 以降と、C コンパイラー(tree-sitter 文法用)が必要です。
| プラットフォーム | セットアップ |
|---|---|
| macOS | xcode-select --install |
| Ubuntu/Debian | sudo apt install build-essential cmake |
| Fedora/RHEL | sudo dnf install gcc gcc-c++ cmake |
| Windows | Visual Studio Build Tools(C++ ワークロード)+ CMake |
macOS、Linux、Windows と Python 3.11/3.12/3.13 で動作確認済みです。
cce init はエディターを自動検出し、適切な設定を書き込みます。特定のエージェントを指定するには、
--agent claude、--agent codex、--agent copilot、--agent pi、または
--agent all を使用します。
| エディター | 書き込まれる設定 | 指示ファイル |
|---|---|---|
| Claude Code | .mcp.json | CLAUDE.md |
| VS Code / Copilot | .vscode/mcp.json | .github/copilot-instructions.md |
| Cursor | .cursor/mcp.json | .cursorrules |
| Gemini CLI | .gemini/settings.json | GEMINI.md |
| OpenAI Codex | ~/.codex/config.toml(ユーザー全体の設定、プロジェクトごとのセクション) | AGENTS.md |
| OpenCode | opencode.json | |
| Tabnine | .tabnine/agent/settings.json | TABNINE.md |
| Pi | .mcp.json | AGENTS.md |
同じプロジェクトで複数のエディターを使っていますか?1 つのコマンドですべて設定できます。
Codex に関する注意: Codex CLI は ~/.codex/config.toml からのみ MCP サーバーを読み込みます。
プロジェクトごとの設定には対応していません。cce init はプロジェクトごとに
[mcp_servers.cce-<project>-<hash>] セクションを 1 つ追加するため、複数のプロジェクトを共存させられます。cce uninstall は
現在のプロジェクトのセクションのみを削除します。
Pi に関する注意: Pi は MCP をネイティブではサポートしていません。Pi で CCE を使うには、
.mcp.json 設定を読み込み、CCE のツールを Pi エージェントに公開する pi MCP アダプター拡張機能(例:
pi-mcp-adapter)が必要です。
cce init は .mcp.json と AGENTS.md の両方を設定します(Pi は起動時の指示ファイルとして後者を自動的に読み込みます)。
  my-project · 38 queries · last query 5m ago

  ⛁ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶  88% tokens saved

  Input savings   1.9M  tokens   $27.78
  Output savings  4.8k  tokens   $0.36
  ──────────────────────────────────────────
  Total saved   1.9M  tokens   $28.15

  Breakdown:
    retrieval              84%  ▰▰▰▰▰▰▰▰▰▰    1.8M   $26.76 · 12 calls
    chunk compression       3%  ▰▱▱▱▱▱▱▱▱▱   68.5k    $1.03 · 12 calls
    output compression*    <1%  ▰▱▱▱▱▱▱▱▱▱    4.8k    $0.36 · 12 calls

  Cost estimate based on Opus pricing (input $15.0/1M, output $75.0/1M)
Anthropic、OpenAI、Google のモデル料金に対応しています。~/.cce/config.yaml の pricing.model で設定します。
これが重要な理由
入力トークンは、Claude Code の料金の85〜95%を占めます。CCE は入力トークンを94%削減します(FastAPIでのベンチマーク)。
Without CCE:    Claude reads payments.py + shipping.py   = 45,000 tokens
With CCE:       context_search "payment flow"            =    800 tokens
| CCE なし | CCE あり | |
|---|---|---|
| セッション開始時 | 毎回ファイルを読み直す | インデックスを検索する |
| 関数の検索 | 800行のファイル全体を読む | 40行の関数を取得する |
| セッション間のメモリ | なし | 決定事項とコード領域を保存 |
| トークンコスト(Sonnet、中規模プロジェクト) | 約0.14ドル/セッション | 約0.04ドル/セッション |
ベンチマーク:FastAPI(再現可能)
FastAPI(ソースファイル53個、180Kトークン)を対象に、実際のコーディングに関する質問20件を使ってCCEのベンチマークを実施しました。都合のよい結果だけを選んだり、合成クエリを使用したりしていません。
方法: 各クエリについて、「CCEなし」は、そのクエリで扱うすべてのファイルの全内容を読むことを意味します。「CCEあり」は、圧縮後の関連チャンクを意味します。
ベースラインに関する重要な注意点: 94%という数値は、ファイル全体を読む場合と比較した測定値であり、Claude Code の実際の動作と比較したものではありません。実際には、Claude Code はすでに grep、ファイルの一部読み取り、対象を絞ったツールを使用しているため、通常の Claude Code の動作と比較した現実の削減率は94%を下回ります。ファイル全体の読み取りをベースラインとするのは、再現可能かつ決定的であるためです(エージェントの動作のばらつきがありません)。このベンチマークは、Claude Code に組み込まれた探索機能との直接比較ではなく、CCE の検索効率を測定しています。
| 指標 | 結果 |
|---|---|
| 検索による削減 | 94%(83,681 → 1クエリあたり4,927トークン) |
| 圧縮(取得したチャンクに対する追加分) | 89%(4,927 → 1クエリあたり523トークン) |
| Recall@10(適切なファイルを発見) | 0.90 |
| レイテンシ p50 | 0.4ms |
| テストしたクエリ数 | 20 |
レイヤーごとの削減率(各レイヤーを個別に測定)
| レイヤー | 処理内容 | 削減率 | 方法 |
|---|---|---|---|
| 検索 | ファイル全体 → 関連するコードチャンク | 94% | 実測 |
| チャンク圧縮 | 生のチャンク → シグネチャ+ドックストリング | 89% | 実測 |
| 文法 | メモリテキストから冠詞や埋め草を削除 | 13% | 実測 |
出力圧縮(Claude の返信を短くすること)によっても追加の削減が見込めます(推定約65%)が、上記の主要な数値には含まれていません。
多言語ベンチマーク
| リポジトリ | 言語 | ファイル数 | 検索による削減 | Recall@10 |
|---|---|---|---|---|
| FastAPI | Python | 53 | 94% | 0.90 |
| Django | Python(大規模) | 2,347 | 93% | 0.95 |
| Express | JavaScript | 6 | 94% | 1.00 |
| chi | Go | 94 | 76% | 0.67 |
| fiber | Go(モノレポ) | 396 | 93% | 0.07 |
Django(ファイル数2,347、5.4Mトークン)では、CCE が再現率0.95を保ちながら大規模なコードベースにも対応できることが示されています。Go ではファイルが短いため、検索による削減の余地が小さくなります(ベースラインが小さい)。モノレポでは、top-10 の再現率が薄まります(fiber)。機能ごとにファイルが分かれているミドルウェアのクエリでは、一貫してR=1.00を達成します。
ご自身で再現するには:
pip install code-context-engine
python benchmarks/run_benchmark.py --repo https://github.com/fastapi/fastapi.git --source-dir fastapi
python benchmarks/run_benchmark.py --repo https://github.com/go-chi/chi.git --source-dir .
全結果はbenchmarks/results/にあります。クエリと方法についてはbenchmarks/をご覧ください。
得られるもの
Claude が自動的に使用する11 個の MCP ツール:
| ツール | 機能 |
|---|---|
context_search | グラフ拡張を備えたベクトル検索と BM25 検索のハイブリッド |
expand_chunk | 圧縮された検索結果のソース全体を取得 |
related_context | グラフのエッジ(呼び出し、インポート)を使ってコードを検索 |
session_recall | 過去のセッションから決定事項を呼び出す |
session_timeline | セッションのターン要約をたどる(想起した結果を詳しく確認) |
session_event | 特定のイベントのツール入出力の生データを確認 |
record_decision | 今後のセッションのために決定事項を保存 |
record_code_area | 作業したファイルを記録 |
index_status | インデックスの鮮度を確認 |
reindex | ファイルまたはプロジェクト全体を再インデックス |
set_output_compression | 応答の簡潔さを調整(off / lite / standard / max) |
ドーナツチャート、ファイルの健全性、セッション履歴を備えたライブダッシュボード:
cce dashboard
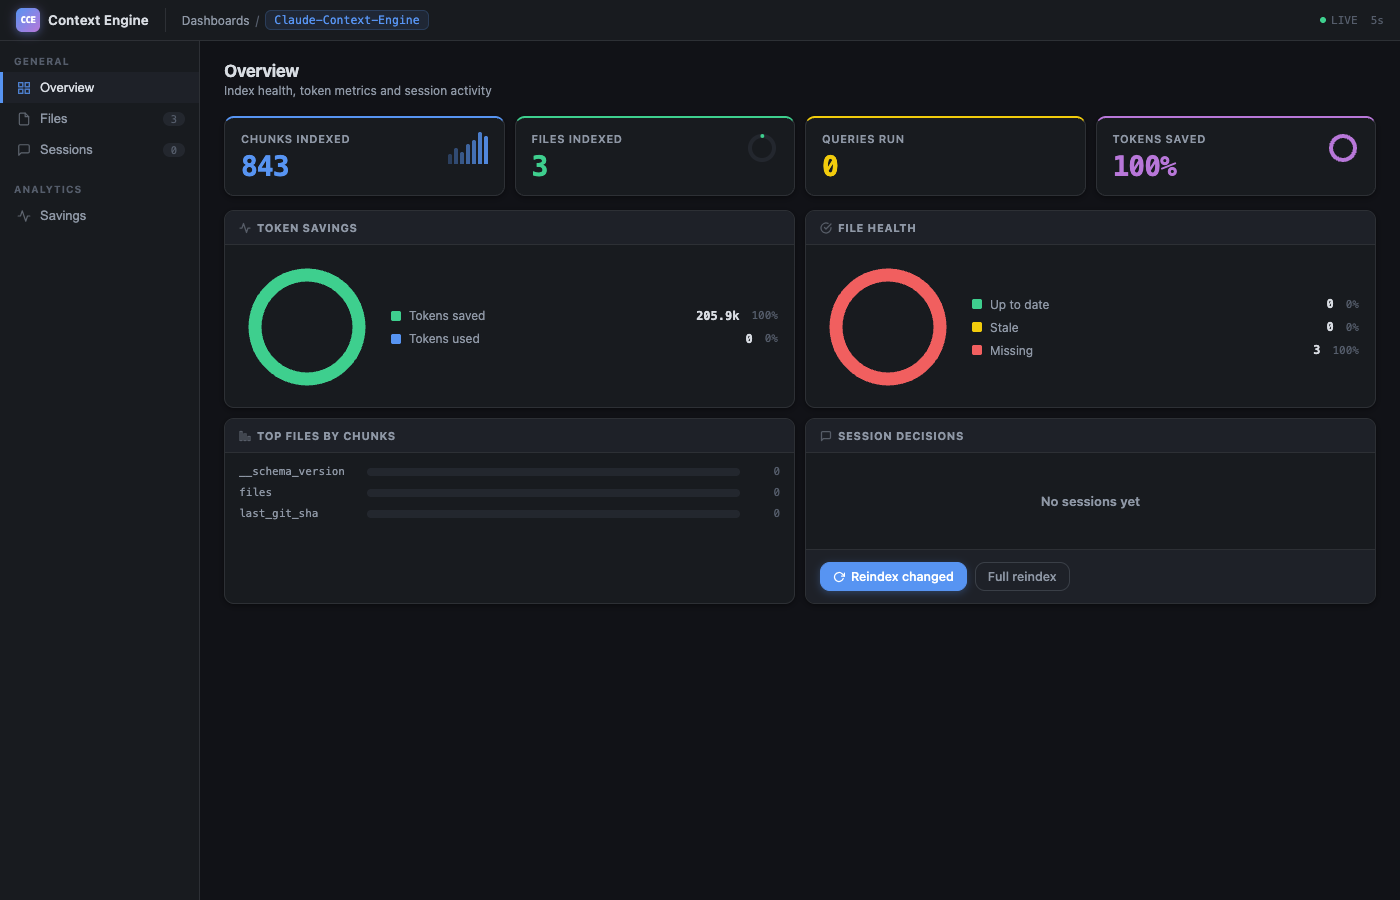
複数のプロバイダー(Anthropic、OpenAI、Google)の料金に基づくドル換算の推定額:
cce savings --all # see savings across all projects
仕組み
- インデックス作成: Tree-sitter がコードを意味的なチャンク(関数、クラス、モジュール)に解析します。ベクトル埋め込みとしてローカルに保存されます。
- 検索: Claude が
context_searchを呼び出します。ベクトル検索と BM25 検索を組み合わせた取得により、適切なチャンクを見つけます。コードグラフによって関連ファイルも自動的に追加されます。 - 圧縮: チャンクはシグネチャと docstring のみに切り詰められます(Ollama が実行中の場合は LLM による要約も可能です)。
- 記憶:
session_recallを通じて、決定事項とコード領域がセッションをまたいで保持されます。 - 追跡: すべてのクエリが記録されます。
cce savingsで節約できた金額を正確に確認できます。
編集後の再インデックス作成は 1 秒未満で完了します(埋め込みキャッシュのヒット率は 96%)。Git フックによって、インデックスは自動的に最新の状態に保たれます。
CCE の特長
コストがかかる部分で節約します
Caveman などの出力圧縮ツールは、出力トークンを 20~75% 節約します。出力が請求額に占める割合は 5~15% です。正味の節約率は約 11% です。
CCE は入力トークンを節約します(FastAPI では取得によって 94% 節約。再現可能なベンチマークを こちら で実施しています)。入力が請求額に占める割合は 85~95% です。
コードを実際に理解します
単なるテキスト検索ではありません。Tree-sitter の AST 解析によって、意味的なチャンクが作成されます。ハイブリッド検索では、ベクトル類似度と BM25 キーワードマッチングを Reciprocal Rank Fusion で統合します。信頼度スコアでは、類似度(50%)、キーワード一致度(30%)、新しさ(20%)を組み合わせます。グラフ拡張では、CALLS/IMPORTS のエッジをたどって関連コードを取得します。
記憶します
record_decision("use JWT for auth", reason="session tokens flagged by legal") は SQLite に保存され、次のセッションで session_recall を通じて参照できます。アーキテクチャを何度も説明し直す必要はありません。
実際の節約額を追跡します
推定値ではなく、実際のトークン使用量とファイル全体を読み込む場合の基準値との差を、取得、圧縮、出力、メモリ、文法の各カテゴリに分けて表示します。ドル換算のコストは Anthropic の料金ページから取得されます。節約額の概要は、すべてのセッション開始時に表示されます。
デフォルトで安全です
機密ファイル(.env、*.pem、credentials.json)はインデックス化されません。コンテンツは AWS キー、GitHub トークン、Slack トークン、Stripe キー、JWT、一般的な認証情報についてスキャンされます。メモリへの書き込みでは、PII(メールアドレス、IP アドレス、SSN、クレジットカード番号)が除去されます。すべての MCP ファイルパスで、パストラバーサルが検証されます。
内部の仕組み
コンテンツハッシュ埋め込みキャッシュ
チャンクごとにモデル名をソルトとして加えた SHA-256 フィンガープリントを作成します。再インデックス時には、変更されていないコードをスキップします。バイナリの float32 形式で保存するため、JSON の 10 分の 1 のサイズです。一般的な再インデックスでは、キャッシュヒット率は 96%で、1 秒未満で完了します。
sqlite-vec:217 MB から 2 MB に削減
LanceDB を sqlite-vec に置き換えました。コサイン距離の品質は同等で、インストールサイズは 99%小さくなります。WAL モードと PRAGMA NORMAL により、書き込み速度が 80%向上します。ベクトル、FTS5、コードグラフ、圧縮キャッシュは、すべて 3 つの SQLite ファイルに保存されます。
決定論的な文法圧縮
メモリーエントリーを LLM 呼び出しなしで圧縮します。冠詞、フィラー、代名詞を削除します。3 段階(lite/full/ultra)で、20~60%削減できます。コード、パス、URL はバイト単位でそのまま保持されます。同じ入力からは常に同じ出力が生成されます。
フェイルクローズ方式のフック設計
5 つの Claude Code ライフサイクルフックがセッションのコンテキストを取得します。各フックは curl ... || true を実行するため、サーバーがクラッシュしてもユーザーの操作は妨げられません。SessionStart は起動時のコンテキストを挿入し、その他のフックは通知なしで情報を取得します。
複数プロバイダーの料金設定
cce savings のドル換算の見積もりは、Anthropic、OpenAI、Google の 15 以上のモデルに対応しています。静的な料金データは CCE に同梱され、Anthropic の最新料金は取得後 7 日間キャッシュされます。pricing.model(例:gpt-4o、gemini-2.5-pro、sonnet)を設定するか、pricing.input / pricing.output でカスタム料金を指定できます。
リソースガバナー(複数インスタンスの安全性)
多数の cce serve プロセス(AI セッションごと、プロジェクトごとに 1 つ)を実行すると、システムメモリーを使い果たすおそれがあります。リソースガバナーはプロセスごとの ONNX Runtime スレッド数を制限し、アドバイザリーファイルロックを使用して、同じプロジェクトのインデックス作成を同時に行うプロセスを 1 つに制限します。また、Linux のメモリー負荷(PSI)が高いときは処理を遅らせ、30 分間アイドル状態のサーバーを自動的にシャットダウンします。serve.idle_timeout_minutes と serve.max_ort_threads で設定できます。
メモリー記録のリマインダー
CCE のセッション間メモリーは、エージェントが record_decision と record_code_area を呼び出すことで機能します。メモリー記録のリマインダーにより、記録を自然に促せます。記録せずに N 回検索すると、context_search の結果に短いリマインダーが含まれます。セッション終了時には、Stop フックが未記録のアクティビティを要約します。最初の記録後にリマインダーが再設定されるため、煩わしさを抑えながら役立つ状態を保てます。
HTTP 検索エンドポイント
cce serve --http を実行すると、MCP stdio の代わりに HTTP を使用するカスタムエージェント連携向けに、POST /search エンドポイントが公開されます。同じハイブリッド検索パイプラインを使用し、信頼度スコアを含む構造化 JSON レスポンスを返します。入力検証では、top_k(1..100)と confidence_threshold(0.0..1.0)の値を上限内に制限します。
追記専用の節約量台帳
7 つのカテゴリ(検索、チャンク圧縮、出力圧縮、メモリー再利用、文法、ターン要約、段階的開示)で、節約したトークンをすべて追跡します。再起動後も保持されます。CLI とダッシュボードの分析機能に利用されます。
エージェントプラグイン
エージェントプラグインは、AI スキルと MCP サーバーをポータブルなゼロインストールバンドルとしてパッケージ化するためのオープン標準(v1.0.0)です。Amazon、Cursor、Microsoft、OpenAI、Vercel が支援しています。CCE は、対応エディターが自動的に検出して読み込めるプラグインディレクトリを生成できます。
cce init --plugin                          # Generate at .cce/plugin/
cce init --plugin --plugin-dir ~/plugins/cce  # Custom location
cce init --agent claude --plugin           # Both: agent config + plugin
生成されるもの
.cce/plugin/
├── plugin.json                       # Agent Plugins v1.0.0 manifest
├── mcp.json                          # MCP server config (uvx + stdio)
├── skills/
│   └── code-context/
│       ├── SKILL.md                  # Agent instructions (frontmatter + body)
│       └── references/
│           └── tools.md              # Per-tool parameter docs (loaded on demand)
└── LICENSE
対応エディター
VS Code、GitHub Copilot、ChatGPT、Codex、Cursor、Kiro に対応しています。プラグインは uvx を使って必要に応じて CCE を起動するため、Python パッケージを事前にインストールする必要はありません。MCP サーバーは、作業ディレクトリから上位のディレクトリをたどり、.context-engine.yaml または .git/ を探してプロジェクトのルートを自動検出します。
--plugin と --agent の使い分け
--agent(デフォルト) | --plugin | |
|---|---|---|
| インストール方法 | エディター固有の設定ファイルを書き込みます | ポータブルなプラグインディレクトリを生成します |
| インストール不要 | いいえ。CCE が PATH 上にある必要があります | はい。uvx が必要に応じて CCE を取得します |
| 指示の更新 | cce init を再実行するまで古いままです | cce init --plugin を再実行するまで古いままです |
| 最適な用途 | 自分のマシンでの使用 | チームとの共有や配布 |
両方を併用できます。--agent はエディターごとの MCP 設定を処理し、--plugin はポータブルな代替手段を提供します。
CLI の概要
cce init                    # Index + install hooks + register MCP
cce init --plugin           # Generate Agent Plugin for VS Code, Cursor, etc.
cce                         # Status banner
cce savings                 # Token savings with dollar estimates
cce savings --all           # All projects
cce dashboard               # Web dashboard with live charts
cce search "auth flow"      # Test a query
cce status                  # Index health + config
cce services                # Ollama + dashboard + MCP status
cce commands add-rule '...' # Project rules for Claude
cce uninstall               # Clean removal of all CCE artifacts
コマンドの詳細については、cce list を実行してください。
設定
デフォルトでは設定不要です。必要に応じて ~/.cce/config.yaml または .context-engine.yaml で上書きできます。
compression:
  level: standard          # minimal | standard | full
  output: standard         # off | lite | standard | max
  ollama_url: http://localhost:11434   # point at a remote Ollama if desired

retrieval:
  top_k: 20
  confidence_threshold: 0.5

pricing:
  model: opus              # opus | sonnet | haiku | gpt-4o | gemini-2.5-pro | ...
  # input: 15.0            # override $/1M input tokens
  # output: 75.0           # override $/1M output tokens
リモート Ollama: ネットワーク上の別のマシンで Ollama を実行している場合は、compression.ollama_url(例:http://nas.local:11434)を設定するか、CCE_OLLAMA_URL をエクスポートしてください(環境変数が優先されます)。CCE はエンドポイントをプローブし、接続できない場合は切り詰めのみの圧縮にフォールバックするため、接続が不安定でもインデックス作成に支障はありません。
出力の圧縮
CCE は Claude の応答も圧縮します(Caveman と同じ考え方です)。
| レベル | スタイル | 削減率 |
|---|---|---|
off | 完全な出力 | 0% |
lite | 冗長表現や婉曲表現を省略 | 約30% |
standard | 断片的な表現にし、冠詞を削除 | 約65% |
max | 電文のような簡潔な表現 | 約75% |
Claude に「圧縮を最大に切り替えて」または「圧縮をオフにして」と伝えてください。コードブロックとコマンドは圧縮されません。
ディスク使用量
| コンポーネント | サイズ |
|---|---|
| コアのインストール(Ollama バックエンド) | 約17 MB |
[local] エクストラを含む場合(fastembed + ONNX) | 約189 MB |
| 埋め込みモデル(初回のみダウンロード) | 約60 MB(fastembed)または Ollama が管理 |
| プロジェクトごとのインデックス(小/中/大) | 5~60 MB |
GPU は必要ありません。Ollama を使用する場合、埋め込みは Ollama サーバーが処理します。[local] エクストラを使用する場合、埋め込みモデルは ONNX Runtime 経由で CPU 上で実行されます。
対応言語
AST 対応のチャンク分割(tree-sitter による解析、11 拡張子):
| 言語 | 拡張子 |
|---|---|
| Python | .py |
| JavaScript | .js, .jsx |
| TypeScript | .ts, .tsx |
| PHP | .php |
| Go | .go |
| Rust | .rs |
| Java | .java |
| C# | .cs |
言語を考慮したフォールバックのチャンク分割(40 以上の拡張子):
| カテゴリ | 言語 |
|---|---|
| Web | HTML、CSS、SCSS、LESS、Vue、Svelte |
| システム | C、C++、Zig、Nim |
| モバイル | Swift、Kotlin、Dart |
| 関数型 | Haskell、Scala、Clojure、Elixir、Erlang、F# |
| スクリプト | Ruby、Perl、Lua、R、Bash/Zsh |
| データ/設定 | JSON、YAML、TOML、XML、SQL、GraphQL、Protobuf |
| DevOps | Terraform、HCL、Dockerfile |
| ドキュメント | Markdown |
その他のすべてのテキストファイルは、行の範囲ごとにチャンク分割されます。バイナリファイルはスキップされます。
ドキュメント
| ページ | 内容 |
|---|---|
| AI コーディングトークンにいくら費やしていますか? | 入力トークンと出力トークンの計算 |
| CCE とは?(完全ガイド) | セットアップ、ツール、仕組み、FAQ |
| Claude Code のトークンを節約する方法 | コストの内訳と節約ガイド |
| ベンチマークの詳細解説 | FastAPI ベンチマークの完全な手法 |
| 代替製品との比較 | CCE と Cursor、Aider、Continue、Greptile の比較 |
| 使用例 | Claude との実際の会話 |
| 仕組み | 9 段階の完全なパイプライン |
| CLI リファレンス | すべてのコマンドと出力 |
| 設定 | すべての設定オプション |
FAQ
CCE は応答の品質に影響しますか?
いいえ。品質は変わらないか、わずかに向上します。
CCE は「ファイル全体をダンプする」方法を「関連する関数を検索する」方法に置き換えます。モデルは必要なコードを引き続き取得できます(ベンチマークで Recall@10 は 0.90)。関連性のないコンテキストが減ると、注意を奪うノイズが少なくなり、モデルが実際の質問に集中しやすくなります。
出力トークンの節約はどのように実現しますか?
CCE は cce init の実行時に、出力を圧縮するルールをエージェントの指示ファイル(CLAUDE.md、AGENTS.md、.cursorrules など)に直接書き込みます。これらのルールは CCE ツールの応答だけでなく、セッション全体に適用されるため、エージェントからのすべての返答に反映されます。
~/.cce/config.yaml または .context-engine.yaml でレベルを設定します。
compression:
  output: max       # off | lite | standard | max
その後、cce init を再実行して指示ファイルを更新します。または、実行中に変更します。
set_output_level output_level=max
| レベル | 節約率 | 内容 |
|---|---|---|
off | 0% | 圧縮しません |
lite | 約 25% | 冗長表現/曖昧な表現/社交辞令を削除し、コード変更には差分のみを使用 |
standard | 約 70% | 冠詞、断片的な表現、短い同義語を削除し、コードには差分のみを使用 |
max | 約 80% | 電文のような簡潔な文体にし、コードには差分のみを使用 |
デフォルトは standard です。すべてのレベルに、モデルが変更した行だけを表示し(ファイル全体を書き直さず)、コーディングセッションで出力トークンの大半を占めるコード出力ルールが含まれます。max レベルでは、非常に簡潔な文章が生成されます(「原始人モード」に似ています)。レベルにかかわらず、コードブロック、パス、コマンドは圧縮されません。
節約はどこから生まれますか?
節約の大半は入力トークン(モデルに入力される内容)によるものです。
| レイヤー | 種類 | 一般的な節約率 |
|---|---|---|
| 検索 | 入力 | 94%(ファイル全体 → 関連するチャンク) |
| チャンク圧縮 | 入力 | 89%(チャンク → シグネチャ) |
| 文法圧縮 | 入力 | 13%(冠詞/冗長表現の削除) |
| ターンの要約 | 入力 | 変動(セッション履歴) |
| 段階的な開示 | 入力 | 変動(ツールのペイロード) |
| 出力圧縮 | 出力 | 25~80%(レベルによって異なります) |
出力トークンは 1 トークンあたりのコストが入力の 5 倍です(例:Opus は入力が 100 万トークンあたり $15、出力が $75)。そのため、出力をわずかに削減するだけでも、コストに大きな影響があります。
ロードマップ
- 複数リポジトリのベンチマーク(FastAPI、chi、fiber)
- 追加のベンチマーク(Django、Express)
- C、C++、Ruby、Swift、Kotlin の Tree-sitter サポート
- リモートモードの Docker サポート
- mcp 2.x API への移植
リリース済みの機能については、CHANGELOG.md をご覧ください。
貢献
貢献を歓迎します。セットアップについては、https://github.com/elara-labs/code-context-engine/blob/main/CONTRIBUTING.mdをご覧ください。
ライセンス
MITです。LICENSEをご覧ください。
作成者
謝辞
Claude Code · MCP · sqlite-vec · Tree-sitter · fastembed · Ollama
CCEでトークンを節約できたら、スターを付けてください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。