searchts について
searchtsは、AIエージェント向けのオープンソースWebページリーダーです。ページをMarkdownに変換し、取得できない場合は理由を明示します。段階的なアクセス、検索、共有チャットの復元、アセット取得、動画文字起こしを備えています。
主な機能
- 01ブロックやJavaScriptページへの段階的アクセス
- 028サービスの共有チャット復元
- 03キー不要のWeb検索
- 04ページアセットの抽出と保存
- 05対応動画の文字起こし
- 06プロンプトインジェクション兆候の除去
活用シーン
- 01標準の取得機能では読めないページの閲覧
- 02AIチャット共有リンクから全文を取得
- 03Web検索から結果ページを開く
- 04サイトの画像、フォント、SVGの収集
- 05字幕のない動画の文字起こし
MCP 対応
MCP サーバーとして動作し、MCP クライアントにWebページの読み取りなどの機能を提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
9掲載時のツール一覧 · 3 日前に更新
このツールにパラメーターはありません。
詳細
searchts
AI エージェント向けの、キー不要のウェブページ解除・閲覧ツールです。 (ここだけの話:「これ検索しろよ」という意味です。)
ページを読み取るか、読み取れないことをエージェントにはっきり伝えます。
Claude、Cursor、Codex などのエージェントが URL を取得すると、403 のボット対策ページ、空の JavaScript シェル、途中で切れた AI チャット共有リンク、ログイン画面など、役に立たない結果が返ってくることがよくあります。モデルはログイン画面を記事だと思い込んで、喜んで要約することさえあります。searchts は、エージェントが代わりに呼び出すリーダーです。オープンソース(MIT)で、無料、API キー不要、有料の住宅用プロキシはデフォルトで使用せず、MCP サーバー、CLI、Python ライブラリとして動作します。




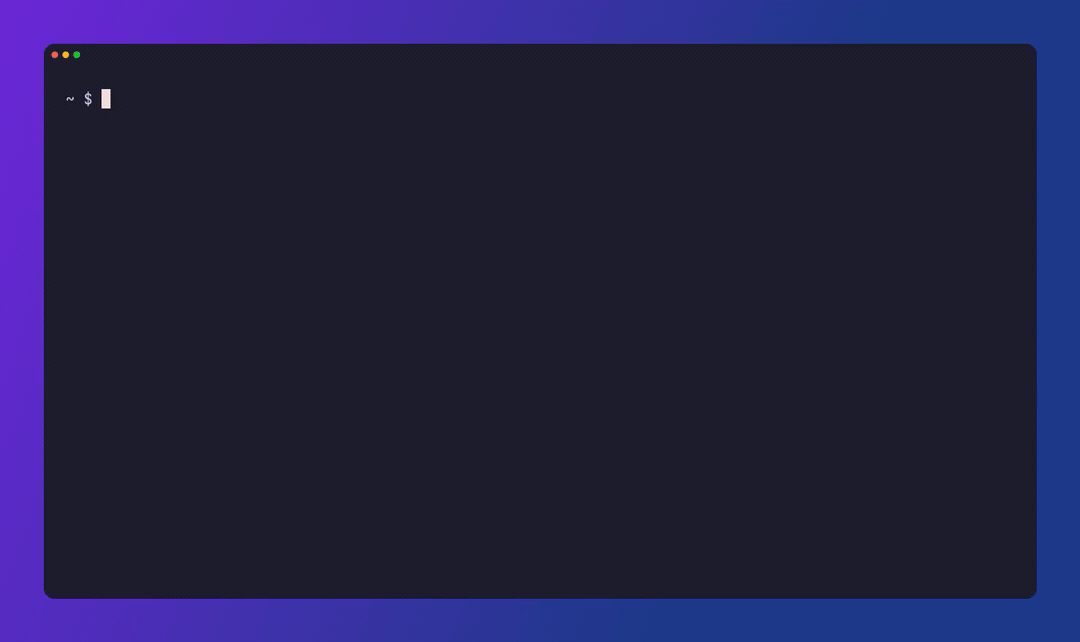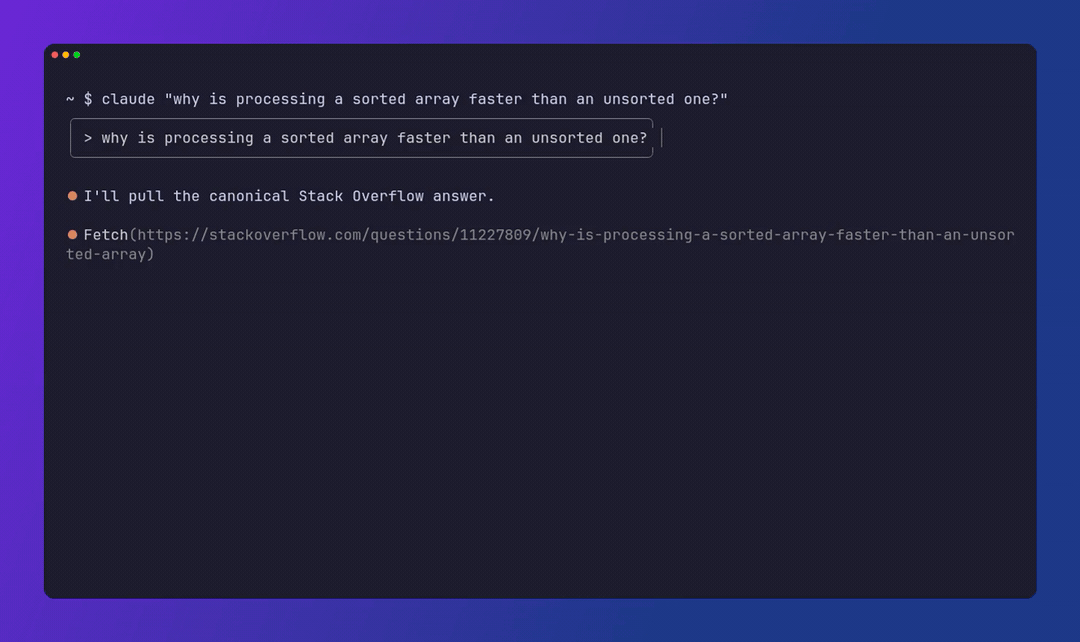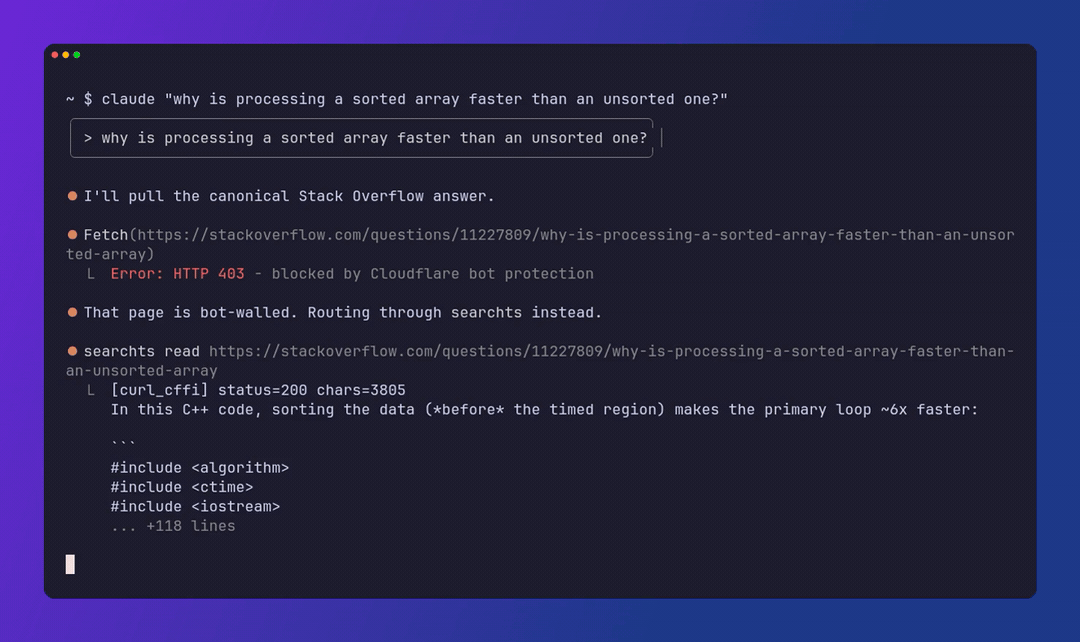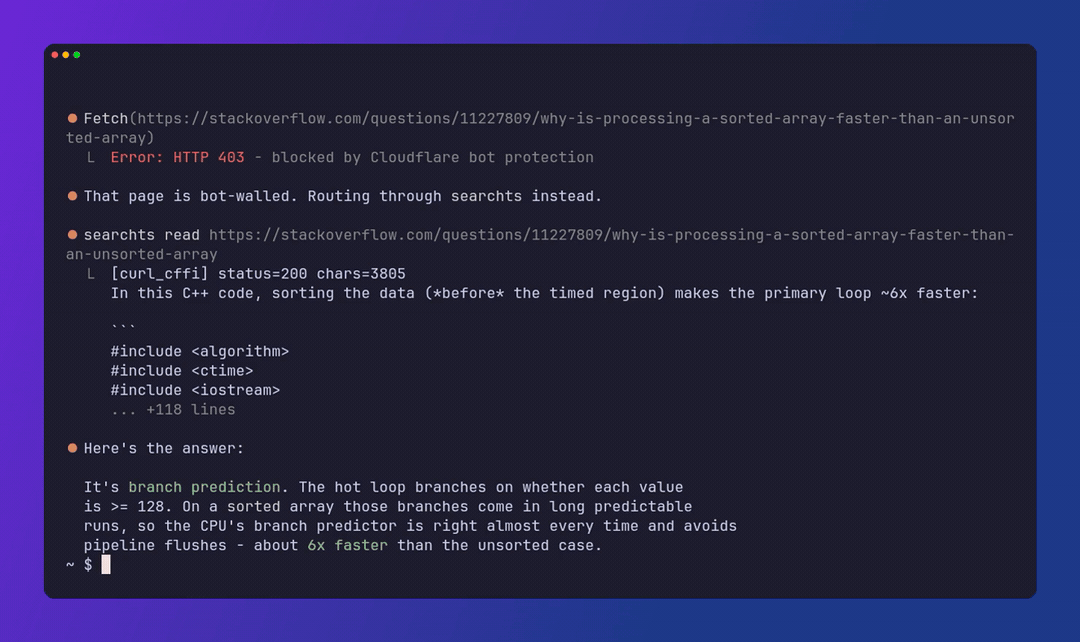
エージェントへのワンコマンドインストール
コマンド1つで、searchts を Claude Code、Cursor、または任意の MCP クライアントに追加できます。API キーは不要です。
claude mcp add searchts -- uvx --from "searchts[mcp]" searchts mcp serve
グローバルにインストールし、より難しい段階で使うステルスブラウザーを追加するには、次のようにします。
pipx install "searchts[mcp]" && searchts install --browser
claude mcp add searchts -- searchts mcp serve
インストールでは、uvx、pipx、venv、ブラウザーエクストラについて説明します。CLI、MCP サーバー、Python ライブラリはすべて同じ読み取り経路を使います。
エージェント標準の取得機能にはできない3つのこと
1. ChatGPT、Claude、Gemini、Grok、Poe、DeepSeek、Perplexity、Copilotの共有リンクを完全にデコードする
共有された会話は、初期ページの HTML にプレーンテキストとして存在しません。通常の取得では JavaScript シェルしか得られず、レンダラーでもスレッドの途中で切れてしまうことがあります。searchts read は共有 URL を認識し、各プロバイダー独自のデータチャネルから、ロール名付きの完全な Markdown をデコードします。ログインもキーも不要です。
searchts read https://chatgpt.com/share/...        # turbo-stream payload in the page (no browser)
searchts read https://claude.ai/share/...          # keyless snapshot API behind Cloudflare (no browser)
searchts read https://gemini.google.com/share/...  # keyless batchexecute RPC (no browser)
searchts read https://chat.deepseek.com/share/...  # stealth render, auto-scrolls past list virtualization
対応する8つのプロバイダー:ChatGPT(/share/<uuid> と新しい /s/<prefix>_<id> 短縮リンクの両方)、Claude、Gemini、Grok、Poe、DeepSeek、Perplexity、Copilot。最初の5つではブラウザーは不要です。残りの3つではステルス段階を再利用し、ページの高さが変わらなくなるまでスクロールして、折りたたみ部分を開いてから読み取ります。
2. ボット対策を突破するか、ログイン画面を見て幻覚する代わりに、失敗を明確に伝える
すべての searchts read は3段階のオープンソース解除ツールを順に試し、ドメインごとにどの段階が成功したかを記憶します。
curl_cffiは、実際の Chrome の TLS/JA3 および HTTP/2 フィンガープリントを偽装します。高速で、ローカルに動作し、プライベートです。- Jina Reader(
r.jina.ai)は、JavaScript が実行された後にページの内容が表示される場合に、JavaScript をレンダリングします。デフォルトで有効です。SEARCHTS_NO_JINA=1を設定すると、URL が Jina のサーバーに送信されなくなります。 patchrightは、安価な段階で失敗した場合にのみ起動する、遅延起動型のステルス Chromium です。--humanは、ページを解除できるのが人間だけの場合に、実際のブラウザーを開きます。
searchts read https://some-js-heavy-or-fingerprinted-site.com --scrub
# Tier 1 (curl_cffi) -> 403 | Tier 2 (Jina) -> clean Markdown returned, injection scrubbed

searchts read https://www.linkedin.com/in/someone/
# Fails loudly: reports the exact tier and login-wall reason. stdout stays empty.
--scrub は、不可視文字や双方向テキスト制御文字を除去し、信頼できないテキストがモデルに渡される前にプロンプトインジェクションの兆候を検出します。
ユーザーが引き渡すログイン情報と、searchts が推測するログイン情報は別物です。0.15.0 では、ローカルでの再利用はオプトイン方式で、コマンド内の1つのホストに限定されます。使用できるのは --cookies-from-browser <browser> --yes、--cookies <path>、または --cdp-port <port> です。これらのいずれも指定されていない場合、ボット対策ページは記事として扱われず、エラーになります。
3. 動画を書き起こし、フィンガープリントで保護されたデザインアセットを取得する
searchts transcribe https://youtu.be/...                     # YouTube, TikTok, Instagram Reels, Reddit
searchts transcribe https://www.instagram.com/reel/... --cookies-from-browser chrome
searchts grab https://stripe.com --kinds images,fonts,svg --read --out ./stripe-kit
字幕を優先して書き起こし、字幕がない場合は yt-dlp で音声を取得し、Whisper を使用します。grab は同じアンロッカーを使ってページの画像、アイコン、CSS、フォント、SVG、カラーパレットを抽出するため、オープンな CDN だけでなく、フィンガープリントで保護された CDN でも動作します。
ネイティブのウェブ検索
組み込みのフェッチ機能では検索できません。searchts search は、デフォルトではキー不要の DuckDuckGo を使い、SearXNG、Exa、Brave、Tavily の検索結果を相互ランク融合します。スニペットはページそのものではありません。各 URL を読み込んでください。
searchts search "open source vector db"
開発した理由
Claude にウェブを読んでもらおうとすると、何度も壁にぶつかるため、searchts を開発しました。きっかけは Devpost のハッカソンページとその利用規約でした。ページには特にアクセス制限がなかったのに、Claude は読み取れませんでした。
Claude と開発した初期バージョンは、反対の問題を起こしました。ページを取得できないと、手に入ったものを何でも返し、エージェントは読み込み画面を記事であるかのように要約していました。そのため searchts には、何よりも優先するルールがあります。本物のページを返すか、失敗したこととその理由を明確に伝えることです。エージェントに偽の読み取り結果を渡すことはありません。
searchts の比較
searchts は Agent-Reach のチャネル/診断の仕組みを基に開発を始め、その後、読み取り/検索のコア部分を段階的にエスカレーションするアンロッカー、共有リンクデコーダー、MCP サーバーに置き換えました。
| 機能 | 組み込みの WebFetch / curl | Agent-Reach | ホスト型スクレイパー(Firecrawl、Jina Pro) | searchts |
|---|---|---|---|---|
| アーキテクチャ | 単純な HTTP フェッチ | サードパーティ製 CLI(yt-dlp、OpenCLI、Jina)用のインストーラーとプラットフォーム別ルーター | ホスト型フェッチ+スクレイパー群 | ローカルで段階的にエスカレーションするアンロッカー+MCP サーバー+CLI |
| ボット/JS 対応のエスカレーション | なし | ウェブ向けの Jina Reader を一度経由 | ホスト型プロキシとレンダリング | curl_cffi(TLS/JA3)→ Jina → patchright のステルスモード+--human |
| ログインまたはブロック | ログイン用 HTML を 200 OK としてモデルに渡すか、エラーになる | 上流の CLI とそのセッションによる | クレジット、制限、または部分的な HTML | 失敗した階層と理由を明示して失敗します。ローカルのログイン情報の再利用はオプトインです |
| AI チャットの共有リンク | 空の JS シェル、または途中で切れた内容 | 共有リンクデコーダーはなく、Jina に依存 | レンダラーが長いチャットを途中で切ることがある | ネイティブデコーダー+自動スクロール対応のステルスレンダリング(8 プロバイダー) |
| ウェブ検索 | なし | mcporter 経由の Exa | 有料の検索エンドポイント | キー不要の DuckDuckGo+SearXNG/Exa/Brave/Tavily を横断する RRF。スニペットはページそのものではありません |
| プロンプトインジェクションの除去 | なし | — | — | 組み込み(--scrub) |
| ベンチマーク | なし | なし | 宣伝用の成功率 | 再現可能な 2 つのスイートによるスコアカード(Smoke 対 Walled) |
| デフォルトのコスト | 無料 | 無料。ただしインストールする CLI は別途必要 | API キーとページごとのクレジット | 無料、MIT、キー不要(デフォルトでは有料の住宅用プロキシを使用しません) |
できること
- エージェント自身のフェッチ機能では読めないページを読み取ります。ブラウザーフィンガープリントのチェック、JavaScript のみで表示されるページ、一部のボット対策ページに対応します。
- 読み取り結果が本物のページではない場合(ユーザーから提供されていないログイン情報、人の操作が必要なパズル、アクセス先そのものがブロックされている場合など)は、失敗した階層と理由を明示して失敗します。
- ChatGPT / Claude / Gemini / Grok / Poe / DeepSeek / Perplexity / Copilot の共有会話をすべて読み取ります。
- Claude、Codex、MCP エージェントで動作します。
- モデルにすぐ渡せる、きれいな Markdown を抽出します。
- 次のページ、フィード、折りたたまれたテキストなど、取得した内容の先にページが続く場合はそのことを伝え、検索結果やフィードのうち抽出器が壊してしまうものを再構築します。
- API キー不要でウェブを検索します(DuckDuckGo に加えて、SearXNG、Exa、Brave、Tavily に対応)。スニペットはページそのものではありません。
- ページのアセット(画像、フォント、パレット)をダウンロードします。
- 字幕を優先して動画を書き起こします。
- ページ内の画像、動画、埋め込みコンテンツの URL を示します。
searchts get <url>を使うと、その URL のコンテンツを同じ手順で取得します。 - プレーヤーのページでは字幕を返します。字幕がない場合は失敗し、音声には
searchts transcribeを使うよう案内します。
読み取りで次の手順が示された場合
search はURLの一覧と、スニペットはページそのものではないという行を出力します。各URLを読み取ってください。
プレーヤーのページ(YouTubeの視聴URL、TikTokの動画、Instagramのリール、v.redd.it のファイル、または動画を含むXの投稿)を読み取ると、字幕が返されます。あるいは、標準出力が空のまま失敗し、音声には searchts transcribe を使うよう表示されます。動画のないXの投稿は、引き続きページの読み取りです。字幕の取得にキーは必要ありません。音声には、2つ目のリーダーではなく、transcribeコマンドを使ってください。
searchts transcribe https://youtu.be/...                     # audio, when read found no captions
searchts transcribe https://www.instagram.com/reel/... --cookies-from-browser chrome
searchts get https://example.com/logo.svg -o logo.svg        # one file a read named
searchts grab https://stripe.com --kinds images,fonts,svg --read --out ./stripe-kit
ファイル一式が納品物の場合、grab はそのファイル一式を保存します。同じアンロッカーを使うため、フィンガープリントで保護されたCDNも、読み取りと同じ段階をたどります。
パッケージが無料の理由
インストールするパッケージは無料で、キーも不要です。取得処理とブラウザーは、お使いのマシン上でお使いの接続を利用して動作します。住宅用プロキシは同梱されていません。唯一のホスト型の段階であるJina Readerは無料で、無効にもできます。これは、あらゆる難しいページが今後もずっと無料で読めるという約束ではありません。当社が運用する出口を必要とする読み取りは別製品であり、このパッケージのデフォルト機能ではありません。スコアカードは、このビルドで実際に読み取れたものを示しており、決して突破できない壁の一覧ではありません。
アンロッカー
searchts は段階を上げながらあらゆるURLを読み取り、実際のコンテンツを返す最初の段階で停止します。
- curl_cffi:実際のChromeのTLS/JA3とHTTP2フィンガープリントを偽装するフェッチです。ユーザーエージェントとフィンガープリントによるフィルターを回避します。高速で、ローカルで動作し、プライベートです。
- Jina Reader:JavaScriptを実行してレンダリングするリレー(
r.jina.ai)です。JSの実行後にのみコンテンツが表示されるページに使用します。デフォルトで有効です。この段階では、対象URLがJinaのサーバーに送信されます。SEARCHTS_NO_JINA=1または設定のjina: falseでオプトアウトできます(ローカルのcurlとステルスのみを使用します)。 - ステルスブラウザー:検出を回避するヘッドレスChromium(patchright)です。より低コストの段階で失敗した場合に限り、ライブJSやCloudflareの管理チャレンジ用として、必要になったときに遅延起動します。
どの段階でも実際のコンテンツが返されない場合は、オプションのヒューマン・イン・ザ・ループ手順で実際のブラウザーを開き、一度ページのブロックを解除してから続行できます。これにより、操作が必要なCAPTCHAも、緩やかなブロックも対処できます。HTTP 200で配信されるログインページはチャレンジではありませんが、人間だけが先に進めるページであることに変わりはありません。ブロックの検出はフレーズに基づいており(ベンダー名には基づきません)、ボット検出スクリプトが埋め込まれているだけの正規のページを誤って拒否することはありません。コンテンツは trafilatura でクリーンなMarkdownに抽出されます。
対応しないこと。 ブロックページを記事であるかのように装うことはありません。ユーザーが提供していないログイン情報が必要な場合は、理由を示して失敗します。ローカルでの再利用機能は0.15.0で追加されました。ただし、コマンド内で指定した1つのサイトのセッションを searchts に渡した場合に限ります(--cookies-from-browser <browser> --yes、--cookies <path>、または --cdp-port <port>)。FirefoxベースのZenプロファイルは読み取り専用のSQLiteとして扱われます。VivaldiなどのChromiumブラウザーは、一時的なプロファイルのコピーを使ってループバックCDPポートで開かれ、その後searchtsがコピーを削除します。Vivaldiの使用にChromeのインストールやPATHへの登録は必要ありません。リモートブラウザーでのサインイン機能は未実装です(F27)。DataDomeのデバイスチェックは永続的な失敗ではありません。ステルスブラウザーはそのスクリプトを完了させ、簡単なクリック操作(続行、チェックボックス、1回の操作で済む長押し)に対応することを想定しています。画像の認識を人に求めるパズルでは停止します。このパッケージは、デフォルトで有料の住宅用プロキシを経由させることはありません。リリースでは、実際にサイトを読み取るまでは、読み取れると主張しません。現行のスコアカードでは、datadome.co は引き続き失敗です。これは測定結果であり、ルールではありません。
AI チャットの共有リンク
AI チャットアプリの共有リンクは、特に厄介な種類のリンクです。会話はページの HTML に抽出可能なテキストとして現れないため、通常のフェッチでは空の殻が返され、レンダラーを使ってもチャットの途中で切れてしまうことがあります。searchts read はこうした URL を認識し、代わりに各プロバイダー独自のデータチャネルをデコードして、会話全体を役割ラベル付きの Markdown として返します。API キーもログインも不要です。
| プロバイダー | 共有 URL | 読み取り方法 |
|---|---|---|
| ChatGPT | chatgpt.com/share/…、chatgpt.com/s/… | ページに埋め込まれた turbo-stream ペイロード |
| Claude | claude.ai/share/… | API キー不要のスナップショット API(Cloudflare の背後) |
| Gemini | gemini.google.com/share/… | API キー不要の batchexecute RPC |
| Grok | grok.com/share/…、x.com/i/grok/share/… | API キー不要の共有リンク API |
| Poe | poe.com/s/… | ページに埋め込まれた __NEXT_DATA__ ペイロード |
| DeepSeek | chat.deepseek.com/share/… | ステルスレンダリングでページ末尾までスクロール |
| Perplexity | perplexity.ai/search/…、perplexity.ai/page/… | ステルスレンダリングでページ末尾までスクロール |
| Copilot | copilot.microsoft.com/shares/…、…/shares/pages/… | ステルスレンダリングでページ末尾までスクロール |
最初の 5 つはブラウザーを必要としません。最後の 3 つは初期 HTML に何も含まれない JavaScript シェルなので、ステルス層を利用します。会話がレンダリングされるのを待ち、ページの高さが変わらなくなるまで自動スクロールします(そうしないと、リストの仮想化によって長いチャットが途中で切れてしまいます)。その後、折りたたまれたセクションを展開してから読み取ります。現在のベンチマークはブラウザーなしで読み取れる 5 つを対象としています。ブラウザーが必要な 3 つは、まだ含まれていません。
ChatGPT のリンクには 2 種類あります。会話全体を共有する /share/<uuid> と、1 つの共有ターン用の新しい短縮リンク /s/<prefix>_<id> です(t_ はスレッド、m_ はメッセージ、dr_ は詳細リサーチ、cd_ は Codex)。どちらも読み取れます。
各プロバイダーは、差し替え可能なプラグインモジュール(searchts/share_extractors/)です。プロバイダーが形式を変更した場合、抽出に失敗する代わりに、通常のアンロッカーの段階的な処理にフォールバックします。
実際に機能しますか?
言葉だけで信じてもらうのではなく、searchts には再現可能な 2 種類のテストスイートが付属しています。2 つのページセットに対してアンロッカーを実行し、API キーなしで読み取れたページ数と、それぞれに使われた段階を報告します。
- Smoke — 小規模な公開ページセット(対照ページ、公開ドキュメント、AI チャットの共有リンク)。回帰を検知するためのものであり、ボット対策が厳しいサイトについての証拠ではありません。
- Walled — ボットを制限する実在のサービス(Reddit、ログインウォールのある LinkedIn、Cloudflare/DataDome クラスのサイト、X、Booking)。本文がアンロッカーの最小コンテンツしきい値に満たない場合は、成功ではなく失敗です。想定されるウォールでの失敗は、100% という数字でごまかさず、正直に報告します。
最後にコミットされた実行では、Smoke は 12/12、Walled は 2/7 を読み取りました。重要なのは Walled の数値です。実在する 5 つのウォールを、偽の 100% の背後に隠さず失敗として報告しています。
この 2 つは、意図的に別々に報告しています。Smoke の数値は「ウォールで機能するか」を示すものではありません。benchmarks/README.md を参照してください。
python -m benchmarks.run                       # both suites, print a scorecard
python -m benchmarks.run --suite walled       # the real walled pass rate only
python -m benchmarks.run --out docs/          # write docs/scorecard.md + results.json
最新の実行結果:docs/scorecard.md。独自の対象を追加するには、benchmarks/README.md を参照してください。
この数値が意味を持つのは、一般家庭向けの回線から実行した場合だけです。データセンターの IP(または TLS フィンガープリントを変える VPN)では、実際のユーザーが遭遇する場合よりも、curl_cffi の高速層が強くブロックされます。
インストール
これを使います(グローバルに分離された CLI、MCP の追加機能を含みます):
pipx install "searchts[mcp]"
インストールせずに試します(1 回限りの実行、コピーして貼り付けます):
uvx --from "searchts[mcp]" searchts <verb>
venv/パッケージ化のみ(CLI には推奨しない方法です):
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install "searchts[mcp]"
通常のインストールには、ステルスブラウザーライブラリ(patchright)、ブラウザー Cookie、MCP サーバー、同梱の ffmpeg、YouTube に必要な JavaScript ランタイム(yt-dlp[deno] 経由の deno)がすでに含まれています。システムへのインストールは不要です。[mcp]、[browser]、[cookies] の追加機能も空のエイリアスとして引き続き解決されるため、既存の仕様はそのまま動作します。
初回セットアップでは、サイズ付きのリストを 1 つ表示し、1 回の承認で、項目をすべてデフォルトで選択済みにします。対象は、ステルスブラウザー用の Chromium(約 170 MB)、X 用の twitter-cli(約 39 MB)、Reddit 用の rdt-cli(約 15 MB)、linkedin-scraper-mcp(約 214 MB)、mcporter(約 77 MB、Node.js が必要)、GitHub 用の gh(約 13 MB)です。ローカルの Whisper モデルは、サイズとともに一覧表示され、ローカルで初めて文字起こしを行うときにインストールするか尋ねられます。サイトへのログインはこの承認には含まれません。読み取りにログインが必要な場合は、サイトごとに尋ねられます。
searchts install                                 # a terminal asks once; type ids to uncheck
searchts install --yes --skip linkedin,mcporter  # agents: no prompt, nothing outside the list
searchts install --dry-run --json                # the list as searchts.setup.v1, changes nothing
ターミナルがない場合、または --yes を指定しない場合は、一覧にあるものは何もインストールされません。代わりに、一覧と正確な承認コマンドが表示されます。ステルスブラウザーのみをインストールする場合:searchts install --browser。
実行中のコピーを更新します(searchts upgrade も同じコマンドです):
searchts update
更新チェックとエージェントへの注意
searchts は 24 時間に 1 回を上限として、GitHub に
capad-xyz/searchts
の最新リリースを問い合わせます
(GET https://api.github.com/repos/capad-xyz/searchts/releases/latest)。このリクエストに含まれるのは searchts/<version> という User-Agent のみで、あなたやマシンに関する情報は送信されません。応答は ~/.searchts/update-check.json に 24 時間キャッシュされます。チェックに失敗しても何も通知されません。
そのリリースのほうが新しい場合:
searchts read --json、searchts grab --json、searchts doctor --jsonは、トップレベルにupdate_availableオブジェクト({"current": "...", "latest": "...", "command": "searchts update"})を追加します。新しいバージョンがない場合は追加されないため、既存のパーサーに新しいキーは現れません。searchts search --jsonは標準出力に配列のみを出力し、標準エラー出力に{"update_available": {...}}を JSON 1 行で出力します。- 成功した MCP ツールの結果(
Error: ...文字列を除く)には同じオブジェクトが含まれ、さらに 24 時間に 1 回を上限として、エージェントにあなたへ知らせるよう指示する 1 行が追加されます。通知済みの記録は~/.searchts/update-notice.jsonに保存されます。 - ターミナルから実行した場合は、従来どおり標準エラー出力に更新を促すメッセージが表示されます。
インストール、ダウンロード、変更が自動で行われることはありません。 自分で searchts update を実行してください。SEARCHTS_NO_UPDATE_CHECK=1 を設定すると、更新チェック、通知、標準エラー出力のメッセージが無効になります。
クイックスタート
実行するコマンドは read です。search は読み取る URL を検索します。ページ内の言葉が音声で読み上げられている場合や、ファイルがテキストに含まれていない場合に、読み取りが呼び出すのが transcribe と get です。
searchts read https://en.wikipedia.org/wiki/Ada_Lovelace   # the page as Markdown, or a plain failure
searchts search "open source vector db"    # native multi-provider web search, keyless by default
searchts transcribe https://youtu.be/...   # the audio, when a read found no captions
searchts get https://example.com/logo.png  # one file a read named
searchts grab https://example.com          # the set of files, when the files are the deliverable
searchts doctor                            # see what is configured and working
read のフラグ:--json、--backend <tier>、--human(CAPTCHA またはログイン画面の操作を実際のブラウザーに引き継ぎます)、--scrub(インジェクションを伏せます)、--pages <n>(次のページも取得します。curl のみ、最大 5 ページ)、--items <n>(リストの行数が指定数に達するまで取得を続けます。必要な場合はフィードをスクロールします)、--expand(閉じた <details> や「続きを読む」「表示」などのラベルが付いたボタンを開きます。リンク、フォーム、サインインは操作せず、「続きを読む」ペイウォールは開かずにその旨を示します)、--proxy <url>(プロキシ経由で接続します。--proxy-trusted を指定すると、リモートプロキシの運営者が Cookie ヘッダーを参照できるようになります)。ログイン済みの状態で読み取る場合は、コマンドで指定した 1 つのサイトに限り、すべてオプトインで利用できます:--cookies-from-browser <browser> と --yes(このセッション用にそのサイトの Cookie をコピーします)、--cookies <path>(searchts が管理する Cookie ファイル)、--cdp-port <port>(localhost のデバッガーポートから Cookie を取得します)。
追加要求数には上限があり、searchts はその上限を超えて要求できません。上限は SEARCHTS_MAX_PAGES(デフォルト 5)、SEARCHTS_MAX_ITEMS(デフォルト 300)、SEARCHTS_MAX_EXPAND_CLICKS(デフォルト 8)です。環境変数または ~/.searchts/config.yaml の more: ブロックで設定してください(環境変数が優先されます)。上限を超える要求は黙って減らされるのではなく、上限の値に調整され、読み取ったテキストに注記が表示されます:[items: asked for 900, the ceiling is 300]。--expand は引き続き yes/no の指定です。展開の範囲はフラグではなく、設定した上限によって決まります。スクロールでしか読み込まれないリストや、JavaScript が必要な折りたたみ表示にはブラウザーが必要です:searchts install --browser。スクロール時には専用のブラウザーが起動します。このブラウザーにはプロキシも Cookie も引き継がれないため、どちらかを使う読み取りではスクロールが行われず、その旨が表示されます。この 3 つの上限は Reddit の読み取りにも適用されるすべての上限です。投稿カード、コメント、検索結果はすべて行として数えられるため、取得件数を決めるのは SEARCHTS_MAX_ITEMS だけです。除外された項目は破棄されず、件数として表示されます。
login の動詞:searchts login keep <url> --cookies-from-browser zen --yes(または vivaldi)は、そのサイトの Cookie だけを searchts のストアにコピーします。その後は通常の searchts read <url> で保存済みのログイン情報が使われます。searchts login signin <url> は、新しいサインインウィンドウを開きます。Cookie を保存するには --yes を追加します。searchts login list は、保存済みサイトごとに有効な Cookie の数、コピー元のブラウザーまたは signin、有効期限(保証ではなく上限)を表示します。searchts login sweep は、期限切れの Cookie をただちにオフラインで削除します。searchts は各コマンドの開始時にも削除を行い、削除内容の記録を表示します。cron、launchd、タスク スケジューラの項目がインストールされることはありません。searchts login check <site> [--url <signed-in-page>] は、保存済みの Cookie を使って、ログインが必要なページを 1 つ直接読み取り、ログイン中なら終了コード 0、ログアウト中なら 1、不明なら 2 で終了します。CAPTCHA またはブロックが表示された場合は不明となり、公開ページではログイン中と判定されません。login kill <url> は searchts が保持しているコピーを削除します。--also-browser を指定しない限り、使用しているブラウザーには影響しません。login purge-scratch はスクラッチコピーを削除します。
保存済みのブラウザーログイン情報は、有効期限まで 24 時間以内になった場合、または読み取り時にログイン画面が表示された場合に再コピーできます。これは、そのサイトについて記録済みの許可がある場合、実行時に --yes を指定した場合、またはターミナルで確認した場合にのみ行われます。それ以外の場合、searchts はコピーをスキップしたこととその理由を表示します。login signin で保存したログイン情報には再コピー元のブラウザーがないため、login signin をもう一度実行するよう案内するだけです。自動処理を行うたびに記録行(サイト、ブラウザーまたは signin、処理、件数、理由)が表示され、searchts read --json には同じ情報が cookie_actions に含まれます。Cookie の値が表示またはログに記録されることはありません。
search のフラグ:-n <count>、--json、--provider <name>。コンテンツは stdout に出力され(パイプで使用可能)、ステータスは stderr に出力されます。
grab のフラグ:--out <dir>、--kinds <images,icons,css,fonts,svg,inline_svg>、--scripts、--read(page.md も保存)、--max <n>、--tokens <n>(半径、影、間隔の値。デフォルト 24、上限 200)、--json。
read --media <n> は、ページに含まれるインラインメディアの保存数に上限を設定します。install --channels twitter,reddit,opencli,linkedin はオプションの連携機能を指定し、install --system-deps(別名 --apply)はシステムへの変更を許可し、install --env local|server|auto は対象を選択します。uninstall --keep-config は設定ディレクトリを残し、skill install --dir <dir> はスラッシュコマンドを別の場所に書き込みます。その他の動詞は check-update、setup、watch、version です。searchts help --json は機械可読なカタログです。すべてのフラグ、デフォルト値、使用例については docs/cli.md を参照してください。
AI エージェントから使用する
1 行で searchts をエージェントに追加できます。MCP サーバーとして、または Claude Code のスラッシュコマンドとして使用できます。
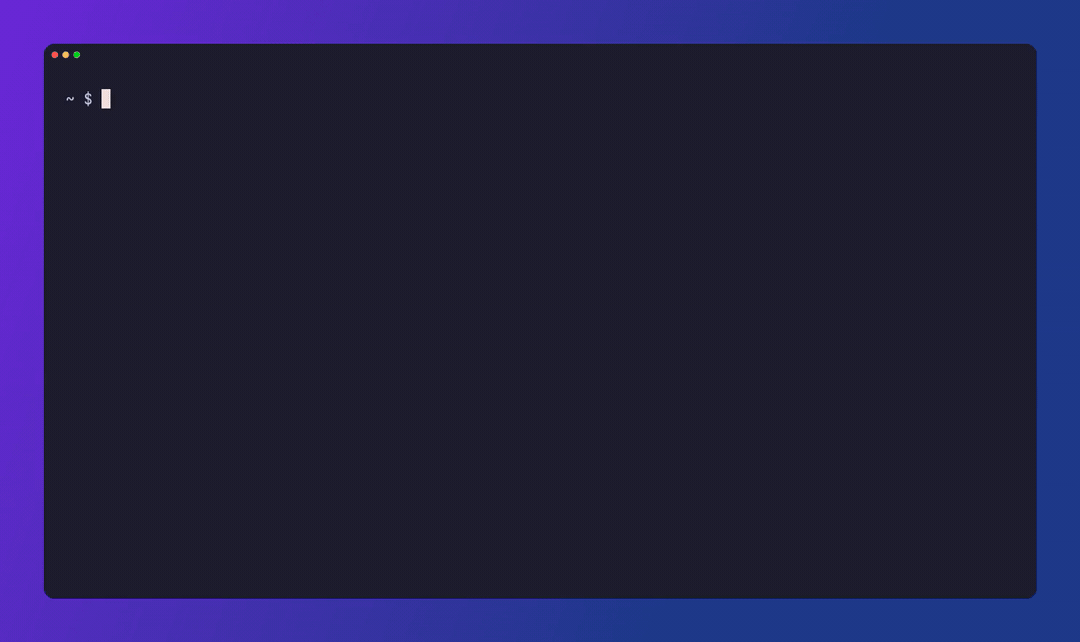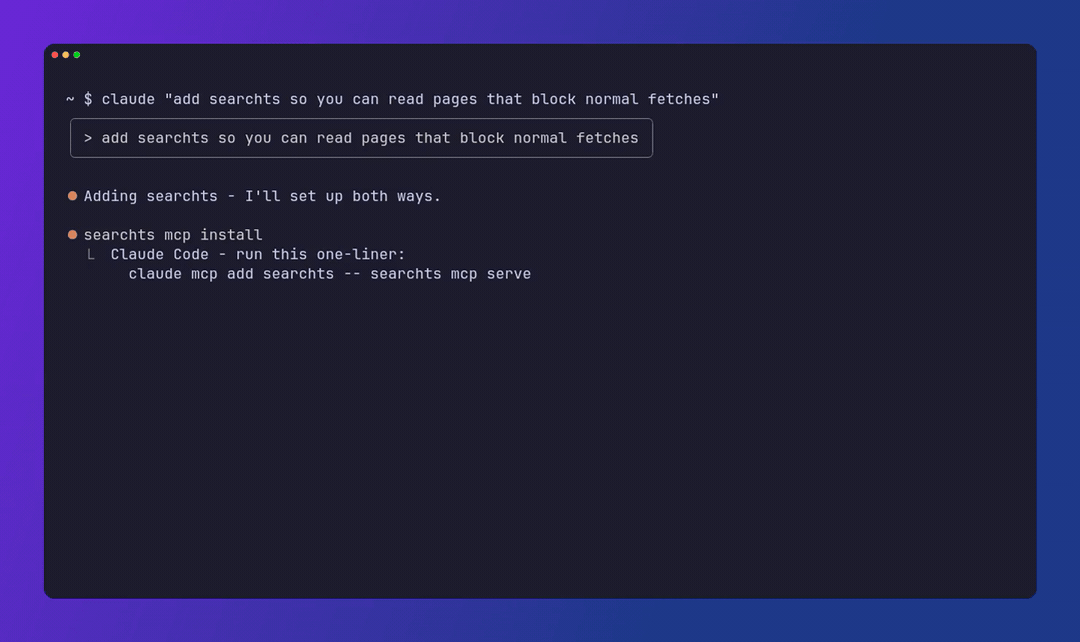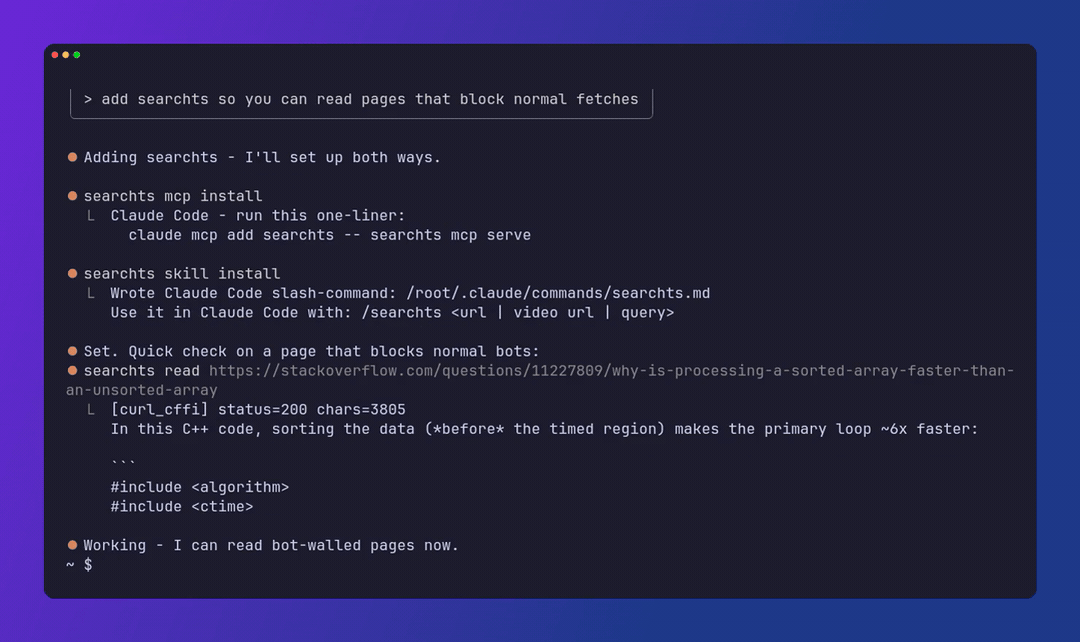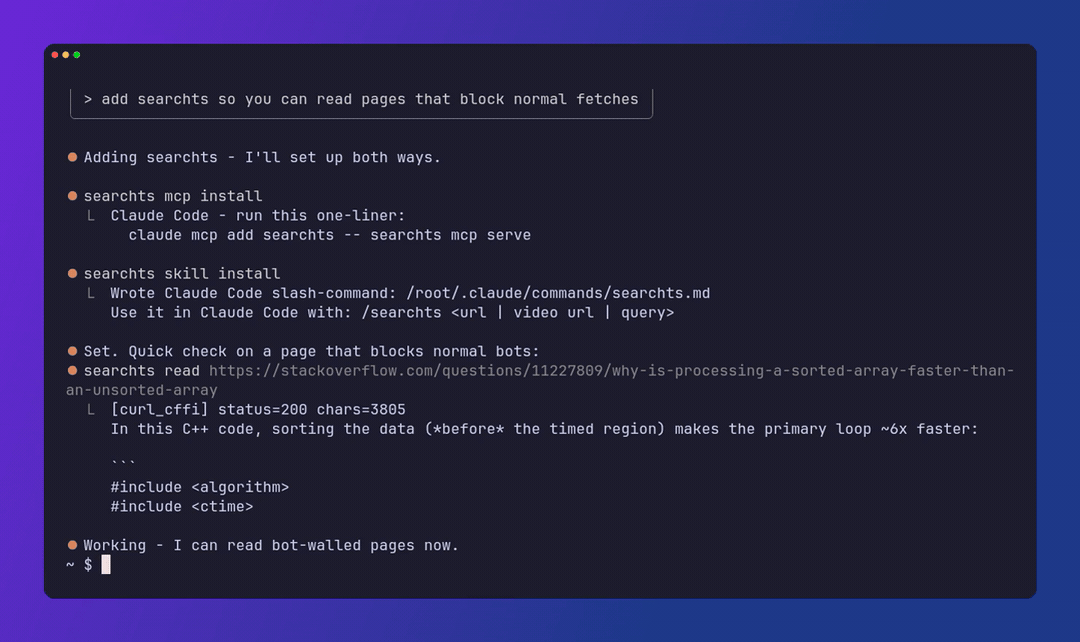
どちらも 1 つのコマンドで実行できる 2 つの方法です。
# 1) MCP: always-on read_url + web_search + fetch_asset + grab_site + get_status + transcribe + login_status / login_signin / login_check / login_kill
# Try / no install / Claude cannot see PATH:
claude mcp add searchts -- uvx --from "searchts[mcp]" searchts mcp serve
# Keep (after pipx install "searchts[mcp]"):
#   claude mcp add searchts -- searchts mcp serve
# Desktop / Cursor / the other local agents: `searchts mcp install`
# writes the stdio server into each client already on the machine.
# First read: Wikipedia shows more than example.com, which is one short paragraph.

# 2) Skill: /searchts in Claude Code, plus SKILL.md for Claude and OpenCode
searchts skill install        # ~/.claude/commands/searchts.md and the SKILL.md bundle
10 個すべてのツール(read_url、web_search、fetch_asset、grab_site、get_status、transcribe、login_status、login_signin、login_check、login_kill)、それぞれの入力と出力、使い分けについては、MCP サーバーのリファレンスをご覧ください。
機能
- 段階的にアクセス制限を解除するオープンソースの仕組み:curl_cffi、次に Jina Reader、最後にステルスブラウザーを使用します。
- 複数プロバイダーの検索と順位統合:DuckDuckGo(キー不要のデフォルト)に加え、設定に応じて SearXNG、Exa、Brave、Tavily を利用します。結果は逆順位統合によってマージされ、重複が取り除かれます。
- 動画の文字起こし:YouTube、TikTok、Instagram、Reddit の動画に対し、yt-dlp の音声と Whisper を使用します。
- アセットとデザインの取得:
searchts grab <url>はページの画像/アイコン/css/フォントをダウンロードし、カラーパレットと使用中のフォントを抽出します。searchts get <url>は単一のアセットを取得します。どちらも同じ段階的なアクセス解除手順を使うため、公開されている CDNs だけでなく、フィンガープリントによってアクセスが制限される CDNs でも動作します。 - プロンプトインジェクションの除去:不可視文字や双方向テキスト制御文字を取り除き、インジェクションの兆候を検出して、必要に応じて編集します。これにより、信頼できないページのコンテンツをモデルに渡す際の安全性が高まります。
- ドメインごとのバックエンド記憶:ドメインごとに動作した階層を記憶し、次回はその階層から試します(無効にするには
SEARCHTS_NO_MEMORY=1を設定します)。 - Jina のオプトアウト:JS レンダリングのリレーはデフォルトで有効です。
SEARCHTS_NO_JINA=1(または~/.searchtsの設定でjina: false)にするとスキップされるため、URL がr.jina.aiに送信されることはありません。 - 提供形態:CLI、MCP サーバー(
read_url、web_search、fetch_asset、grab_site、get_status、transcribe、login_status、login_signin、login_check、login_kill)、Python ライブラリ。
ライブラリとして使用する
from searchts import unlocker
r = unlocker.fetch("https://example.com")
print(r.backend, r.status, r.text)

from searchts.search import search
for hit in search("open source vector db", max_results=5):
    print(hit.title, hit.url)
仕組みと制限
- 無料パッケージは、個人利用の範囲でご自身の接続から実行します。プロキシプールは同梱されていません。
- 簡単なクリック 1 回を含むスクリプトチェックは、ステルスブラウザーが処理します。人の操作が必要なパズルや、ユーザーから提供されていないログイン情報が必要な場合は、引き続き処理できません。その場合は
--humanを使用してください。アクセス制限が接続元アドレスのみによる場合は、別の階層の問題です。この方法では解決できず、DataDome は不可能だと結論づける理由にもなりません。 - Reddit は既知ホスト用ファイルの 1 つであり、バイパスではありません。 一覧、スレッド、プロフィール、検索結果はカードとして読み取ります。
--itemsは Reddit 独自の次の投稿を示すカーソルをたどり、--expandは「返信をもっと見る」のコントロールを開きます。そのためブラウザー階層が引き続き必要であり、すべての Reddit URL を読み取れるという保証もありません。どの階層で応答できるかはブラウザープロファイルによって異なります。Reddit が「人間であることを証明してください」というチェックを表示するかどうかは、接続元アドレスではなく、プロファイルの利用状況に基づいて判断されます。そのため、新規作成したプロファイルではページを開くたびにチェックが表示されますが、十分に使い込まれたプロファイル(永続化された~/.searchts/browser-profile)では表示されません。この環境では、新しいプロファイルでの初回実行はどの階層でも拒否されましたが、数分後に同じコマンドを実行すると読み取れました。一時的なHOMEを使うとそのプロファイルは破棄されるため、使い捨ての CI 環境やテスト環境で測定できるのは、初回の応答だけです。ページがブロック画面の場合は、ナビゲーションバーを返すのではなく、その理由(非公開、停止、隔離、18 歳以上、削除済み、アーカイブ済み)を示します。 - 一部のプラットフォーム(特に Instagram と、2026 年時点の YouTube)では、ブラウザーの Cookie が必要になるか、動作が不安定になることがあります。これはプラットフォーム側の事情です。
- ボット対策システムは進化します。これはいたちごっこであり、手法も定期的に更新が必要になる場合があります。各サイトの利用規約を守り、責任を持ってご利用ください。
設定
検索はキーなしで利用できます(DuckDuckGo)。それ以外はすべて任意で、searchts configure または .env で設定できます(.env.example を参照してください)。
- 検索プロバイダー:より多く、質の高い結果を得るには、Exa、Brave、Tavily の API キー、またはセルフホストの
SEARXNG_URLを設定します。 - 文字起こし:Groq または OpenAI(Whisper)のキーを設定します。
ffmpegとyt-dlpは searchts に同梱されています(PATH 上にffmpegがある場合は、そちらが優先して使われます)。ログインが必要な動画の場合:searchts transcribe URL --cookies-from-browser chrome(オプトインです。readにも独自のオプトインがあります。上記のreadフラグを参照してください)。 - GitHub トークン:レート制限を緩和できます。
searchts doctor を実行すると、設定済みの項目と動作状況を確認できます。
任意の連携機能
コア機能は read / search / transcribe です。すべての searchts read は
unlocker.fetch を経由します。プラットフォームごとのルーターはありません。searchts doctor は
任意の CLI(gh、twitter-cli、opencli、mcporter)が PATH 上にあり、
認証済みかどうかのみを確認します。これらが存在することは、searchts がそれらの CLI を通じて
各サイトを読み取ることを意味するものではありません。
ロードマップ
未完了の作業については PLAN.md をご覧ください。ROADMAP.md は方向性を示すもので、タスクリストではありません。すでにリリース済みの内容は docs/plan-shipped.md をご覧ください。
クレジット
searchts は Agent-Reach(MIT)を基盤に拡張し、そのチャネル、インストーラー、診断アーキテクチャを再利用しています。段階的にアクセスを解除するオープンソースのアンロッカー、ランキング統合によるマルチプロバイダー検索、プロンプトインジェクションの除去、ドメインごとのバックエンド記憶、ヒューマン・イン・ザ・ループ方式の CAPTCHA フロー、動画文字起こしチャネル、read_url / web_search MCP ツール、read / search CLI コマンドは、searchts で追加されたものです。原作者の皆さまに感謝します。
ライセンス
MIT。LICENSE をご覧ください。元の部分の著作権は Agent Eyes に帰属します(Copyright (c) 2025)。変更および追加部分の著作権は capad-xyz に帰属します(Copyright (c) 2026)。
capad が開発しました。ご質問やフィードバックがある場合は、issue を作成するか [email protected] までメールでご連絡ください。
豆知識:「searchts」は正式には何かの略語ではありません。内輪の話ですが、「search this shit」の略です。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。