Browser Scraper について
Browser Scraperは、ChromeでWebページを抽出・操作するNode.jsライブラリ、CLI、MCPサーバーです。Markdown、メタデータ、アクセシビリティスナップショットを取得し、クローズドShadow DOMやクロスオリジンiframeにも対応します。AIエージェントやスクレイピングの用途を想定しています。
主な機能
- 01DevTools Protocol経由のChrome操作
- 02Markdown・メタデータ・リンクの抽出
- 03クリック可能な参照付きアクセシビリティスナップショット
- 04クローズドShadow DOMとiframeの走査
- 05必要に応じたHTTPからブラウザーへの切り替え
- 06MCPサーバー、CLI、任意のLLM抽出
活用シーン
- 01エージェントのワークフロー向けページ抽出
- 02ボット対策ページの閲覧と操作
- 03スナップショットによる操作要素の確認
- 04変化するサイトからの構造化データ収集
MCP 対応
MCPサーバーとして動作し、ブラウザーのナビゲーション、スナップショット、クリック、入力、Markdown・メタデータ抽出、スクレイピング、スクリーンショット、Turnstile操作をツールとして公開します。ドメイン許可リストとシークレット用プレースホルダーを設定できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
13掲載時のツール一覧 · 今日に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| url | string | はい | 絶対 http(s) URL。 |
| waitUntil | enum | いいえ | load | domcontentloaded | networkidle0 | networkidle2 |
詳細
Browser Scraper:ウェブスクレイピングとAIエージェント向けのステルスブラウザー
ボットをブロックするサイトを読み取り、操作するNode.js向けの検出されないChromeです。ライブラリ、CLI、またはClaude、Cursor、Codex向けのMCPサーバーとして利用できます。クローズドShadow DOMやクロスオリジンiframeを含むあらゆるページを、エージェントがクリックして操作できる、クリーンなMarkdown、構造化データ、またはアクセシビリティスナップショットに変換します。ローカルで無料、MITライセンス、LLMはご自身で用意してください。



CreepJS:ヘッドレス判定 0%、ステルス判定 0% · bot.sannysoft.com:失敗 0件 · Runtime.enable の漏えいなし (意味と限界について)
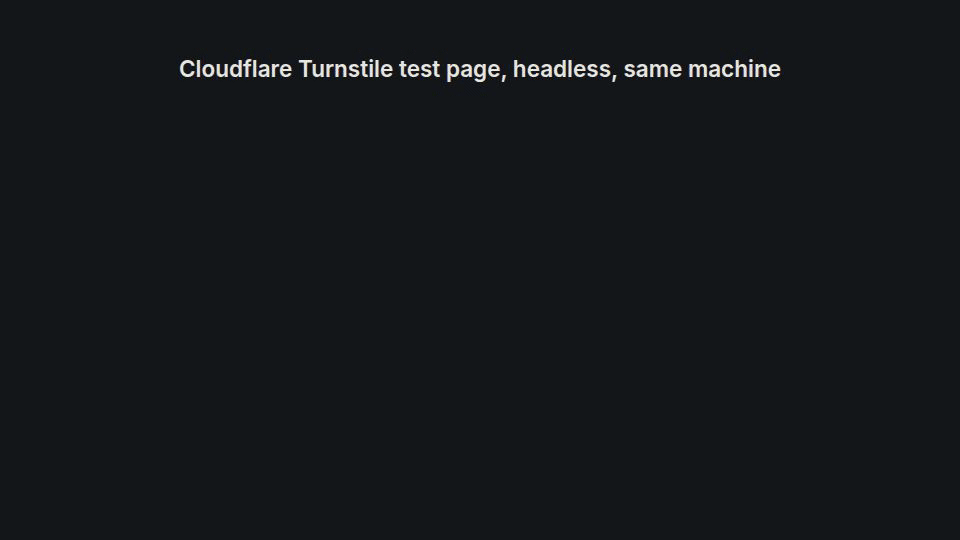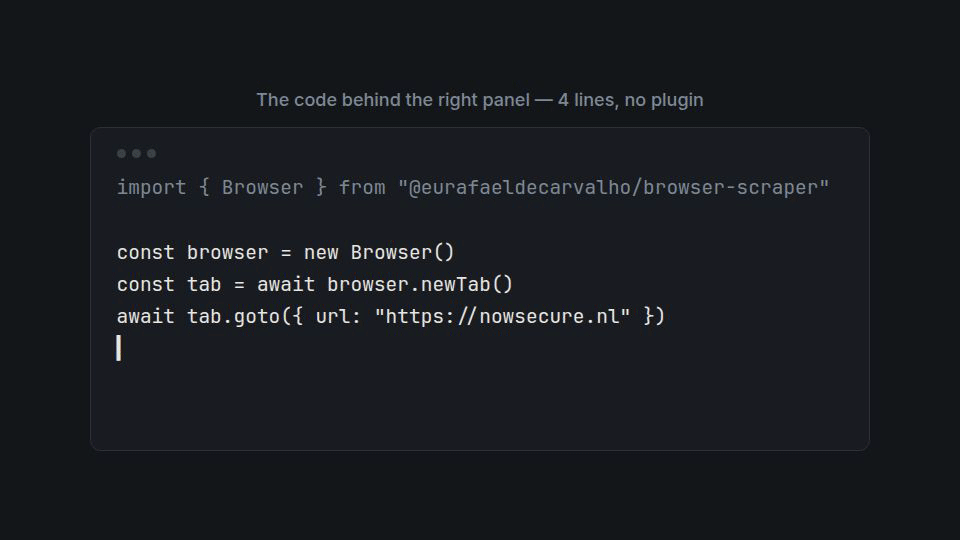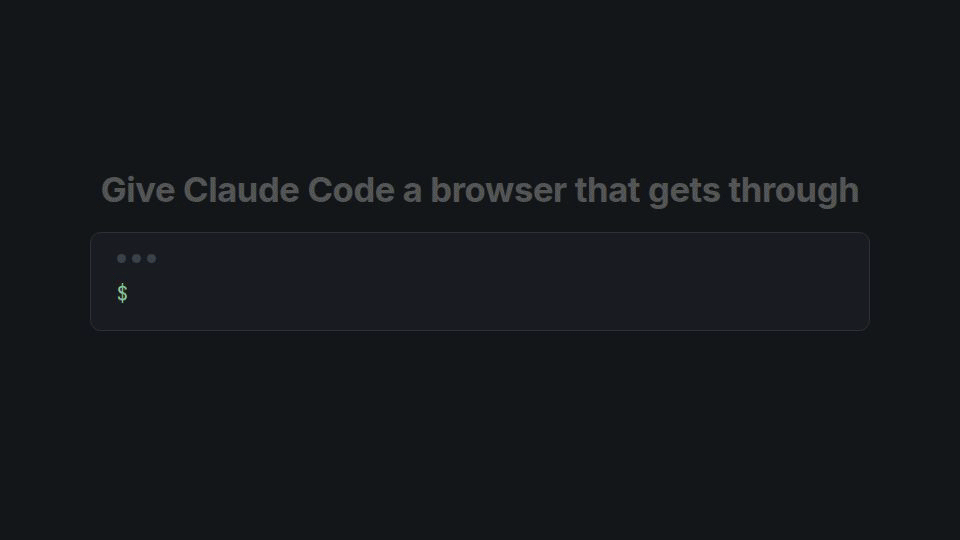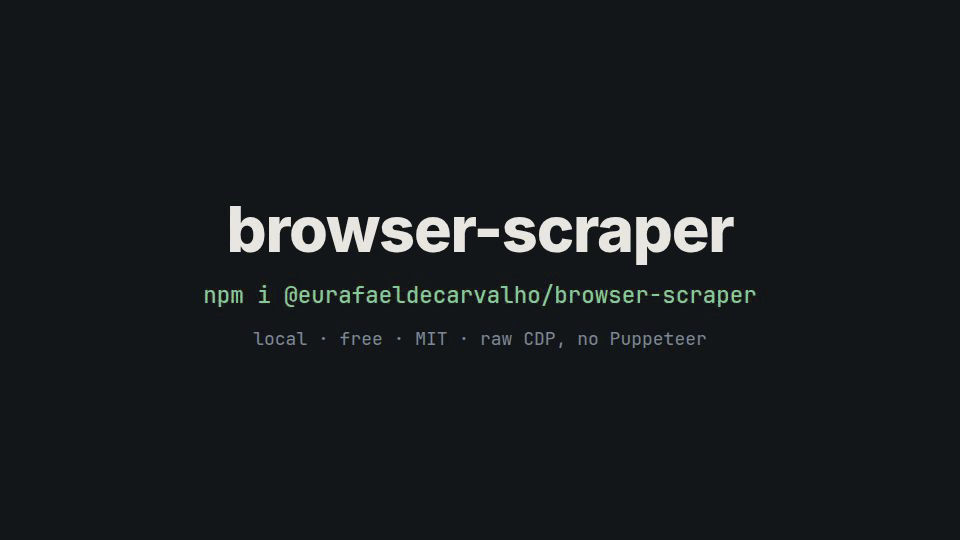
1台のデスクトップPCで記録:headlessモードのnowsecure.nlにあるTurnstileテストページ、およびPC内蔵GPUでheadfulモードで動作するbot.sannysoft.com。
import { scrape } from "@eurafaeldecarvalho/browser-scraper";

const page = await scrape({ url: "https://example.com", formats: ["markdown", "metadata"] });
console.log(page.tier);     // "http" | "browser" | "stealth": the cheapest tier that worked
console.log(page.markdown); // clean, LLM-ready Markdown of the main content
# Give Claude Code a browser that gets through Cloudflare:
claude mcp add browser-scraper -- npx -y @eurafaeldecarvalho/browser-scraper mcp
@eurafaeldecarvalho/browser-scraper は、生のDevTools Protocol(CDP)を介して実際のChromeを操作します。最も広くフィンガープリントされている自動化シグナルの1つであるRuntime.enableは送信せず、ブラウザーのあらゆるレイヤーで一貫した情報を示します。このステルス機能を基盤に、AIワークロードに必要な機能を追加しています。Markdownとメタデータの抽出、クリック可能な参照を含むアクセシビリティスナップショット、必要な場合のみプレーンなHTTPからステルスブラウザーへ段階的に切り替える1回の呼び出しで使えるscrape()、MCPサーバー、そして任意のモデルを使ったオプションのLLM抽出です。
選ばれる理由:
- ヘッドレスブラウザーがブロックされるサイトにもアクセスできます。
Runtime.enableの漏えいがなく、ペルソナ(UA、Client Hints、WebGL、タイムゾーン、ロケール)に一貫性があり、マウスとキーボードの入力も人間のようです。solveTurnstile()はCloudflareのチェックボックスに対応します。 - あらゆる情報を取得できます。
find()、markdown()、snapshot()はすべて、PlaywrightのスナップショットやReadability形式の抽出ツールでは取得できない、クローズドシャドウルートやクロスオリジンiframeにもアクセスできます。 - エージェント向けに設計されています。 MCPサーバーとCLIは追加のインストールなしで動作します。認証情報は
{{SECRET}}プレースホルダーを使って入力するため、モデルに見えることはありません。許可リストでドメインを制限し、ページの内容は信頼できないデータとして明確に区切られます。 - LLMは効果がある場合にのみ使用します。
generateExtractor()はモデルにCSSセレクターを一度だけ生成させます。その後はrun()がLLMを使わずに抽出し、サイトが変更された場合はrunOrHeal()がセレクターを再生成します。 - ローカルで無料です。 クラウド、APIキー、ページごとの課金はありません。プロキシはご自身で用意してください。必要に応じて、Vercel AI SDK経由でOpenAI、Anthropic、Google、Ollamaなどのモデルを使うか、ご自身の関数を使用できます。
実際に使われているボット検出ツールを通過
適切なセットアップを行えば――クリーンな住宅用/モバイル IP と、レンダーハッシュを対象とする実 GPU(EC2 g4dn/g5)を組み合わせれば――browser-scraper は、ヘッドレス自動化をブロックするフィンガープリントテストやアンチボットスタックを通過できるよう設計されています。
| 検出/フィンガープリントテスト | アンチボット/WAF ベンダー | ||
|---|---|---|---|
bot.sannysoft.com — 失敗 0 件 | ✅ | Cloudflare (Turnstile) | ✅ |
| CreepJS — ヘッドレス 0%、ステルス 0% | ✅ | DataDome | ✅ |
bot-detector.rebrowser.net | ✅ | Kasada | ✅ |
| Pixelscan | ✅ | Akamai Bot Manager | ✅ |
| IPHey | ✅ | PerimeterX / HUMAN | ✅ |
| Browserscan | ✅ | Imperva (Incapsula) | ✅ |
| Incolumitas | ✅ | Shape / F5 | ✅ |
| Fingerprint.com | ✅ | AWS WAF Bot Control | ✅ |
✅ はフィンガープリントと動作のレイヤーを通過することを示します。回避を保証するものではありません。 厳しいターゲットに対しては、IP のレピュテーションが上限を決めます。データセンター ASN は JavaScript の実行前に拒否されるため、住宅用/モバイルプロキシ経由で接続してください(本番環境のスタックを参照)。
browser-scraperは CAPTCHA ソルバーではありません。reCAPTCHA v2/hCaptcha/Arkose(FunCaptcha)の画像チャレンジには、ソルバーサービスを組み合わせてください。一方、人間らしい入力とウォームアップ済みプロファイルにより、reCAPTCHA v3 のスコアは高く保てます。
数値はデスクトップ版 Chrome で取得しました。GPU のない Lambda で chrome-headless-shell(
@sparticuz/chromium)を実行すると、サーフェスが異なります。実際に本番環境で使うバイナリでテストを再実行し、それを正確な基準として扱ってください(クラウドへのデプロイを参照)。
これは精密なツールであり、魔法のように回避するものではありません。限界についても率直に説明しています(注意事項と制限を参照)。その率直さがあるからこそ、上記の緑色のチェックには意味があります。
目次
- インストール
- クイックスタート
- AI エージェントと LLM 向け — Markdown、
scrape()、スナップショットと refs、MCP サーバー、CLI、LLM 抽出 - ツアー — 機能を例で紹介
- API リファレンス
- ステルスの詳細
- クラウドホスト上の WebGL / GPU
- 本番環境のスタック — プロキシ · VPS · ソルバー
- クラウドへのデプロイ(Lambda と EC2-GPU の比較)
- ID と永続化
- WebRTC
- 代替手段 — 比較
- よくある質問
- 注意事項と制限
- サポート
インストール
npm install @eurafaeldecarvalho/browser-scraper
または:
pnpm add @eurafaeldecarvalho/browser-scraper
Node.js ≥ 20 とローカルの Chrome/Chromium が必要です(自動的に検出されますが、chromePath で指定することもできます)。AWS Lambda の場合は、オプションの @sparticuz/chromium もインストールしてください。クラウドへのデプロイを参照してください。プロファイル履歴のシードには、Node 組み込みの node:sqlite(Node ≥ 22.5)またはオプションの better-sqlite3 を使用します。どちらも利用できない場合は、単にスキップされます。LLM ヘルパーには ai(Zod スキーマを使う場合は zod も)が必要です。これらが必要なのは /ai をインポートする場合のみです。
クイックスタート
import { Browser } from "@eurafaeldecarvalho/browser-scraper";

const browser = new Browser();

try {
  const tab = await browser.newTab();
  await tab.goto({ url: "https://example.com" });

  const heading = await tab.find({ selector: "h1" });
  console.log(await heading?.text());

  await tab.screenshot({ path: "example.png" });
} finally {
  await browser.close();
}
ライブラリの全体像はこれだけです。Browser、Tab、そして検索して操作する Element。以下では、この 3 つを基に詳しく説明します。
AI エージェントと LLM 向け
Markdown、メタデータ、リンクをすっきりと取得
const tab = await browser.newTab();
await tab.goto({ url: "https://shop.example.com/product/42" });

const { markdown, title, links, wordCount } = await tab.markdown({
  mainContent: true,      // drop nav/header/footer/cookie banners (default)
  query: "price shipping", // optional: keep only the relevant blocks (BM25), saves tokens
  links: "inline",        // "inline" | "reference" | "none"
  includeIframes: false,  // true = also inline iframe documents, cross-origin included
});

const meta = await tab.metadata();
// { title, description, canonical, lang, image, openGraph, twitter, jsonLd: [...] }
// JSON-LD often already has the price, rating and availability: check it before you prompt.
markdown() は、CDP(pierce を指定した DOM.getDocument)を介して Chrome 独自の DOM ツリーを読み取ります。ページにスクリプトを注入することはなく、閉じたシャドウルートのコンテンツもスロットを合成した読み取り順で含まれます。すでに手元にある HTML については、ブラウザーを使わずに htmlToMarkdown(html) と extractMetadata(html) で同じ処理ができます。
scrape():1 回の呼び出しで、最も低コストなティアから実行
import { Browser, scrape } from "@eurafaeldecarvalho/browser-scraper";

const browser = new Browser({ proxy: process.env.PROXY });   // reuse it across URLs
const page = await scrape({
  url,
  browser,
  formats: ["markdown", "metadata", "links", "html", "screenshot"],
  strategy: "auto",   // http → browser → stealth (or pin one tier)
  http: { curlImpersonate: "curl_chrome131" }, // optional: real Chrome TLS for the http tier
});

page.tier;      // which tier produced the result
page.attempts;  // [{ tier: "http", ok: false, reason: "needs JavaScript (empty app shell)", ms: 4 }, …]
| ティア | 実行内容 | 使用する状況 |
|---|---|---|
http | Chrome を使わずに 1 回リクエストします(Node fetch、または本物の Chrome JA3/JA4 を実現する curl-impersonate) | 静的ページ、API |
browser | ステルス Chrome | HTTP レスポンスがブロックされた場合(403/429/503)、チャレンジが表示された場合、または JS アプリのシェルが空の場合 |
stealth | 同じタブに、動作のウォームアップとインタラクティブな Turnstile の解決を加えます | ブラウザーでもチャレンジページが表示される場合 |
チャレンジページがコンテンツとして返されることはありません。すべてのティアでブロックされた場合、scrape() は attempts を含む ScrapeError をスローします。
アクセシビリティスナップショットと参照(エージェントがクリックする対象)
console.log(await tab.snapshot());
// - main
//   - heading "Sign in" [level=1]
//   - textbox "Email" [ref=e3]
//   - button "Continue" [ref=e4]
//   - Iframe [ref=e5]
//     - checkbox "Verify you are human" [ref=e6]   ← cross-origin iframe, still addressable

await (await tab.byRef({ ref: "e3" })).type({ text: "[email protected]" }); // human-like typing
await (await tab.byRef({ ref: "e4" })).click();                          // human-like mouse
アクセシビリティツリーは合成ツリー上で計算されるため、閉じたシャドウルート内の要素も表示され、クリックできます。クリックまたは入力が可能な要素だけのフラットなリストを取得するには、{ interactive: true } を渡します。
MCP サーバー(Claude Code、Claude Desktop、Cursor、Codex…)
claude mcp add browser-scraper -- npx -y @eurafaeldecarvalho/browser-scraper mcp
または、任意の MCP クライアント設定(claude_desktop_config.json、.cursor/mcp.json、…)で設定します。
{
  "mcpServers": {
    "browser-scraper": {
      "command": "npx",
      "args": ["-y", "@eurafaeldecarvalho/browser-scraper", "mcp", "--allowed-domains", "example.com", "--secrets", "/path/to/.env"]
    }
  }
}
ツール:
| ツール | 機能 |
|---|---|
navigate | URL を開き、スナップショットを返します |
snapshot | [ref=…] を含むアクセシビリティの概要 |
click | 人間のような入力で、参照を指定して要素をクリックします |
type | 人間のような入力で、参照を指定して要素に入力します |
press_key | キーを押します |
go_back | 履歴を戻ります |
wait | 指定した秒数だけ待機します |
markdown | メインコンテンツを Markdown として取得します。query を指定できます |
metadata | JSON-LD、OpenGraph、その他のページメタデータ |
screenshot | PNG スクリーンショット |
solve_turnstile | インタラクティブな Cloudflare Turnstile を解決します |
scrape | ティアを段階的に上げながら取得するワンショット処理 |
check_egress | 外部への接続に使う IP がデータセンターのものに見えるか確認します |
保護機能:
--allowed-domains a.com,b.comを指定すると、リスト外への移動を拒否し、リスト外に移動するクリックを元に戻します。--secrets .envを指定すると、エージェントは{{PASSWORD}}を入力できます。値はキー入力時に入力され、返されるすべての内容から伏せられます。- ページのコンテンツは、必ず
<untrusted-page-content>マーカーで囲んで返されます。 - その他のオプション:
--proxy、--headful、--user-data-dir、--geo BR。MCP Registry にもサーバーが登録されています(server.json)。Agent Skill も含まれています。
CLI
npx @eurafaeldecarvalho/browser-scraper markdown https://example.com --query pricing
npx @eurafaeldecarvalho/browser-scraper scrape https://example.com --format markdown,metadata,links --json
npx @eurafaeldecarvalho/browser-scraper snapshot https://example.com --interactive
npx @eurafaeldecarvalho/browser-scraper scrape https://example.com --format screenshot --out page.png
LLM による抽出:@eurafaeldecarvalho/browser-scraper/ai
これはオプションであり、使用しない限り追加のものはインストールされません。Vercel AI SDK のモデル(npm i ai @ai-sdk/anthropic、または openai、google、ollama…)または独自の llm 関数を渡します。スキーマには Zod またはプレーンな JSON Schema を使用できます。
import { extract, generateExtractor, Extractor, observe } from "@eurafaeldecarvalho/browser-scraper/ai";
import { anthropic } from "@ai-sdk/anthropic";
import { z } from "zod";

const Product = z.object({ name: z.string(), price: z.number(), inStock: z.boolean() });
const model = anthropic("claude-sonnet-5-5");

// 1) One LLM call per page.
const product = await extract({ tab, schema: Product, model });
//    input: "markdown" (default) | "snapshot" | "image" (screenshot for vision models)

// 2) The LLM writes the selectors ONCE; later pages cost nothing.
const extractor = await generateExtractor({ tab, schema: z.array(Product), model });
await extractor.save({ path: ".extractors/products.json" });

const again = await Extractor.load({ path: ".extractors/products.json", schema: z.array(Product), model });
const items = await again.run({ tab });                 // no LLM, runs in the isolated world
const { data, via } = await again.runOrHeal({ tab });   // via: "selectors" | "healed" | "llm"

// 3) Find elements by description: the model only LOCATES, your code acts.
const [login] = await observe({ tab, model, instruction: "the login button" });
await login.element.click();
モデルが手元にない場合でも、llm: async ({ system, prompt, schema, images }) => myClient.json(...) のように指定すれば、任意のプロバイダーやローカルモデルで動作します。
ツアー
よく使う各機能を、実際の使用方法に沿って紹介します。
1 つの find() で、閉じた Shadow DOM とクロスオリジン iframe を検索
find() は中心となる機能です。CSS セレクターを渡すと、メインドキュメント、閉じたシャドウルート、クロスオリジン iframe を 1 回の呼び出しで検索します。サンドボックス化された iframe の 3 階層奥にある CAPTCHA のチェックボックスも、トップレベルの <h1> とまったく同じ方法で見つかります。
// Reaches into a closed shadow root or an OOP iframe automatically — no frame plumbing.
const checkbox = await tab.find({ selector: "input[type='checkbox']", timeout: 12_000 });
await checkbox?.click();

// Returns null on timeout instead of throwing, so branching is clean:
const banner = await tab.find({ selector: ".cookie-banner", timeout: 2_000 });
if (banner) await banner.click();

// Collect every match (also shadow- and iframe-aware):
const links = await tab.findAll({ selector: "a[href]" });
for (const link of links) console.log(await link.getAttribute({ name: "href" }));
適切なタイミングを待つ
実際のページは段階的に読み込みが完了します。何となく待つのではなく、実際に待ちたい条件に合ったものを選んでください。
// Navigation: same waitUntil names as Puppeteer — load | domcontentloaded | networkidle0 | networkidle2
await tab.goto({ url, waitUntil: "networkidle2", timeout: 45_000 });

// "ready" = visible AND interactable (enabled, not busy) — the state you want before a click
await tab.waitForSelector({ selector: "button.submit", state: "ready", timeout: 30_000 });

// Arbitrary page predicate
await tab.waitForFunction({ expression: "window.__APP_READY__ === true" });

// Whichever finishes first — selector appears, or a JS condition flips. Great for success-or-challenge forks:
const winner = await tab.race({
  selectors: [".dashboard"],
  jsFunctions: ["document.querySelector('.captcha') !== null"],
  timeout: 30_000,
});
人間のように操作
入力はデフォルトで人間らしく処理されます。リアルさはコードではなく、ライブラリによって実現されています。
const button = await tab.find({ selector: "#cta" });
await button?.click();                      // cursor travels a Bézier path, then presses

await button?.click({ humanLike: false });  // opt out: dispatch straight at the target
await button?.click({ removeNewTabTarget: true }); // strip target/formtarget, stay in this tab

const input = await tab.find({ selector: "#email" });
await input?.type({ text: "[email protected]", clear: true });          // real keyDown/keyUp, lognormal timing
await input?.type({ text: "[email protected]", typos: true });          // opt-in: occasional misstroke + self-correct

// Ambient motion before a token-minting call (grecaptcha.execute) or a high-value submit:
// a "blind execute" with no prior pointer/scroll activity tanks a reCAPTCHA v3 score.
await tab.ambientActivity({ durationMs: 1200 });
type() と pressKey() は、正しい keyCode/code を持つ本物の keyDown/keyUp イベントを送信するため、名前付きキー(Enter、Tab、ArrowDown)は、合成的に value を直接変更するのではなく、実際のキーボードのように動作します。
ネットワークを制御
従量制プロキシの帯域幅を節約したり、トラッカーを停止したり、リクエストを書き換えたりできます。ページを壊して、それ自体がボットのように見えることはありません。
// Block by HOST so the page still renders normally — safest near anti-bot/captcha,
// which read a broken page as a bot signal:
await tab.blockResources({ urls: ["*googletagmanager.com*", "*adobeaemcloud.com*"] });

// Or block whole resource types to trim bandwidth:
await tab.blockResources({ types: ["Image", "Media", "Font"] });

// Full control: inspect each request and decide:
tab.network.intercept({
  pattern: "*",
  resourceType: "Image",
  handler: async (req) => {
    if (req.url.includes("keep-me")) return req.continueRequest();
    await req.abort({ reason: "BlockedByClient" });
  },
});

// Just watch the traffic go by:
tab.network.on({ event: "response", handler: (res) => console.log(res.status, res.url) });
ブロック機能は認証済みプロキシとスムーズに併用できます。単一の Fetch.enable でプロキシ認証情報とブロックルールの両方を設定するため、互いに上書きしません。
一貫性のあるブラウザーフィンガープリント(User-Agent、Client Hints、WebGL、タイムゾーン)
最も強力なフィンガープリント対策は、単一の偽装ではありません。あらゆる要素が互いに矛盾しないことです。ペルソナを一度設定すれば、すべてのレイヤーに反映されます。
const browser = new Browser({
  geoCountry: "BR",       // sets timezone + locale + Accept-Language together, in sync
  spoofWebGL: true,       // OS-coherent WebGL string derived from the UA (soft targets)
  proxy: "http://user:pass@residential-proxy:8000",
});

// Or adjust a live tab — one call keeps language, navigator.languages,
// Accept-Language, and timezone consistent. Match it to your proxy's region:
await tab.emulateLocale({ locale: "pt-BR", timezone: "America/Sao_Paulo" });
プロキシの出口国が事前にわからない場合は、autoGeo: true を設定してください。最初の newTab() でプロキシ経由で出口国を調べ、位置情報を自動設定します。
プロファイルの永続化とウォームアップ
reCAPTCHA v3 は評判をスコアリングするため、使い捨てのプロファイルには評判がありません。同一のIPアドレスを維持したまま同一のIDを使い続け、ウォームアップしてサーバーに本物のCookieを発行させましょう。
import { Browser, ProfileStore, warmProfile } from "@eurafaeldecarvalho/browser-scraper";

const store = new ProfileStore({ baseDir: "/mnt/efs/profiles" }); // EFS, or sync to S3 between runs
const browser = new Browser({
  userDataDir: store.dirFor("identity-42"),
  proxy: "http://user:pass@sticky-residential:8000",
  geoCountry: "BR",
});

const tab = await browser.newTab();
await warmProfile(tab); // genuine navigations + ambient motion so cookies/history accrue
同一のID、同一の固定IP、同一のフィンガープリントを使っていても、ローテーションするデータセンターIPの背後にあるウォームアップ済みプロファイルでは何も得られません。
API リファレンス
ブラウザー
new Browser({
  chromePath: null,
  headless: false,
  userDataDir: null,
  proxy: null,            // http(s):// or socks5:// (auth only on http(s) — Chrome can't auth SOCKS)
  extraArgs: [],
  autoSeed: true,

  // --- stealth / persona (all derived coherently from the resolved UA) ---
  userAgent: null,        // override the UA for the WHOLE persona (WebGL OS default,
                          // Client-Hints, platform) and apply it via --user-agent at launch.
                          // Keep the Chrome major matching the host build.
  spoofWebGL: false,      // OS-coherent WebGL identity (soft targets only; off on real GPU)
  webglVendor: null,      // explicit override (must match the UA's OS)
  webglRenderer: null,
  geoCountry: null,       // ISO-2, e.g. "BR" => timezone + locale + Accept-Language together
  autoGeo: false,         // detect the proxy exit country at first newTab() and set geoCountry
  timezone: null,         // explicit overrides for the above
  locale: null,
  acceptLanguage: null,
  hardwareConcurrency: null, // re-applied per worker session to stay coherent main↔worker
  screen: null,           // { width, height } => device-metrics + window.screen/outerWidth
  windowSize: null,       // { width, height } => --window-size (defaults to screen or 1920x1080)
  evasions: true,         // webdriver / Notification / screen init scripts
  lambda: false,          // adds --no-sandbox --disable-dev-shm-usage for containers
  warnOnDirectEgress: true,  // warn once when launching with no proxy

  // --- Lambda / chrome-headless-shell (@sparticuz/chromium) ---
  channel: null,          // "headless-shell" => binary is chrome-headless-shell:
                          // never add --headless=new, own the software-WebGL flags,
                          // ensure HOME/XDG/user-data dirs, DBUS=/dev/null, and
                          // auto-apply the shell shims (window.chrome, connection).
  chromium: null,         // pre-resolved { executablePath, args, shellMode } from
                          // `await resolveSparticuz()`; implies channel:"headless-shell".
  onStderr: null,         // (chunk) => void : receive Chrome's stderr live. Even
                          // without it, stderr is captured and attached to the
                          // BrowserError on a launch timeout (real crash cause).
  screenCoordOffset: null,// OPT-IN { x, y }: MouseEvent.screenX/screenY = clientX+x /
                          // clientY+y to counter the CDP screenX==clientX artifact.
                          // VERIFY on your exact binary first (a ~Sep-2025 Chromium
                          // fix may already report correct coords).
});

await browser.newTab({ url: "about:blank" });
await browser.checkEgress();  // optional: report exit IP ASN + hosting flag
await browser.close();
**既知の強化上の未対応点(未対処):**このライブラリは、
127.0.0.1にバインドされたTCP--remote-debugging-portを通じてCDPを公開します。ページ内から同一オリジンでlocalhostを調べるプローブを、ランダムポートを使って完全にブロックすることはできません。この問題を解消するには、トランスポート全体を--remote-debugging-pipe(fd 3/4)に切り替える必要があります。これによりHTTP/json/*エンドポイントがなくなり、タブごとのWebSocketモデルが、単一セッションを多重化する接続に統合されます。そのため、トランスポートを大幅に書き換える必要があります。中途半端な状態でリリースするのではなく、独立した変更として意図的に残しています。重大度の低い攻撃ベクトルであり、ランダムポートとlocalhostへのバインドですでにリモートからのスキャンを軽減できます。
タブ
await tab.goto({ url, waitUntil: "load", timeout: 30_000 });
await tab.waitForNavigation({ waitUntil: "networkidle2", timeout: 30_000 });
await tab.find({ selector, timeout: 5_000 });
await tab.findAll({ selector });
await tab.waitForSelector({ selector, state: "attached", timeout: 30_000 });
await tab.waitForSelector({ selector, state: "ready", timeout: 30_000 });
await tab.waitForFunction({ expression, timeout: 30_000 });
await tab.race({ selectors: [".success"], jsFunctions: ["window.done === true"], visible: false, timeout: 30_000 });
await tab.evaluate({ expression: "document.title" });
// Read page-owned globals the isolated world can't see (the page's own window state,
// the live grecaptcha/turnstile objects). Opt-in; the isolated world is the default.
await tab.evaluate({ expression: "window.__APP_STATE__", world: "main" });
await tab.screenshot({ path: "shot.png" });
await tab.content();
await tab.sleep({ milliseconds: 2_000 });
// AI-ready content (no page JS; closed shadow DOM included)
await tab.markdown({ mainContent: true, query: "pricing", links: "inline", includeIframes: false });
await tab.metadata();            // OpenGraph, Twitter, canonical, JSON-LD
await tab.snapshot({ interactive: false }); // accessibility outline with [ref=eN]
await tab.byRef({ ref: "e4" });  // → Element (human-like click/type)
await tab.url();
await tab.title();
await browser.closeTab(tab);     // closes the page target (tab.close() only disconnects)

// History navigation
await tab.back();
await tab.forward();
await tab.reload();

// Input helpers
await tab.pressKey({ key: "Enter" });
await tab.mouse.moveTo({ x: 200, y: 300 });

// Emulation / stealth
await tab.addInitScript({ source: "/* runs before page scripts */" });
await tab.setUserAgent({ userAgent: "..." });
await tab.setExtraHeaders({ headers: { "Accept-Language": "en-US" } });
await tab.setViewport({ width: 1280, height: 800 });
await tab.setGeolocation({ latitude: -23.55, longitude: -46.63 });
await tab.setTimezone({ timezoneId: "America/Sao_Paulo" });
await tab.setLocale({ locale: "pt-BR" });
// One call that keeps language + navigator.languages + Accept-Language + timezone
// consistent — match this to your proxy's region to avoid a geo mismatch.
await tab.emulateLocale({ locale: "pt-BR", timezone: "America/Sao_Paulo" });
await tab.bringToFront();
await tab.pdf({ path: "page.pdf" });

// Native dialogs (alert/confirm/prompt/beforeunload)
tab.onDialog(async (dialog) => {
  await dialog.accept();
});

// Human-like ambient motion BEFORE a token-minting call (grecaptcha.execute) or a
// high-value submit — a "blind execute" with zero prior pointer/scroll activity
// tanks a reCAPTCHA v3 score.
await tab.ambientActivity({ durationMs: 1200 });

// Cloudflare Turnstile (INTERACTIVE checkbox): wait for the widget, human-click it,
// poll for the token. Built on the lib's own primitives (no third-party solver).
// For an INVISIBLE widget, read the token directly with turnstileToken(). Best
// behind a residential IP — the click can't rescue a datacenter-IP session.
const { solved, token } = await tab.solveTurnstile({ timeoutMs: 30_000 });
const t = await tab.turnstileToken();        // live cf-turnstile-response, or null

// Inject a warmed cookie bundle via CDP (encrypted with the live profile key —
// unlike the inert SQLite seeding). Each cookie needs a `domain` or `url`.
await tab.setCookies({ cookies: [{ name: "NID", value: "...", domain: ".google.com", secure: true }] });

// Surface a mid-run Chrome death as a typed, recoverable error for THIS run
// (in-flight CDP commands reject immediately instead of hanging to a 30s timeout).
tab.onDisconnect((error) => { /* abort this run gracefully */ });
waitUntil は、Puppeteerと同じ公開名(load、domcontentloaded、networkidle0、networkidle2)に従います。
タイムアウトとスリープはすべてミリ秒単位です。
waitForSelector({ state: "visible" }) は、可視状態のみを待ちます。
waitForSelector({ state: "ready" }) は、可視状態に加えて操作可能な状態を待ちます。一般的なボタンの状態について、有効かどうかやビジー状態でないかどうかも確認します。
ネットワーク/リクエストのブロック
// Drop bandwidth-heavy resources (handy to cut metered-proxy traffic).
// Block by HOST to keep the page rendering normally — safest around anti-bot /
// captcha, which read a broken page as a bot signal:
await tab.blockResources({ urls: ["*adobeaemcloud.com*", "*googletagmanager.com*"] });

// Or block whole resource types (Image, Media, Font, Stylesheet). With no proxy
// auth, only the listed types pause at the CDP level — scripts/XHR/documents are
// never intercepted:
await tab.blockResources({ types: ["Image", "Media"] });

// Lower-level equivalents:
await tab.network.block({ patterns: ["*.jpg", "*ads*"], resourceTypes: ["Font"] });
tab.network.intercept({
  pattern: "*",
  resourceType: "Image",
  handler: async (req) => {
    if (req.url.includes("keep-me")) return req.continueRequest();
    await req.abort({ reason: "BlockedByClient" });
  },
});

// Observe traffic:
const onResponse = tab.network.on({ event: "response", handler: (res) => console.log(res.status, res.url) });

// Detach handlers. Drain them before teardown so none fires (and issues a CDP
// command the closing socket would reject) while the connection is going down:
tab.network.off({ event: "response", handler: onResponse });
tab.network.removeAllListeners();
リクエストのブロック機能は認証済みプロキシと併用できます。単一の Fetch.enable
でプロキシ認証情報の処理とブロックルールの両方を設定するため、互いに
上書きしません。
HTTP 高速レーン(ブラウザーレス)
低コストで保護されていないエンドポイント(JSON API、静的HTML)では、必ずしもタブは必要ありません。browser.createHttpClient() を使うと、Chromeを起動せずにブラウザーのペルソナ(解決済みのUser-Agentと Accept-Language)およびプロキシを使って、単一のリクエストを送信できます。
const http = browser.createHttpClient({
  // Optional: a curl-impersonate binary gives a REAL Chrome TLS/JA3/JA4 + HTTP/2
  // fingerprint through the proxy. WITHOUT it, the Node `fetch` fallback is used
  // (coherent headers, but Node's TLS — fine for unprotected targets, a tell for
  // hard ones) and a proxy is REFUSED rather than leaking the host TLS/IP.
  curlImpersonate: "curl_chrome131",
});

// Reuse a warmed session by passing cookies pulled from a tab:
const cookies = Object.fromEntries((await tab.getCookies()).map((c) => [c.name, c.value]));
const res = await http.get("https://api.example.com/data", { cookies });
console.log(res.status, res.impersonated, res.body);
これは補完的な機能であり、ステルス機能の代替ではありません。実際のアンチボット機能で保護されているものには、タブを操作してください。
要素
await element.click();
await element.click({ humanLike: false });
await element.click({ removeNewTabTarget: true });
await element.hover();
await element.type({ text: "hello", clear: true });
await element.pressKey({ key: "Enter" });
await element.text();
await element.innerHtml();
await element.getAttribute({ name: "href" });
await element.setAttribute({ name: "data-test", value: "1" });
await element.getProperty({ name: "value" });
await element.boundingBox();
await element.isVisible();
await element.isChecked();
await element.selectOption({ value: "b" });
await element.setInputFiles({ files: ["/path/to/file.png"] });
await element.screenshot({ path: "element.png" });
click() はデフォルトで人間らしく動作します。押す前に、ベジェ曲線に沿ってカーソルを要素まで移動します。
click({ humanLike: false }) は、解決済みのターゲット位置で直接押下/解放イベントをディスパッチします。
click({ removeNewTabTarget: true }) は、クリック前に target と formtarget を削除します。これにより、可能な場合は操作が現在のタブ内で行われます。
type() と pressKey() は、本物の keyDown/keyUp イベント(正しい keyCode/code)をディスパッチするため、Enter、Tab、ArrowDown などの名前付きキーが機能します。
type({ typos: true })(オプトイン、デフォルトではオフ)は、ときどき隣接キーの打ち間違いと自動修正(Backspace)を挿入します。行動分析のスコアリングでは、人間らしい動作として評価されます。入力中に値を検証するフィールドや、キー入力ごとに検証するフィールドでは、オフのままにしてください。
ステルス機能の詳細
背景調査: reCAPTCHA v3/Enterprise とアンチボットベンダー(Cloudflare、DataDome/Picasso、PerimeterX/HUMAN、Kasada、Akamai、Imperva、securiti.ai、Arkose、hCaptcha)が実際にどのようにボットを検出するか、シグナル層の分類、および以下の各選択の設計根拠については、
docs/antibot-and-captcha-research.mdに記載されています。
このライブラリは、アンチボットベンダー(Cloudflare、DataDome、Kasada)が検出するシグナルを最小限に抑えるように構築されています。
Runtime.enableを使用しません。 すべての JavaScript はPage.createIsolatedWorldとRuntime.evaluateを通じて実行されます。これらは Runtime ドメインを有効にしない通常のコマンドです。コンテキストの無効化にはPage.frameNavigatedと古いコンテキストへの再試行で対応します。(検証結果:最もよく知られたプローブ、つまりインスペクターによるシリアライズ時に発生するError.stackゲッターのトリガーは、2025 年 5 月の V8 パッチでほぼ無効化されたため、かつてのように単独で最も支配的な判定要因ではなくなりました。ただし、Runtime.enableを回避すればRuntime.consoleAPICalledなど、ほかの Runtime ドメイン依存のシグナルも引き続き防げるため、これは今も適切な不変条件です。)- クリーンな User-Agent とクライアントヒント。
--headless=newでは、Chrome が UA とsec-ch-uaにHeadlessChromeを注入します。このライブラリはそれを取り除き、一致するuserAgentMetadataを適用することで、navigator.userAgentDataとの整合性を保ちます。 - タブごとに分離されたランダムな分離ワールド名(固定の
utilや Playwright の__playwright_utility_world__のようなマーカーではなく、ランダムなu…トークン)を使用するため、仮に情報が漏れても(たとえばErrorのスタックフレーム経由など)、ワールド名をセッションをまたいだ静的なシグネチャとして特定できません。 - 起動フラグでは、存在するだけでフィンガープリントになるオプション(
--disable-popup-blocking、--disable-component-update、--disable-extensions、--enable-automation)を避けています。 - 人間らしい入力。 マウス移動には、距離に応じたタイミング、移動中の微細な揺れ、弾道的な行き過ぎと修正を伴う、最小ジャークの速度プロファイルを使用します。タイピングでは、対数正規分布のキー押下時間と移動時間を使い、ときおりキーの重なりを発生させます。
tab.mouse.idle()は周期性のない、周囲に溶け込むカーソルのドリフトを追加します(grecaptcha.execute()の前に役立ちます)。 - 一貫性のあるペルソナ。 UA 文字列、Client-Hints(
platform、platformVersion、実際のfullVersionList、architecture)、WebGL ID、地域情報(タイムゾーン/ロケール/Accept-Language)はすべて、解決済みの 1 つの User-Agent から導出されます。これにより各層の矛盾を防ぎます。層をまたいだ不一致は、最も強い検出シグナルです。
少数の 条件付きで防御的な JS パッチがデフォルトで注入されます(evasions: false で切り替え可能)。起動フラグによってすでに設定されていない場合に限り、navigator.webdriver を存在する false ゲッターに固定します。Notification.permission は navigator.permissions.query と整合させます(実際の PermissionStatus を返し、state のみをマッピングするため、default は有効な prompt になります)。また、screen/windowSize が設定されている場合、window.screen/outerWidth を整合性のある最大化ウィンドウのジオメトリに正規化します。各パッチは toString() をネイティブのまま保ち、値がすでに適切な場合は何もしません(正しい値に対する過剰なパッチ適用も、それ自体が検出要因です)。navigator.hardwareConcurrency は Emulation.setHardwareConcurrencyOverride で固定します。このページセッションのオーバーライドはワーカーターゲットには適用されないため、ライブラリは各ワーカーの CDP セッションでも再設定します(自動アタッチ中に一時停止したままになってしまうため、ワーカーも再開します)。これにより、メインスレッドと Web/Shared/Service Worker 間で navigator.hardwareConcurrency の整合性を保ちます。メインスレッドとワーカー間の不一致は、値そのものより強い検出要因だからです。deviceMemory は意図的に偽装しません(ターゲットごとのオーバーライドがないため、メインワールドだけにパッチを適用するとワーカーとの不整合が生じます)。独自のスクリプトは tab.addInitScript({ source }) で追加できます。
bot-detector.rebrowser.net(runtimeEnableLeak なし、navigatorWebdriver なし、分離ワールドでの実行)、bot.sannysoft.com(失敗 0 件)、CreepJS(headless 0%、stealth 0%)で監査済みです。
本番バイナリで再測定してください。 これらの結果はデスクトップ版Chromeで取得したものです。GPUのないLambdaで chrome-headless-shell(
@sparticuz/chromium)を実行すると、window.chrome/navigator.pluginsがないこと、SwiftShader WebGL、コーデックなど、サーフェスが異なります。まさにこれをシムするのがchannel:'headless-shell'です。実際のsparticuzバイナリでスイートを再実行し、それを信頼できる唯一の情報源として扱ってください。
クラウドホストでのWebGL/GPU
お使いのマシンでは、WebGLは実際のGPUを報告します。GPUのないクラウドサーバーでは、ChromeはSwiftShader/llvmpipeにフォールバックし、レンダラーにSwiftShader/llvmpipeが含まれることは、ヘッドレス環境であることを示す既知のシグナルです。ただし、スプーフィングには注意すべき重大な落とし穴が2つあります。
-
レンダラーが実際にはあり得ないOSを名乗らないでください。
Direct3D11/D3D11というレンダラー文字列が存在するのはWindowsだけです。LinuxのUAでこれを出力するのは、あり得ない組み合わせであり、DataDome/Picassoにハードブロックされます。正直にソフトウェアレンダラーの文字列を使うより、明らかに不利です。現在のspoofWebGL: trueは、解決済みのUAからOSと整合性のあるデフォルト値を導きます(Linux→Mesa/ANGLE OpenGL、Windows→D3D11、macOS→Metal)。LinuxのUAでWindowsのGPUを示すことはありません。明示的なwebglRendererを渡した場合、バックエンドがUAのOSと矛盾するとライブラリが警告します(Linux/macOSでのD3D11文字列、Windows/macOSでのMesa/SwiftShader文字列、Windows/LinuxでのMetal文字列)。 -
getParameterだけのスプーフィングでは、強制レンダリングを回避できません。 オーバーライドで変更されるのはベンダー/レンダラーの文字列ですが、拡張機能の一覧、パラメーターの上限値、実際にレンダリングされたピクセルのハッシュは引き続きSwiftShader由来です。最上位のアンチボット(DataDome Picasso、Cloudflare、Kasada)はレンダリングを強制して照合するため、ソフトウェアレンダリング中にディスクリートGPUの文字列を示すと検出されます。このスプーフィングは、検出の緩いターゲット専用です。
// Soft targets: an OS-coherent default derived from the UA (Linux => Mesa string)
const browser = new Browser({ headless: true, spoofWebGL: true });

// Or pick exact strings (must match your UA's OS)
const browser = new Browser({
  webglVendor: "Google Inc. (Intel)",
  webglRenderer: "ANGLE (Intel, Mesa Intel(R) UHD Graphics (TGL GT1) (0x00009A60), OpenGL 4.6 (Core Profile) Mesa 23.2.1)",
});
Lambda/Linux+--headless=newターゲット向けの判断ガイド:
- 厳しいターゲット(DataDome/Cloudflare/Kasada): 文字列のスプーフィングでは、レンダーハッシュの検査を通過できません。実GPU(EC2
g4dn/g5+NVIDIAドライバー)を使い、スプーフィングをオフにしてください。WebGLに、内部的に整合性のある本物のハードウェアを報告させます。Picassoを通過する構成はこれだけです。 - 検出の緩いターゲット:
spoofWebGL: true(整合性のあるLinux文字列)で問題ありません。
--headless=newでは、ライブラリは常に--enable-unsafe-swiftshaderを追加します。Chrome 137以降ではソフトウェアWebGLへの自動フォールバックが削除されているため、これがないとGPUのないホストではgetContext('webgl')がnullを返し、それ自体が検出の手がかりになるうえ、スプーフィングも機能しません。実GPUがある場合は、引き続きGPUが使用されます。
オーバーライドはページのメインワールドで実行され、getParameter.toString()はネイティブに見える状態に保たれます。既知の制限として、対象はメインスレッドであり、Web Workers/OffscreenCanvasは対象外です。
本番環境のスタック
プロキシ · VPS · ソルバー — スクレイピングが成功するかどうかを左右する3つの要素です。このライブラリがブラウザーを担当し、これらがその周辺すべてを担います。ライブラリ自身のアドバイスも、まさにこれらを指しています。利用できるところでは読者向けの割引も用意しています。
| 必要なもの | 理由 — このライブラリ自身のアドバイスより | おすすめ(割引あり) |
|---|---|---|
| 住宅用/モバイルプロキシ | IPのレピュテーションが上限を決めます — JavaScriptが実行される前に、データセンターのASNでは負けてしまいます。最も効果の大きい要素です。 | IPRoyal — 通過できる中では最安のプール · Bright Data — 最も厳しいターゲット向けのプレミアムサービス |
| 24時間365日稼働させるVPS | 定期実行するスクレイピングには、ノートPCではなく、常時稼働のLinuxマシンが必要です。GPUなしのソフトウェアWebGL経路でも、難易度が低〜中程度のターゲットなら問題なく動作します。 | Hostinger VPS — このリンクから 20%オフ |
| CAPTCHAソルバー(必要に迫られた場合のみ) | このライブラリは設計上、ソルバーではありません — 画像/チェックボックス形式のチャレンジは外部に任せ、まずIPを改善してください。 | 2Captcha · Anti-Captcha |
難易度が高く、レンダリングハッシュを使うターゲット(DataDome Picasso、Kasada)には、安価なVPSではなく**実GPU搭載のEC2 g4dn/g5**に切り替え、spoofWebGLをオフにしてください — 詳細は以下のクラウドデプロイを参照してください。
プロキシ、VPS、CAPTCHAへのリンクはアフィリエイト/有料リンクです — 追加費用なしで割引を受けられ、私は紹介料を得る場合があります。私自身がトラフィックの経路として使っているツールです。
クラウドへのデプロイ(Lambda と EC2-GPU)
支配的なシグナルはフィンガープリントではなく、IP です。 AWS のエグレス IP を使う完璧なヘッドレス Chrome でも、データセンターの ASN は JavaScript が実行される前に ペナルティを受けるため、reCAPTCHA v3 のスコアは低くなり、Cloudflare/DataDome によるチャレンジが発生します。保護対象には、レジデンシャルプロキシまたはモバイルプロキシを経由してください。私が見つけた中で、IPRoyal はそれでもアクセスできる最安のレジデンシャル IP プールです(アフィリエイトリンク)。最も厳しい対象には、プレミアムな選択肢である Bright Data をおすすめします。このライブラリは直接エグレス時に警告を出し(
warnOnDirectEgress)、browser.checkEgress()は出口 IP がホスティングプロバイダーのものとしてフラグ付けされているかどうかを報告します。
Lambda — ZIP ランタイム + @sparticuz/chromium(サポート対象の方法)。 実際の google-chrome-stable は Lambda の ZIP ランタイムでは動作しません。単一プロセスで実行しても Firecracker の namespace/seccomp サンドボックスで終了し(credentials.cc Operation not permitted、「Zygote could not fork」)、フル版 Chrome は解凍後約 250 MB の ZIP サイズ制限にも収まりません。@sparticuz/chromium を使用してください(オプションの依存関係です。インストールしてバージョンを固定し、相対パスでバイナリを解決できるよう、バンドラーでは**external**のままにしてください)。このパッケージには、すでにヘッドレスの chrome-headless-shell が含まれています(--headless='shell')。ライブラリは channel:'headless-shell' によってこれを検出し、--headless=new を追加せず、ソフトウェア WebGL のフラグを管理し、HOME/XDG_*/ユーザーデータディレクトリが /tmp 以下に存在するようにし、DBUS_SESSION_BUS_ADDRESS を /dev/null に設定します。また、通常のヘッドフル Chrome が標準で備えているシェル用シム(window.chrome、navigator.connection)を自動で適用します。
import { Browser, resolveSparticuz } from "@eurafaeldecarvalho/browser-scraper";

const browser = new Browser({
  chromium: await resolveSparticuz(), // executablePath + Lambda args; implies channel:'headless-shell'
  proxy: "http://user:pass@residential-proxy:8000",
  geoCountry: "BR",                   // timezone + locale + Accept-Language, matched to the proxy exit
  onStderr: (chunk) => console.error(chunk), // optional: live Chrome stderr (OOM/seccomp cause)
});
これはアンチボット対策上、多少の妥協を伴います(chrome-headless-shell + SwiftShader、独自コーデックなし)。ただし、reCAPTCHA v3 ではIP の評価が最も重要なため、この選択をしています。フル Chromium の
--headless=newビルドをパッケージ化する価値はありません。ZIP に収まらず、Firecracker で終了し、さらに最も目立つ特徴(SwiftShader WebGL、GPU なし)はヘッドレスモードではなく GPU のないホストに由来するため、シェルと同じです。関数の/tmp(エフェメラルストレージ)は、デフォルトの 512 MB より大きく設定してください。バイナリの展開に約 130 MB を使うほか、ユーザーデータプロファイルの領域も必要です。
geoCountry はプロキシの出口国と一致させる必要があります(ドイツの IP で UTC の時計や pt-BR ロケールを使うのは、明らかに不自然です)。事前に出口国がわからない場合は、geoCountry の代わりに autoGeo: true を設定してください。最初の newTab() がプロキシ経由で出口国を調べ、自動で設定します(起動時にリクエストが 1 回追加されます。明示的に指定した geoCountry/timezone/locale は常に優先され、対応付けできない国は推測せず警告します)。
EC2 g4dn/g5(実 NVIDIA GPU): 厳しい対象に対応する構成です。chrome://gpu で GPU を確認し、spoofWebGL はオフのままにして、レジデンシャルプロキシまたはモバイルプロキシも引き続き使用してください。
AWS を使わない場合でも、一般的な VPS が使えます。 対策が軽度から中程度の対象や定期実行ジョブには、安価な常時稼働 VPS が最も手軽なホストです。Hostinger VPS(このリンクから 20% 割引)なら、GPU なしのソフトウェア WebGL 構成も問題なく動作します。レジデンシャルプロキシまたはモバイルプロキシを組み合わせるというルールは同じです。実 GPU 搭載の EC2 インスタンスが必要なのは、レンダリングハッシュに厳しい対象だけです。
ID と永続化
実行のたびに新しい一時プロファイルを使うと評判が蓄積されません。また、偽造した Google/_GRECAPTCHA Cookie は役に立ちません(Google はサーバー側で Cookie を発行・検証するため、シーダーはもう Cookie を捏造しません)。reCAPTCHA-v3 で保護されたターゲットでは、ID ごとに永続プロファイルを用意し、固定プロキシ IP に紐付けてウォームアップし、サーバーに本物の Cookie を発行させてください。
import { Browser, ProfileStore, warmProfile } from "@eurafaeldecarvalho/browser-scraper";

const store = new ProfileStore({ baseDir: "/mnt/efs/profiles" }); // EFS, or sync to S3 between runs
const browser = new Browser({
  userDataDir: store.dirFor("identity-42"),
  proxy: "http://user:pass@sticky-residential:8000",
  geoCountry: "BR",
});
const tab = await browser.newTab();
await warmProfile(tab); // genuine navigations + ambient motion so cookies/history accrue
ローテーションするデータセンター IP の背後でウォームアップしたプロファイルでは、何も得られません。1 つの ID、1 つの固定 IP、1 つのフィンガープリントを使ってください。
ウォームアップ済み Cookie は SQLite ファイルではなく、CDP 経由で注入してください。
ProfileManager.seedCookies()(起動前の SQLite 書き込み)は、Chrome ≥ 80 では機能しません。Chrome は OSCrypt で暗号化されたencrypted_valueを読み取り、平文のvalueを無視するため、ファイルからシードされた Cookie は読み込み時に破棄されます(現在、自動シードでは履歴のみをシードします。SQLite の経路では問題なく処理されます)。実際に保持されるウォームアップ済み Cookie バンドルを注入するには、Chrome 独自の(暗号化された)ストアを通じて実行時に設定してください:await tab.setCookies({ cookies })— 現在のプロファイルキーで暗号化されます。ProfileManager.cookieSeeds()はデフォルトの控えめなバンドルを返します。各バンドルは、ウォームアップに使用した同じ固定住宅用 IP に紐付けてください。
WebRTC
WebRTC は有効のままにします(完全に無効化すること自体が異常です)が、IP リークを防ぐために制限しています。プロキシ経由では、すべての UDP 通信をプロキシ経由に強制し(disable_non_proxied_udp)、それ以外の場合はパブリックインターフェースのみを公開し、ローカル IP を隠します(default_public_interface_only)。
代替手段 — 比較
検出されにくい Puppeteer/Playwright の代替手段をお探しなら、このライブラリの位置付けをご覧ください。通常の Puppeteer + puppeteer-extra-plugin-stealth や puppeteer-real-browser と同じ用途を対象としていますが、高水準ドライバーを後からパッチするのではなく、生の CDP を使用します。
| 機能 | Puppeteer/Playwright | + puppeteer-extra-plugin-stealth | puppeteer-real-browser | browser-scraper |
|---|---|---|---|---|
| 通信方式 | 高水準 API(Runtime を有効化) | 同じ + JS パッチ | 実 Chrome + パッチ | 生の CDP |
Runtime.enable の漏えい | あり | パッチ適用済み | 軽減 | 送信しない(分離ワールドで実行) |
| 1 回の呼び出しで閉じた Shadow DOM にアクセス | ✗ | ✗ | ✗ | ✓ find() |
同じ find() でクロスオリジン iframe にアクセス | ✗(手動でフレームを指定) | ✗ | ✗ | ✓ |
| 一貫性のあるペルソナ(1 つの UA から取得した UA + Client-Hints + WebGL + タイムゾーン) | ✗ | 部分的 | 部分的 | ✓ |
| 人間らしい入力(最小躍度のマウス、対数正規分布のタイピング) | ✗ | ✗(ghost-cursor を追加) | 部分的 | ✓ 組み込み |
| AWS Lambda/chrome-headless-shell 経路 | 手動 | 手動 | ✗ | ✓ resolveSparticuz() |
これは精密なツールであり、魔法の CAPTCHA 回避ツールではありません。Cloudflare、DataDome、Kasada などの厳しいターゲットでは、依然としてIP の評判が最も重要です。住宅用/モバイルプロキシと組み合わせてください(クラウドへのデプロイを参照)。
AI エージェント向け
@playwright/mcp | Stagehand | Firecrawl/ホスト型スクレーパー | browser-scraper | |
|---|---|---|---|---|
| ローカルで動作し、API キー不要 | ✓ | ✓(モデルは自分で用意) | ✗(有料 API)/セルフホスト | ✓ |
ステルス性(Runtime.enable なし、一貫性のあるペルソナ、人間らしい入力) | ✗ | Browserbase クラウド経由 | サーバー側 | ✓ 組み込み |
| Cloudflare Turnstile の解決 | ✗ | クラウドのみ | ✓(有料) | ✓ solveTurnstile() |
| スナップショットが閉じたシャドウルートに対応 | ✗ | ✗ | 該当なし | ✓ |
| HTML → Markdown、メタデータ | ✗ | 部分的 | ✓ | ✓ |
| セレクターを一度生成すれば、その後は LLM 不要 | ✗ | アクションキャッシュ | ✗ | ✓ generateExtractor() |
| ページあたりのコスト | 無料 | アクションごとに LLM | クレジット単位 | 無料(LLM は任意) |
自律型エージェントのループを使いたい場合は、Stagehand または browser-use を使用してください。browser-scraper はエージェント(Claude、Cursor、自作のエージェント)の下位にあるブラウザレイヤーとして、または保護されたページから低コストでコンテンツを取得したい場合に使用してください。
FAQ
Node.js で Puppeteer を検出されないようにする/ボット検出を回避するには?
検出の手掛かりとなるのは、Runtime.enable による CDP の漏えい、HeadlessChrome を含む User-Agent/クライアントヒント、そしてレイヤー間のフィンガープリントの不一致です。このライブラリは Runtime.enable を一切使わず(すべての JS は Page.createIsolatedWorld + Runtime.evaluate 経由で実行)、ヘッドレス UA を取り除き、整合性のあるペルソナをひとつ生成します。詳しくはステルスの詳細をご覧ください。bot.sannysoft.com(失敗 0 件)、CreepJS(ヘッドレス判定 0%)、bot-detector.rebrowser.net で検証済みです。
Node.js で Cloudflare Turnstile を回避するには?
Turnstile のチェックボックスは通常、サンドボックス化されたクロスオリジン iframe 内にあります。単一の find() でチェックボックス(および閉じたシャドウルート)に到達できるため、実際のユーザーのように click() できます。または、tab.solveTurnstile() を呼び出す方法もあります(ウィジェットを待機し、チェックボックスを人間のようにクリックして、トークンをポーリングします)。閉じた Shadow DOM とクロスオリジン iframe をひとつの find で突破すると、examples/cloudflare-turnstile.ts の例をご覧ください。クリーンな住宅用 IP を使えば Cloudflare のインタースティシャルを通過できます。クリックではなく IP が主な決め手です。
閉じた Shadow DOM にアクセスまたはクエリするには?
Puppeteer と Playwright は閉じたシャドウルートを突破できません。find()/findAll() を使うと、メインドキュメント、閉じたシャドウルート、クロスオリジン(OOP)iframe を一度の呼び出しで検索できます。shadowRoot をたどったり、フレームを扱うためのコードを書いたりする必要はありません。
Runtime.enable による CDP 検出の漏えいとは何ですか? また、どう回避しますか?
Runtime.enable を呼び出すと(ほとんどの自動化スタックは起動時に呼び出します)、Runtime.consoleAPICalled などの Runtime ドメインのシグナルが発生し、ボット対策ベンダーにフィンガープリントとして利用されます。このライブラリは Runtime ドメインを有効化しません。実行は Runtime.evaluate 経由で名前付きの分離ワールド内で行われるため、こうしたシグナルは発生しません。
スクレイピング用に AWS Lambda でヘッドレス Chrome を実行するには?
オプションの @sparticuz/chromium ビルドと resolveSparticuz() を使ってください。このライブラリは chrome-headless-shell を検出し、適切なフラグ、ディレクトリ、シムを自動的に適用します。詳しくはクラウドへのデプロイ(Lambda と EC2-GPU)をご覧ください。
ステルススクレイピングには Puppeteer と Playwright のどちらを使うべきですか?
どちらも Runtime ドメインを有効化する高水準のドライバーであり、閉じたシャドウルートを突破できないため、検出に敏感なスクレイピングではステルスプラグインを追加することになります。このライブラリは、そうした用途を最初から想定して構築された CDP ファーストの代替手段です。詳しくは代替手段と比較をご覧ください。
ブロックされないブラウザーを Claude/Cursor に使わせるには?
組み込みの MCP サーバーを実行します。claude mcp add browser-scraper -- npx -y @eurafaeldecarvalho/browser-scraper mcp。エージェントはステルス Chrome 上で navigate/snapshot/click/type/markdown/solve_turnstile を使えます。詳しくはMCP サーバーをご覧ください。
LLM/RAG パイプライン用にウェブサイトをスクレイピングして Markdown にするには?
scrape({ url, formats: ["markdown"] }) は、必要な場合にのみプレーン HTTP からステルスブラウザーへ処理を切り替えて、本文を抽出したクリーンな Markdown を返します。構造化されたフィールドを取得するには、Zod スキーマを使った extract()、またはページごとではなくサイトのレイアウトごとに一度だけ LLM のコストを払う generateExtractor() を使います。
CAPTCHA や reCAPTCHA v3 を解決できますか?
画像/トークン型 CAPTCHA は解決しません。このライブラリが行うのは、reCAPTCHA のv3 スコアを高く保つことです。人間らしいマウス操作/タイピング、トークン生成の呼び出し前の自然なアクティビティ、固定された住宅用 IP 上で温めた永続プロファイルを使います。詳しくはアイデンティティと永続性をご覧ください。v2 の画像チャレンジには、ソルバーサービスを組み合わせてください。
注意事項と制限
markdown()のメインコンテンツ検出はヒューリスティック(セマンティックタグ、ロール、クラスのヒント、リンク密度)であり、Readability ではありません。削りすぎる場合はmainContent: falseを使用してください。snapshot()は CDP Accessibility ドメインを使用しており、Playwright のスナップショットと同じソースです。generateExtractor()のセレクターは分離されたワールドでquerySelectorAllを実行するため、閉じたシャドウルートにはアクセスできません。その場合はextract()(Markdown/スナップショット入力)またはobserve()を使用してください。- 通常のデスクトップ版 Chrome では、デフォルトで JavaScript のフィンガープリント偽装は挿入されません。パッチを適用した API よりも、ネイティブの動作のほうが検出されにくいためです。ステルス性の向上は、
Runtime.enableを回避すること、ヘッドレスの UA/クライアントヒントをクリーンアップすること、汎用的なワールド名、慎重な起動フラグ、人間らしい入力によって実現します。対象サイトでパッチが必要な場合は、tab.addInitScriptを使って独自のパッチを適用してください。 channel:'headless-shell'の場合、ライブラリはシェル固有の兆候を2つ解消するため、少数の条件付きシムを適用します。シェルバイナリを通常のヘッドフル Chrome と見分けがつかなくするものではありません。シムは、値がすでに実際のものであれば何もしないようになっており、Chrome のネイティブな記述子の形状に合わせて書かれています(window.chromeは列挙可能な独自データプロパティ、navigator.connectionはネイティブに見えるtoStringを持つプロトタイプアクセサーです)。具体的には、最小限のwindow.chrome/chrome.runtime(存在しない場合のみ)と、ゼロ以外のnavigator.connection.rtt(読み取り値が0の場合のみ)です。残るシェルの差異は意図的にそのままにしています(偽造したnavigator.plugins/WebGPU アダプター自体が兆候になります。調査ドキュメントを参照してください)。これらはソフトターゲットにおける制限であり、最も重要な要素は引き続き IP です。また、このライブラリは、ハードコード値が古いままローテーションするのではなく、navigator.userAgentDataから読み取った実際のライブな GREASE ブランドを Client-Hints に渡します。さらに、WebGL 文字列の偽装をインストールする前に WebGL コンテキストの存在を確認します(背後にコンテキストがなければgetParameterのみの偽装は機能せず、一貫性もありません。DataDome Picasso のようなレンダリングハッシュ型のアンチボットに対しては、正直な値よりも悪影響があるため、ソフトターゲットでのみspoofWebGLを使用してください)。- WebGL 文字列の偽装はソフトターゲット専用です。強制レンダリングハッシュには対抗できません。ハードターゲットには、実際の GPU を使用してください。
- 最も支配的なシグナルはフィンガープリントではなく、IP の評判です。データセンターの ASN は JavaScript が実行される前に拒否されます。保護された対象には、住宅用/モバイルプロキシを経由させてください(予算を抑えるなら IPRoyal、難しい対象には Bright Data — 有料リンク)。
- **このライブラリは設計上、CAPTCHA を解決しません。**方針は IP の評判と人間らしい動作であり、トークンの偽造ではありません(偽造した
_GRECAPTCHAトークンには効果がありません)。対象サイトが、実際にクリアする必要のある画像/チェックボックス形式の対話型チャレンジを表示する場合は、解決サービスに任せてください — 2Captcha または Anti-Captcha(有料リンク)。まず IP を改善してください。フラグが立てられたデータセンター IP 上の解決サービスも、やはり失敗します。
サポート
このライブラリはオープンに開発・メンテナンスされています。Runtime.enable による漏えい、シャドウ DOM の走査、フィンガープリントの一貫性への対処を自分で行う手間を省けた場合は、少額のご支援が開発の継続に役立ちます。
- GitHub でスポンサーになる — 1回限り、または毎月
- Ko-fi でコーヒーをおごる — 手軽な1回限りのチップ
リポジトリにスターを付けることも役立ちます — 他の開発者がこのプロジェクトを見つけるきっかけになります。
この README に含まれるプロキシおよび CAPTCHA のリンクには、有料リンクが含まれています。追加費用なしで、紹介料を受け取る場合があります。いずれも、私自身の通信を経由させるツールです。
ライセンス
MIT。0.7.0 までのバージョンは PolyForm Noncommercial 1.0.0 の下で公開されており、0.8.0 以降のライブラリは MIT です。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。