Voice Coach について
Voice Coachは、歌唱者、英語学習者、スピーカー向けのローカルMCPサーバーです。音程、発音、話し方を端末上で測定し、付属スキルで練習を進めて記録できます。
主な機能
- 01音符ごとの音程と旋律の分析
- 02英語の音素単位の発音評価
- 03速度、間、フィラー、音声指標の測定
- 04マイク録音と音質警告
- 05ガイド付き練習と進捗記録
活用シーン
- 01キーやMIDI旋律に合わせた歌唱練習
- 02英語で繰り返す発音ミスの特定
- 03発表の速度やフィラーの確認
- 04練習セッションごとの変化の記録
MCP 対応
MCPサーバーは録音、音程・音声分析、英語発音評価、進捗の読み書きに使うツールを提供します。歌唱、発音、スピーキング練習用のプロンプトも利用できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx voice-coach-mcpVOICE_COACH_DIRFolder for recordings, analysis details and progress.md (default ~/VoiceCoach).VOICE_COACH_WHISPER_MODELWhisper model for transcription and speech metrics (default small).ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
7掲載時のツール一覧 · 5 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| name | any | いいえ | |
| seconds | number | はい |
詳細
voice-coach-mcp
Claude に耳を与えましょう。 あなたの歌声、話し声、音読を聞き、音声を測定して、Claude があなたの声をコーチできるローカル MCP サーバーです。


Claude は音声を処理できません。このサーバーはマイクから録音し、コンピューター上で音声を分析して、Claude が具体的なコーチングに活用できる簡潔な測定結果を返します。
| モード | 測定内容 |
|---|---|
| 🎤 歌唱 | 音ごとの音程の正確さ(セント)、フラット/シャープの傾向、ずれ、安定性、ビブラートを測定します。平均律、キー、MIDI メロディーを基準に、誤った音、歌い損ねた音、遅れた音も比較します。 |
| 🗣️ 英語の発音 | 実際に話した内容を、音素レベルで読むはずだった内容と比較し、単語ごとのスコアと、よくある混同(θ → s、v → b、iː → ɪ…)を示します。 |
| 🎙️ 人前でのスピーチ | 1 分あたりの単語数、長い間、フィラーワード(英語とスペイン語)、声の高さの単調さ、音量の変化を、タイムスタンプ付きの文字起こしとともに示します。 |
付属のスキルにより、Claude がコーチとして機能します。ウォームアップ → エクササイズ → 分析 → フィードバックのセッションを実施し、テイクごとに具体的な重点項目を 1 つ提示して、セッションをまたいで進捗記録を維持します。Claude はあなたの言語で返答します。
- ローカルでプライベート:Azure バックエンドを選択しない限り、音声がコンピューターの外に送信されることはありません。
- 無料:オープンソースモデル(faster-whisper、wav2vec2)を使用し、API キーは不要です。
- ツールが測定し、Claude が解釈:すべての応答は、
confidenceとwarningsを含む簡潔な JSON(≤ 2 KB)なので、Claude が不適切な音声に基づいてコーチングすることはありません。
インストール
uv と、発音分析を利用する場合は espeak-ng が必要です。
brew install uv espeak-ng ffmpeg # macOS (ffmpeg is optional: m4a/aac input)
Linux の場合:uv をインストールしてから、sudo apt install espeak-ng ffmpeg libportaudio2 を実行します。macOS で発音分析を利用するには、Apple Silicon と macOS 14 以降が必要です(PyTorch の要件)。
Claude Code(プラグイン:サーバー + スキル)
claude plugin marketplace add FabianIMV/voice-coach-mcp
claude plugin install voice-coach@voice-coach
または、セッション内で /plugin install voice-coach --marketplace FabianIMV/voice-coach-mcp を実行します。
初回起動時に uv が Python の依存関係をインストールするため、1〜2 分かかることがあります(モデルは後で初回使用時にダウンロードされます)。インストール直後に /mcp で voice-coach が失敗と表示された場合は、インストールが完了してから /mcp で再接続してください。
Claude Desktop(拡張機能)
最新リリースから voice-coach.mcpb をダウンロードし、ダブルクリックするか、Claude Desktop にドラッグします。コーチングスキルを利用するには、voice-coach-skill.zip もダウンロードし、設定 → 機能 → スキルからアップロードしてください。
任意の MCP クライアント(手動)
claude mcp add voice-coach --scope user -- uvx --from "voice-coach-mcp[speech,pronunciation]" voice-coach-mcp
Claude Desktop の claude_desktop_config.json では、絶対パスを指定してください(Desktop はシェルの PATH を引き継がないため、which uvx を実行してパスを確認できます)。
{
  "mcpServers": {
    "voice-coach": {
      "command": "/opt/homebrew/bin/uvx",
      "args": ["--from", "voice-coach-mcp[speech,pronunciation]", "voice-coach-mcp"]
    }
  }
}
任意:uvx --from "voice-coach-mcp[speech,pronunciation]" voice-coach-mcp download-models を一度実行すると、初回呼び出しでモデルを待つ必要がなくなります(Whisper は約 480 MB、音素モデルは約 1.3 GB)。
マイクのアクセス許可(macOS)
macOS では、マイクの使用がサーバーを起動するアプリに許可されます。Claude Desktop、または Claude Code を実行しているターミナル(Terminal、iTerm、Ghostty、VS Code…)です。アクセスが拒否されると、macOS はエラーではなく無音を返し、record_audio は no_microphone_permission を報告します。システム設定 → プライバシーとセキュリティ → マイクで設定を変更し、そのアプリを再起動してください。
使い方
Claude に話しかけるだけです。
- 「音程を合わせて歌う練習をしたいです。初心者です。」
- 「プロジェクトの発表を30秒録音して、つなぎ言葉を何回使ったか教えてください。」
- 「「th」の発音を手伝ってください。読み上げる文を出して、採点してください。」
- 「このボイスメモを melody.mid と照らし合わせて分析してください」(wav/mp3/m4a のパスを指定できます)。
- 「上達していますか?」(Claude が進捗ログを読み込みます)。
Claude Code での実際のセッション例:仕事についての60秒間のスピーチと、1つの音を伸ばして歌うベースライン測定。
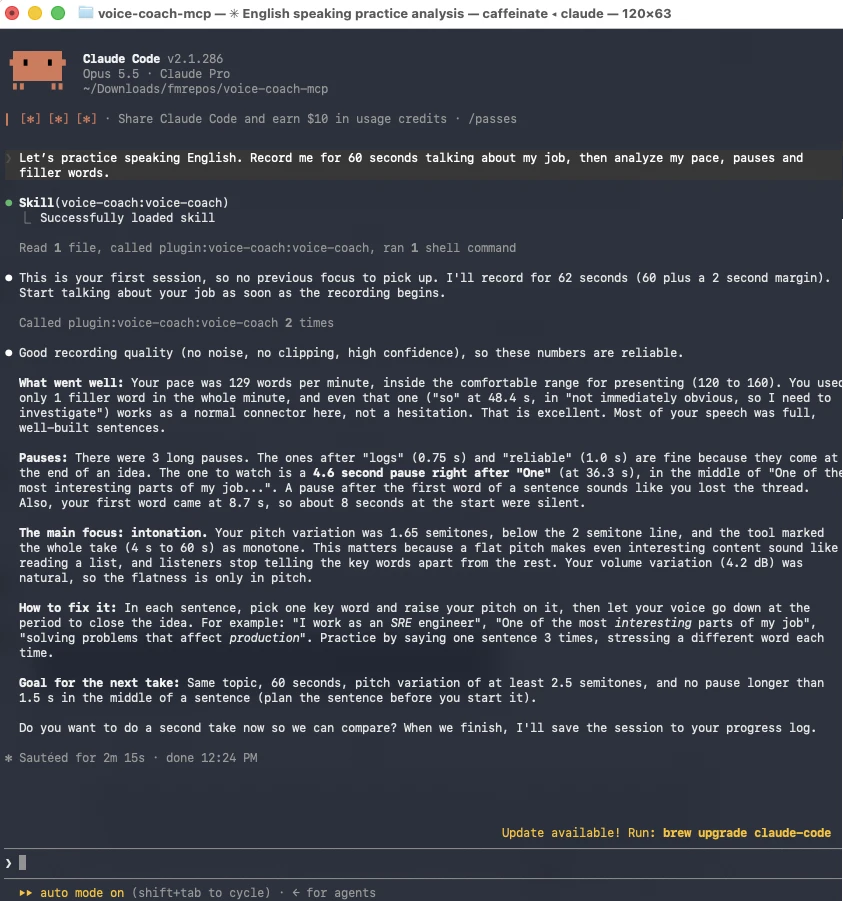
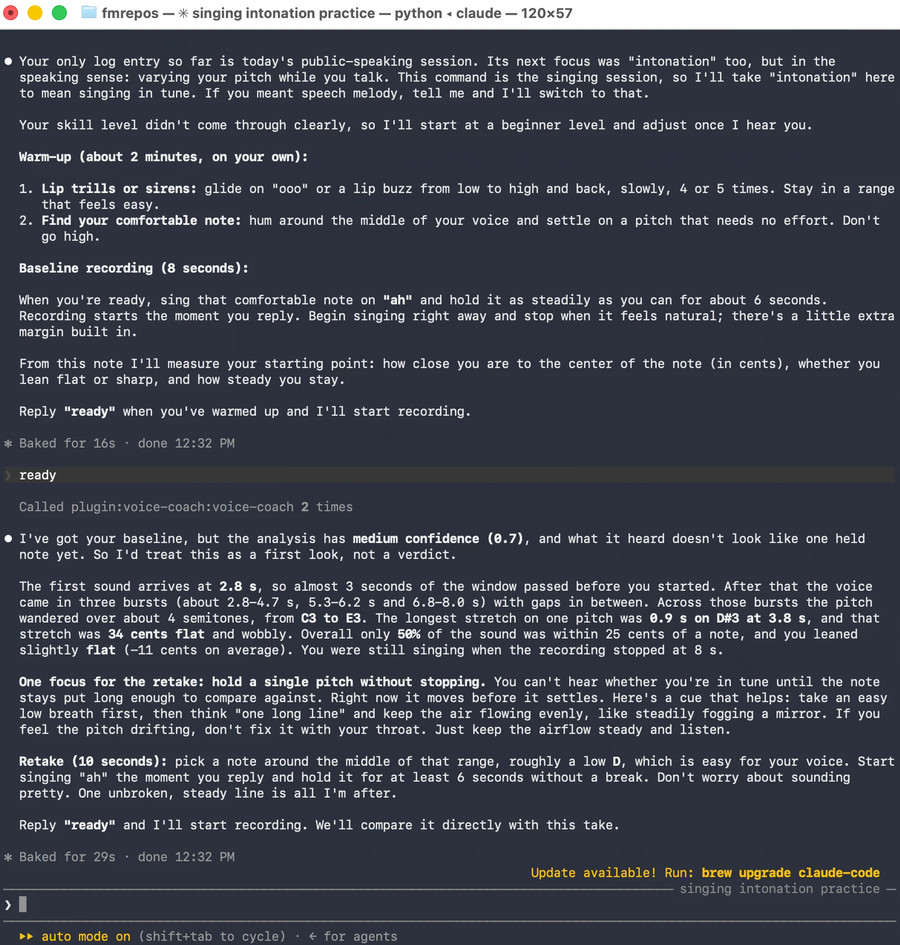
ガイド付きセッションは MCP プロンプトとしても利用できます:singing_session、pronunciation_session、speaking_session(Claude Code では /mcp__voice-coach__singing_session)。
ツール
| ツール | 目的 |
|---|---|
record_audio(seconds, name?) | 16 kHz モノラル WAV を ~/VoiceCoach/recordings/ に録音し、音量レベル、クリッピング、ノイズを報告します。 |
analyze_pitch(audio, reference_midi?, key?, midi_track?) | 平均律、調(「A minor」、「G major」など)、または MIDI メロディーに対する音符ごとの音程精度を分析します。 |
transcribe(audio, language?) | セグメントと単語のタイムスタンプ付きでローカル文字起こしを行います。 |
speech_metrics(audio, language, pause_threshold_s=0.7) | 話す速さ、長い間、つなぎ言葉、音程の単調さ、音量の変化を分析します。 |
assess_pronunciation(audio, expected_text, language="en-US") | 英語の音素レベルの発音スコアと誤りを提示します。 |
read_progress(entries=5) / log_progress(entry) | ~/VoiceCoach/progress.md のセッションを読み込み、追記します。 |
音声にはパス、または record_audio が返す名前を指定できます。結果が長すぎる場合は、関連性の高い項目を返し、残りは音声ファイルの隣に保存します(full_details)。
例:analyze_pitchを使った、既知のずれがある合成 C メジャー音階の分析
{"audio":"examples/audio/c_major_scale.wav","duration_s":7.36,"mode":"equal_temperament",
 "summary":{"notes":8,"range":"C4–C5","pct_within_25_cents":75.0,"mean_deviation_cents":-7.8,
   "mean_abs_deviation_cents":13.6,"tendency":"centered","drift_cents":-1.0,
   "stability":{"stable":7,"vibrato":1,"unstable":0}},
 "notes":[{"t":0.4,"dur":0.62,"note":"C4","cents":0,"stability":"stable"},
   {"t":1.84,"dur":0.62,"note":"E4","cents":-30,"stability":"stable"},
   {"t":4.72,"dur":0.62,"note":"B4","cents":-42,"stability":"stable"},
   {"t":5.44,"dur":1.43,"note":"C5","cents":-2,"stability":"vibrato","vibrato_hz":5.5,"vibrato_pp_cents":84}, "…"],
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
MIDI リファレンスを使用すると、サーバーはメロディーが1オクターブ低く歌われたこと(octave_shift: -1)、1秒遅れて始まったこと(start_offset_ms: 1003)、1つの音符が134 ms遅れて入ったことを検出します。
例:assess_pronunciation — 「I sink the berry best sings…」と、「I think the very best things in life are free」を読み上げた場合
{"backend":"wav2vec2-local",
 "summary":{"overall_score":90,"words":10,"words_with_errors":3,
   "errors":{"substitution":3,"deletion":0,"insertion":0},
   "frequent_confusions":[{"expected":"θ","detected":"s","count":2},{"expected":"v","detected":"b","count":1}]},
 "words":[{"word":"think","score":75,"t":0.56,"expected":"θ ɪ ŋ k","detected":"s ɪ ŋ k",
     "errors":[{"type":"substitution","expected":"θ","detected":"s"}]},
   {"word":"very","score":75,"t":0.96,"expected":"v ɛ ɹ i","detected":"b ɛ ɹ i",
     "errors":[{"type":"substitution","expected":"v","detected":"b"}]}, "…"],
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
例:speech_metricsを使った、間とつなぎ言葉を挿入した短い合成スピーチの分析
{"language":"en",
 "pace":{"words":36,"speaking_time_s":14.9,"words_per_minute":145,"wpm_excluding_long_pauses":165},
 "pauses":{"threshold_s":0.7,"count":2,"total_s":1.9,"max_s":1.03,"per_minute":8.1,
   "items":[{"t":4.42,"dur":1.03,"after":"speaking"},{"t":12.1,"dur":0.83,"after":"normal"}]},
 "fillers":{"total":6,"per_minute":24.2,"by_type":{"um":1,"so":1,"uh":1,"you know":1,"like":1,"i mean":1}},
 "pitch":{"median_f0_hz":101,"std_semitones":1.53,"monotone":true,"monotone_stretches":[{"t":0.0,"end":12.0}]},
 "volume":{"mean_dbfs":-21.2,"std_between_words_db":2.4,"low_variation":true},
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
合成音声は非常に平坦なため、monotone: true になります。スペイン語の例も含まれています。
すべての出力例は、合成音声を使って examples/generate_examples.py で再生成した、stdio 経由のサーバーからの実際の応答です。examples/outputs/を参照してください。
仕組み
- ピッチ:pYIN(librosa)が有声音フレームを検出し、各フレームを倍音ピークから放物線補間で調整します(C2〜C6で約1セントの精度)。音符は無音、エネルギーの低下、持続するピッチ変化で分割されます。ビブラートでは分割されません。MIDI リファレンスがある場合は、相互相関でオクターブとオフセットを求め、Needleman–Wunsch で音符をアラインメントし、テンポの直線
t_sung = a·t_ref + bを当てはめて各発音タイミングを評価します。 - 発話:faster-whisper が単語ごとのタイムスタンプ付きで文字起こしします(冒頭のプロンプトでフィラーを保持します)。Whisper は単語の語尾を無音部分まで引き延ばすため、ポーズは音声のエネルギーから測定します。曖昧なフィラー(「like」「so」)は、コンマまたはポーズで区切られている場合にのみカウントします。
- 発音:phonemizer と espeak-ng で期待される IPA 音素を取得し、
facebook/wav2vec2-lv-60-espeak-cv-ftの音素モデルで発話された内容を取得します。両者を編集距離でアラインメントします。一般的なアメリカ英語の発音(フラップ、シュワー、リンキング r、声門閉鎖音)は誤りとしてカウントされません。 - 品質を優先:クリッピング、背景ノイズ、無音、マイクの権限がない場合は警告として報告され、信頼度が下がります。
既知の制限事項:一度に扱える声は1つです(伴奏があるとピッチ検出の精度が低下します)。完全なレガートで歌われた同じ音程の音符が2つある場合、1つとしてカウントされます。音素モデルは文脈を利用するため、発音を誤った単語を「修正」することがあります。発音評価は英語のみです。
プライバシーとネットワークアクセス
プラグインの実行、書き込み、ダウンロードの内容は次のとおりです。
- 実行:
uvがプラグインフォルダーからサーバーを起動します(uv run --frozen、uv.lockで固定)。サーバーは期待される音素の取得にespeak-ngを使用し、m4a/aac ファイルの読み込みにのみffmpegを使用します。 - マイク:
record_audioの実行中に限り、Claude が指定した秒数だけ使用します。 - 書き込み:録音と
progress.mdを~/VoiceCoach(またはVOICE_COACH_DIR)に保存し、分析した各音声の隣に分析詳細ファイル<audio>.<tool>.jsonを保存します(そのフォルダーが読み取り専用の場合は~/VoiceCoach/analysisに保存します)。同じ音声を再分析すると、その詳細ファイルが置き換えられます。それ以外のファイルが上書きまたは削除されることはありません。 - ダウンロード:初回起動時に PyPI から Python の依存関係をダウンロードし、初回使用時に Hugging Face からモデルをダウンロードします。対象は faster-whisper モデル(デフォルトは
Systran/faster-whisper-small)とfacebook/wav2vec2-lv-60-espeak-cv-ftです。以降、モデルはローカルキャッシュから読み込まれます。 - 送信:デフォルトでは何も送信しません。テレメトリー、アカウント、API キーはありません。独自の
AZURE_SPEECH_KEYとAZURE_SPEECH_REGIONを設定してVOICE_COACH_PRONUNCIATION_BACKEND=azureを指定した場合に限り、assess_pronunciationが音声と期待されるテキストをリージョン内の Azure Speech に送信します。
設定
| 変数 | デフォルト | 用途 |
|---|---|---|
VOICE_COACH_DIR | ~/VoiceCoach | 録音、分析詳細、progress.md |
VOICE_COACH_MAX_SECONDS | 120 | record_audio の最大録音時間 |
VOICE_COACH_A4_HZ | 440 | チューニングの基準 |
VOICE_COACH_MAX_BYTES | 2048 | レスポンスサイズの上限 |
VOICE_COACH_WHISPER_MODEL | small | tiny、base、small、medium、large-v3… |
VOICE_COACH_WHISPER_DEVICE / _COMPUTE_TYPE | cpu / int8 | CTranslate2 の設定 |
VOICE_COACH_FILLERS | — | 独自のフィラー用 TOML(fillers.toml を参照) |
VOICE_COACH_PRONUNCIATION_BACKEND | local | local(wav2vec2)または azure |
VOICE_COACH_PRONUNCIATION_DEVICE | auto | auto(利用可能な場合は MPS)、cpu または mps |
AZURE_SPEECH_KEY、AZURE_SPEECH_REGION | — | オプションの Azure Pronunciation Assessment バックエンド(pip install voice-coach-mcp[azure])。この場合、音声は Azure に送信されます |
PHONEMIZER_ESPEAK_LIBRARY | 自動検出 | Homebrew のデフォルトの場所に libespeak-ng がない場合のパス |
開発
git clone https://github.com/FabianIMV/voice-coach-mcp.git && cd voice-coach-mcp
uv sync --extra speech --extra pronunciation
uv run pytest                 # fast suite: synthetic audio, simulated microphone
uv run pytest -m models       # real Whisper and wav2vec2 models on synthetic speech
uv run ruff check . && uv run ruff format --check .
設計原則とリリースプロセスについては、CONTRIBUTING.mdをご覧ください。
src/voice_coach_mcp/
  server.py         MCP tools and prompts (thin layer)
  audio/            loading, recording and quality checks
  singing/          pitch tracking, music theory, MIDI reference, pitch accuracy
  speech/           transcription, speech metrics, filler lists
  pronunciation/    expected phonemes, alignment, wav2vec2 and Azure backends
  output.py         2 KB response budget and details file
  progress.py       progress log
skills/voice-coach/ coaching skill (also bundled in the Python package)
examples/           synthetic audio and real tool outputs
ライセンスとクレジット
MIT © FabianIMV。faster-whisper、 librosa、wav2vec2 phoneme recognition および公式のMCP Python SDKを基盤としています。 オプションの発音機能には、どちらもGPL-3.0のphonemizerと espeak-ngを使用します。サンプル音声はespeak-ngと Piper(パブリックドメインのLJSpeech音声)で合成しました。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。