FastOCR について
FastOCR は、FastOCR API を使ってローカルのスキャン PDF や画像をテキストまたは検索可能な PDF に変換する MCP サーバーです。MCP クライアントで文書を処理する用途向けで、100 以上の言語を自動判別します。
主な機能
- 01PDF と画像の OCR
- 02テキストまたは検索可能な PDF を出力
- 03100 以上の言語を自動判別
- 04文書の状態とページ数を確認
- 05保存済み文書の一覧・削除
- 06残りのページ残高を確認
活用シーン
- 01スキャンした契約書からテキストを抽出
- 02領収書画像の文字を読み取る
- 03保管 PDF の検索可能なコピーを作成
- 04最近の文書とページ残高を確認
MCP 対応
stdio MCP サーバーは、ローカルの PDF や画像を OCR に送信し、結果の取得、文書の確認、保存ファイルの管理を行うツールを提供します。ファイルは FastOCR API に送信されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細




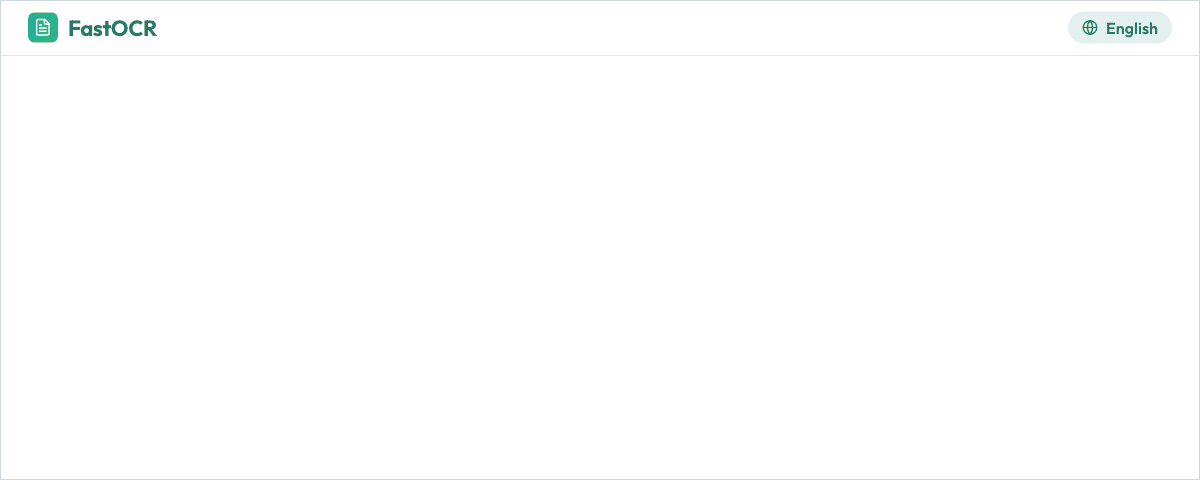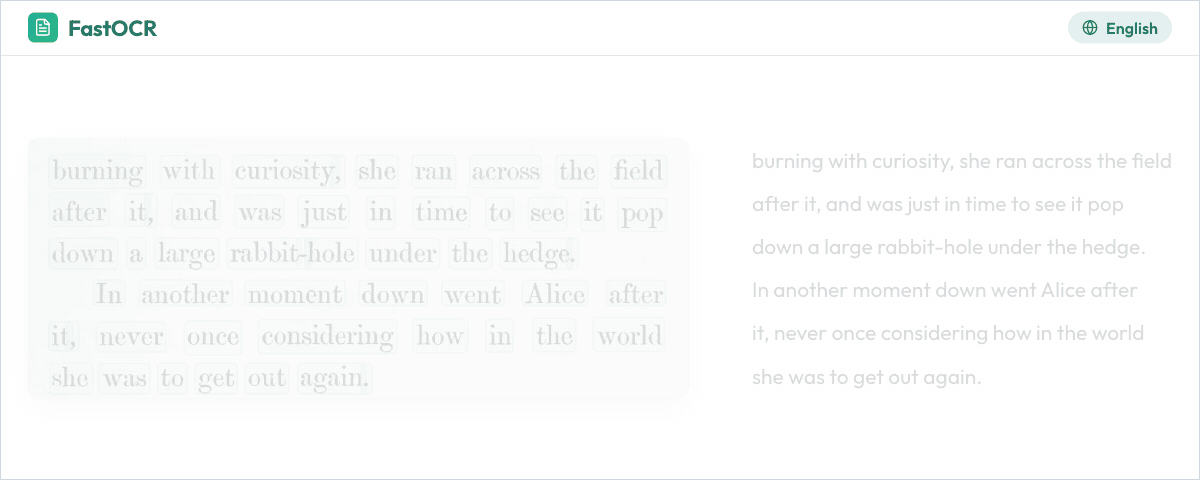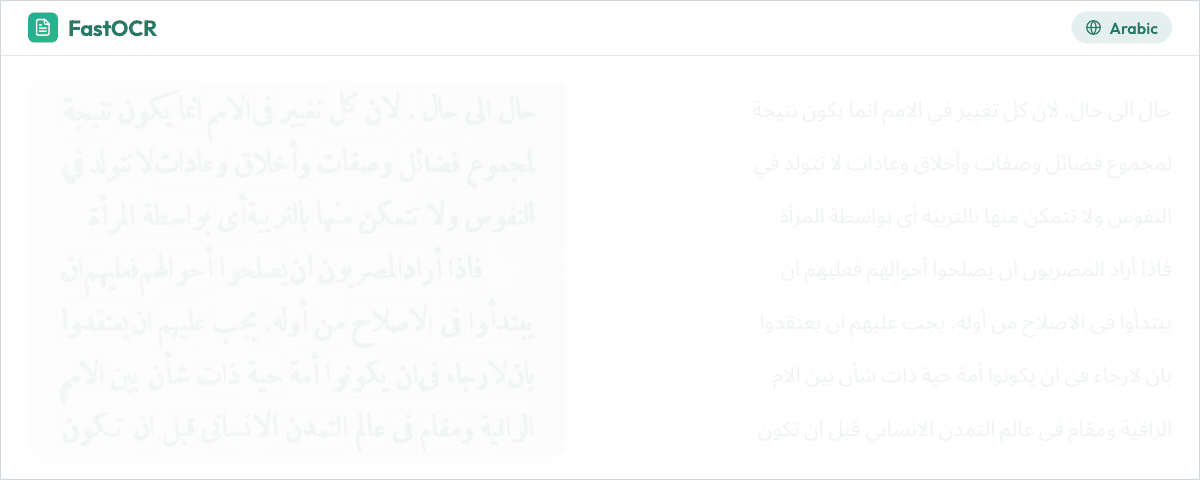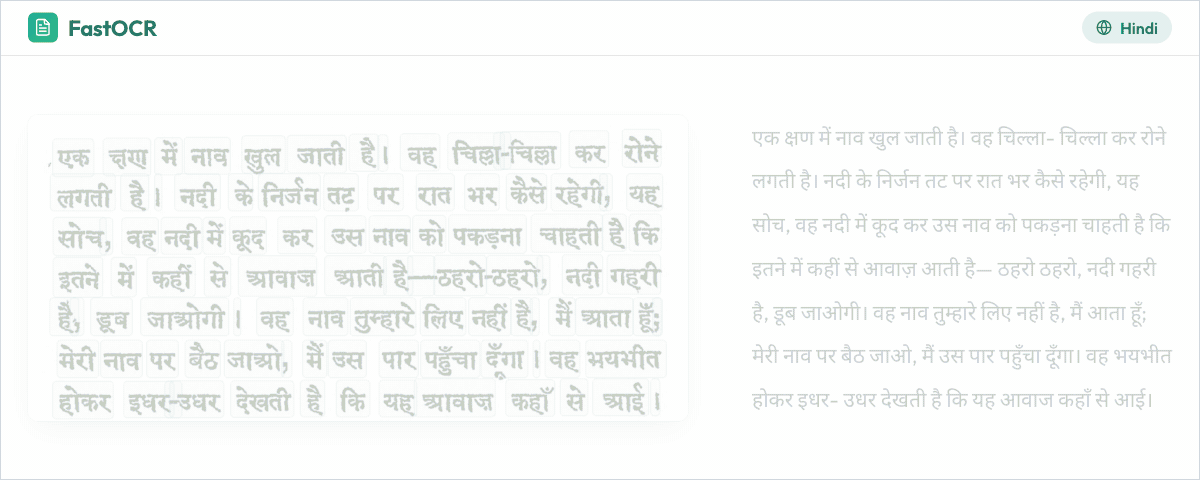
クライアントがローカルのスキャン済みPDFや画像をstdio経由でOCRできるようにするMCPサーバーです。ファイルはFastOCR APIにのみ送信されます。
クイックスタート
- 開発者コンソールでAPIキーを作成します。
- サーバーをClaude Codeに追加します。
claude mcp add fastocr -e FASTOCR_API_KEY=your_api_key -- uvx fastocr-mcp
- *「~/Scans/contract.pdfをOCRして」*と依頼します。
uvを使えば、インストールは不要です。クライアントはuvx fastocr-mcpを実行します。pipを使う場合は、pip install fastocr-mcpを実行し、コマンドfastocr-mcpを使用します。Python 3.10以降が必要です。
その他のクライアント
どのクライアントでも、同じコマンドuvx fastocr-mcpと、FASTOCR_API_KEYに設定したキーが必要です。
Claude Desktop
claude_desktop_config.json(設定 > 開発者 > 設定を編集)に以下を追加し、Claude Desktopを再起動します。
{
  "mcpServers": {
    "fastocr": {
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
Cursor
~/.cursor/mcp.json(すべてのプロジェクト)または.cursor/mcp.json(1つのプロジェクト)に以下を追加します。
{
  "mcpServers": {
    "fastocr": {
      "type": "stdio",
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
VS Code
ワークスペースの.vscode/mcp.jsonに以下を追加します。VS CodeではmcpServersではなくserversを使用します。
{
  "servers": {
    "fastocr": {
      "type": "stdio",
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
pipでインストールした場合は、"command": "fastocr-mcp"と"args": []を使用します。
使用例
クライアントに自然な言葉で依頼します。
- 「~/Downloads/scanned-contract.pdfをOCRして、契約解除条項を要約して」
- 「/Users/me/Desktop/receipt.jpgのテキストを読んで」
- 「/Users/me/archive/1998-letters.pdfの検索可能なコピーを作成して」
- 「FastOCRの直近5件のドキュメントを一覧表示して」
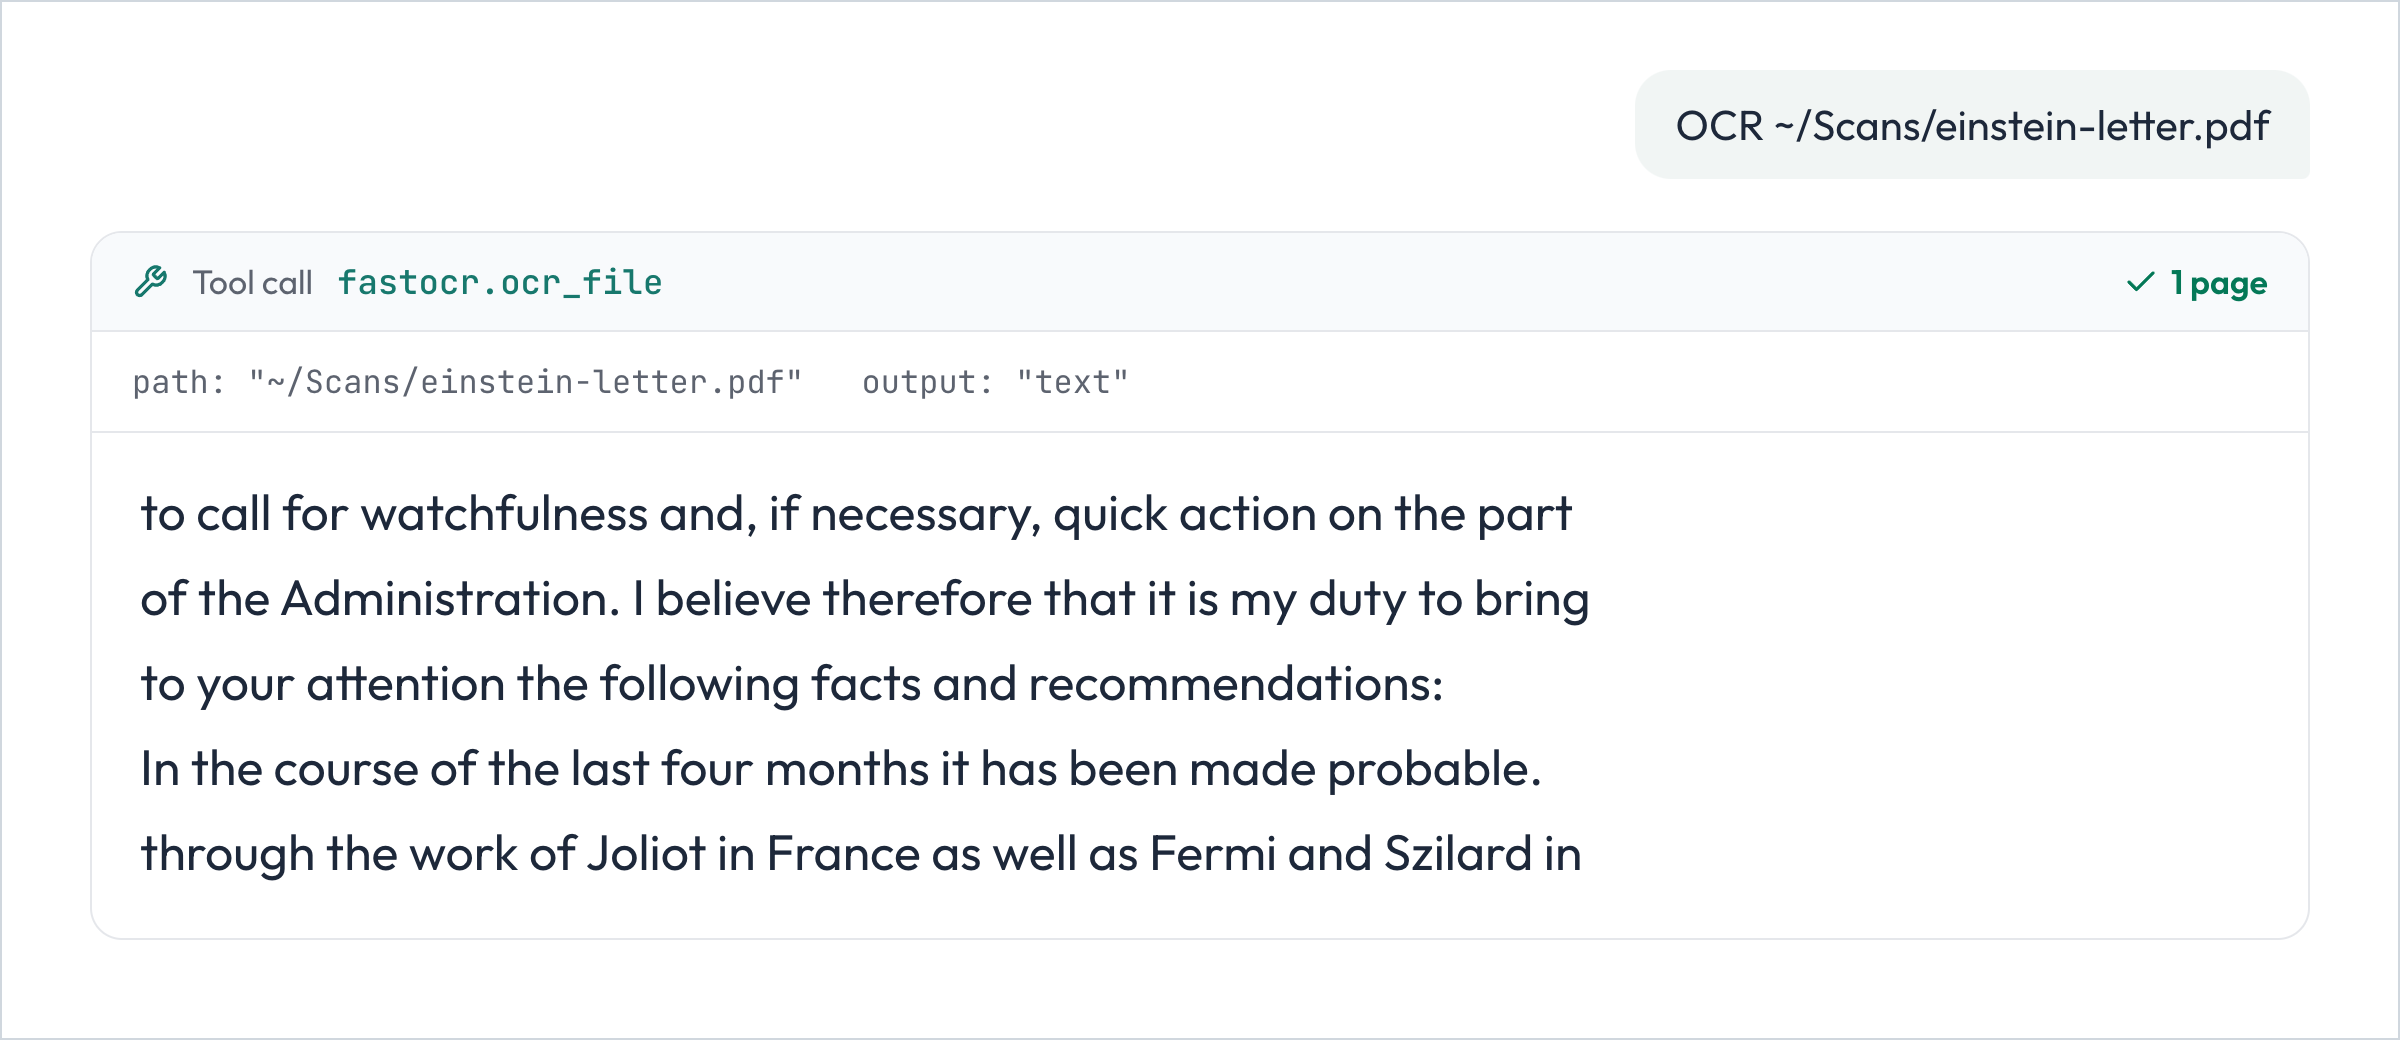
上記のテキストは、スキャンページに対してFastOCRが返した未編集の出力です。
ツール
| ツール | 機能 |
|---|---|
ocr_file(path, output="text", output_path=None) | ローカルの PDF または画像をアップロードして OCR を実行し、最大 45 秒待機します。大きなドキュメントの場合は、get_document 用の ID を返します。output="text" はテキストを返します(20,000 文字を超えるテキストは切り詰められ、全文は output_path または入力ファイルと同じ場所の <file>.ocr.txt に保存されます)。output="pdf" は検索可能な PDF を output_path または <file>.searchable.pdf に保存します。 |
ocr_pdf(path, output="text", output_path=None) | 既存の設定との互換性を保つために残されている、以前の名前で呼び出せる ocr_file と同じツールです。 |
get_document(document_id, output="status", output_path=None) | ドキュメントのステータスとページ数を返します。output="text" または "pdf" を指定すると、最大 45 秒待機して処理済みの結果を取得します。結果を再取得してもページは消費されません。 |
list_documents(limit=20) | アカウント内の最新のドキュメントを、新しい順に返します。 |
get_balance() | アカウントの残りページ数を返します。無料ページ(月ごとにリセット)、契約ページ(ある場合)、Page Pack のほか、追加購入用のリンクも含まれます。ページは消費されません。 |
delete_document(document_id) | FastOCR 上のドキュメントと保存済みファイルを削除します。ローカルファイルには影響しません。 |
取得できるもの
| 取得できるもの | 方法 |
|---|---|
| ドキュメントのテキスト | ocr_file(path)、または get_document(id, output="text") |
| 検索可能な PDF | ocr_file(path, output="pdf")。入力ファイルと同じ場所に保存されます |
| ステータスとページ数 | get_document(id) |
| 最近のドキュメント | list_documents() |
対応言語とファイル
- 100 以上の言語に対応し、自動的に検出されます。言語の設定は不要です。
- 最大 1 GiB の PDF ファイル、および最大 20 MiB の PNG、JPG、JPEG、GIF、WebP、BMP 画像に対応しています。画像は 1 ページとして数えられます。
- 公式の
fastocr-sdkと公式の MCP Python SDK を基盤として構築されています。
ページ数と料金
FastOCR にサインインしているアカウントであれば、API キーを作成してすぐに利用できます。各アカウントには毎月 50 ページの無料枠があり、ウェブサイト上の PDF と共用です。画像は 1 ページとして数えられます。追加が必要になった場合は、料金ページで Page Pack を購入してください。Page Pack とページ残高は、ウェブサイトと API で共通です。エージェントに get_balance を実行させると、残りページ数を確認できます。アカウントで同時に処理できるドキュメントは 2 件です。API 契約がある場合、または 10,000 ページ以上を購入した場合は 10 件まで処理できます。最初のキーを作成すると、API 利用規約に同意したものとみなされます。
エラーと設定
ツールのエラーメッセージは、エージェントが対処できるように記述されています。無効なキー、アカウントのページ不足(buy_pages)、同時処理ドキュメント数の超過(concurrency_limit)、ファイルの欠落、未対応のファイル形式などが該当します。それぞれのメッセージに、次に行うべき操作が記載されています。ページ不足になったドキュメントは buy_pages エラーで失敗します。ツールがその旨を通知し、料金ページへのリンクを表示します。エラーコードはAPI ドキュメントに記載されています。
| 変数 | 用途 |
|---|---|
FASTOCR_API_KEY | 必須。API キーです。 |
FASTOCR_BASE_URL | 任意。https://api.fastocr.org を上書きします。 |
サポートとライセンス
お問い合わせ:[email protected]。バグ報告と機能リクエスト:GitHub の課題。Python SDK:fastocr-python。MIT ライセンスです。詳しくは LICENSE をご覧ください。FastOCR が制作しました。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。