pandas-doctor について
pandas-doctorは、pandasの遅い書き方を見つけ、提案した書き換えを手元のデータで検証したいPython開発者向けです。結果を比較して実行時間を測定してから書き換えを推奨・適用し、CLI、ノートブック、CI、MCPから利用できます。
主な機能
- 01よくあるpandasの遅い処理を検出
- 02実データで書き換え結果を比較
- 03変更前後の実行時間を計測
- 04検証済みの書き換えをファイルに適用
- 05CLI・ノートブック・CIでコードを確認
- 06チェックと検証用のMCPツール
活用シーン
- 01Pythonスクリプトの性能問題を特定
- 02適用前に書き換え結果を検証
- 03CIやpre-commitでpandasコードを確認
- 04AIアシスタントのコード変更案を検証
MCP 対応
pandas-doctor mcpコマンドは、check_code、verify_rewrite、list_rulesをMCPクライアント向けに提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
3掲載時のツール一覧 · 1 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| code | string | はい | スキャンする Python ソース:スクリプト、モジュール、またはノートブックのセル。 |
| filename | string | いいえ | 検出事項に表示する名前。実際のパスがある場合は、そのパスを使用します。 |
詳細
pandas-doctor


pandas-doctor は、コード内の処理が遅い pandas の行を見つけて書き換え、結果がまったく同じであることを実際のデータで確認します。そのうえで、推測ではなく計測に基づき、書き換えによってどれだけ高速化したかを知らせます。
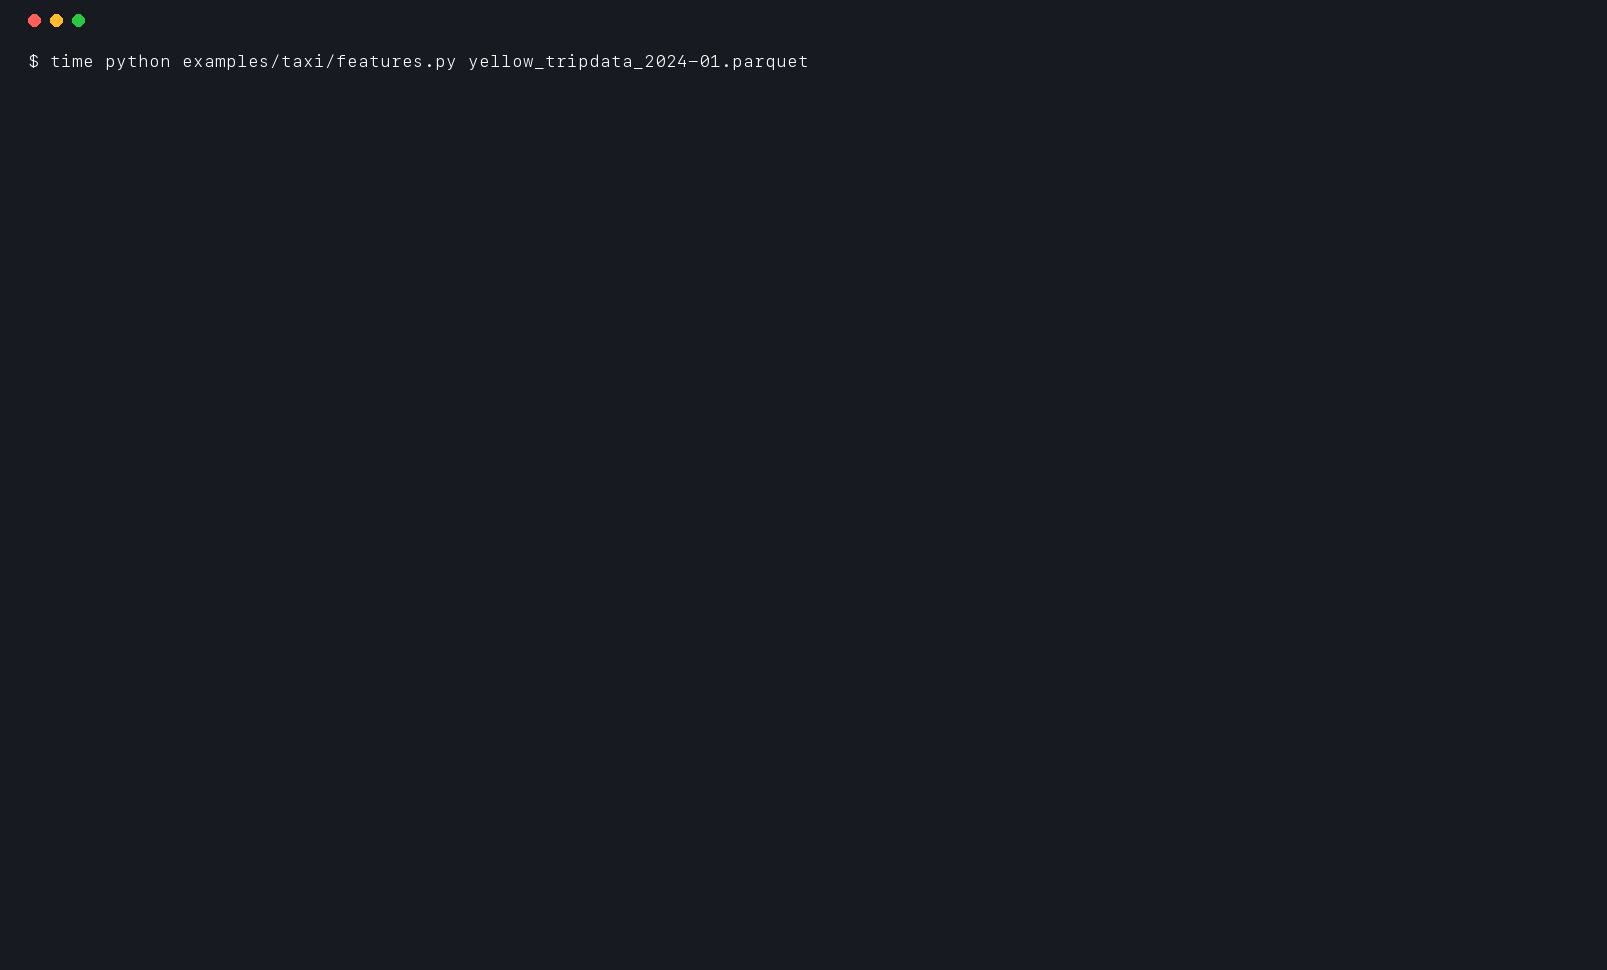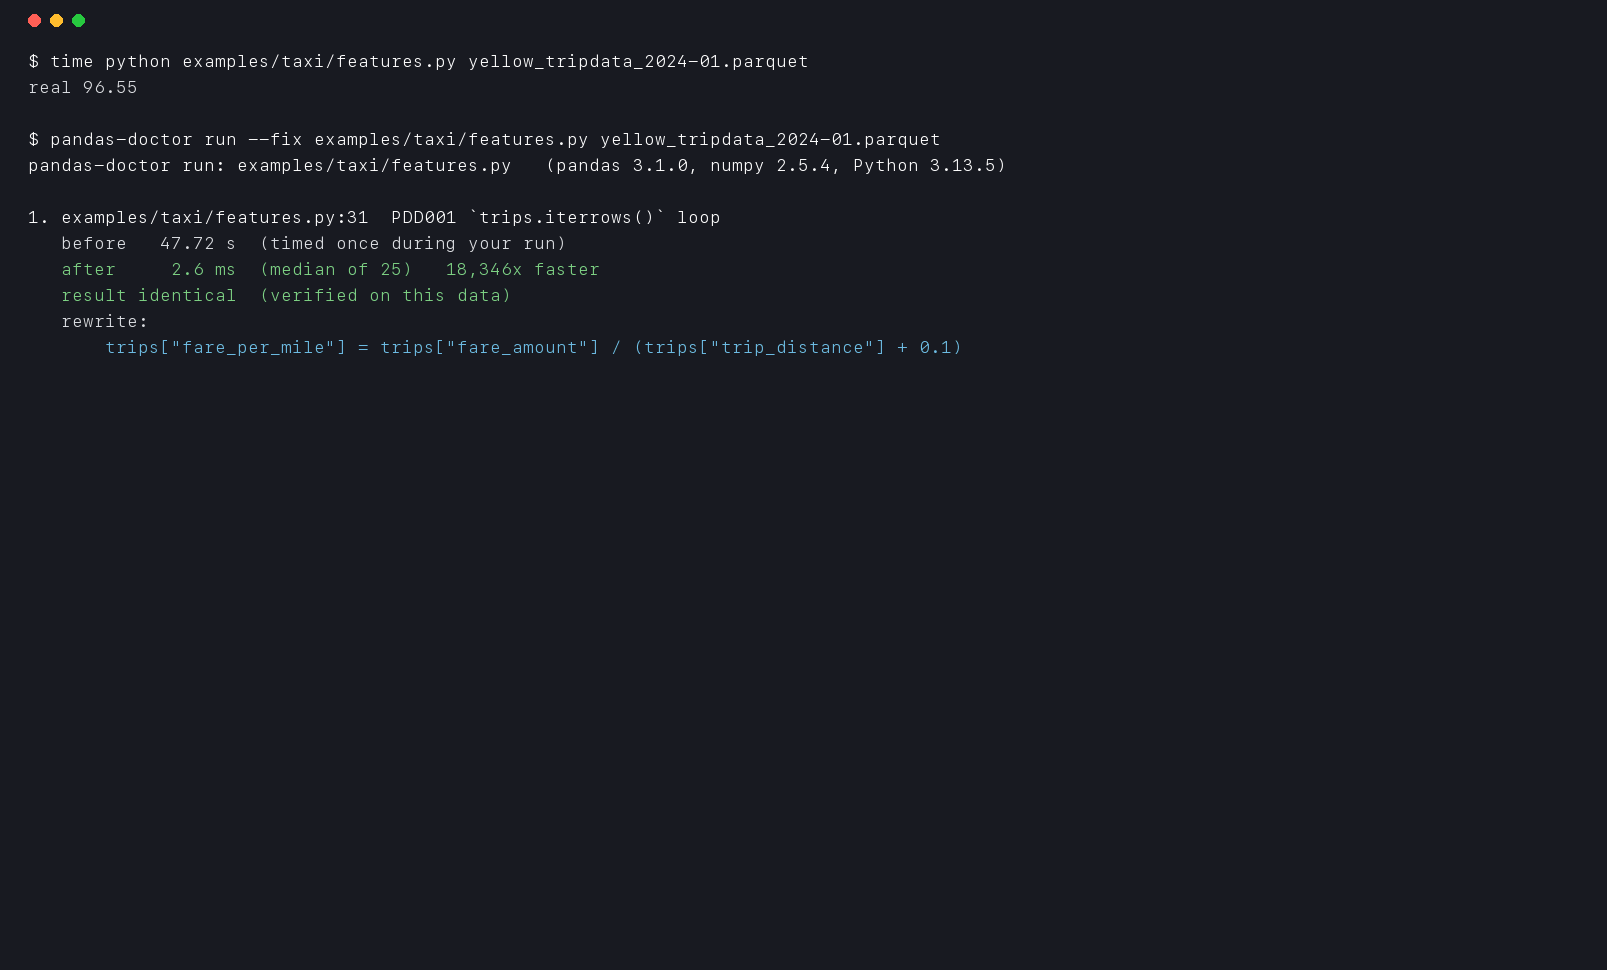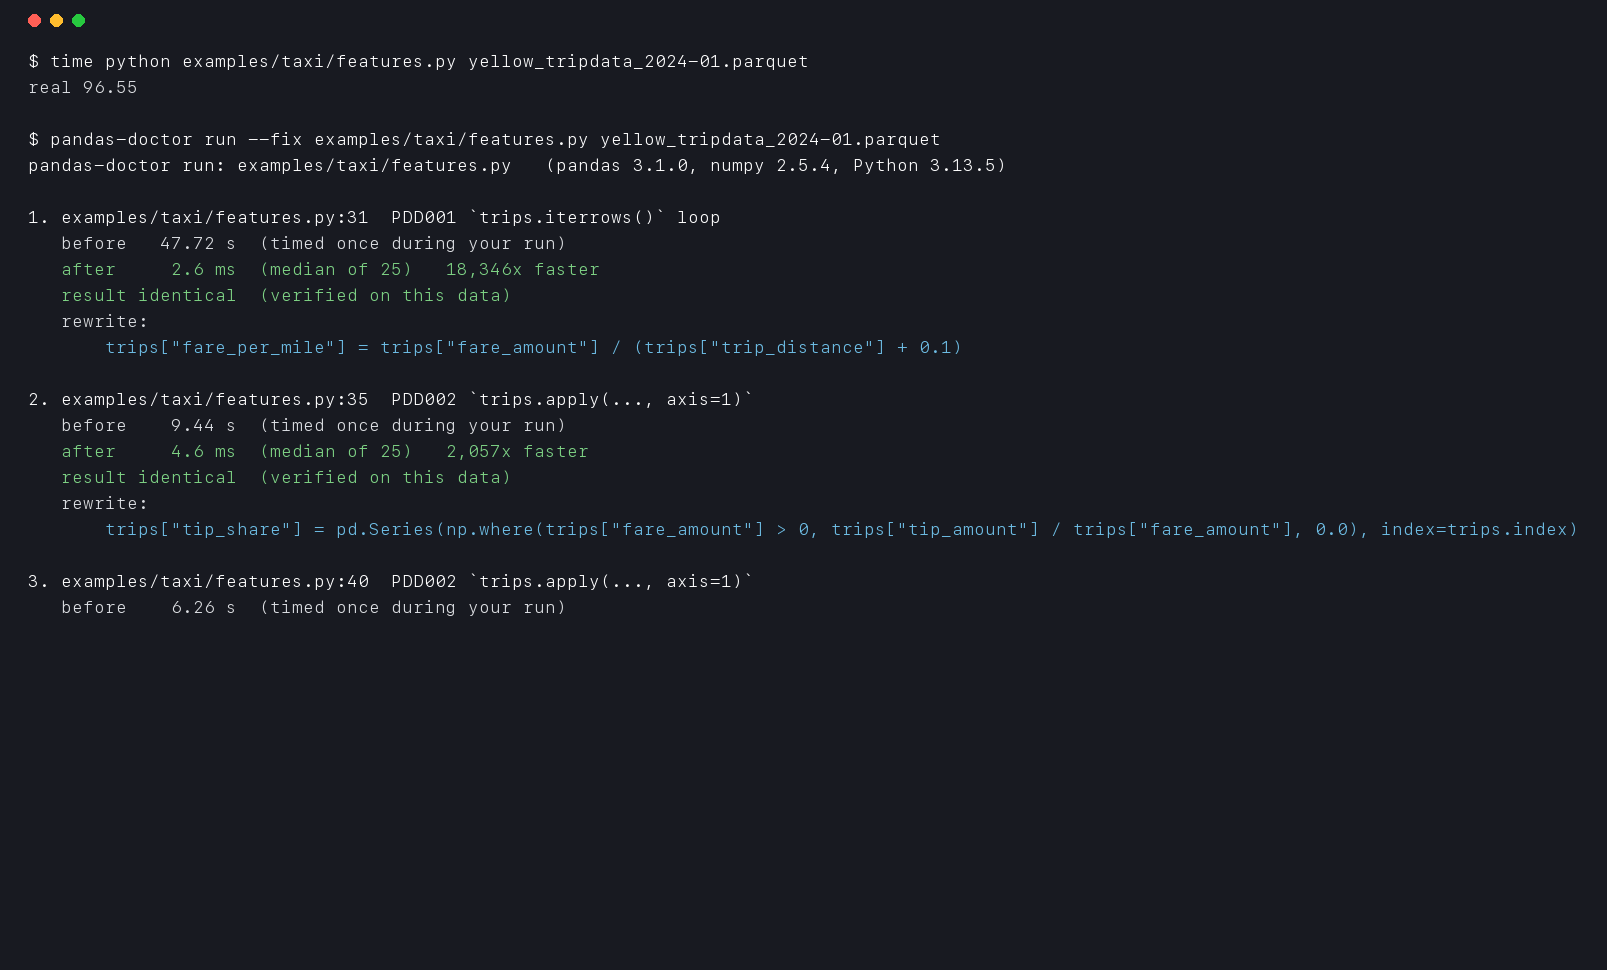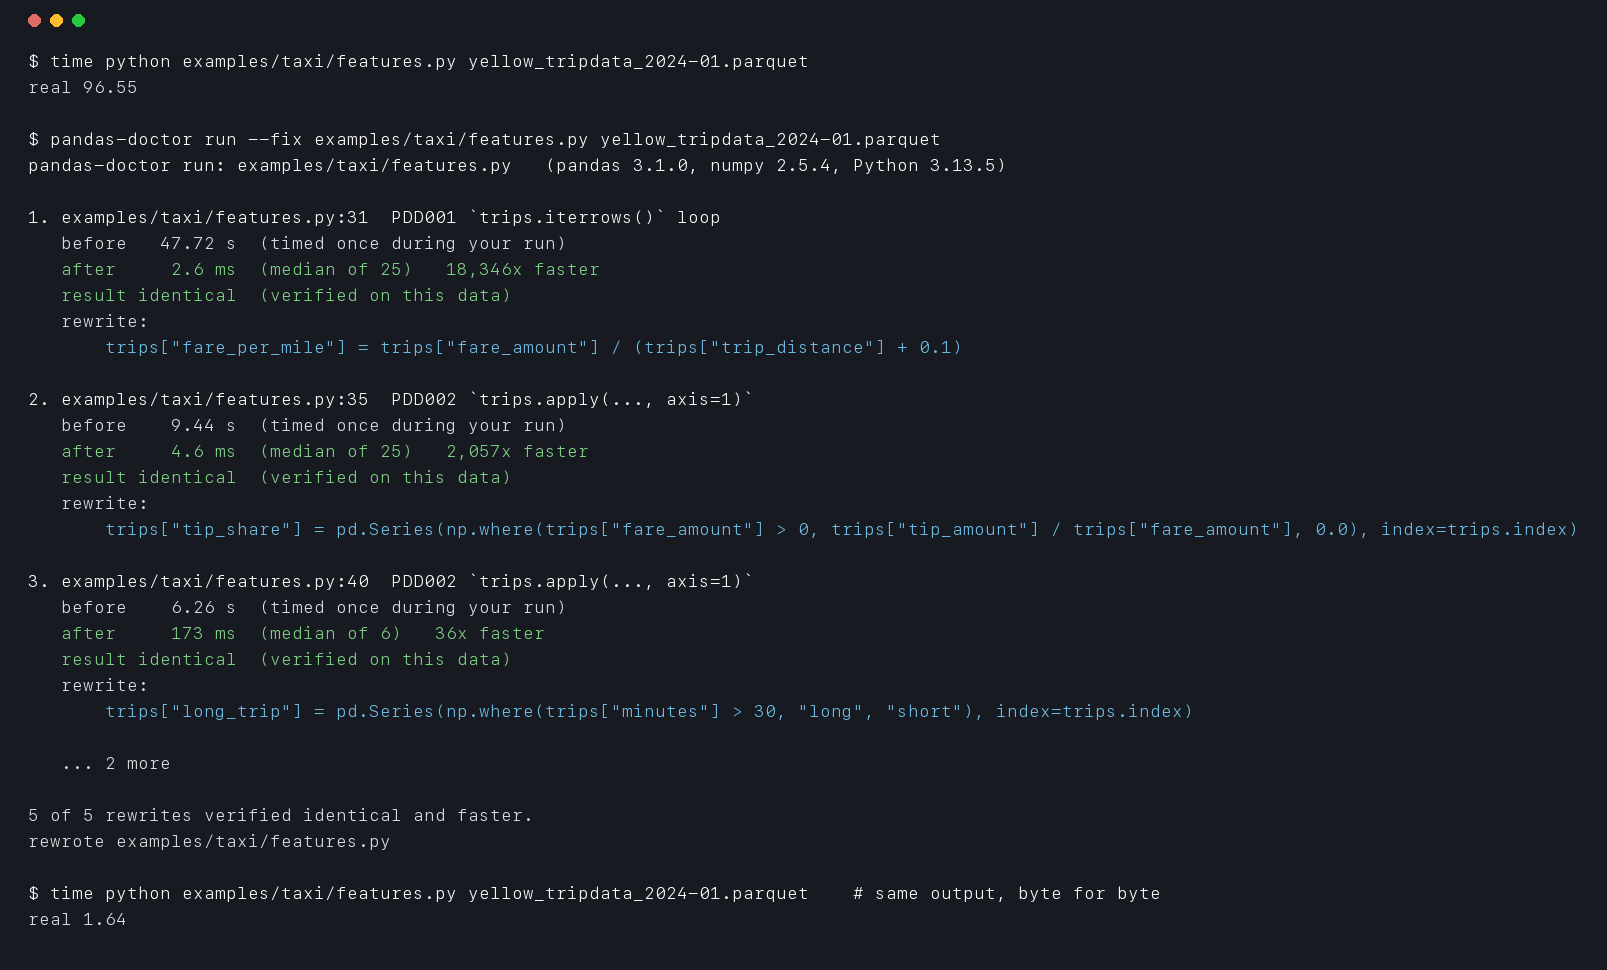
これは実データでの実行例です。examples/taxi/features.py を、NYC TLC のイエロータクシー乗車データ の 2024 年 1 月分(296 万行)に対して実行しました。多くのノートブックで見られるようなループを含んでいます。このスクリプトの実行には 96.6 秒かかりました(M4 Pro、pandas 3.1.0、pyarrow 使用)。pandas-doctor は、スクリプト自体のデータで 5 つの書き換えを確認し、すべて結果が同じで、かつ高速であることを検証しました。--fix の適用後、スクリプト全体の実行時間は 1.64 秒となり、まったく同じ出力を表示します。全レポートは docs/taxi-run-full.txt にあります。
examples/hero/features.py ではダウンロードは不要です。同じスクリプトを、シード値を指定して生成した合成乗車データ 100 万件で実行できます。適用前は 27.9 秒、適用後は 1.01 秒です(レポート)。
試してみる
pip install pandas-doctor
pandas-doctor run your_script.py
または、まずブラウザーで試してみることもできます。インストールは不要です:
run はスクリプトを通常どおり実行します。処理が遅いパターンを見つけると、そのコードの入力をコピーし、通常どおりコードを実行した後、コピーに対して書き換え後のコードを実行して出力を比較します。--diff は検証済みの書き換えをパッチとして表示し、--fix は書き換えをファイルに反映します。
ノートブックでは:
%load_ext pandas_doctor
%%doctor
for i, row in df.iterrows():
    df.at[i, "total"] = row["price"] * row["qty"]
%%doctor --rewrite は、検証済みのコードを下の新しいセルに挿入します。
「同一」の意味
2 つの結果が同一と見なされるのは、次のすべてを満たす場合だけです。
- 各値に至るまで型が同じ(
numpy.float64はfloatではありません) - dtype、インデックス、列、ラベル、名前を含めて同じ
- 欠損値が同じ位置にある
- 値が完全に一致する
各チェックの結果は、次の 4 つの判定のいずれかになります。
| 判定 | 意味 | run で適用されるか |
|---|---|---|
| identical | 上記のすべてが一致しています | はい |
| equal values, different scalar types | すべての値は完全に一致しますが、元の値が Python のスカラーだった箇所に numpy のスカラーがある、またはその逆です。レポートには型が記載されます。 | はい。レポートにもその旨が記載されます。--strict-types を指定すると適用されません。 |
| equal within tolerance | 浮動小数点数の差が --rtol 以下です。通常は、合計を異なる順序で計算したことが原因です。最大の差が表示されます。 | --rtol を指定した場合のみ |
| different | それ以外のすべてです。最初に異なる箇所が示されます | いいえ |
これは見た目以上に厳密で、実際の違いを検出します。
iterrowsは各行を Series として渡すため、フレームに浮動小数点数の列もあると、整数列が浮動小数点数に変わります。単純な書き換えでは整数が保たれ、dtype が変わるため、different になります。- 数値のみのフレームでは、
row["x"] * 2をリストに集めると numpy の浮動小数点数になりますが、同じ処理を.tolist()で行うと Python の浮動小数点数になります。これは equal values, different scalar types です。問題になることはまれですが、たとえばjson.dumpsはnumpy.int64を処理できません。 - 合計を異なる順序で計算すると、浮動小数点数の最下位ビットがわずかに変わります。これは equal within tolerance です。
単純な書き換えが受け入れられない場合、pandas-doctor は、より元の動作に忠実な方法をいくつか試します。たとえば、iterrows が使用していた行の dtype、numpy のスカラー、同じ合計順序などです。受け入れられる候補のうち、最も単純なものを採用し、同じ程度に単純な候補が複数ある場合は、identical のものを優先します。どれも受け入れられない場合は理由を伝え、何も変更しません。
同一でも高速化されない書き換えは、おすすめされません。実際にそうなる場合があります。たとえば、Python をバックエンドとする文字列では、.str.lower() は .apply(lambda x: x.lower()) より遅くなることがあります。
「検証済み」とは、常に このデータで という意味です。厳密なチェックですが、あらゆる入力に対する証明ではありません。
AI に頼むだけではだめですか?
アシスタントも同じ書き換えを提案できますが、その書き換えが手元のデータで同じ結果になるかどうかは判断できません。また、上記の例が示すように、実際には同じ結果にならないこともよくあります。pandas-doctor は両方のバージョンを実行して比較します。アシスタントを使う場合は、pandas-doctor を呼び出して編集内容をチェックさせることもできます(AI アシスタントを参照)。
3 つのコマンド
| コマンド | 処理内容 | コードを実行しますか? |
|---|---|---|
pandas-doctor check PATH | .py ファイルとノートブックから低速なパターンを検出し、書き換え案を出力します。高速で、CI や pre-commit 向けです。 | いいえ |
pandas-doctor run script.py | スクリプトを実行し、データを使って各書き換えをチェックし、両方のバージョンを計測して、検証済みのものを適用できます。 | はい。それが目的です |
pandas-doctor verify | 独自の書き換えを検証します。元のコード、候補、入力を作成するセットアップコードを渡します。 | それらのスニペットのみ |
pandas-doctor verify --setup setup.py --original slow.py --candidate fast.py
verify は、書き換えが identical またはスカラー型を除いて同等の場合、終了コード 0 を返します。ただし、--strict-types を指定した場合は除きます。--accept-tolerance を指定すると、equal within tolerance も許容されます。--format json(および run --json)では、判定は identical、scalar_types、within_tolerance、different のいずれかになり、詳細も併記されます。
検出対象
| ルール | 遅いパターン | 書き換え | 10万行での測定結果 | 結果 |
|---|---|---|---|---|
| PDD001 | for i, row in df.iterrows(): ... | 列式、.sum()、.extend(...) | 1.13 s → 79 µs(14,239倍) | 同一 |
| PDD002 | 列の計算を行う df.apply(f, axis=1) | 列式または np.where | 192 ms → 92 µs(2,091倍) | 同一 |
| PDD003 | ループ内の X = pd.concat([X, part]) | パーツを収集し、1回の pd.concat を実行(安全でない修正) | 65.5 ms → 2.3 ms(29倍) | 同一 |
| PDD004 | s.apply(lambda x: ...)、.map(lambda ...) | .str / .dt / 算術演算 | 27.8 ms → 403 µs(69倍) | 同一 |
| PDD005 | groupby(...).apply(lambda g: g[c].count()) | groupby(...)[c].count() | 4.2 ms → 479 µs(8.8倍) | 同一 |
| PDD006 | 列ごとの astype ループ(run のみ) | 1回の astype 呼び出し | 102 ms → 111 ms(1.1倍遅い) | 同一 |
| PDD007 | インデックスをループ処理する際の df.at[i, c] = ... | 列全体への代入 | 844 ms → 64 µs(13,283倍) | 同一 |
| PDD008 | ユニーク値の種類が少ないテキスト列(run のみ) | category | メモリ:100万行で 52.8 MB → 1.0 MB | 提案のみ |
benchmarks/ を使って、Apple M4 Pro、Python 3.13.5、pandas 3.1.0、numpy 2.5.4 で測定しました(pandas 2.2.3 と pyarrow を使用した場合の全結果は benchmarks/results/ にあります)。各行はパターンの一例です。高速化の度合いは、データとループ内の処理によって異なります。
知っておくべき結果が2つあります。
- 文字列メソッドの性能は、文字列バックエンドによって異なります。
.apply(lambda x: x.strip().lower())→.str.strip().str.lower()は、pyarrow なしの場合は 5.6 ms → 8.7 ms(1.5倍遅い)でしたが、pyarrow をインストールした場合は 8.0 ms → 1.9 ms(4.2倍)でした。pandas-doctor は推奨する前に測定します。 - groupby の合計はビット単位では一致しません。
groupby.apply(lambda g: g[c].sum())→groupby[c].sum()は 5.7 ms → 613 µs(9.3倍)ですが、pandas の組み込み sum は補償和を使用するため、結果は相対誤差 2.2e-16 以内でのみ一致します。pandas-doctor はそのことを報告し、--rtolが指定された場合にのみ適用します。
PDD006 と PDD008 はデータを必要とするため、run のみで報告されます。PDD006 は、1回の astype 呼び出しが実際に高速な場合にのみ表示されます。現在の pandas リリースでは、通常は高速になりません。
検出結果には2つのレベルがあります。
- warning:修正する価値のある遅いパターンです。検出すると
checkは 1 で終了します(報告のみ行うには--exit-zeroを指定します)。 - info:ベクトル化された書き換えに該当しない
iterrowsループです。通常は、各行に対してプロット、出力、または何らかの呼び出しを行うものです。以下のコーパスチェックで検出されたiterrowsの結果99件は、すべてこのパターンでした。情報レベルの結果は一覧表示され(GitHub Action では通知として表示され)、checkが失敗することはありません。
check --fix が単独で動作を変更することはありません。concat の書き換え(PDD003)は、すべてのパーツで列と dtype が同じ場合にのみ同一になります。プロパティテストでは、一致しないデータフレームが見つかりました。そのため、これは --unsafe-fixes が必要な安全でない修正であり、run は実際のデータでチェックします。
リリース前に、誤検出を探すため、一般に公開されている13のリポジトリ(pandas、statsmodels、Kaggle のコース、人気のノートブック集)から8,419ファイルを対象に check を実行しました。結果と修正内容は docs/corpus.md にあります。よく知られた教材用ノートブックで見つかった遅い行を再測定した結果は、高速化ギャラリー にあります。
CI での使用
pre-commit:
- repo: https://github.com/furqan-khan07/pandas-doctor
  rev: v0.1.0
  hooks:
    - id: pandas-doctor
GitHub Action。差分に注釈を付け、PR にサマリーコメントを1つ維持します。
- uses: furqan-khan07/[email protected]
  with:
    paths: src notebooks
コメントには permissions: pull-requests: write が必要です。check --format json は、その他のあらゆるものと連携できます。
AI アシスタント
pandas-doctor mcp は MCP 経由で、check_code、verify_rewrite、list_rules の 3 つのツールを提供します。pip install "pandas-doctor[mcp]" でインストールするか、uvx に取得させてください。Claude Code では次のように設定します。
claude mcp add pandas-doctor -- uvx --from "pandas-doctor[mcp]" pandas-doctor mcp
Cursor、Claude Desktop、または mcpServers 設定を受け付けるその他のクライアントでは、次のように設定します。
{
  "mcpServers": {
    "pandas-doctor": {
      "command": "uvx",
      "args": ["--from", "pandas-doctor[mcp]", "pandas-doctor", "mcp"]
    }
  }
}
MCP Registry にも io.github.furqan-khan07/pandas-doctor として登録されています。
Claude Code 向けには、速度向上を主張する前に検証するようアシスタントに指示するスキルを含むプラグインもあります(uvx 経由で CLI を使用するか、追加済みの場合は上記の MCP サーバーを使用します)。
/plugin marketplace add furqan-khan07/pandas-doctor
/plugin install pandas-doctor@pandas-doctor
制限事項
runはpython script.pyと同様に、スクリプトを 1 回実行します。検出されたブロックが単純な計算(ファイル、ネットワーク、乱数を使わないもの)の場合は、安定した中央値を得るため、コピー上で再実行します。処理の遅いブロックは実行中に 1 回だけ計測し、その旨をレポートに記載します。- 検出された箇所は、それぞれ初回の呼び出し時にチェックされます。2 GB を超える入力はコピーされないため、チェックされません。
- 書き換えに対応しているのは、表に記載された形式のみです。それ以外は推測せず、注記を表示します。
- ネットワーク呼び出しやテレメトリーはありません。
- Python 3.11 以降と pandas 2.2 以降に対応し、pandas 2.2 から 3.1 でテスト済みです。
貢献
誤検出や、対応してほしい遅いパターンを見つけた場合は、小さなコード例を添えて issue を作成してください。修正前後のテストとベンチマークが付いたパターンは、追加しやすくなります。
pandas コントリビューターの Furqan Khan が作成しました。同氏による DST プロットの修正(pandas-dev/pandas#69960)はマージ済みで、pandas 3.2 に含まれています。MIT ライセンスです。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。