qikly について
qiklyは、独立したPythonモジュールを検証する開発者向けで、受け入れ基準に基づくテスト生成とコード修復を分離します。テストエージェントがテストを作成し、コーディングエージェントは基準やテストを見ずにコードのコピーを修正します。
主な機能
- 01ミューテーションによる既存テストの評価
- 02受け入れ基準タスクファイルの作成
- 03基準からのテスト生成
- 04テストに合わせたコードコピーの修復
- 05コーディングエージェントへの基準の秘匿
- 06エージェントSkillのインストール
活用シーン
- 01Pythonモジュールのテスト不足を確認する
- 02データ変換ロジックを独立して検証する
- 03コーディングエージェントの実装を評価する
- 04ソースファイルを変更せず受け入れ検査を行う
MCP 対応
qiklyはMCPサーバーとして動作し、エージェントによる実行開始と結果取得を可能にします。ツールは受け入れ基準を返さないため、コーディングエージェントには失敗したテストとpytest出力だけが見えます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
4掲載時のツール一覧 · 3 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| model | string | いいえ | |
| task_id | string | はい | |
| provider | string | いいえ |
詳細
qikly




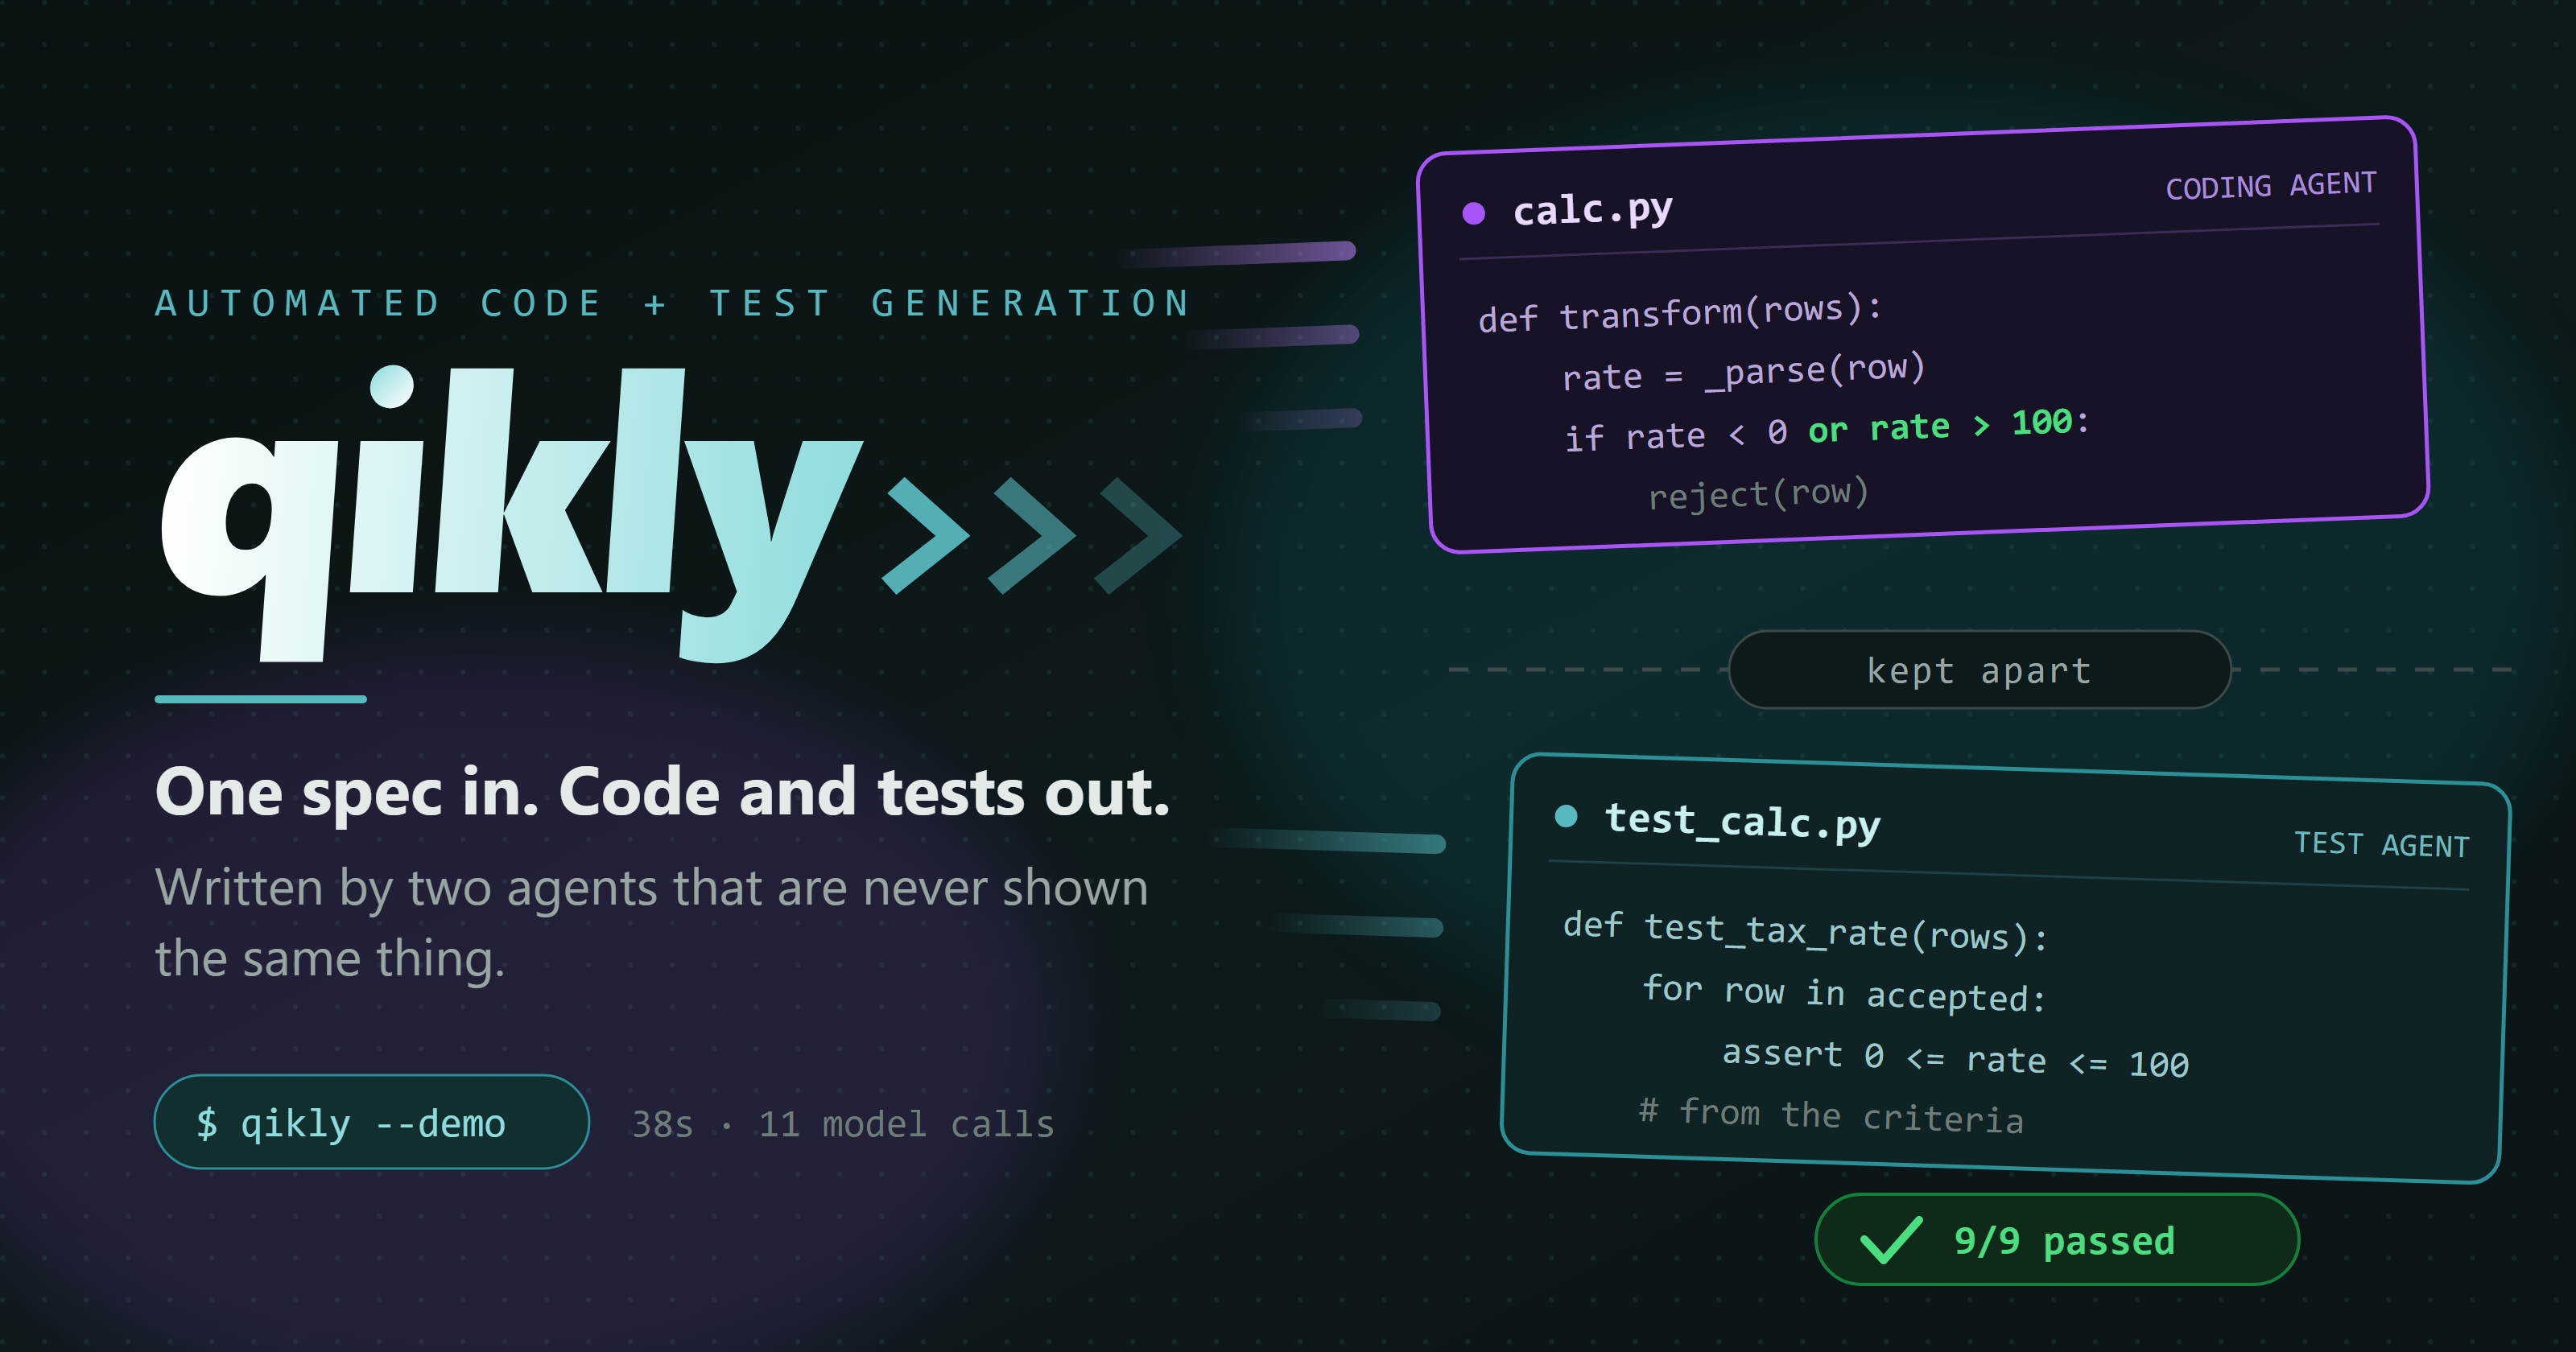
課題:AI がコードとそのテストの両方を書く場合、そのテストが本当に有効だとどうすれば分かるでしょうか?
ある実行を記録した例です。テストエージェントがテストスイートを作成します。仕様の受け入れ基準に基づき、レートは100を超えてはならないと指示されています。コーディングエージェントは受け入れ基準を一度も見ておらず、失敗したテストからそのレート制限を発見しました。そして自ら or rate > 100 を追加したため、修正を自動修復ループで適用した後、コードは最終的にテストスイートに合格し、9件中9件が成功しました。
| はじめに | qikly を使う理由 · ここから始める · 用途 · コーディングエージェントから使う |
| 仕組み | 考え方 · 他との違い |
| 実行する | 4つの使い方 · 無料コマンドの詳細 · デモの内容 · 独自データをすべて使う · 2種類のテストデータと異なるソース · 実行 · 実行が収束しない場合 · 出力 · テストで測定されない点を確認する2つの無料チェック |
| セットアップ | 設定 · CI で使う · バージョン確認 |
| リファレンス | 機能 · 現在の用途 · qikly が実際に検出した例 · 参考資料 |
| コミュニティ | バッジ · タスクの提供 · 開発の経緯 · プライバシー · ライセンス |
qikly を使う理由
試験問題と解答を自分で作成してから自分で試験を受ける学生は、合格するでしょう。モデルに受け入れ基準を与え、実装とそれを検証するテストスイートの両方を作るよう求めたときにも、同じことが起こります。すべてがグリーンになりますが、そのグリーンには何の意味もないかもしれません。qikly は学生から解答を取り上げます。コーディングエージェントは受け入れ基準を一度も見ることがありません。
ここから始める
始める前に、次の3つを確認してください。
-
qikly をインストールします:
pip install --upgrade qikly。 -
手順2と3で使う API キーを1つ設定します:Google Gemini(無料枠、カード不要)、Anthropic、または OpenAI。qikly を実行するターミナルで、次のコマンドを実行します。
export GEMINI_API_KEY="..." # macOS and Linux $env:GEMINI_API_KEY = "..." # Windows PowerShellキーの取得方法と、その他2つのプロバイダー。 ステップ1ではキーは不要です。キーがない場合、ステップ2ではすべての回答を 自分で記述することになります。
-
テストが単独で通ることを確認します。プロジェクトのルートフォルダーで 次を実行してください:
python -m pytest。qiklyも同じ方法で実行するため、 パッケージが不足していたり、Pythonのバージョンが間違っていたりすると、 ステップ1も停止します。
次に、そのルートフォルダーから以下を実行します。各ステップでは、モジュール1つか フォルダー全体を指定し、すべてのステップで同じパスを使います:
qikly --score my_module.py       # 1. what your tests miss         free, no key
qikly --scaffold my_module.py    # 2. the drafted spec, to check   a fraction of a cent
qikly --tasks my_module.py       # 3. the run                      a cent or so
-
--scoreは、現在のテストを評価します。 コードのコピーに一度に1つずつ 障害を仕込み、テストで検出できなかったものを、何も検証されていない動作に関する 質問としてそれぞれ提示します。テストは自動で見つかります。プロジェクトのルートから 検索した、コードをインポートするtest_*.pyと*_test.pyファイルが対象です。 代わりにファイルを指定するには、--score-tests tests/を追加します。モデルは 呼び出されず、あなたのファイルも変更されません。 -
--scaffoldは仕様書の草案を作成します。inputs_private/config/tasks/MY_MODULE_VERIFY.yamlに、コードから読み取れる情報をすべて記入し、テストですでにコードに渡している値を データファイルにまとめます。キーを設定すると(Google Gemini、Anthropic、または OpenAI)、仕様作成エージェントが、所有者だけが記述できる部分の草案も作成します。 モジュールの用途を説明する一文と、ステップ1の各質問への回答を受け入れ基準として 記述します。READMEとdocstringは読みますが、コードは読みません。そのため、 コードが実際に何をするかではなく、何をするべきかを記述し、そこから作成したテストが コードと一致しないことがあります:#? What should apply_discount(100, 100) do? #? Answer below drafted by qikly from your README or docstrings: "...so a rate #? of 100 or more is rejected with ValueError". Keep it, or change it. - "apply_discount(100, 100) raises ValueError"各回答には、その根拠が記載されます。ドキュメントからの引用は一語一句照合され、 エージェントがモジュールの用途から判断したものの、書かれた内容だけでは決められない 場合は
CHECKと表示されます。草案をそのまま実行することも、引用の有無にかかわらず、 納得できない回答を変更することもできます。ドキュメントだけでは決められない内容は TODOとして残ります。qiklyがコードを実行して値を見つけた選択肢については、その番号で 回答します(値を尋ねる項目なら1: <value>、コードの現在の動作を維持するならkeep)。または、値を指定する文で回答します。未回答のTODOはスキップされます。 キーがない場合、すべての回答を自分で記述し、requirements行にはTODO: MODIFY THIS:と記されます。フォルダーを指定すると、ステップ1で対象となった 各モジュールについてタスクファイルが1つずつ作成されます。#?で始まる行は あなた向けのメモで、どちらのエージェントも読みません。このファイルが唯一の信頼できる 情報源です。変更を加えたら、ステップ3をもう一度実行してください。qikly --validate my_module.pyで無料で検証でき、各短い回答がどのような基準になるかを確認できます。 -
--tasksは処理を実行します。APIキー(Google Gemini、Anthropic、または OpenAI)が必要です。コードを一切見せる前に、テストエージェントがあなたの基準に基づいて テストを作成します。別のコーディングエージェントは、そのテストを一切見ずに、コピーした コードをテストに合格するまで修正します。あなたのファイルが編集されることはありません。 最後に、qikly --take-tests my_module.pyを案内します。これを実行すると、新しい テストがあなたのテストフォルダー内のqikly_generated/にコピーされ、qiklyのコピーではなく あなたのモジュールをインポートするように書き換えられたうえで、あなたのコードに対して 実行されます。そこで失敗するテストは、その基準と照らし合わせて確認してください。 コードかテストのどちらかが間違っています。レポートには、どの失敗が基準から作成された テストによるものか、どれがテスト作成者独自の解釈によるものかが示されます。
まず、完成例で試してみてください: docs/examples/
には、モジュール1つのプロジェクトと、モジュール2つのフォルダーがあり、それぞれ回答済みの
タスクファイルも含まれています。自分のファイルと見比べてください。
このタスク名はモジュール名に由来する MY_MODULE_VERIFY です。_VERIFY は、すでにあるコードをテストするタスクを示します。入力する必要はありません。どのステップでも --score に指定したパスが使われ、--task-id で指定したタスクもそのパスから見つかります。qikly --scaffold my_module.py --fresh を実行すると、代わりに MY_MODULE.yaml が書き込まれます。このタスクでは、qikly が同じインターフェースの新しい実装を書きます。
ほかの方法
| 目的 | 実行するコマンド | 必要なもの |
|---|---|---|
| 同梱タスクで、実際の実行を最初から最後まで見る | qikly --demo | API キーが必要です。所要時間は約 30 秒で、費用は 1 セント未満です |
| 自分のプロジェクトで、完成済みの例から始める | qikly --example | セットアップは不要です |
| 同梱タスクで、分割の様子を確認する | qikly --explain CALC_TAX | 何も必要ありません。API キーも不要です |
| 何もない状態からタスクを作成する | qikly --init | セットアップは不要です |
知っておくとよいこと
- ミーティングで試すなら、単独の
--scoreがおすすめです。 すでにあるテストとともに、モジュールまたはパッケージを指定します。コードのコピーに一度に 1 つの不具合を仕込み、それぞれに対してテストを実行し、何も検出できなかった不具合を示します。どちらのフラグも必要です。一方は何を壊すか、もう一方は何で検出するかを指定します。 - テストによって、コードの変更が検出されるかどうかを示します。コードを壊して動作するため、そもそもコードが正しかったかどうかは判断できません。コードが一度も行わなかったことは検出できません。モデルは呼び出されず、コードは変更されず、コードがマシンの外に出ることもありません。
- 仕込める不具合をすべて仕込みます。上限は 1 つのモジュールで 60 個、フォルダーで 150 個です。テストに時間がかかる場合はサンプルを使います。
--score-mutants 48で数を設定し、--score-seed 1で別のサンプルを選びます。 --demoは、削除することを前提とした使い捨てのdemo/throwaway_<timestamp>/フォルダー内で動作します。これは見学用であり、開発用ではありません。--exampleと--scaffoldは、現在のディレクトリーに実際のプロジェクトを作成します。開発の開始には、この 2 つを使ってください。- 単なるインストールではなく
--upgradeを使ってください。Skill はパッケージに同梱されています。古いバージョンがすでにあるマシンでpip install qiklyを実行すると、「Requirement already satisfied」と表示され、何も変更されません。その状態で--install-skillを実行すると、古い Skill が書き込まれます。 - クイックスタートでは、同じ手順を説明した後、各コマンドを個別に解説しています。
- test.qikly.com はこのページの 2 分版です。ほかの人に送るならこちらをお使いください。
新機能:エージェント Skill。
qikly --install-skillを実行すると、Claude Code、Gemini CLI、Codex、Cursor、GitHub Copilot に qikly の操作方法を教えられます。 Skill の内容。
対象ユーザー: データを変換する自己完結型の Python モジュール(ETL のステップ、マージ、計算、検証ルーチンなど)に AI コーディングエージェントを使っている開発者やチームです。同じエージェントがコードとテストの両方を書いた場合、テスト一式が成功しても信用したくない人を対象としています。小規模から中規模のリポジトリーで、1 度に 1 つのモジュールを扱うのに適しています。テストが失敗したときは、その失敗が示すファイルだけが読み込まれるため、実行は小規模かつ迅速に保たれます。自動車、医療機器、フィンテック、防衛など、検証の独立性がすでに求められる分野で特に適しています。同梱例の ADAS_HEADWAY は、前方レーダーのサンプルから車間距離を確認します。対象ユーザーをご覧ください。
どのような用途か
大規模な既存リポジトリではなく、データを変換する自己完結型の Python モジュール向けです。ETL、マージ、計算、検証などが対象です。誤った結果が正しい結果に見えてしまうのがこのレイヤーであり、ルールに基づいて書かれたテストだけが、それを検出できます。
**現時点で適していない用途:**大規模な既存リポジトリです。PATCH プロンプトが読み込むのは FIX で指定されたファイルだけです。大きなファイルは現在、全体を読み込むのではなく抜粋されますが、ファイルを横断するインデックスはありません。現時点で適している用途をご覧ください。
コーディングエージェントから使う
qikly はMCPサーバーとして動作するため、任意の MCP ホスト上のエージェントが実行を開始し、会話を離れずに結果を読み取れます。現時点では VS Code と Claude Code でテスト済みです。uvがインストールされていれば、ほかにインストールするものはありません。Claude Code では次のようにします。
claude mcp add qikly -- uvx --from "qikly[mcp]" qikly-mcp
VS Code では、このページ上部にあるInstall qikly MCPバッジが同じコマンドを書き込みます。
**qikly のツールは、成功時も失敗時も、受け入れ基準を返しません。**エージェントに表示されるのは失敗したテストと pytest の出力だけで、違反したルールは表示されません。
docs/mcp.mdには、4 つのツール、pip を使ったインストール方法、サーバーが起動しない場合の対処方法、生成されたテストをエージェントの手の届かない場所に保つ方法が記載されています。
Skill として使う方法:呼び出すのではなく、使い方を教える
qikly --install-skill
このコマンドは、現在のディレクトリの .claude/skills/qikly に Skill をコピーします。Skill はエージェントが読むフォルダーです。qikly が適切な選択肢となる場面、仕様のうちコーディング担当者が知る必要のある判断事項と、伏せておくべき結果、修復ループが停滞したときの意味、コストのかからないコマンドをエージェントに伝えます。サーバーも設定も必要ありません。
Claude Code、Gemini CLI、Codex、Cursorで読み込まれ、その後正しく使われることを確認済みです。それぞれで初めて試した際、競合するテスト用 Skill が隣にインストールされたプロジェクトで、qikly に言及していない依頼を与えました。エージェントには別の選択肢があり、ヒントもありませんでした。報告する価値があるのはそのためです。
--install-skill agents、
cursor、または gemini を指定すると、各ツールが独自のフォルダーとして案内している場所に書き込みます。一方、copilot を指定すると GitHub Copilot が読み込む指示ファイルに書き込みますが、ここに挙げた中で、その読み込みをまだ誰も確認していないのはこの方法だけです。
**この 2 つは互いに代替するものではありません。**MCP サーバーはコードなので、どのツールも受け入れ基準を返さないことや、それが変更された場合にテストでビルドを失敗させることを強制できます。Skill は指示なので、情報を伝えることしかできず、その旨も明記されています。Skill がインストールされているかどうかにかかわらず、ツールによって情報の非公開が強制されます。docs/skill.mdには、Skill の内容、読み込まれているか確認する方法、両者の違いが詳しく記載されています。
アイデア
qiklyは学生から答えを取り上げます。受け入れ基準からテストスイートを生成し、そのテストスイートに照らして実装を作成し、すべてのテストに合格するか、リトライ回数の上限に達するまで修正を続けます。その間の失敗、推論内容、差分をすべて記録します。
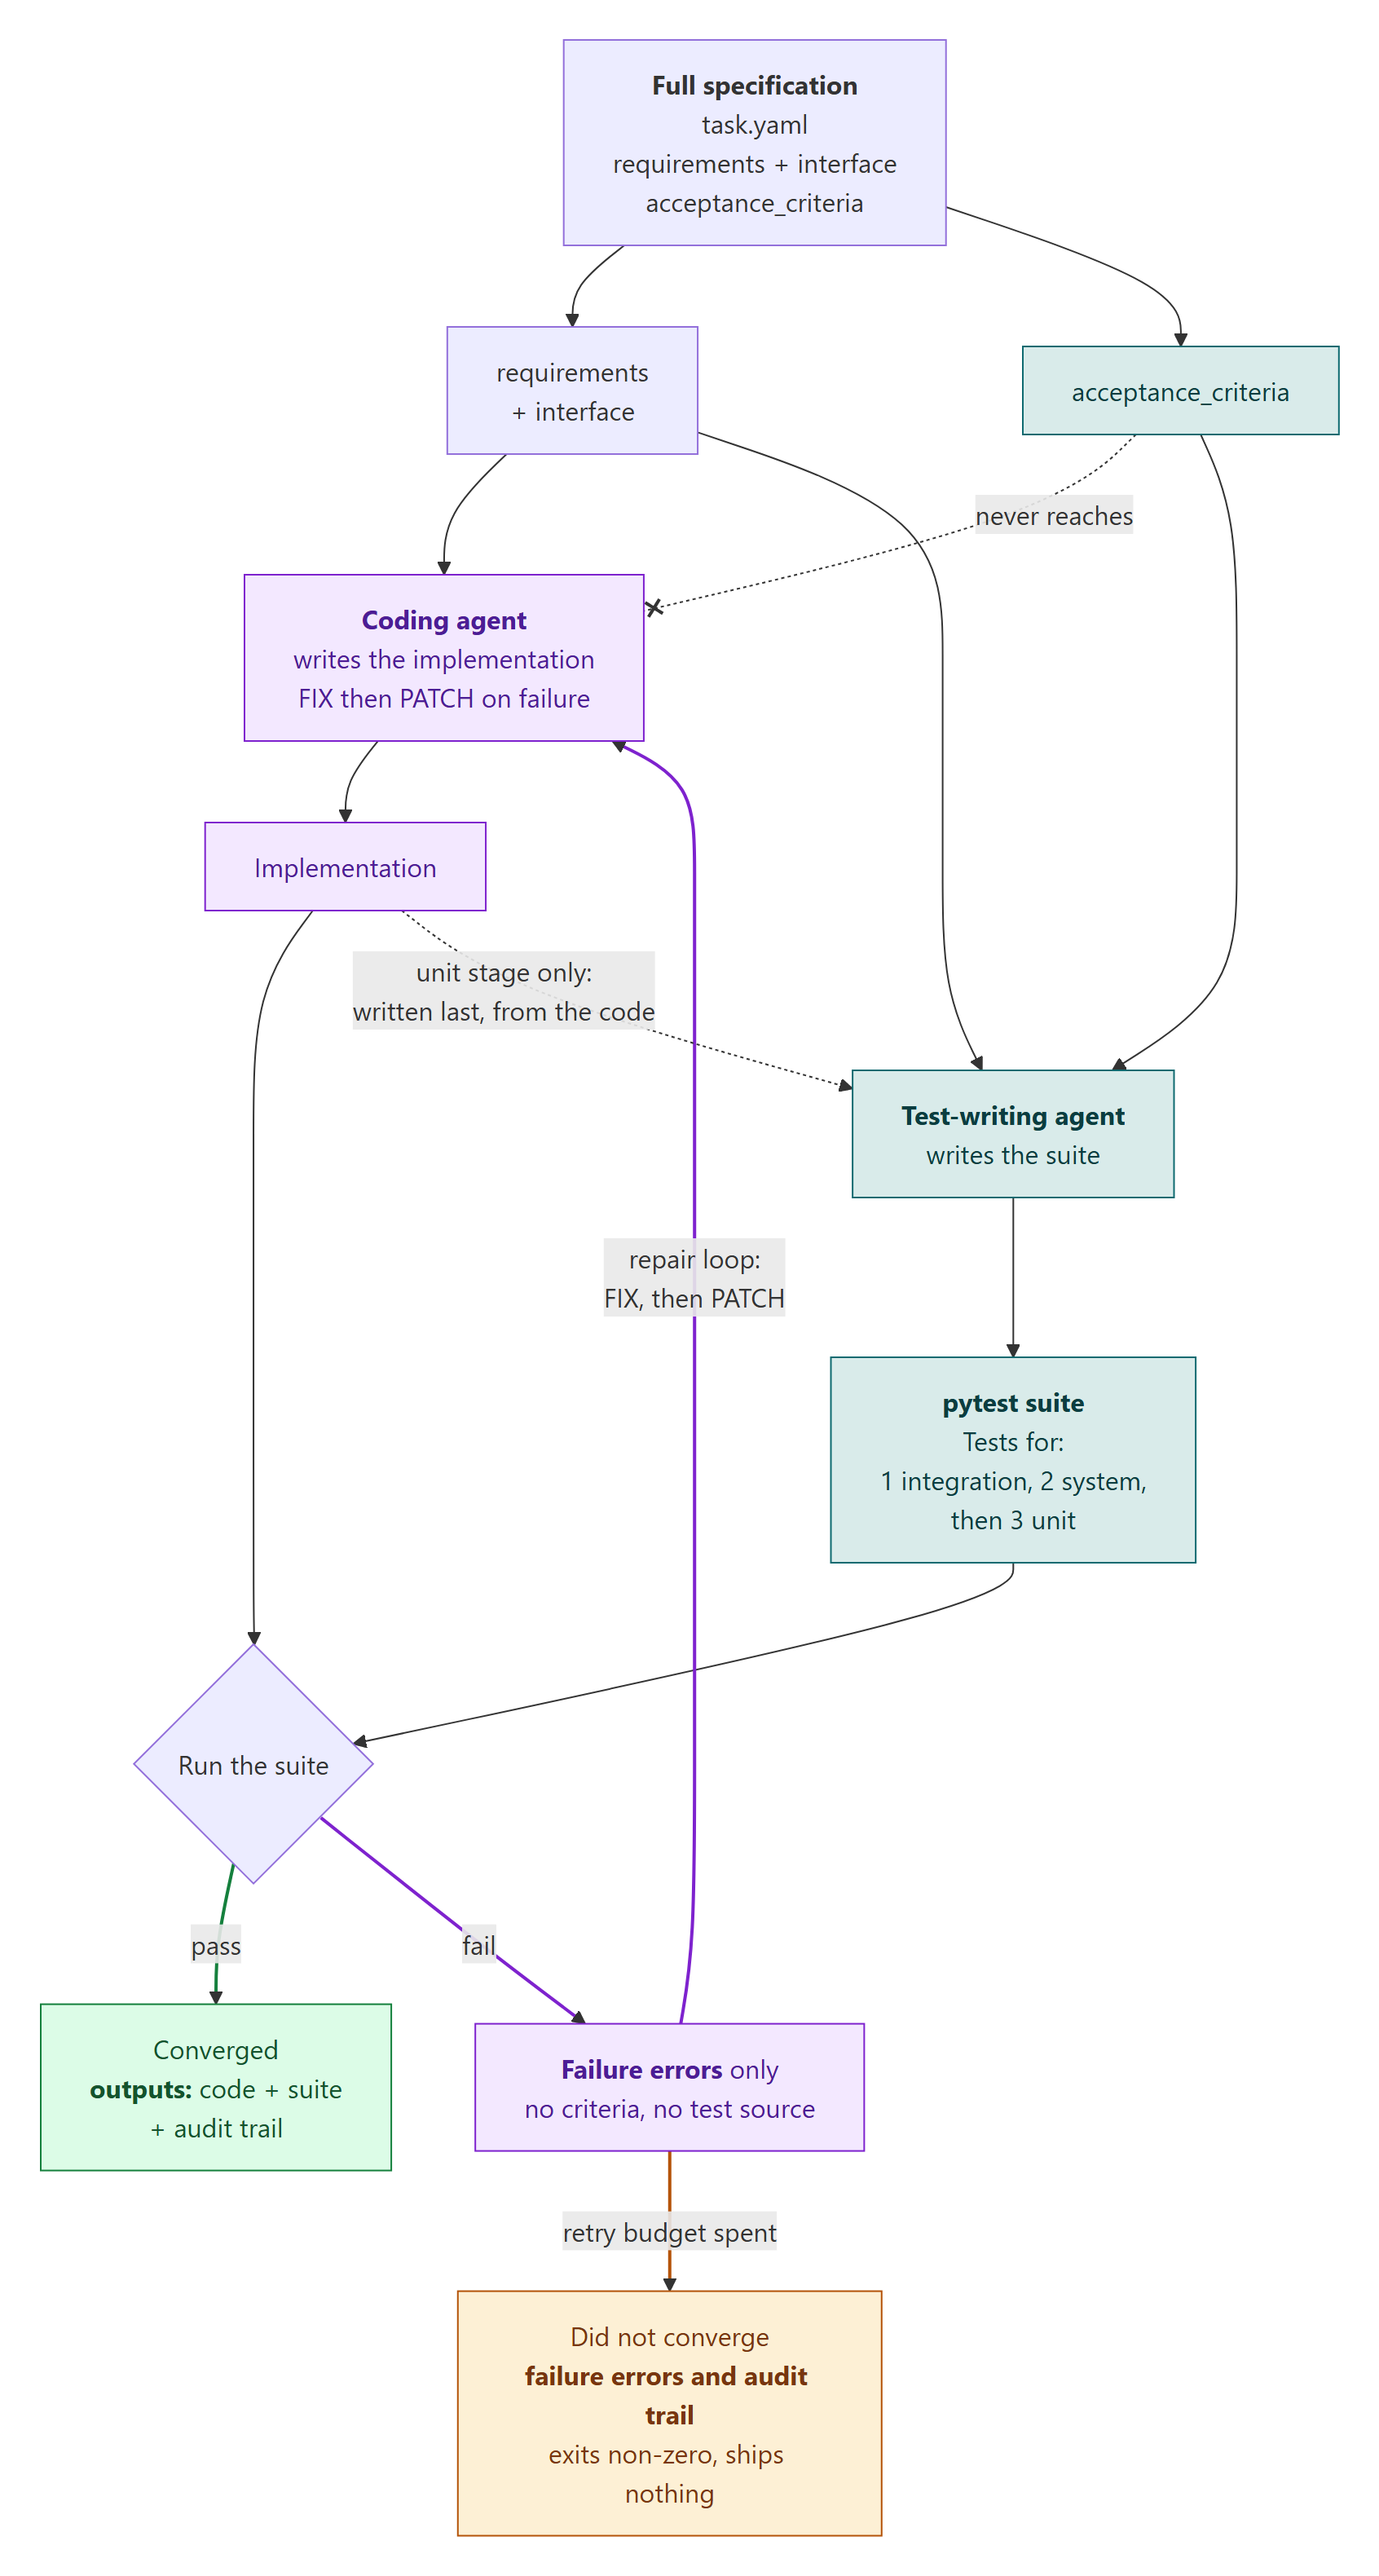
**結果に意味を持たせる仕組み:**コーディングエージェントはacceptance_criteriaを決して見ません。そのセクションを削除した仕様を受け取るため、開発者が作業するのと同じ曖昧な依頼に基づいて作業します。一方、テスト生成側は仕様全体を受け取ります。テストが失敗すると、エージェントに表示されるのはそのテストに対するpytestの出力だけで、受け入れ基準は決して表示されません。この非対称性がなければ、両側が同じ仕様を同じように読み、すべてのテストに初回で合格してしまいます。それでは何も証明できません。
**紫色の部分はコーディングエージェントに見える情報です。青緑色の部分は基準の作成元です。**両者が交わることはありません。実行が収束しなくても、得るものはあります。ゼロ以外の終了コードを返し、障害となっているテストを示し、完全な記録をそのまま保持します。紫色の矢印は修正ループを表しており、実行の大半はここで行われます。失敗したスイートはエージェントに失敗内容のテキストだけを渡し、エージェントはFIXとPATCHを生成して、スイートを再度実行します。ステージに合格するか、リトライ回数の上限に達するまで繰り返します。エージェントが基準そのものを見ることはないため、与えられた基準に合わせてコードを書くことはできません。tests/test_withholding.pyは、いずれかの呼び出し箇所で基準が渡されるとビルドを失敗させます。
実行はintegration、system、unitの3つのステージを順に進みます。
- **統合テストとシステムテストは、コードがまだ存在しない段階で仕様だけをもとに最初に生成されます。**実装がまだないため、実装を見ることはできません。
- **コーディングエージェントが実装を作成します。**基準を除いた仕様に基づいて作成します。
- pytestを実行します。失敗すると、モデルはまずFIX(失敗の要約、根本原因、計画、変更予定のファイル)を生成し、続いてPATCH(そのファイルだけを対象とした統一形式の差分)を生成します。PATCHは全体を一括で適用するか、まったく適用しません。ステージに合格するか、上限に達するまで繰り返します。
- **ユニットテストは、実際のコードが存在して名前を参照できるようになってから最後に生成されます。**実装を見ることが許されるのは、このステージだけです。
- **あるステージに合格すると、前のステージも再実行されます。**これにより、後の修正が合格済みの機能をひそかに壊すことを防ぎます。
**FIXに戻るすべての矢印で渡されるのは、pytestのエラーテキストだけです。**つまり、渡されるのは失敗したテストであり、そのテストの根拠となった仕様ではありません。ユニットテストが最後なのは、実際の関数名を参照する必要があるテストがユニットテストだけだからです。そのため、実装を読めるのもこのステージだけです。各ステージに合格するたびに前のステージを再実行することで、後の修正が合格済みの機能をひそかに壊すことを防ぎます。
テスト生成側に見えるものは、要件、入力と出力の契約、すべての受け入れ基準です。基準に照らして、統合テスト、システムテスト、ユニットテストを作成します。
コーディングエージェントに見えるものは、基準のセクションを削除した同じ仕様と、直前に失敗したテストのテキストです。通常、開発者が作業するのと同じ曖昧な依頼です。
テストスイートを入手する2つの方法と、それぞれで証明できること
| コードから導出したスイート ほとんどの商用テスト生成ツールと、qikly 独自のユニットテスト | 仕様から導出したスイート qikly の統合テストとシステムテスト |
|---|---|
| 現在のコードから作成されます | あなたが記述した受け入れ基準から作成されます |
| 用意するものはリポジトリだけです | 用意するものは正しい状態を定義した記述です |
| 検出するものは将来の動作変更です | 検出するものは現在の動作の誤りです |
| 検出できないものは現時点でのコードの誤りです。今日のバグが明日のアサーションになります | 検出できないものは誰も書き残していないことです |
| 適しているのは意図がどこにも書き残されておらず、安全網が必要な場合です | 適しているのは意図がチケット、仕様ページ、または Gherkin ファイルに記載されている場合です |
どちらも役に立ちますが、答える問いは異なります。qikly はどちらか一方だけというわけではありません。統合テストとシステムテストはコードが存在する前に基準から作成され、ユニットテストの段階では、それらに合格したコードから最後にテストが作成されます。また、--refine-criteria は収束した実装を読み取り、最初の草案で見落とされた基準を提案します。これらはいずれも意図的にコードを読み取りますが、そのコードに異議を唱えることはできません。
これが他と異なる点
テストはコードではなく、基準から作成されます。 これが最も重要な点です。この分野にあるほかの AI テスト生成ツールはすべて、すでに存在する実装からテストを作成するため、コードがすでに行っていることしか記述できません。そのため、優れたリグレッションテストの仕組みにはなりますが、コードが間違っているとは教えてくれません。qikly は、実装が存在する前に受け入れ基準から統合テストとシステムテストを作成するため、判断の基準が、判断される対象によって形作られることはありません。
情報を伏せる仕組みは、実際に確認できます。 モデルに特定のセクションを無視するよう頼むプロンプトでも、誰かが覚えておく必要のある慣習でもありません。オフラインで無料のコマンドを1つ実行すれば、それぞれの側に渡される情報と、その違いが表示されます。
qikly --explain <MY_TASK> # e.g. qikly --explain MERGE_SALES
11個の基準がテスト生成に渡されます。コーディングエージェントが同じファイルを見る前に、12行が取り除かれます。tests/test_withholding.py は、誰かが来年この仕組みを読んだことがなくても、呼び出し箇所から情報が漏れることがあればビルドを失敗させます。これはコードの性質であり、確認にかかる時間は30秒です。
手元に残るのは、実行可能なテストスイートです。 出力されるのは pytest ファイルと JUnit XML です。内容を読み、実行し、CI に組み込めます。6か月後にテストが失敗したときも、調べて議論できる理由があって失敗します。テストスイートは、モデルの判定とは異なり、長期にわたって価値を保つ資産です。判定は翌日のコミットに対して再実行できません。
基準に照らして確認するだけでなく、基準の作成にも役立ちます。 --init と
--scaffold は既存のコードをタスクに変換し、--criteria-from はすでに書いたチケットから基準を取り出し、--generate-criteria は要件だけをもとに最初の基準案を作成します。また、--check-criteria は仕様内のどこにある記述であっても、同時には満たせない2つの記述を探します。これには、互いに矛盾する2つの受け入れ基準も含まれます。
すべての実行は再現可能で、過程全体が記録されます。 各実行では、プロバイダー、モデル、設定、実行に使用したバージョンが記録されます。それぞれの失敗したテスト、根本原因が記載されたすべての FIX、差分としてのすべての PATCH も併せて記録されます。コードの各行が存在する理由を正確に読み返せます。どのアサーションがその行を必要としたのか、モデルが何を結論づけたのか、何を変更したのかがわかります。収束しなかった実行の記録も残ります。それこそ、最も記録を確認したいときです。
「なぜ異なるモデルを2つ使わないのですか?」
ほとんどの人が最初に尋ねることで、多少は役に立ちます。しかし、根本的な問題には届きません。どちらのモデルも同じ基準を読み、どちらもそれに合わせて書くからです。コードは依然として、これから評価される基準を満たすように作られます。誰が入力するかを変えても、何を見せられたかは変わりません。また、これは仕組みではなく習慣であり、2つのモデルが異なるままでいるかを確認するものはありません。
ちなみに、この2つはうまく組み合わせられます。qikly はエージェントの役割ごとにプロバイダーとモデルを選ぶからです。情報を伏せることも、2つのモデルを使うこともできます。
「レビュアーエージェントを追加すればよいのではありませんか?」
これは同じ質問の新しい形で、慎重に答える価値があります。独立した検証ステップが、今では主流のコーディングエージェントに搭載されているからです。多くの場合、異なるモデルファミリーの2つ目のエージェントが、最初のエージェントの成果物をレビューします。
役には立ちますが、これも根本的な問題には届きません。同じ仕様を渡されたレビュアーは、同じ受け入れ基準を読み、同じように曖昧さを解消します。その文脈から見える間違いなら見つけられます。たとえば、不整合、明らかに無視された要件、誰が見てもわかるバグです。しかし、このツールが対象としているケースは見つけられません。ある行に2通りの解釈があり、そのうち1つの解釈だけで一度読まれ、コードも基準もその解釈に基づいて書かれたケースです。誰も間違っていないため、何も間違っているようには見えません。
問題は、確認するものがなかったことではありません。確認するものがすべて、すでに答えを見ていたことです。情報を伏せることで、確認が同じ文脈から生まれるもう1つの意見ではなく、構造的なものになります。また、それを維持するよう誰かが覚えておかなければならない取り決めではなく、テストによって強制されます。
もう1つ違いがあります。それは実行が終わった後も残ります。レビュアーが出すのは評価結果ですが、こちらが出すのは6か月後にも手元にある pytest スイートです。
「失敗したテストで、基準がわかってしまうのではありませんか?」
わかるのは1つのケースだけで、それは意図したものです。テストが失敗すると、コーディングエージェントにはそのテストに関する pytest の出力が表示されます。テスト名、失敗した行までのソース、あれば docstring、そしてアサーションエラーです。ケーススタディでは、本来受け入れてはいけない税率150が受け入れられたことがわかりました。テストの docstring は、多くの場合、そのテストの元になったルールを言い換えているため、テストが失敗すれば、その背後にある基準は実質的に見えてしまうと考えてください。
失敗していないテストについては、エージェントに見えるのは名前だけです。pytest は収集したすべてのテストを一覧表示するため、エージェントは test_tax_exempt_zero_rate というチェックが存在し、成功していることはわかりますが、そのテストの本体、docstring、アサーションは見えません。
エージェントに渡されることがないのは、仕様そのものです。受け入れ基準は、プロンプトを与える前にタスクから取り除かれ、FIX または PATCH のプロンプトに基準の文面が含まれることはありません。
失敗したテストを通じて伝わる情報は3つありますが、それらを伏せるコストは同じではありません。
| 伝わる情報 | 明かされる内容 | 修正に必要か? | デフォルト |
|---|---|---|---|
| docstring の文章 | 基準の言い換え | はい | 表示されます。 diagnostic_feedback: staged で範囲を絞れます。この設定では、まず不具合の特定に必要な最小限の詳細だけを表示し、パッチが何も変更しなかった場合に限り、さらに詳細を追加します |
| 成功したものも含むテスト名 | ルールの存在と、多くの場合はその対象:test_tax_exempt_zero_rate | いいえ | 表示されます。 これを伏せるには pytest の -v を外す必要があります。レポートの作成に使われる各テストのステータスは、このオプションで出力されるためです。名前を明かすかどうかは、取引です |
# Criteria: 2 マーカー | このテストの元になった基準と、基準の総数 | いいえ | 伏せられます。 基準の番号はルールではないため、これがコストなしで伏せられる唯一の情報です。traceability_markers_visible: true で再表示できます |
マーカーはどちらの場合もディスク上のテストスイートに残るため、カバレッジレポートやテストを読む人には、各テストがどの基準を満たすものかが引き続きわかります。
これは分離を損ないません。独立性は、コードの作成者が後からどれだけフィードバックを受け取るかではなく、テストスイートがどのように作成されたかに左右されるからです。統合テストスイートとシステムテストスイートは、実装が存在する前に基準から生成されます。したがって、コーディングエージェントが後から知ったことによって、すでに書かれたテストの内容が変わることはありません。目に見える1つの失敗だけを攻略する修正でも、残りのテストは立ちはだかります。また、後の段階を通過するたびに、先の段階が再実行されます。
これは、CI が赤くなったときの開発者と同じ立場です。何が壊れたかはわかりますが、テスト計画はわかりません。ケーススタディのエージェントが tax_rate > 100 と書いたのは、テストで150が誤りだと示されたからにすぎません。基準を渡されていれば、最初から上限を設定していたでしょう。そして、その場合にテストが成功しても、何も証明できなかったはずです。
設計の根拠、および、そもそも acceptance_criteria はどこから来るのかという、より難しい問題については、全3部の第1部である docs/design_1_case_study.md をご覧ください。
このプロジェクトのツールの使い方
利用方法は4つあります。クイックスタートの下にある表で、それぞれに必要なコマンドを確認できます。
-
自分が書いていないコードを検証する。 実装を
seed:で指定すると、コードを読まないエージェントが受け入れ条件に基づいてテストスイートを作成します。コードと同じコンテキストから生成されたテストスイートは、モデルが自分自身に同意しているにすぎません。モジュールまたはパッケージ全体の場合は、seed.implementationにディレクトリを指定すると、元の名前のままコピーされます。そのため、from mypkg.money import to_centsは自分のツリーと同じように解決され、その中のすべてのモジュールを修正できます。限界については、はっきり述べておく価値があります。qikly は、提供されたコードの作者が何を見ていたかを知ることはできません。 情報を与えないことが保証されるのは、qikly が実行した実行処理に限られ、渡されたファイルには当てはまりません。同じ人やモデルが条件を開いた状態でコードを書いていたなら、得られるのは独立したテストスイートであり、独立した作者ではありません。それでも常に得られるのは、コードから派生したものではないテストスイートです。コードから生成する方法では、これをまったく得られません。
-
仕様から始める。 コードがまだない場合は、最初の実装と、それを正当化するテストスイートを
outputs/に生成します。ソースツリーには決して書き込みません。 -
手持ちのテストを使う。 任意の段階をシードとして指定すれば、このループは生成器ではなく修正手順になります。
-
カタログを無人で実行する。 収束しない場合はゼロ以外の終了コードを返すため、スケジューラーや CI ジョブで多数の仕様を実行し、レポートを保存できます。
無料コマンドの詳細
モデルへの呼び出しがなく、API キーも不要で、費用もかからない3つのコマンドです。--explain はその他の利用方法で紹介しています。ここでは、--explain とその前後のコマンドが実際に何をするのかを説明します。
qikly --explain MERGE_SALES   # what each side is shown, and the difference
qikly --validate              # check your task files: YAML, criteria, fixtures
qikly --explain MERGE_SALES --json
qikly --explain MERGE_SALES --html   # the same, as a page to share
最初に実行するなら、--explain がおすすめです。テスト生成に渡される受け入れ条件、次にコーディングエージェントに渡されるものと同じタスクファイル、そして差分が表示されます。MERGE_SALES では、11個すべての受け入れ条件と、それらが属する acceptance_criteria: キーが取り除かれます。実際の実行で使うものと同じ関数を使ってこれらの文字列を生成するため、仕組みの説明ではなく、仕組みそのものを確認できます。
--html を追加すると、qikly_explain_MERGE_SALES.html も書き出されます。両方の表示を横並びにし、取り除かれたすべての行を強調表示したファイルで、外部から何も読み込みません。プルリクエストに添付したり、スライドに載せたり、投稿用にスクリーンショットを撮ったりできます。
--validate はタスクファイルだけを読み込みます。ファイルを解析できること、acceptance_criteria が長い文字列1つではなくリストであること、フィクスチャのパスが解決できること、条件で形容詞ではなく値を指定していることを確認します。これは qikly-validate というプレコミットフックとしても利用できます。有料のチェックではなく、無料のチェックとして意図的に提供しています。
--demo の実行内容
その他の利用方法の最後の行を、全文掲載します。プロバイダーのキーが必要です。
export GEMINI_API_KEY=...     # PowerShell: $env:GEMINI_API_KEY = "..."
qikly --demo
Python 3.10 以降と GNU patch が必要です。macOS では、まず brew install gpatch を実行してください。バンドルされたタスクを一時的な demo/throwaway_<timestamp>/ フォルダーで最初から最後まで実行します。所要時間は約30秒で、このフォルダーの外には何も書き込みません。そこで作業を続けるのではなく、後でフォルダーを削除することを想定しています。
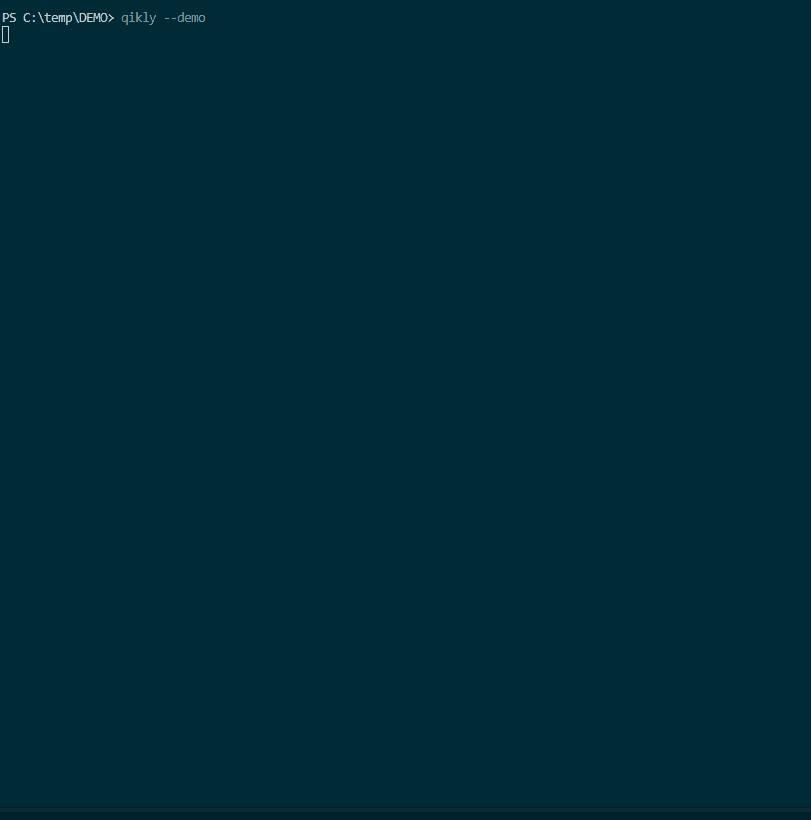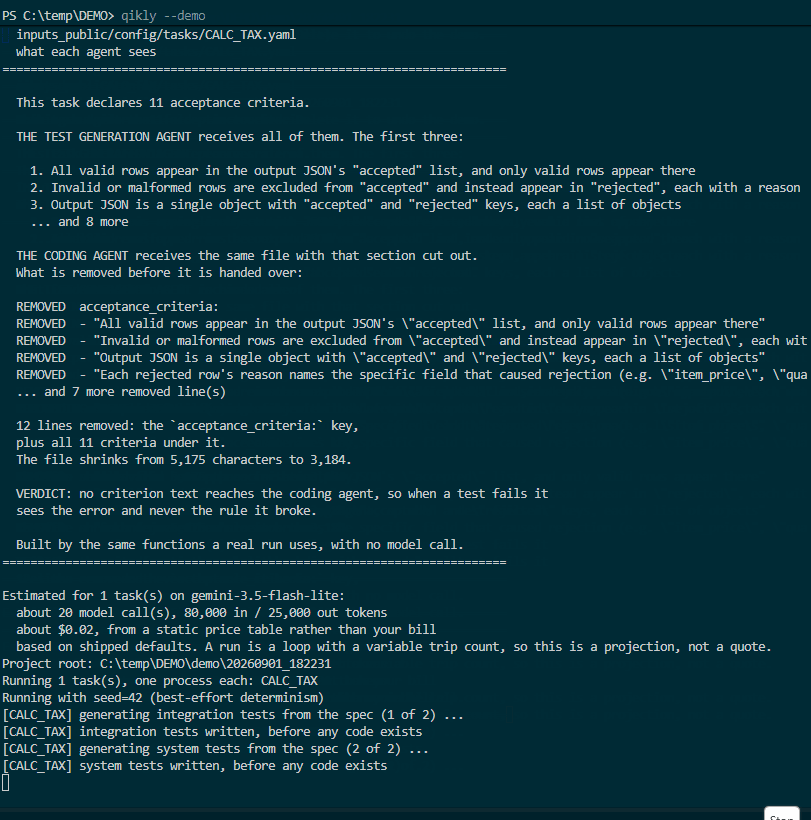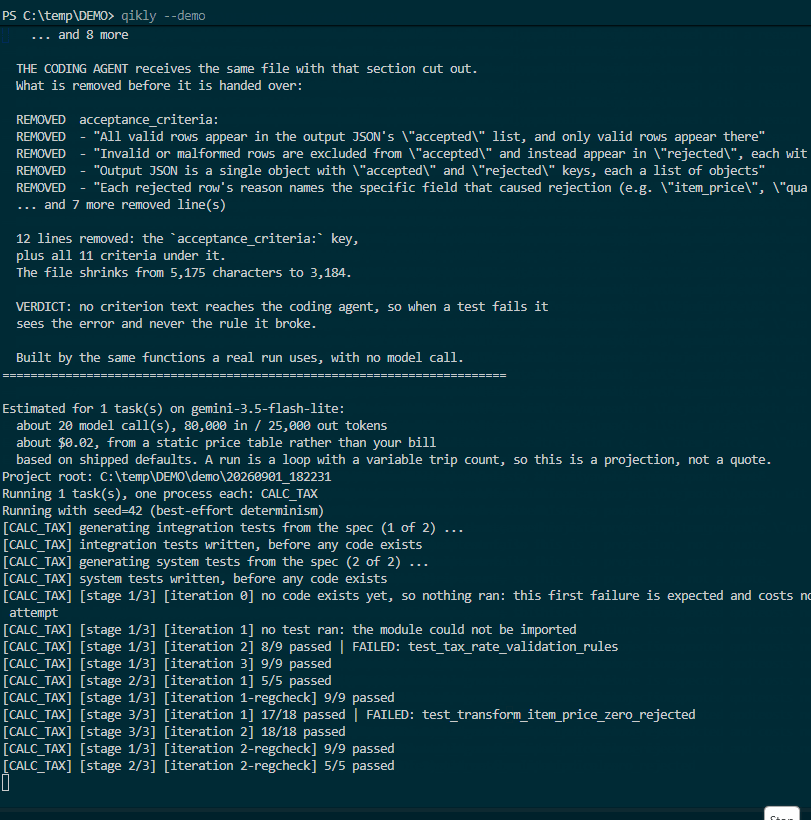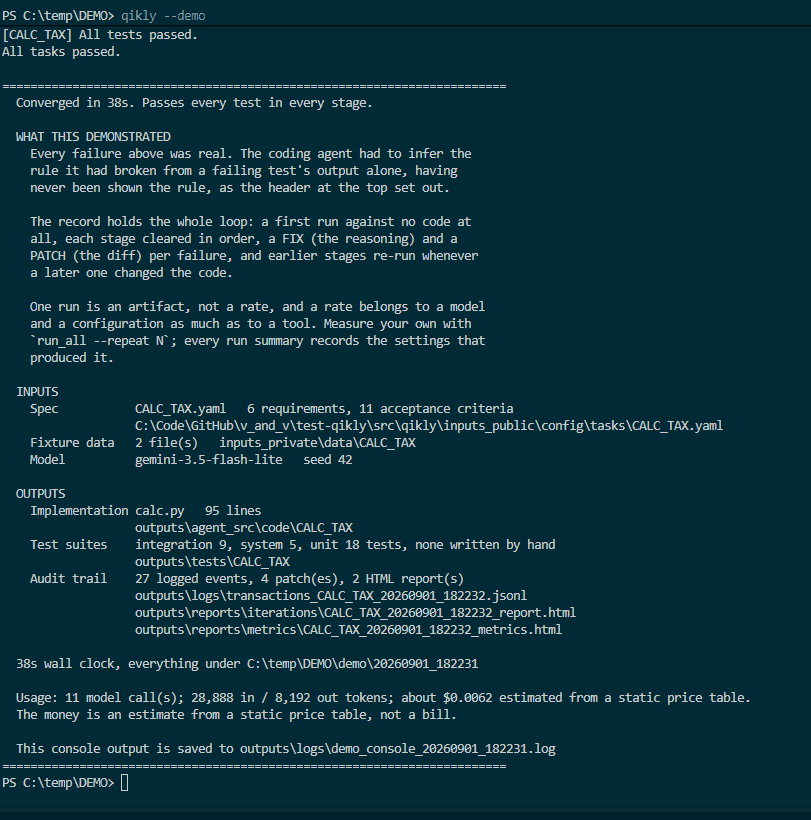
これは gemini-3.5-flash-lite で実行した実際の例です。所要時間は38秒で、早送りではありません。
試してみましたか? うまくいったか、停止したか、インストールから先に進めなかったか、結果をお知らせください。
独自のデータをすべて使う
手元にあるコードから始めるのではなく、何もない状態から始める場合は、2つの ディレクトリを作成し、フィクスチャデータを入れて、タスクファイルを書き、 実行します。パッケージにもソースツリーにも何も書き込まれません。タスクファイルの 各フィールドを説明するチュートリアルは、 docs/QUICK_START_ON_YOUR_OWN_DATA.mdにあります。
qikly --init                    # creates inputs_private/ and a starter task
qikly --tasks MY_TASK
何も書く前に動作を見てみたいですか? qikly --exampleを実行すると、
そのまま動くサンプル一式が追加されます。モジュール、それをスキャフォールドして
生成される2つのタスクファイル、サンプルデータ、すでに記述済みの
requirementsとacceptance_criteriaが含まれ、すべて実際のタスクで使われるパスに
配置されます。ここでプロジェクトのルートにファイルを置くコマンドはこれだけです。
作成されるのはmy_metrics.pyで、作業が終わったらすべて削除できます。
--initと--exampleのどちらを使うかは、以下のクイックスタートで説明しています。
**docs/QUICK_START_ON_YOUR_OWN_DATA.md**には、
タスクファイルの各フィールド、requirementsとacceptance_criteriaの適切な使い分け
(一方には判断事項を、もう一方にはその結果を記述します。その間の隔たりこそが、
仕組みの要です)、すでに作成したチケットからの基準の抽出、自分の実装や
テストスイートの初期設定、各ファイルの読み込み元、そしてテストで到達できるように
基準に必要なフィクスチャ行を提案する方法など、詳しい情報があります。
異なるソースから作られる2種類のテストデータ
フィクスチャデータを用意する前に知っておくと役立ちます。データに何を含める必要があるかが ここで決まります。
| 行の取得元 | 使用するステージ | |
|---|---|---|
| 生成データ | テスト作成エージェントがacceptance_criteriaからデータを作り、Pythonコードに直接書き込みます | 単体テスト、統合テスト |
| ユーザーデータ | フィクスチャデータ(例:タスクのinputs:リストに記載されたCSVファイル) | システムテスト |
テスト作成エージェントはフィクスチャデータを参照しません。渡されるのはタスクファイルと、 単体テストの場合はコードだけです。ほかには何も渡されないため、次のように記述するとき、
invalid_prices = ['0', '0.00', '-5.00', 'abc', '']
この5つの値はファイル内の行ではなく、基準を読んで作られたものです。
何を検証できるかは、依然として自分のデータで決まります。 実際のファイルに対して 実際のパイプラインを実行するのは、システムテストのステージだけです。そのため、 どの行も到達しない基準は、生成データで小規模に検証されるだけで、実際にコードが 通る経路では一度も検証されません。テストは成功しても、ルールの1つが最初から最後まで 一度も実行されていないことになります。だからこそ、同梱のサンプルデータには意図的に 扱いにくい行が含まれており、この隔たりを見つけるコマンドが用意されています。
qikly --propose-fixtures --tasks MY_TASK
このコマンドは、データのどの行も到達しない基準を報告し、それぞれについて、どの基準向けに 提案したかを明記した行を提案します。読み取りやコピーに使えるファイルを書き出しますが、 フィクスチャは編集しません。行が正しいかどうかは、提案先の基準に照らしてのみ決まります。 モデルが興味を持った方向へフィクスチャを増やし続けると、実際に処理するデータとは かけ離れていくからです。
実行
python run.py                            # every task found
python run.py --tasks ETL_ADDRESS        # one
python run.py --tasks ETL_ADDRESS,ETL_EMAIL
python run.py --demo --tasks MERGE_STOCK # isolated, any task
各タスクはそれぞれ独立したプロセスで並行して実行され、コンソール出力には
[task_id] がプレフィックスとして付きます。いずれかのタスクが完全に収束しなかった場合、終了コードはゼロ以外になります。
意図的に停止する実行があることを想定してください。 およそ10回中8回の実行で、コードはすべての統合テストとシステムテストに合格します。およそ10回中6回は、ユニットテストも含めてすべてに合格します。この2つの数字の差のほぼすべては、ユニットテストの段階によるものです。
これらは概数です。測定は3回行いました。427回の実行、16日後に同じタスクと設定で行った140回の実行、そしてベンチマーク自体を修正した後の400回の実行です。このとき、10個のタスクのうち8個に、どの入力行でも発生させられない受け入れ基準が含まれていたことが判明しました。3回とも、互いの信頼区間内に収まりました。いずれも、繰り返しの測定を手頃なコストで行うために選んだ、小型で低コストのモデル gemini-3.5-flash-lite を使用しているため、これらの結果は最低ラインとして捉えてください。3回の測定結果が一致していることには、いずれか1回の小数点以下の精度よりも価値があるため、小数点以下の数値は記載していません。
予算を使い切った実行は、ゼロ以外の終了コードで終了し、進行を妨げたテストを示して、記録全体を保持します。実行自身のテストで拒否されたコードが成功したと報告することはありません。
5つのドメインにわたる13個のタスク例が、このツールに同梱されています。詳細は docs/design_3_mechanism.md に記載されています。
生成ではなく測定する。 1回の実行は成果物であり、成功率ではありません。同じシードで同じタスクを実行しても、収束する場合としない場合があります。収束の頻度を主張するには、測定を繰り返して信頼区間を確認してください。
python -m qikly.orchestrator.run_all --repeat 10
これにより、信頼区間を含む集計レポートが書き出され、収束しなかった実行は、何につまずいたかに基づいてグループ化されます。詳細は docs/design_3_mechanism.md をご覧ください。
実行が収束しない場合
停止は異常ではなく、通常起こり得る結果です。実行はゼロ以外の終了コードで終了し、進行を妨げたテストを示し、記録全体を保持します。何も出荷されることはありません。
最初に試すべきなのは、より強力なモデルです。このファイル内のどの設定よりも収束率を大きく向上させ、必要なのは環境変数1つだけです。その後は、次の順序で問題を切り分けてください。タイムラインレポートを読み、収集エラー(何も実行されなかった状態)がないか確認し、--trends で設定の忘れがないかを調べ、同じパッチが繰り返されていないか(基準がモデルの事前知識と衝突している状態)を確認し、--check-criteria、--validate、propose_fixtures を実行します。
それぞれについて、確認すべき兆候と修正方法: docs/TROUBLESHOOTING.md。
開始前によく寄せられる質問(API キーを登録する前に何が実行されるのか、マシンの外に何かが送信されるのかなど): docs/FAQ.md。
すでにあるコードを対象にする方法(変更される可能性のあるモジュールや、欠陥が変更対象外のモジュールにあると判明した場合に実行結果に何が表示されるかなど): docs/EXISTING_CODE_AND_HELPERS.md。
出力
同時実行時に衝突しないよう、すべて task_id ごとに名前空間が分けられています。
| パス | 内容 |
|---|---|
outputs/agent_src/code/<task_id>/ | コーディングエージェントが作成した実装です。各実行の開始時にクリアされます(old/<timestamp>/ にバックアップされます)。 |
outputs/tests/<task_id>/{integration,system,unit}/ | 今回の実行で生成されたテストファイルです。 |
outputs/data/<task_id>/ | タスクの実際の出力成果物です(例:output.json)。 |
outputs/logs/transactions_<task_id>_<run_timestamp>.jsonl | すべてのテスト実行、FIX、PATCH、適用結果を追記形式で記録した構造化ログです。この実行の信頼できる唯一の情報源です。 |
outputs/logs/patches/<task_id>/<run_timestamp>/<fix_id>.diff | エージェントが生成したすべてのパッチです。適用されたかどうかは問いません。 |
outputs/reports/junit/<task_id>_<run_timestamp>.xml | 今回の実行の JUnit XML で、ステージごとに <testsuite> が 1 つあります。ここにある唯一の成果物は、別のシステムが読み取ります。Xray、qTest、TestRail にインポートするか、CI から公開できます。ステージごとのファイルはその隣にあり、それぞれのステージの最終状態を格納します。一度も実行されなかったステージは、空の成功として報告されるのではなく、ファイルが作成されません。 |
outputs/reports/iterations/<task_id>_<stage>_<run_timestamp>.txt | 試行ごとの合否を1行ずつリアルタイムで追記したサマリーです(コンソールに出力される内容です)。 |
outputs/reports/iterations/<task_id>_<run_timestamp>_report.html | まずはこちらを確認してください。 実行のデバッグ用タイムラインを1ページにまとめたレポートです。ブラウザーで開いてください。run.py の各呼び出しの終了時に自動生成され(パスはコンソールに表示されます)、または必要に応じて次のコマンドで生成できます:python -m qikly.orchestrator.reports.report [--task ID] [--run TIMESTAMP]。対応するメトリクスレポートへのリンクがあります。説明に焦点を当て、数値の重複はありません。 |
outputs/reports/metrics/<task_id>_<run_timestamp>_metrics.html | 数値を中心にまとめた補助レポートです。KPI の行(反復回数、FIX/PATCH の試行回数、検出されたリグレッション、適用失敗率、実行時間)、ステージごとの反復チャート、FIX/PATCH の結果内訳が含まれます。対応するデバッグ用タイムラインへのリンクがあります。タイムラインレポートと同じタイミングで生成されるほか、必要に応じて次のコマンドで生成できます:python -m qikly.orchestrator.reports.metrics_report [--task ID] [--run TIMESTAMP]。現時点では1回の実行が対象です。詳細は現在の位置づけを参照してください。 |
outputs/reports/run_summary/<task_id>_<run_timestamp>.json | メトリクスレポートと同じ数値を HTML ではなく JSON で格納します。スクリプトを使って実行間で比較できます。run.py の各呼び出しの終了時に自動的に書き込まれ、ディスク上に保存されます。このプロジェクトが行うネットワーク呼び出しは、設定済みの LLM プロバイダーへのものと、無効にしない限り起動時に行う新しいリリースの確認のみです(バージョン確認を参照)。 |
outputs/reports/aggregate/aggregate_<timestamp>.{html,json} | 1回ではなく、複数回の実行をまとめたレポートです。報告内容とその理由については、すべてをまとめて実行するを参照してください。--repeat によって書き込まれるほか、必要に応じて次のコマンドで生成できます:python -m qikly.orchestrator.reports.aggregate_report [--task ID] [--last N]。run_summary/ の JSON のみを読み込むため、LLM への呼び出しはなく、何度でも再実行できます。 |
テストで測定できていないことを確認する2つの無料チェック
データでは到達できない基準。 qikly --validate は、基準で指定された値を持つ入力行がない場合に、そのことを表示するようになりました。そのような基準から生成されるテストは、コードの動作に関係なく成功するためです。
MY_TASK.yaml: criterion 2 names 0 for gap_m, and no row holds it.
`qikly --propose-fixtures --tasks MY_TASK` drafts the rows it would take.
テストスイートが検出できなかったこと。 qikly --score-suite --tasks X は、収束したコードを一度に1か所ずつ壊し、その都度テストスイートを再実行して、見逃されたものを一覧表示します。既存のものは変更されません。上に表示された到達可能性の警告とあわせてスコアを確認してください。どの行からも実行されない動作の不具合は、テストスイートでは検出できません。
設定と LLM プロバイダー
デフォルトは Gemini です。OpenAI と Anthropic にも対応しています。1 回の実行につき、プロバイダーは 1 つです。
export GEMINI_API_KEY=...
qikly --demo
docs/CONFIGURATION.md には、すべての環境変数、settings.yaml のキー、タイムアウト、各プロバイダーで実際にどの程度の決定性が得られるか、SDK の変更に気づく方法が記載されています。キー、PowerShell、CI、および誤ったキーがどのように見えるかについては、docs/PROVIDER_KEY_SETUP.md をご覧ください。
CI で使用する
GitHub Marketplace に Qikly Test Generation として掲載されています。
この Action は 1 つのタスクを実行し、生成された pytest スイート、それを満たすコード、および CI ダッシュボードやテスト管理ツールで読み取れる JUnit XML ファイルを保存します。
- uses: actions/checkout@v5

- id: qikly
  uses: gal-a/qikly@v0
  with:
    task: CALC_TAX
  env:
    GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
このリポジトリには、ここで実行するのではなくコピーして使用することを想定した、動作するテンプレートが 2 つあります。
qikly-example.yml
はオンデマンドで実行され、
qikly-pr-example.yml
はプルリクエストに結果をコメントします。
設定する前に知っておくべきことが 3 つあります。
デフォルトではビルドを失敗させません。 実行が収束しないのは正常な結果であり、パイプラインの故障ではありません。また、誰かのメインブランチに赤い X を表示するのが第一印象となるツールは、二度と注目されません。報告ではなく強制したい場合は、fail-on-stall: true を設定してください。
トリガーのたびに費用がかかります。 どちらのテンプレートも意図的に workflow_dispatch を使用しています。実行コストを把握してから on: pull_request に変更し、paths: でタスクファイルに対象を絞ることで、無関係なコミットによる実行費用を避けられます。
バージョンを固定する方法は 2 つあり、選択は自由です。 @v0 は、このプロジェクトがリリースごとに参照先を更新する移動エイリアスです。破壊的変更を受けずに修正を受け取れます。@v0.6.1 は決して移動しない厳密な固定指定です。こちらでは何も変更されず、新しいものも届きません。ほとんどの人は修正を望むため、テンプレートでは @v0 を使用しています。ポリシーで必要な場合は、厳密な固定形式を使用してください。
バージョン確認
起動時に CLI は pypi.org に 1 回リクエストを送信し、新しいリリースがある場合に 1 行だけ表示します。無効にするには QIKLY_NO_VERSION_CHECK=1 を設定してください。
この確認によって実行内容が変わることはありません。失敗時は常に何も表示せず、タイムアウトは 1.5 秒です。また、タスクごとではなく起動ごとに 1 回だけ行われ、ソフトウェアのインストール時にすでに利用している公開 PyPI および GitHub のリリースインデックスのみを読み取ります。
機能
1 つのリストに性質の異なる項目を混在させないよう、3 つに分けています。入力内容にかかわらずループが保証すること、入力する内容、そして実行後に手元に残るものです。
ループが自動で行うこと
| 実行内容 | |
|---|---|
| 非公開の受け入れ基準 | コーディングエージェントには一切渡されません。指示ではなく、tests/test_withholding.py によって強制されます |
| 段階的なテスト生成 | 統合テスト、システムテスト、ユニットテストの順です。統合テストとシステムテストは実装が存在する前に作成されるため、実装に合わせて調整することはできません |
| 回帰テストの再実行 | すでに合格したすべての段階を、その後の修正のたびに再実行するため、修正によって前の段階がひそかに壊れることはありません |
| ファイル内の検索 | 約16k文字を超えるモジュールでは、失敗内容で指定された定義をすべて含め、それ以外の定義は各1行のシグネチャとして表示します。決定論的なASTベースの方式で、インデックスも追加のモデル呼び出しも必要ありません |
| シード入力 | 独自の実装や任意のテスト段階を、生成する代わりに指定できます |
| 独立性の証拠 | 提供されたコードについて、基準が実装の最初のコミットより前に確定されていたかどうかをgitに確認し、確認できる範囲とともに結果を出力します。実行では、自ら実施していない分離を強制できないためです |
| 任意のプロバイダー | Gemini、OpenAI、Anthropicから選択でき、エージェントの役割ごとに指定できます |
| 並行タスク | 各タスクを個別のプロセスで実行し、出力には[task_id]を付けます |
| 実行の来歴 | すべてのサマリーにモデル、プロバイダー、日付、生成設定を記録します。収束率はツールだけでなく、設定にも左右されるためです |
| 承認ゲート | --review-patchesは各差分を表示してy/Nの入力を待ちます。--dry-runはすべてのパッチを生成しますが、適用はしません |
コマンド
| 実行内容 | |
|---|---|
| 隠されている内容を表示 | --explain TASK は、各陣営に与えられる内容とその違いを出力します。モデルの呼び出しも API キーも必要ありません |
| オフライン検証 | --validate は、タスクファイルを無料でチェックします。有効な YAML か、基準がリストになっているか、フィクスチャのパスが解決できるか、基準が形容詞ではなく値を指定しているかを確認します |
| コードからひな形を生成 | --scaffold FILE は既存のモジュールを読み込み、そのコードをテストするタスクを書き出します。または --fresh を指定すると、同じインターフェースの新しい実装を書き出すタスクを作成します |
| 基準を下書き | --generate-criteria は、基準のないタスクに対し、要件だけをもとに最初の合格基準を書き出します |
| 下書きした基準を自分の基準と比較 | --compare-criteria TASK は、要件だけをもとに基準を下書きし、生成された基準では見落とされる点を報告します。自分の基準を正解として扱います |
| 矛盾をチェック | --check-criteria は、ステージの予算を使う前に、説明、要件、基準をすべて同時に満たせる実装が存在するか、また基準同士に矛盾がないかを確認します |
| チケットから基準をインポート | --criteria-from FILE は、ファイルに貼り付けたチケットから、箇条書き、「Acceptance Criteria」セクション、または Gherkin シナリオを読み込みます |
| Jira インポート | --criteria-from-jira PROJ-412 は、ファイルインポーターと同じパーサーを使い、指定したフィールドまたは課題の説明から基準を読み込みます |
| ドキュメントとコードを1つのコマンドで | --scaffold module.py --from-doc feature.md は、ドキュメントから取得した基準と、モジュールから読み取ったインターフェースを使ってタスクファイルを書き出します。requirements は意図的に空欄のままにしてあります。コーディングエージェントがそれを読み取るうえ、機能ページでは通常、その上の説明文で基準が再掲されているためです。 |
| フィクスチャの提案 | 別のエージェントが、どの入力行でも発生しない基準を特定し、それを発生させる最小の行を提案します。データを編集することはありません |
| 収束の傾向 | --trends は、ディスク上にすでにある概要から各タスクの時間経過に伴う割合を表示し、モデルまたは設定が変更された期間に印を付けます |
| プロンプトの編集に効果はあったか | --compare-prompts TASK は、そのタスクの実行結果を生成に使ったプロンプトごとにグループ化し、両方の結果を出力します。無料で、すでにディスク上にあるデータを読み取ります。先に --repeats N を指定すると、各グループをさらに N 回ずつ実行し、交互に試します。件数と範囲のみを示し、比較する意味がないほど小さいグループは比較しません |
| 機械可読な出力 | --explain と --validate での --json |
保存されるもの
| 内容 | |
|---|---|
| 実行可能な出力 | 実行後も手元に残して読み込み、CI に追加できるプレーンな pytest ファイル |
| JUnit XML | outputs/reports/junit/<task>_<timestamp>.xml。Xray、qTest、TestRail、Jenkins、GitLab、GitHub Actions がすべて取り込める形式です |
| 完全な監査証跡 | すべてのテスト実行、FIX、PATCH、適用結果を追記専用ログに記録し、HTML のタイムラインとメトリクスレポートも保存します |
| コスト予測 | 実行開始前に出力します。履歴があれば自分の履歴をもとに算出し、価格ではなく予測として明記します |
| PR コメント | --pr-comment は最新の実行結果を Markdown に変換します。テンプレートワークフローはコメントを何度も追加せず、既存のコメントを更新します |
| プリコミットフック | 無料チェックの qikly-validate。フックによって git commit の入力に課金されることはありません |
| GitHub Action | gal-a/[email protected]。テストスイート、コード、JUnit XML をアップロードします |
現時点での位置づけ
適合する範囲は機能一覧より重要なので、率直に説明します。
対象は自己完結型の Python モジュールです。 PATCH プロンプトでは、FIX で指定されたファイルだけを読み込みます。約 16,000 文字を超えるファイルは全体を読み込まず、解析して、FIX と失敗箇所で指定された定義を全文で再現し、それ以外はすべて 1 行のシグネチャにまとめ、省略した範囲に印を付けることで、引き続き diff を適用できるようにします。しきい値は QIKLY_MAX_FILE_CHARS で引き上げられます。これはリポジトリ全体を扱う仕組みではありません。ファイル横断のインデックスはなく、抜粋によってサイズは小さくなりますが、上限が設けられるわけではありません。400 個の関数を含むモジュールでは、400 行のシグネチャが出力されます。つまり、57k 文字が 30k 文字になり、小さくはなりますが、それでも大きなままです。FIX と失敗したテストでシンボルがすでに指定されているため、取得方法は類似検索ではなくルックアップです。
必要なのは GNU patch です。単なる patch ではありません。Apple と BSD に付属する実装は --fuzz を拒否します。このオプションがあるからこそ、行番号が多少ずれた diff でも適用できます。qikly は、これが見つかった場合に知らせるようになりました。これまでは通常の hunk 適用失敗として報告され、その実行中の残りの試行で、適用できるはずのない diff が繰り返し生成されていました。
パッチはデフォルトで確認なしに適用されます。 パッチはタイムスタンプ付きのバックアップとともに、使い捨ての outputs/agent_src/code/ ツリーに適用され、作業コピーには適用されません。停止して確認を求める自動実行ループは、無人実行とは言えません。--review-patches を指定すると人が確認に加わり、--dry-run を指定するとすべてのパッチを生成しますが、適用はしません。却下されたパッチは保持され、ログに記録されます。却下は、テストでは得られない証拠だからです。
予算の枯渇はまれな例外ではなく、通常起こりうる結果です。 自分のテストスイートを満たせなかった実行は、ゼロ以外の終了コードを返し、妨げとなっているテストを示し、成果物を一切出しません。これこそ備えておくべき性質です。4 つの原因のうち 3 つはモデルではなく仕様の欠陥なので、ほとんどの停滞はテキストの編集で解消できます。停滞の分類を参照してください。
停滞には 2 つのパターンがあり、それぞれ正反対の意味があります。 同じパッチがバイト単位で繰り返される場合、モデルは人工的なルールに正しく異議を唱えています。再試行予算を増やしても解決しません。基準を広げるか、判断を requirements に移し、エージェントが修正すべきエラーではなく前提として読めるようにしてください。一方、試行ごとに異なるパッチが生成されるものの、同じテストが解決されない場合は、よくあるバグです。失敗のテキストだけでは原因を特定できず、まずはより強力なモデルを試すのがよいでしょう。outputs/logs/patches/<task>/<timestamp>/ にある連続した diff を比較すれば、どちらのパターンかを判断できます。停滞はユニットステージに集中します。このステージだけがコードを見て書かれている段階でもあります。
テスト生成では、記述した基準を見落とすことがあります。 正しく手書きされた基準でも、それを検証するテストがない場合があり、その結果、コーディングエージェントはその基準を満たすよう求められません。根本原因は、テスト生成プロンプトが「基準で満たす必要があると示されている特性」のカバレッジを求めながら、すべての基準をカバーするよう要求していなかったことです。そのため、長いリストは一部だけが選ばれていました。プロンプトの修正によってギャップは縮小しますが、解消はしません。現在も残るギャップとして扱ってください。自分のタスクで確認するには、--explain と生成されたテストスイートを使います。
基準の改善では、基準を厳しくできますが、新たに見つけることはできません。 レビュアーは実装の実際の動作に反応するため、コードがすでに試みている動作に関する検証の抜けを見つけるのは得意ですが、要件で求められていない動作を明らかにすることはできません。基準をどこまで厳しくできるかは、未解決の問題です。
1 回の実行につきプロバイダーは 1 つで、実行をまたいだ傾向のレポートにはまだ対応していません。メトリクスレポートが対象とするのは、単一の実行です。
qikly が実際に見つけた問題の例
具体的な調査結果を、実行内容、見つかった問題、そしてその結果からはわからないこととあわせて紹介します。基準では切り上げとされていたのに銀行丸めで計算された金額、誰も決めていなかった境界値の判定、すべてのテストに合格しながら仕込まれた不具合の半分を見逃した7件のテストスイート、そしてデータが届かなかったため、どのテストスイートでも検出できなかった仕込み済み不具合の3分の2です。
さらに読む
通読するのではなく、必要な情報を調べるためのリファレンスページが2つあります。独自データでのクイックスタート と 設定とプロバイダー です。
設計についての解説は3部構成で、それぞれ単独で読めます。
| 内容 | |
|---|---|
| 1. 事例 | 自分で書いたテストで自分の宿題を採点するエージェントの問題点と、CALC_TAX の修正を最初から最後まで追った事例です。コーディングエージェントに何が与えられたのか、失敗したテスト、失敗だけをもとに導き出した推論、そして1行のパッチを紹介します。まずはこちらからお読みください。 |
| 2. 動作の性能 | 3回の一連のテストと967回の実行、その間に見つかり修正されたベンチマークの欠陥、ユニットテスト段階のギャップ、実行が停止する原因、そしてこのプロジェクトが測定した後に取り下げた結果について説明します。 |
| 3. 仕組み | 他の方法との違い、5つのエージェントとそれぞれが読み取れる情報、FIXとPATCHの分離、13のタスク例、実行のリアルタイム監視、独自のコードやテストの提供方法、受け入れ基準を生成・評価するツールについて説明します。 |
qikly を使っていますか?ぜひ紹介してください
qikly があなたのメンテナンスするもののテストを書く場合は、その README にバッジを追加してください。コードから切り離されたエージェントが受け入れ基準をもとにテストを書いたことを、読者に伝えられます。
[](https://test.qikly.com/?ref=badge)
タスクの貢献
ユーザーによる独自タスクの投稿を歓迎します。特に役立つのは、同梱されている13のタスクでは扱っていない分野の新しいタスク例を、他のタスクと名前が重複しないよう命名規則に従って投稿することです。CONTRIBUTING.md に、タスクに必要なものと、投稿前の確認方法が記載されています。採用されたタスクはすべて変更履歴に記載され、作者にはコントリビューターバッジが贈られます。同じタスクを2人が作成することのないよう、まずはタスクの提案から始めてください。
このツールの由来
このツールが徹底する分離は、安全性が極めて重要なエンジニアリングで一般的に実践されているものです。そこでは、テストにおけるV&V(Verification & Validation)手法の一環として、検証を実装から独立させる必要があります。このツールセットを作る前、私はGeneral Motorsの自動運転車プログラムでそのような環境に携わっていました。
Gal Arav が開発しました。
プライバシー
qikly はお使いのマシン上で動作し、情報を収集しません。仕様とコードは、設定したプロバイダーにご自身のキーを使って送信されます。それ以外のネットワーク接続は、2つの公開インデックスに対するバージョン確認だけで、QIKLY_NO_VERSION_CHECK=1 を指定すると無効になります。PRIVACY.md。
ライセンス
Apache License 2.0です。詳細はLICENSEをご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。