wso2-docs-mcp-server について
wso2-docs-mcp-server は、AI アシスタントや開発者向けに WSO2 製品ドキュメントのセマンティック検索を提供します。RAG と pgvector で索引を作成し、GitHub の Markdown 取り込みやウェブクロールによる補完に対応します。
主な機能
- 01対応製品全体のセマンティック検索
- 02指定製品内のガイド検索
- 03概念検索と上位結果の取得
- 04GitHub リポジトリから Markdown を取り込み
- 05ウェブクロールによる取り込みの補完
- 06ローカルまたはクラウドの埋め込みプロバイダー
活用シーン
- 01WSO2 API Manager のデプロイ手順を調べる
- 02Ballerina や Choreo のドキュメントを検索
- 03複数の WSO2 製品にまたがって情報を探す
MCP 対応
ドキュメントのセマンティック検索、製品別ガイド検索、概念検索、対応製品一覧の4つの MCP ツールを公開します。AI クライアントが stdio 経由で必要に応じてサーバーを起動します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
npx -y wso2-docs-mcp-serverDATABASE_URLPostgreSQL connection string for pgvector (e.g. postgresql://user:pass@localhost:5432/wso2docs)EMBEDDING_PROVIDEREmbedding backend to use: ollama (default, local), openai, gemini, or voyageOPENAI_API_KEYシークレットRequired only when EMBEDDING_PROVIDER=openaiGEMINI_API_KEYシークレットRequired only when EMBEDDING_PROVIDER=geminiVOYAGE_API_KEYシークレットRequired only when EMBEDDING_PROVIDER=voyageローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
WSO2 Docs MCP Server


"This is an unofficial community project. Not affiliated with or endorsed by WSO2."
Retrieval-Augmented Generation(RAG)を通じて、WSO2 のドキュメントをセマンティック検索できる、本番環境対応の Model Context Protocol (MCP) サーバーです。AI アシスタント(Claude Desktop、Claude Code、Cursor、VS Code)に検索機能を提供します。
内部では、非常に高速なデュアル取り込みエンジンを使用しています。
- GitHub ネイティブ: Git Trees API を介して、WSO2 の公開 GitHub リポジトリから Markdown を直接取得します(Web スクレイピングによるノイズやレート制限を回避します)
- Web クロールのフォールバック: 専用の GitHub ドキュメントリポジトリがない製品(WSO2 Library など)に対応します
アーキテクチャ
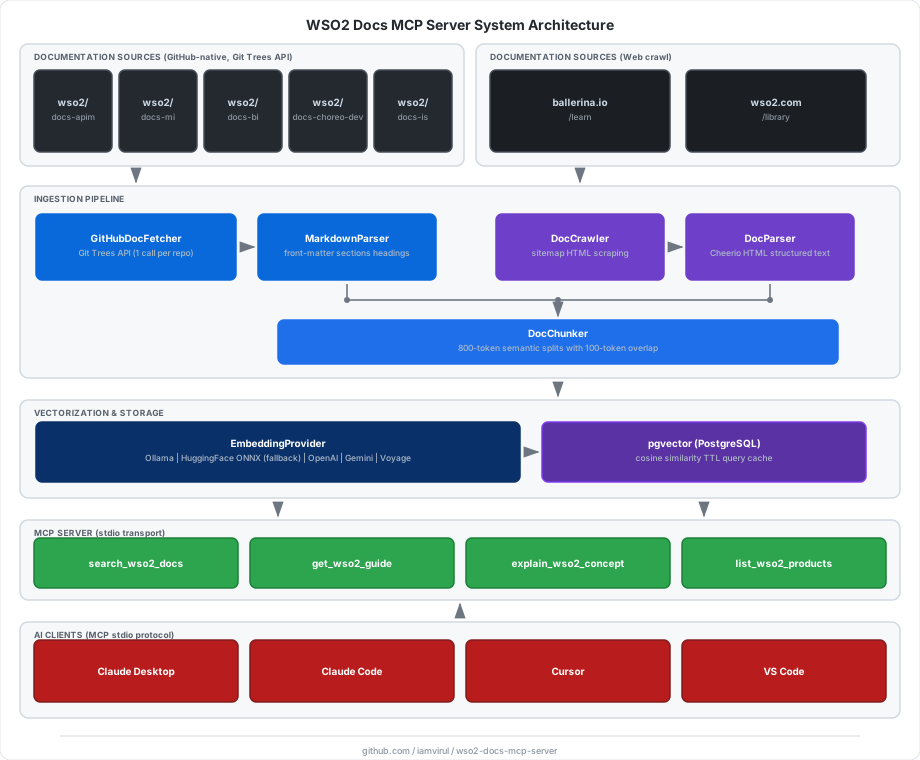
ドキュメントソース
| 製品 | ID | URL |
|---|---|---|
| API Manager | apim | https://apim.docs.wso2.com |
| Micro Integrator | mi | https://mi.docs.wso2.com/en/4.4.0 |
| Ballerina Integrator | bi | https://bi.docs.wso2.com |
| Choreo | choreo | https://wso2.com/choreo/docs |
| Identity Server | is | https://is.docs.wso2.com/en/latest |
| Ballerina | ballerina | https://ballerina.io/learn |
| WSO2 Library | library | https://wso2.com/library |
前提条件
- Node.js ≥ 20
- Docker(pgvector 用)
- エンベディング - デフォルトでは API キーは不要です:
- Ollama(推奨)- ローカルで実行され、モデルは初回起動時に自動ダウンロードされます
- Ollama が起動していない場合、サーバーは自動的に HuggingFace ONNX(プロセス内で動作し、こちらも自動でダウンロードされます)にフォールバックします
- クラウドプロバイダーもサポートされています:OpenAI、Google Gemini、Voyage AI
クイックスタート
ユースケースに合ったセットアップ方法を選択してください。
- npm からインストール - 最も簡単で、クローンは不要です
- クローンしてビルド - 開発またはコントリビューション向け
npm からインストール
パッケージをグローバルにインストールすると、wso2-docs-mcp-server、wso2-docs-crawl、wso2-docs-migrate コマンドをシステム全体で使用できるようになります。
npm install -g wso2-docs-mcp-server
グローバルインストールを避けたい場合 以下の各手順で
npx wso2-docs-mcp-server、npx wso2-docs-crawl、npx wso2-docs-migrateを使用できます。コマンドをそれぞれ対応するnpx付きの形式に置き換えてください。
1. pgvector を起動する
docker-compose.yml をダウンロードして、データベースを起動します。
curl -O https://raw.githubusercontent.com/iamvirul/wso2-docs-mcp-server/main/docker-compose.yml
docker compose up -d
2. Ollama を起動する(任意ですが推奨)
Ollama をインストールして、デフォルトのエンベディングモデルを取得します。
ollama pull nomic-embed-text
ollama serve
Ollama を使用しない場合: この手順はスキップしてください。サーバーは自動的に HuggingFace ONNX にフォールバックします。モデルは初回使用時に追加の設定なしでダウンロードされます。
3. データベースのマイグレーションを実行する
DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  wso2-docs-migrate
EMBEDDING_DIMENSIONSを変更するたびに(つまり、エンベディングプロバイダーを切り替えるたびに)マイグレーションを再実行してください。スクリプトが次元の変更を自動的に検出して処理します。
4. WSO2 ドキュメントをインデックス化する
# Index all products (first run downloads the embedding model automatically)
DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  wso2-docs-crawl

# Index a single product (faster, great for testing)
DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  wso2-docs-crawl --product ballerina --limit 20

# Force re-index even unchanged pages
DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  wso2-docs-crawl --force
使用可能な製品 ID:apim、mi、bi、choreo、is、ballerina、library
5. AI クライアントを設定する
MCP サーバーは AI クライアントによって必要に応じて起動されるため、バックグラウンドプロセスは不要です。
Claude Desktop - ~/Library/Application Support/Claude/claude_desktop_config.json を編集します。
{
  "mcpServers": {
    "wso2-docs": {
      "command": "wso2-docs-mcp-server",
      "env": {
        "DATABASE_URL": "postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs",
        "EMBEDDING_PROVIDER": "ollama"
      }
    }
  }
}
Claude Code - ターミナルで一度実行します。
claude mcp add wso2-docs \
  --transport stdio \
  -e DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  -e EMBEDDING_PROVIDER="ollama" \
  -- wso2-docs-mcp-server

# Verify
claude mcp list
Cursor - プロジェクトのルートに .cursor/mcp.json を作成します。
{
  "mcpServers": {
    "wso2-docs": {
      "command": "wso2-docs-mcp-server",
      "env": {
        "DATABASE_URL": "postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs",
        "EMBEDDING_PROVIDER": "ollama"
      }
    }
  }
}
VS Code - .vscode/mcp.json を作成します。
{
  "servers": {
    "wso2-docs": {
      "type": "stdio",
      "command": "wso2-docs-mcp-server",
      "env": {
        "DATABASE_URL": "postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs",
        "EMBEDDING_PROVIDER": "ollama"
      }
    }
  }
}
グローバルインストールではなく
npxを使用する場合:"command": "wso2-docs-mcp-server"を"command": "npx"に置き換え、"args": ["-y", "wso2-docs-mcp-server"]を追加してください。
クラウドのエンベディングプロバイダーを使用する場合: キーを
envに追加します。例:"EMBEDDING_PROVIDER": "openai", "OPENAI_API_KEY": "sk-..."。
クローンしてビルド
1. クローンしてインストールする
git clone https://github.com/iamvirul/wso2-docs-mcp-server.git
cd wso2-docs-mcp-server
npm install
2. Ollama を起動する(任意ですが推奨)
Ollama をインストールして、起動します。
ollama serve
Ollama がない場合 この手順はスキップしてください。サーバーは Ollama が起動していないことを検出し、自動的に HuggingFace ONNX 推論に切り替えます。モデルは初回使用時にダウンロードされるため、追加の設定は不要です。
3. 環境を設定する
cp .env.example .env
# Defaults work out of the box with Ollama.
# Only edit if using a cloud provider (OpenAI / Gemini / Voyage).
4. pgvector を起動する
docker compose up -d
# pgAdmin available at http://localhost:5050 ([email protected] / admin)
5. データベースのマイグレーションを実行する
npm run db:migrate
注意:
EMBEDDING_DIMENSIONSを変更するたびに(つまり、埋め込みプロバイダーを切り替えるたびに)、マイグレーションを再度実行してください。スクリプトは次元の変更を自動的に検出して処理します。
6. ドキュメントにインデックスを付ける
# Index all products
# On first run the embedding model is downloaded automatically (Ollama or HuggingFace)
npm run crawl

# Index a single product (faster, great for testing)
npm run crawl -- --product ballerina --limit 20

# Force re-index even unchanged pages
npm run crawl -- --force
7. MCP サーバーをビルドして起動する
npm run build
npm start
開発用(ビルド手順なし):
npm run dev
8. AI クライアントを設定する
/ABSOLUTE/PATH/TO/wso2-docs-mcp-serverを、実際にクローンしたパスに置き換えてください。
Claude Desktop - ~/Library/Application Support/Claude/claude_desktop_config.json を編集します。
{
  "mcpServers": {
    "wso2-docs": {
      "command": "node",
      "args": ["/ABSOLUTE/PATH/TO/wso2-docs-mcp-server/dist/src/index.js"],
      "env": {
        "DATABASE_URL": "postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs",
        "EMBEDDING_PROVIDER": "ollama"
      }
    }
  }
}
Claude Code:
claude mcp add wso2-docs \
  --transport stdio \
  -e DATABASE_URL="postgresql://wso2mcp:wso2mcp@localhost:5432/wso2docs" \
  -e EMBEDDING_PROVIDER="ollama" \
  -- node "/ABSOLUTE/PATH/TO/wso2-docs-mcp-server/dist/src/index.js"

# Verify
claude mcp list
便利なスクリプトについては、config-examples/claude_code.sh を参照してください。
Cursor - .cursor/mcp.json を作成します。詳しくは config-examples/cursor_mcp.json を参照してください。
VS Code - .vscode/mcp.json を作成します。詳しくは config-examples/vscode_mcp.json を参照してください。
MCP ツール
| ツール | 説明 |
|---|---|
search_wso2_docs | すべての製品を対象にセマンティック検索を行います。product と limit で任意の絞り込みができます。 |
get_wso2_guide | 特定の製品(apim、mi、bi、choreo、is、ballerina、library)を対象に検索します。 |
explain_wso2_concept | すべての製品を対象に幅広く概念を検索し、上位 8 件の結果を返します。 |
list_wso2_products | サポートされているすべての製品について、ID とベース URL を返します。 |
応答の例
[
  {
    "title": "Deploying WSO2 API Manager",
    "snippet": "WSO2 API Manager can be deployed in various topologies…",
    "source_url": "https://apim.docs.wso2.com/en/latest/install-and-setup/...",
    "product": "apim",
    "section": "Deployment Patterns",
    "score": 0.8712
  }
]
ローカル埋め込み
デフォルトの EMBEDDING_PROVIDER=ollama は、API キーなしでマシン上のみで動作します。起動時の処理は次のとおりです。
Is Ollama running?
├── Yes → Is model present?
│         ├── Yes → Ready (instant)
│         └── No  → Pull via Ollama (streamed, runs once)
└── No  → Download ONNX model from HuggingFace Hub (~250 MB, cached after first run)
           and run inference in-process via @huggingface/transformers
どちらの経路も、デフォルトで nomic-embed-text / Xenova/nomic-embed-text-v1 を使用して同一の 768 次元ベクトルを生成するため、再インデックスせずに切り替えられます。
ハードウェアアクセラレーション(HuggingFace ONNX フォールバック)
Ollama が利用できない場合、サーバーは最適な計算バックエンドを自動検出します。
| マシン | 検出方法 | ONNX dtype | バッチサイズ | スループット |
|---|---|---|---|---|
| Apple Silicon(M1/M2/M3/M4) | process.arch === 'arm64' | q8 INT8 | 32 | 約 9 ms/chunk |
| NVIDIA GPU | nvidia-smi のプローブ | fp32 | 64 | GPU に依存 |
| その他すべて | フォールバック | q8 INT8 | 16 | 約 10 ms/chunk |
Apple Silicon で CoreML/Metal ではなく q8 を使う理由は?
CoreML は初回使用時に Metal シェーダーをコンパイルします(初回起動時は約 20 分)。このサーバーが生成する一般的なチャンクサイズ(1 ページあたり 6~20 チャンク)では、CPU と GPU 間の転送オーバーヘッドによって推論の利点が失われます。ARM NEON SIMD による INT8 量子化推論は、初回起動時のコストなしで、常に fp32 の CPU 推論より約 100 倍高速です。
ベンチマーク(Apple M チップ、Xenova/nomic-embed-text-v1):
fp32 CPU (before): ~1,000 ms/chunk   (68 chunks ≈ 68 s of embedding)
q8  ARM NEON:          ~9 ms/chunk   (68 chunks ≈  0.6 s of embedding)  ← ~100× speedup
注意: 小規模なクロール(10 ページ以下)では、合計実行時間の大部分をネットワーク I/O(ドキュメントサイトへの HTTPS 取得)が占めるため、エンドツーエンドでの改善はわずかです。埋め込みの高速化が大きな効果を発揮するのは、埋め込み処理に以前は数時間かかっていた 500 ページ以上のクロールなど、大規模な場合です。クロールのパフォーマンスを最大限に高めるには、Ollama(
ollama serve)を実行してください。推論をネイティブに並列化し、チャンクごとのオーバーヘッドもありません。
環境変数
基本設定
| 変数 | デフォルト | 説明 |
|---|---|---|
DATABASE_URL | - | PostgreSQL 接続文字列(必須) |
EMBEDDING_PROVIDER | ollama | ollama | openai | gemini | voyage |
EMBEDDING_DIMENSIONS | 768 | モデルの出力次元数と一致させる必要があります |
CRAWL_CONCURRENCY | 5 | クロール中の同時 HTTP リクエスト数 |
CHUNK_SIZE | 800 | チャンクあたりの概算トークン数 |
CHUNK_OVERLAP | 100 | チャンク間で重複させるトークン数 |
CACHE_TTL_SECONDS | 3600 | メモリ内クエリキャッシュの TTL |
TOP_K_RESULTS | 10 | デフォルトの検索結果数 |
Ollama(デフォルト)
| 変数 | デフォルト | 説明 |
|---|---|---|
OLLAMA_BASE_URL | http://localhost:11434 | Ollama サーバーの URL |
OLLAMA_EMBEDDING_MODEL | nomic-embed-text | Ollama 経由で取得して使用するモデル |
HUGGINGFACE_EMBEDDING_MODEL | Xenova/nomic-embed-text-v1 | Ollama が起動していない場合の ONNX フォールバック |
クラウドプロバイダー
| 変数 | デフォルト | 説明 |
|---|---|---|
OPENAI_API_KEY | - | EMBEDDING_PROVIDER=openai の場合に必須 |
OPENAI_EMBEDDING_MODEL | text-embedding-3-small | OpenAI モデル |
GEMINI_API_KEY | - | EMBEDDING_PROVIDER=gemini の場合に必須 |
GEMINI_EMBEDDING_MODEL | text-embedding-004 | Gemini モデル |
VOYAGE_API_KEY | - | EMBEDDING_PROVIDER=voyage の場合に必須 |
VOYAGE_EMBEDDING_MODEL | voyage-3 | Voyage モデル |
埋め込み次元のリファレンス
| プロバイダー | モデル | 次元 |
|---|---|---|
| Ollama / HuggingFace | nomic-embed-text / Xenova/nomic-embed-text-v1 | 768(デフォルト) |
| Ollama / HuggingFace | mxbai-embed-large / Xenova/mxbai-embed-large-v1 | 1024 |
| Ollama / HuggingFace | all-minilm / Xenova/all-MiniLM-L6-v2 | 384 |
| OpenAI | text-embedding-3-small | 1536 |
| OpenAI | text-embedding-3-large | 3072 |
| Gemini | text-embedding-004 | 768 |
| Voyage | voyage-3 | 1024 |
| Voyage | voyage-3-lite | 512 |
定期的な再インデックス作成
# Run a one-off re-index (checks hashes, skips unchanged pages)
npm run reindex

# Or from the project directory using node-cron (runs daily at 2 AM)
DATABASE_URL=... node -e "
  const { ReindexJob } = require('./dist/jobs/reindexDocs');
  const job = new ReindexJob();
  job.initialize().then(() => job.scheduleDaily());
"
プロジェクト構成
src/
  config/          env.ts · constants.ts
  vectorstore/     pgvector.ts · schema.sql
  ingestion/       crawler.ts · parser.ts · githubFetcher.ts · markdownParser.ts · chunker.ts · embedder.ts
  server/          mcpServer.ts · toolRegistry.ts
  jobs/            reindexDocs.ts
  index.ts
scripts/
  crawl.ts         CLI ingestion pipeline
  migrate.ts       Dynamic schema migration
config-examples/   claude_desktop.json · claude_code.sh · cursor_mcp.json · vscode_mcp.json
docker-compose.yml
.env.example
開発
# Type-check
npx tsc --noEmit

# Run crawl with tsx (no build needed)
npm run crawl -- --product ballerina --limit 5

# Run server in dev mode
npm run dev
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。