llmxray について
LLMxRayは、Ollamaユーザーや開発者、エージェント向けのローカル監視・診断ツールです。Ollamaリクエストを中継してプロンプトや実行状況を可視化し、読み取り専用のMCPツールで呼び出しを分析できます。
主な機能
- 01Ollama互換リクエストプロキシ
- 02リクエストとキャッシュのライブ確認
- 03プロンプトと実行状況の可視化
- 04モデルとGPU使用状況の表示
- 05ローカルの読み取り専用MCP診断
- 06OpenTelemetryトレースのエクスポート
活用シーン
- 01ローカルAIクライアントのプロンプト確認
- 02キャッシュ消失やコンテキスト切り詰めの特定
- 03エージェントの最近のOllama呼び出しを診断
- 04変更前後のモデル呼び出し性能を比較
MCP 対応
LLMxRayは、最近の呼び出し、ローカルモデル、プロンプトの見積もり、稼働状況を確認する7つの読み取り専用MCPツールを提供します。MCPサーバーはlocalhost経由で起動中のLLMxRayからデータを読み取ります。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
3掲載時のツール一覧 · 4 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| client | string | いいえ | LLMxRay に表示されるクライアントラベルまたは ID の一部(例:"VS Code Copilot"、"python-requests"、または送信した X-LLMxRay-Client ヘッダー)。大文字と小文字を区別しない部分文字列です。省略すると、すべてのクライアントが対象になります。 |
| since_minutes | integer | いいえ | 直近 N 分間のターンのみを対象にします。省略すると、LLMxRay が保持しているすべてのターンが対象になります。 |
詳細
LLMxRay


ローカル AI が実際に何をしているのかを確認できます。
VS Code Copilot、Open WebUI、Continue、n8n、または独自のエージェントの接続先を Ollama ではなく LLMxRay にするだけで、やり取りのすべてを確認できます。
キャッシュされた内容、再読み込みされた内容、デーモンがひそかに削除した内容、どのツールがどのモデルを退避させたかがわかります。クラウド不要。API キー不要。費用もかかりません。



🌐 English • Français • 中文 • العربية • Srpski
クイックスタート • ツールが実際に送信する内容 • 保存して転送 • エージェント向け • ほかの機能 • 対象ユーザー • インストール • Ollama との互換性 • 変更履歴
クイックスタート
少なくとも 1 つのモデルを取得した状態で(ollama pull llama3.2)、Ollama を起動しておく必要があります。その後、次を実行します。
npx llmxray
Docker を使う場合:
docker run -p 5174:5174 -p 11435:11435 djovaneli/llmxray
ツールの接続先を Ollama の 11434 ではなく http://localhost:11435 に設定します。VS Code Copilot、Open WebUI、Continue、n8n、自分のスクリプトなどが対象です。Ollama とまったく同じように動作し、すべてを転送します。http://localhost:5174 を開いて Live に移動すると、ツールのターンが届く様子を確認できます。
モデルを試してみたいだけですか?Chat ページを開いてモデルを選び、メッセージを送信してください。
ツールが実際に送信する内容
エディター、エージェント、スクリプトは、すべて同じ Ollama と通信します。各ページでは、それぞれが何を送信するのか、デーモンがどう処理するのか、ほかのツールにどのような影響があるのかを確認できます。
Live:ほかのツールが送信する内容
LLMxRay は、Ollama とまったく同じように動作してすべてを転送する 2 つ目のポート 11435 を開きます。VS Code Copilot、Open WebUI、Continue、n8n、または自分のスクリプトの接続先を http://localhost:11435 に設定すると、それらが送信するすべてのターンがここに表示されます。クライアント、モデル、プロンプトのサイズ、キャッシュから取得した量、プリフィルと生成の速度、ツール呼び出しなどを確認できます。
VS Code Copilot ─┐
Open WebUI ──────┤                                    ┌─ Live page: every turn,
Continue / n8n ──┼─► http://localhost:11435 ─► Ollama ┤  cache hits, prefill speed,
your scripts ────┘        (LLMxRay)                   └─ where the cache broke
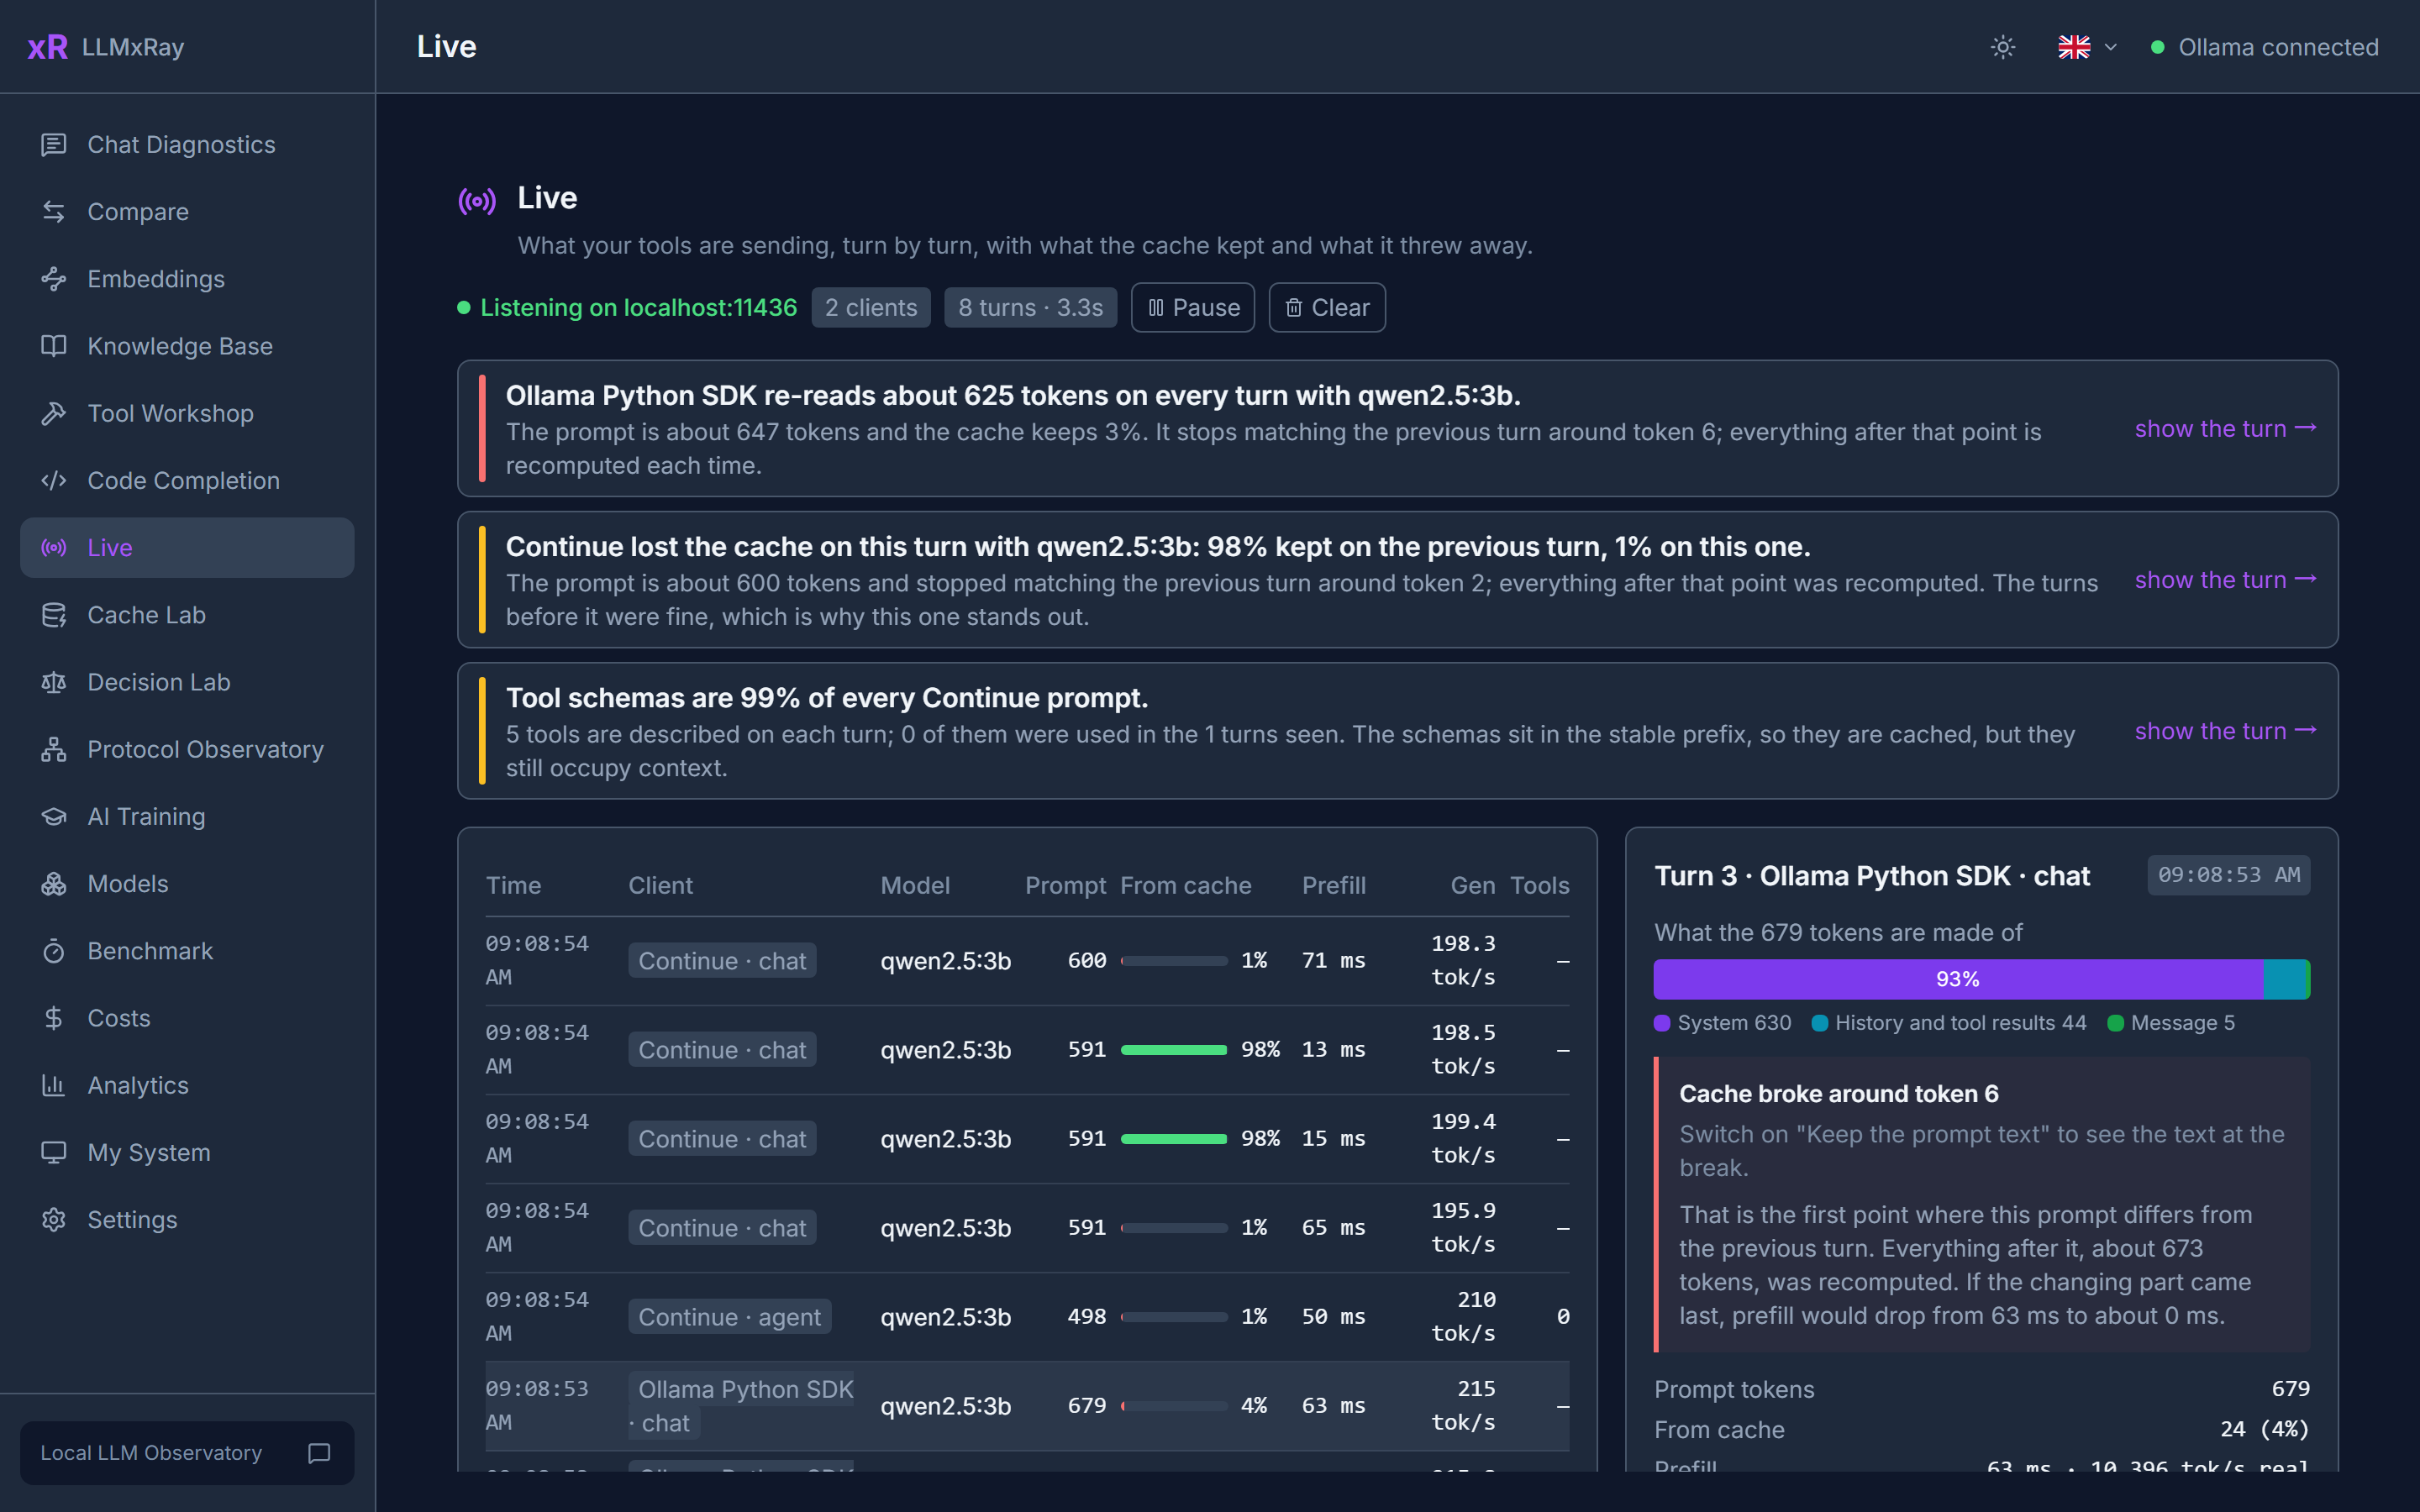
ターンを選択すると、プロンプトの構成と、前回の内容との一致が途切れた正確な箇所、つまりキャッシュが切れた箇所を確認できます。調査結果は簡潔な文章で示され、それぞれ根拠となるターンにリンクされています。たとえば、毎回プロンプト全体を読み込み直すクライアント、コンテキストに収めるためにデーモンがひそかに切り詰めたプロンプト(Ollama は最初の数トークンと末尾を残し、その間を破棄しますが、何も通知しません)、一部が CPU で実行されているモデル、すべてのプロンプトの 40%を占めるツールスキーマなどです。保存されるのは件数と時間だけで、このマシン上に 30 日間保存されるため、再起動後も続きから利用できます。プロンプトのテキストを保存するには、オプトインしてローカルファイルに書き込みます。自分のトレースビューアーにターンを転送しない限り、データがマシンの外に出ることはありません。モデル呼び出しごとに OpenTelemetry スパン、実行ごとにトレースとして、Jaeger、Phoenix、Langfuse、Grafana に送信できます。
Live ログにはツールが送信した内容がそのまま含まれるため、どちらのポートもデフォルトではこのマシンからの接続だけに応答します。ネットワーク上のほかのマシンからアクセスできるようにするには、npx llmxray --host 0.0.0.0 で起動します。2 つ目の画面で Live ページを表示したり、GPU マシンを共有したりできます。
Prompt X-ray:プロンプト自体を縮尺どおりに描画
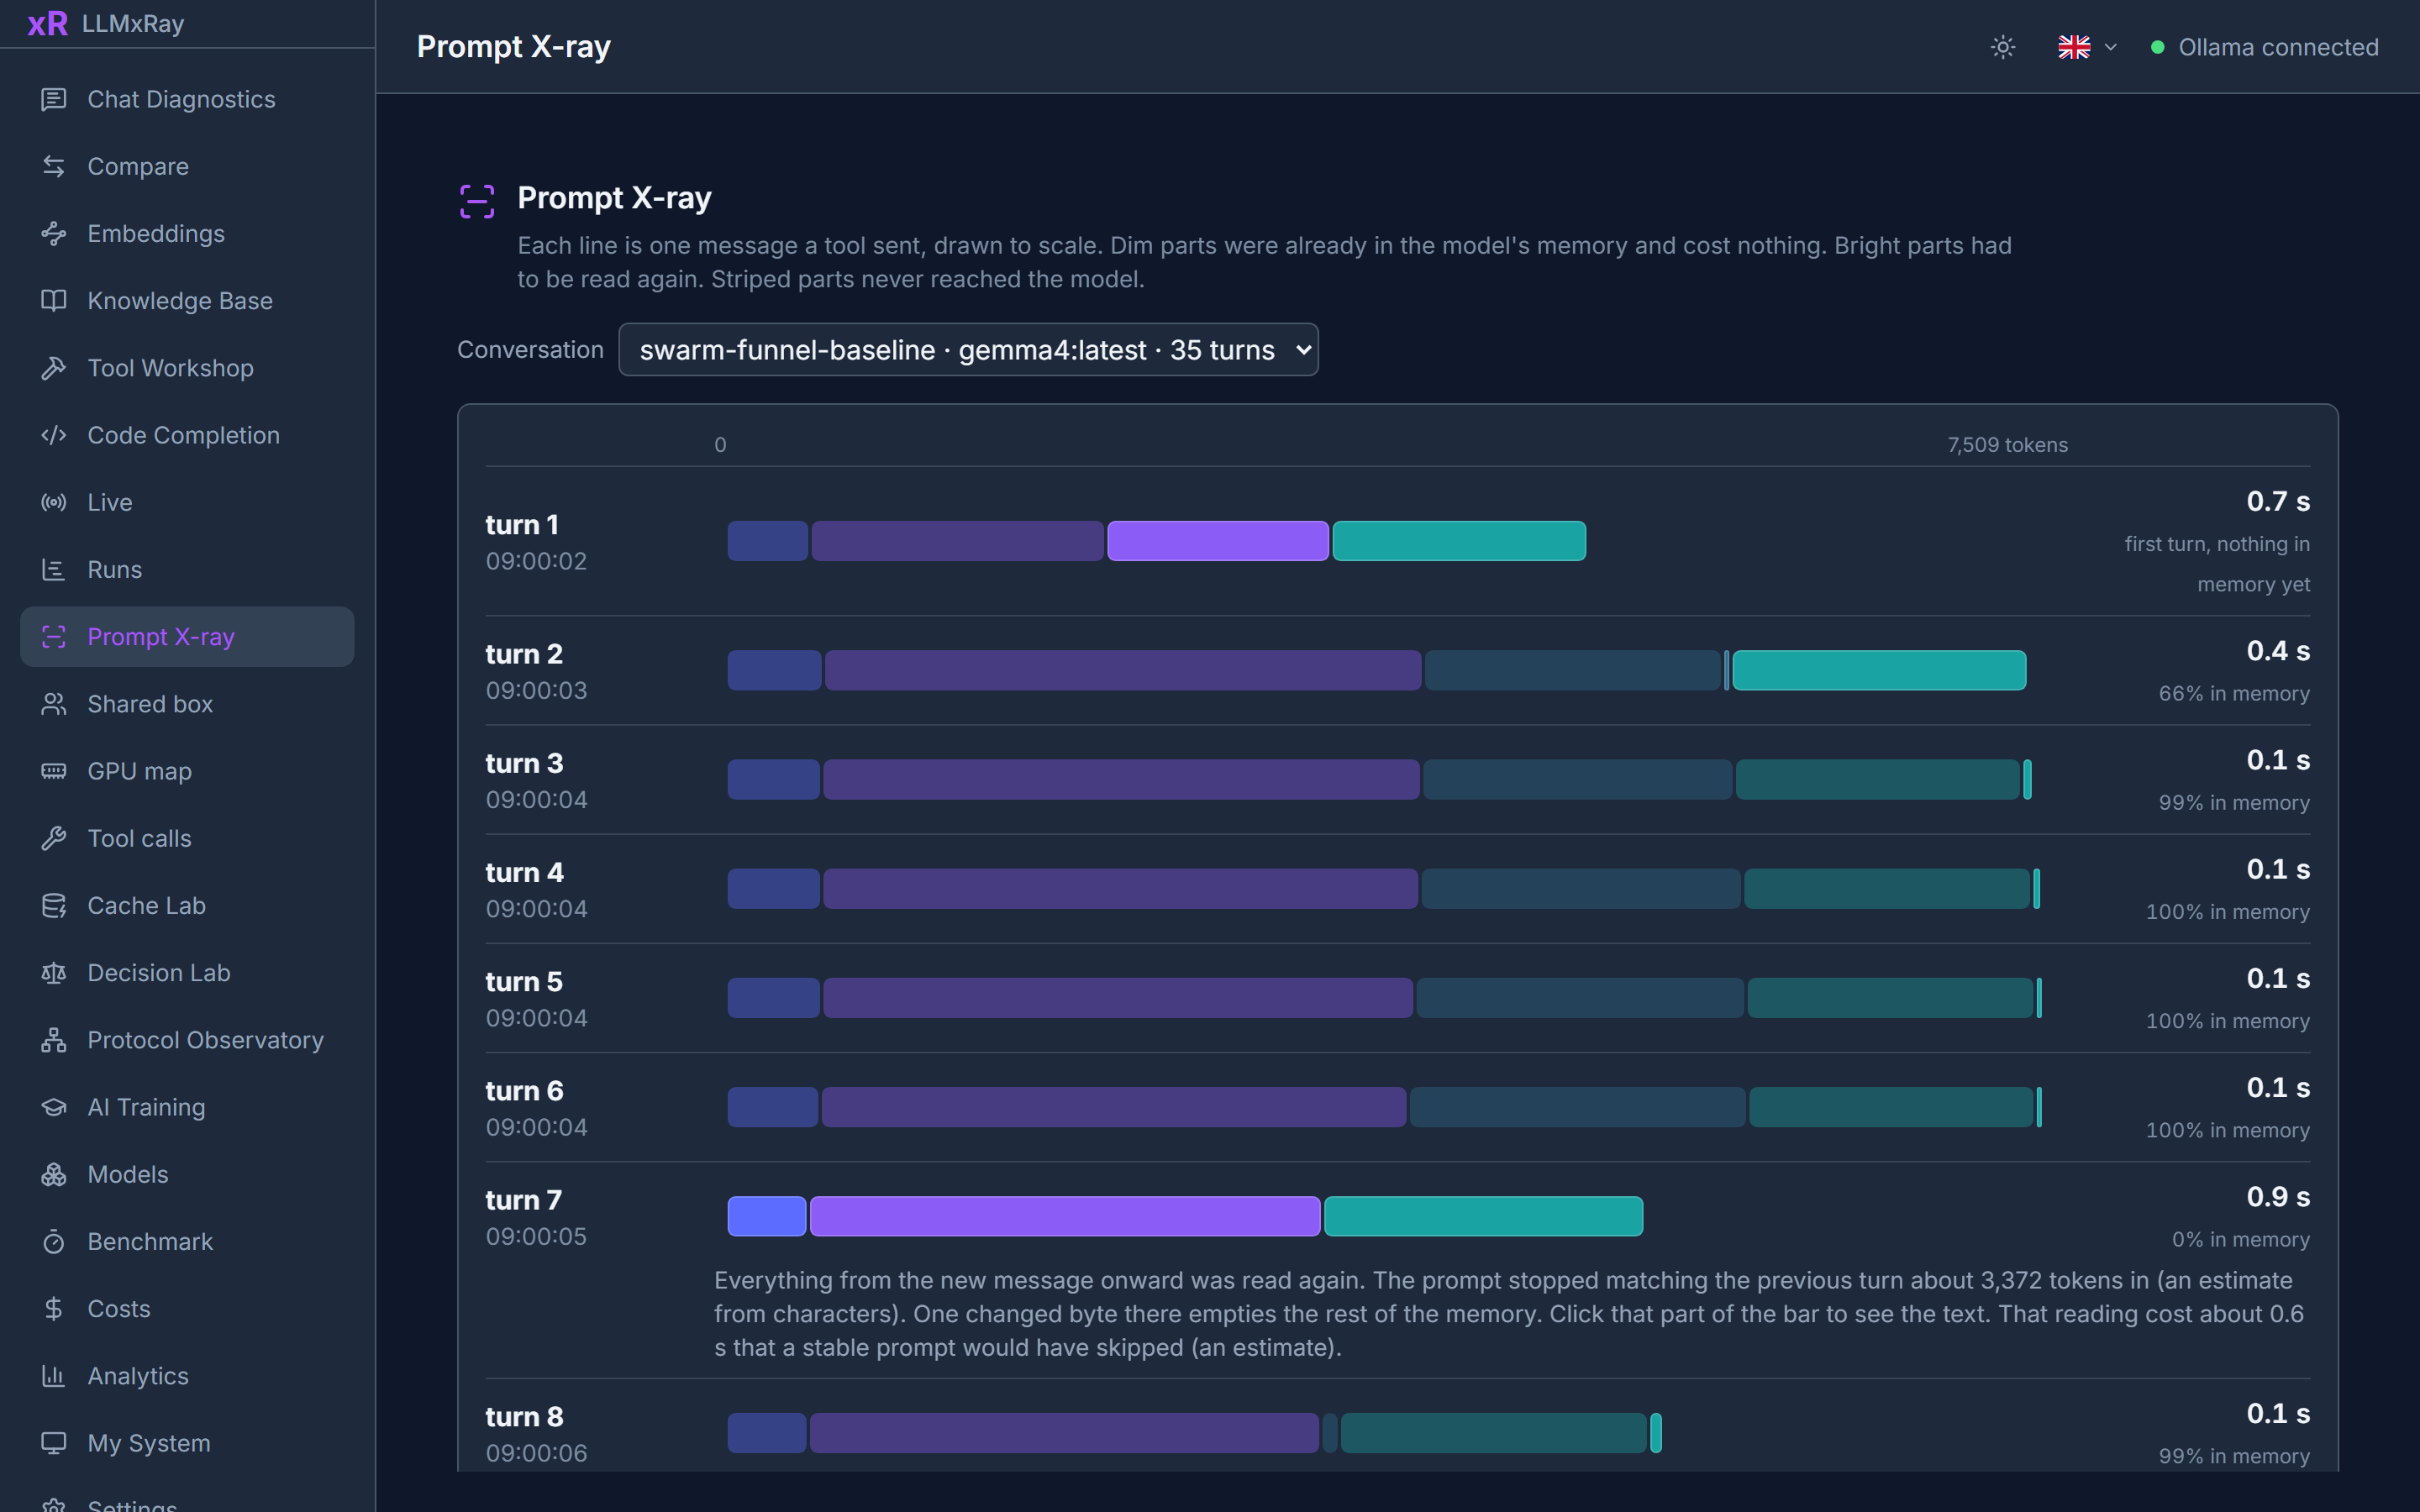
ツールが送信した各ターンを、バーで表示します。色はプロンプトの各部分が何であるかを表します。システムプロンプト、ツールスキーマ、以前のターン、新しいメッセージです。明るさは、その部分がどう処理されたかを表します。暗い部分はすでにモデルのメモリにあり、コストがかかりません。明るい部分は再び読み込む必要があり、縞模様の部分はデーモンによって切り詰められ、モデルには渡されていません。会話のターンを積み重ねると、キャッシュの増加や、システムプロンプトのタイムスタンプによってキャッシュが空になったターン、プロンプトがコンテキストを超過し、システムプロンプトを含む先頭部分を Ollama がひそかに破棄して、それでも応答したターンがわかります。部分をクリックすると、その箇所を開いた状態でリクエストが表示されます。
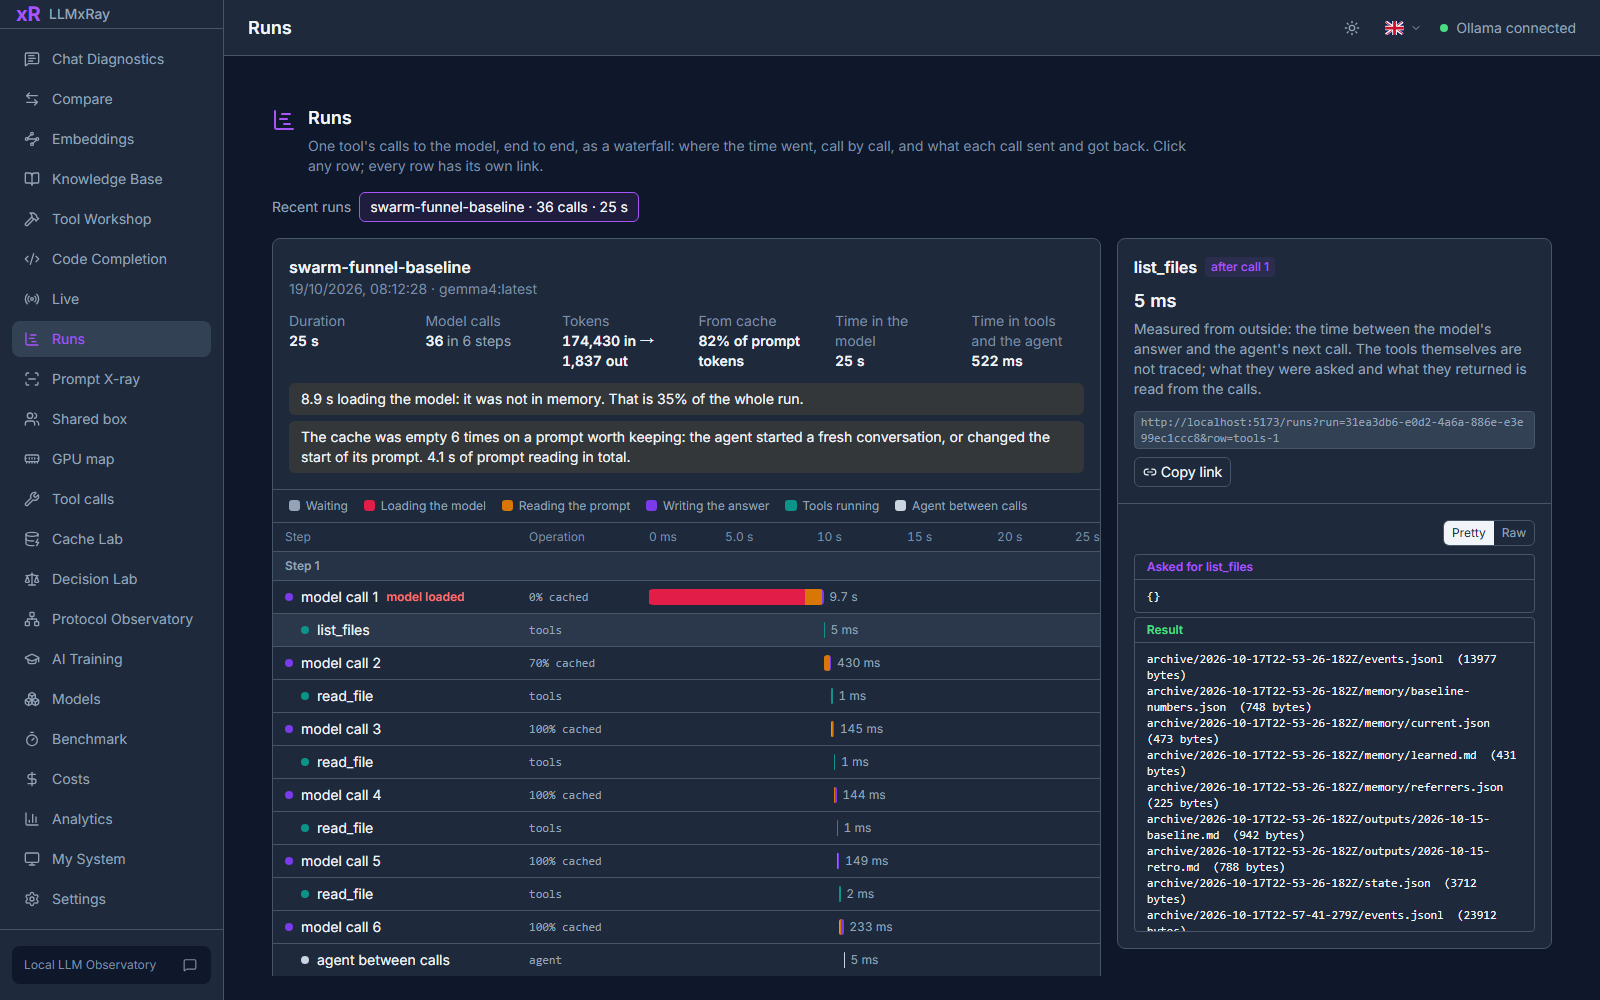
実行:1 つのツールの処理を最初から最後まで
1 つのツールがモデルを呼び出す様子を、時間順にウォーターフォール形式で表示します。各呼び出しは、Ollama が報告する「待機」「モデルの読み込み」「プロンプトの読み取り」「回答の生成」に分かれています。呼び出しの合間には、モデルが要求したツール名にちなんで名付けられた、ツール自体の処理時間が表示されます。各ステップはツールが新しい会話を始めた時点から表示されるため、ステップごとにキャッシュを破棄するエージェントも、実行開始時にモデルがメモリに読み込まれていなかったケースも一目でわかります。任意の行をクリックすると、その呼び出しで送信した内容と返された内容、モデルの思考内容と引数を含むツール呼び出し、またはツールへの要求とその戻り値を確認できます。各行には専用のリンクがあります。テキストを確認するには、Live ページで Keep the prompt text を有効にしてください。タイミングの確認には必要ありません。
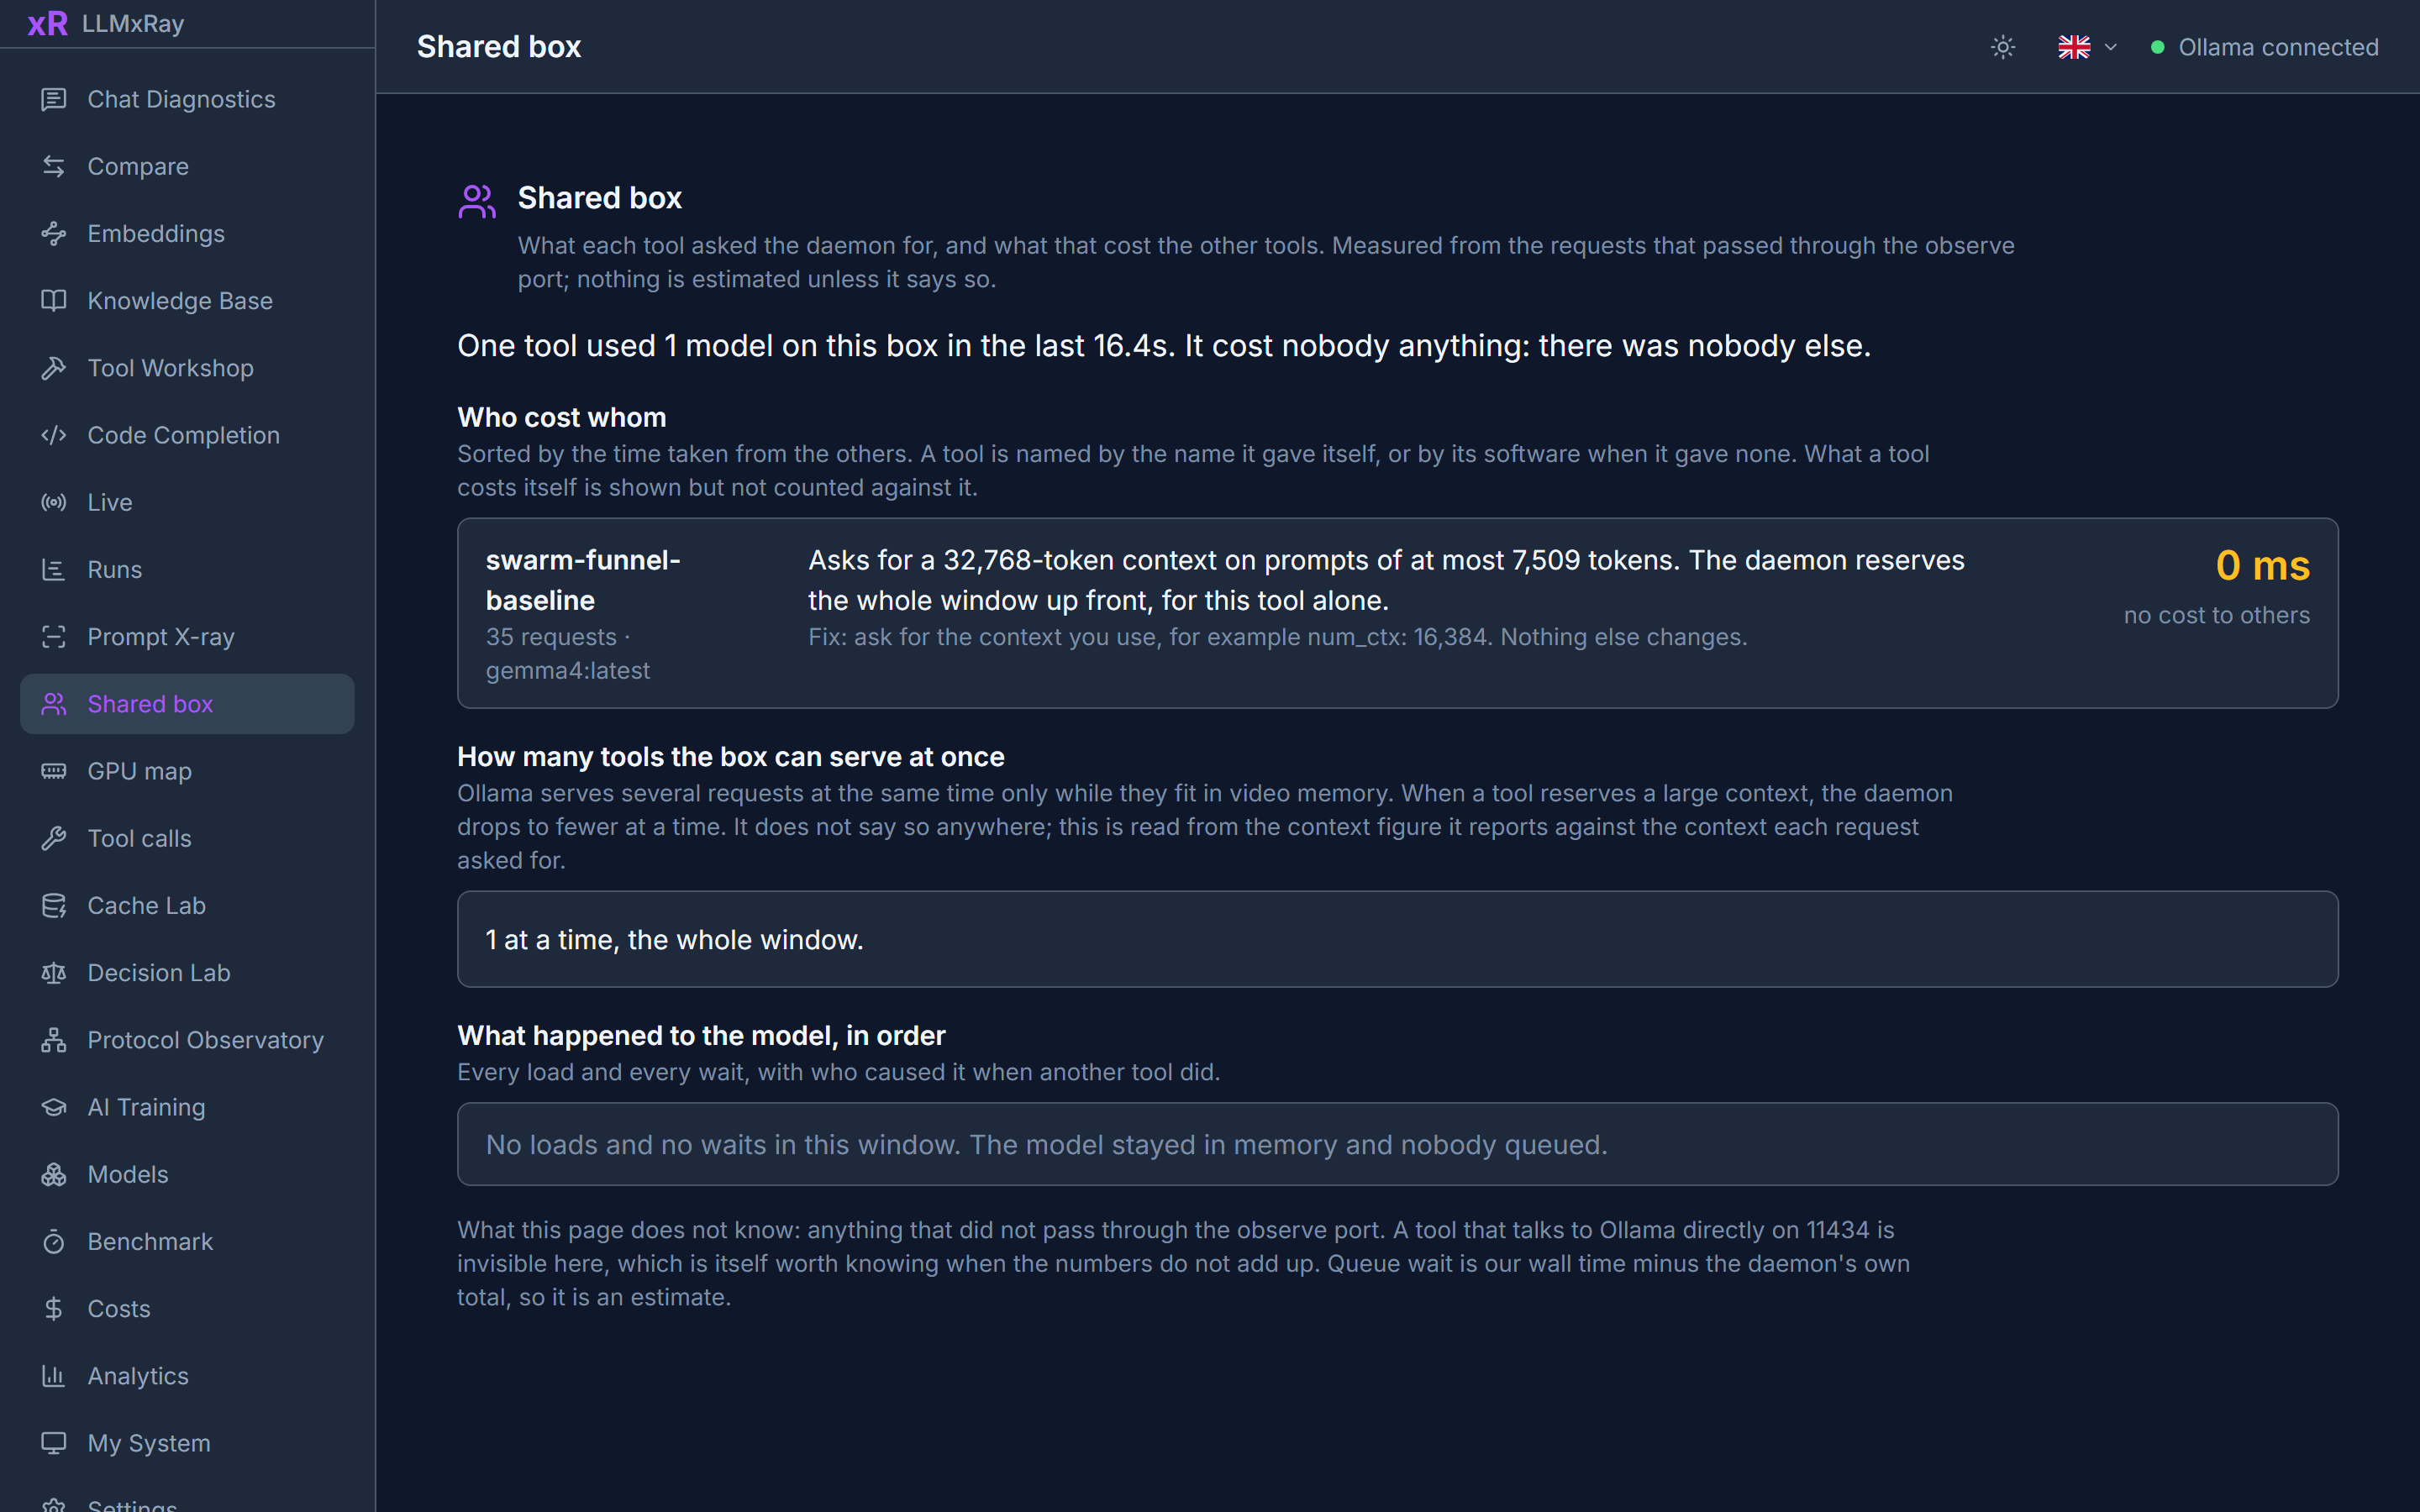
共有ボックス:今 Ollama が遅い理由と、その原因になったツール
他のツールにかかった負荷を秒単位で並べ替え、ツールごとに 1 行で表示します。実行のたびに keep_alive: 0 を送ってモデルをアンロードするツール、4K のプロンプトに 128K のコンテキストを要求してデーモンの同時リクエスト数を 1 にするツール、そしてそれらの後ろで 22 秒待たされたツールを確認できます。それぞれ、変更すべき設定も表示されます。負荷をかけていないツールも一覧に含まれるため、望ましい状態も確認できます。
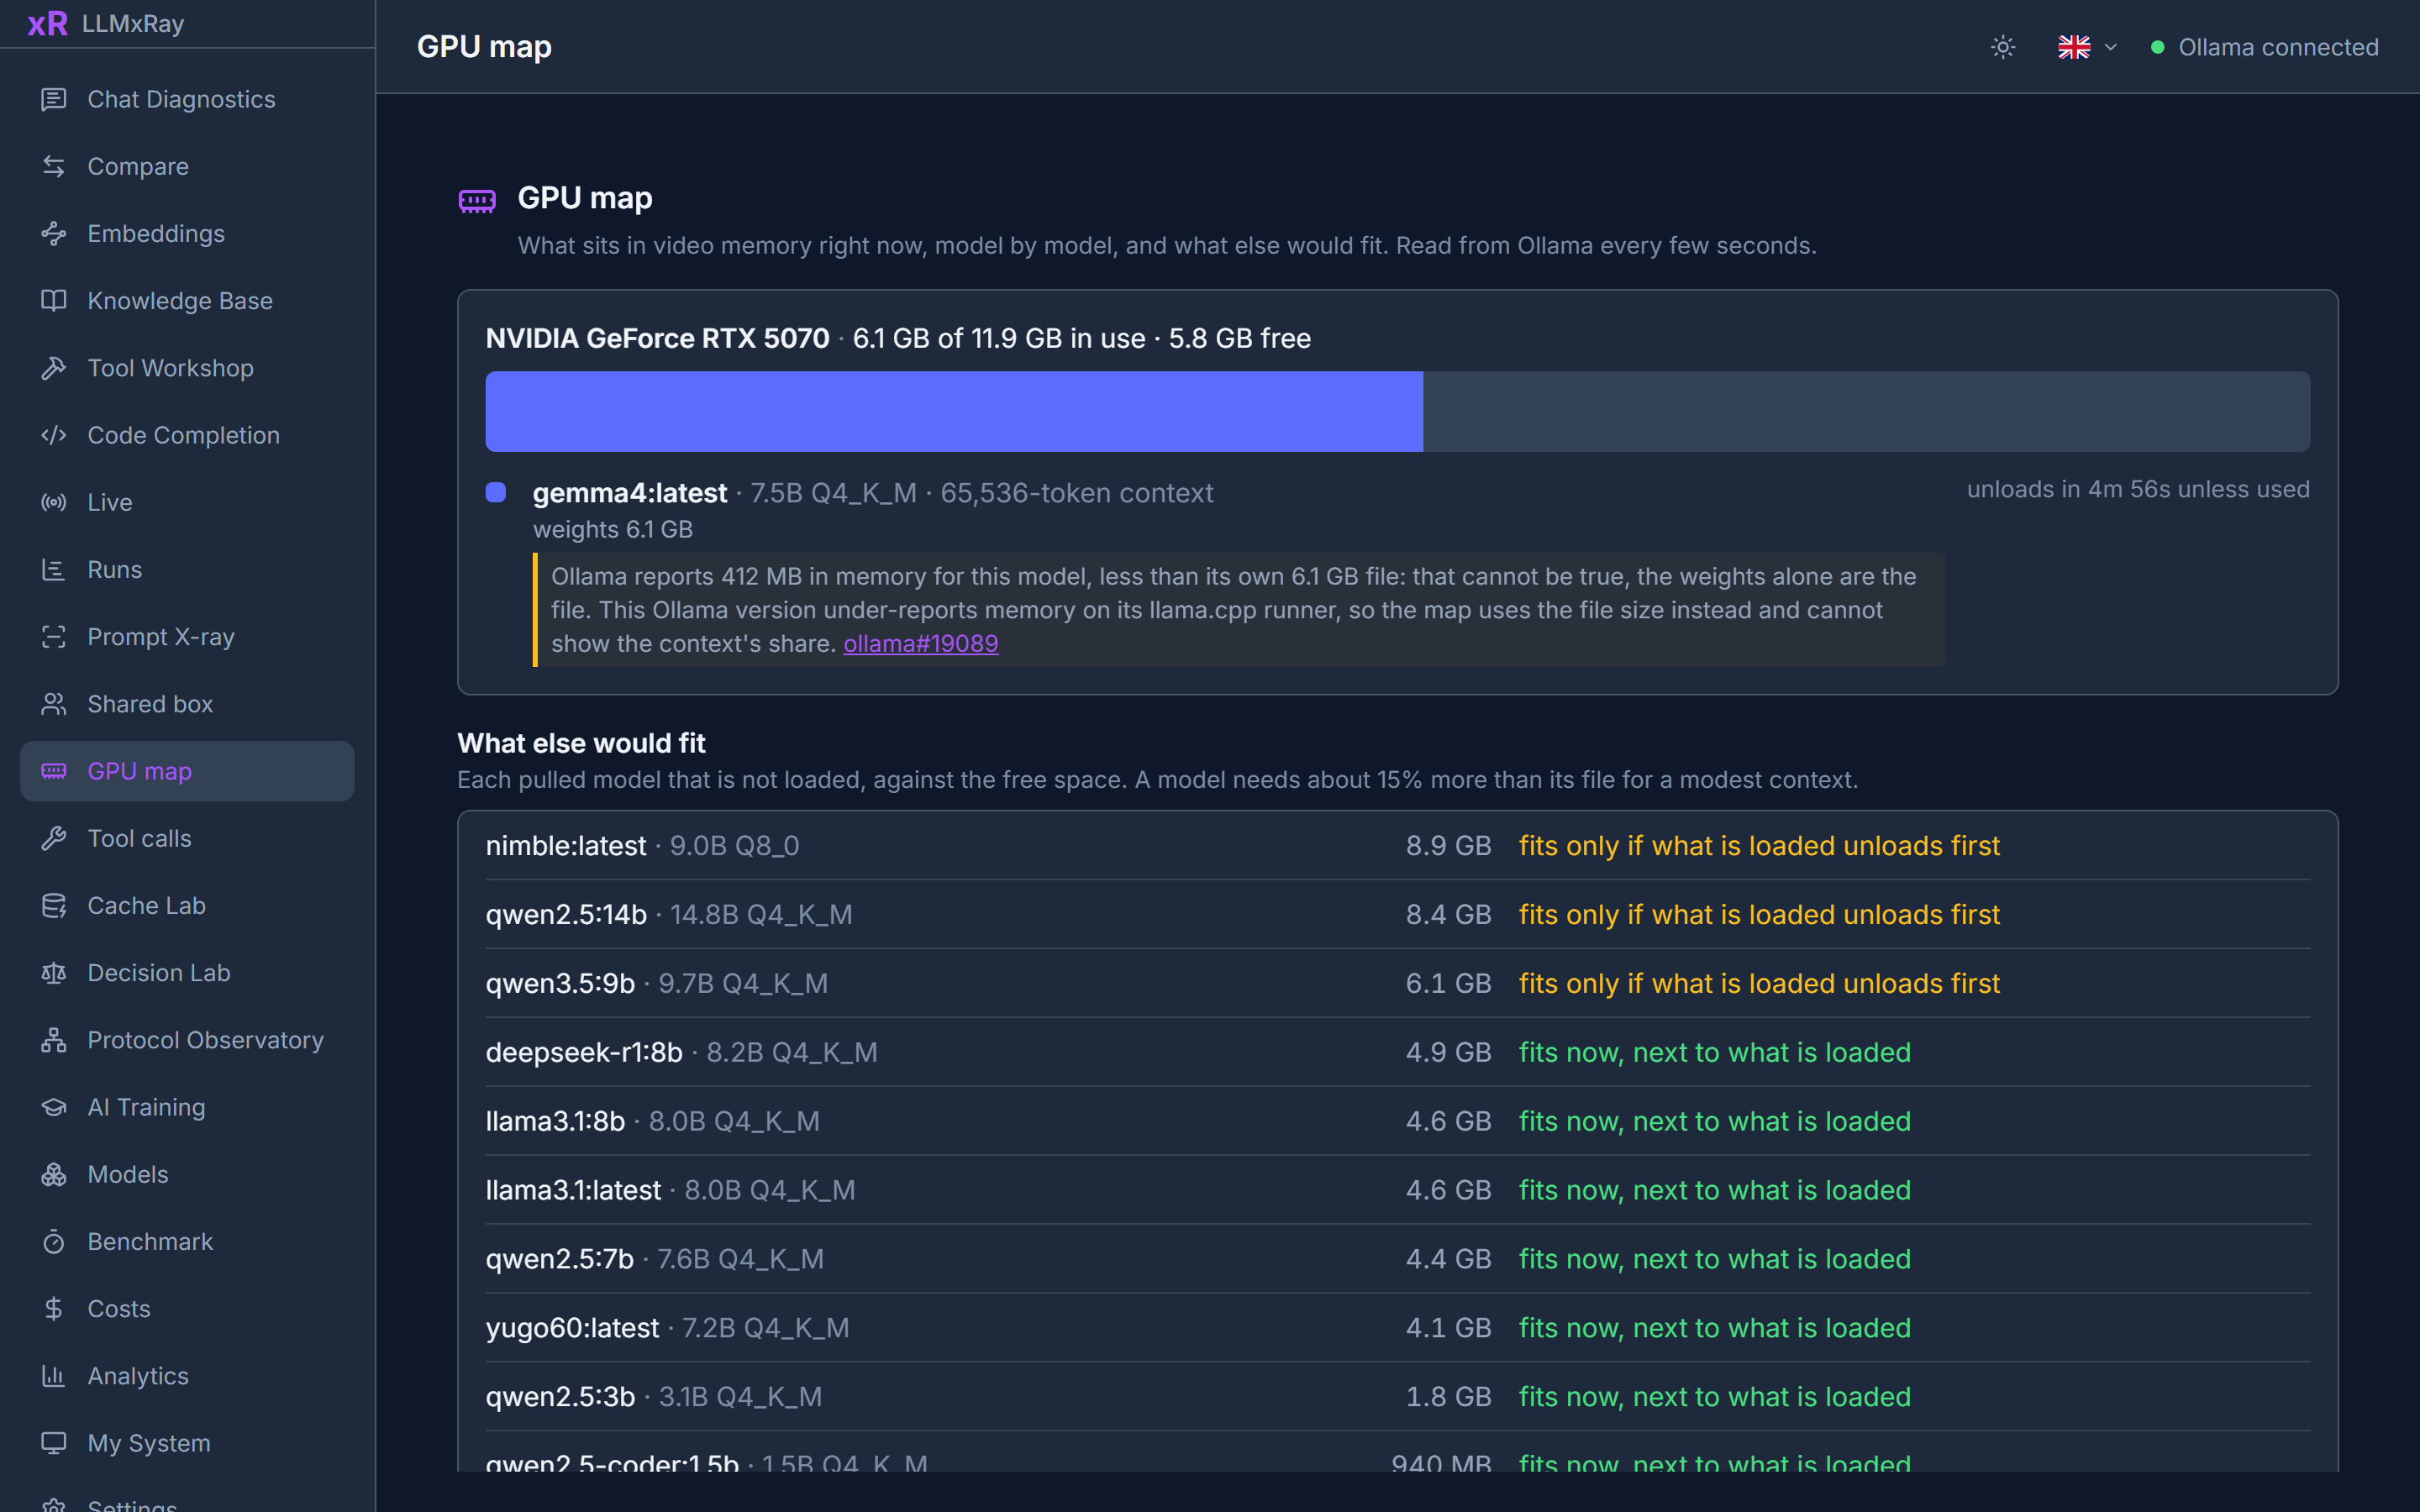
GPU マップ:ビデオメモリの使用状況と、ほかに読み込めるモデル
グラフィックカードの幅に合わせたバーに、読み込み済みモデルをブロックで表示します。各ブロックは重みとコンテキストの追加コストに分かれ、その後に空き領域が表示されます。その下には、取得済みのすべてのモデルが 3 つの判定のいずれかで表示されます。「今すぐ読み込める」「現在のモデルがアンロードされれば読み込める」「カードより大きい」です。
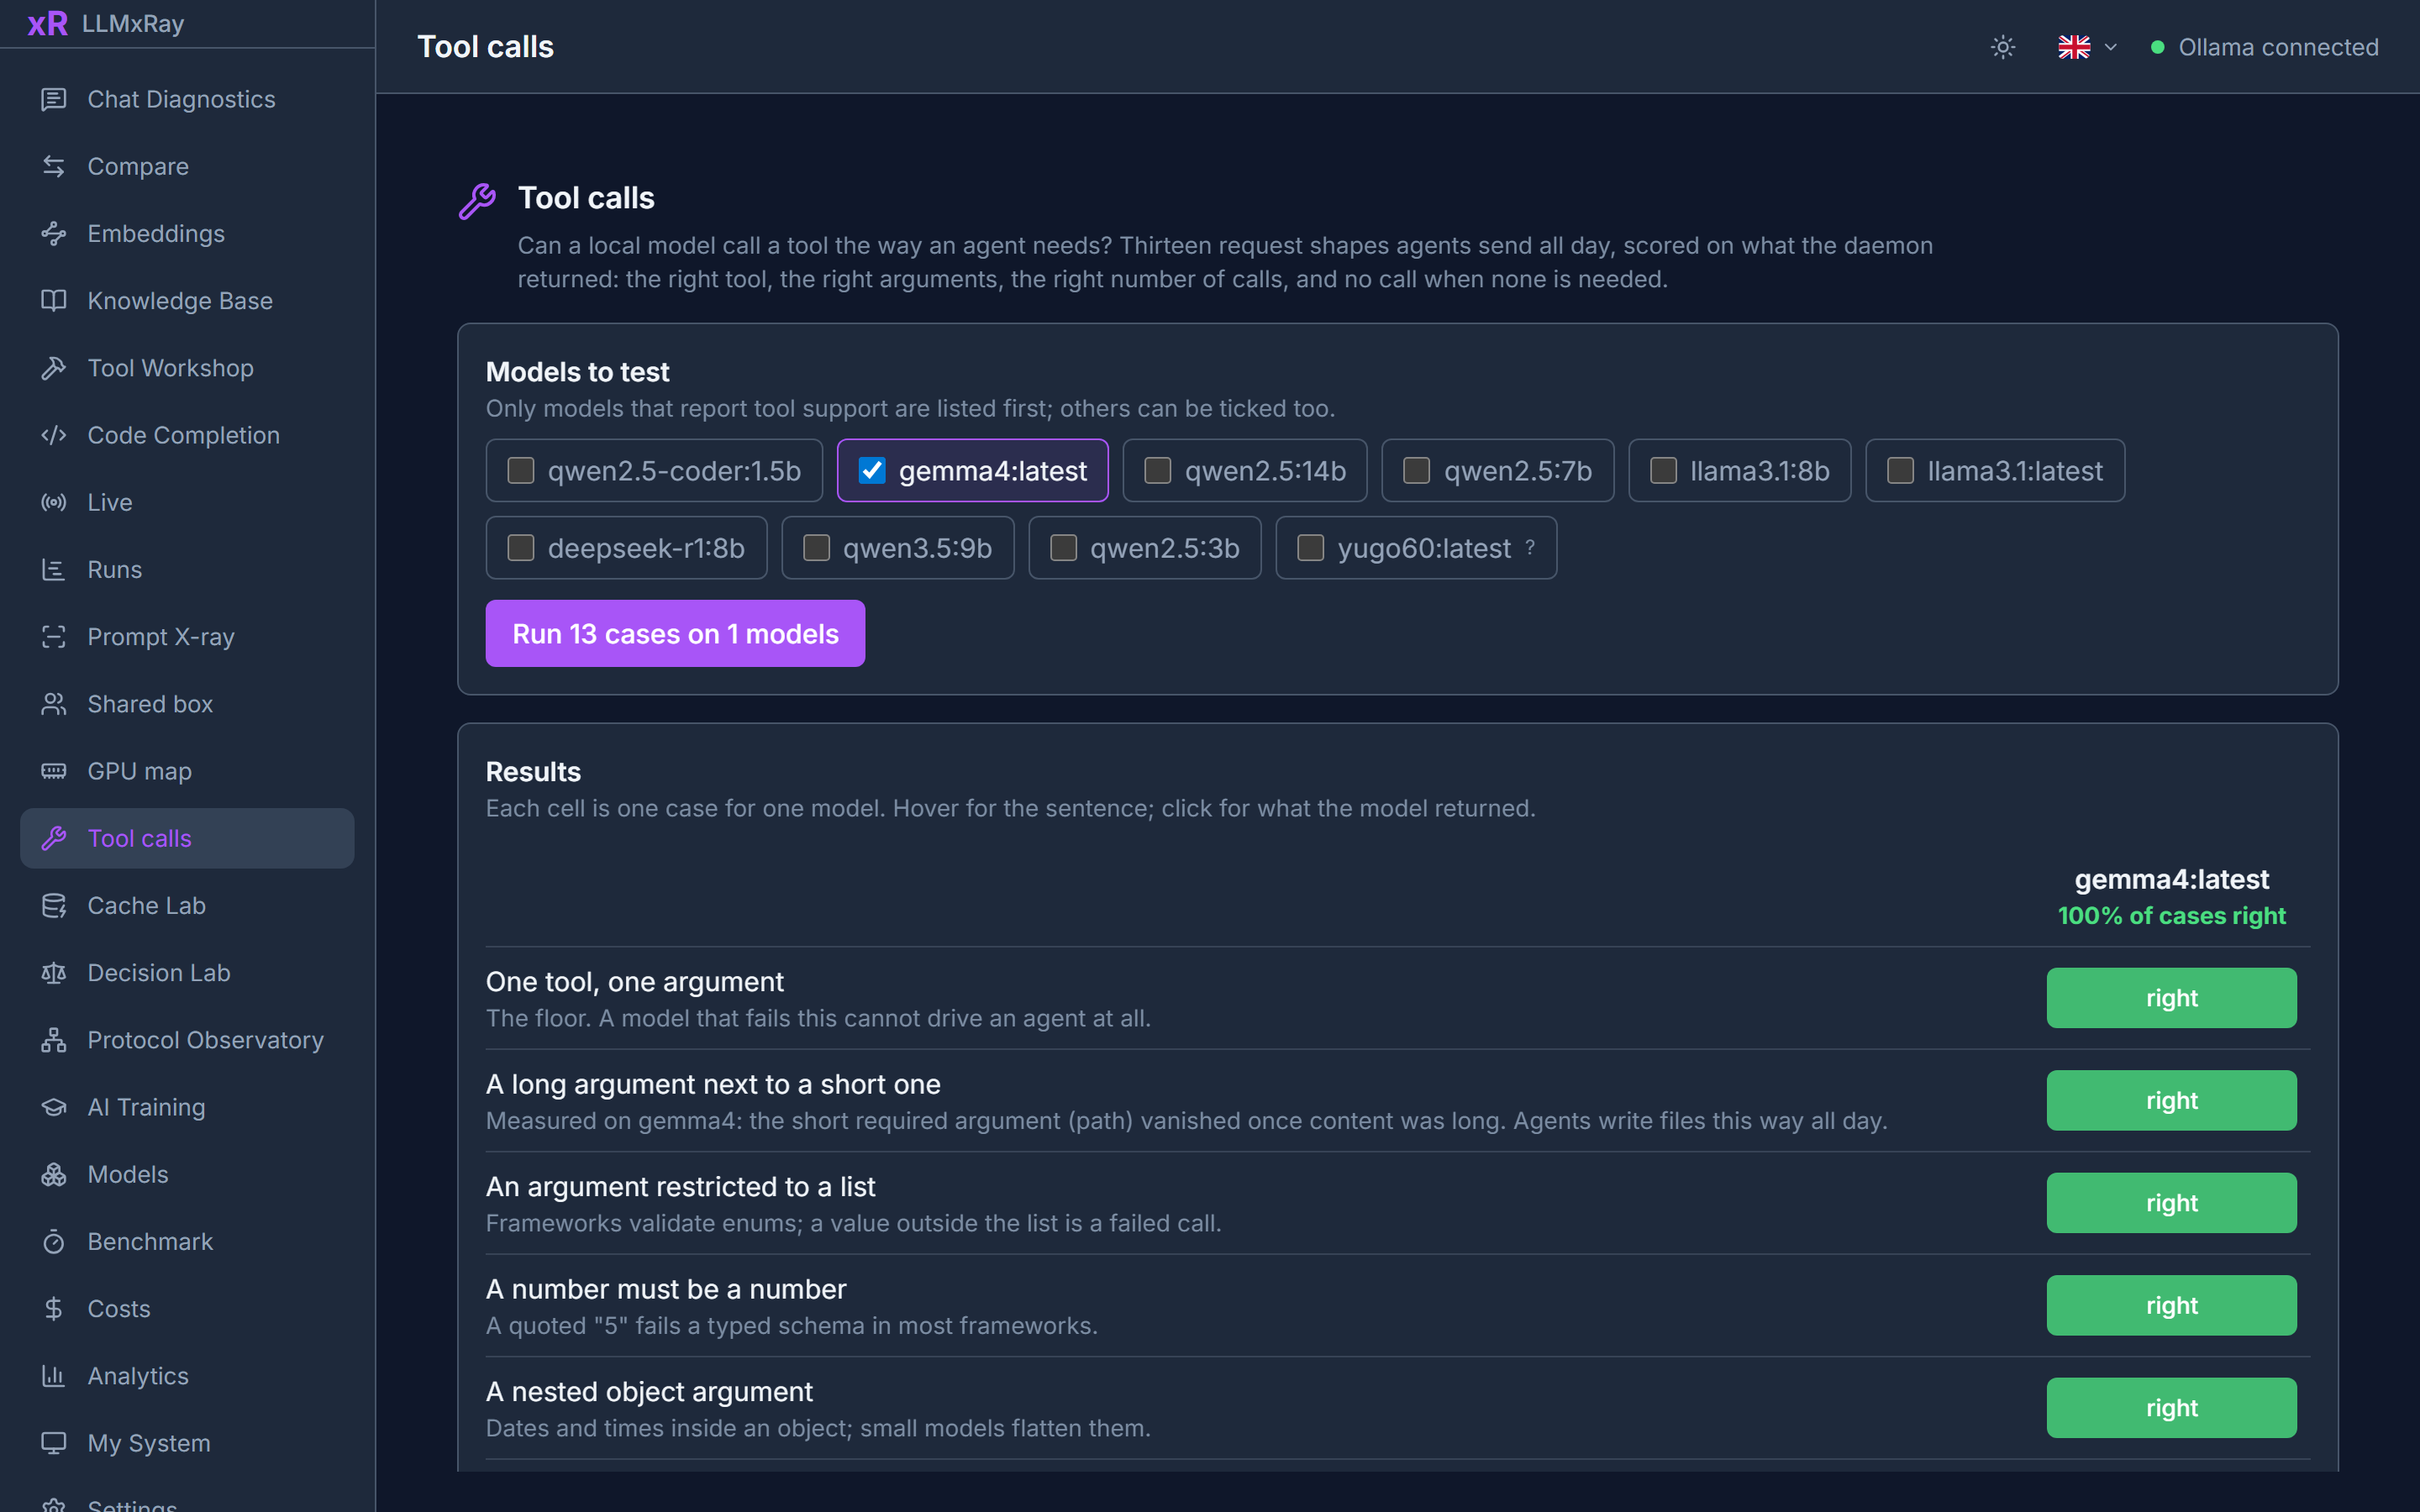
ツール呼び出し:このモデルはエージェントを動かせるか?
エージェントが日常的に送る 13 種類のリクエスト形式を、デーモンからの応答に基づいて評価します。適切なツールが選ばれたか、引数が適切か、呼び出し回数が適切か、不要な呼び出しをしていないかを確認できます。各セルには、「パス引数がありません」「呼び出しを回答テキストに書き込みました」「ツールが不要な場面で search_web を呼び出しました」のように、1 文で結果が表示されます。クリックすると、モデルが返した内容を確認できます。
Cache Lab
ローカルモデルがプロンプトキャッシュを再利用できるのは、最初のトークンからプロンプトが一致している間だけです。先頭付近にある 1 つのタイムスタンプによって、それより後ろの内容がすべて再利用できなくなることがあります。Cache Lab は、ターンごとに変わる値を見つけ、再利用がどこで途切れるかを示し、さらに独自のデーモンで測定して、それらの値を末尾に移すことでどれだけ節約できるかを確認します。
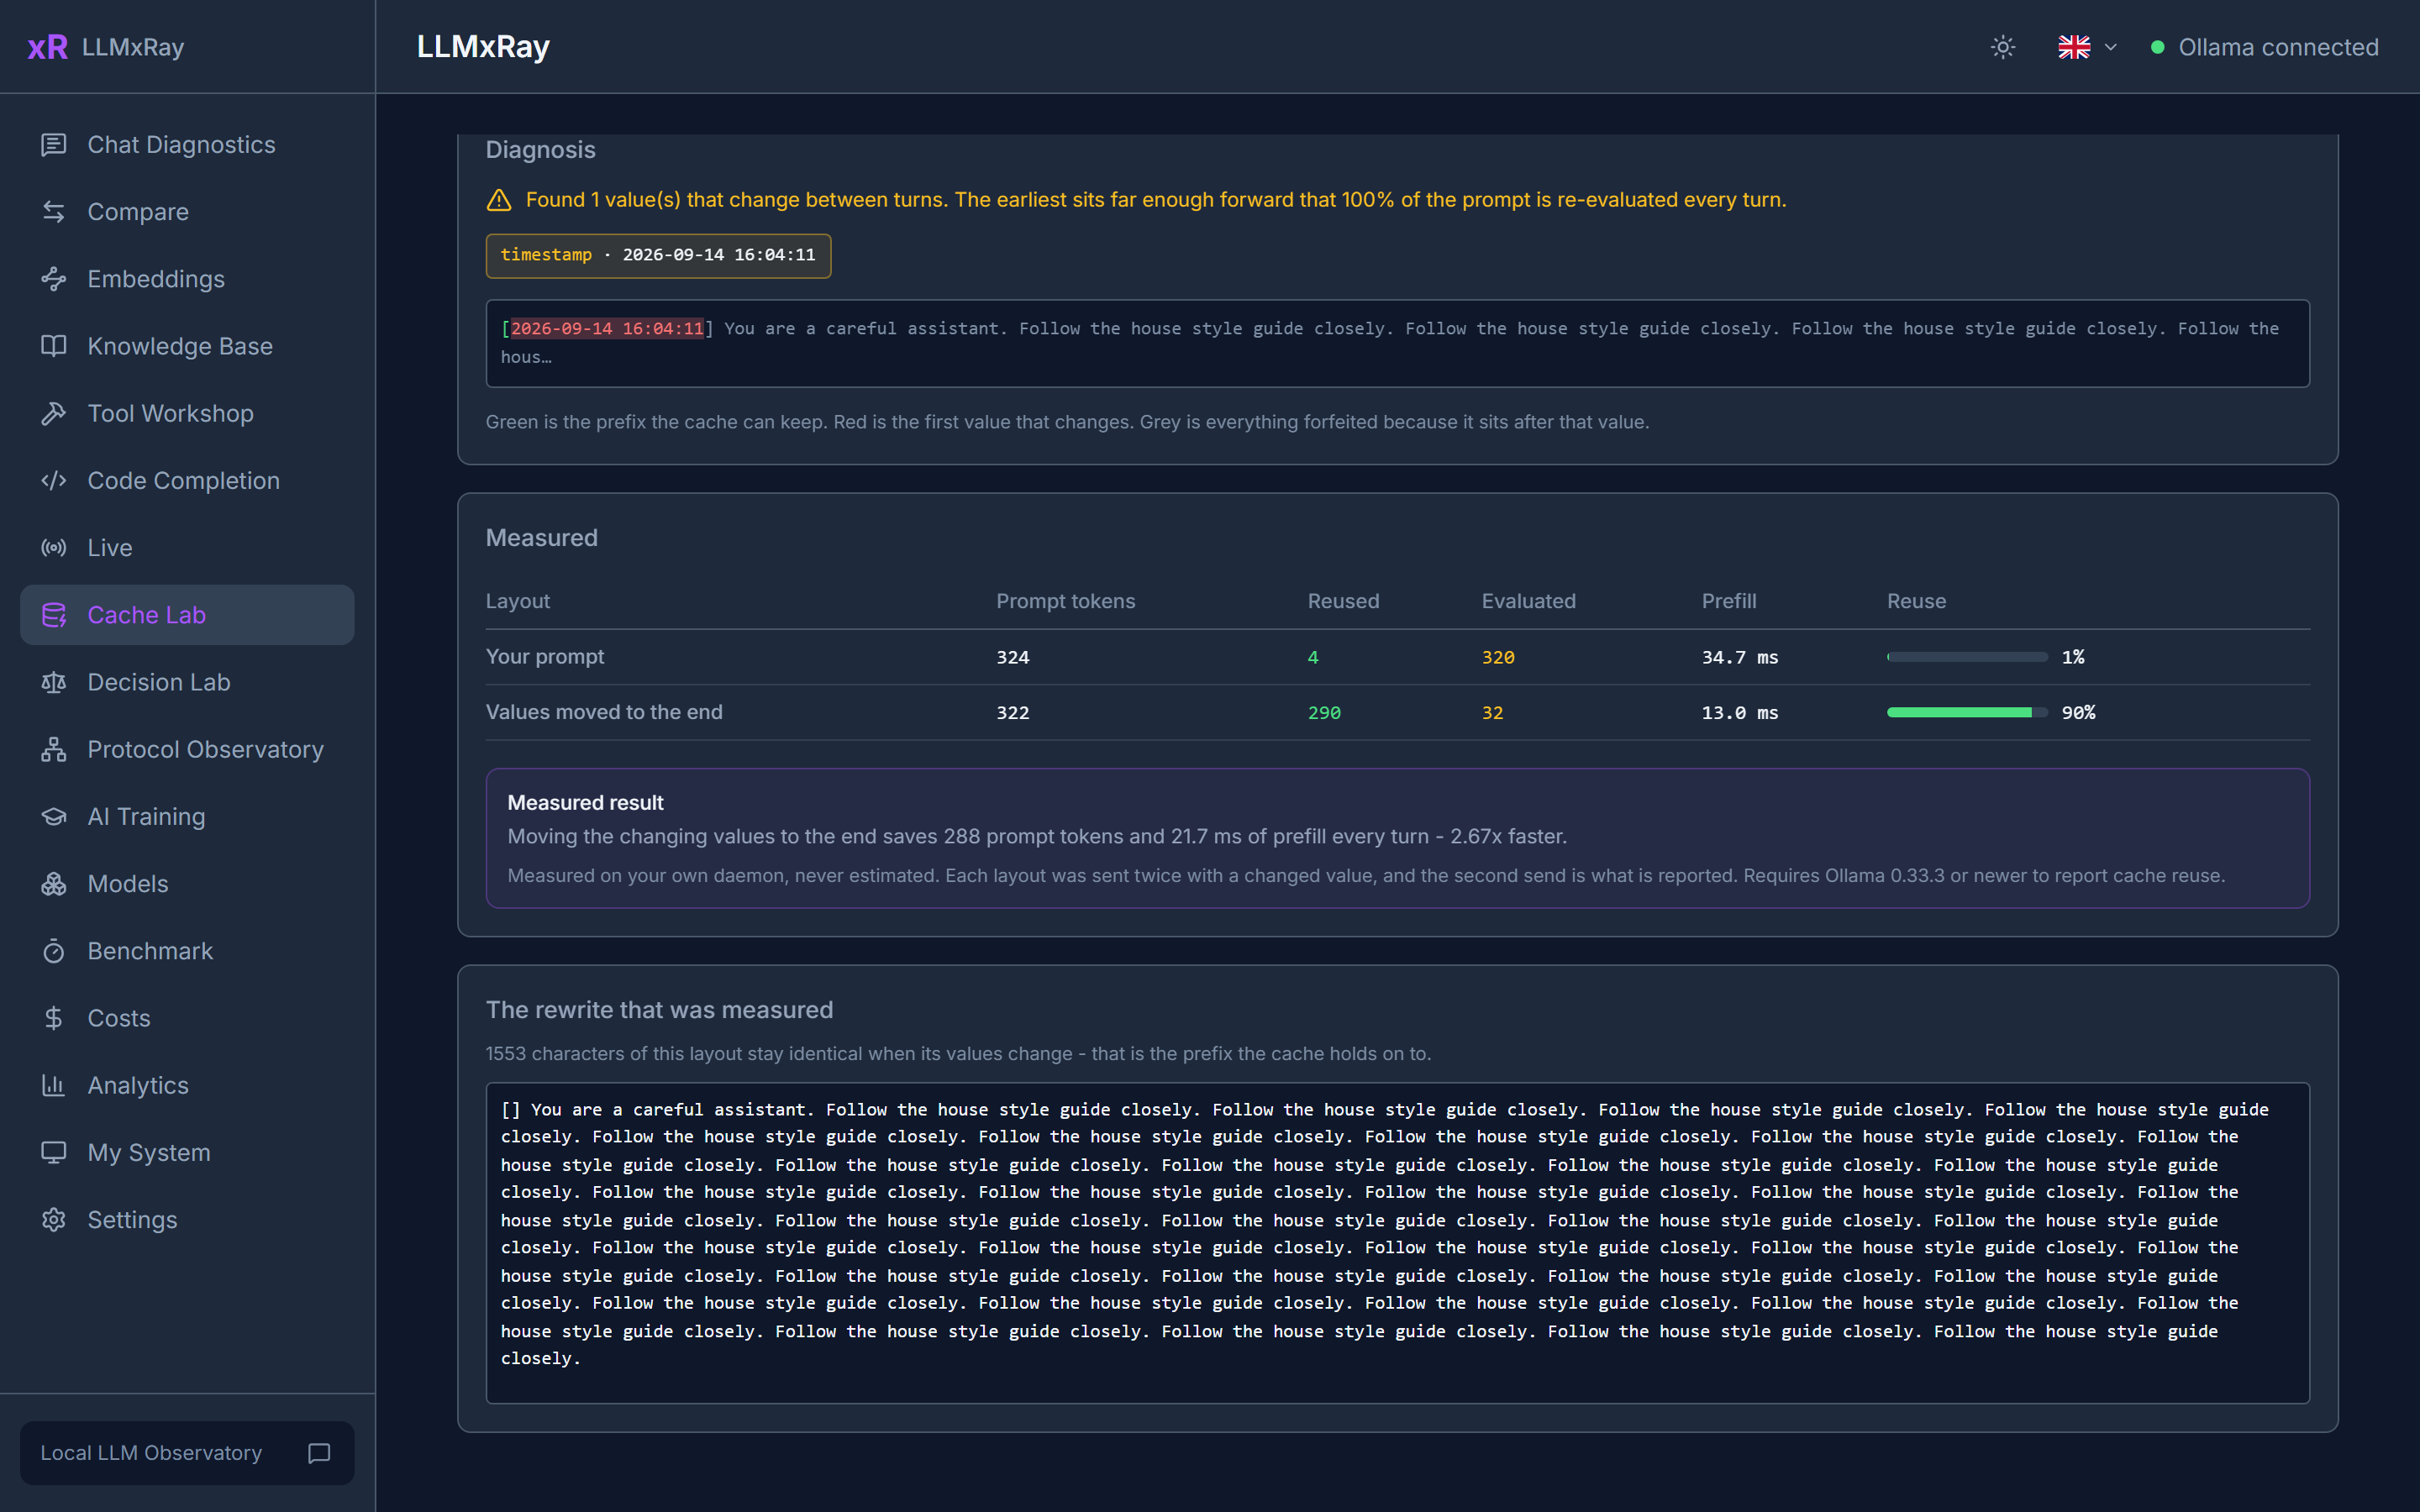
実際の 324 トークンのプロンプトで測定した結果:タイムスタンプが先頭にある場合は 4 トークンを再利用し、プレフィルに 64.6 ms かかりました。末尾にある場合は 290 トークンを再利用し、18.6 ms かかりました。3.5 倍高速で、文言は同じです。
Protocol Observatory
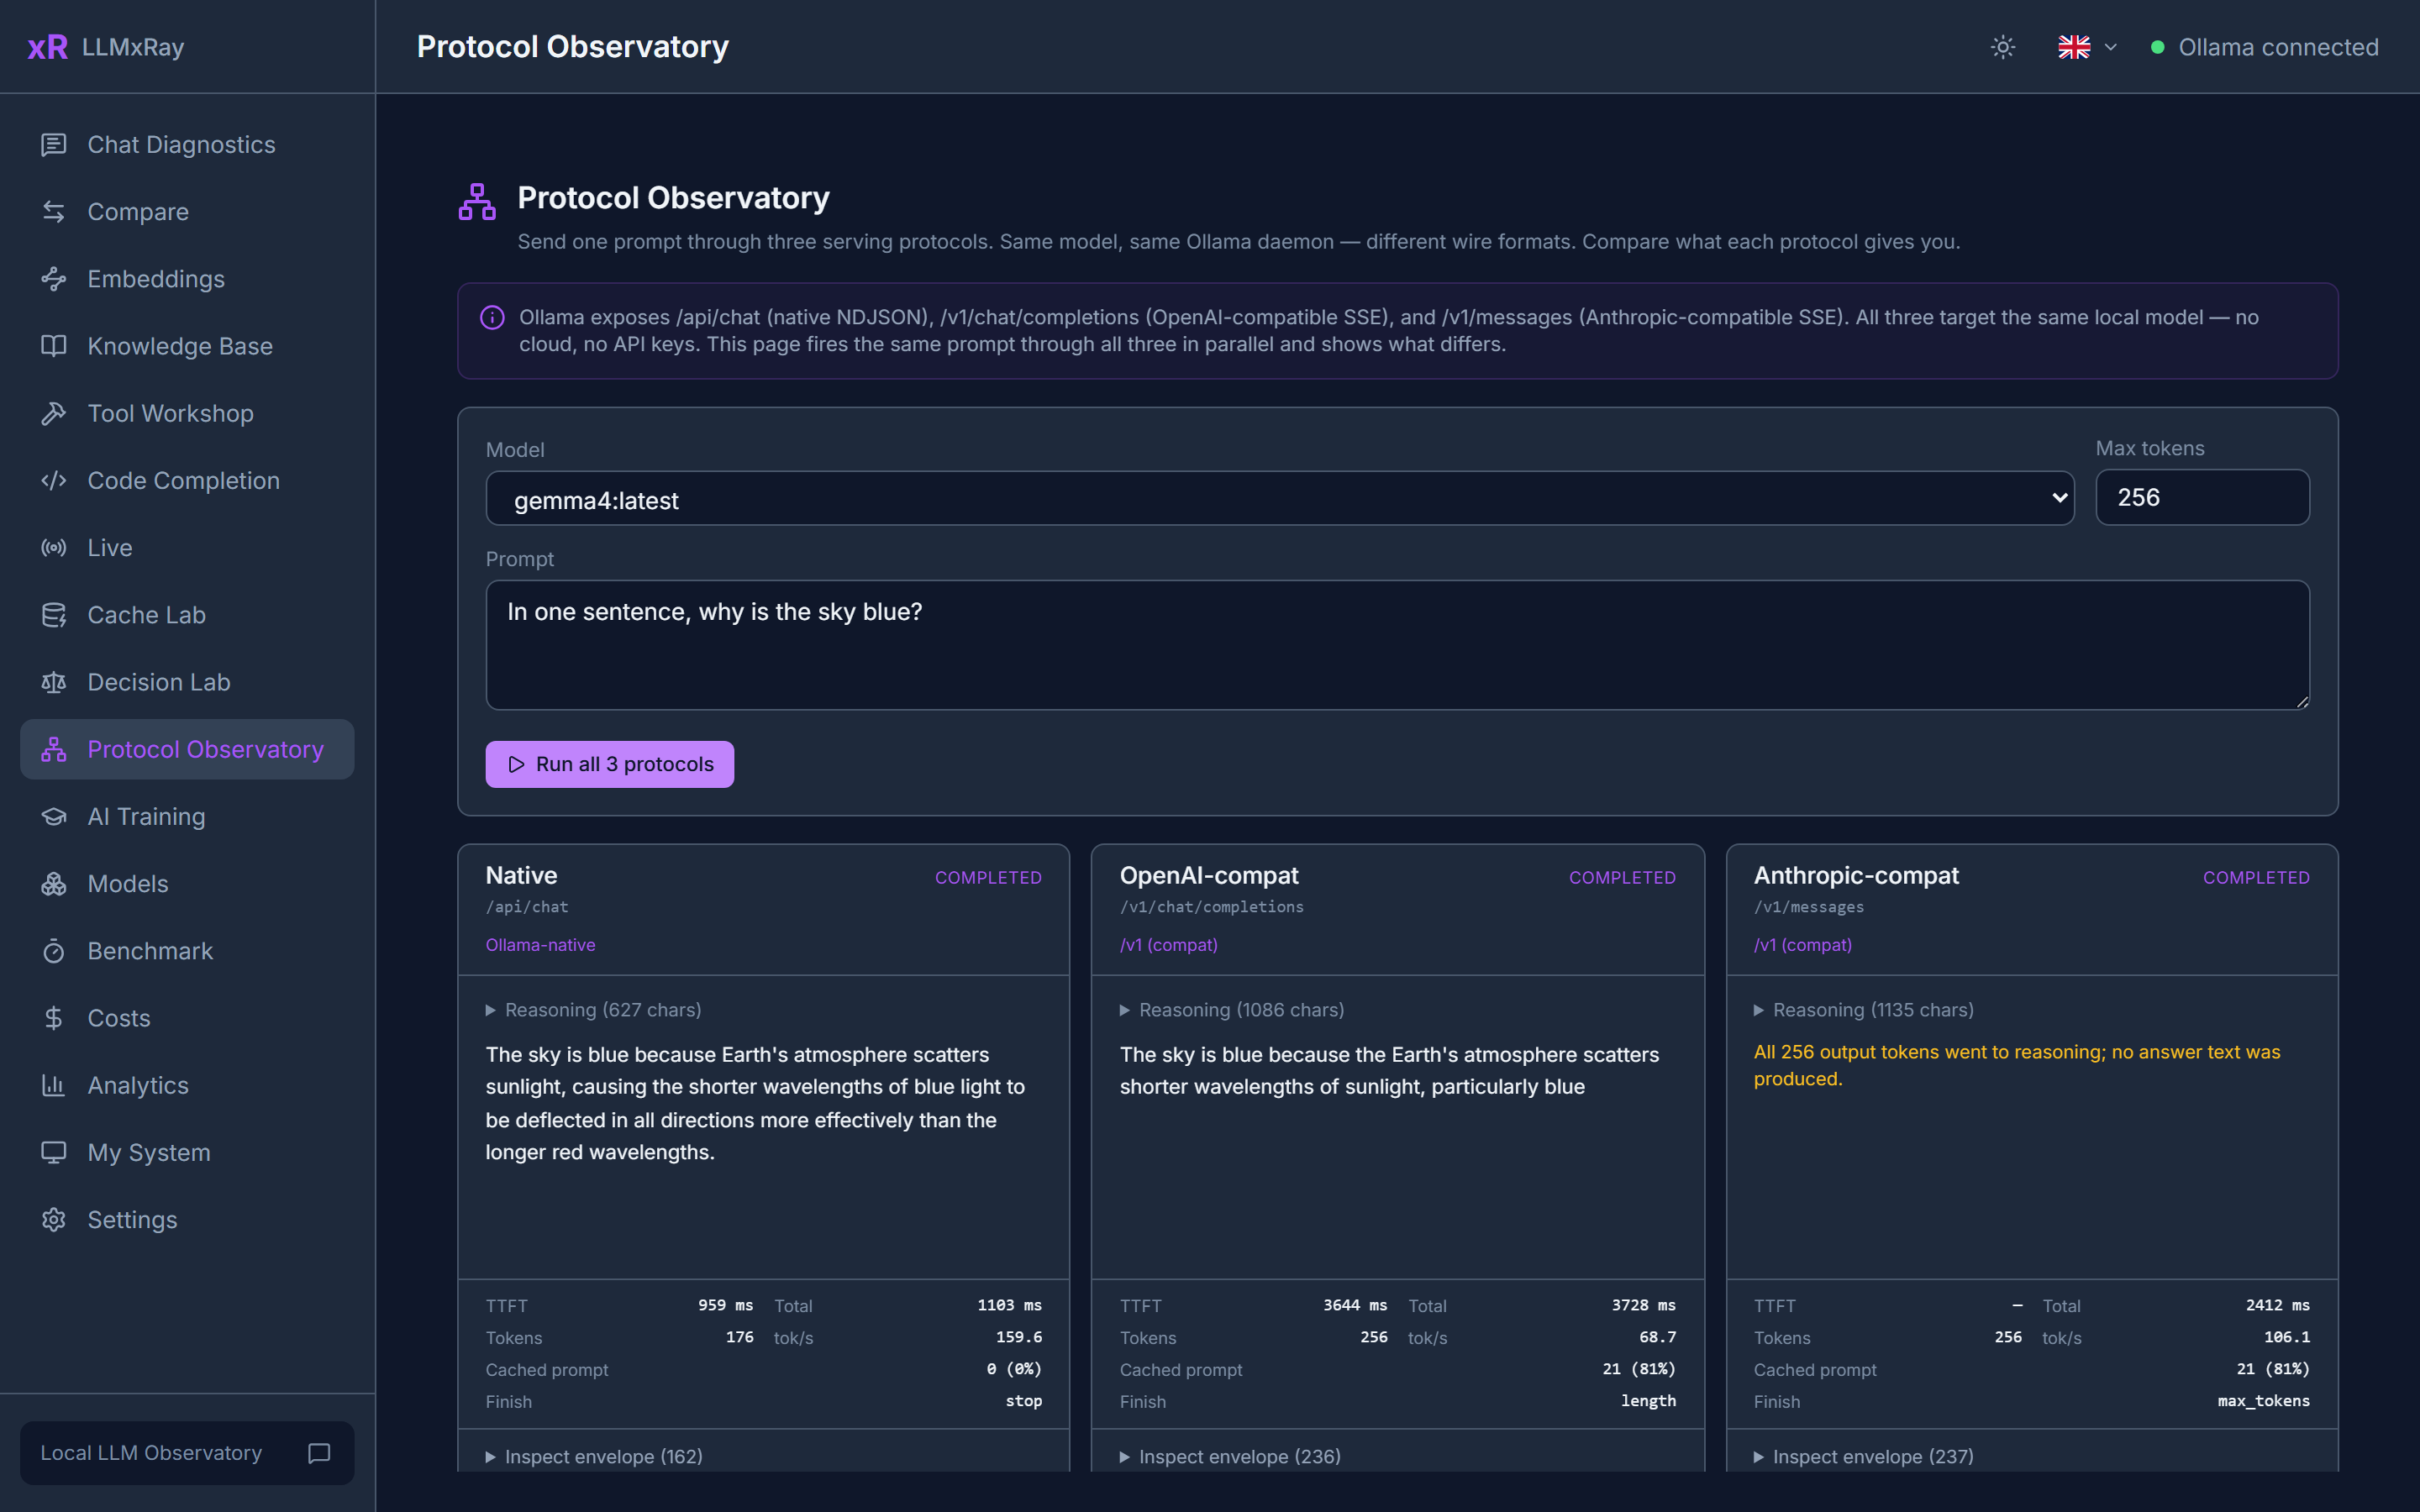
Ollama の 3 つのサービングプロトコル(ネイティブの /api/chat、OpenAI 互換の /v1/chat/completions、Anthropic 互換の /v1/messages)を通じて、同じプロンプトを並行して実行します。ストリーミングの並列表示、プロトコルごとのメトリクス、終了理由・トークン数・エラーを各プロトコルがどのように表現するかを示すエンベロープの差分を確認できます。
記録を保持し、送信する
各ターンの記録(トークン数、キャッシュ、タイミング、クライアント、モデル。テキストは含みません)は30日間マシン上に保持されるため、再起動後も中断したところから再開できます。Live、Runs、Prompt X-ray、MCP ツールは、何事もなかったかのように動作を続けます。
チームですでにトレースを確認している場合は、ターンをそこに送信できます。各モデル呼び出しは、ビューアーがすでに読み取れる GenAI 属性を持つ OpenTelemetry スパンになり、各実行はトレースに、呼び出し間のツール処理時間は独立したスパンになります。Runs と同じウォーターフォール表示です。Live ページでアドレスを設定するか、OTEL_EXPORTER_OTLP_ENDPOINT を設定してください。
| ビューアー | アドレス |
|---|---|
Jaeger (docker run -p 16686:16686 -p 4318:4318 jaegertracing/jaeger) | http://localhost:4318 |
Arize Phoenix (docker run -p 6006:6006 arizephoenix/phoenix) | http://localhost:6006 |
| Langfuse | https://cloud.langfuse.com/api/public/otel。キーを使った Basic ヘッダーが必要です |
| Grafana Tempo、OpenTelemetry Collector | OTLP HTTP アドレス。通常はポート4318です |
プロンプトテキストが送信されるのは、プロンプトテキストを保持 と 各スパンにプロンプトテキストを含める の両方を有効にした場合のみです。
エージェント向け
ローカルモデル上で動作するエージェントの場合、LLMxRay は自身の呼び出しで何が問題だったかを特定できます。手順は2つです。
- Ollama の呼び出し先を11434ではなく11435にします。Ollama とまったく同じように動作し、すべてを転送します。LLMxRay は通過するデータを記録するだけです。
- LLMxRay MCP サーバーをツールに追加します。
{ "mcpServers": { "llmxray": { "command": "npx", "args": ["-y", "-p", "llmxray", "llmxray-mcp"] } } }
7つのツールはすべて読み取り専用で、マシン外にデータが送信されることはありません。
| ツール | 回答内容 |
|---|---|
diagnose_my_turns | 最近のターンで目立つ点を、修正方法とともに文章で示します。読み込まれたコンテキストを超過して拒否されたプロンプト、毎ターンまたは特定のターンで失われたプロンプトキャッシュ、一部が CPU で実行されているモデル、プロンプトを圧迫しているツールスキーマなどを確認できます。 |
read_my_last_turn | 直近のターンの数値を示します。プロンプトトークン数とキャッシュされた割合、プレフィル時間と速度、生成トークン数と速度、生成が停止した理由、プロンプトの構成、モデルがビデオメモリに収まったかどうかを確認できます。 |
list_local_models | 取得済みモデルとそのサイズ、量子化方式、現在読み込まれているモデルとそのコンテキスト、各モデルがビデオメモリに収まるかどうかを示します。 |
list_my_turns | 履歴を表示します。各ターンのトークン数、キャッシュされた割合、プレフィル、生成速度、停止理由、フラグを1行ずつ示します。 |
compare_my_turns | 変更に効果があったかを確認します。変更前後のキャッシュされた割合、プレフィル、速度、プロンプトサイズの中央値と判定を示します。 |
estimate_my_prompt | 送信前に、Nトークンのプロンプトが読み込み済みのコンテキストに収まるか、どれだけ余裕があるか、モデルがビデオメモリに収まっているか、キャッシュでどれだけ再利用できるかを確認します。 |
read_llmxray_status | LLMxRay の実行場所、監視ポート、転送先の Ollama、保持しているターン数を示します。 |
LLMxRay 自体が実行中である必要があります(npx llmxray)。MCP サーバーは localhost 経由で LLMxRay からデータを読み取ります。
同じ手順をエージェントスキルとして読み込むこともできます。npx skills add LogneBudo/llmxray(skills.sh)または clawhub install llmxray-diagnose-ollama-calls(ClawHub)を実行します。ソース:skills/diagnose-ollama-calls/SKILL.md。
ターンを自分のものとして識別できるよう、名前を設定してください。ヘッダー X-LLMxRay-Client: my-agent を送信するか、ベース URL に http://localhost:11435/?client=my-agent を使用し、ツールの client に my-agent を渡します。ベース URL の設定場所:Ollama SDK と CLI では OLLAMA_HOST=127.0.0.1:11435、OpenAI 互換クライアントでは base_url=http://localhost:11435/v1、Claude Code では ANTHROPIC_BASE_URL=http://localhost:11435、Continue では apiBase、Open WebUI では OLLAMA_BASE_URL です。
ほかにも使える機能
ローカルモデルを実行し、それとチャットします。LLMxRay は、その次に浮かぶ疑問に答えます。各トークンの生成速度、プロンプトのコスト、キャッシュの効果、どの設定が実際に優れていたか、ほかのツールが同じモデルに何を送信しているかを確認できます。
以下の各ページが、それらの疑問への答えです。
チャット、トークンごと
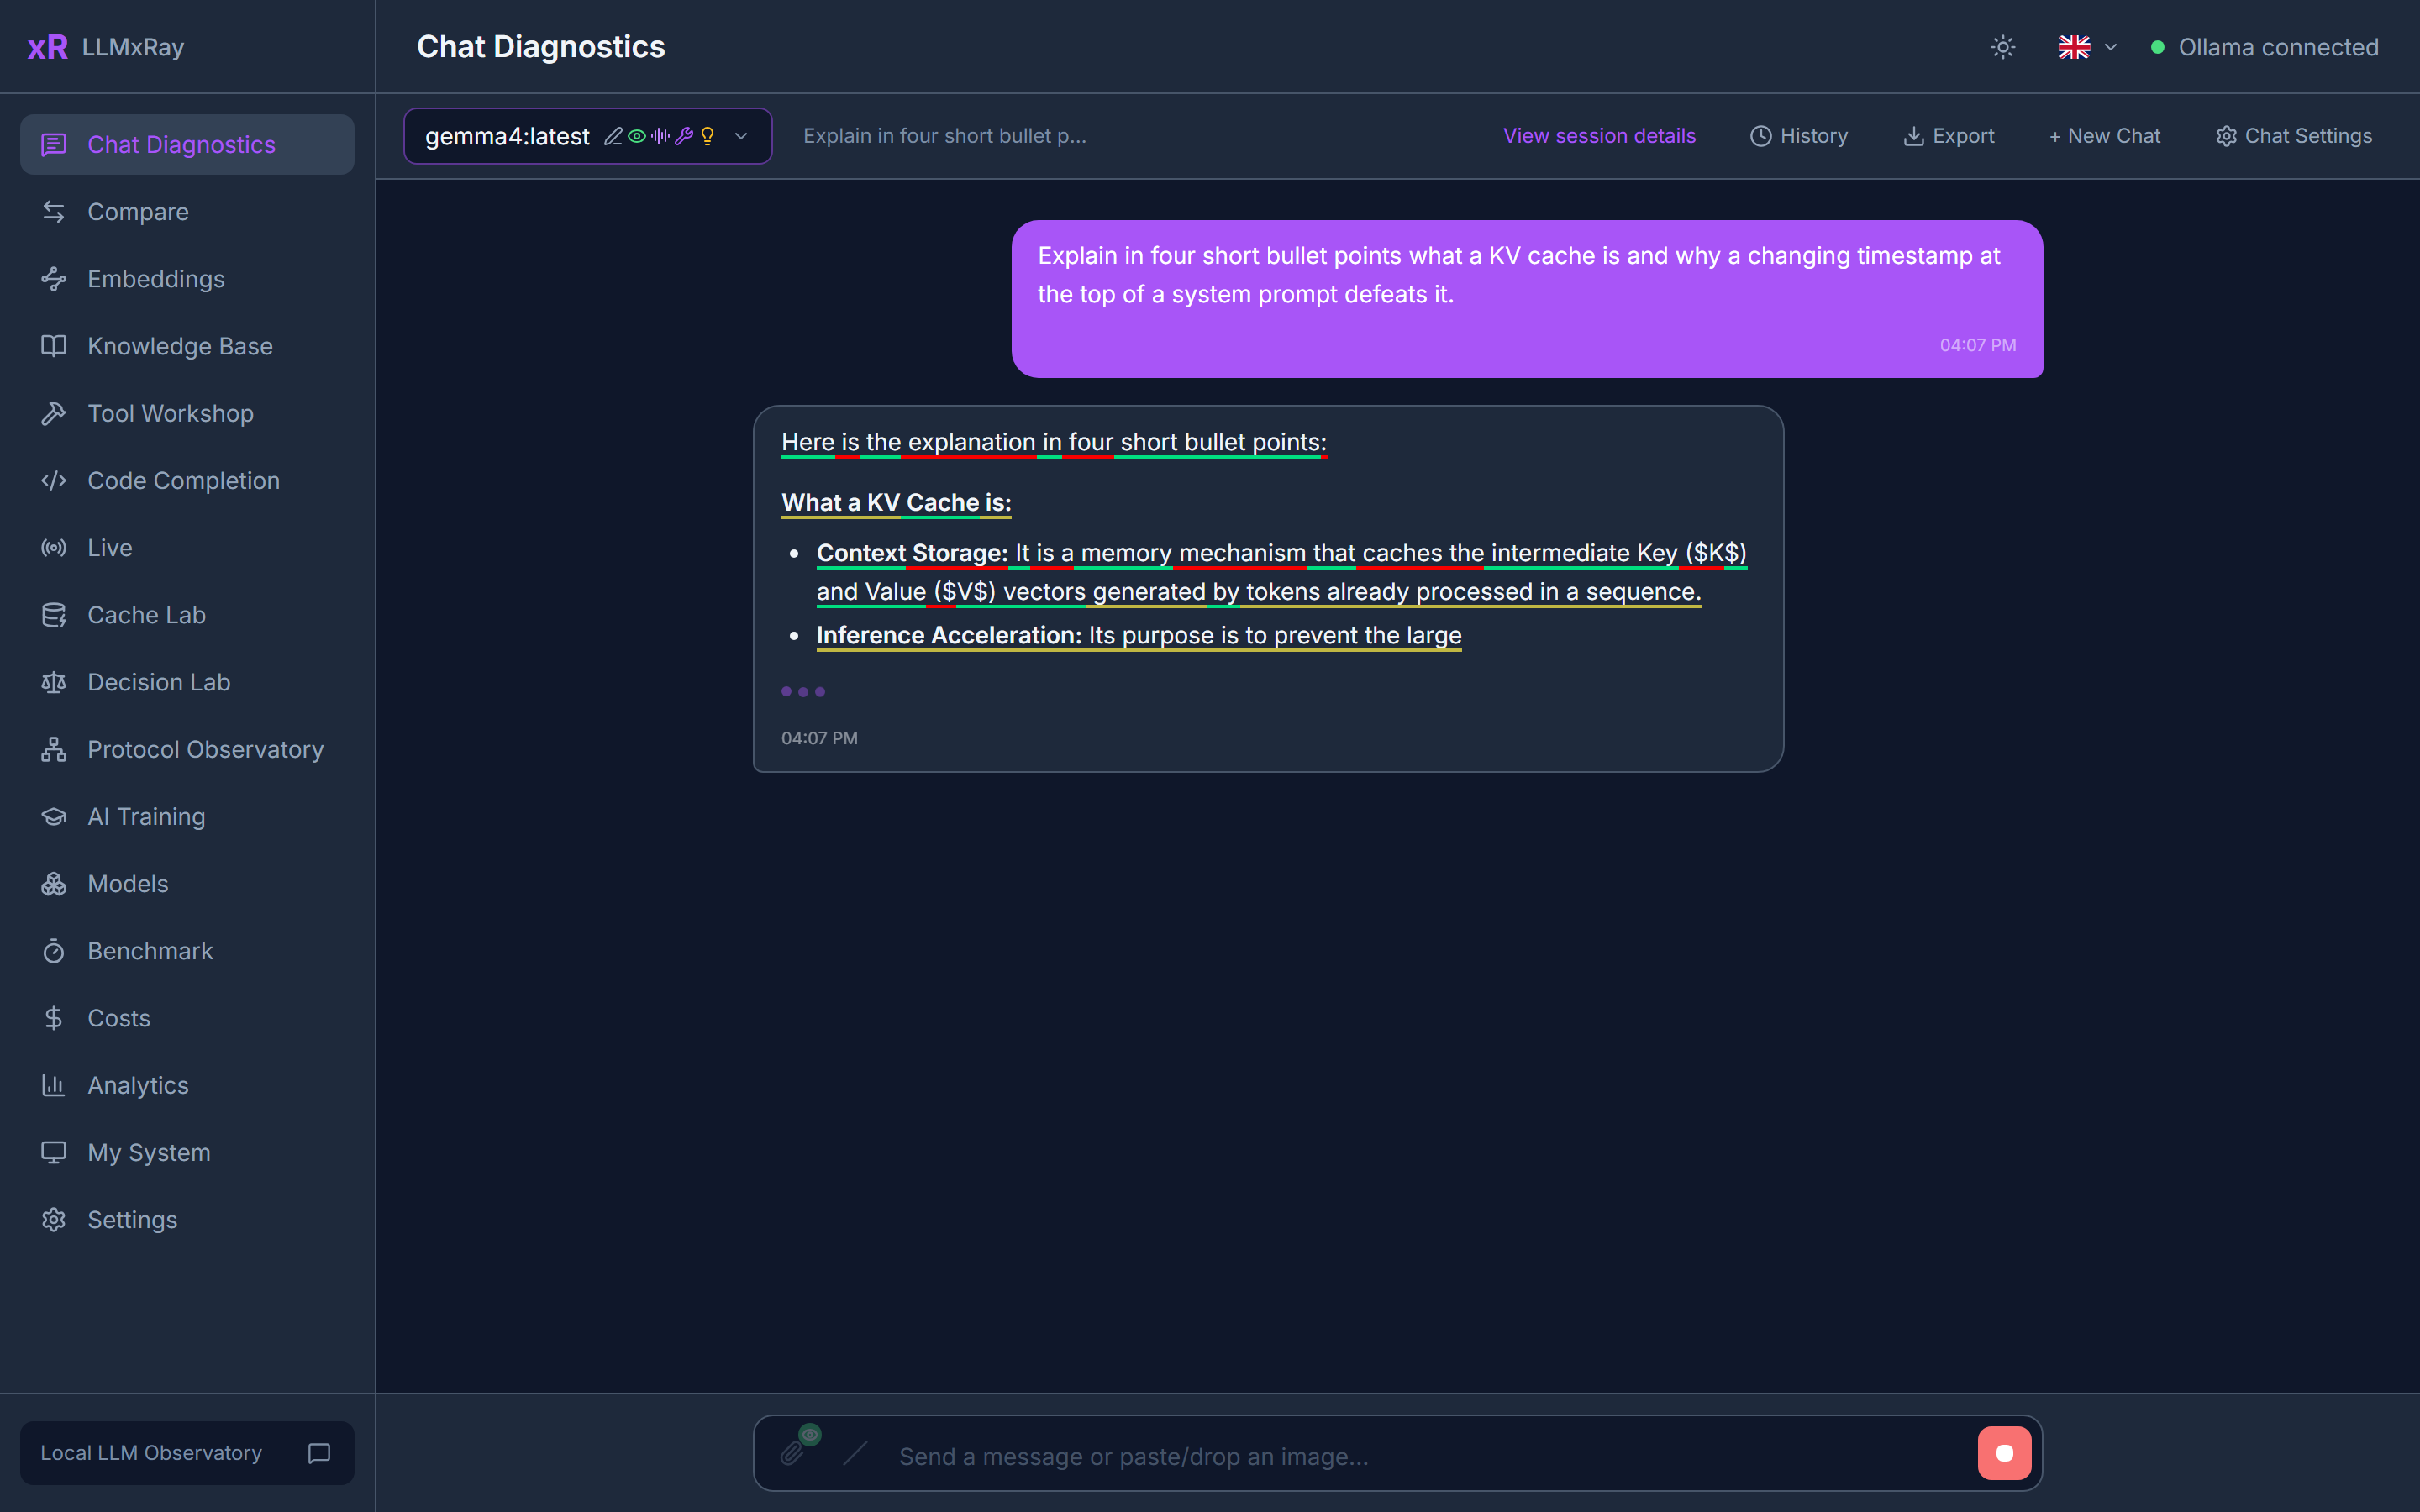
トークンが届くたびに、Ollama の logprobs に基づくモデル自身の確率で色分けして描画します。モデルがどこで迷い、どこで確信していたかを確認できます。Markdown、複数ターン、ファイルと画像の添付、スラッシュコマンド、推論モデル向けの思考バジェット(オフ、モデルに任せる、または低/中/高/最大)に対応しています。
各応答は、届くそばからチェックされます。問題がある場合に限り、バッジが表示されます。繰り返し、拒否、意味不明な文章、空の回答、またはトークン上限による回答の途切れが対象です。
スクリーンショット
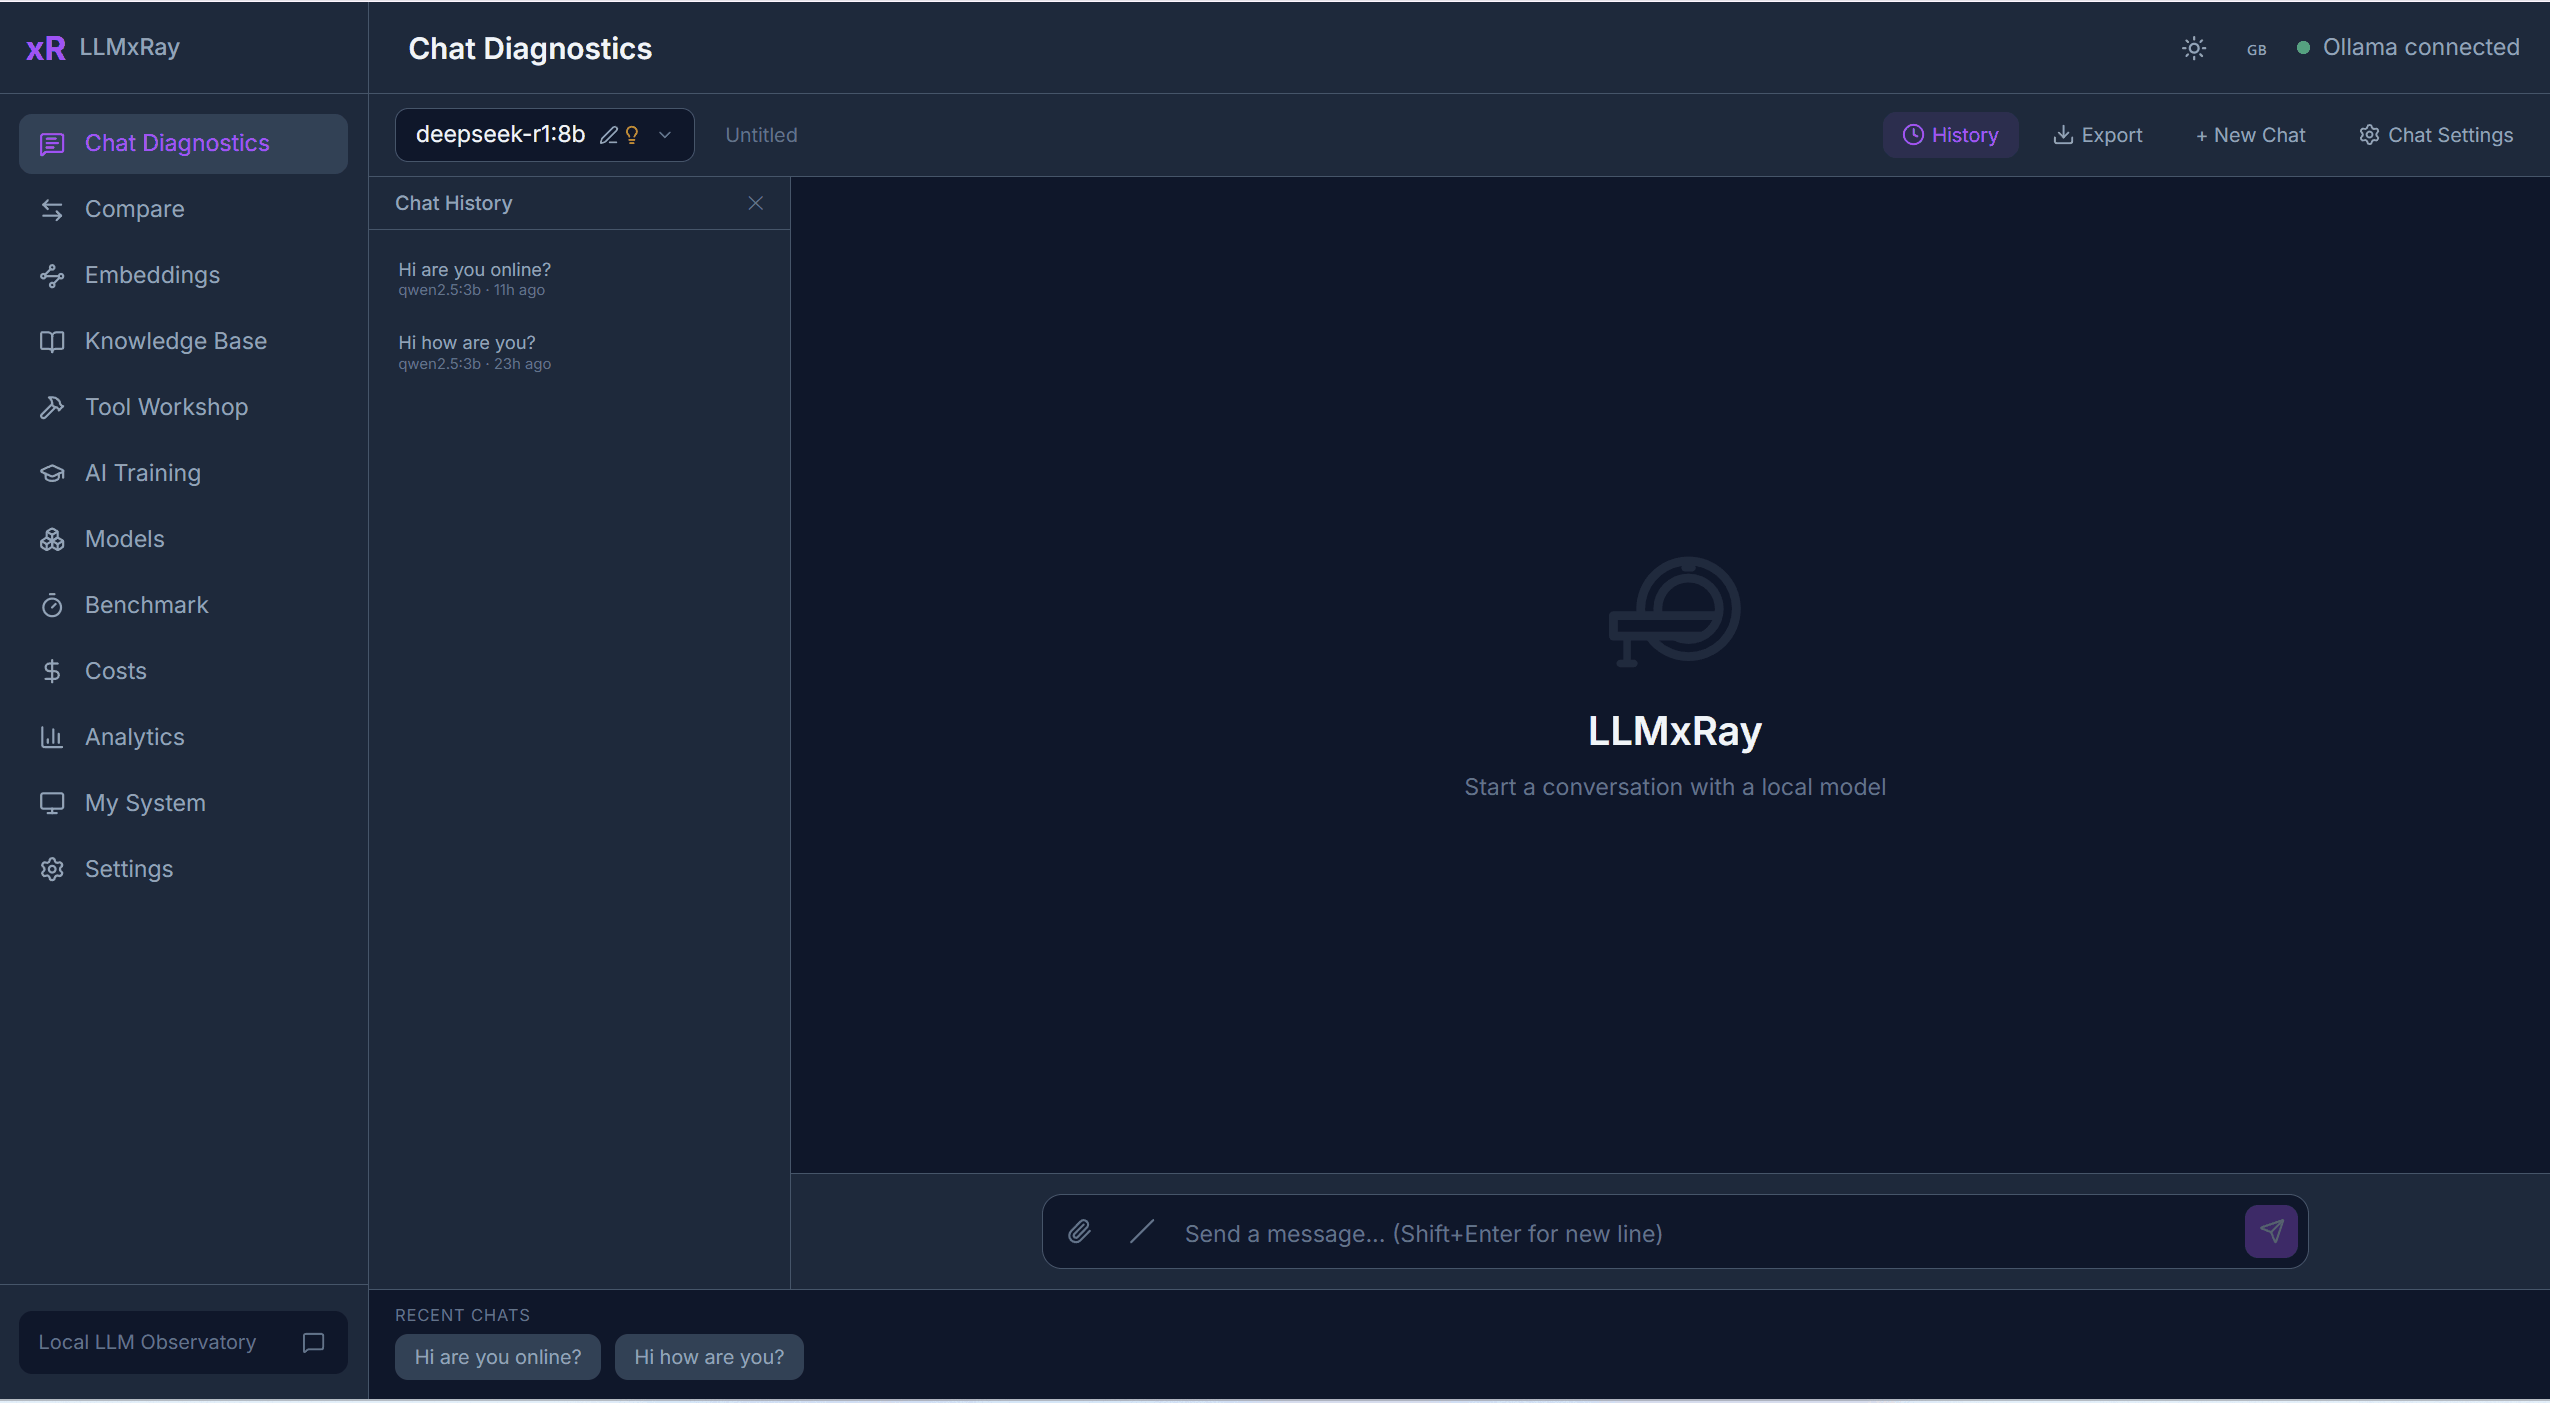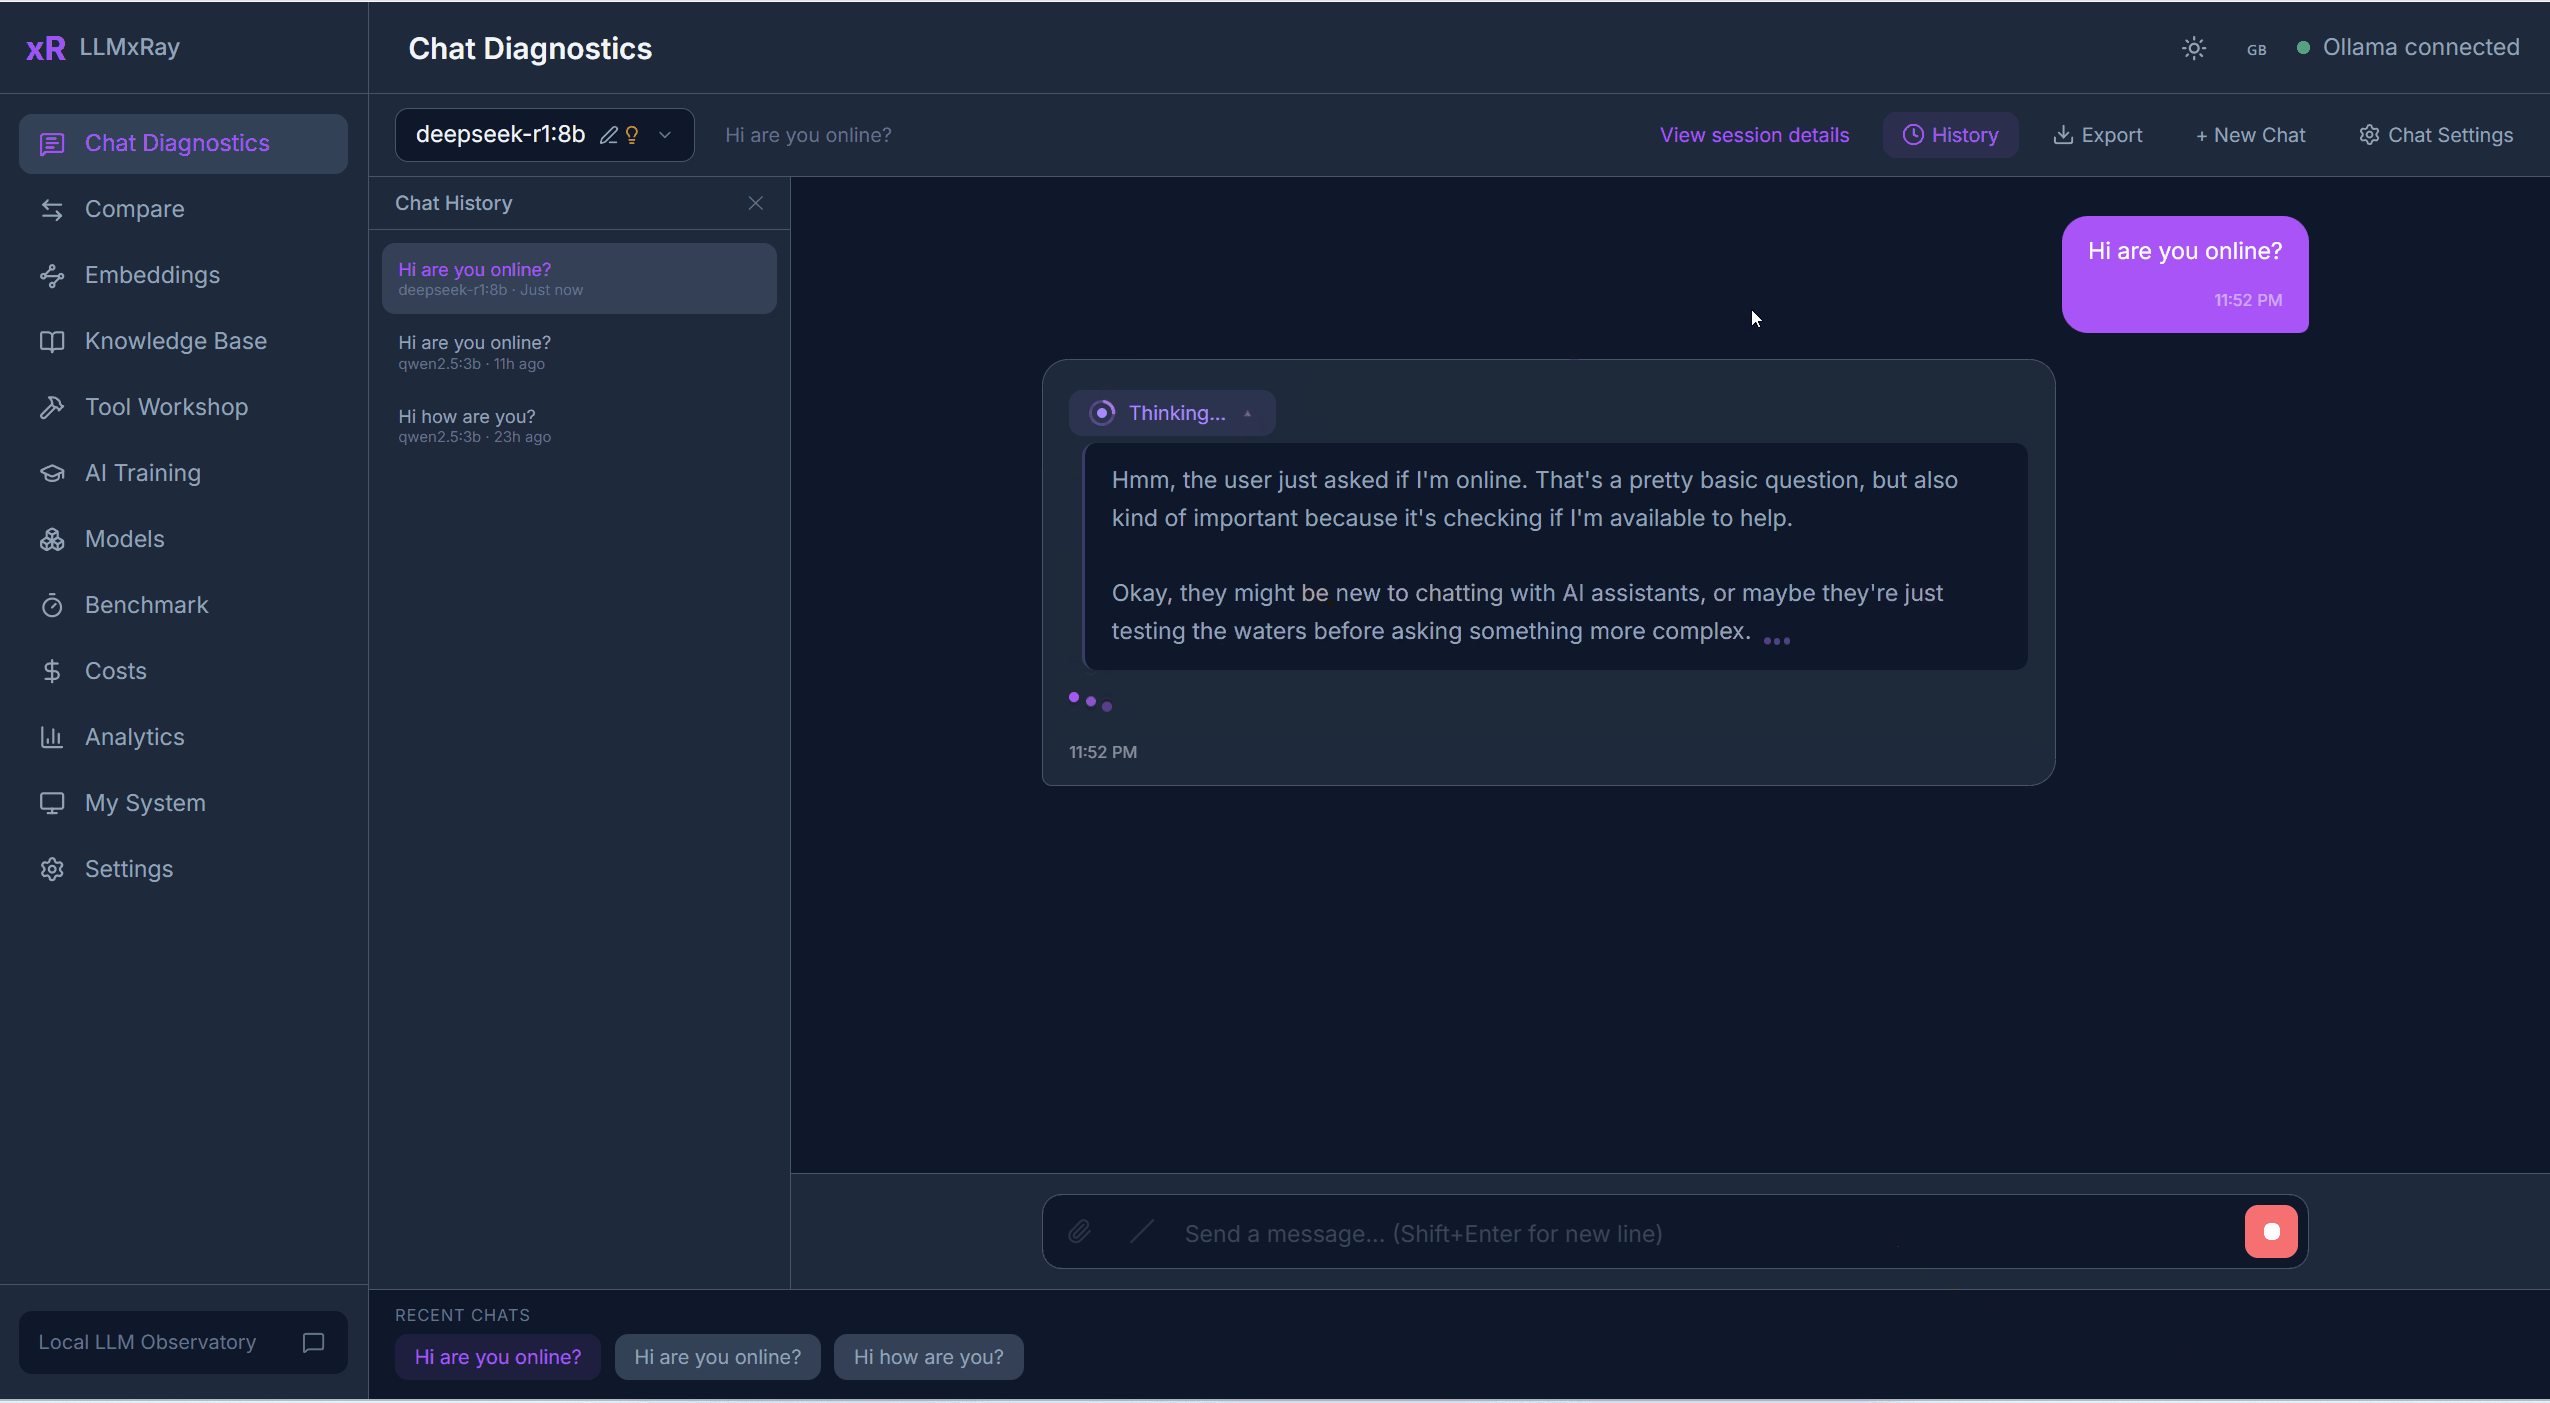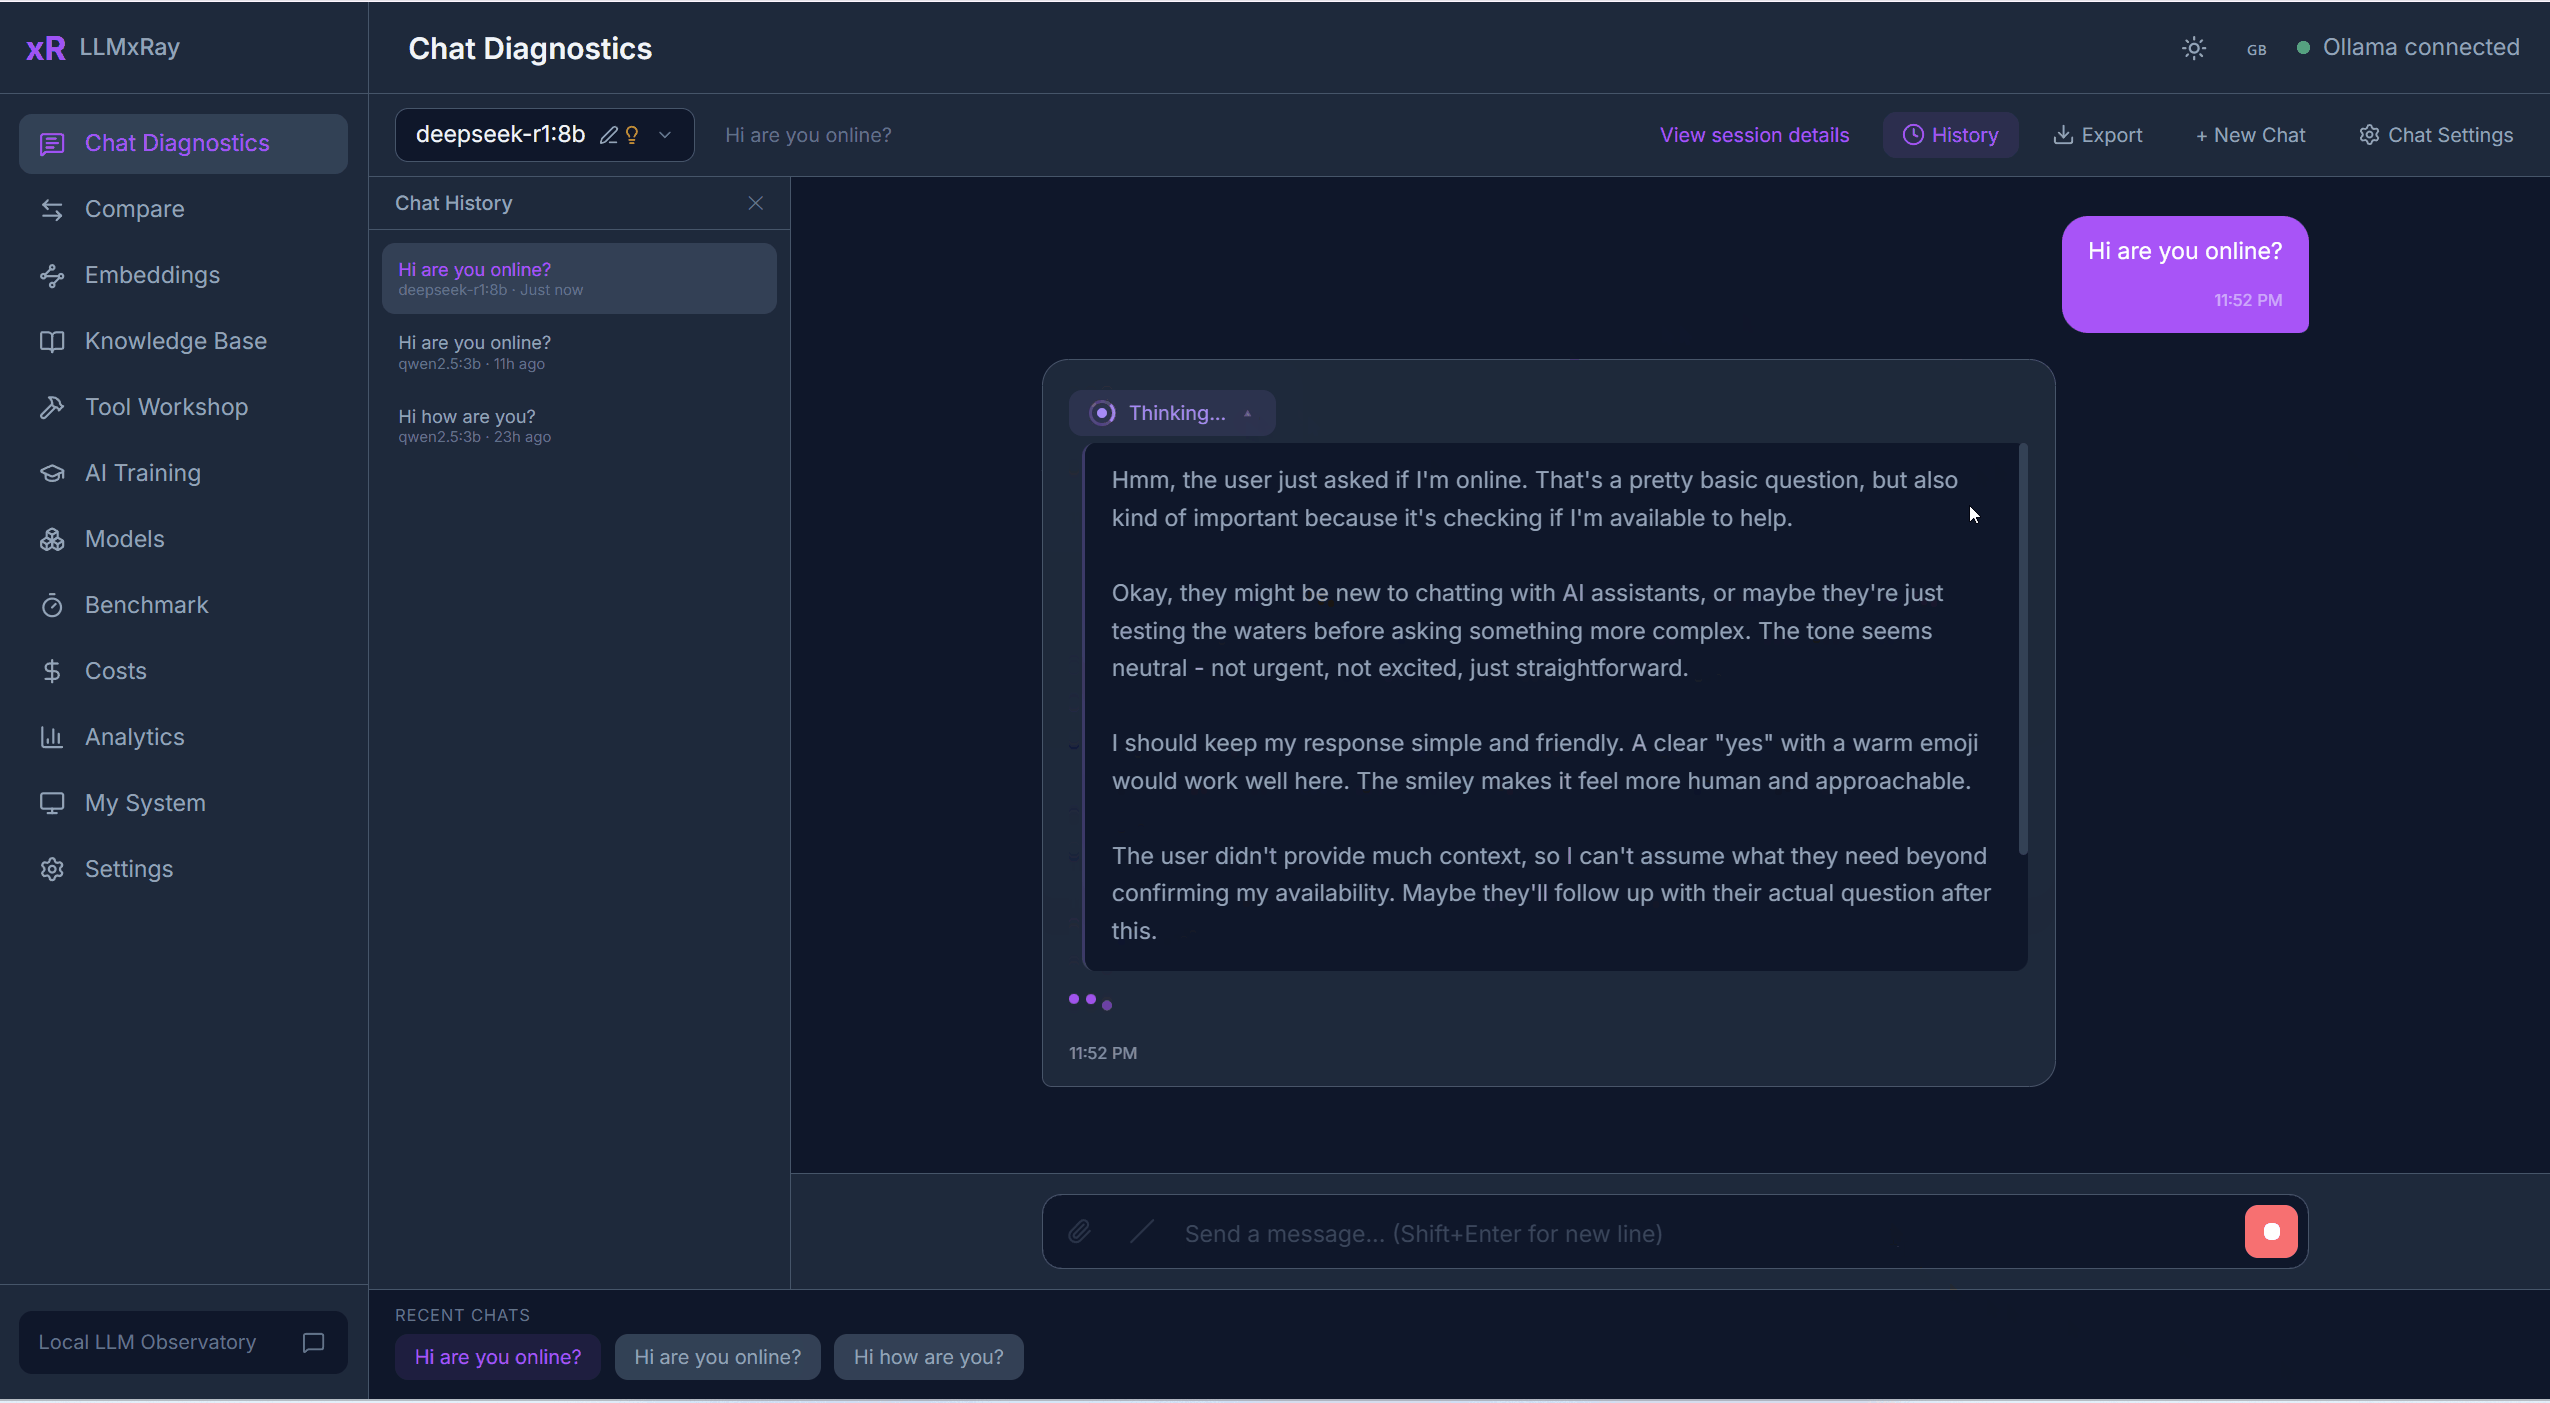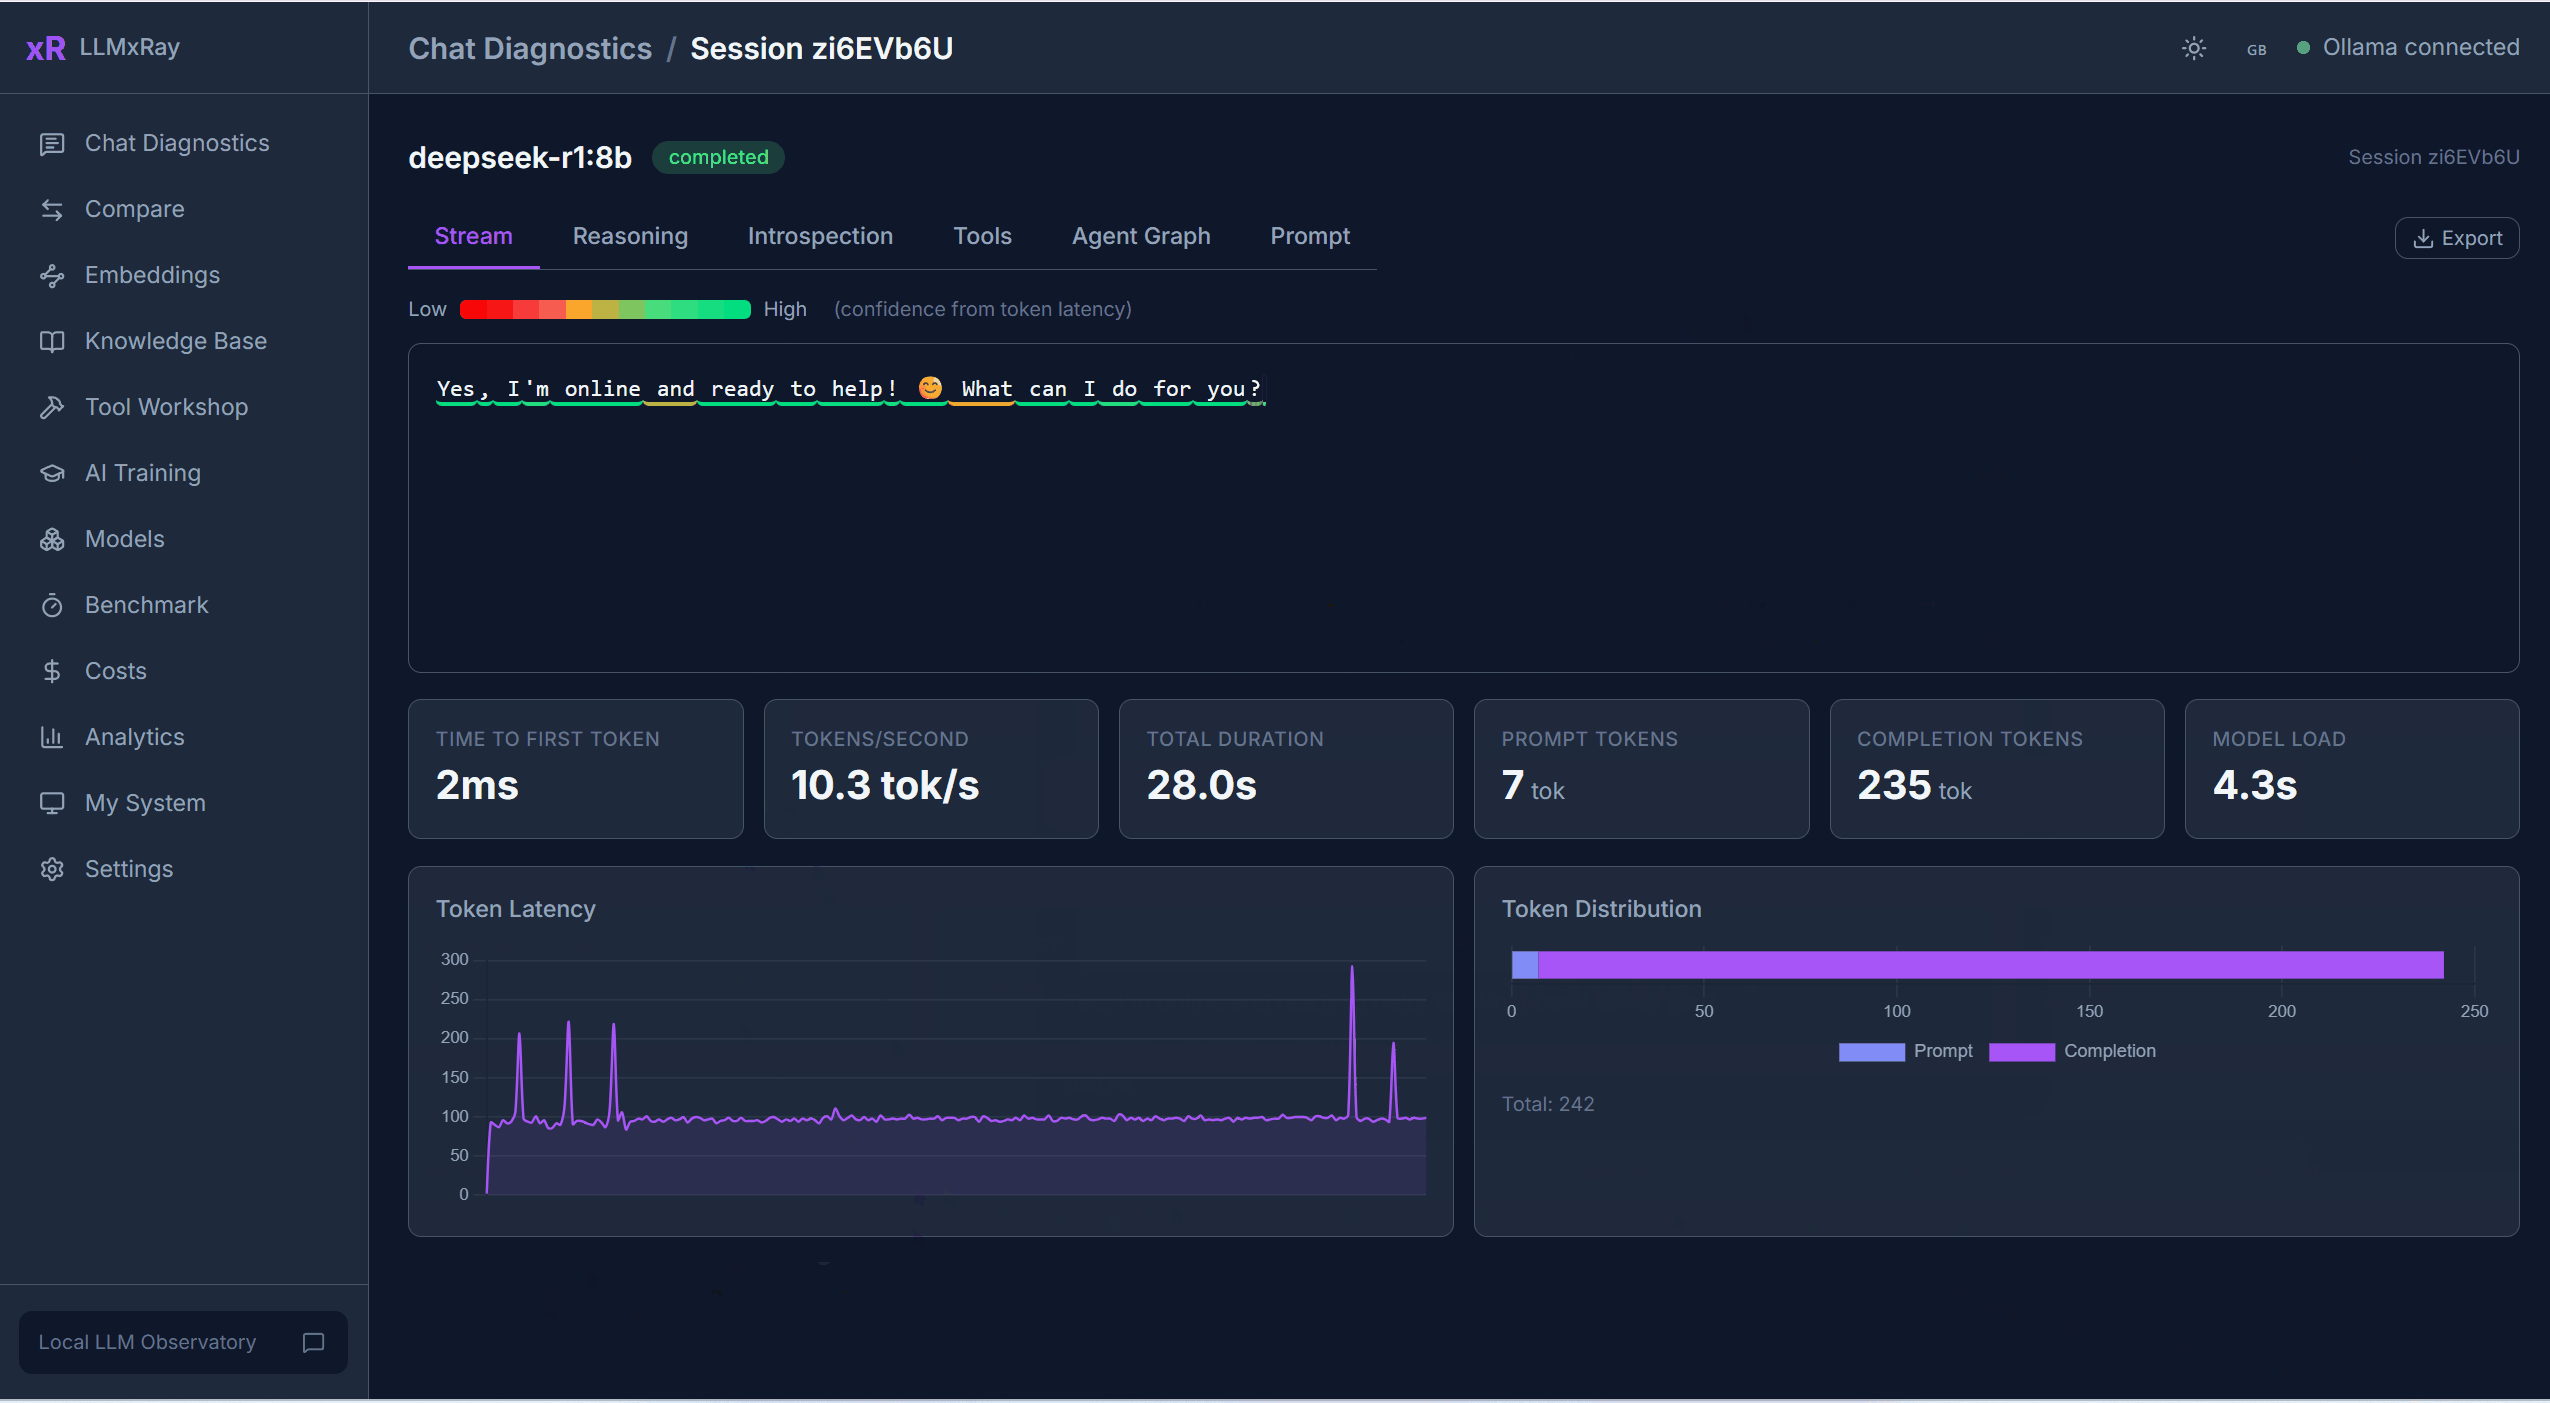
セッションの詳細分析
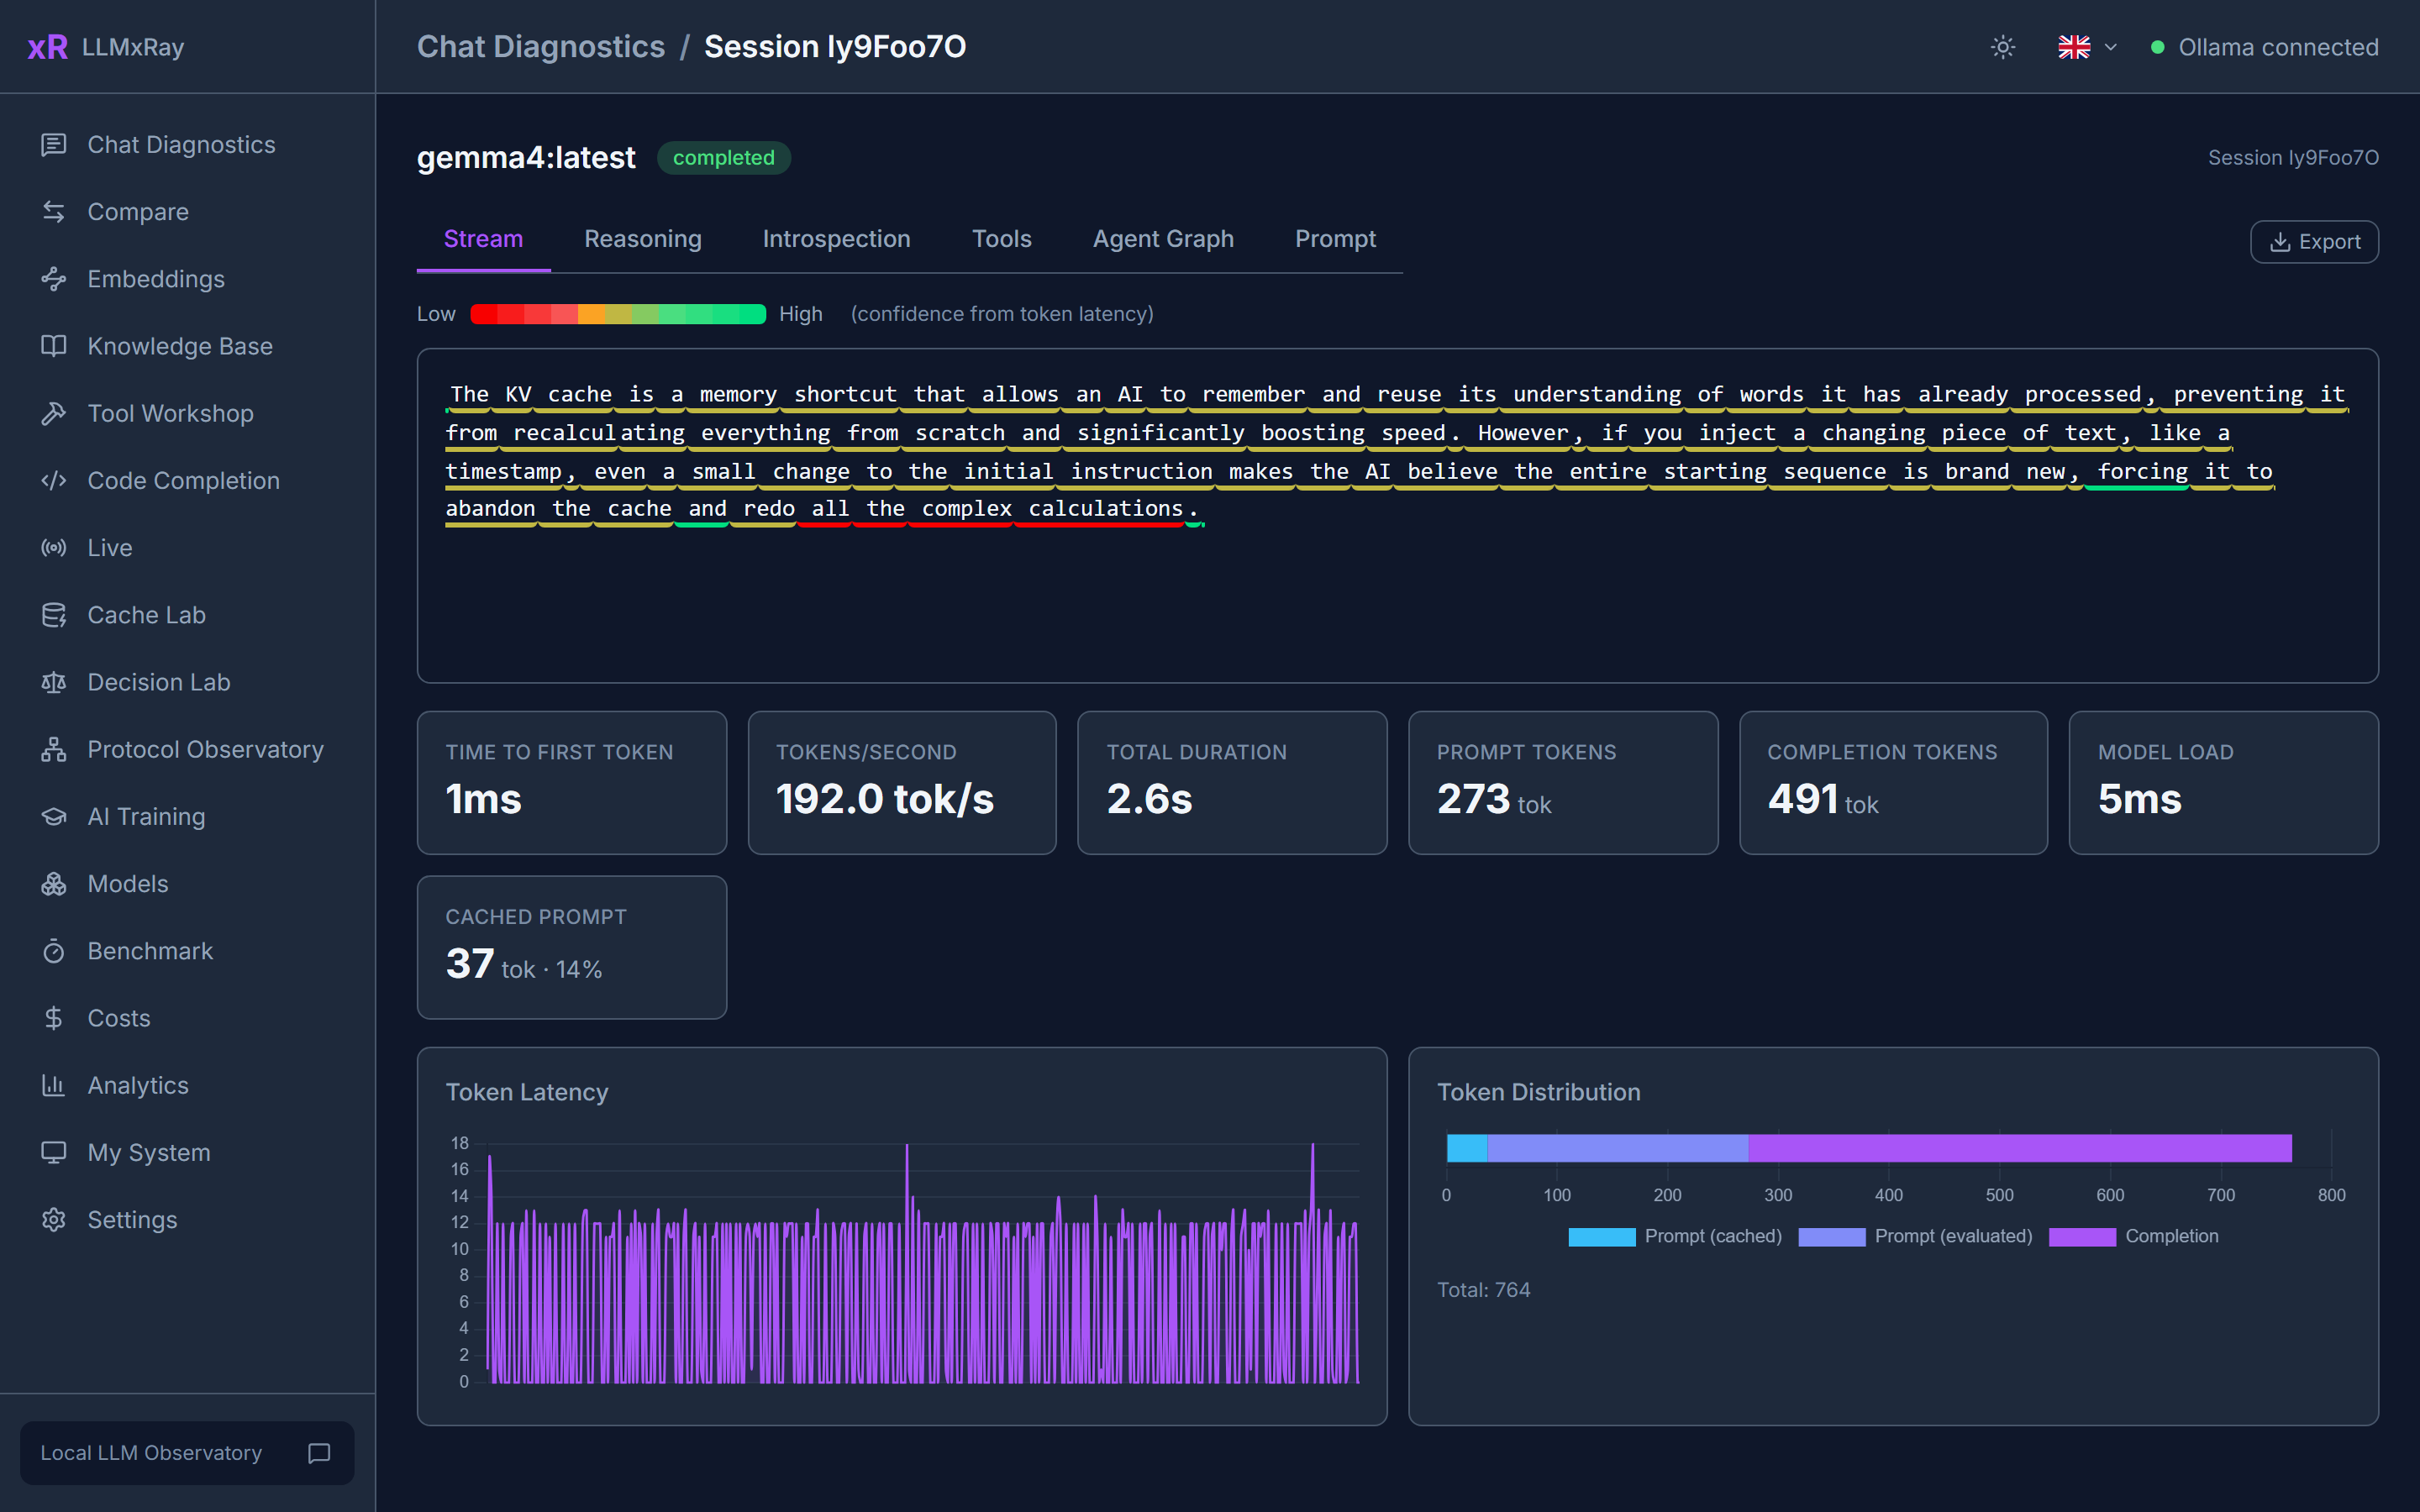
任意のターンを開くと、タイムラインとして確認できます。最初のトークンが出るまでの時間、トークン間の間隔、推論ブロックがあればその内容、ツール呼び出し、送信されたプロンプトを正確に表示します。
スクリーンショット
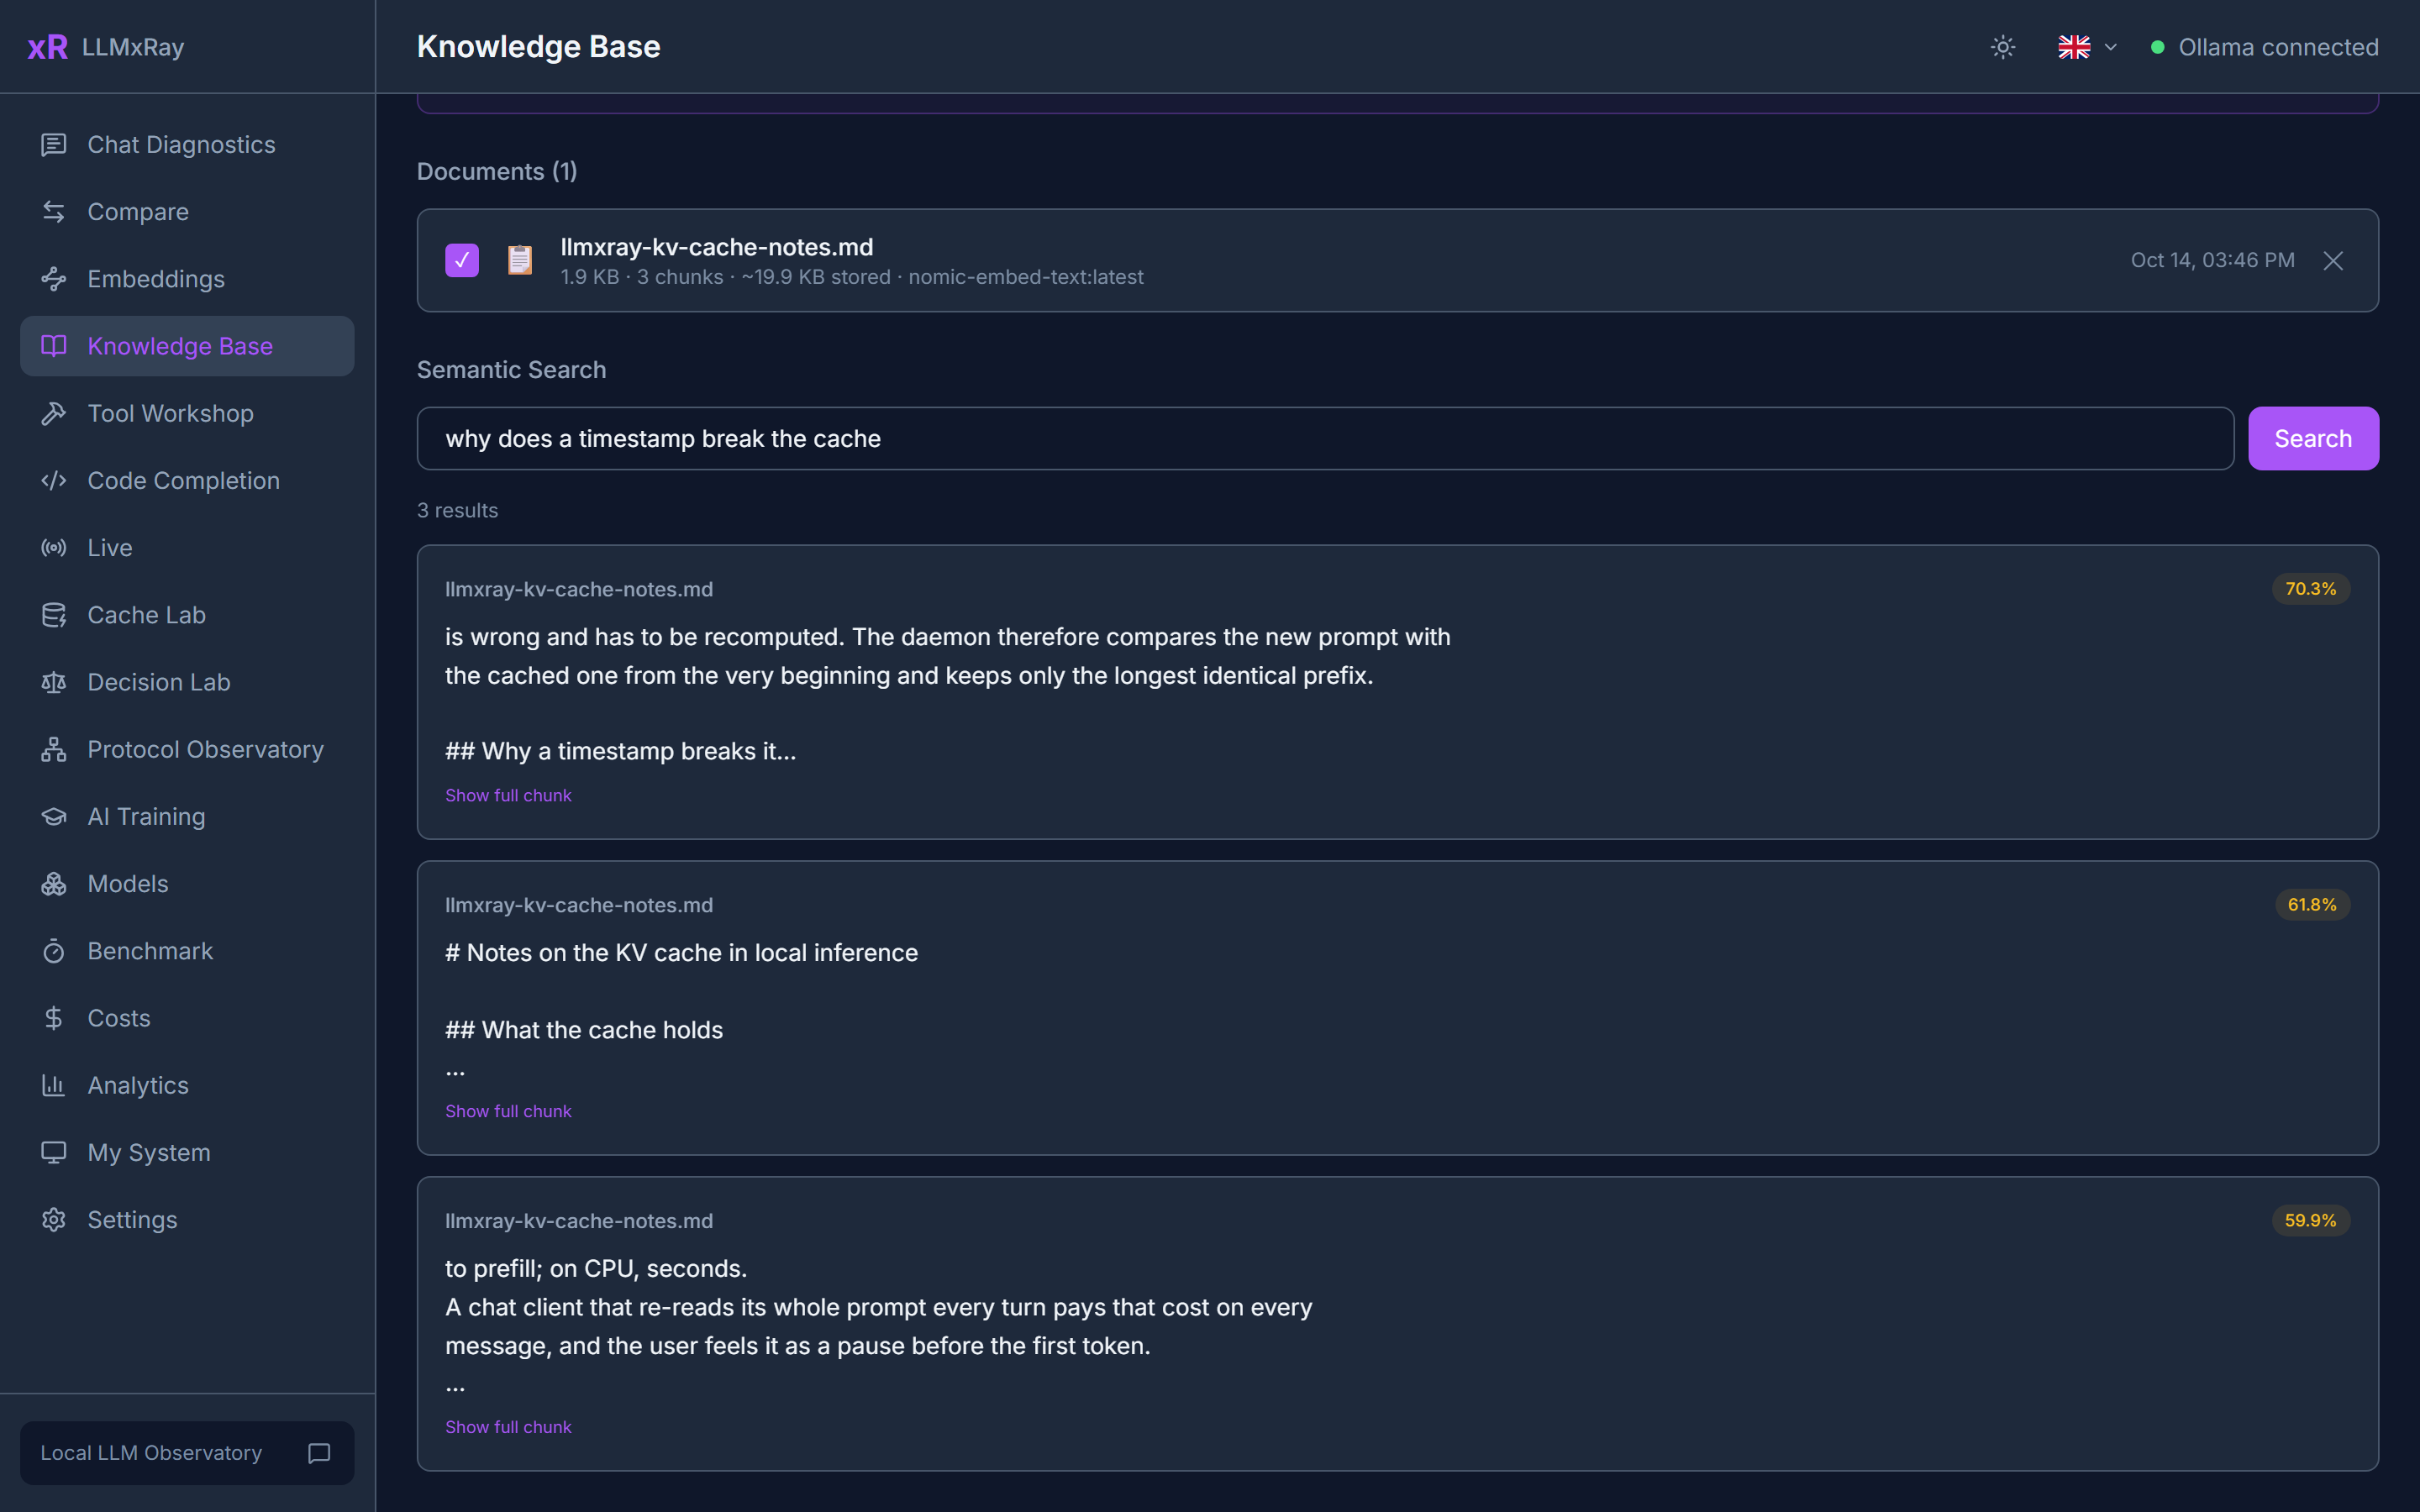
比較
同じプロンプトを最大4つのスロットに入力し、それぞれ異なるモデル、温度、システムプロンプトを設定して並べてストリーミングできます。温度スイープ、決定論的ペア、言語比較のプリセットをワンクリックで適用できます。単語単位の差分で、2つの回答の違いを正確に確認できます。
スクリーンショット
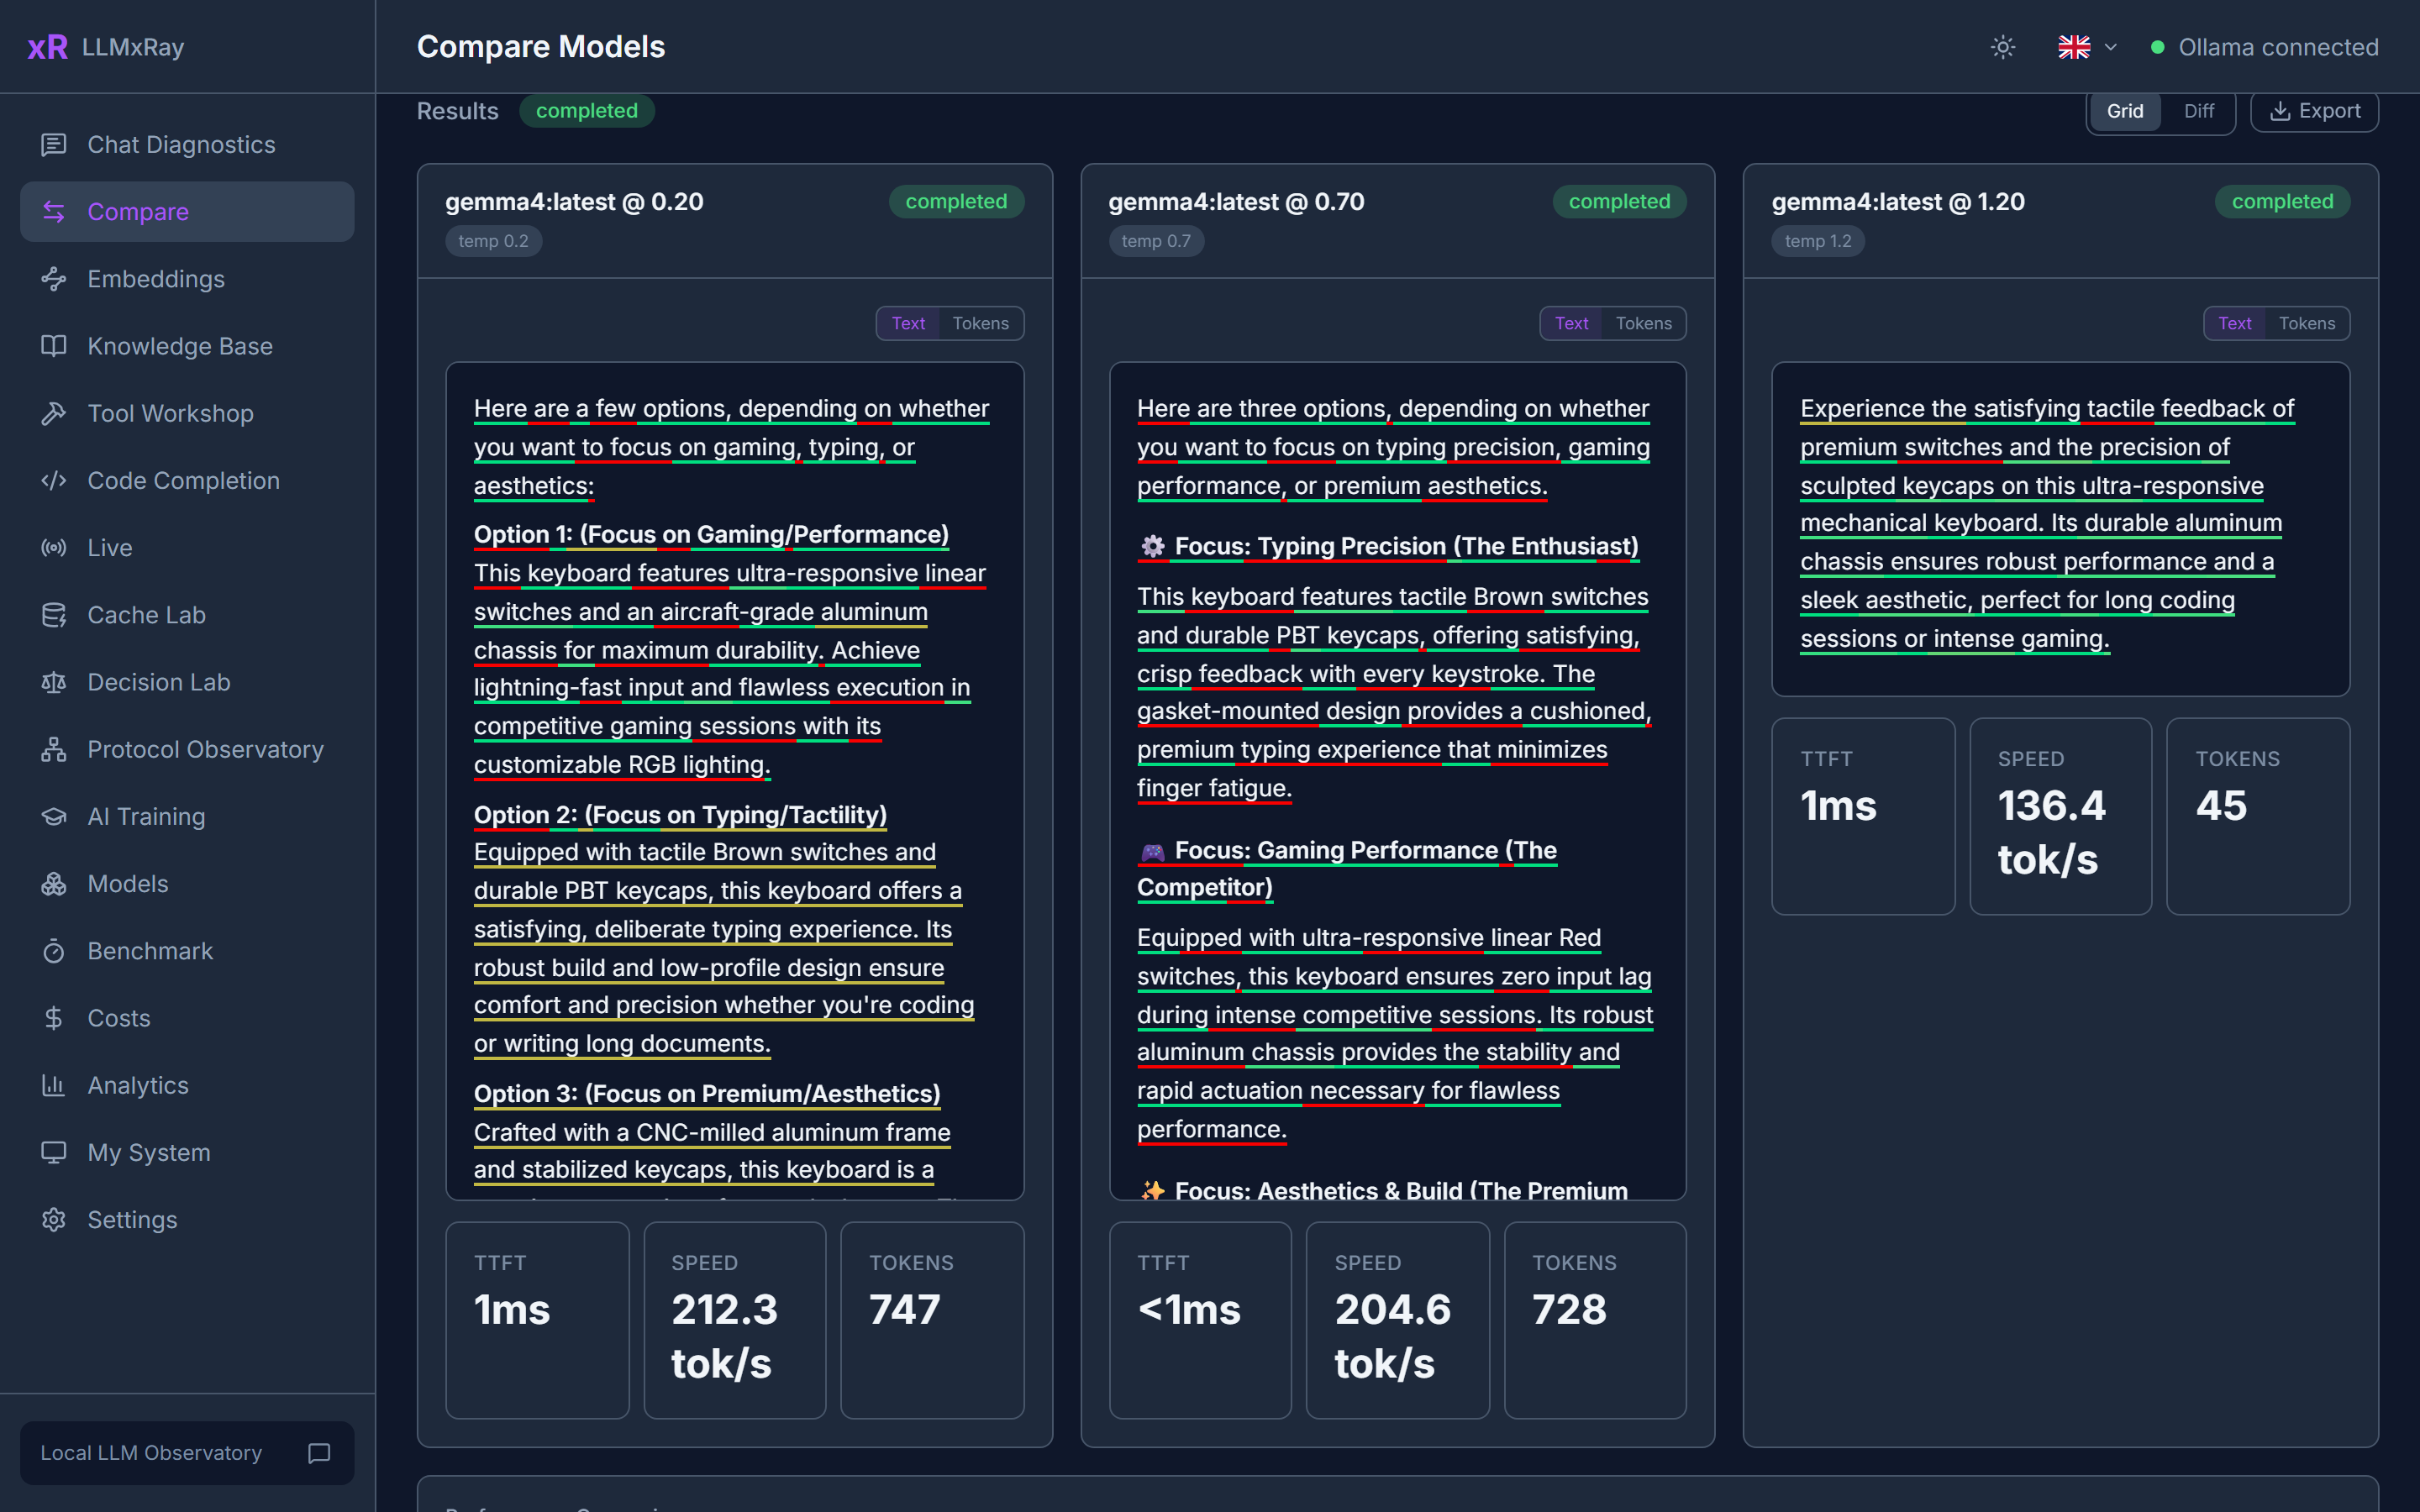
外科的ベンチマーク
厳選された質問セット(MMLU-Pro、ARC-Challenge、HellaSwag、GSM8K、TruthfulQA)を使って、モデルの実際のトークン logprobsでスコアを算出します。回答がたまたま正しそうに見えたかどうかでは評価しません。カテゴリごとの信頼度と正確度を確認できるため、モデルが自信満々に間違える箇所がわかります。独自の質問セットを JSON としてインポートできます。
スクリーンショット
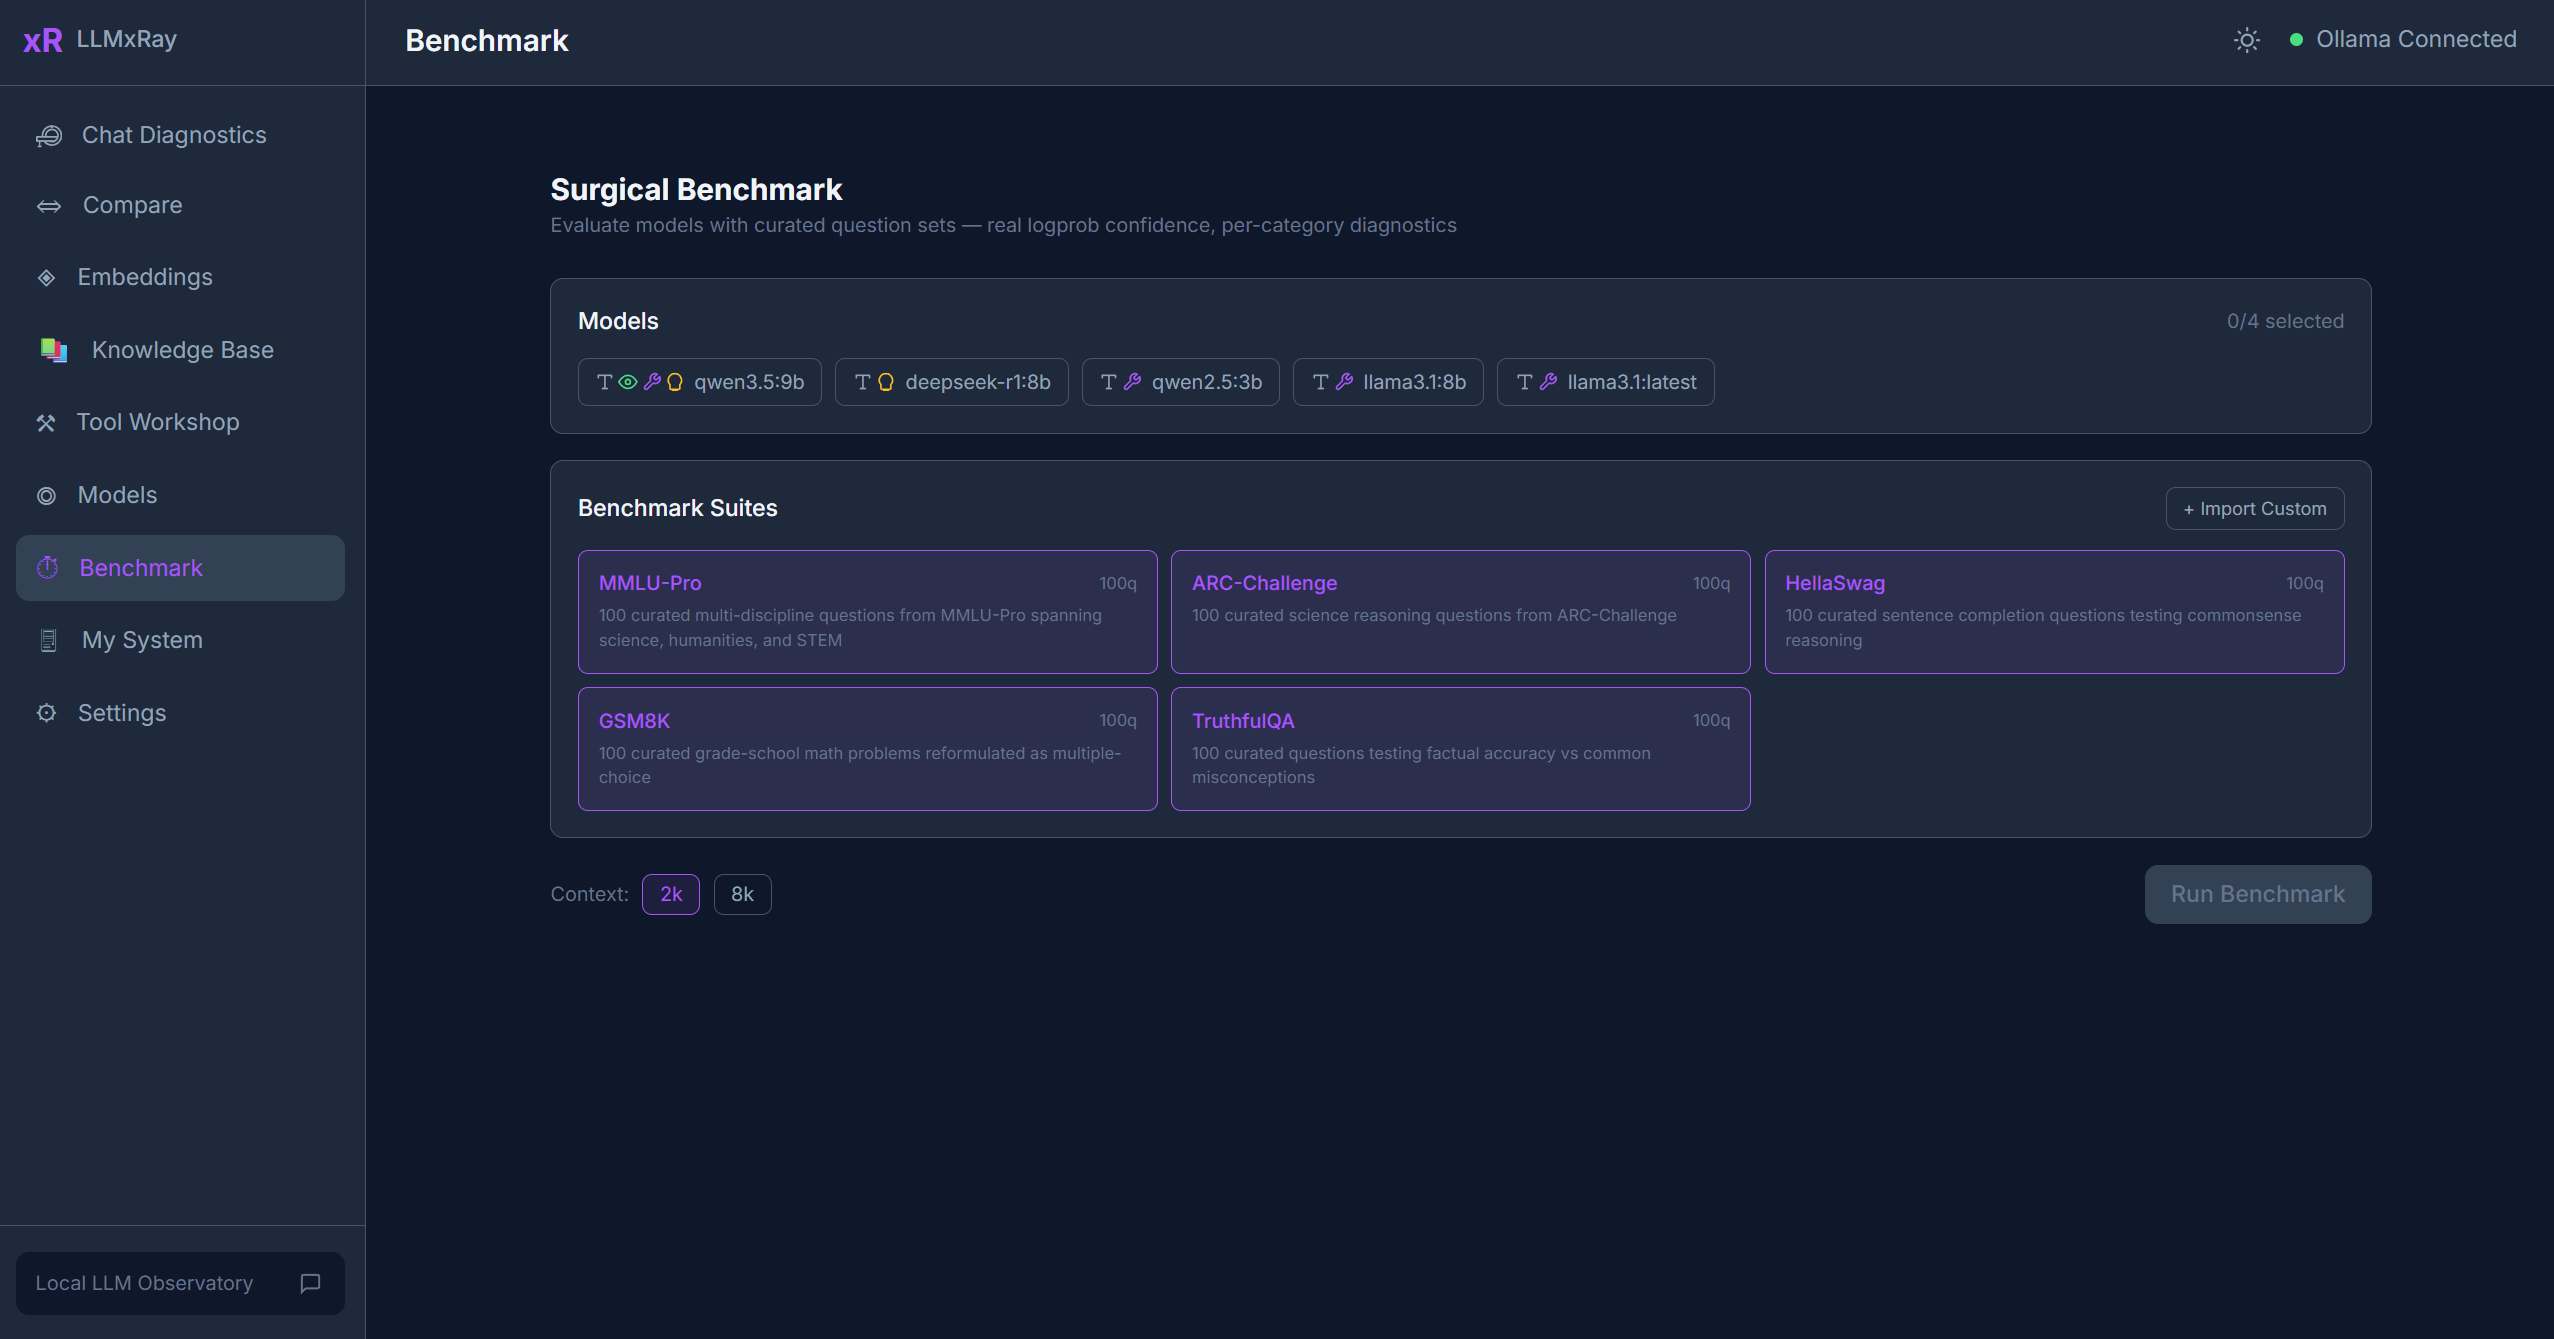
Decision Lab
意思決定モデル(nimble、tev1、clef)は、文章ではなく確率で、型付きの質問に回答します。状況を入力し、候補からの選択、はい/いいえの確率、または尺度上の評価を尋ねます。回答はすべてモデル自身の分布として返され、棒グラフで表示されます。
スクリーンショット
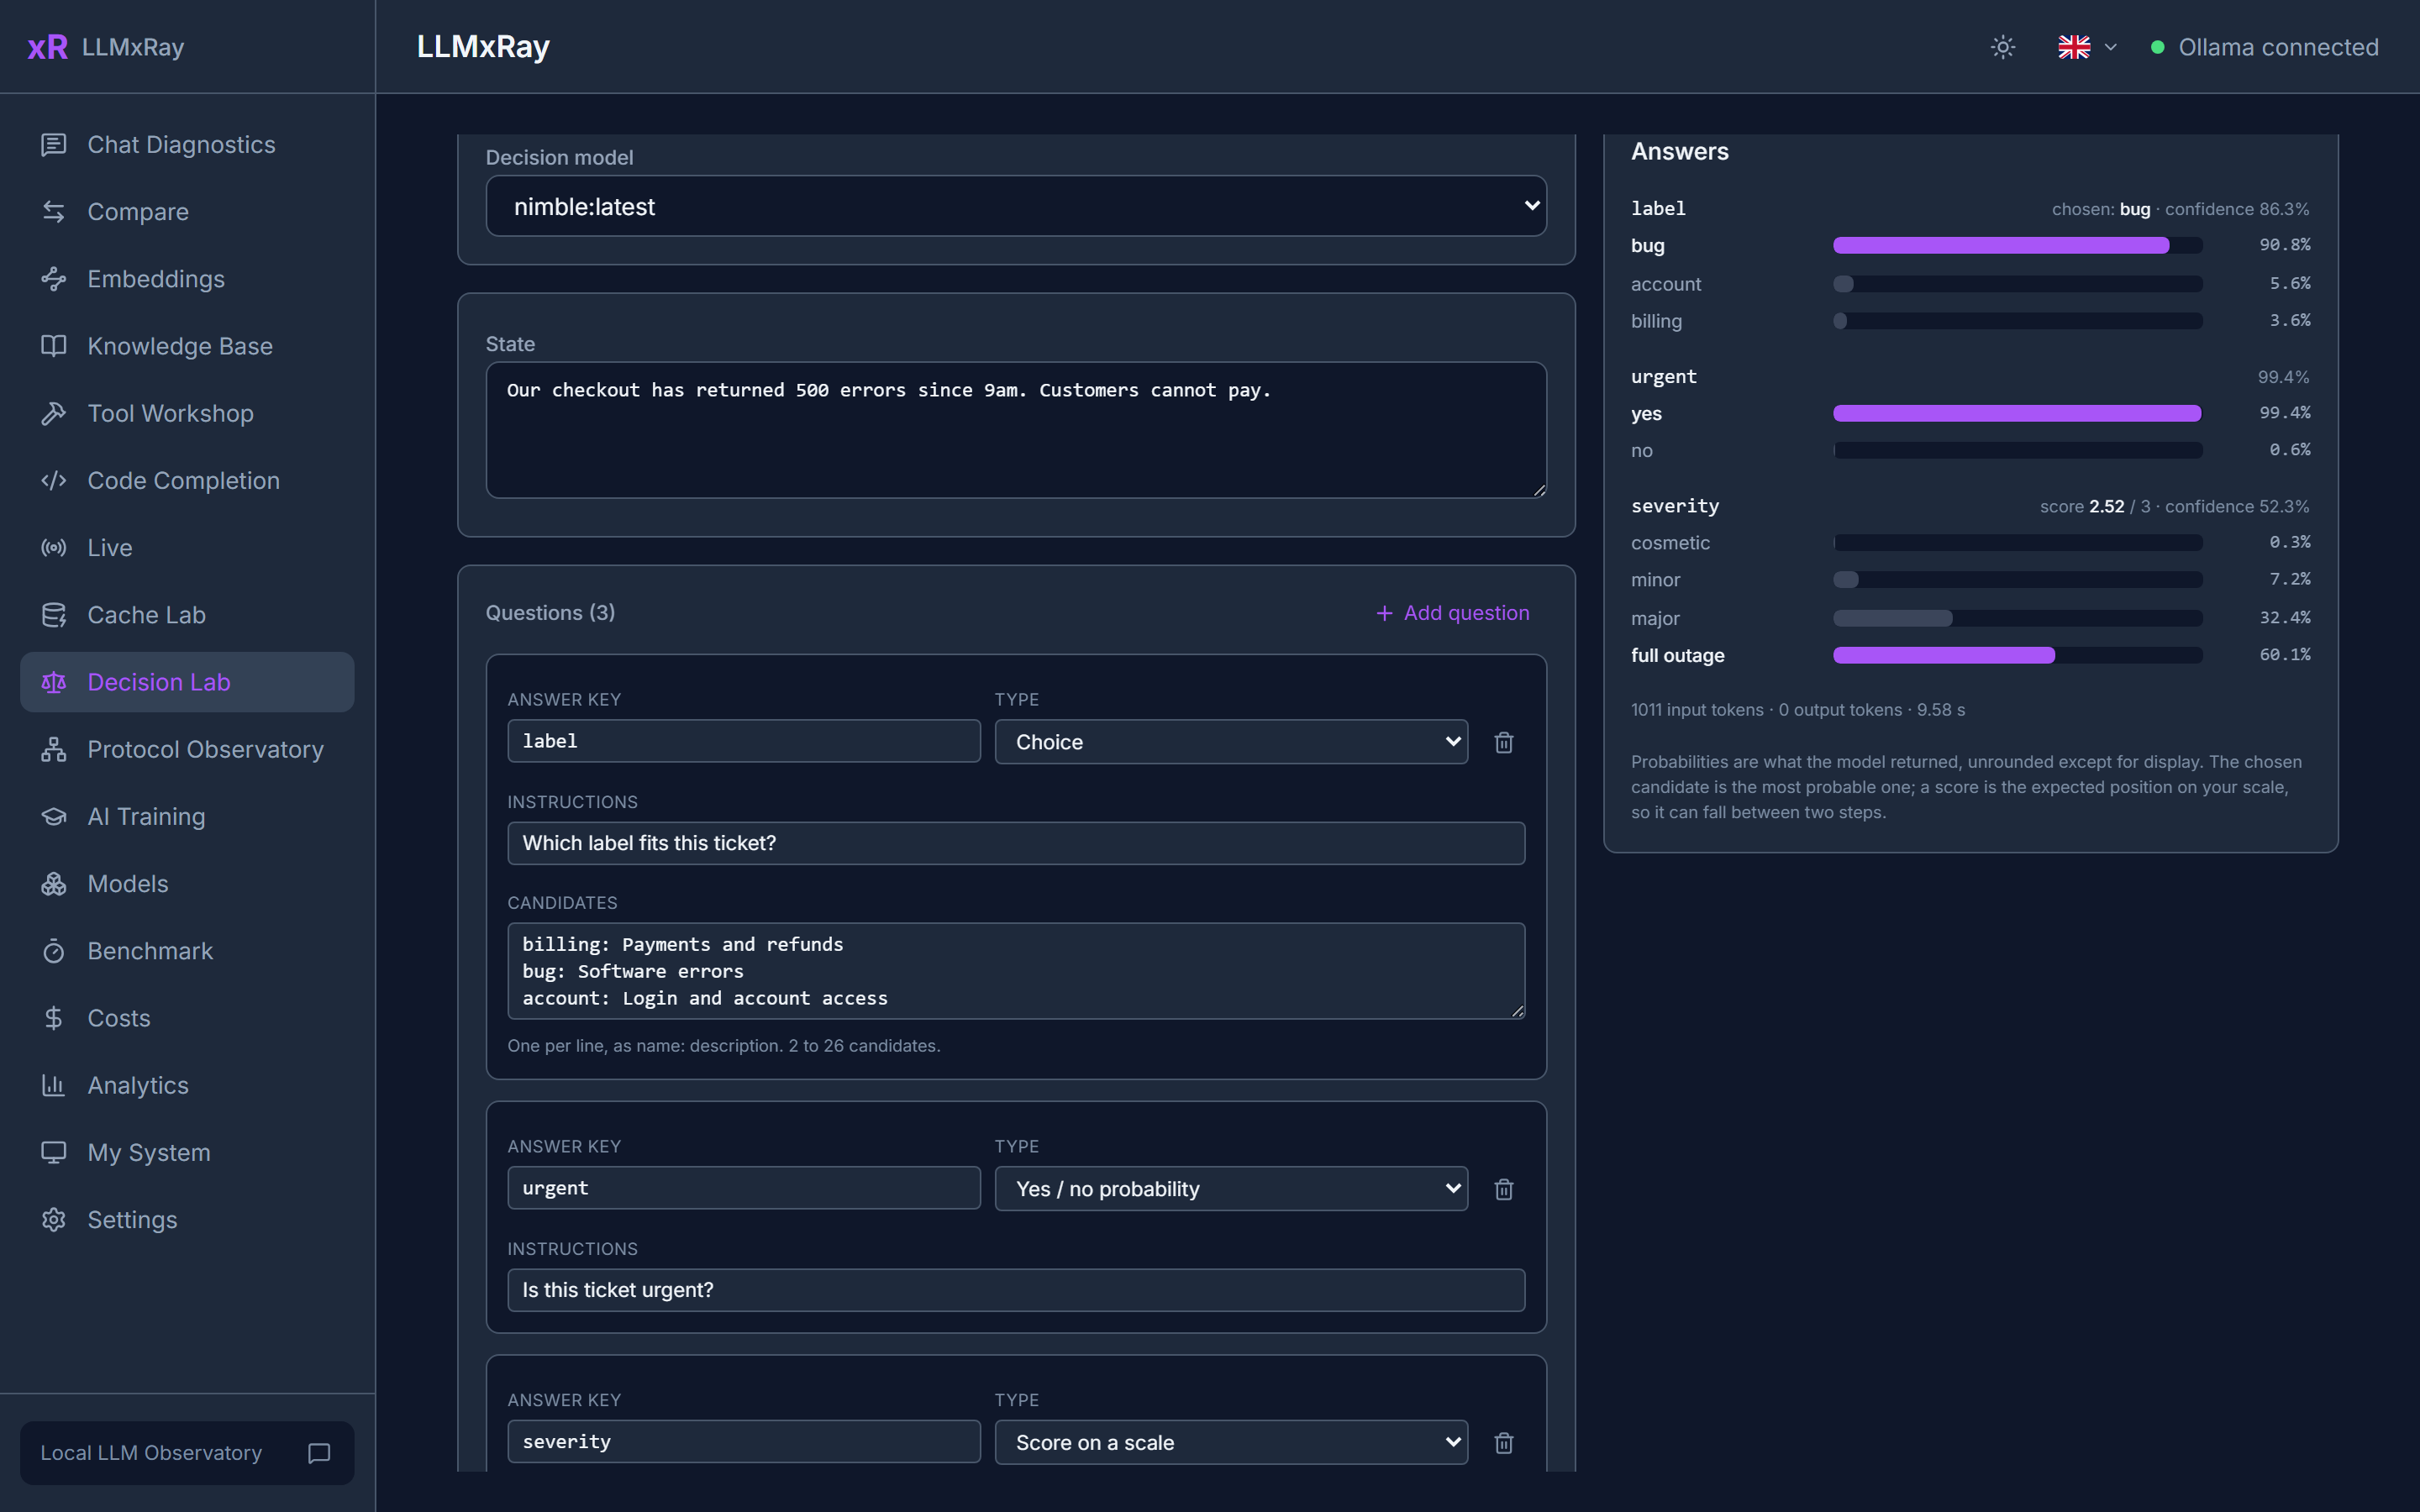
ナレッジベースと埋め込み
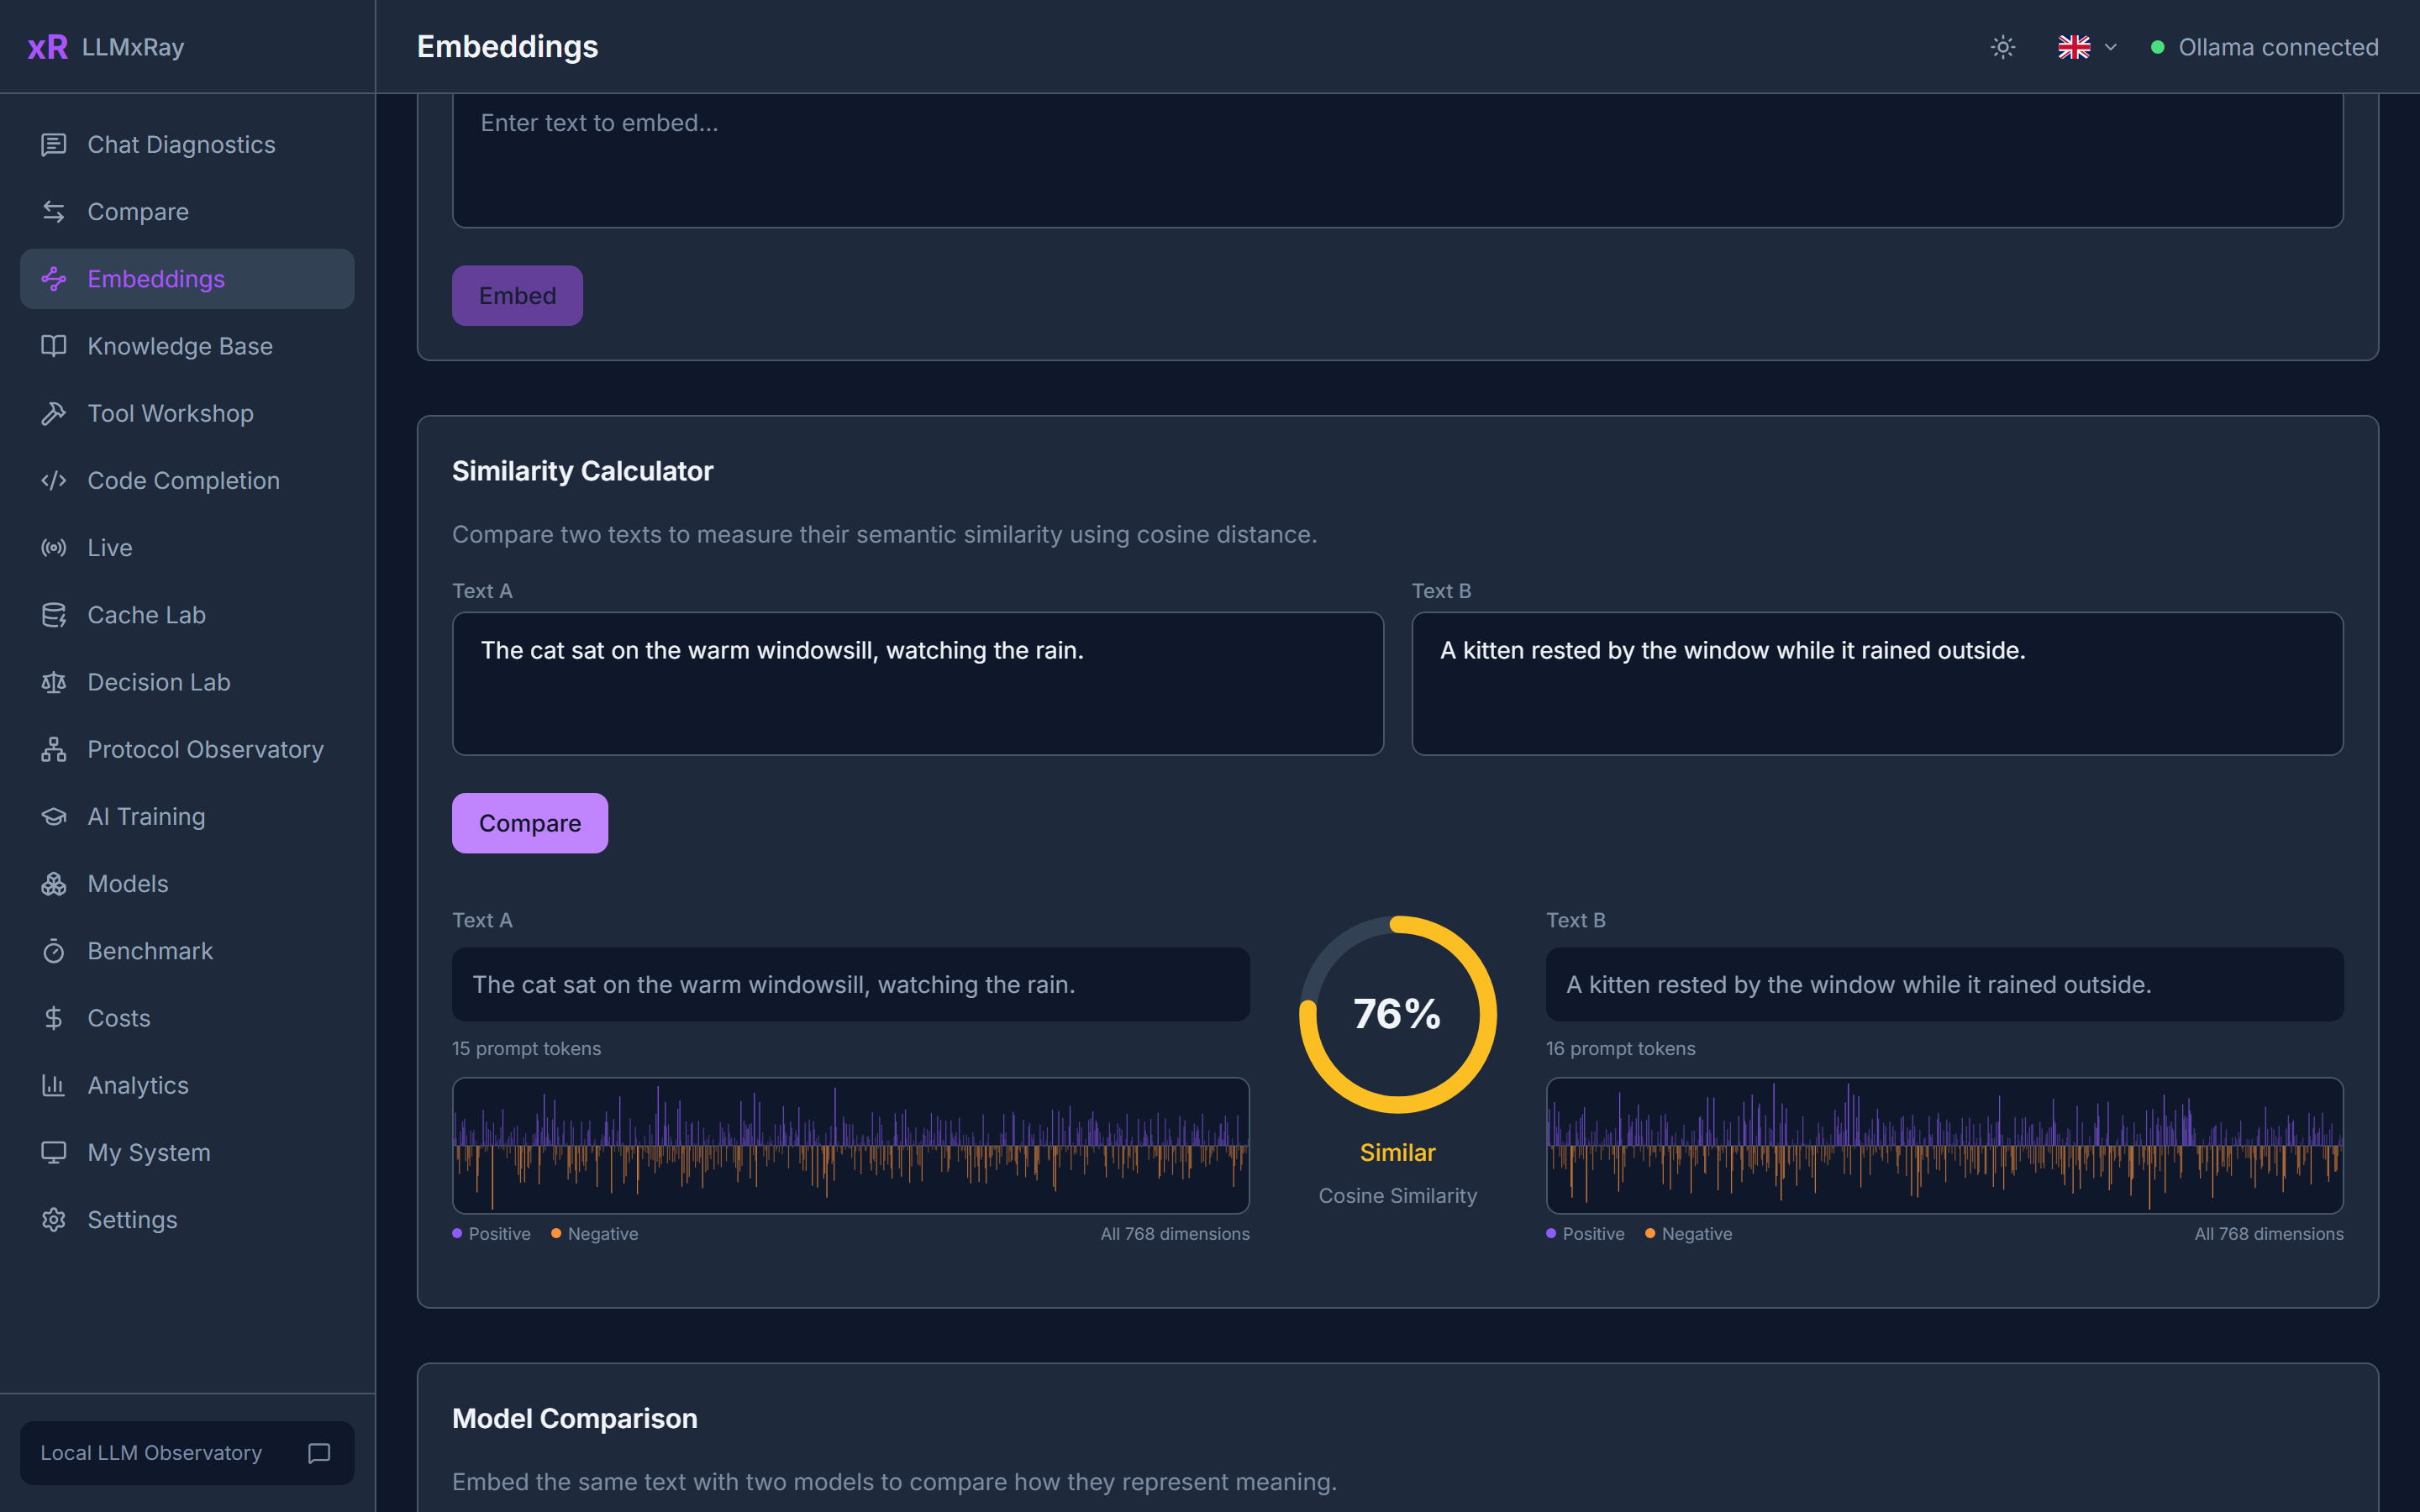
PDF、DOCX、Markdown、CSV ファイルを追加できます。ファイルはチャンクに分割され、埋め込みが生成されて検索可能になるため、モデルに渡される前に、検索で実際に何が返されるかを確認できます。「埋め込み」ページでは、任意の2つのテキストをコサイン類似度で比較し、ベクトルを可視化して、Matryoshka の切り詰めによる損失を確認できます。
データはすべてブラウザーの IndexedDB に保存されます。
スクリーンショット
|
|
|
コード補完
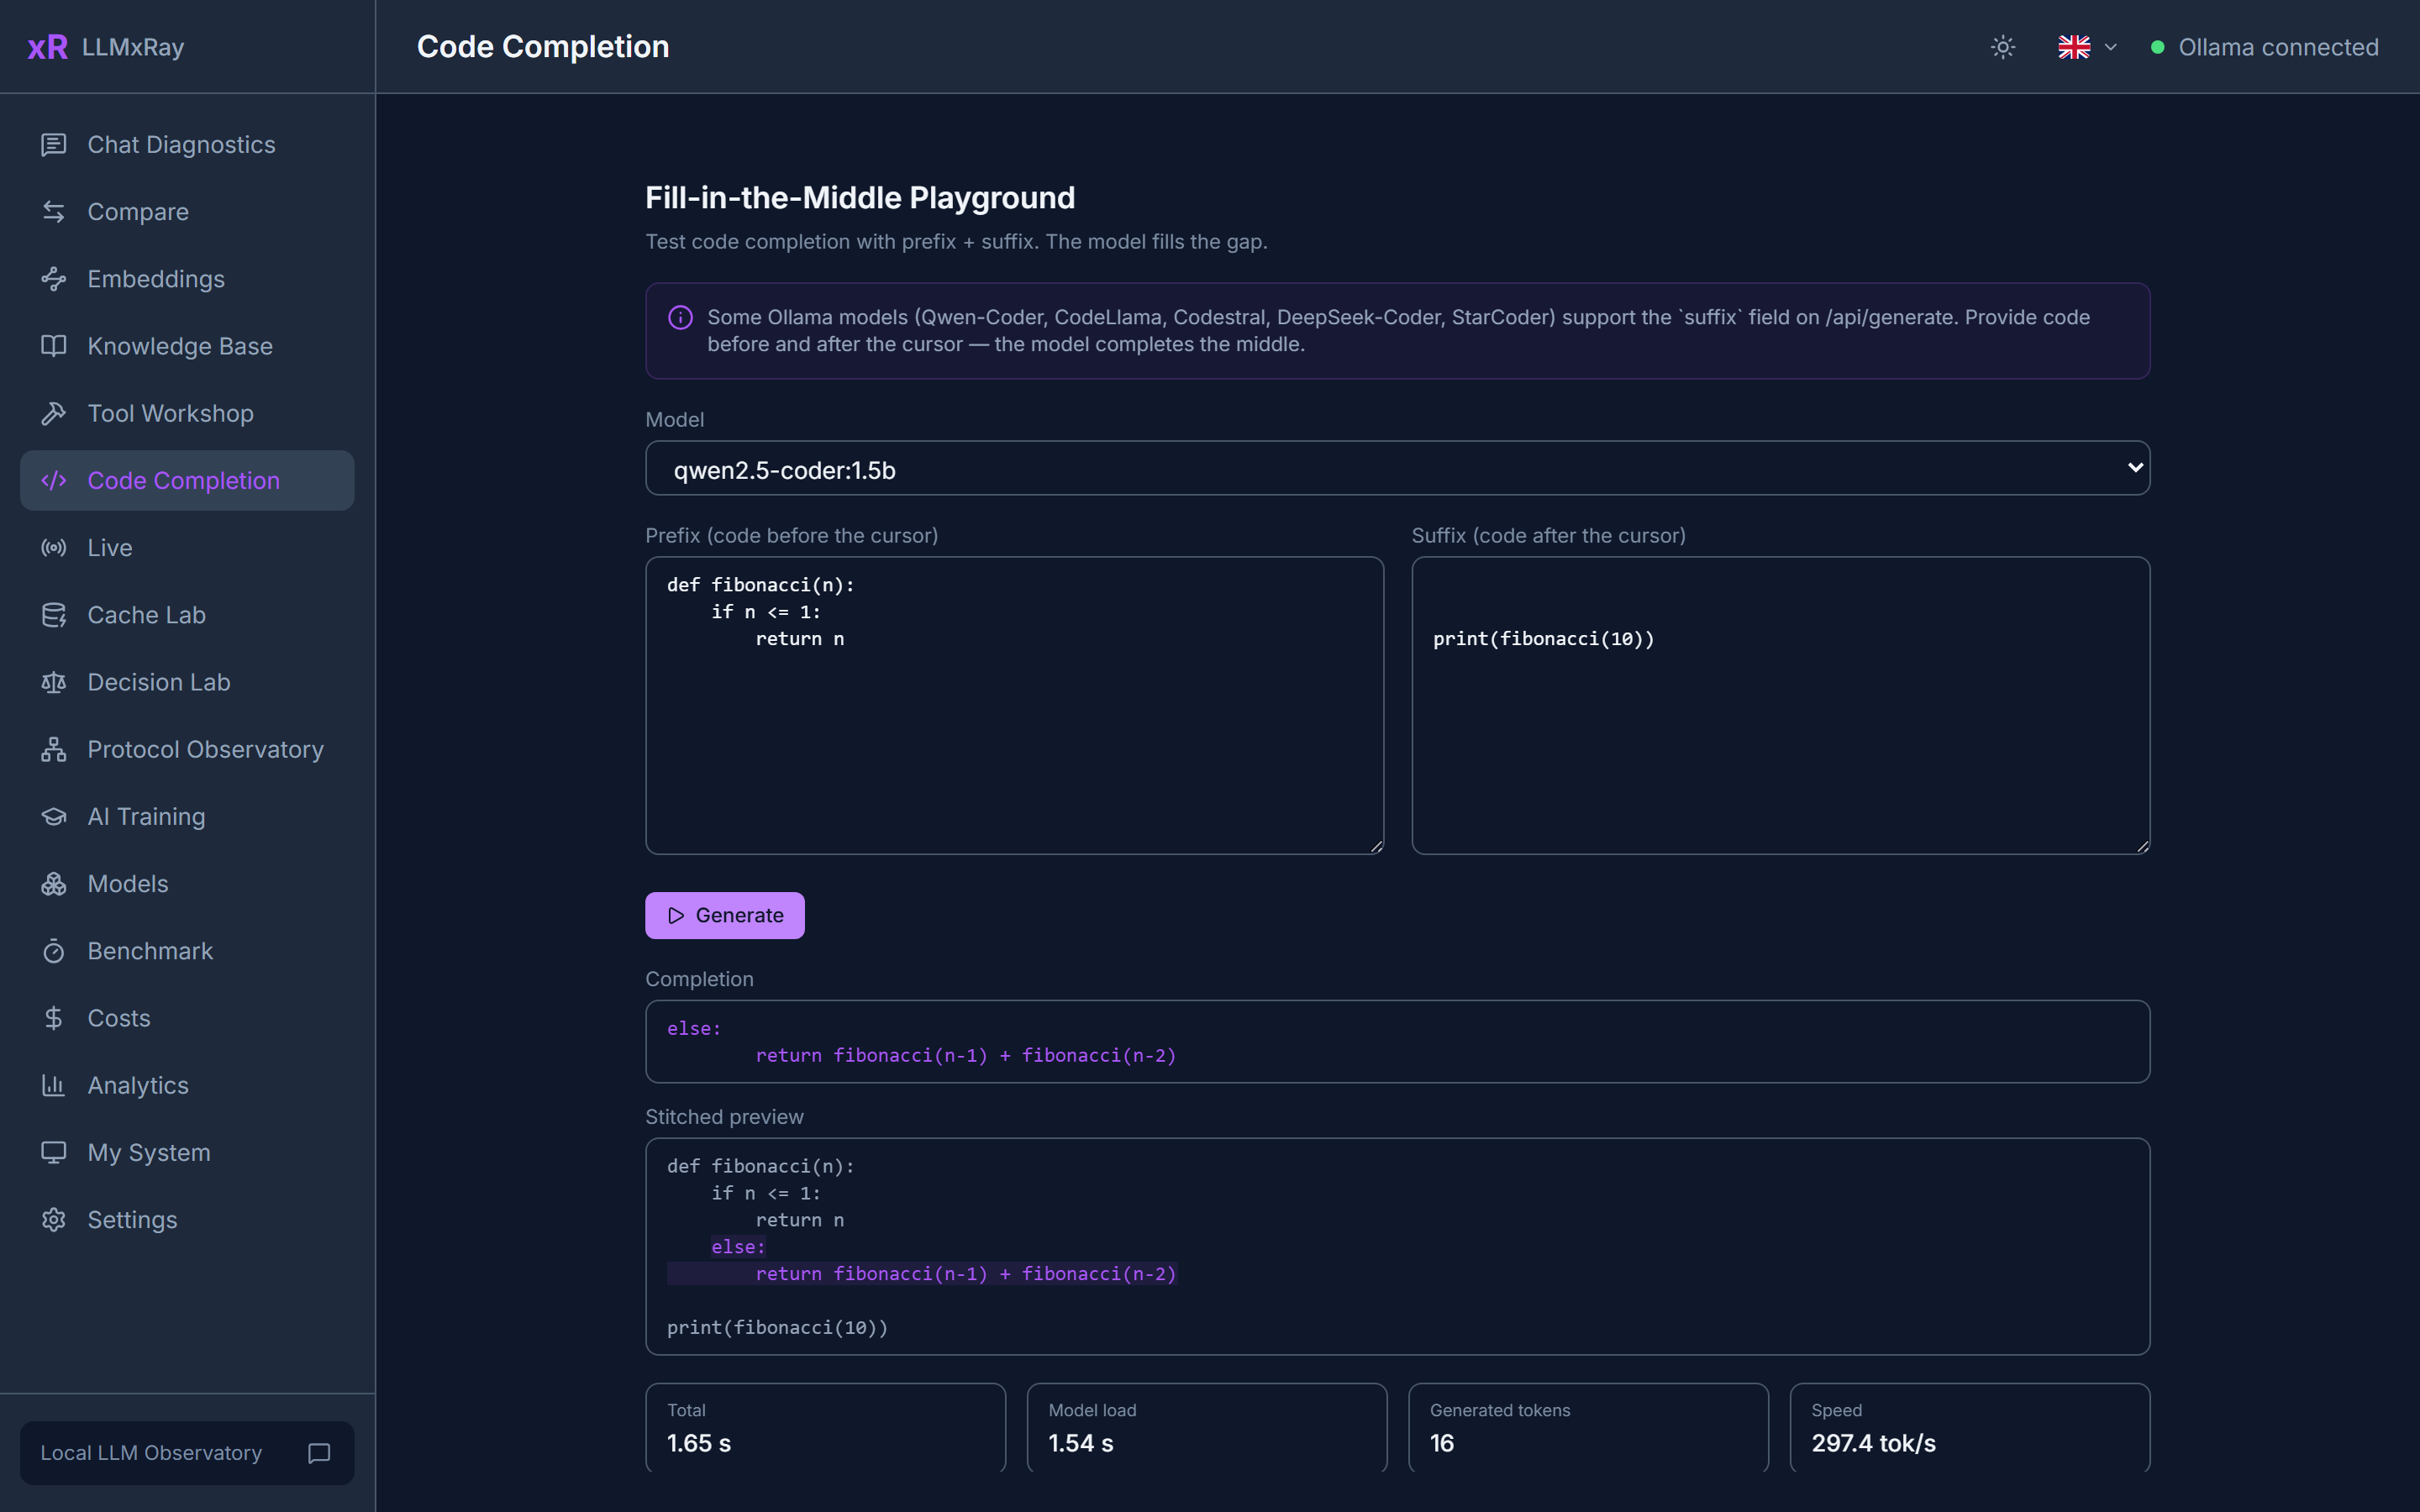
Qwen-Coder、CodeLlama、Codestral、DeepSeek-Coder、StarCoder 向けの Fill-in-the-middle に対応しています。プレフィックスとサフィックスを指定すると、モデルがその間を補完します。結合プレビューでは、エディターに表示される形で結果を確認できます。
スクリーンショット
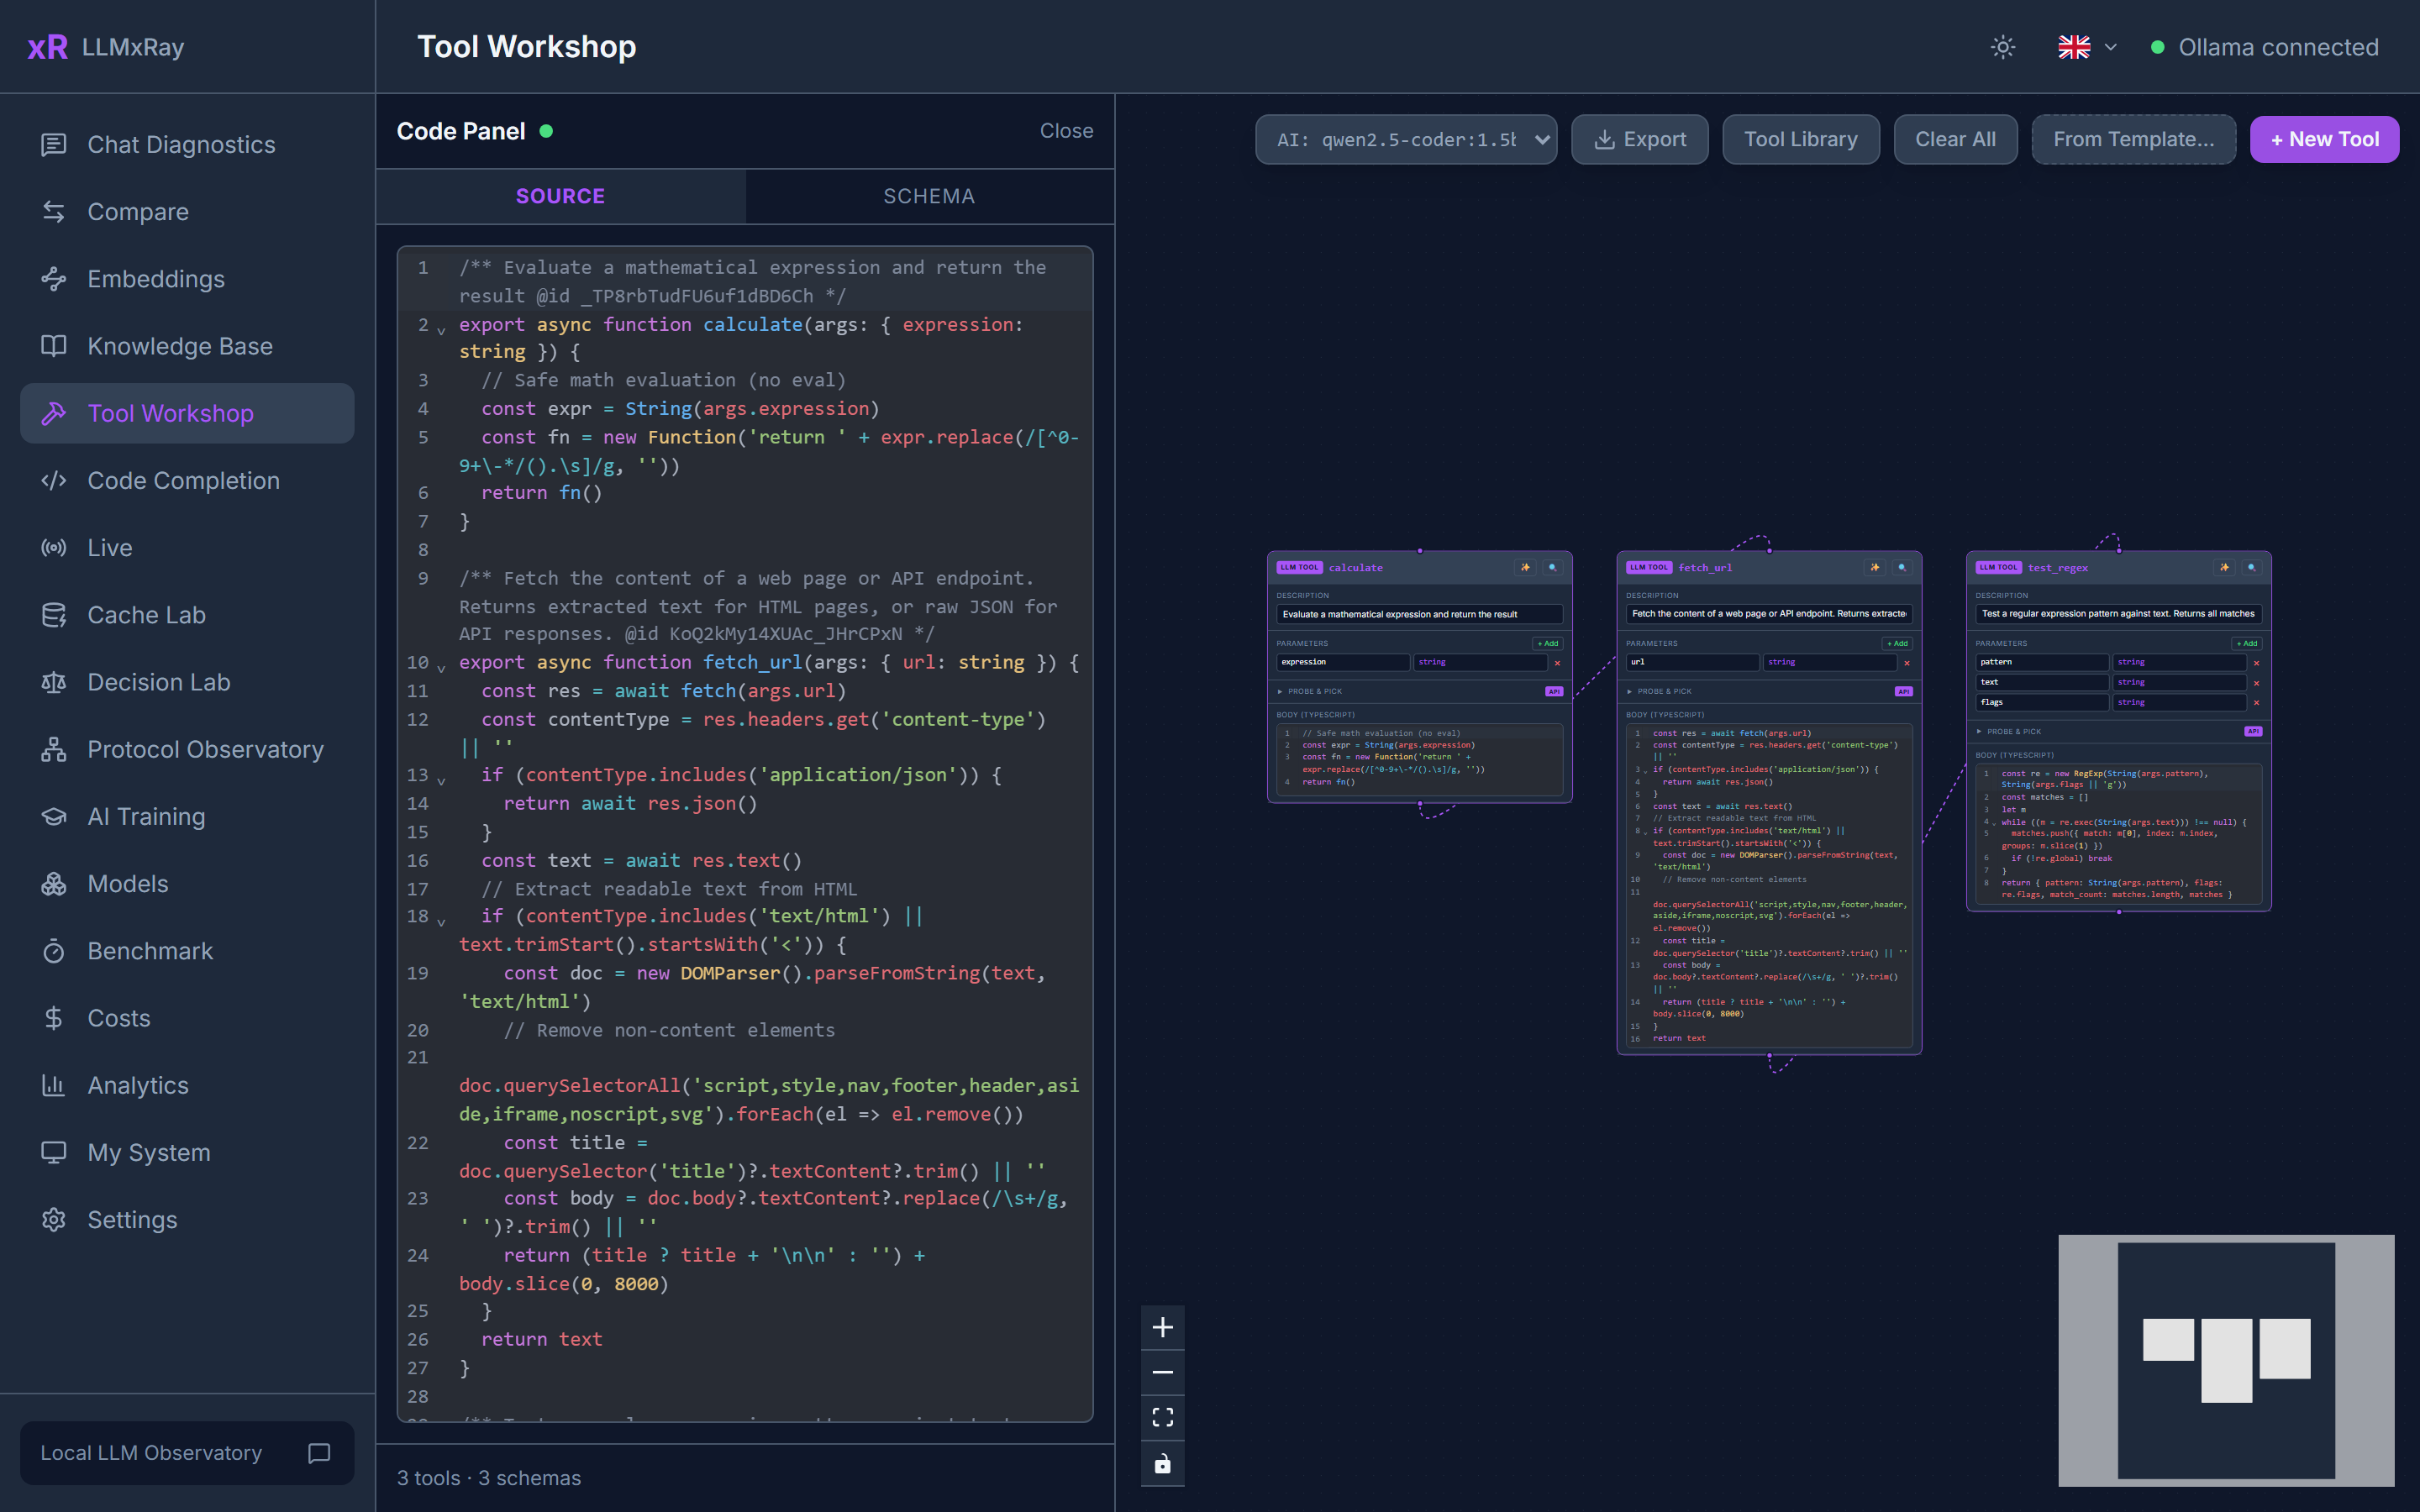
ツール定義を作成するためのノードキャンバスです。TypeScript は双方向で同期されるため、ノードを編集してもコードを編集しても反映されます。API を調査してスキーマを生成し、実際の呼び出しでツールをテストできます。
スクリーンショット
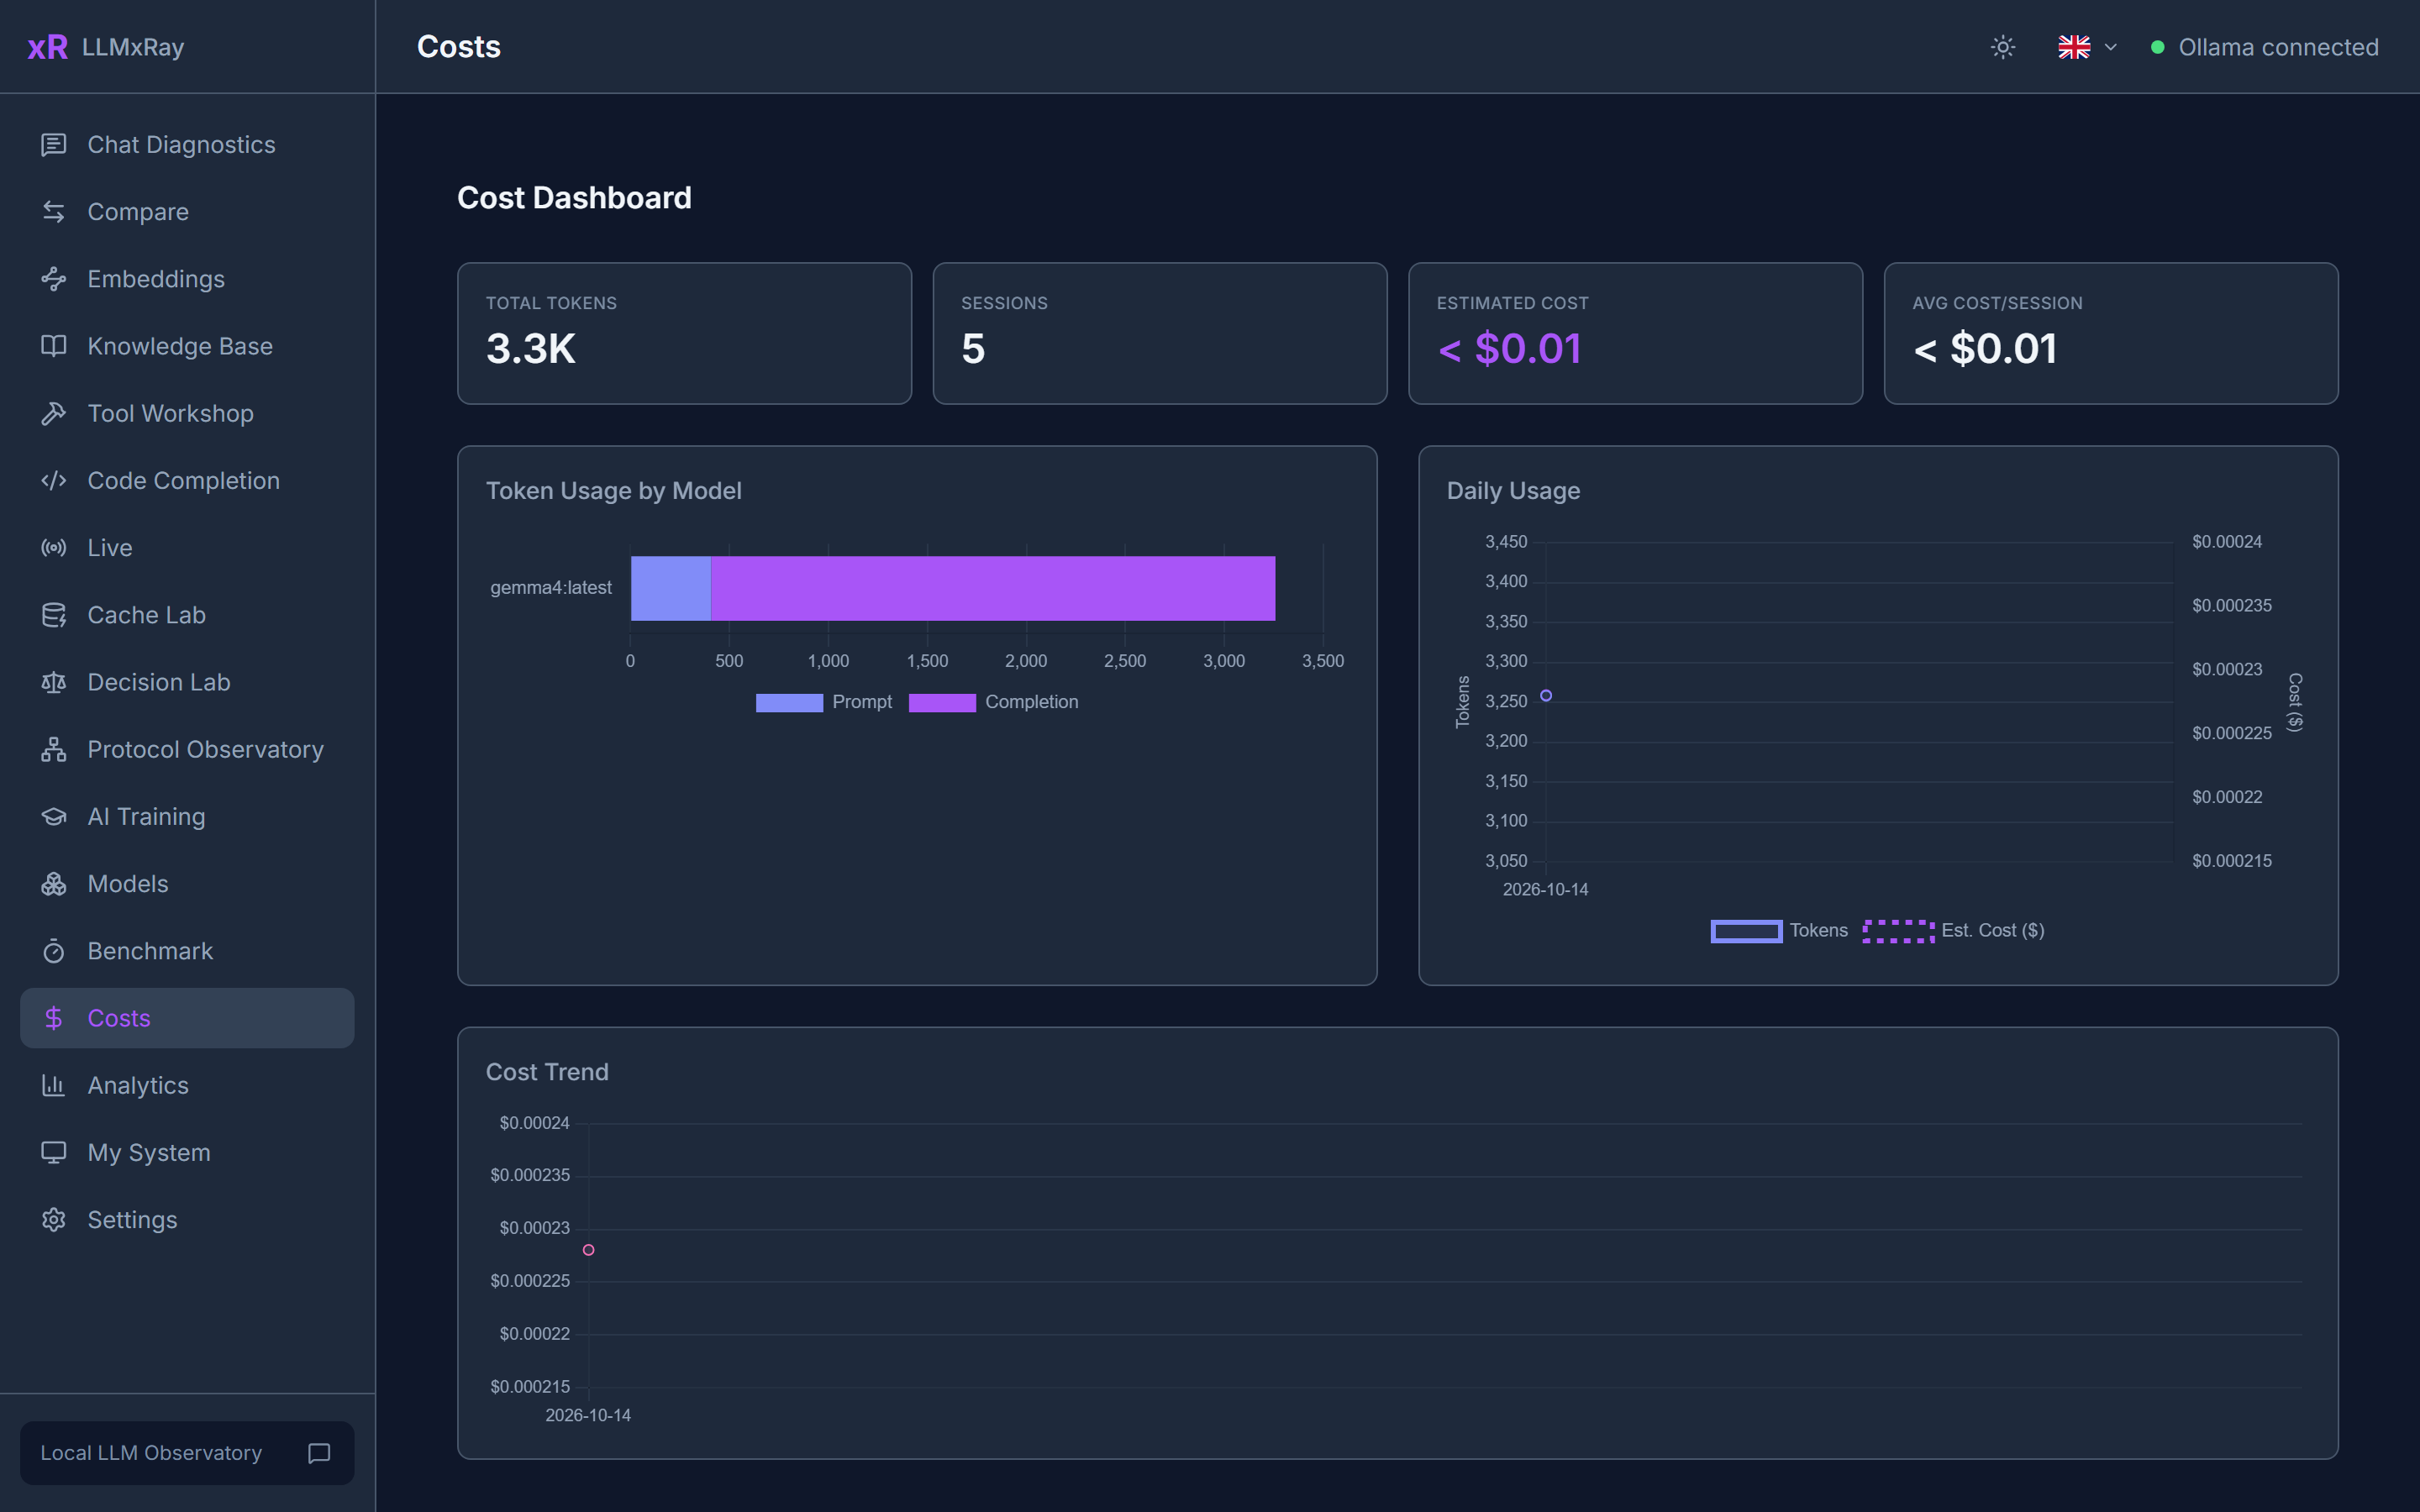
分析とコスト
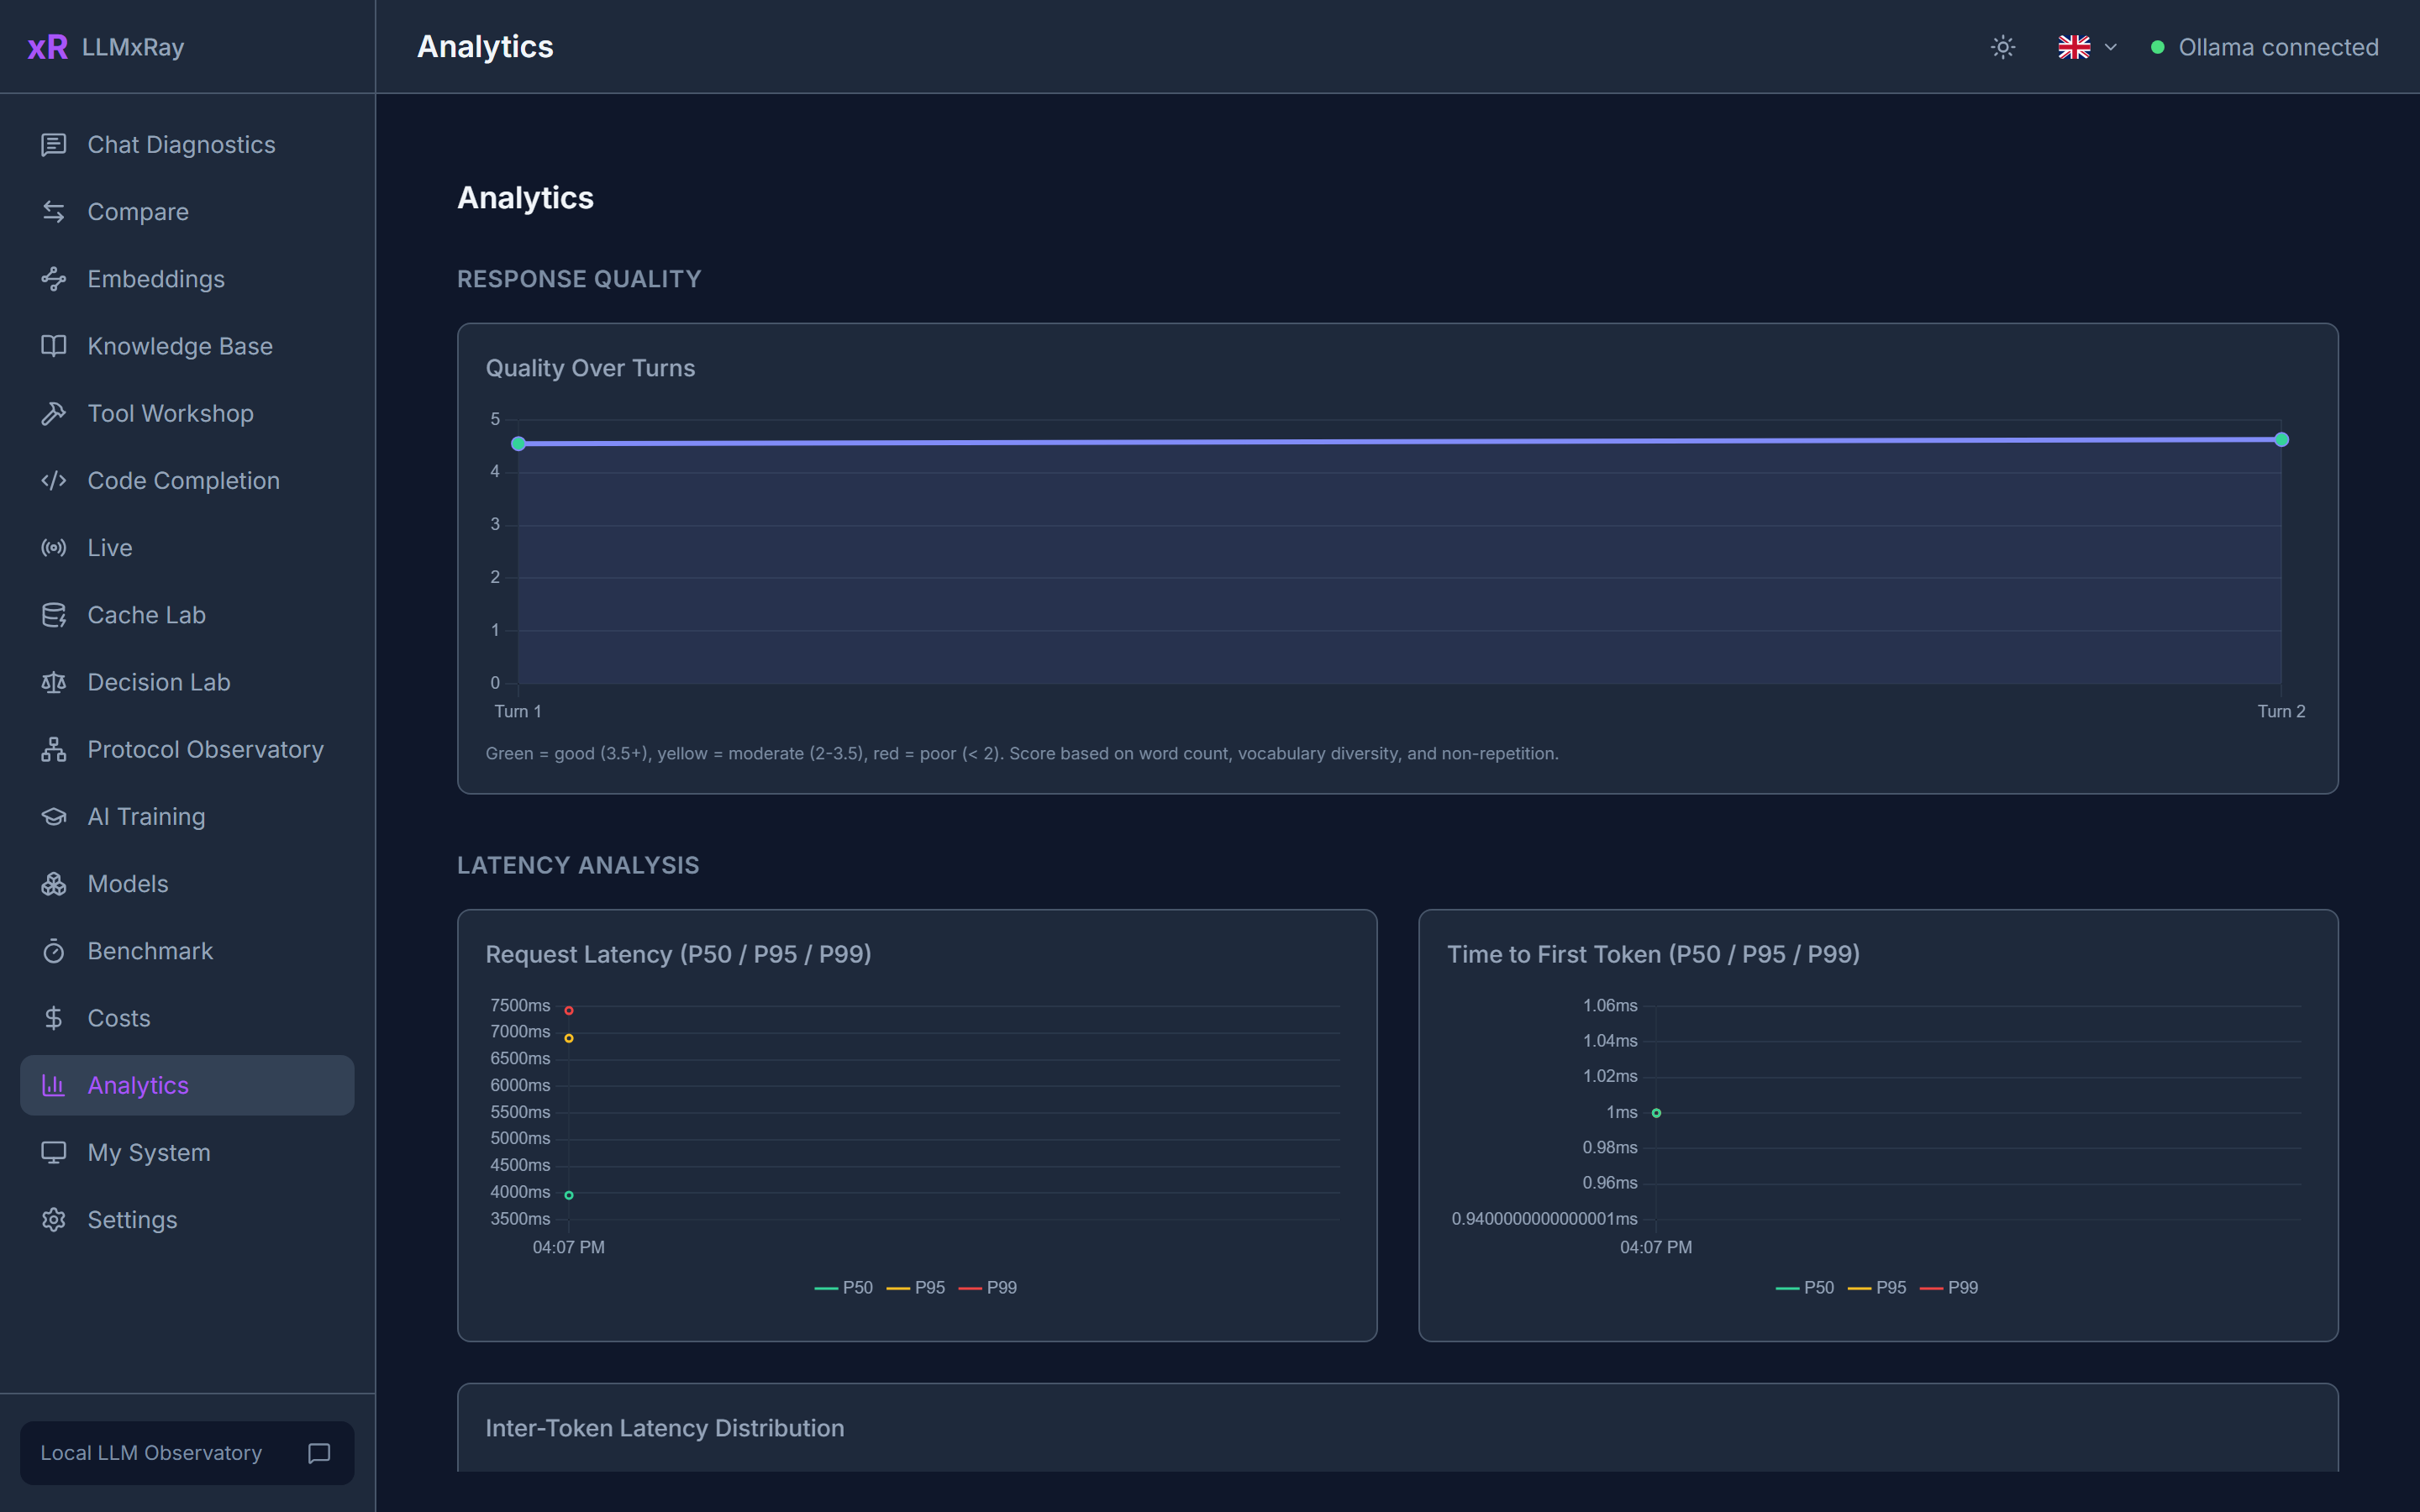
リクエストと最初のトークンのレイテンシパーセンタイル(P50/P95/P99)、ターンごとの品質、モデル別のエラー、使用状況のヒートマップ、温度と1秒あたりのトークン数を確認できます。コストページでは、ローカルでの使用量をクラウド料金で換算するため、ローカルで実行することでどれだけ節約できるかがわかります。
スクリーンショット
|
|
|
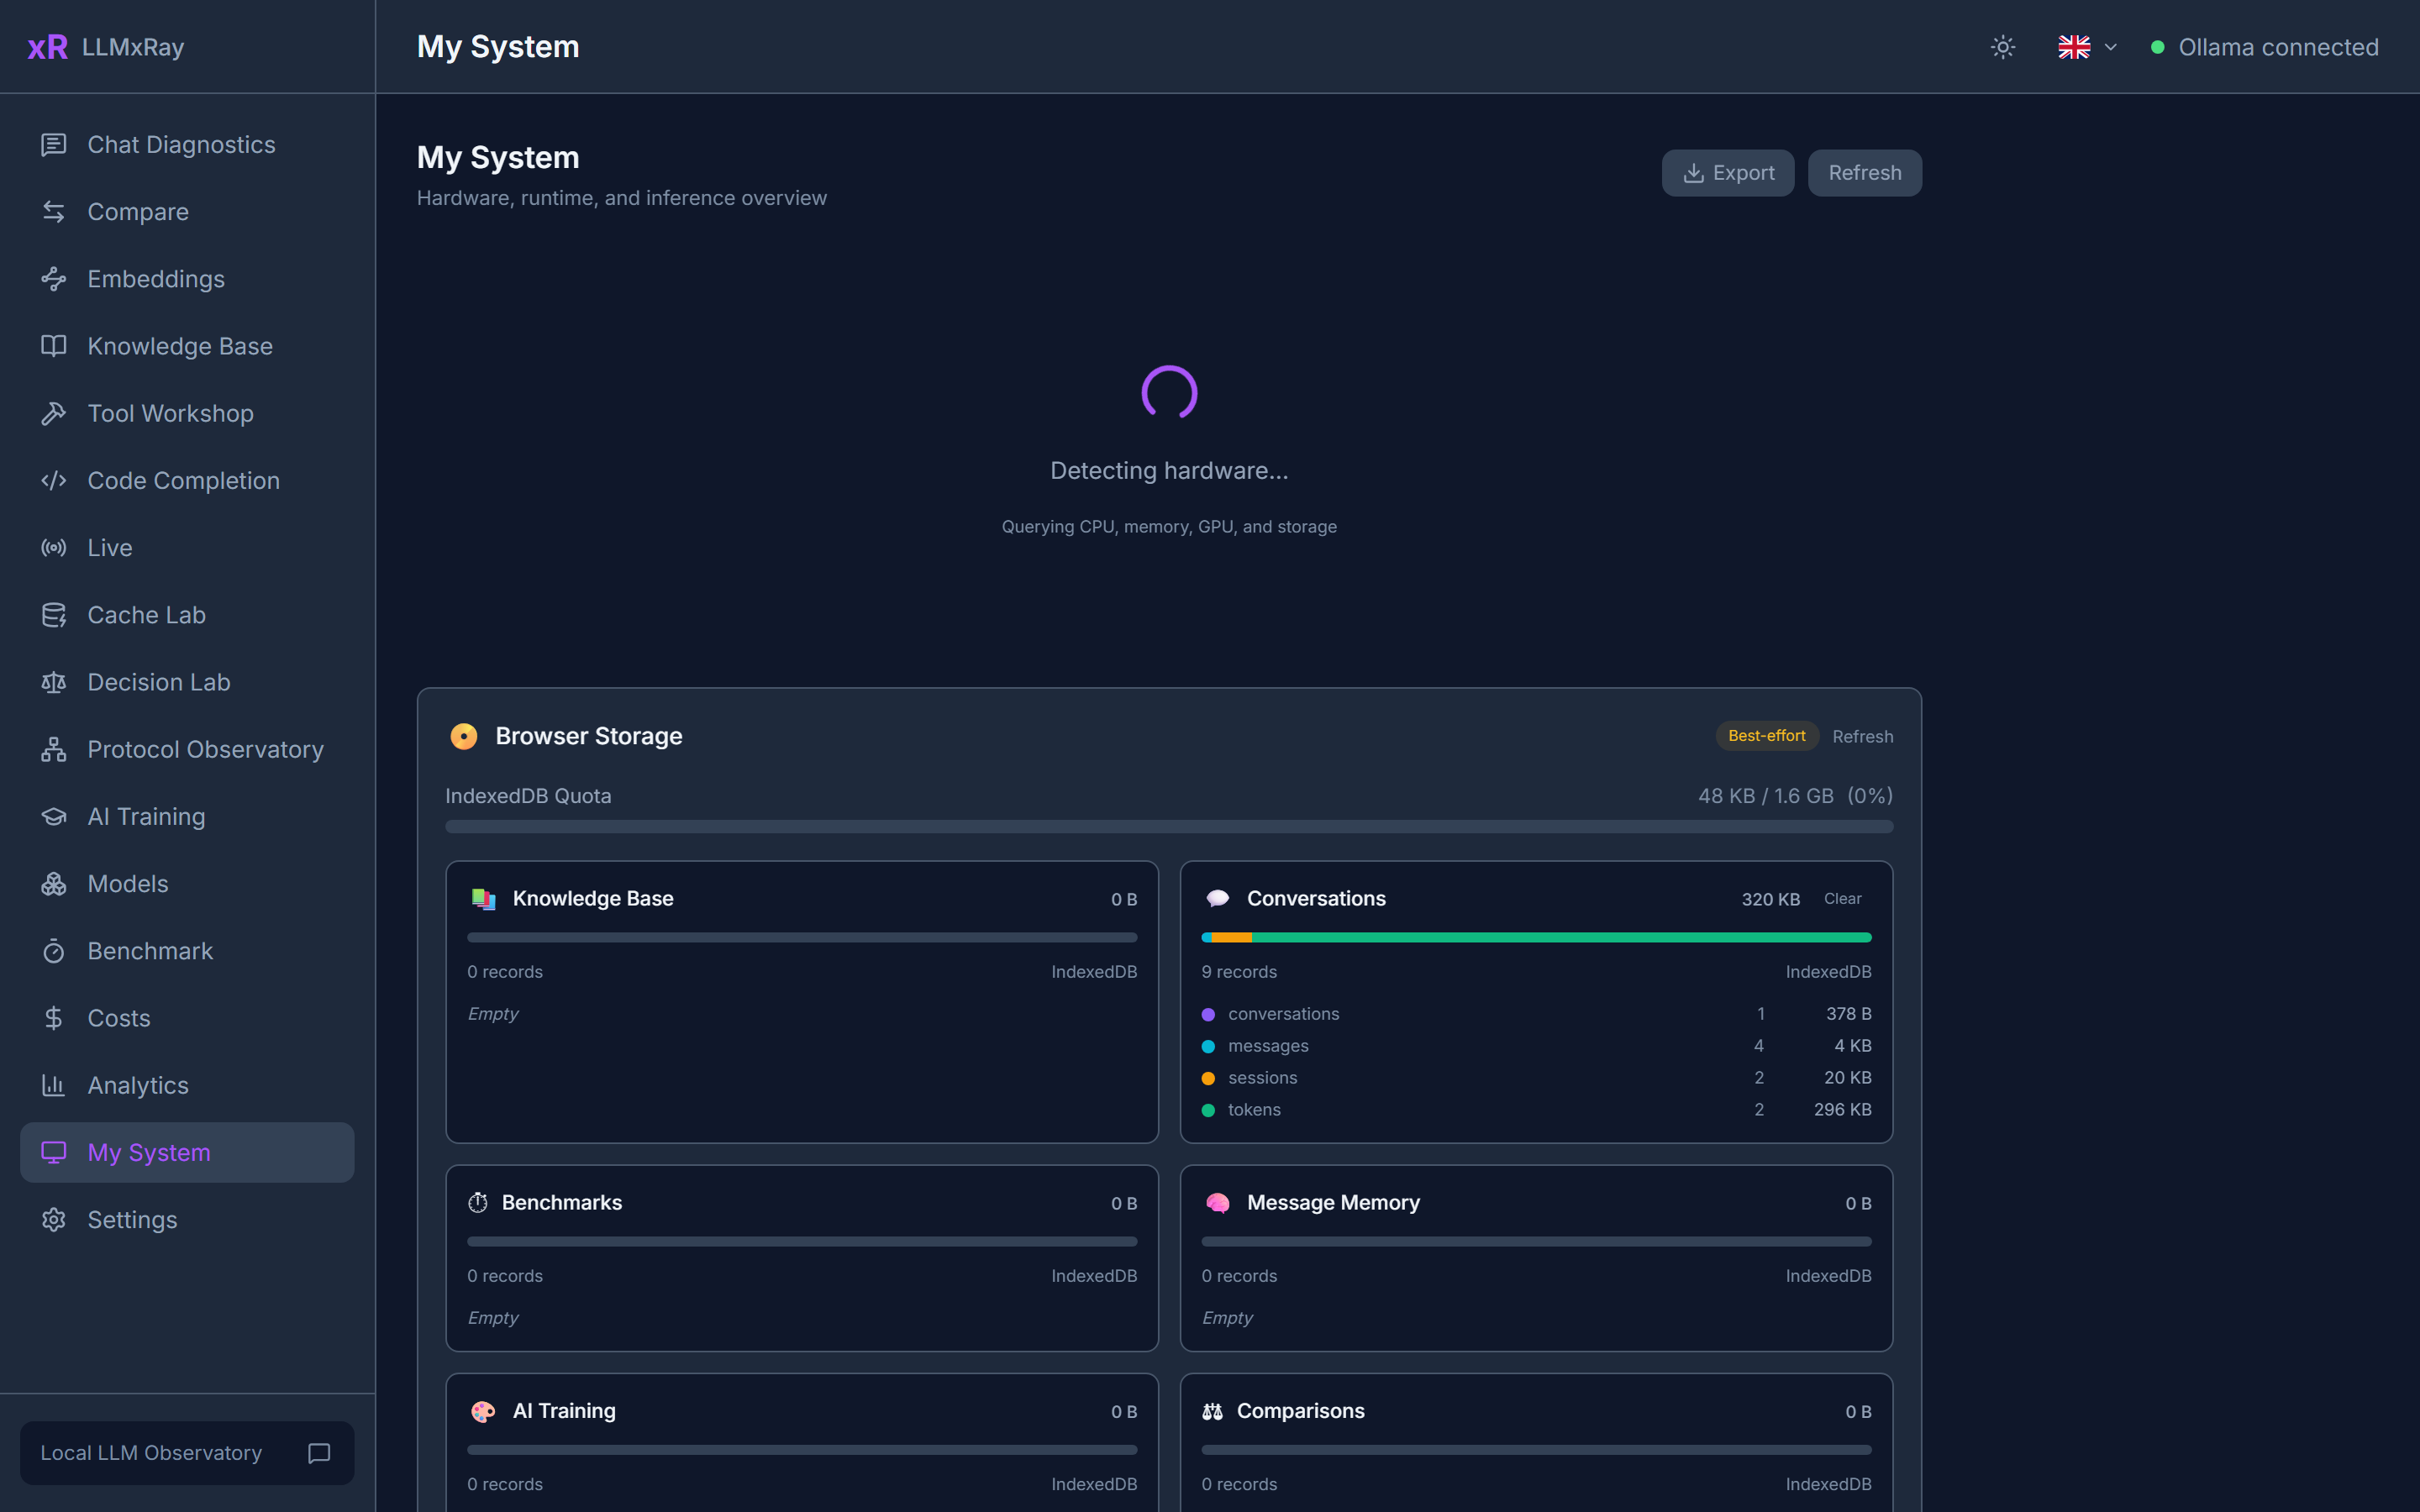
システムとモデル
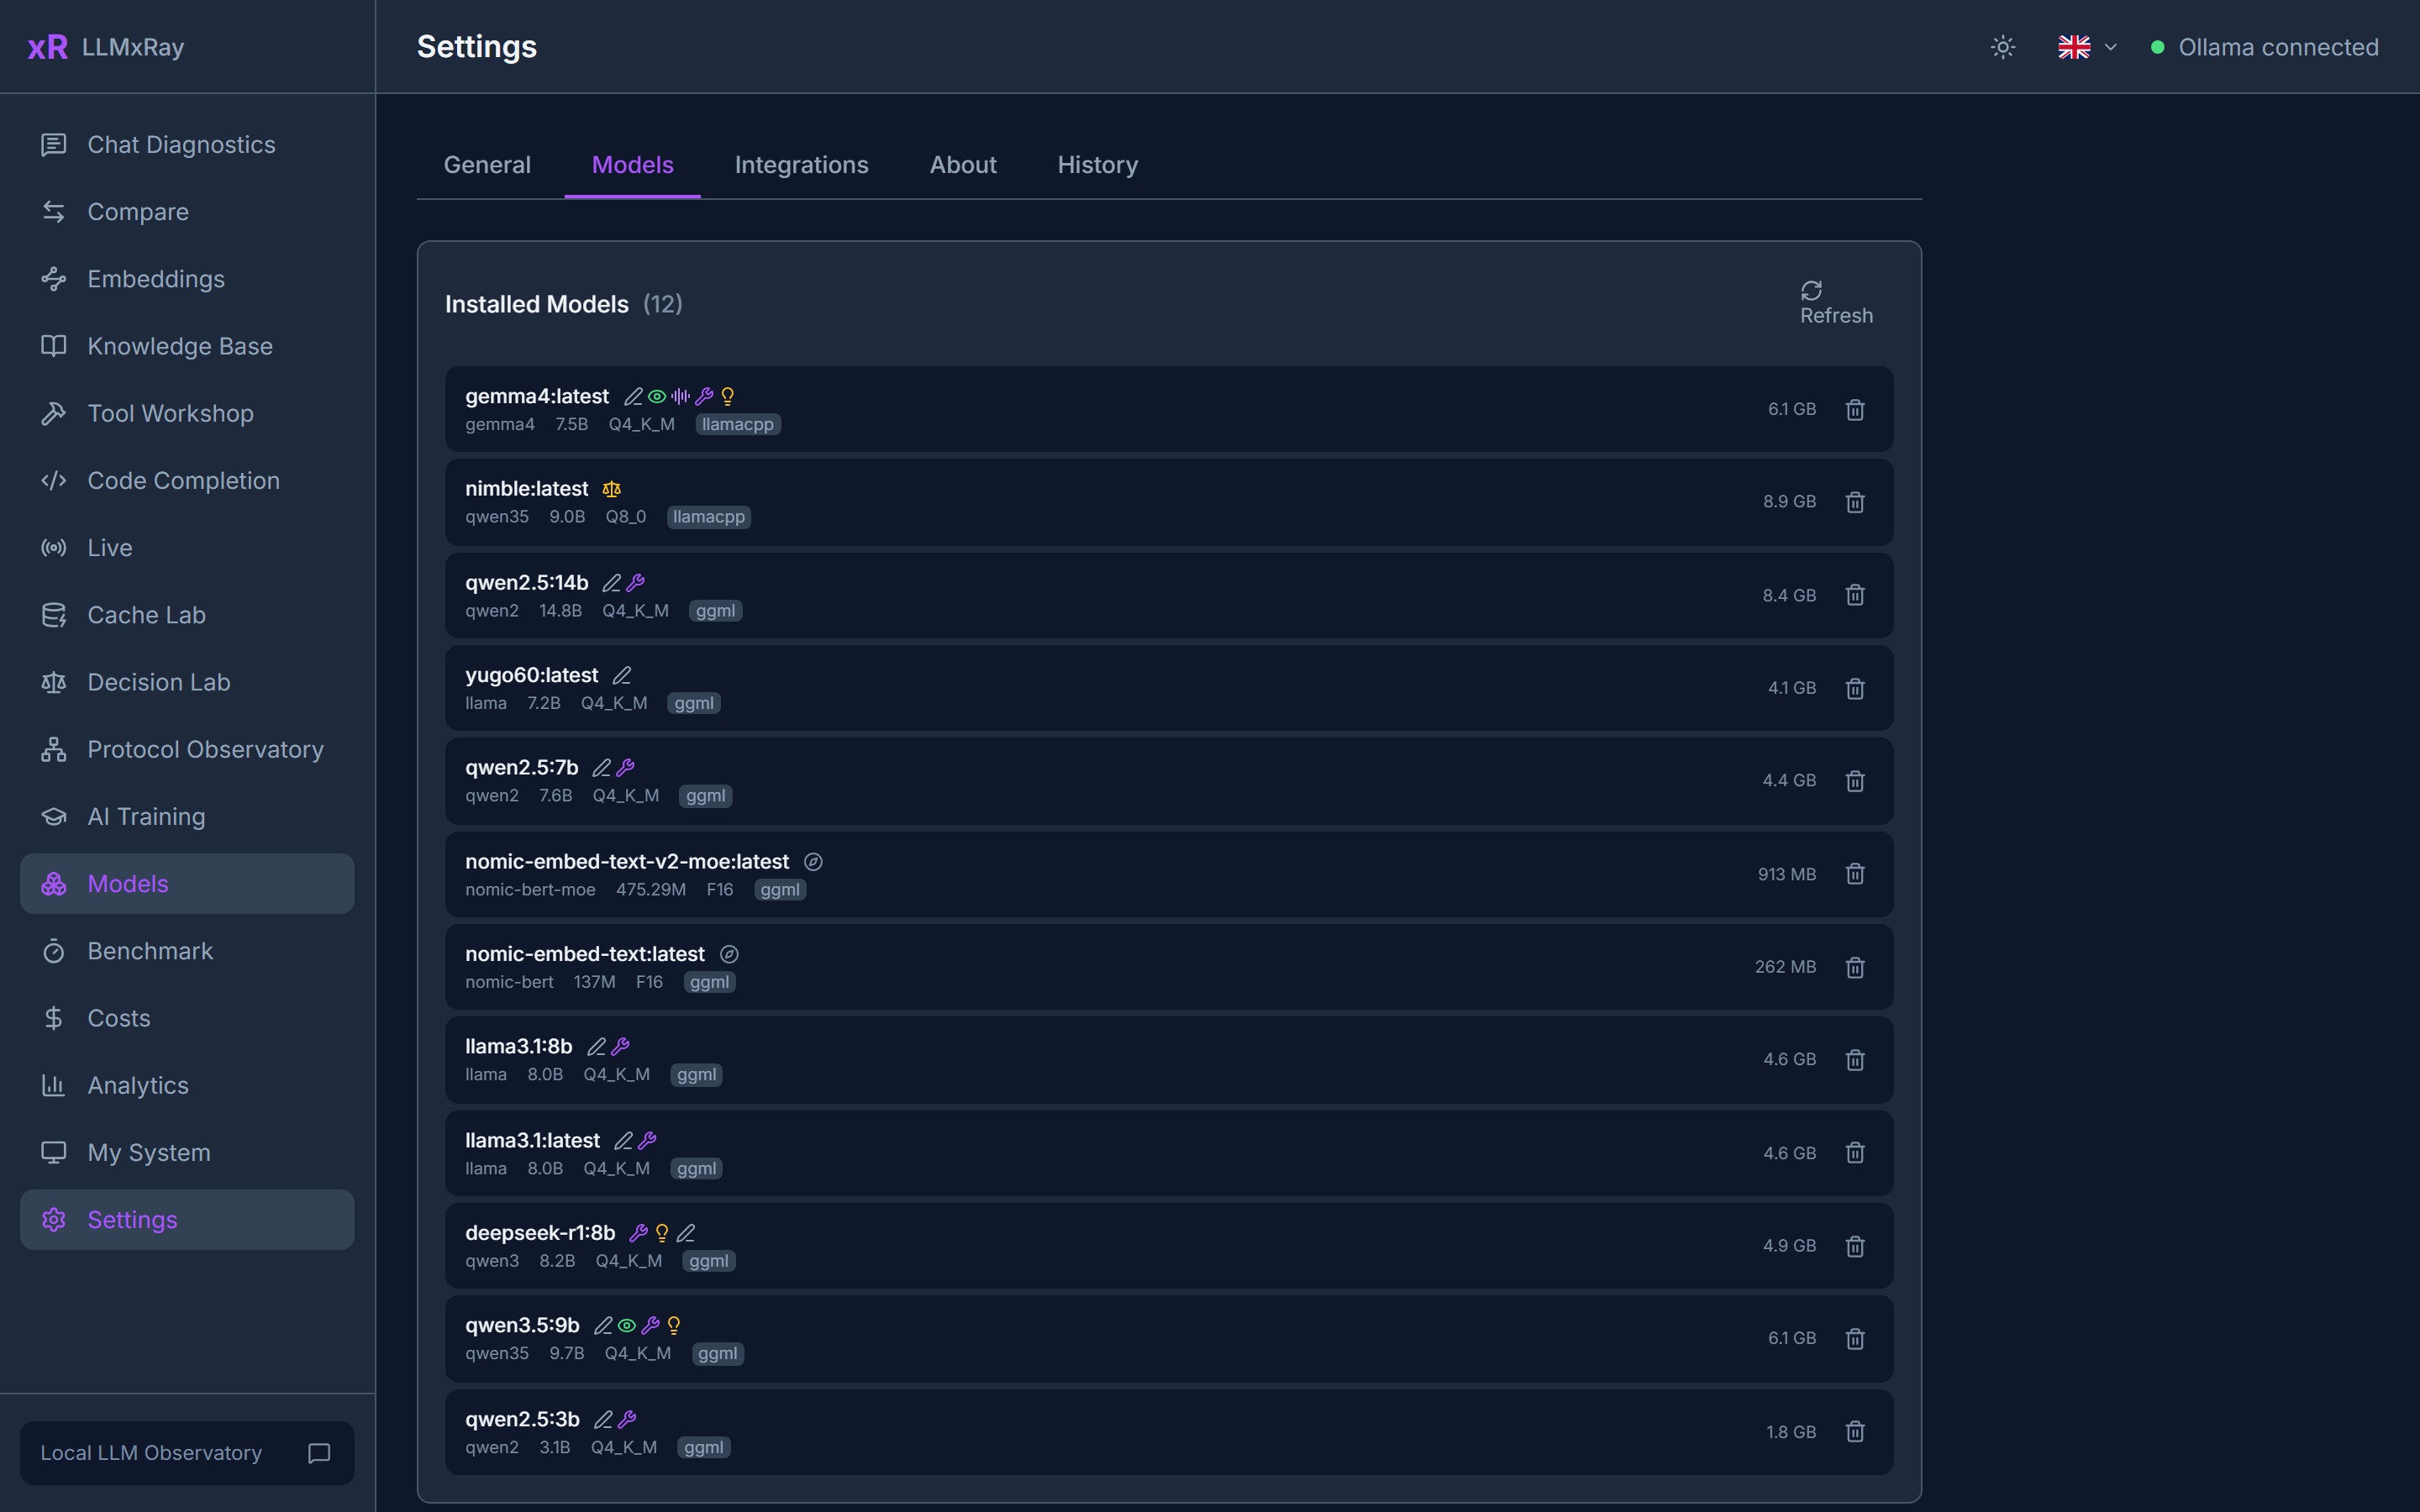
ハードウェア、ランタイム、推論の概要を1ページで確認できます。CPU、メモリ、GPU、読み込まれているモデルとその場所が表示されます。モデルタブには、インストール済みのすべてのモデルがパラメーター、テンプレート、ランナーとともに一覧表示され、カタログから新しいモデルを取得できます。
スクリーンショット
|
|
|
その他
- AI トレーニングパイプライン。 会話からペアを選別し、タグ付けとレビューを行い、ファインチューニング用の JSONL をエクスポートできます。
- ローカル履歴データベース。 すべてのチャット、比較、ベンチマークが IndexedDB にアーカイブされ、フィルター、傾向、エクスポート、保持ルールを利用できます。
- 教育者キット。 ドキュメントサイトにある9つのレッスンモジュール。それぞれが LLMxRay のページを中心に構成されています。
- 5言語に対応。 英語、フランス語、セルビア語(ラテン文字とキリル文字)、中国語、アラビア語に対応し、RTL レイアウトも利用できます。ヘブライ語と日本語の追加に向けたひな形も用意されています。
対象ユーザー
| あなたは… | LLMxRay でできること… |
|---|---|
| 開発者 | プロンプトのデバッグ、レイテンシのプロファイリング、モデルの比較、ツール呼び出しの調査、エディターが送信する内容の確認 |
| 研究者 | モデルや温度を問わず同じ設定で、制御された実験を実施 |
| 学生/教育者 | 読むだけでなくモデルの動作を観察し、9つのモジュールで構成された教育者キットを活用 |
| AI チームリーダー | すべての開発者に同じローカル環境を提供し、エクスポートされたベンチマーク結果とトレーニング用ペアを収集 |
インストール
npx(推奨)
npx llmxray
npx llmxray --port 3000
npx llmxray --ollama-url http://192.168.1.50:11434
npx llmxray --observe-port 11436     # the Live port, 11435 by default
Docker
docker run -p 5174:5174 -p 11435:11435 djovaneli/llmxray
docker run -p 5174:5174 -p 11435:11435 -e OLLAMA_URL=http://host.docker.internal:11434 djovaneli/llmxray
ソースから
git clone https://github.com/LogneBudo/llmxray.git
cd llmxray
npm install
npm run dev     # http://localhost:5173
Ollama との互換性
Ollama 0.40.x でテスト済みです(2026年10月に 0.40.6 で検証)。0.20 以降で動作します。古いバージョンでもチャットはできますが、think と JSON スキーマの format には対応していません。推奨:0.33.3 以降。プロンプトキャッシュの再利用が報告されるため、実際に評価されたトークン数に基づいてプリフィル速度を測定できます。
| エンドポイント | 用途 |
|---|---|
/api/chat | ストリーミングチャット(NDJSON、tools、think の推論レベル、スキーマ形式の format に対応) |
/api/generate | suffix による生成と Fill-in-the-Middle |
/api/tags、/api/show | モデル一覧、機能、コンテキスト長、パラメーター、テンプレート |
/api/embed | ナレッジベース用のベクトル埋め込み。オプションで dimensions による切り捨てに対応 |
/api/pull、/api/delete、/api/ps、/api/version | モデルの管理とステータス |
/v1/chat/completions | OpenAI 互換のパス。実際の logprobs を使う Surgical Benchmark で使用 |
/v1/messages | Anthropic 互換のパス。Protocol Observatory で使用 |
/v1/systemone | Decision Lab で使用する意思決定モデル |
内部の仕組み
Vue 3.5、TypeScript 6(strict)、Vite 8、Tailwind CSS 4、用途別の Pinia ストア、グラフ用の Chart.js と D3、ツールキャンバス用の Vue Flow、コード用の CodeMirror 6 を使用しています。アプリはチャット、比較、ベンチマーク、ナレッジベースのデータをブラウザーの IndexedDB に保存します。Live ログのターン記録は、LLMxRay を実行するマシン上の ~/.llmxray に保存されます。バックエンドにはローカルの Ollama を使用します。
ストリーミングでは、fetch() と ReadableStream を使って Ollama の NDJSON を読み取り、Pinia を通じてトークンごとに UI を更新します。Chat と Compare では、Ollama が返す実際の logprobs に基づいてトークンを色分けします。logprobs がない場合、トークンには色を付けません。また、トークンビューではタイミングを信頼度ではなくペースとして表示します。ベンチマークでも実際の logprobs を使用します。ハードウェア検出には、OS に直接問い合わせる小規模な Vite プラグインを使用します。Live ポートは透過的なプロキシです。すべてのリクエストを変更せずに Ollama に転送し、何も変換しません(OpenAI 互換および Anthropic 互換のルートは Ollama 自身が提供します)。また、件数と所要時間を記録し、その記録を30日間保持します。
| コマンド | 動作 |
|---|---|
npm run dev | 開発サーバー(ポート 5173) |
npm run build | 型チェックと本番ビルド |
npm run test | 単体テスト(Vitest) |
npm run test:e2e | エンドツーエンドテスト(Playwright) |
コントリビューション
コントリビューションを歓迎します。セットアップ方法とガイドラインについては、CONTRIBUTING.md をご覧ください。コミュニティによる翻訳も特に歓迎しています。ヘブライ語と日本語の翻訳用ファイルはすでに用意されています。
ライセンス
商標
LLMxRay は Ivan Stankovic (LogneBudo) の商標です。TRADEMARK.md をご覧ください。
LLMxRay が AI への理解に役立った場合は、ぜひスターを付けてください。
ほかの人がこのプロジェクトを見つけやすくなります。

コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。