lynx について
Lynxは、grepでは答えにくいコードの質問に対応する、開発者やコーディングエージェント向けのローカルMCPサーバーです。AST対応インデックス、ハイブリッド検索、オプションのコードグラフを組み合わせ、索引データを端末内に保持します。
主な機能
- 01AST対応のコード索引
- 02BM25と密ベクトル検索の併用
- 03オプションのコードナレッジグラフ
- 04コード、ドキュメント、PDFの一括索引
- 05ローカルMCPサーバーとCLI
活用シーン
- 01シンボル変更前に呼び出し元と影響範囲を追跡
- 02識別子が不明なコードの動作を検索
- 03利用中のライブラリバージョンの文書を検索
- 04変更ファイルに絞ったコードレビュー
MCP 対応
LynxはMCPクライアントに、コード検索、シンボル検索、グラフ照会、影響分析、ソース管理ツールを提供します。MCPハンドシェイク時に利用方法とガイドリソースも渡します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Lynx
LynxMCP は、grep では答えられないコードに関する質問に対応する、完全ローカル実行の MCP サーバーです。これは何を呼び出しているのか、変更すると何が壊れるのか、X を実行するコードはどこにあるのか、実際に使っているバージョンのライブラリはどのように動作するのか。AST を考慮したチャンク分割、BM25 と高密度検索のハイブリッド、オプションのコードナレッジグラフ、そしてコードと一緒にインデックス化されたライブラリのドキュメントや PDF を利用できます。あらゆる MCP クライアント(Claude Code、Cursor、Windsurf、Antigravity など)で動作します。




識別子が分かっていて、エージェントがすでにそれを把握している場合、grep は適切なツールです。Lynx は、grep では答えられない質問に対応します。動作に関する質問:「カメラのズームを制限している箇所はどこですか?」は、文字列検索では見つかりません。構造に関する質問:これは誰が呼び出しているのか、何がこれを継承しているのか、変更すると何が壊れるのか。ポリモーフィックなディスパッチは、テキスト上に痕跡を残しません。モデルの学習期限を超える知識:使用するフレームワークのバージョンのドキュメントをソースとしてインデックス化します。情報がマシンの外に出ることはありません。
grep では答えられないこと
各行は計測結果です。数値は以下のベンチマークから取得しています。
| 質問 | エージェントによる grep | Lynx |
|---|---|---|
「Field を継承しているのは?」(Django、4 階層にわたる 100 クラス) | クラスを見つけるたびに grep を実行し、合計 101 回 | graph_query を 4 回呼び出し、すべてのエッジに file:line を表示 |
「ApplyDamage を変更すると何が壊れる?」 | 名前がテキストで言及されている箇所 | impact:ホップ数とともに、推移的な呼び出し元をすべて表示し、再実行すべきテストも提示 |
| C#(Json.NET)で「セッション トークンを検証している箇所は?」 | hit@1 33% | hit@1 47% |
| 「使用しているバージョンでは、この API はどのように動作する?」 | モデルの記憶 | インデックス化したドキュメントと、その出典ページを添えて提示 |
grep のほうが優れている場合は、このページにその旨を記載しています。クラス名がそれ自体を説明している Guava(BloomFilter、RateLimiter)では、grep の順位のほうが高く、hit@1 は 73% 対 60% です。リポジトリ全体がエージェントのコンテキストに収まる場合は、組み込みツールで十分です。Lynx の効果が発揮されるのは、大規模なコードベース、モデルの知識が古くなったフレームワークのドキュメント、そしてゼロから調べ直す手間が無駄になる繰り返しのセッションです。
クイックスタート
# 1. Install the CLI (isolated, no venv ritual). About 460 MB on disk, no PyTorch.
pipx install lynx-mcp
#    or: uv tool install lynx-mcp

# 2. Create a config and point it at your project
lynx manager init
lynx source add myproject --type codebase --path /path/to/your/repo

# 3. Build the index (downloads the 130 MB embedding model on first run)
lynx build
lynx manager init はウェブ UI を開くことも提案します。ウェブ UI では、フォルダーピッカー付きのガイド形式のフォームから同じソースを追加できます。以下の手順は、どちらの方法でも利用できます。
AI が利用できるツールはすべて、同じ名前、同じ出力のコマンドとしても実行できます。lynx find-definition ApplyDamage、lynx impact ApplyDamage、lynx graph query --op callers --symbol ApplyDamage。スクリプトで使う場合は、いずれにも --json を追加してください。
次に、MCP クライアントに Lynx を登録します。ここでは Claude Code の例を示します。完全なガイドでは Cursor、Antigravity、汎用の stdio クライアントについて説明しています。または、lynx manager ui を使って設定スニペットを生成できます。
{
  "mcpServers": {
    "lynx": {
      "command": "lynx",
      "args": ["serve", "--config", "/absolute/path/to/config.json"]
    }
  }
}
サーバーは約 1 秒で MCP ハンドシェイクに応答し、バックグラウンドでインデックスを開きます。それより前に呼び出しが届いた場合は、読み込み中の状態を返し、再試行されます。ターミナルを使いたくない場合は、macOS と Windows 用のダブルクリックで実行できるインストーラーを利用できます。
AI が利用するツール
ツールセットは固定されており、ソースの数が増えても増加しません。また、階層化されています。各ツールの定義は、毎回のターンでクライアントのコンテキストに含まれるためです。プロファイルは 3 種類あります。core(5 ツール、定義は約 1,300 トークン)、standard(10 ツール、約 2,800 トークン、デフォルト)、full(17 ツール、約 4,150 トークン)です。config.json で tools.profile を設定するか、lynx serve --profile full を渡してください。tools.include を使うと、プロファイルに 1 つのツールを追加できます。該当するツールには source 引数を指定します。
| ツール | プロファイル | 回答する内容 |
|---|---|---|
search(query, source?, outline?) | core | 基本となるハイブリッド検索です。すべてのソースを一度に検索するには、source を省略します(RRF 融合)。outline=true を指定すると、低コストでトリアージできるよう、シグネチャのみを返します。 |
deep_search(queries, source?) | standard | エスカレーション用です。品質しきい値を満たすまで、複数のクエリ表現を試します。 |
graph_query(operation, symbol?) | standard | callers、callees、subclasses、superclasses、imports、neighbors、shortest_path、overview、surprising_connections、status。 |
find_definition(symbol) | standard | X はどこで定義されていますか?(グラフが有効な場合は AST に基づいて正確に検索し、それ以外の場合は BM25 にフォールバックします。) |
find_usages(symbol) | core | X のすべての使用箇所です。呼び出しだけでなく、ジェネリクス、デコレーター、ドキュメントなどの非呼び出し参照も含みます。 |
find_tests_for(symbol) | full | X のテストはありますか? |
find_similar(snippet) | full | このようなコードはすでに存在しますか? |
describe_symbol(symbol) | core | X のコンテキストを一度の呼び出しで取得します。定義、呼び出し元、呼び出し先、テストを確認できます。 |
impact(symbol) | core | 影響範囲を確認します。呼び出しグラフを通じて、X に推移的に到達するすべての要素(ホップ距離付き)に加え、再実行するテストも表示します。 |
module_summary(file) | full | ファイル全体の概要です。定義されているシンボル、インポートしているもの、そのファイルに依存するファイルを確認できます。(グラフ) |
repo_overview() | standard | 「これは何で、どこから始めればよいですか」という質問に答えます。検出された言語、フレームワーク、エントリーポイント、ビルド/テスト/実行コマンドを確認できます。 |
export_graph(target, mode?) | full | 共有可能なオフラインのグラフビュー(シンボルの影響範囲またはファイルのハブ)を、単一の自己完結型ファイルとして描画します。(グラフ) |
search_diff(query, base?) | standard | ベースブランチと比較して変更されたファイルのみを検索します。コードレビュー向けに設計されています。 |
feedback(trying_to_do, tried, stuck) | core | インデックスで回答できなかった場合、エージェントがレポートを送信します。レポートは 100% ローカルに保存され、ソースを調整するためのシグナルになります。 |
list_sources / get_rag_status / update_source_index | full | 内部状態の確認とメンテナンスです。 |
検索ツールには MCP の readOnlyHint アノテーションが付いているため、クライアントは自動承認できます。書き込みを行うのは export_graph のみで、グラフビューのファイルを保存します。サーバーは MCP ハンドシェイクで使用ガイド(instructions と lynx://guide リソース)を提供するため、ルールファイルを設定しなくても、エージェントは適切な検索方法を把握できます。
(グラフ) ツールを使うには、ソースに対してオプションのコードナレッジグラフを有効にする必要があります。ツールセットは機能ごとに設定され、ソースごとに設定されることはありません。
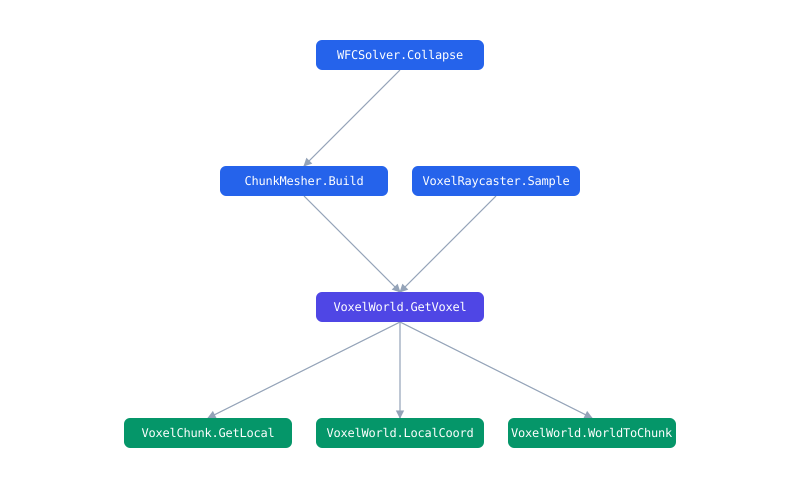
共有可能なグラフビュー:lynx graph export --symbol GetVoxel を実行すると、シンボルの影響範囲、呼び出し元(上)、呼び出し先(下)を含む、自己完結型のオフラインファイルが 1 つ作成されます(サーバーも CDN も不要)。PR に添付したり、監査用にアーカイブしたりできます。
flowchart LR
    A["Your code + docs + PDFs"] --> B["Tree-sitter<br/>AST chunker"]
    B --> C["bge-small<br/>dense embeddings"]
    B --> D["code-tokenized<br/>BM25"]
    B --> G["Code knowledge graph<br/>(opt-in)"]
    C --> R{{"RRF fusion"}}
    D --> R
    Q(["Your query"]) --> R
    R --> RR["Optional<br/>reranker"]
    RR --> RES["Ranked code<br/>file : line : symbol"]
    G --> GT["Graph tools<br/>callers · subclasses · usages"]

    classDef store fill:#fff3e6,stroke:#e8742c,color:#24292f;
    classDef out fill:#e8742c,stroke:#e8742c,color:#fff;
    class C,D,G store;
    class RES,GT out;
- Tree-sitter が 18 以上の言語(TSX を数えると 19 の文法)を解析し、任意のテキスト範囲ではなく、関数やクラス全体をインデックス化します。
- 検索はハイブリッド方式です。密ベクトル埋め込みとコードトークン化 BM25 を RRF で融合し、オプションでクロスエンコーダーのリランカーを使用します。
- コードナレッジグラフ(オプトイン)には、呼び出し関係、継承、インポートが記録され、「これを変更したら何が壊れるか?」という質問に、実際の影響範囲を回答します。
- 検索対象には、コードベース、公開ドキュメントサイト(必要に応じて一度取得。オプションのヘッドレス Chromium を使えば JavaScript でレンダリングされた SPA にも対応)、PDF を指定でき、並べて検索できます。
- ファイルを保存すると、ファイルウォッチャーが約 2 秒で再インデックス化します。手動で再ビルドする必要はありません。
- 検索とグラフは、ローカル HTTP API を通じて行としても提供されるため、SQL エンジンでコードとチケット、PR、ログを結合できます(統合を参照)。
lynx manager uiを実行すると、ブラウザーでガイド付きセットアップ、クエリプレイグラウンド、診断、クライアント設定スニペットを利用できます。
すべてローカルで実行されます。HuggingFace モデルは一度ダウンロードされ、その後 Lynx はオフラインモードに切り替わります。テレメトリも、クラウドインデックスも、コードのアップロードもありません。ネットワークへのアクセスは、モデルのダウンロードと、自分で明示的に実行する webdoc の取得ステップのみです。
モデルは ONNX Runtime で実行されるため、インストールに PyTorch は含まれません。ディスク上のサイズは約 460 MB で、Linux でのダウンロードサイズは 165 MB です。以前は torch のホイールだけで 4 GB の CUDA ライブラリが追加されていました。同じモデル、同じベクトルを使うため、以前のバージョンで構築したインデックスも引き続き使用できます。
1 つのインデックスで、好きなだけセッションを同時に開けます。エディターのウィンドウを 2 つ開く、エディターとウェブ UI を併用する、サーバーの実行中に CLI からクエリを実行する、といった使い方ができます。すべて同じインデックスを検索します。排他制御されるのはインデックス作成のみで、作成中のプロセスを閉じると、別のプロセスに自動で引き継がれます。
ファイアウォールの背後、またはエアギャップ環境のマシンで使用しますか? モデルはミラー、このリポジトリの GitHub Releases(自動フォールバック)、または持ち込んだアーカイブから取得できます。ガイドの制限されたネットワークを参照してください。
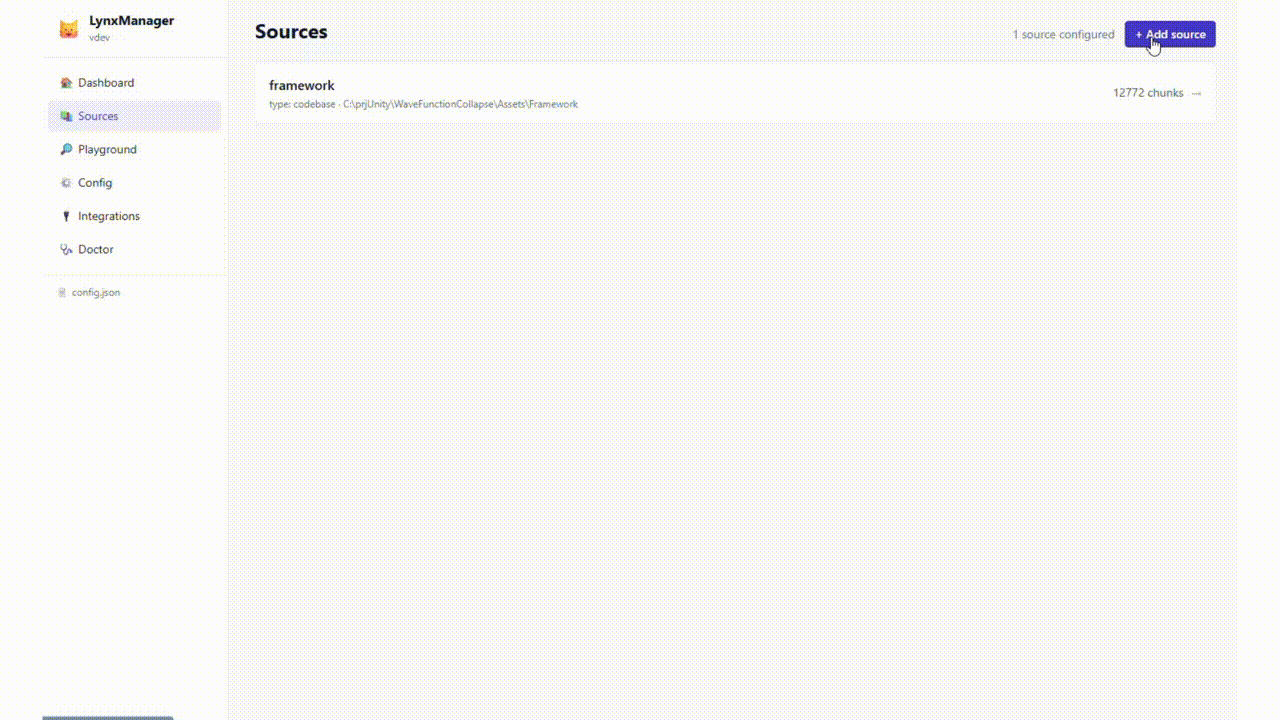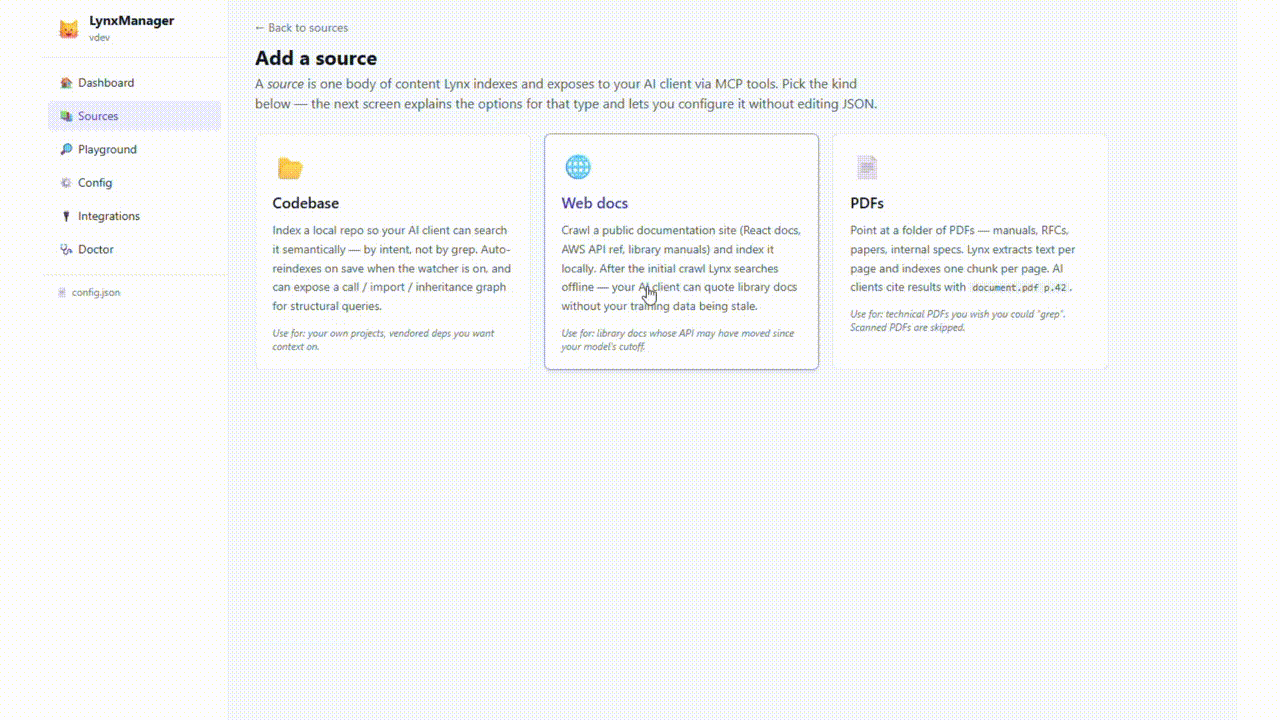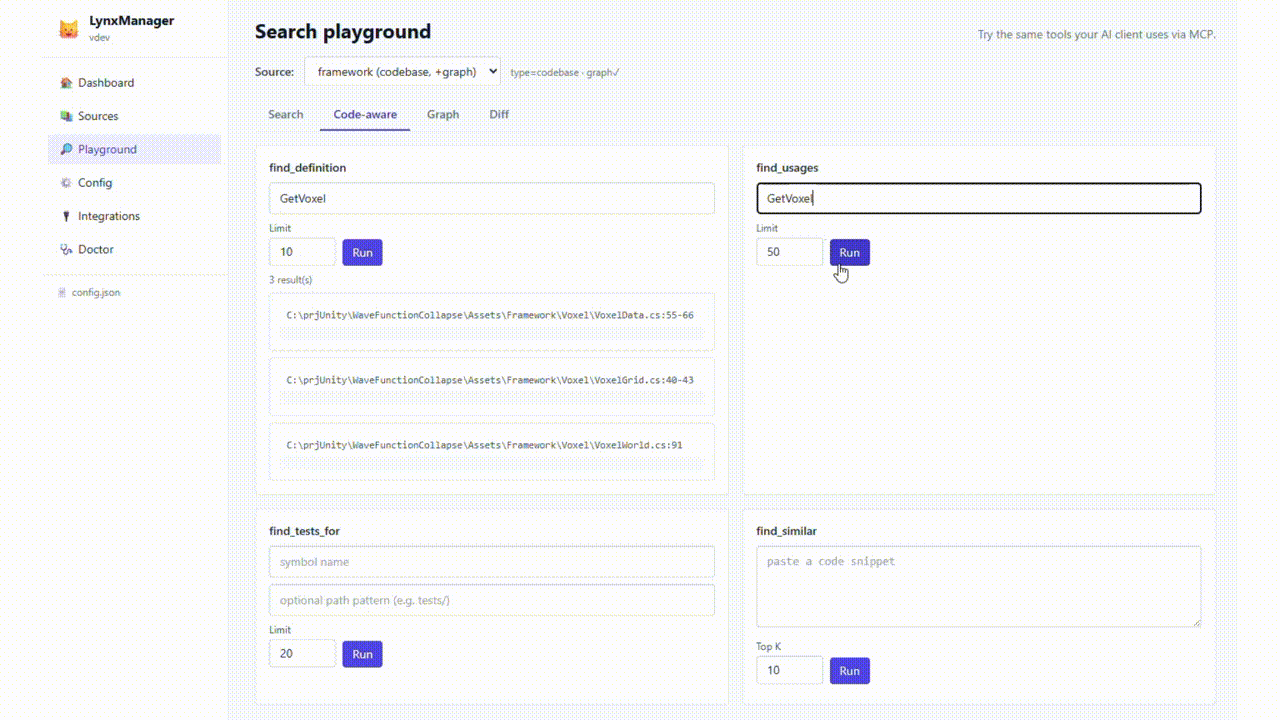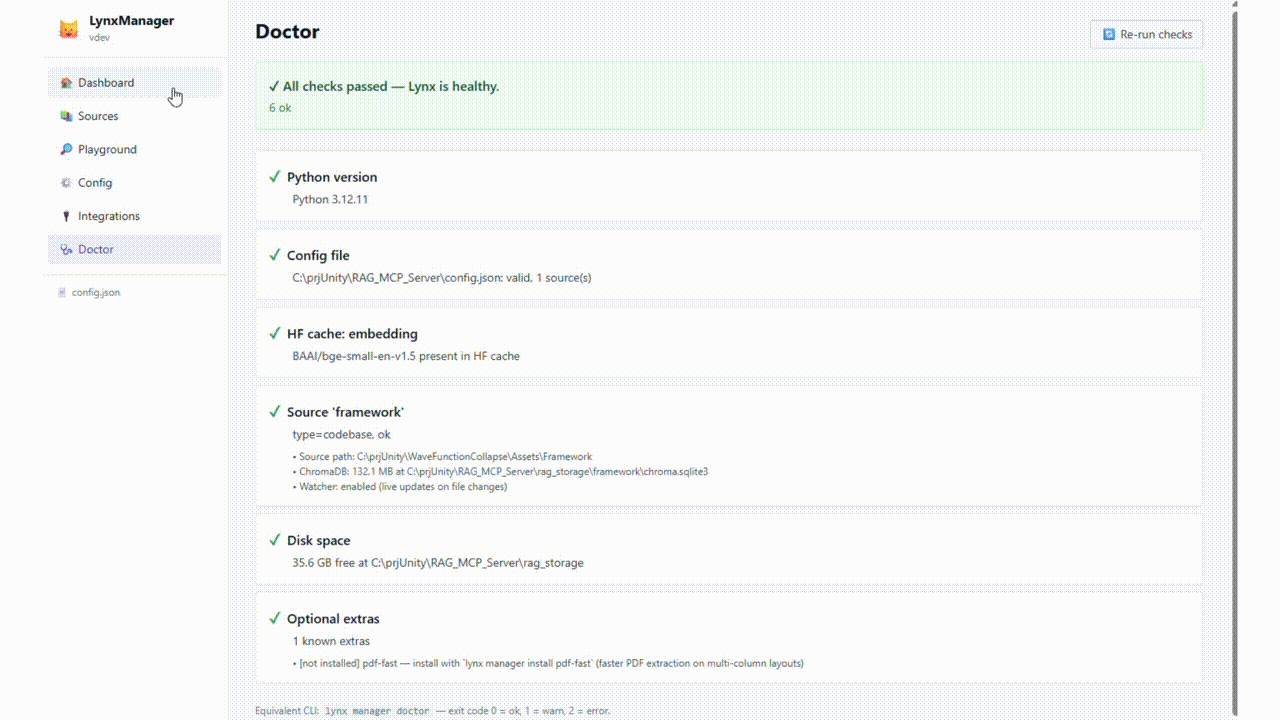
LynxManager:ガイド付きセットアップ、クエリプレイグラウンド、診断をすべてブラウザーで利用できます。詳しい手順
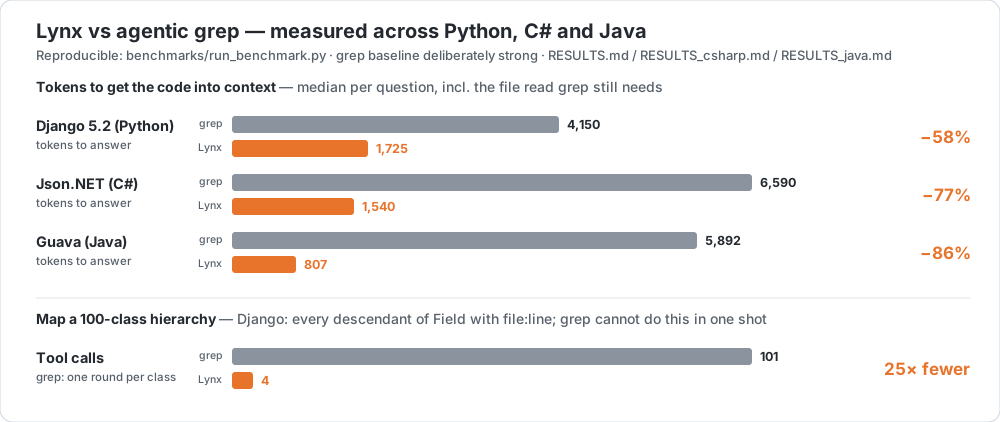
3 つのコードベース、3 つの言語、正解となるファイルがわかっている動作に関する質問、そして強力な grep ベースライン(理想的なストップワード除去を伴う IDF 重み付き複数キーワードランキングで、エージェントが最初に実行する rg よりも BM25 に近いもの)を用意しました。方法論とタスクごとの結果:Django、Json.NET、Guava。
| grep / Lynx | Django 5.2(Python) | Json.NET(C#) | Guava(Java) |
|---|---|---|---|
| コーパス | 883 ファイル、158k 行、20 問 | 240 ファイル、69k 行、15 問 | 606 ファイル、181k 行、15 問 |
| hit@5 | 95% / 85% | 67% / 73% | 93% / 80% |
| hit@1 | 45% / 55% | 33% / 47% | 73% / 60% |
| MRR | 0.64 / 0.67 | 0.47 / 0.58 | 0.81 / 0.70 |
| 回答までのトークン数の中央値 | 4,150 / 1,725 | 6,590 / 1,540 | 5,892 / 807 |
| コードがコンテキストに入るまでのツールの往復回数 | 2+ / 1 | 2+ / 1 | 2+ / 1 |
ランキングの優劣は、コードの自己説明性によって変わります。PascalCase の識別子とコメントの少なさが語彙ベースラインの精度を下げる C# では Lynx が優位です。Python では結果が分かれ、docstring が豊富な Django で hit@1 は上回る一方、hit@5 では下回ります。Guava では下回ります。トークンコストは変わりません。どのケースでも 58% から 86% 削減されます。これは Lynx が関数全体を file:line、シンボル、スコアとともに 1 回の呼び出しで返すのに対し、grep は一致した行を返し、その後に読み込みが必要になるためです。
構造的な差は別の種類のものです。Django の 100 クラスからなる階層について「何が Field を継承していますか?」と尋ねると、grep は見つかったクラスごとに 1 回、増え続けるコンテキストに対してモデルの推論を行うため、101 回のラウンドが必要です。graph_query は解決済みの継承エッジから 4 回の呼び出しで同じ再現率の回答を返し、すべてのエッジに file:line を付けます。
# reproduce: Python (Django)
git clone --depth 1 --branch 5.2 https://github.com/django/django.git benchmarks/_target/django
python benchmarks/run_benchmark.py && python benchmarks/structural_demo.py

# reproduce: C# (Json.NET)
git clone --depth 1 https://github.com/JamesNK/Newtonsoft.Json.git benchmarks/_target/jsonnet
python benchmarks/run_benchmark.py --tasks benchmarks/tasks_jsonnet.json \
  --target-dir benchmarks/_target/jsonnet --storage-dir benchmarks/_storage_csharp \
  --results-json benchmarks/results_csharp.json --results-md benchmarks/RESULTS_csharp.md

# reproduce: Java (Guava)
git clone --depth 1 https://github.com/google/guava.git benchmarks/_target/guava
python benchmarks/run_benchmark.py --tasks benchmarks/tasks_guava.json \
  --target-dir benchmarks/_target/guava --storage-dir benchmarks/_storage_java \
  --results-json benchmarks/results_java.json --results-md benchmarks/RESULTS_java.md
トークンと費用の内訳
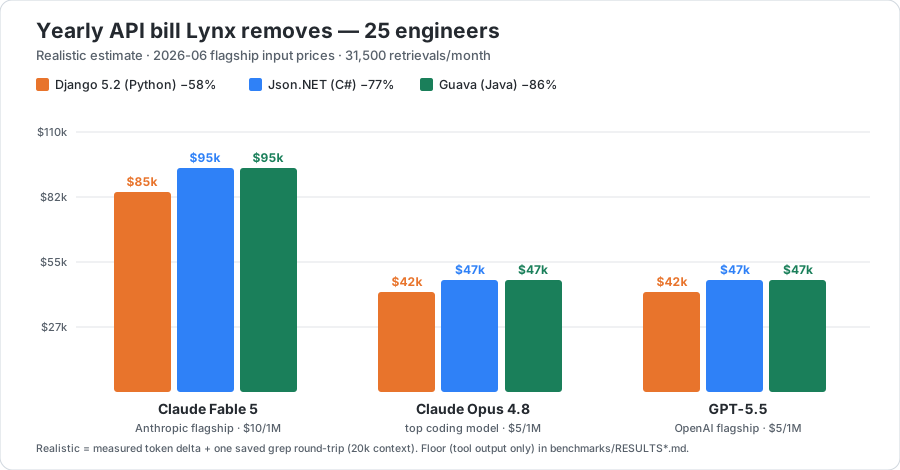
取得 1 回あたりの削減量は、上記で測定した差分、つまり回答をコンテキストに入れるまでに 2,400 から 5,100 トークンです。セッションごとのツール定義には 1,300 トークン(core)、2,800 トークン(standard)、または 4,150 トークン(full)が必要なため、1 回目または 2 回目の取得でツールリスト分のコストを回収できます。outline によるトリアージで、幅広いクエリの検索ステップをさらに 2.4 倍短縮できます(測定結果)。
費用面では、エンジニア 25 人が 1 日に 60 回取得する場合(1 か月あたり 31,500 回)、3 つのコードベース全体で、Lynx によって削減される年間 API 請求額は次の範囲になります。
| 主要モデル(入力 $/1M) | 測定された下限 | 削減される往復を含む場合 |
|---|---|---|
| Claude Fable 5($10) | $9,200 ~ $19,200 | $16,700 ~ $26,800 |
| GPT-5.5、Claude Opus 4.8($5) | $4,600 ~ $9,600 | $8,400 ~ $13,400 |
下限の計算に含まれるのは、ツール出力が小さくなることによる削減分だけで、前提条件はありません。2 列目では、Lynx が削減する grep の往復 1 回分を加算しています。この往復では、20k トークンのコンテキストがプロンプトキャッシュから入力料金の 10 分の 1 で再読み込みされます。この割引が唯一のモデル上の前提条件で、調整可能です。自分のチーム、料金、コードベースで計算するには、python benchmarks/savings_calculator.py --devs N を実行するか、インタラクティブな削減額計算ツールを使ってください(pricing.json と measured.json のプリセットは編集できます)。
 ## 少ない情報を読む:アウトラインモード
検索結果の順位付けは、どのモードでも同じです。search(query, outline=true)(または HTTP 経由で ?view=outline)は、本文を除いた同じ順位の検索結果を返します。内容は、1 行のシグネチャと docstring の最初の行です。これにより、エージェントは候補を確認し、引用された file:line を使って必要な本文だけを読み取れます。公開リポジトリ(psf/requests)では、検索ステップのトークン数を 2.4 倍削減できました。どちらを使うべきか、測定データとグラフについては、docs/OUTLINE.md をご覧ください。
インテグレーション
検索とコードグラフは、ローカル HTTP API(/api/v1)を介して NDJSON で提供されます。また、MCP ツールは、エージェントが利用する他の MCP サーバーと組み合わせられます。以下の処理はすべてお使いのマシン上で行われ、結合先(GitHub、Jira、Sentry)のみが API にアクセスします。
- Coral:Lynx は Coral のレジストリにコミュニティソースとして登録されています。
lynx.searchと 6 つのグラフ関数を使うことで、振る舞いに関する質問を、GitHub や Sentry のライブデータと結合できる SQL テーブルに変換します。 - DuckDB:
read_ndjson_auto('http://127.0.0.1:8765/api/v1/search?...')はテーブルとして扱えます。プラグインもデーモンも不要です。コードの関連性を、Git の変更状況、エラーログ、チケットのエクスポートと結合できます。 - Steampipe:
lynx_source、lynx_search、lynx_graphテーブルを備えたプラグインです。行ごとに結合し、別のテーブルの各行に対して 1 回ずつ検索します。リリースページから、macOS および Linux 向けのビルド済みバイナリを入手できます。 - GitHub Action:すべての PR に、下流の呼び出し元と意味的に関連するコードをコメントします。インデックス作成はランナー上でローカルに行われます。
- MCP レシピ:Lynx を GitHub、Sentry、Jira の MCP サーバーと組み合わせるエージェントのパターンです(トリアージ、PR の影響分析、チケットからコードへの追跡)。
ドキュメント
| 完全ガイド | 設定、すべてのソースタイプ(コードベース/ウェブドキュメント/PDF)、検索の内部処理、ツールプロファイル、トラブルシューティング |
| Manager UI | ガイド付きセットアップ、プレイグラウンド、診断 |
| アウトラインモード | 本文の代わりにシグネチャを表示:使いどころ、測定データ、グラフ |
| Coral / DuckDB / Steampipe | コード検索とコードグラフを SQL テーブルとして利用 |
| MCP レシピ | Lynx と GitHub / Sentry / Jira の MCP サーバーの組み合わせ |
| PR の影響分析(GitHub Action) | 下流の呼び出し元と関連コードを、すべての PR にコメント |
| config.example.json | 注釈付きの設定例 |
ステータス
1 人の開発者が開発しており、1.x が安定するまでは API が変更される可能性があります。Issue や PR を歓迎します。テストスイートは pytest で実行し、CI は常に成功する状態を保つ必要があります。検討中の項目(および明示的に予定していない項目)については、ROADMAP.md をご覧ください。
ライセンス
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。