Mathlas について
Mathlasは、数学研究向けエージェントやMCPクライアント用の数学ツールサーバーです。定理検索、数値の特定、検証を行い、LeanカーネルやPSLQ、完全一致などで結果を確かめます。内部でLLMは呼び出しません。
主な機能
- 01368万件の数学文書を検索
- 02定数と整数列の特定
- 03数値とLeanの主張を検証
- 04定理の適用条件リストを生成
- 05PSLQによる定数関係の検査
活用シーン
- 01数学の問いに関連する定理の検索
- 02未知の定数やOEISの数列の特定
- 03数値の主張やLeanの証明の確認
- 04定理の前提条件の充足状況の評価
MCP 対応
Mathlasは検索、特定、検証を行う12種類のデータ返却ツールをMCPクライアントに公開します。APIキー不要でstdio接続でき、一部機能にはローカルのOEISデータまたはLeanツールチェーンが必要です。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx mathlas-mcpMATHLAS_SEEDSet to 1 to force the lightweight built-in seed corpus and never load the multi-GB prebuilt index (fast cold start).MATHLAS_INDEXPath to a prebuilt index .npz to serve for search_existing_math (optional; the seed corpus is used when absent).ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
mathlas


公開先:mcp.so · Glama · awesome-mcp-servers および best-of-lean4 に掲載されています。
AI が使う、厳密な数学のツールです。LLM も API キーも不要で、無料です。 Claude Code、Cursor、または任意の MCP クライアントに接続できます。AI が頭脳で、mathlas は手です。AI に不足している機能を提供し、AI が推論するためのデータ(候補、判定、チェックリスト、足場)を返します。 Apache-2.0。コードはあらゆる用途で無料で使えます。公開されているコーパス/インデックスの成果物には、ソースごとに独自の利用条件(CC-BY/CC0)が適用されます。
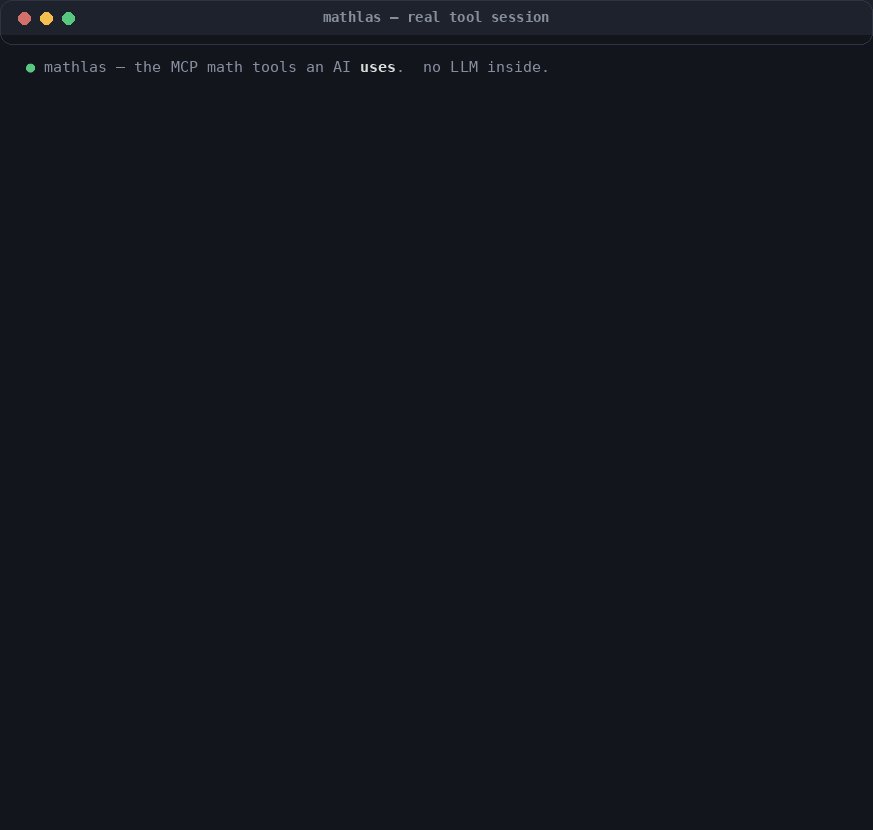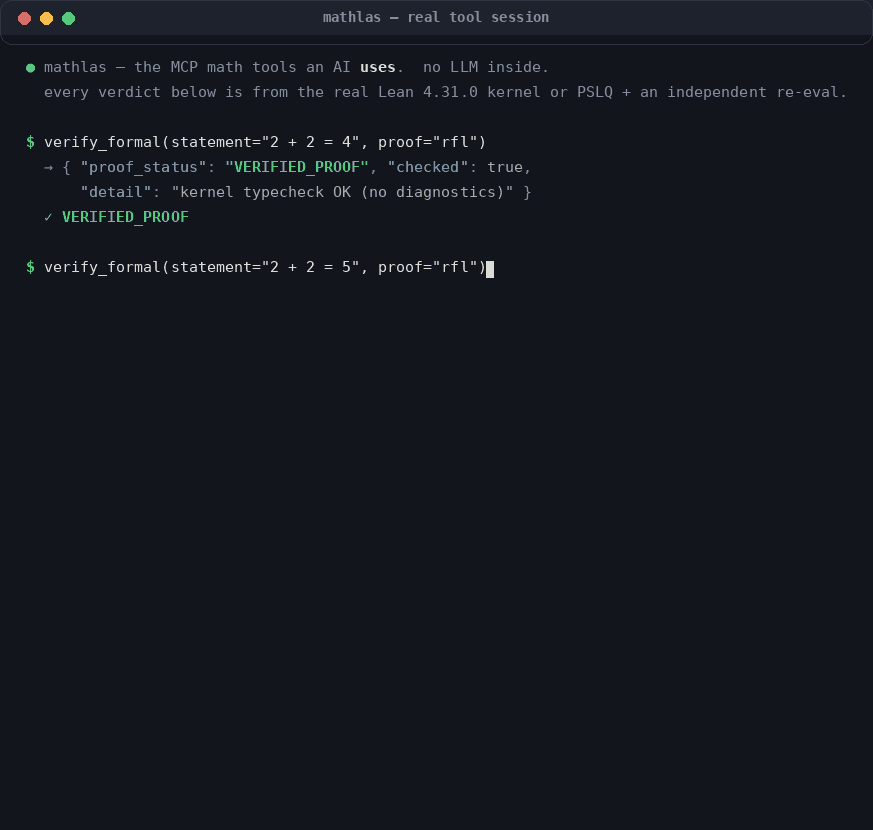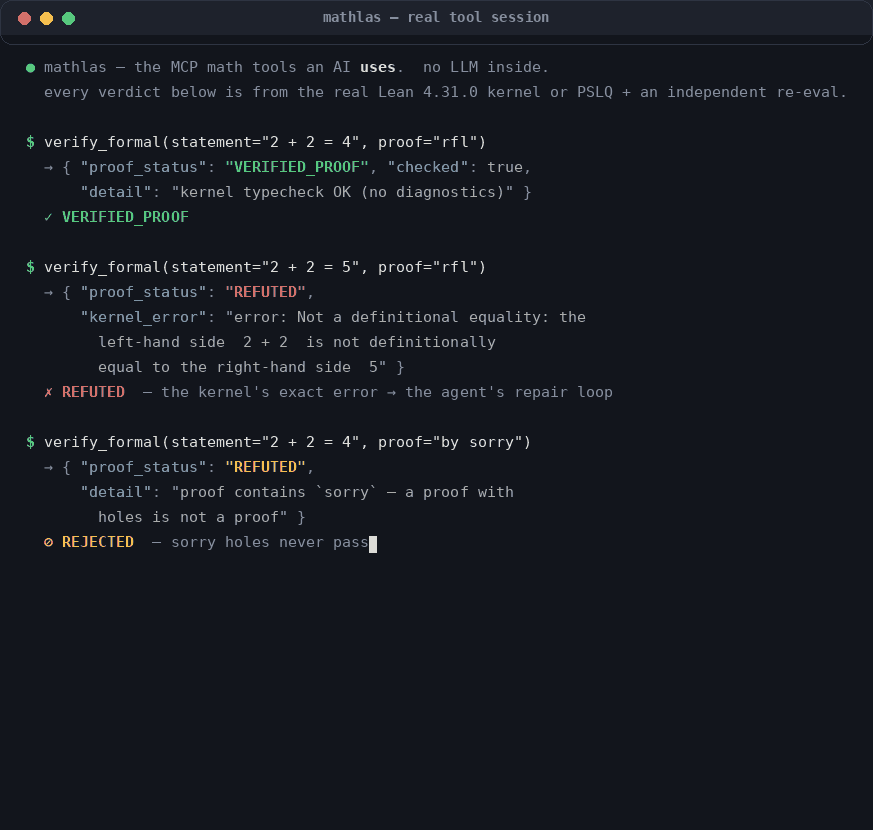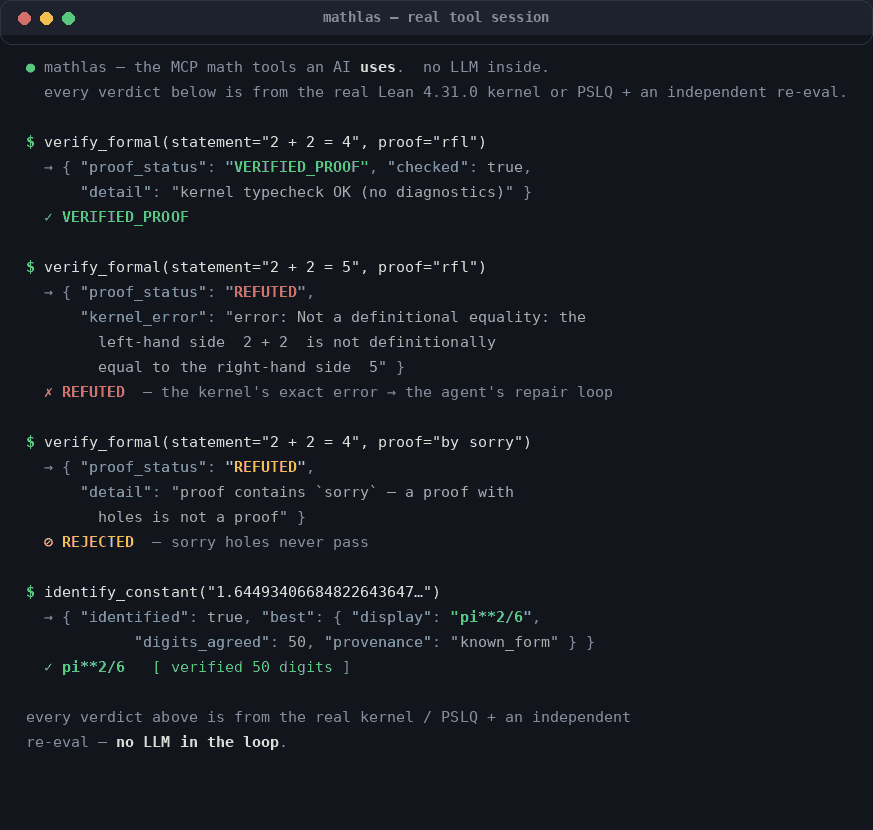
すべての判定は実際の Lean 4.31.0 カーネル/PSLQ と独立した再評価によるものです。内部に LLM はありません。 実際のプロセス内ツール出力を、assets/gen/capture_outputs.py で取得しました。
こんな方におすすめです
- Claude Code / Cursor を使っていて、AI に数学の幻覚をやめさせたい方 —
search_existing_mathは368万件の文書インデックスから実際の定理を見つけます。verify_numericとverify_formalは幻覚のリスクゼロで主張を検証します。 - 特定できない数値定数や整数列がある方 —
identify_constantは PSLQ と閉形式マッチングを実行します(50桁精度)。identify_sequenceは OEIS の項と厳密に照合します。 - ある結果の形式的な(Lean/mathlib での)名前が必要な方 —
search_formal_mathは公開されている Loogle と LeanSearch のサービスをプロキシし、出典情報付きで宣言名と型を返します。 - 厳密な数学を組み込んだエージェントのパイプラインを構築している方 — 12種類のツールはすべて、データのみを返す MCP ツールです。内部に LLM はなく、どのフレームワークとも組み合わせられます。
Claude Code へのインストールと登録(API キー不要)
1 行だけで、事前のインストールは不要です(uv が必要です)。
claude mcp add mathlas -- uvx mathlas-mcp
初回の使用時に、uvx mathlas-mcp がサーバーを取得し、分離された環境で実行します。pip を使う場合は?
pip install mathlas-mcp              # core: numeric + retrieval + verify + scaffolds
pip install 'mathlas-mcp[mcp]'       # + official MCP SDK
pip install 'mathlas-mcp[retrieve]'  # + pyarrow, to read the real index
pip install 'mathlas-mcp[embed]'     # + sentence-transformers/torch, for the Qwen3 embedder

claude mcp add mathlas -- python -m mathlas.server
mathlas が、エージェントが呼び出せる12 個のツールとして表示されます。サーバーは公式の mcp SDK を優先し、mcp がインストールされていない場合は依存関係不要の stdio JSON-RPC サーバーにフォールバックします。常に実行できます。(Cursor/任意の MCP クライアントでは、同じ uvx mathlas-mcp または python -m mathlas.server の stdio コマンドを指定してください。)
任意のローカルデータ(正直に機能を制限します):
identify_sequenceにはローカルの OEIS コピーが必要で、verify_formalには Lean ツールチェーンが必要です。これらがない場合、ツールは「データ/ツールチェーンを利用できません」と明確に返します。偽の回答を返すことはありません。それぞれを 1 行でセットアップする方法については、docs/methods.mdを参照してください。
使用例 — ツールを使う AI
User:  "Does x = cos(x) have a unique solution I can reach by iterating?"

AI →   search_existing_math("contraction mapping unique fixed point complete metric space")
       ← [{name:"Banach Fixed-Point Theorem", statement:"Let (X,d) be a complete metric
            space and T a contraction. Then T has a unique fixed point ...", ...}, ...]
AI →   applicability_checklist(banach.statement)
       ← preconditions: ["(X,d) is a complete metric space", "T: X→X is a contraction"]
          conclusion:    "T has a unique fixed point"
AI  (reasons): [0,1] is complete; cos is a contraction there (|cos'|=|sin|≤sin 1<1).
       Every precondition holds ⇒ Banach applies ⇒ unique fixed point, reachable by iteration.
AI →   verify_numeric("0.7390851332151607", "<the Dottie-number closed form, if claimed>")
mathlas は検索、チェックリスト、そして厳密な数値検証を提供しました。判定を行ったのは AI です。mathlas 内部では LLM は呼び出されていません。
結果
この取り組みの原則は完全な検証か、結果なしのどちらかです。結果は独立して検証可能な事実か、正直な「何もありません」のどちらかです。すべてのティアで偽陽性率は 0 です(表とコマンドの全容は RESULTS.md を参照してください)。
| ティア | 既知の結果の再現率 | 偽陽性 | 厳密に検証できる理由 | ベンチマーク |
|---|---|---|---|---|
数値(identify_constant) | 8/8 | 0/3 | 独立した高精度での再評価(50~51 桁) | benchmarks/numeric_bench.py |
数列(identify_sequence) | 8/8(上位 1 件は 7 件) | 0/3 | ローカル OEIS(約 40 万個の数列)との項の完全一致 | benchmarks/tier_bench.py |
形式検証(verify_formal) | 判定 7/7 | — | 実際の Lean 4.31.0 カーネルによる型チェック | benchmarks/tier_bench.py |
ラマヌジャン(conjecture_relation) | 6/6 | 0/2 | PSLQ + CF。見つかった結果はすべて 25 桁以上で再検証 | benchmarks/tier_bench.py |
| 適用可能性の堀 | 分解 15/15 + 検出 6/6 | — | 原子的な前提条件、誤適用の罠 | benchmarks/moat_bench.py |
| FunSearch + Web 拡張 | 14/14 | — | サンドボックスによる封じ込め(ネットワーク/タイムアウト/メモリ) | benchmarks/tools_bench.py |
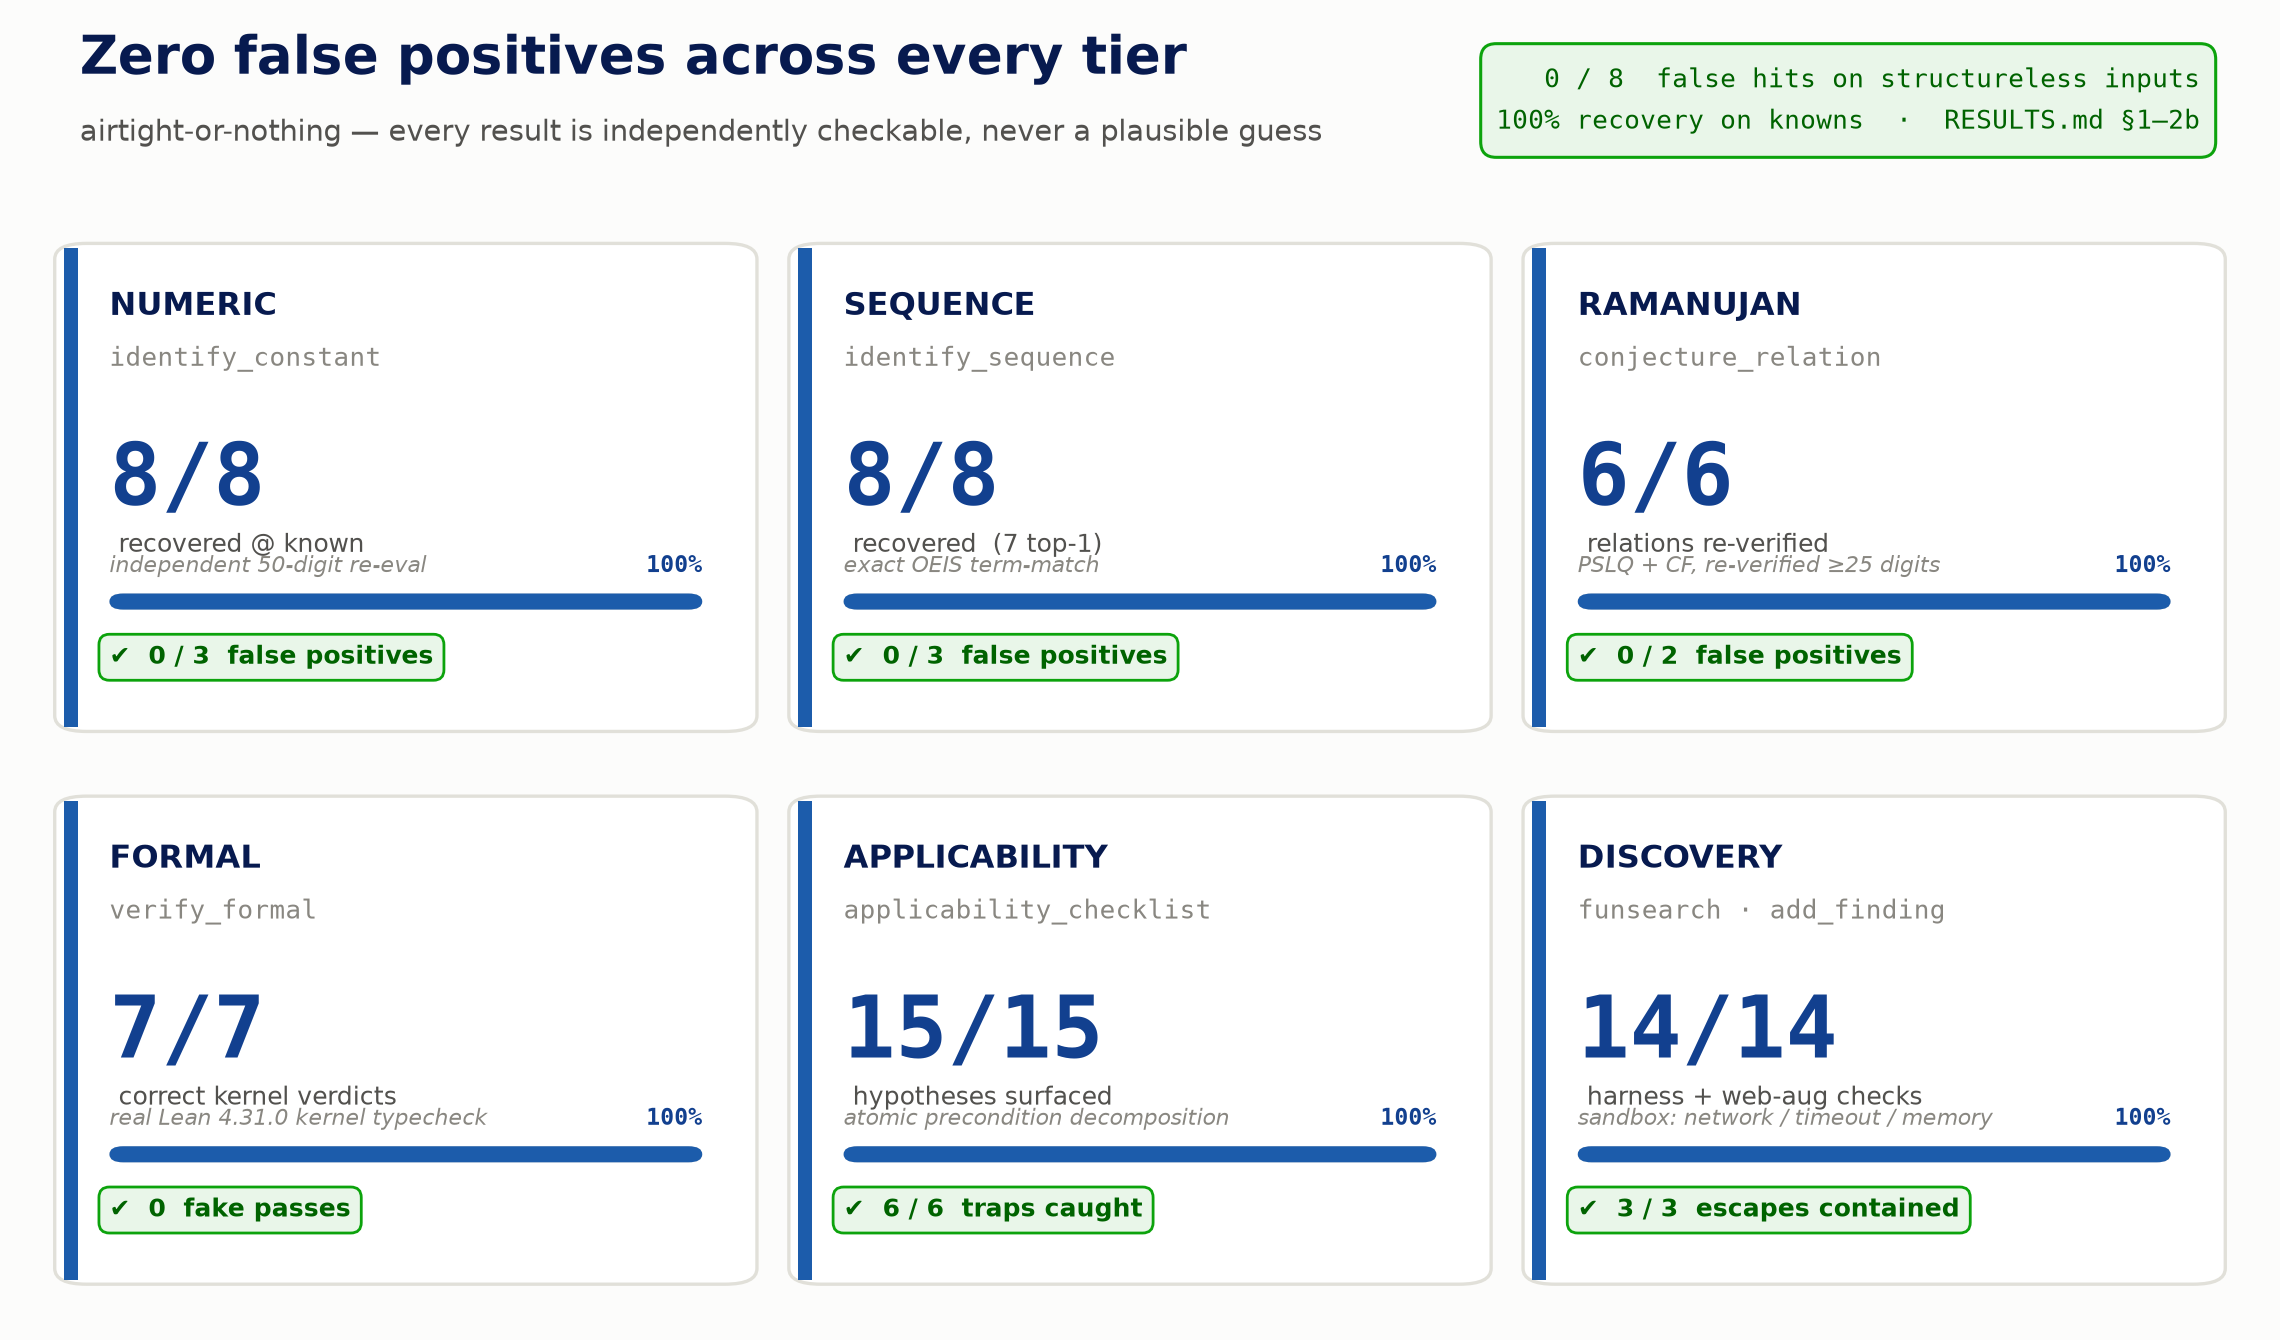
上の表の概要 — すべてのティアで偽陽性 0(構造のない入力 8 件のうち、誤検出は 0 件)、既知の結果の再現率 100%。数値については RESULTS.md §1–2b を参照してください。
368万件のドキュメントインデックス。 search_existing_math は、3,683,428件のドキュメントを含む密なインデックス(Qwen3-Embedding-8B、4096次元)から提供されます。このインデックスは、利用許諾が明確な CC-BY/CC0 の TheoremSearch サブセット 134万件と、Dolma のスローガン埋め込み済み arXiv-math ドキュメント 234万件を組み合わせ、密検索、Okapi-BM25、RRF を使用します。3,680万件ではなく全368万件規模での、正直な主要再現率は、ドキュメントの生の本文で、そのスローガン埋め込み済みエントリーを検索した場合、R@1 0.614/R@10 0.832です。これは難易度の高い表現形式をまたぐ自己再現率評価です。(以前の163.5万件のビルドでは、より簡単な同一表現形式でのスローガン→スローガン自己再現率は、81,833件のホールドアウト分割で R@1 0.977/R@10 0.998 でした。)
Hugging Face で公開しているコーパス。 このインデックスのテキストとメタデータは、kattri15/mathlas-corpusで公開しています。定理レベルのドキュメント3,683,428件に、小規模な findings 設定を加えたもので、theoremsearch、dolma、findings の各設定に分かれています。スローガン、LaTeX の記述、ソース URL、タイトル、ラベル、カテゴリ、判明している場合は引用数、出典情報キーが含まれます。30 GB の埋め込み行列やローカルのベンチマーク用データは含まれていません。ライセンスは設定ごとに異なります。TheoremSearch サブセットは CC BY-SA 4.0、Dolma の記述は ODC-BY 1.0、当方のスローガンは CC BY 4.0、findings は CC BY 4.0 です。完全な監査情報については、docs/HF_DATASET_LICENSING.mdを参照してください。
from datasets import load_dataset

ts = load_dataset("kattri15/mathlas-corpus", "theoremsearch", split="train")
dolma = load_dataset("kattri15/mathlas-corpus", "dolma", split="train")
ノート PC 向け量子化ティア(オプトイン)。 fp16 行列はディスク上で30 GB(fp32 ではメモリ上で約60 GB)あり、ビルド用マシンには適していますが、ノート PC には適しません。MATHLAS_QUANTIZED=binary(または HybridRetriever.from_index で quantized="binary")を設定すると、メモリマップされた量子化サイドカーから同じインデックスを提供します。1.9 GBの符号ビットハミング検索で候補を1000件に絞り込み、正確な再スコアリングで上位 k 件を選びます。主要値と同じ n=3000 のプロトコルを使用し、全368万件のインデックスで測定したところ、再現率の低下はありません(R@1 は fp16 の0.6140に対して0.6143、R@10 は同じ0.8323です。int8 モードは R@1 0.6147、15 GB)。CPU 4スレッドで1クエリあたり2.4秒です。正直な注意点として、これにより縮小されるのはドキュメント側だけです。クエリは引き続き同じ Qwen3-Embedding-8Bで埋め込む必要があります(小型の0.6Bエンコーダーは別のベクトル空間を使用します)。真のエンドツーエンド小型エンコーダーティアについては、以下の0.6Bティアを参照してください。数値、ビルドコマンド、注意点の詳細については、docs/QUANTIZED_TIER.mdを参照してください。
0.6B エンドツーエンドのノート PC 向けティア(オプトイン)。 同じ 3,683,428 件のコーパスを Qwen3-Embedding-0.6B で再度一度だけ埋め込みました(1024 次元、提供されるメタデータと行単位で対応)。これにより、クエリエンコーダー自体をノート PC の CPU で実行できます:MATHLAS_ENCODER=0.6b(MATHLAS_QUANTIZED=binary と組み合わせ可能)。同一の n=3000 クロス表現プロトコルで測定し、クエリを 0.6B モデルで再エンコードした結果は R@1 0.545/R@10 0.745 でした(binary + int8 再スコアリング;0.6B fp16 の正確な全件スキャンは 0.544/0.745 で、このティアでも量子化による損失はありません)。8B ティア(0.614/0.832)と比べた場合、誠実に言えば再現率は約 7~9 ポイント低下します。デュアルチャネルの 8B 構成(0.965/0.999)は、ハイエンド環境での品質上限です。ノート PC 向けの要点は、全 3.68M 件のドキュメントを対象に、クエリのエンコードを含めて CPU 4 スレッドでクエリあたり 0.67 秒(2 スレッドでは 0.88 秒) です。密チャネルの容量は、binary サイドカーが 0.47 GB、0.6B エンコーダーが 約 1.2 GB(合計約 1.7 GB;int8 再スコアリング用のソースとして 3.77 GB を推奨;完全な fp16 の兄弟インデックスは 7.54 GB)です。TheoremSearch-110 のコーパス限定プローブでは、このティアの Hit@20 は定理/論文で 8.2%/10.0% でした。8B ティアは 10.0%/11.8% です(どちらもライセンス制限に基づく下限値)。全表、容量、注意事項については docs/QUANTIZED_TIER.md をご覧ください。ビルド:scripts/build_06b_index.py;評価:scripts/eval_06b_tier.py。
デュアルチャネル検索(オプトイン)。 0.614 という見出しの数値は、LaTeX の命題形式のクエリを、スローガン形式で埋め込まれたドキュメントから検索する際の、表現間の隔たりを示しています。2 つ目の密チャネルでは、同じ 3,683,428 件のドキュメントを、クリーニング済みの LaTeX 命題で埋め込みます(Qwen3-Embedding-8B、行単位で対応、scripts/build_statement_channel.py でビルド)。ドキュメントごとの最大類似度を使って密ランキングに統合します。同じ n=3000 サンプルをコーパス全体の規模で測定した結果は、R@1 が 0.614 から 0.965、R@10 が 0.832 から 0.999 になりました。正直なところ、注意点があります。この評価は自己検索の代理指標であり、命題チャネルはクエリの元となったテキストそのものをインデックス化します(BM25 と同様に、完全一致が有利になります)。リークのない 110 件の人間作成クエリのベンチマークでは、改善は実際にありますが限定的です(論文 Hit@20 は 11.8% から 12.7%)。また、2 つ目の行列によってサーバー実行時の RAM 使用量はおおむね 2 倍になります(全規模での測定値:デュアルサーバーのプロセスピークは 150 GB、単一チャネルでは約 95 GB;CPU 2 スレッドでのデュアル密スキャンはクエリあたり約 2.75 秒)。そのため、厳密にオプトイン方式で提供され(MATHLAS_STATEMENT_INDEX=/path/index_full_statement.npz、自動検出はされません)、量子化ティアとは併用できません。全数値とサービングティアの表については docs/RETRIEVAL_UPGRADE_NOTES.md をご覧ください。本番環境のハイブリッド検索では、デフォルトの rrf_k は 10 です(テストしたすべての k の中で最良でした)。さらに、オプトインでクロスエンコーダーによる再ランク付けをブレンドできます(MATHLAS_RERANK=1、Qwen3-Reranker-0.6B、誠実な評価で R@1 が +1.7 ポイント改善)。再ランク付けバックエンドは MATHLAS_RERANK_MODEL で選択できます:qwen3(デフォルト、Qwen3-Reranker-0.6B、変更なし)または jina-v3(jinaai/jina-reranker-v3、arXiv:2509.25085 — 0.6B 規模で BEIR をリードする「last but not late」再ランカー)。どちらも初回使用時に重みを遅延ロードし、torch/transformers または重みが見つからない場合は、再ランク付けなしの融合にフォールバックします(stderr に正直な注記が表示されます)。モデル名に誤字がある場合は、誤った再ランカーを黙って使用せず、エラーになります。ここで提供するのは接続部分であり、jina のベンチマーク数値ではありません。重みはご自身でご用意ください。
自己拡張ループ — TheoremSearch を上回る
TheoremSearch 独自の人手で作成された110件のクエリでは、mathlas のベースラインはカバレッジの限界に達します。TheoremSearch は独自の9.2M件のコーパスの85%を非公開にしているため、オープンなシステムでは95件の対象論文にアクセスできません。そこで AI がループを実行します。見つからない定理ごとに、ウェブ上で実際の定理の記述を見つけ、同じ Qwen3-Embedding-8B で埋め込みを作成し、add_finding(dense_vec=…) で実行時に密ベクトルのチャネルを通じて統合します(提供中の3.68M件のインデックスで2026-06-10に再計測 — ループ後の主要な数値は完全に再現されました。Dolma の無関係な文書が追加されたため、コーパスのみのベースラインは論文レベルで13.6%から11.8%に低下しましたが、そのまま報告しています)。
| 手法 | theorem Hit@20 | paper Hit@20 |
|---|---|---|
Google(site:arxiv.org) | — | 37.8% |
| Search 付き ChatGPT 5.2 | 19.8% | — |
| Gemini 3 Pro | 27.0% | — |
| TheoremSearch(Qwen3-8B、非公開の9.2M件全体) | 45.0% | 56.8% |
| mathlas — ベースライン(コーパスのみ) | 10.0% | 11.8% |
| mathlas — 自己拡張ウェブループ実行後 | 59.1%(65/110) | 70.0%(77/110) |
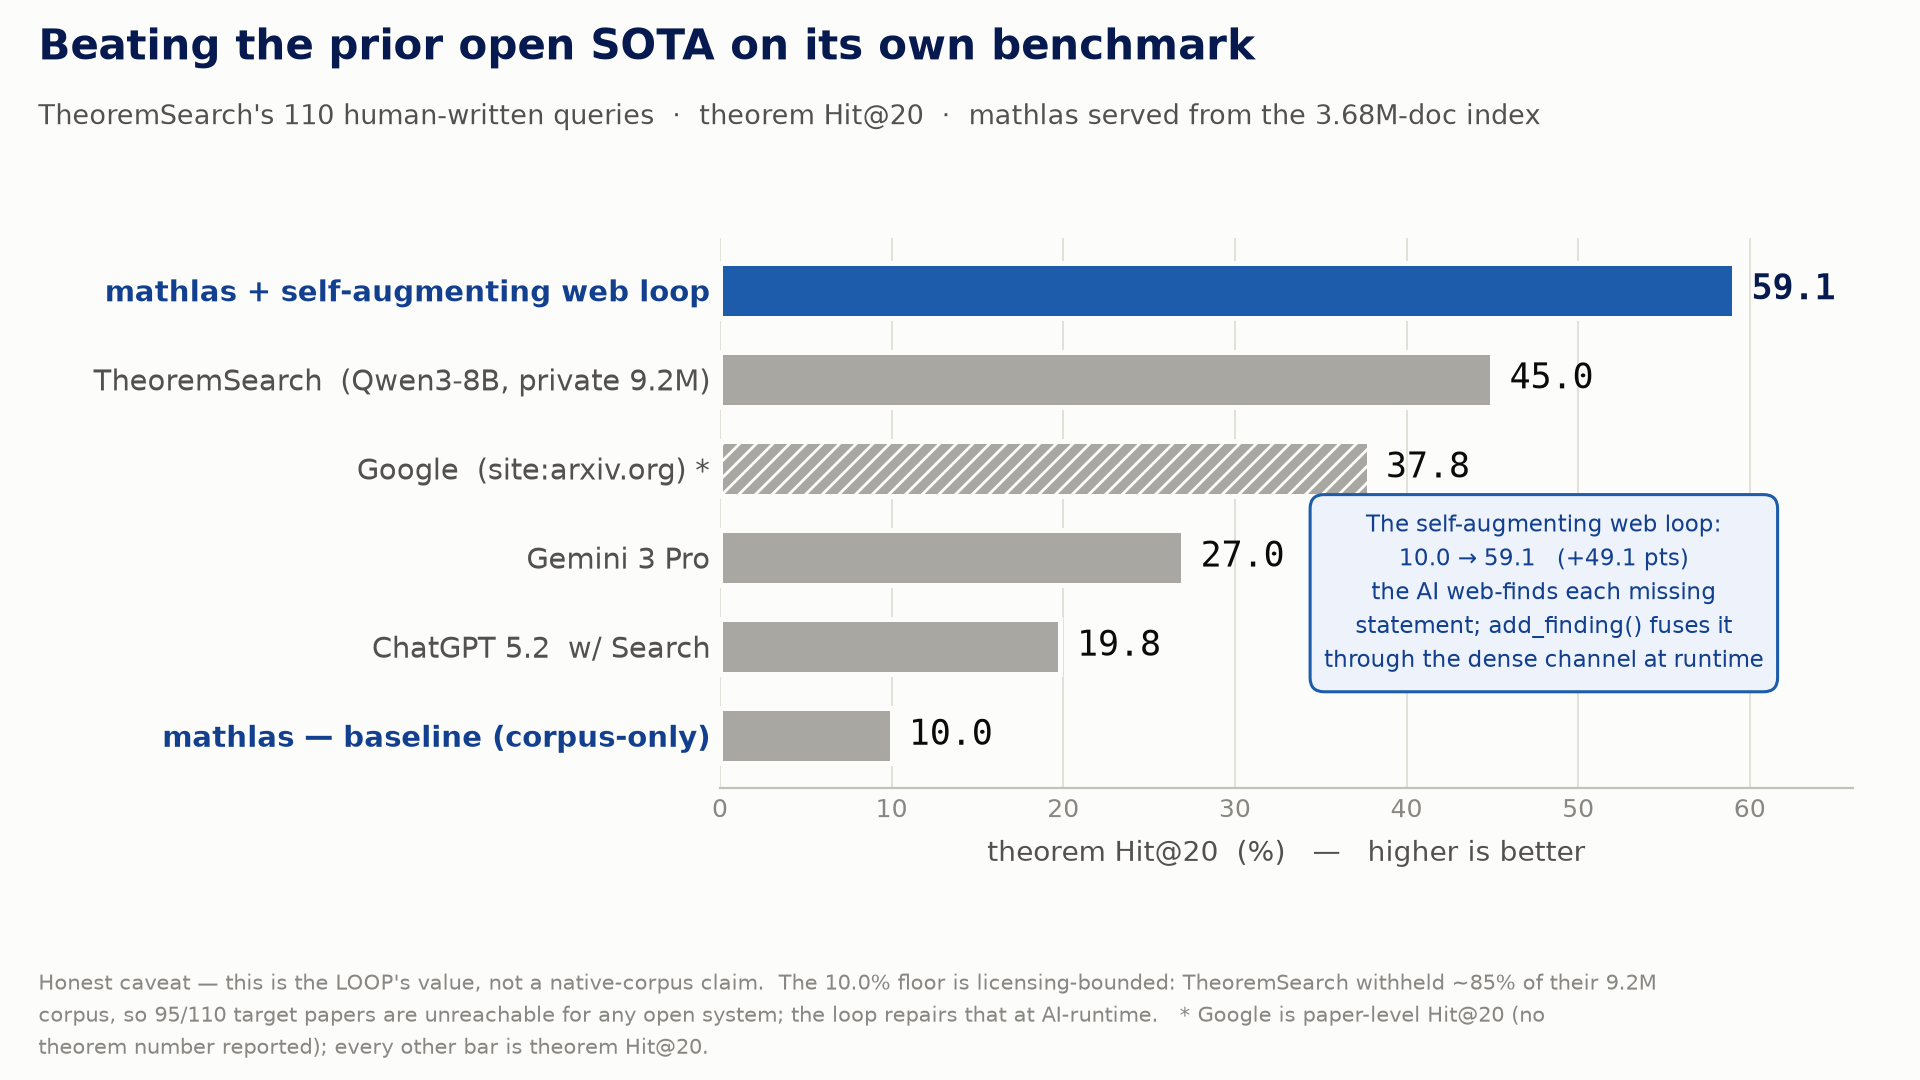
これはループの価値を示すものであり、ネイティブコーパスに関する主張ではありません。 10.0%のベースラインはライセンス上の制約を受けています。TheoremSearch は9.2M件のコーパスの約85%を非公開にしているため、対象論文110件中95件にはオープンなシステムからアクセスできません。自己拡張ウェブループは、AI の実行時にこのカバレッジのギャップを補います。Google の値は論文レベルの Hit@20 です(定理番号の報告なし)。それ以外のすべての値は定理レベルの Hit@20 です。
benchmarks/webaug_110_bench.py で再現できます(完全版の82件の調査リスト _findings_worklist_full.json を使用してください)。
ソースを考慮した検索(オプトイン)。 インデックスを1.34M件から3.68M件に拡大したことで、計測可能なコストが発生しました。ウェブから収集したDolmaの文書2.34M件によって、正準的な論文が上位20件から押し出されます(この同じ110件のクエリで、コーパスのみの場合の論文レベルの精度は13.6%から11.8%に低下)。現在、search_existing_math はオプションの source_filter / source_weights を受け取ります。たとえば、正準的な定理の記述だけを対象にする場合は source_filter={"exclude": ["dolma"]} を指定できます。dolma を除外すると、論文レベルでは拡大前の13.6%(15/110、到達可能な15件の論文では15/15=100%)を完全に回復し、定理レベルでは以前のインデックスを上回ります(11.8%対10.9%)。デフォルトのランキングはバイト単位で同一のままです(テストで固定済み)。これはクエリの意図に応じて使い分ける設定であり、常に有効な改善策ではありません。自己再現率テスト n=3000 では、対象の65%がDolmaの文書です。dolma の重みを下げると、それらのクエリでは大幅に悪化します(dolma を対象とするクエリの R@10 は、重み0.5で0.999から0.884に、除外すると0になります)。まさにこのため、オプトインとして提供され、デフォルトでは無効になっています。また、設定を使わずにデュアルチャネルでこの回帰を構造的に解消できるかも検証しました。一部は回復します(デフォルト設定で論文レベルは11.8%から12.7%に、定理レベルは10.0%から10.9%に向上)が、13.6%までは回復しません。そのため、このベンチマークでは設定による緩和策を引き続き推奨しています。全評価結果は docs/02_eval_vs_theoremsearch.md を参照してください。
12 個のツール
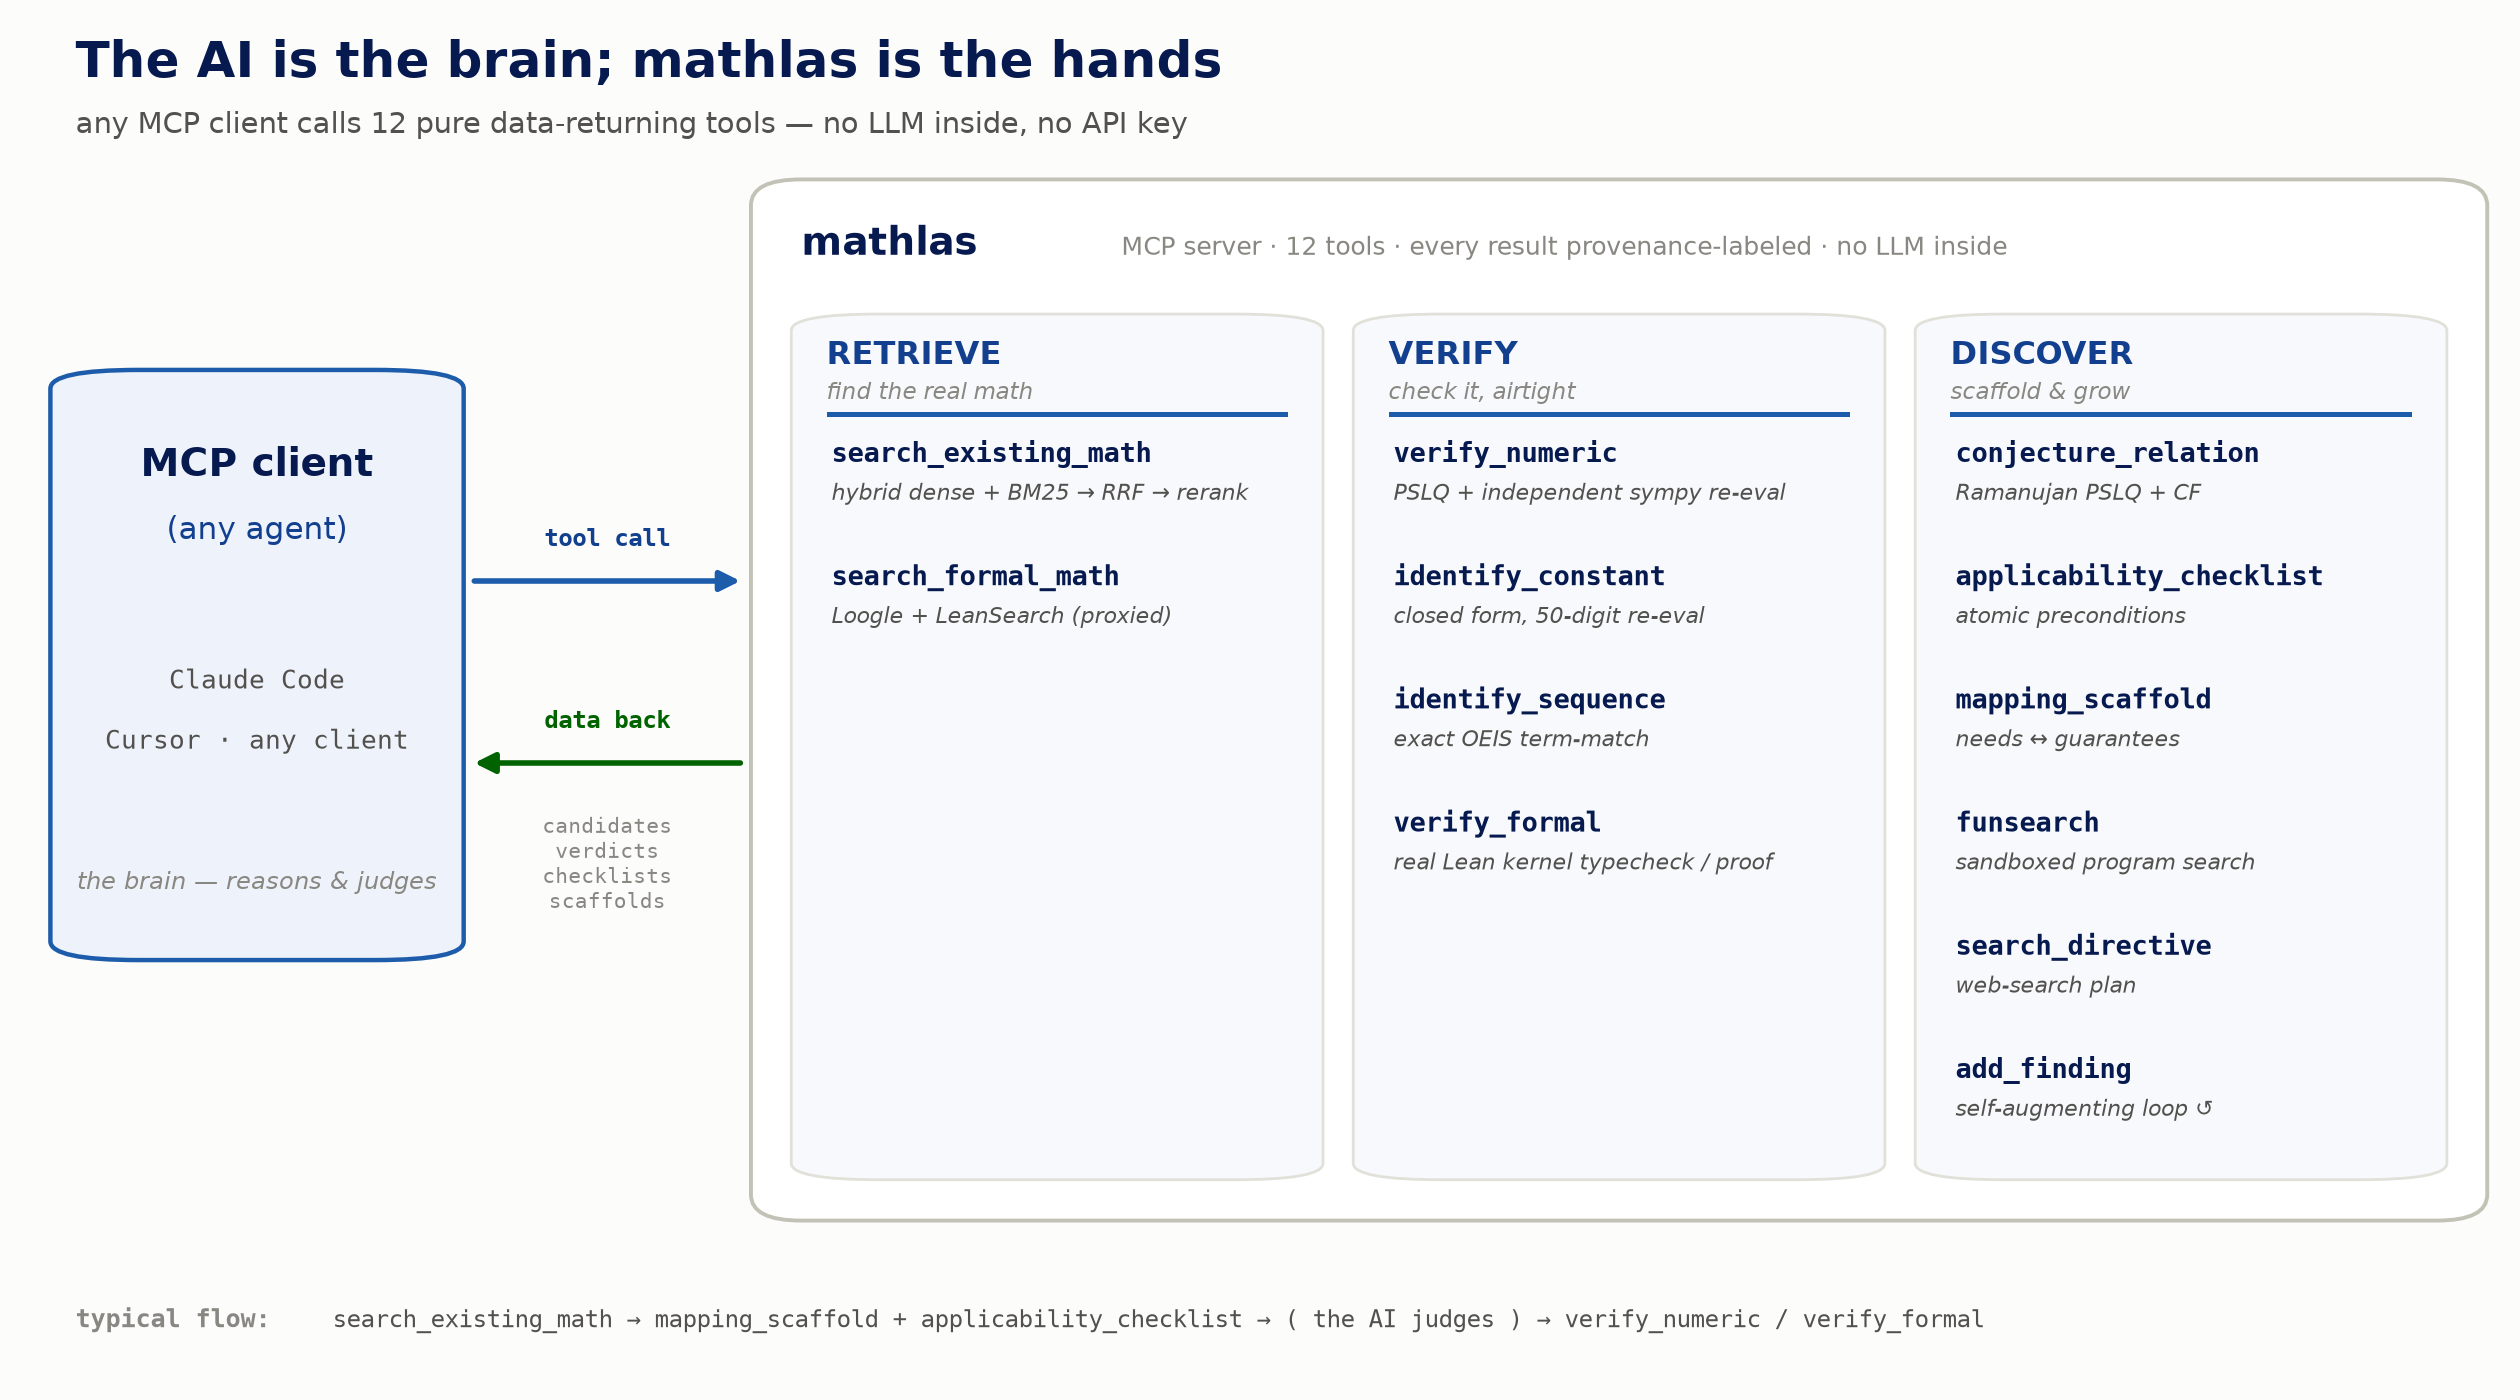
search_existing_math ─▶ mapping_scaffold + applicability_checklist ─▶ (AI judges) ─▶ verify_numeric / verify_formal
   (own index)            (needs↔guarantees, no LLM)                                  (airtight)
中核となる 4 つ — 多くのエージェントが使用するツールです:
| ツール | 機能 |
|---|---|
search_existing_math(query, k) | クエリ → 368 万件のドキュメントを収録した dense + BM25 + RRF インデックスからのランク付け済み結果 |
identify_constant(value) | 実数値 → 既知の閉形式 + 出典情報(50 桁で再評価) |
verify_numeric(value, closed_form) | 桁の一致判定 — 別のエンジンを使い、より高精度で検証 |
verify_formal(statement, lean?, proof?) | 実際の Lean カーネルを実行 — スニペットの型チェックを行うか、proof を渡してLean 4 の完全な証明をカーネルで検査します:VERIFIED_PROOF / REFUTED(修正ループ向けのカーネルの正確なエラー)/ 正直な UNDETERMINED |
全ツール:
| ツール | 機能 |
|---|---|
search_formal_math(query, backend) | 公開 Loogle(パターン/型)+ LeanSearch(自然言語)サービスを介した mathlib の宣言名 + 型。出典情報付きで、サービスが利用できない場合は正直に「サービス利用不可」と表示します。さらに、7 日間のオンディスクキャッシュにより、サービス停止時には直近の正常な応答を提供し、(cached, <age> old) と明示します |
identify_sequence(terms) | 整数列 → 一致する OEIS エントリ(項の完全一致) |
applicability_checklist(statement) | 結果の仮定を、AI がチェックを付けられる個別項目のチェックリストとして提示 |
mapping_scaffold(problem, statement) | 必要条件↔保証事項に関する質問 + 記入用テンプレート |
conjecture_relation(value) | Ramanujan Machine:豊富な基底を用いた PSLQ + 連分数/漸化式の予想 |
funsearch(action, problem_id, …) | 1 つのツールで FunSearch ハーネスを提供 — action=evaluate(AI が作成したプログラムをサンドボックスでスコアリング)、register(MAP-Elites DB)、status(最良の結果 + few-shot) |
search_directive(problem) | ウェブ検索計画:arXiv クエリ + サブ分野 + 実行するツール |
add_finding(statement, slogan, source) | ウェブで見つけた結果を稼働中のコーパスに取り込み |
すべてのツールはデータを返します。LLM を呼び出すツールはありません。search_formal_math はそれ自体がウェブ呼び出しを行う唯一のツールです(公開 Loogle/LeanSearch サービスを呼び出します)。それ以外はすべて完全にローカルで動作します。
証明の検証 — 修正ループ
verify_formalは文の型チェックだけを行うのではありません。命題と、あなたが書いたLean 4の証明を渡すと、本物のカーネルが宣言全体を検証します。mathlasが証明を書くことはありません(生成と検証の分離は絶対です)。しかし、証明が間違っている場合、カーネルはその理由をkernel_errorで一字一句そのまま正確に示します。これにより、証明の作成は短いループになります。エージェントが証明を書く → mathlasのカーネルが問題点を正確に示す → エージェントが修正して再度呼び出す。
verify_formal(statement="∀ n : Nat, n + 0 = n", proof="by\n  intro n\n  rfl")
// → {"proof_status": "VERIFIED_PROOF", "checked": true, ...}
verify_formal(statement="2 + 2 = 5", proof="rfl")
// → {"proof_status": "REFUTED", "kernel_error": "error: Not a definitional equality:
//     the left-hand side 2 + 2 is not definitionally equal to the right-hand side 5 ...", ...}
仕組み上、偽の合格はありません。sorry/admitの穴は拒否されます(Lean自体はsorryを含む証明でも終了コード0を返します。mathlasはソースとカーネルのsorryAx診断の両方をスキャンします)。ツールチェーンがない場合、タイムアウトした場合(上限60秒)、またはこの最小限のツールチェーンでは解決できないインポートがある場合は、すべて正直にUNDETERMINEDを返し、決して判定を下しません。tests/test_proof_check.pyには、本物のカーネルとの統合チェックのみが残されています。純粋な宣言/パーサーの単体テストとAPIサーフェスの単体テストケースは、このレビュー用ブランチには含まれていません。CIでは、tests/test_hf_upload_corpus.pyの合成Hugging Face Parquetビルド/ロード統合チェックも実行します。
CPUデータパイプラインとオプションのLeanカーネル統合チェックは、次を実行して行います。
python -m pip install -e ".[retrieve]" pytest datasetsを実行してから、
python -m pytest -q tests/test_hf_upload_corpus.py tests/test_proof_check.pyを実行します。
Leanの実行ファイルが利用できない場合、Leanのテストケースはスキップされます。
CLI/Python
mathlas 1.6449340668482264364724151666460251892   # -> pi**2/6  [verified 51 digits]
mathlas 1,1,2,3,5,8,13,21                          # -> A000045 Fibonacci  https://oeis.org/A000045
mathlas "a bounded sequence has a convergent subsequence" --k 5   # search + scaffold
mathlas mcp                                                        # run the MCP server
import mpmath
from mathlas import identify, identify_sequence, mapping_scaffold, applicability_checklist
print(identify(mpmath.zeta(2)))            # -> pi**2/6 [verified 51 digits]
print(identify_sequence([1,1,2,3,5,8,13,21]).matches[1].a_number)  # -> 'A000045'
ドキュメント
RESULTS.md— 各ツールの検証結果をコマンドとともに再現しています。docs/methods.md— アーキテクチャ、設計上の決定事項、引用文献。docs/05_open_dataset.md— オープンデータセットとインデックス。docs/QUANTIZED_TIER.md— 量子化されたノートPC向けティア:実測した再現率/フットプリント/レイテンシ。docs/02_eval_vs_theoremsearch.md— 検索機能の直接比較。docs/REGISTRY_PUBLISH.md— 公式MCPレジストリへの公開。
位置づけ — 検索は必須条件、検証こそが競争優位性
正当に評価すべき点:最も近いシステムであるTheoremSearch(UW Math AI Lab)は、現在、本番環境向けREST APIと独自のMCPエンドポイント(api.theoremsearch.com/mcp)を9.2M文書のコーパス上で提供しています。数学文献の生の再現率では、これが競うべきシステムです。「こちらはMCPネイティブで、向こうは研究室のツール」という点は、もはや差別化要因ではありません。私たちが自分たちのインデックスの生データとして再利用しているのは、オープンライセンス(CC-BY/CC0)のデータセットのサブセットのみであり、API、MCP、インデックス、コードは利用していません。
DeepMindが示すもの、そしてオープンな検証器が今も重要な理由。DeepMindのAlphaProof Nexus(arXiv:2605.22763)は、mathlasのアーキテクチャ、すなわちLLMエージェントがLeanカーネルとOEISのような構造化された数学リソースをグラウンドトゥルースのオラクルとして統括する方式を、まさに実証しています。しかし、これは内部専用です。公開されている成果物は結果のダンプ(google-deepmind/alphaproof-nexus-results)であり、実行可能なシステムではなく、APIもMCPサーフェスもありません。Gemini Deep Thinkなどのシステムが必要性をさらに際立たせています。エージェントの推論が高度になるほど、エージェントから呼び出せる、低コストでオフライン動作するローカルかつ決定論的な検証器がボトルネックとなり、モデルではなくなります。mathlasは今も、あらゆるエージェントが今日導入できる唯一のオープンで、APIキー不要、MCPと組み合わせ可能な検証レイヤーです。さらに、DeepMind自身のオープンライセンスのLeanコーパス**formal-conjectures**(arXiv:2605.13171)も、インデックスのソースとして取り込むようになりました(scripts/fetch_formal_conjectures.py、Leanの予想文3,941件、ソースタグformal_conjectures。凍結されたFC100SolvedSet1/FC100OpenSet1の評価用サブセットを含みます)。
名称に関する注記: mathlas は Matlas(matlas.ai、北京大学の定理検索、arXiv:2604.17484)とは無関係です。別のプロジェクトで、作者も異なります。名前が似ているのは偶然です。
競合にはなく、検索の後に行われるすべての処理が備わっています。
- 検証ティア —
verify_numeric(独立した50桁での再評価)とverify_formal(実際の Lean カーネルによる型チェック。完全な証明チェックも含み、カーネルのエラーをそのまま返してエージェントの修正ループを可能にします。判定できない場合は、正直に UNDETERMINED を返します)。検索では候補が得られますが、mathlas ではさらに主張そのものとその主張の証明をチェックできます。 applicability_checklist— 候補定理を個々の前提条件に分解し、AI が一つずつ検証することで、誤った適用(開区間と閉区間、無限群と有限群など)を検出します。これを備えた競合はありません。- 自己拡張型の
add_findingループ — AI がウェブで不足している命題を見つけて埋め込み、実行時に稼働中のインデックスへ統合します。独自の110件のクエリベンチマークで、定理 Hit@20 は TheoremSearch の45.0%に対して59.1% です(上記参照)。私たちの知る限り、これは検証済み書き戻し RAG ループを数学領域に適用した初の事例です。これは、検索を読み取り専用として扱うのではなく(Self-RAG、arXiv:2310.11511、CRAG、arXiv:2401.15884)、検証済みの推論結果を検索可能なストアへ書き戻す双方向検索システムの一種です(Bidirectional RAG、arXiv:2512.22199)。数学領域が適している理由は、書き戻す候補を信頼する前に、決定論的にチェックできる(verify_numeric/verify_formal)ことです。そのため、汎用的な書き戻しループに伴う幻覚の増幅リスクを避けながら、コーパスを拡張できます。 - 誤検出ゼロの徹底 — 各ティアは、独立して検証可能な事実、または「何もない」という正直な結果を返します。実測の誤検出率はすべてのティアで0です(
RESULTS.md)。 - 無料、API キー不要、出典ラベル付き — すべての結果に出典(
known_constant、conjectured_relation、web_added、external:loogleなど)が表示され、インデックスは100%オープンライセンスのデータから構築されています。
| mathlas | TheoremSearch | LeanSearch / Loogle | Wolfram MCP | sympy-mcp | |
|---|---|---|---|---|---|
| インフォーマルな数学検索 | ✅ 368万件のドキュメント、オープン | ✅ 920万件のドキュメント(約85%は非公開) | ❌(mathlib の宣言のみ) | ❌ | ❌ |
| フォーマル(mathlib)検索 | ✅ 両方をプロキシし、1つの MCP ツールに統合 | ❌ | ✅(まさにこれ) | ❌ | ❌ |
| 数値検証 | ✅ 厳密な50桁での再評価 | ❌ | ❌ | ⚠️ CAS 評価 | ⚠️ CAS(主張チェックの位置付けなし) |
| フォーマル検証 | ✅ 実際の Lean カーネル(命題と完全な証明、修正ループ用のエラー) | ❌ | ❌(検索であり、検証ではない) | ❌ | ❌ |
| 適用可能性チェックリスト | ✅ 独自機能 | ❌ | ❌ | ❌ | ❌ |
| 自己拡張型コーパス | ✅ add_finding(Hit@20 は59.1対45.0) | ❌ | ❌ | ❌ | ❌ |
| 定数/数列 ID | ✅ PSLQ + OEIS + Ramanujan-Machine | ❌ | ❌ | ⚠️ 一部 | ❌ |
| 出典ラベル | ✅ すべての結果 | ❌ | 該当なし | ❌ | 該当なし |
| コスト/キー | 無料、キー不要 | 無料のエンドポイント | 無料 | 有料の Wolfram API キー | 無料 |
| MCP | ✅ stdio、uvx でワンライナー | ✅ リモートエンドポイント | ❌(mathlas がプロキシ) | ✅ | ✅ |
(sympy-mcp は CAS 操作用の優れたサーバーですが、対象範囲はほとんど重なりません。渡された式を書き換えるのに対し、mathlas は既存の数学を見つけ、適用範囲を特定し、検証します。)
公式 MCP レジストリ
mathlas は io.github.Archerkattri/mathlas として公開されています(docs/REGISTRY_PUBLISH.md と server.json を参照)。
mcp-name: io.github.Archerkattri/mathlas
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。