PubChem Finder について
PubChem Finderは、化学研究者向けのコマンドラインツール、Pythonライブラリ、MCPサーバーです。スコア付きのローカル類似構造・部分構造インデックスと、PubChemのライブ情報およびオフラインのRDKit解析を組み合わせています。
主な機能
- 01ローカル化合物類似検索
- 02SMILESまたはSMARTSによる部分構造検索
- 03PubChem情報と生物活性の取得
- 04RDKitによる記述子と警告の算出
- 05構造図で差異や一致箇所を表示
- 06SDFファイルからのインデックス作成
活用シーン
- 01ローカル化合物インデックスで類似体を検索
- 02構造フラグメントで化合物を絞り込み
- 03化合物特性とメディシナルケミストリー警告を確認
- 04PubChemの安全性情報やバイオアッセイを調査
MCP 対応
stdioまたはstreamable HTTP経由で、ローカル構造検索、RDKit解析、PubChem検索のツールをMCPクライアントに提供します。ローカルインデックスが必要なツールは事前構築が必要ですが、PubChemへのライブ検索には不要です。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
PubChem Finder
ターミナルまたは Claude から、化学構造を使って PubChem を検索します。PubChem Finder は、PubChem 全体または必要な範囲のローカルフィンガープリントインデックスを構築し、レート制限なしで正確な類似性検索と部分構造検索を実行します。また、名前、安全性データ、生物活性試験には PubChem のライブサービスを利用し、RDKit による化学処理(構造の描画、メディシナルケミストリーのトリアージ、記述子の計算)も提供します。コマンドラインツール、Python ライブラリ、および Claude Desktop、Claude Code、その他の MCP クライアント向けの MCP サーバーとして動作します。



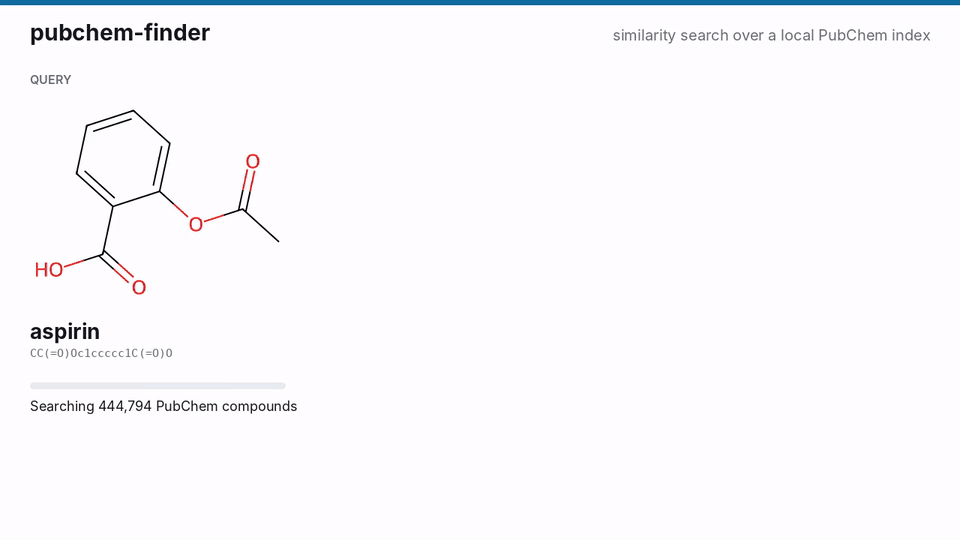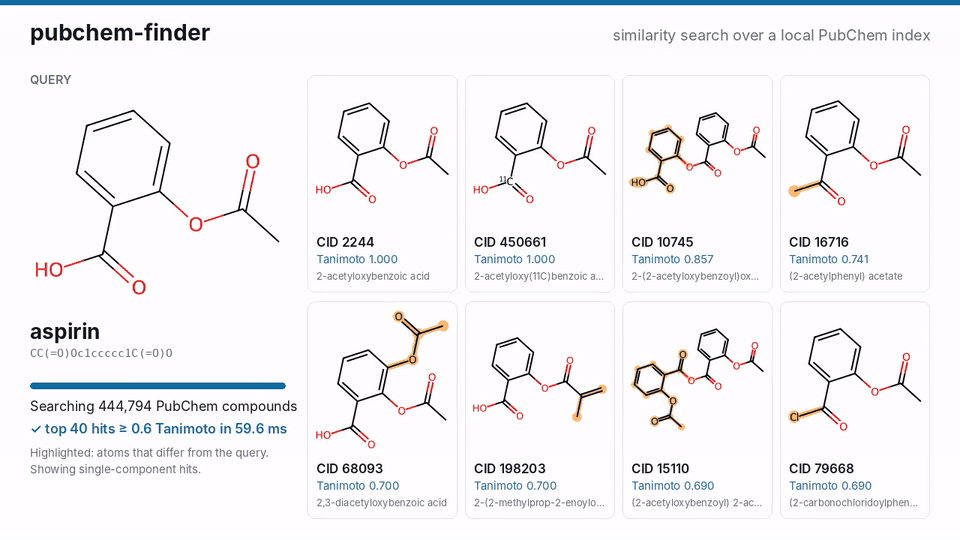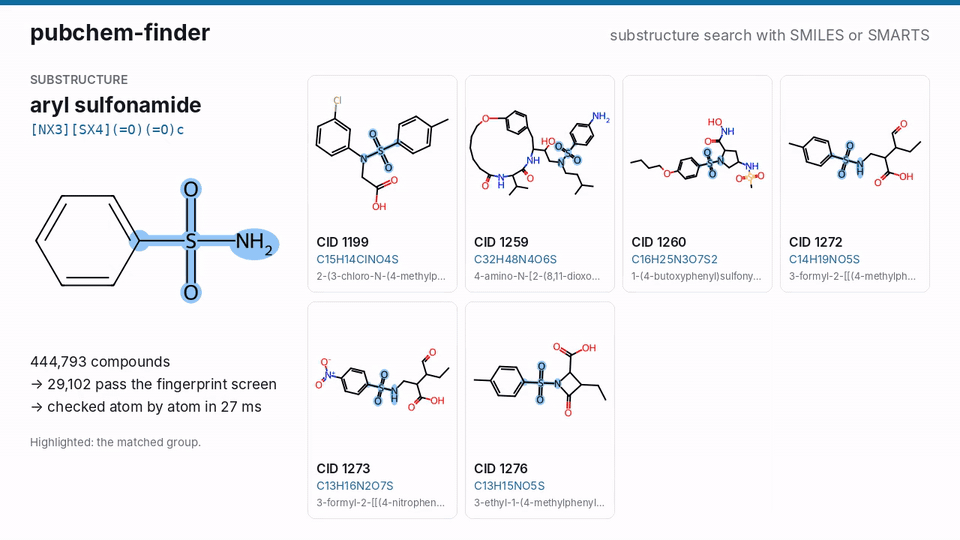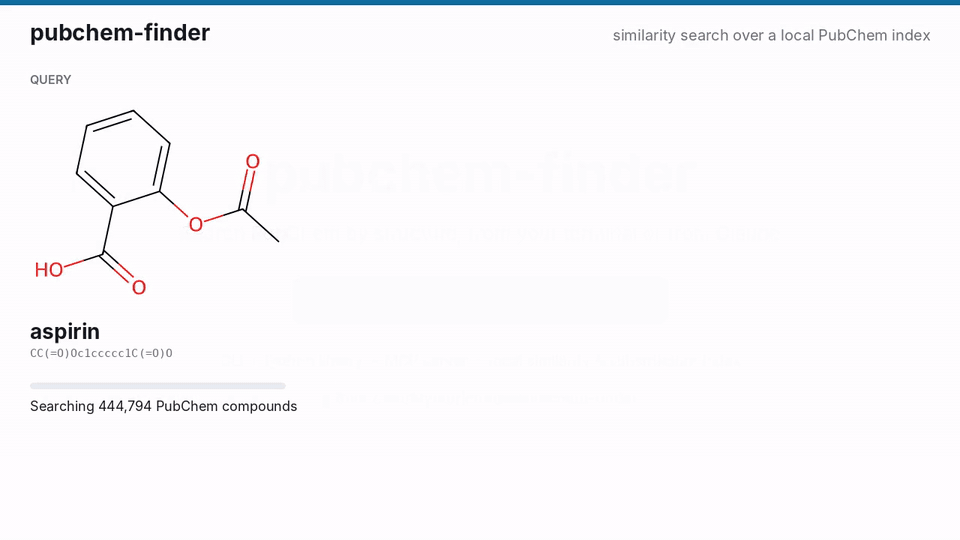
PubChem の最初の 444,794 件を対象にした実際の検索結果です。プロジェクトの実データ用ワークフローで構築したインデックスを使って描画しています。まず、アスピリンとの相違部分をハイライトした類似化合物の検索結果を示し、続いて、一致部分をハイライトしたアリールスルホンアミドの SMARTS 検索結果を示します。MP4 版。
このツールの特長
MCP サーバーを含む他の PubChem ツールは、問い合わせを PubChem の Web API に転送します。化合物の検索には便利ですが、API 経由の構造検索にはレート制限があり、一般的なクエリではタイムアウトし、スコアのないサンプルが返されます。PubChem Finder ではローカルインデックスも使用します。
- 正確なスコア付き類似性検索:インデックス化されたすべての化合物を、デフォルトでは ECFP4 Tanimoto を使ってミリ秒単位で検索します。FPSim2 を使用します。これは ChEMBL の類似性検索を支えるエンジンです。
- ローカル部分構造検索:SMILES または SMARTS を使って、まずフィンガープリントで候補を絞り込み、次に原子ごとに照合するため、すべての検索結果が実際に一致します。
- オフライン化学処理:RDKit による記述子、標準化、PAINS/Brenk/NIH アラート、QED、合成容易性、類縁体間の変化を示す描画を利用できます。
- 出典付き PubChem ナレッジ:同義語と CAS 番号、相互参照、GHS 分類、薬理学、毒性、生物活性試験の要約を、それぞれの出典とともに確認できます。
データベースサーバーも Docker も不要です。インデックスはデータディレクトリ内の 2 つのファイルで構成されます。
Claude から使用する
初回実行時に Python とそのほか必要なものを取得する uv が必要です。
Claude Code:
claude mcp add pubchem-finder -- uvx pubchem-finder mcp
または、プラグインとして使用することもできます。Cowork でも動作します。
/plugin install pubchem-finder --marketplace MysterionRise/pubchem-finder
Claude Desktop(Settings、Developer、Edit Config の順に開き、その後 Claude を再起動します):
{
  "mcpServers": {
    "pubchem-finder": {
      "command": "uvx",
      "args": ["pubchem-finder", "mcp"]
    }
  }
}
次のような質問をしてみましょう。
- 「カフェインの分子量と XLogP はいくつですか?リピンスキーの法則に適合していますか?」
- 「イブプロフェンには危険性がありますか?GHS ラベルには何と書かれていますか?出典を示してください。」
- 「PubChem のバイオアッセイにおけるセレコキシブの主な標的は何ですか?」
- 「アスピリンに最も近い類似化合物を表示して、どこが変わったか強調してください。」
- 「この化合物に PAINS アラートはありますか?
O=C1C(=Cc2ccccc2)SC(=S)N1」 - ローカルインデックスを使用する場合:「イブプロフェンに最も類似した化合物を 20 個見つけてください」または「インデックス登録済みの化合物のうち、アリールスルホンアミドを含むものはどれですか?そのうちいくつかを、該当する基を強調して描画してください。」
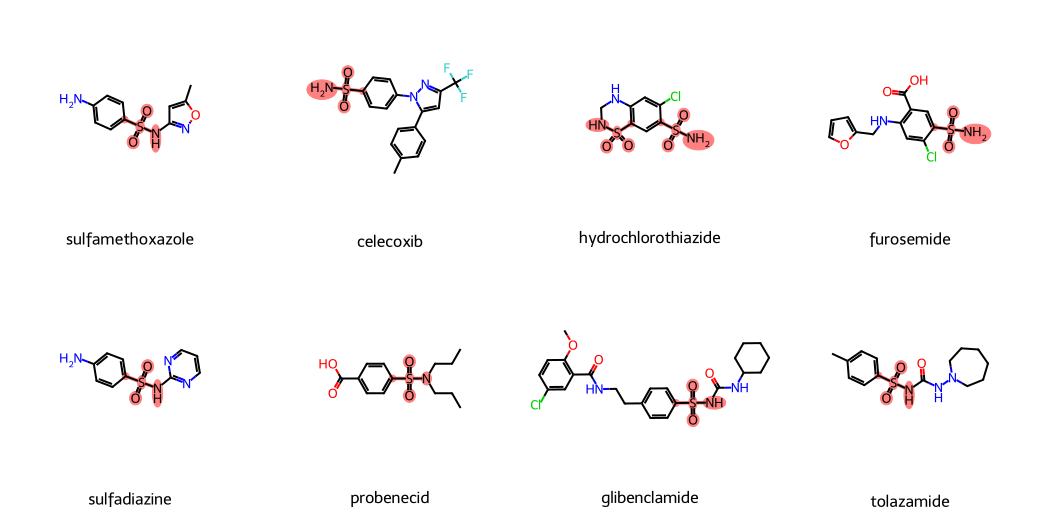
highlight="smarts" を指定した draw_molecules:Claude がインライン表示する、[NX3][SX4](=O)(=O)c とのマッチを強調表示した 8 種類のスルホンアミド薬。
ローカルインデックス用のツールにはインデックスが必要です。以下のコマンドラインから作成すると、サーバーがそれを使用します。デフォルト以外のデータディレクトリを使うには、Claude Desktop のエントリに "env": {"PUBCHEM_FINDER_HOME": "/path"} を追加するか、claude mcp add に --env PUBCHEM_FINDER_HOME=/path を追加します。
その他の MCP クライアント: このサーバーは stdio 経由の標準 MCP に対応しているため、ローカル MCP サーバーを実行できるクライアント(Cursor、VS Code、Windsurf、Zed、JetBrains IDEs、Codex CLI、LM Studio など)であれば、同じコマンドと引数で起動できます。サーバーをそこからインストールするクライアント向けには、MCP registry に io.github.MysterionRise/pubchem-finder として登録されています。
docs/clients.md には設定方法、簡単な動作確認方法、動作が確認されたセットアップ例が記載されています。これらのクライアントをお使いの場合、ご利用のクライアントの情報を追加することは、最初の貢献として最適です。
HTTP 経由: pubchem-finder mcp --transport http を実行すると、プロセスを起動する代わりに URL に接続するクライアントや、チームのマシンでインデックスを共有する場合に向けて、同じツールを http://127.0.0.1:8000/mcp(MCP ストリーマブル HTTP)で提供します。たとえば、claude mcp add --transport http pubchem-finder http://127.0.0.1:8000/mcp を実行します。サーバー自体には認証機能も TLS もありません。127.0.0.1 以外にバインドする前に、HTTP 経由をお読みください。
ツール
| ツール | 機能 |
|---|---|
pubchem_lookup(query, by, limit) | 名前、CID、SMILES、InChIKeyからPubChemのレコードを特定します。識別子、分子式、MW、XLogP、水素結合数、TPSA、リンクを取得できます。 |
compound_properties(smiles) | 任意のSMILESについてRDKit記述子とLipinskiチェックを行います。オフラインで動作します。 |
standardize(smiles) | 塩および対イオンを除去し、中和して標準化します。オフラインで動作します。 |
compare(smiles_a, smiles_b) | ECFP4およびMACCSフィンガープリントによるTanimoto類似度を計算します。オフラインで動作します。 |
medchem_profile(smiles) | QED、合成容易性、Lipinski/Veber、原子情報付きのPAINS/Brenk/NIHアラート、Murcko骨格を表示します。オフラインで動作します。 |
draw_molecules(smiles, legends, highlight, smarts, reference_smiles) | 構造をインライン画像で表示します。SMARTS一致箇所、参照構造との変更点、または類似度マップをハイライトできます。オフラインで動作します。 |
similarity_search(smiles, threshold, top_k, metric, group_by_scaffold) | ローカルインデックス内で最も類似する化合物を検索します。Murcko骨格でグループ化することもできます。 |
substructure_search(query, query_type, max_hits) | SMILESまたはSMARTSフラグメントを含むインデックス内の化合物を、CIDの昇順で検索します。 |
index_status() | ローカルインデックスの構築状況、収録内容、不足分の構築方法を確認します。 |
pubchem_similarity_search(smiles, threshold, max_records) | PubChem全体から類似化合物をリアルタイムで検索し、ECFP4で再スコアリングします。 |
pubchem_substructure_search(smiles, max_records) | フラグメントを含むPubChem全体の化合物をリアルタイムで検索します。 |
pubchem_exact_match(smiles, identity_type) | この構造と完全に一致するPubChemレコードを取得します。立体化学または同位体を無視することもできます。 |
pubchem_synonyms(cid, limit) | 一般名、ブランド名、体系名、およびCAS登録番号を取得します。 |
pubchem_xrefs(cid) | 登録ID(CAS、ChEMBL、DrugBankなど)、PubMed記事、特許を取得します。 |
pubchem_description(cid) | 出典付きの編集済み説明を取得します。 |
pubchem_annotations(cid, heading, max_chars) | 化合物ページの1セクションを取得します。GHS分類、危険有害性、薬理学、作用機序、医薬品情報、実験的特性、毒性、用途、食品添加物が対象です。各項目に出典が記載されます。 |
pubchem_bioactivity(cid) | バイオアッセイの概要を取得します。アッセイ数、結果、主要な標的、最も強力な活性結果を確認できます。 |
コマンドラインから使用する
uvx pubchem-finder lookup caffeine                     # PubChem record by name, CID, SMILES or InChIKey
uvx pubchem-finder props "CC(=O)Oc1ccccc1C(=O)O"       # RDKit descriptors (offline)
uvxを使うと、インストールせずに最新リリースを実行できます。コマンドをインストールするには、次を実行します。
uv tool install pubchem-finder(またはpip install pubchem-finder)。以下の例では、インストール済みであることを前提としています。開発版を試すには、任意のuvxコマンドでpubchem-finderを
--from git+https://github.com/MysterionRise/pubchem-finder pubchem-finderに置き換えてください。
ローカルインデックスを構築して検索する
pubchem-finder index build --limit 1 --with-substructure   # first PubChem chunk: ~445,000 compounds
pubchem-finder search "CC(=O)Oc1ccccc1C(=O)O" --threshold 0.7 --top 20
pubchem-finder search "CC(=O)Oc1ccccc1C(=O)O" --group-by-scaffold
pubchem-finder substructure "c1ccc2[nH]ccc2c1"              # everything indexed that contains indole
pubchem-finder substructure "[NX3][SX4](=O)(=O)c" --smarts  # aryl sulfonamides, as SMARTS
pubchem-finder index status

pubchem-finder index build --sdf my_library.sdf.gz         # or index your own SDF files
index build --limit Nは、NCBIからHTTPS経由でPubChemの約350個のSDFチャンク(各約500,000 CID)のうち先頭のN個をダウンロードし、各ファイルのMD5を検証してフィンガープリントを作成し、ダウンロードしたファイルを削除した後、すべてを1つの検索可能なインデックスに統合します。再実行しても安全です。完了済みのチャンクはスキップされるため、中断したビルドを再開でき、より大きな--limitを指定すると既存のインデックスを拡張できます。--allを指定するとPubChem全体をインデックス化します。デフォルトのフィンガープリントはECFP4(Morgan半径2、1024ビット)です。新しいインデックスでは、--radiusと--fp-sizeで変更できます。
サブストラクチャ検索には2つ目のフィンガープリントデータベースが必要なため、任意の機能です。インデックス内にすでにあるSMILESから構築するため、index build --with-substructureを実行すると、ダウンロードせずに既存のインデックスへ追加できます。以降のビルドでは最新の状態に保たれます(--without-substructureで削除できます)。各化合物はまずRDKitのパターンフィンガープリントでスクリーニングされ、その後、候補を原子ごとに照合します(立体化学は無視されます)。ヒットはCIDの昇順で返されるため、古くから知られている化合物が先に表示されます。検索は--max件のヒット、または--max-candidates個の化合物を確認した時点で停止し、候補をすべて確認したかどうかを通知します。
PubChem に直接問い合わせる
pubchem コマンドは、インデックスを必要とせず、PubChem のライブサービスに問い合わせます。
pubchem-finder pubchem similarity "CC(=O)Oc1ccccc1C(=O)O" --threshold 90   # across all of PubChem
pubchem-finder pubchem substructure "c1ccc2[nH]ccc2c1" --max 50
pubchem-finder pubchem exact "CC(=O)Oc1ccccc1C(=O)O" --identity same_connectivity
pubchem-finder pubchem synonyms 2244          # names and CAS numbers
pubchem-finder pubchem xrefs 2244             # registry IDs, PubMed articles, patents
pubchem-finder pubchem describe 2244          # curated descriptions with sources
pubchem-finder pubchem annotations 2244 --heading "GHS Classification"
pubchem-finder pubchem bioactivity 2244       # assay outcomes, top targets, most potent results
PubChem の類似検索は独自のフィンガープリントを使用し、スコアを報告しないため、ここではヒットごとにローカルインデックスと同じフィンガープリントである ECFP4 でスコアを付け、そのスコア順に並べます。
成功したレスポンスは 7 日間キャッシュされるため、同じ質問を繰り返しても費用はかからず、PubChem のレート制限にも抵触しません(pubchem-finder cache info | clear。PUBCHEM_FINDER_CACHE=0 でキャッシュを無効にできます)。
画像、トリアージ、ファイル全体
pubchem-finder draw "CC(=O)Oc1ccccc1C(=O)O" "COC(=O)c1ccccc1O" -l aspirin -l "methyl salicylate" \
    --highlight diff --reference "CC(=O)Oc1ccccc1C(=O)O" -o analogues.png
pubchem-finder draw "O=C(O)c1ccccc1O" "CC(=O)Nc1ccc(O)cc1" --highlight similarity_map \
    --reference "CC(=O)Oc1ccccc1C(=O)O" -o similarity.png
pubchem-finder triage "O=C1C(=Cc2ccccc2)SC(=S)N1"     # QED, SA score, rules, PAINS/Brenk/NIH alerts

# .smi ("SMILES [id]" per line), .csv/.tsv with a smiles column, or - for stdin; CSV out
pubchem-finder triage -i library.smi -o triage.csv
pubchem-finder props -i library.csv -o props.csv
pubchem-finder search -i queries.smi -o hits.csv --threshold 0.6 --top 50
pubchem-finder substructure -i fragments.smi -o hits.csv
バッチモードで失敗した行には、実行を中断する代わりに error 列が追加されます。
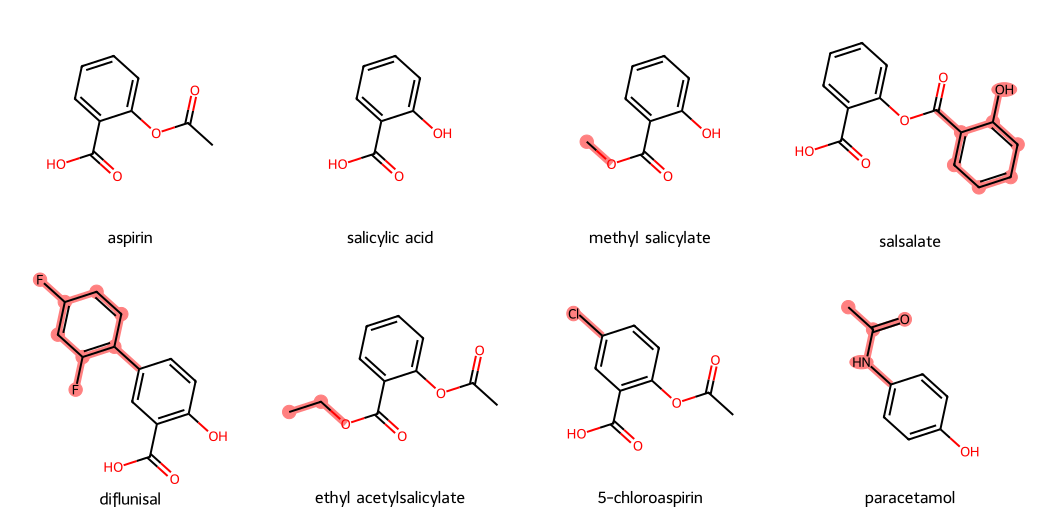
--highlight diff:各類縁体を、アスピリンと共有するコアに位置合わせし、追加された原子を強調表示します。
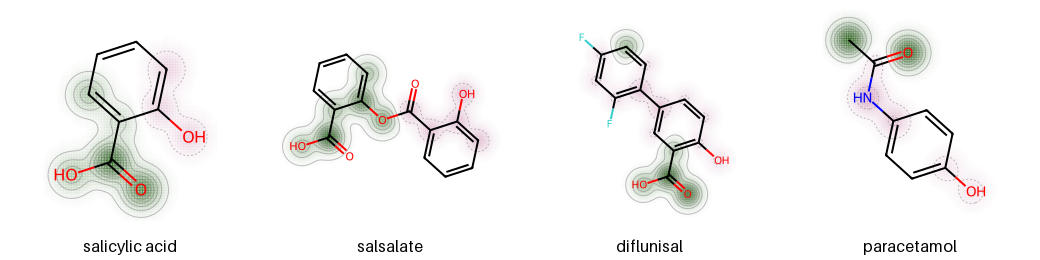
--highlight similarity_map:アスピリンとの ECFP4 類似度を高める原子を緑色で、低下させる原子をピンク色で表示します。
規模はどのくらいですか?
最初の列の数値は、MacBook Pro と、標準的な GitHub Actions Linux ランナー上のプロジェクトの実データワークフローで index build --limit 1 を実行した実測値です。このワークフローでは --with-substructure を指定し、その後、結果に対してすべてのコマンドと MCP ツールを実行します。PubChem 全体の列は、その数値を PubChem の約 1 億 2,000 万件の化合物に当てはめた推定値です。
| PubChem の最初のチャンク(実測値) | PubChem 全体(推定値) | |
|---|---|---|
| インデックス化した化合物 | 444,794 件(RDKit により 29 件をスキップ) | 約 1 億 2,000 万件 |
| フィンガープリント処理 | MacBook の1コアで80秒、GitHub ランナーで169秒 | 8コアで約1時間、ダウンロード時間は別途 |
| ダウンロード | SDF ファイル1つ。インデックス化後に削除 | HTTPS 経由で約100 GB。チャンクごとにストリーミング |
| 類似検索インデックスファイル | 36 MB | 約10 GB |
| メモリ内類似検索に必要な RAM | 64 MB | 約17 GB |
| 部分構造検索(オプション) | 構築にさらに169秒、ファイルサイズ88 MB、RAM 121 MB | 8コアで約1.5時間、ファイルサイズ約24 GB、RAM 約33 GB |
| 構築時に必要な空きディスク容量 | 少量 | 約45 GB。部分構造検索を使う場合はさらに約50 GB |
最初のチャンクでのクエリ時間(GitHub ランナー):類似検索のスキャンはメモリ上で約3ミリ秒、ディスク上で0.12秒です。40件のヒットの名前と SMILES を取得すると、呼び出し全体で約60ミリ秒になります。50件を対象とする部分構造検索は、メモリ上で35~50ミリ秒、ディスク上で0.3秒です。このサイズでは、最初のクエリでインデックスを読み込む時間も1秒を大きく下回ります。 スクリーニング時間は、インデックスのサイズにほぼ比例して増加します。
インデックスは、使用可能な RAM に十分収まる場合はメモリ上で検索され、そうでない場合はディスクから検索されます。PUBCHEM_FINDER_INDEX_MODE=memory|disk を設定すると、モードを強制できます。ノート PC では、PubChem 全体ではなく --limit を指定して一部だけインデックス化してください。
データはプラットフォームのデータディレクトリ(Linux では ~/.local/share/pubchem-finder、macOS では ~/Library/Application Support/pubchem-finder、Windows では %LOCALAPPDATA%\pubchem-finder)に保存されます。--home DIR または PUBCHEM_FINDER_HOME で保存先を変更できます。
Python から使う
CLI と MCP サーバーは、pubchem_finder.service を薄くラップしたものです。
from pubchem_finder import service

service.properties("CC(=O)Oc1ccccc1C(=O)O").molecular_weight  # 180.16
service.standardize("CC(=O)[O-].[Na+]").smiles  # 'CC(=O)O'
service.compare("CCO", "CCCO").ecfp4_tanimoto  # 0.556
service.lookup("caffeine").compounds[0].cid  # 2519 (network)
service.similarity_search("CC(=O)Oc1ccccc1C(=O)O", threshold=0.7)  # needs an index
service.substructure_search("[NX3][SX4](=O)(=O)c", query_type="smarts")
独自のエージェントにツールを使わせるには、MCP サーバーに接続してください。
examples/mcp_client.py
では、50行未満のコードで標準の MCP クライアントを使って実現しています(uv run examples/mcp_client.py。API キーは不要です)。エージェントフレームワーク向けの例も歓迎します。詳細は
#34をご覧ください。
トラブルシューティング
- 初回の起動には1分ほどかかります。 uv は必要に応じて Python をダウンロードし、RDKit、PyArrow、DuckDB など数百 MB のパッケージを一度だけダウンロードします。2回目以降は約1秒で起動します。
- Claude Desktop にサーバーの起動失敗が表示されます。 macOS のデスクトップアプリからはシェルの
PATHが見えないため、uvxが見つからないことがあります。commandにフルパスを指定してください(which uvxを実行して確認します。通常は~/.local/bin/uvxです)。サーバーのログは Claude Desktop の MCP ログにあります。 similarity_searchまたはsubstructure_searchで「ローカルインデックスがありません」と表示されます。pubchem-finder index build --limit 1でインデックスを作成してください(部分構造検索には--with-substructureを追加します)。不足しているものはindex_statusで確認できます。- PubChem の応答が遅い、または混雑しています。 リクエストは PubChem の上限である毎秒5件に制限され、PubChem が混雑している場合は再試行されます。非常に汎用的なフラグメントを使って PubChem 全体を対象に構造検索すると、タイムアウトすることがあります。より具体的なクエリを使うか、ローカルインデックスを利用してください。
- プロキシ経由の場合:
HTTPS_PROXYを設定してください。PubChem および NCBI へのすべてのリクエストで適用されます。 - ARM(aarch64)の Linux: FPSim2 はこの環境向けのホイールを公開していないため、インストールにはビルド用の C++ コンパイラーが必要です。
- 最初からやり直す場合:
pubchem-finder cache clearでレスポンスキャッシュを空にできます。データディレクトリを削除すると、インデックスも削除されます。
データ、クレジット、引用
データは、オープンな化学データベースである米国国立医学図書館の PubChem に由来します。NCBI のポリシーおよびPubChem の引用に関するガイダンスに従い、データの利用時には PubChem を引用してください。
Kim S, et al. PubChem 2025 update. Nucleic Acids Research 2025;53(D1):D1516-D1525. doi:10.1093/nar/gkae1059
安全性、薬理学、毒性などの注釈は、他の組織から提供されています。それぞれの注釈には情報源が記載されており、独自のライセンス条件が適用されるものもあります。
PubChem Finder は、RDKit、FPSim2、DuckDB、Apache Arrow、MCP Python SDK を基盤に構築されています。PubChem Finder 自体を引用するには、CITATION.cff(GitHub の「このリポジトリを引用」ボタン)を参照してください。
開発
uv が必要です。Python 3.11 から 3.14 までをサポートしています。リポジトリの .python-version により、pyenv または conda で古い Python が PATH の先頭に設定されていても、uv sync は 3.12 を使用します。
uv sync            # create .venv and install everything, including dev tools
make check         # ruff lint + format check, mypy (strict), pytest with coverage
make test          # just the tests
PUBCHEM_LIVE=1 uv run pytest -m live   # tests that call the real PubChem services
uv run python scripts/smoke.py --live  # every MCP tool through the real stdio server
uv run python scripts/smoke.py --url http://127.0.0.1:8000/mcp  # same, against a running HTTP server
上部のアニメーションは、実際のインデックスを使って scripts/demo_media.py で描画しています(collect は検索を実行して時間を計測し、render は GIF と MP4 を書き出します)。正確なコマンドは docstring に記載されています。また、実データを使うワークフローでは、実行のたびにアニメーションを描画します。docs/media/demo-data.json には現在のアニメーションの元となる結果が保存されているため、uv run python scripts/demo_media.py render docs/media/demo-data.json -o docs/media を実行すると、インデックスなしで再描画できます。
CI では Linux、macOS、Windows でテストを実行し、3つの環境すべてでビルド済みホイールのスモークテストを行うほか、PubChem のライブテストを毎週実行します。CONTRIBUTING、ROADMAP、CHANGELOG を参照してください。
PubChem Compound SDF (HTTPS) --> streaming RDKit parse --> chunks/<chunk>.parquet  (CID, SMILES, InChIKey, name, formula, MW)
                                                      \-> chunks/<chunk>.h5       (FPSim2 fingerprints)
                                                            \-> merge + popcount sort -> index/pubchem.h5 + manifest.json
chunks/<chunk>.parquet SMILES --> RDKit pattern fingerprints --> chunks/pattern/<chunk>.h5 -> index/pubchem-pattern.h5
                                                                  (only with --with-substructure)
pubchem-finder CLI  ----\                 /-> FPSim2 exact similarity (in memory or on disk) + DuckDB over Parquet
                         +--> service ---+--> FPSim2 pattern screen + RDKit atom match (substructure)
MCP server (stdio|HTTP) /                 \-> PubChem PUG REST / PUG View for live data
このリポジトリは2020年、PubChem ダンプ用の Indigo + Elasticsearch インデクサーとして始まりました。そのコードは、コミット 06619d9 より前の git 履歴に残っています。
ライセンス
MIT です。LICENSE を参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。