Neurarch について
Neurarchは、機械学習開発者やエージェントが起動前にモデル構造と学習ジョブを評価するMCPサーバーです。メモリとGPU適合性の推定、OOM診断、オフライン構造チェックを行います。
主な機能
- 01学習時のピークメモリとGPU適合性の推定
- 02GPUごとのバッチサイズ比較
- 03CUDA OOMの原因診断
- 04アーキテクチャと層の影響の確認
- 05オフラインでのモデルチェック
- 06過去の実行履歴の参照
活用シーン
- 01学習開始前のGPU適合性確認
- 02利用可能なGPUに応じたバッチサイズ選定
- 03OOM発生後の原因調査
- 04開発中のモデル構造検証
MCP 対応
Claude Code、Cursor、Claude Desktop、VS Code、Windsurf、CodexなどのMCPクライアントに、モデル分析と学習計画のツールを提供します。大半のツールはローカルでオフライン動作し、plan、history、model_changesは外部データにアクセスします。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
neurarch-mcp
GPU ジョブが予約を取る前に、そのジョブに必要なリソースをエージェント内で把握できます。Claude Code、Cursor、Claude Desktop、VS Code、Windsurf、Codex 向けの MCP サーバーです。
- 小規模なジョブ: まとめて実行するか、より小さな GPU カードに移します。
- 大規模なジョブ: 適切なカード数とシャーディングを最初から設定できます。
- エージェントが起動するジョブ: エージェント自身ではジョブの規模を見積もれないため、GPU を使う前にチェックします。




ジョブの起動前に size_training_job を呼び出すと、エージェントは指定されたモデル、バッチ、カードに基づいて、ピークメモリ(重みとオプティマイザー状態、アクティベーション、保存されるアテンションスコアをそれぞれ表示)、収まる最小のカード、各カードで処理できる最大バッチサイズ、1 枚では収まらない場合の2 枚への分割方法、1 回の実行にかかるコストを把握し、will not fit a T4: needs ~30 GB with headroom (peak 26 GB) at batch 32, seq 2048, use L40S or batch <= 12 のような一行の判定を得られます。history を使うと、組織内で前回実行したときにその構成で実際に測定された値も確認できます。CUDA のメモリ不足エラーが発生した後は、diagnose_oom が同じ見積もりとエラーメッセージを照合し、原因(カードに対して大きすぎる、メモリの断片化、別のプロセス、語彙数の多いモデルでのロジット、実行中の増加)を特定して、影響の小さい修正方法から提示します。さらに、フォワードパスが実行できるかどうかも確認できます。CI ボットが実行する構造チェック(lint_model、check_design)はオフラインでも利用できます。ジョブを人が作成した場合でもエージェントが作成した場合でも、同じ回答が得られます。これは、GPU の請求を負担する人が知りたいことです。
確認する
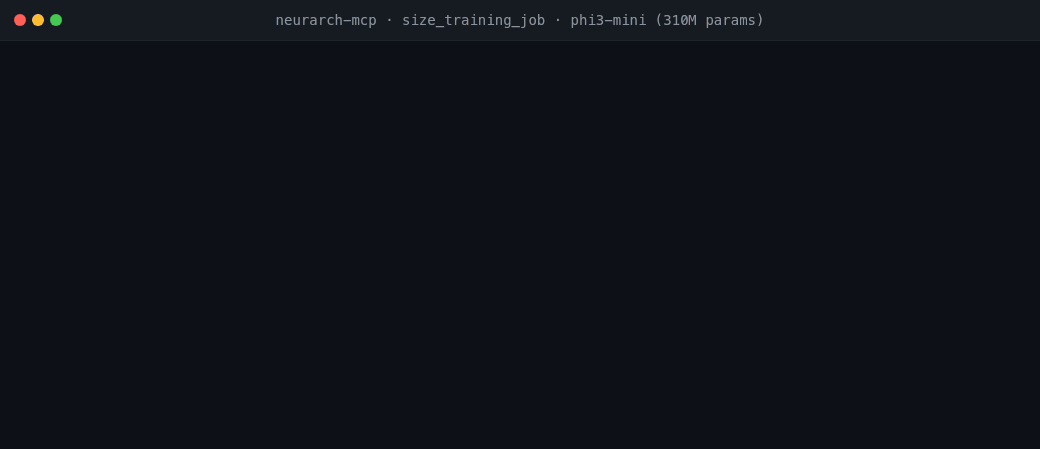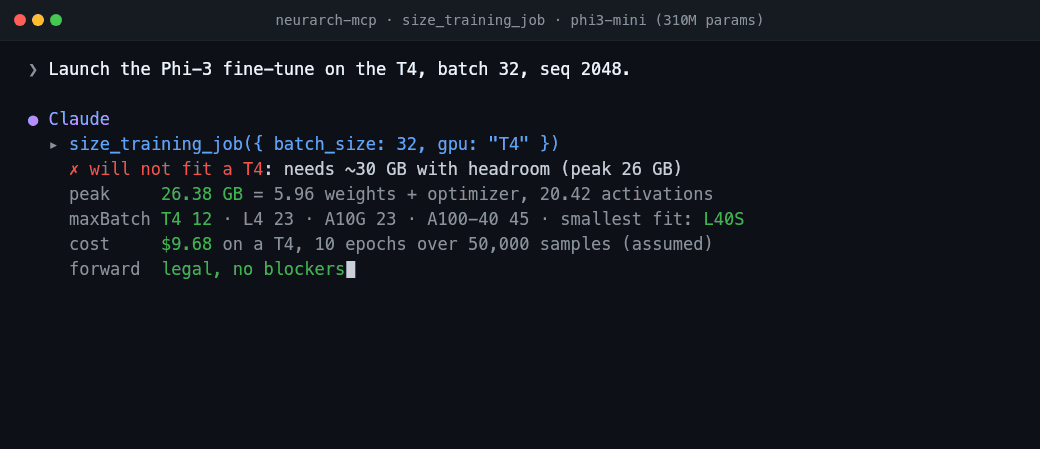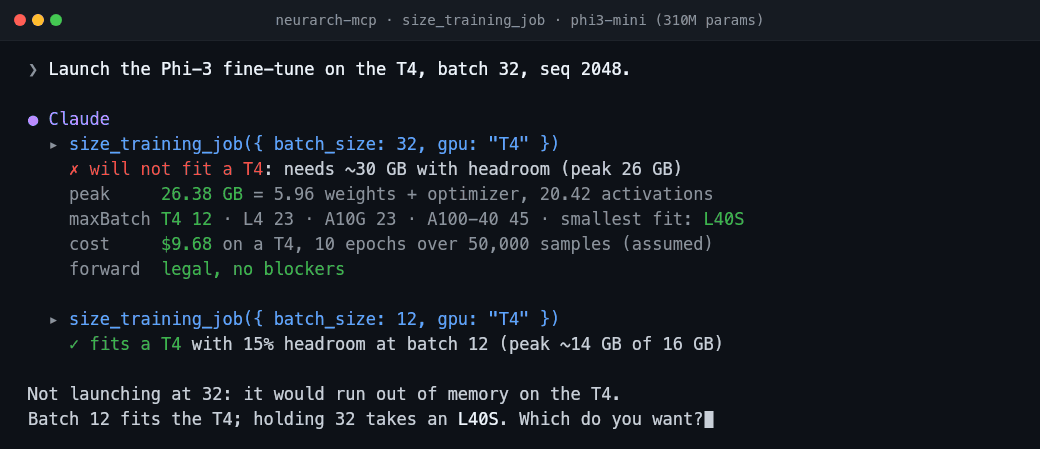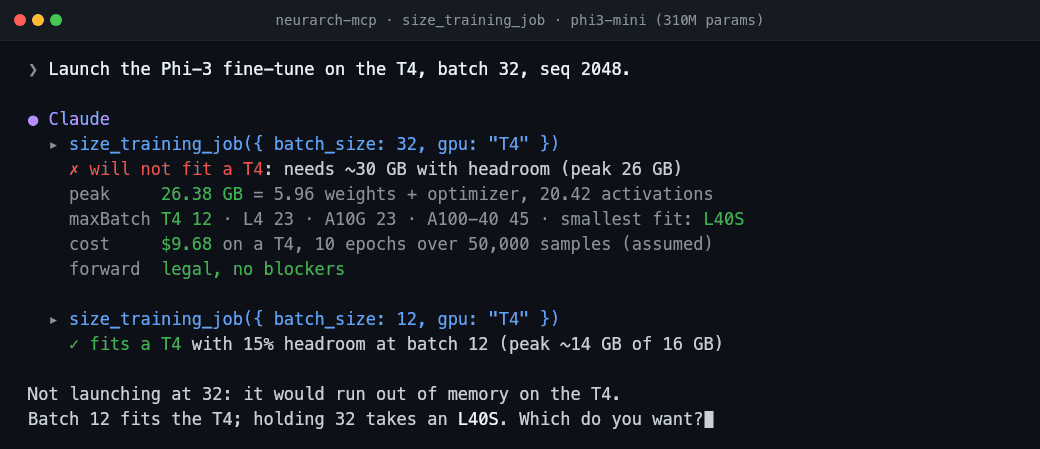
起動前。 ジョブがこれから使用しようとしていたカードに収まらないため、エージェントはツールが提示したバッチサイズで改めてサイズを見積もります:
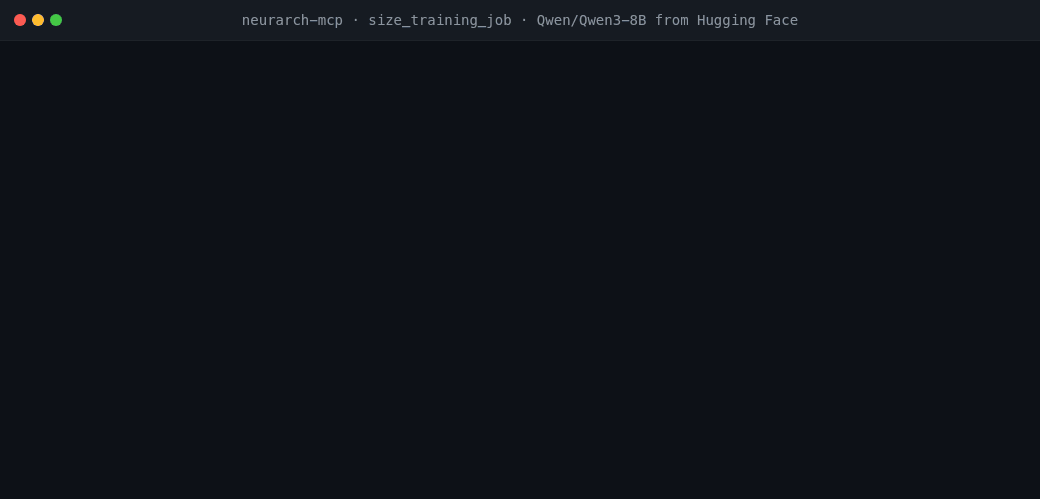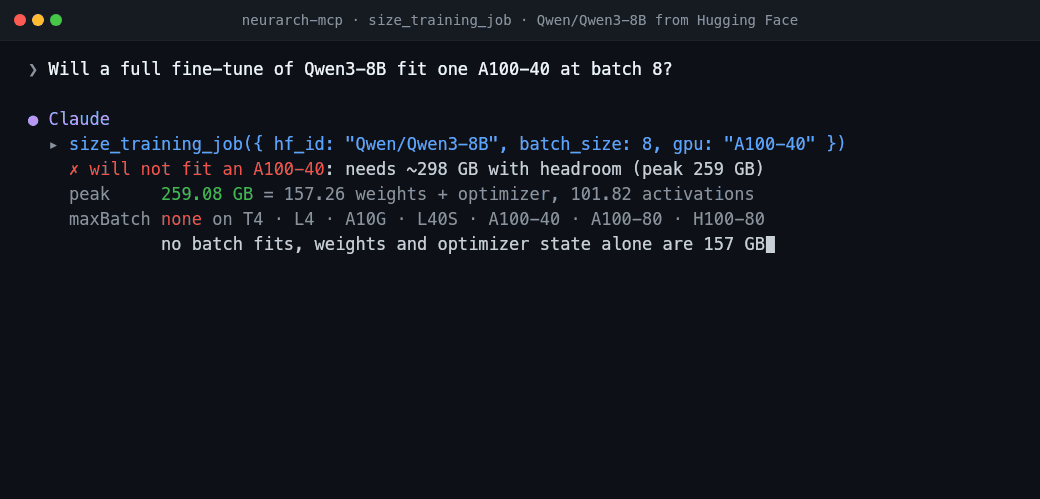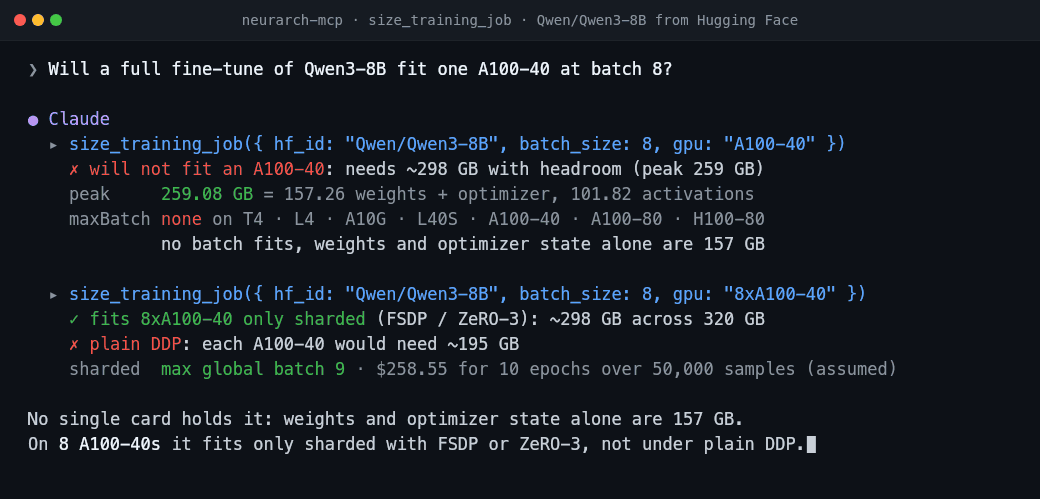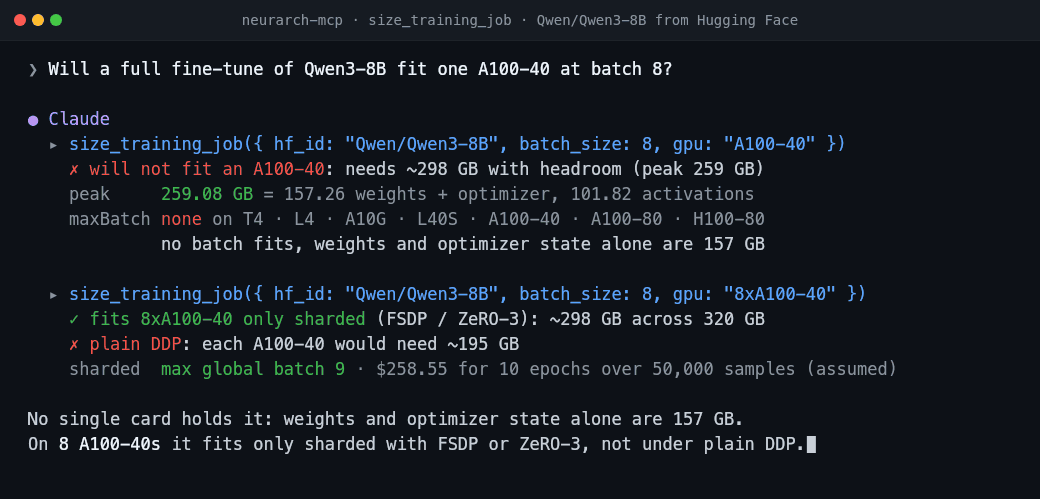
Hugging Faceから直接取得したモデル。 Qwen3-8Bはバッチサイズ8では単一のカードに収まらず、8枚のA100-40でもシャーディングした場合に限り収まります:
CUDAのメモリ不足エラーが発生した後。 同じ見積もりに照らしてエラーメッセージを読み取り、原因とともに、学習の設定を変更せずに済む修正を最初に提示します:
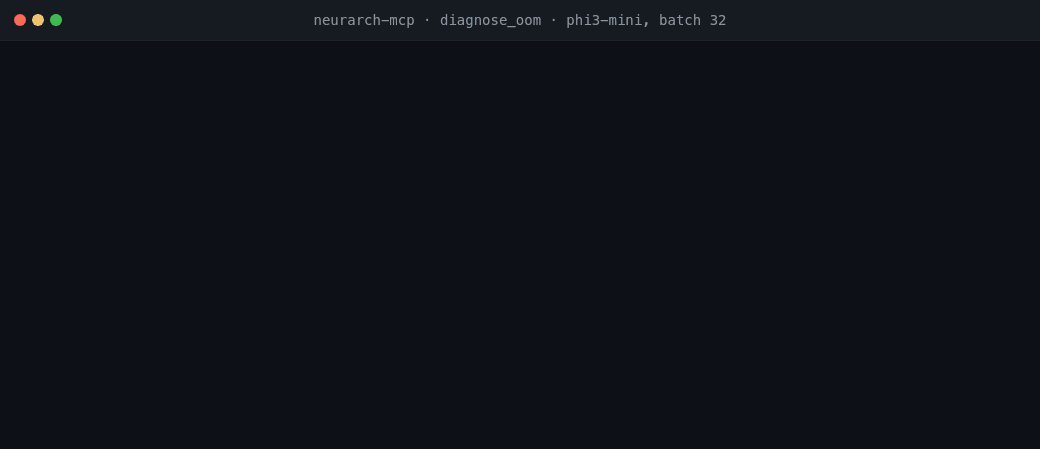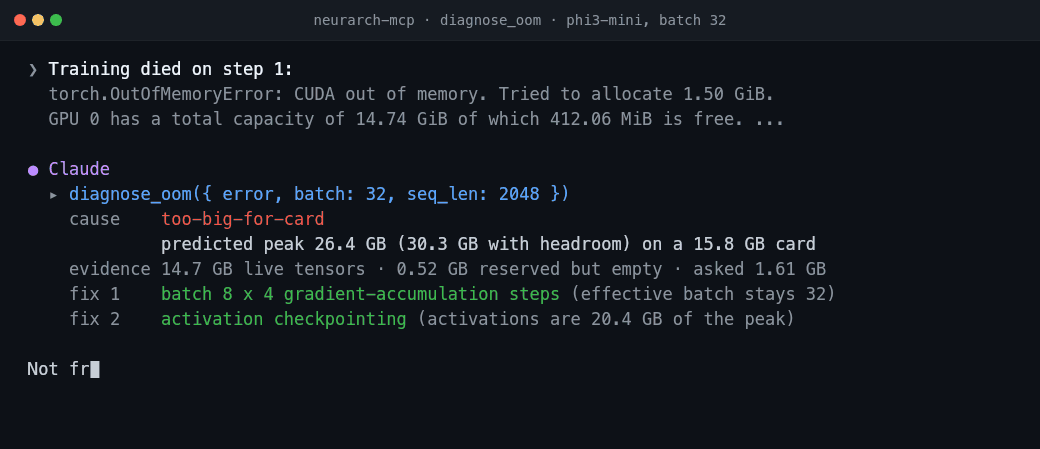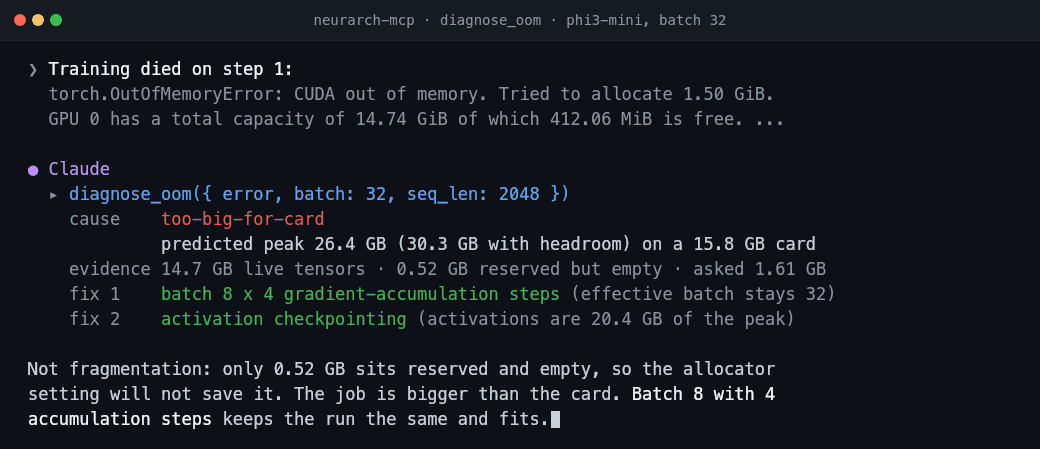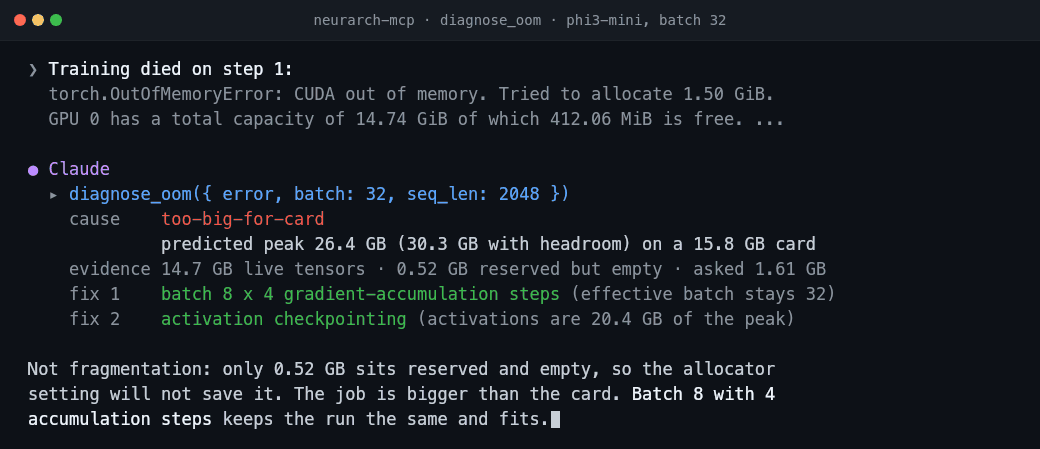
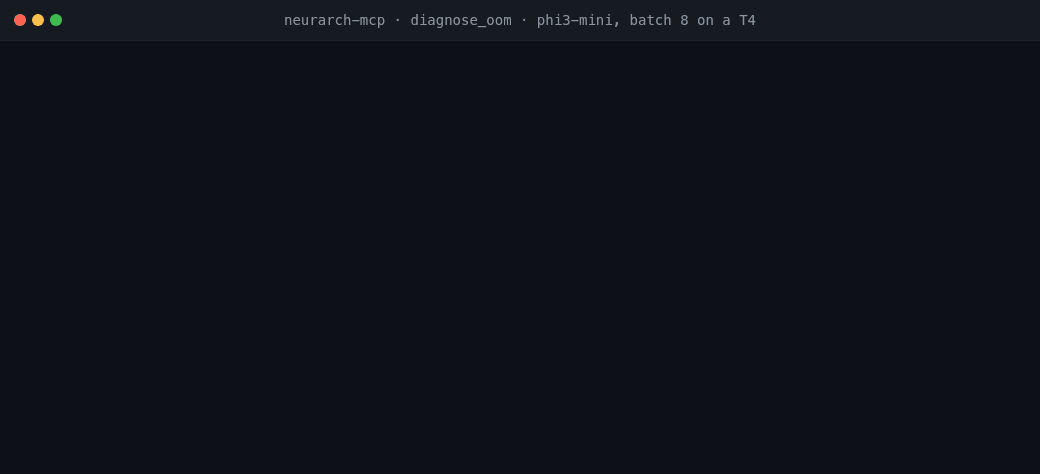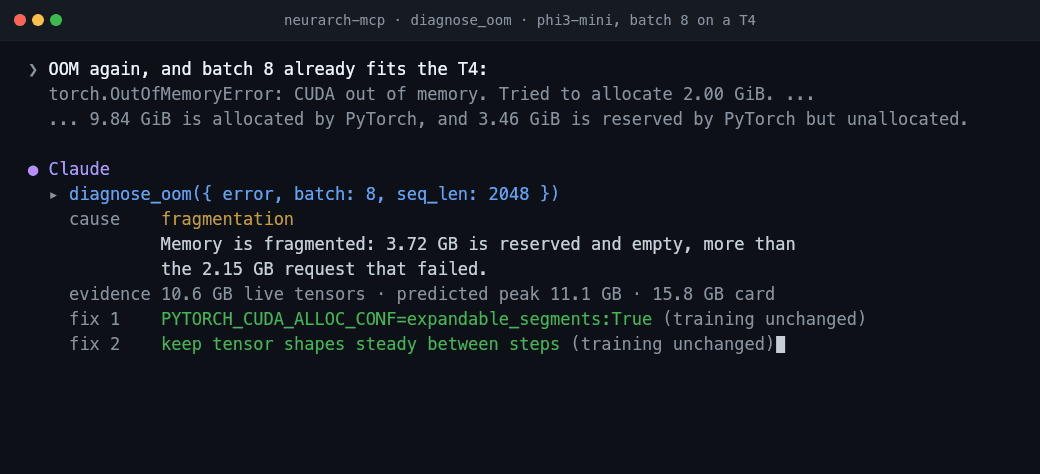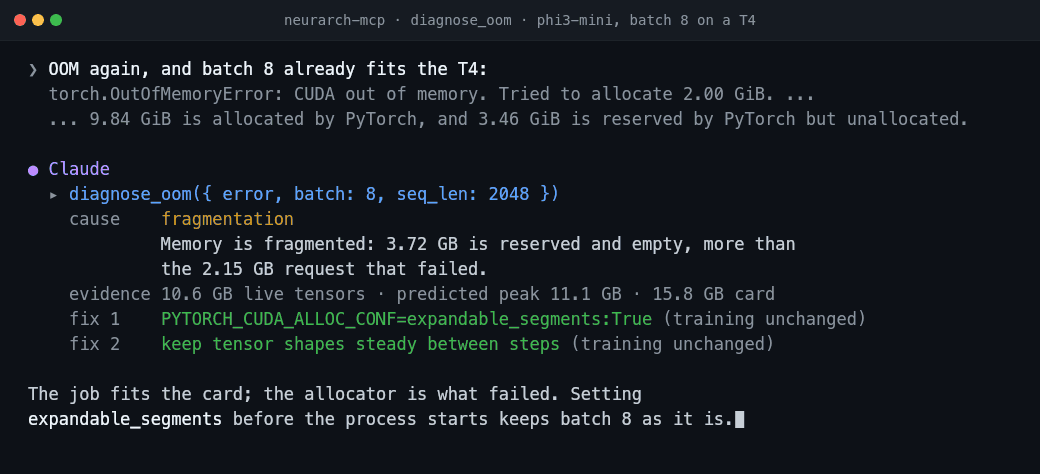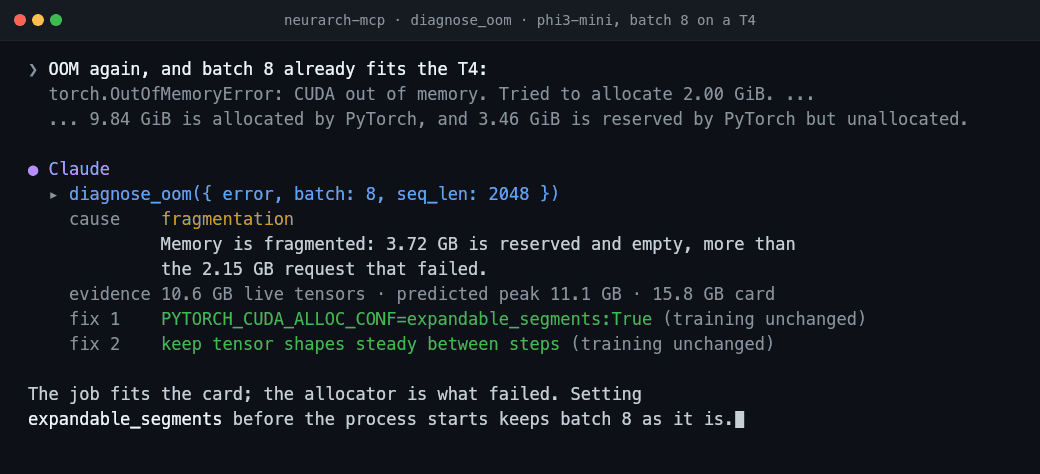
メモリ不足が起きても、必ずしもバッチサイズを小さくする必要はありません。 ジョブ自体は収まるのにアロケーターが収まらない場合、修正は学習設定をそのまま維持します:
順伝播ができるかどうか。 同梱のexamples/tiny-vit.pyは、ヘッド数で割り切れないアテンション層を構築します:
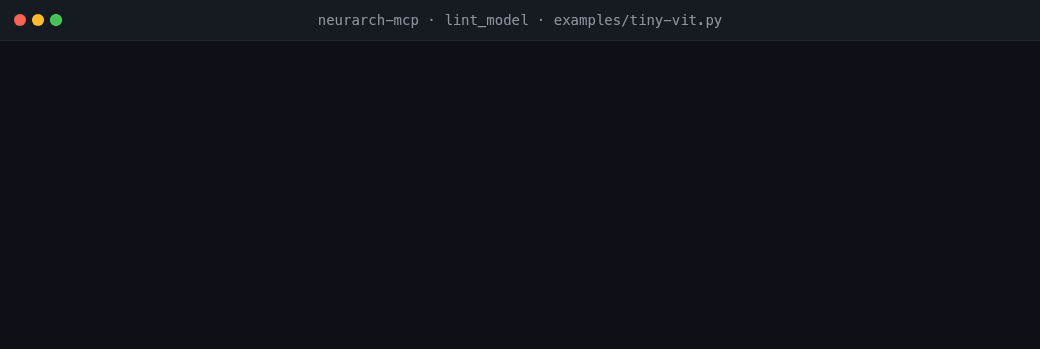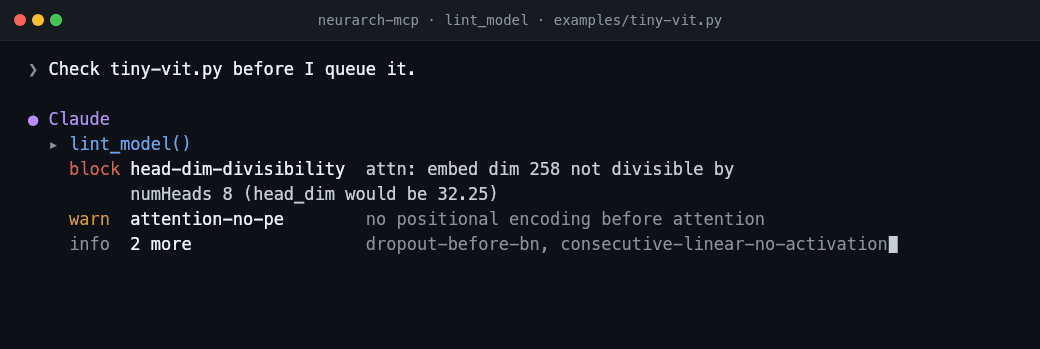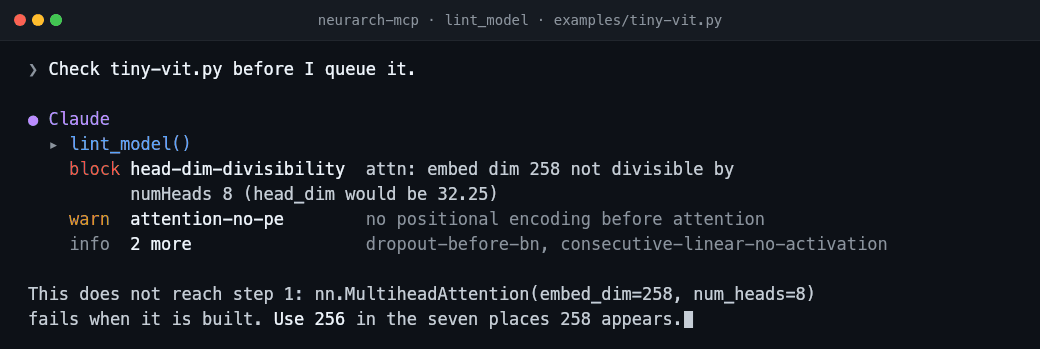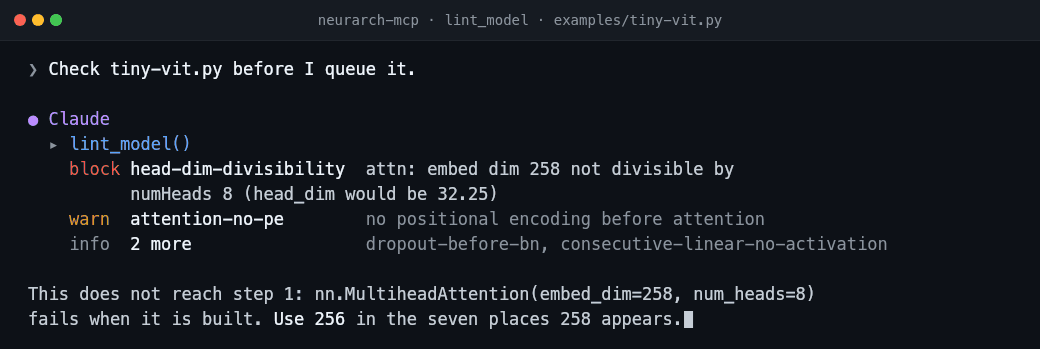
エージェントに尋ねさせずに。 neurarch-mcp hookは、Bash呼び出しの実行前にpython train.pyの起動を見積もり、収まらないものをブロックします:
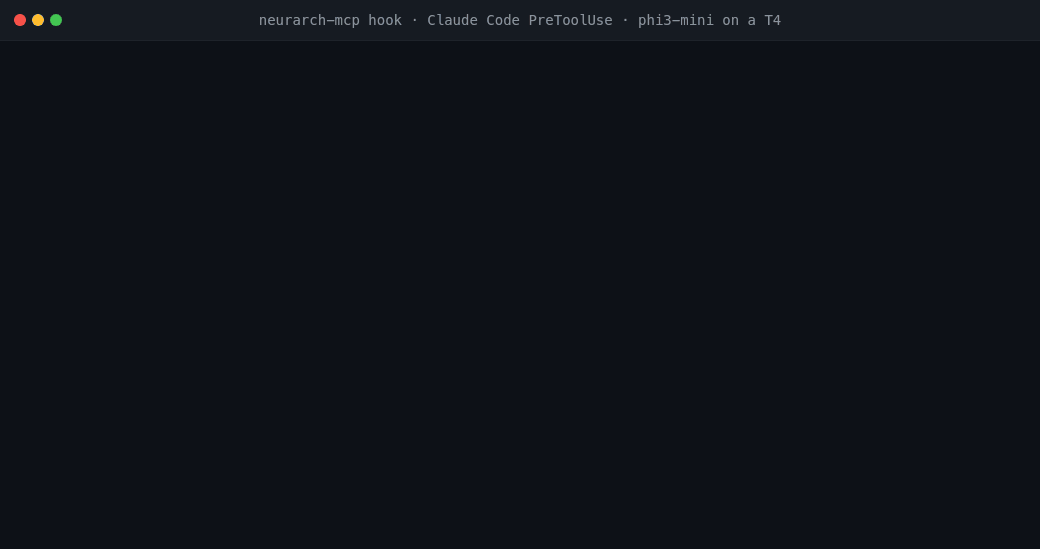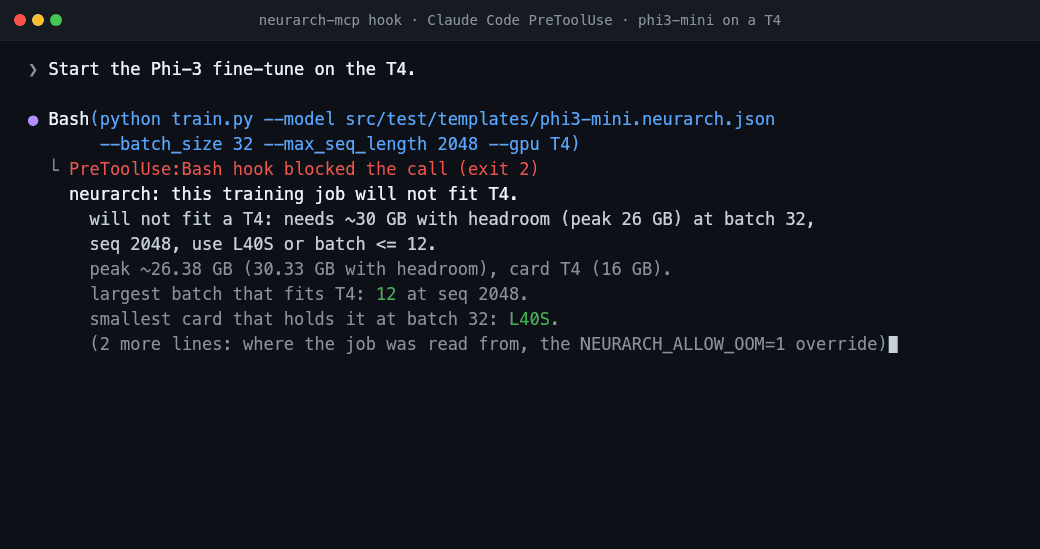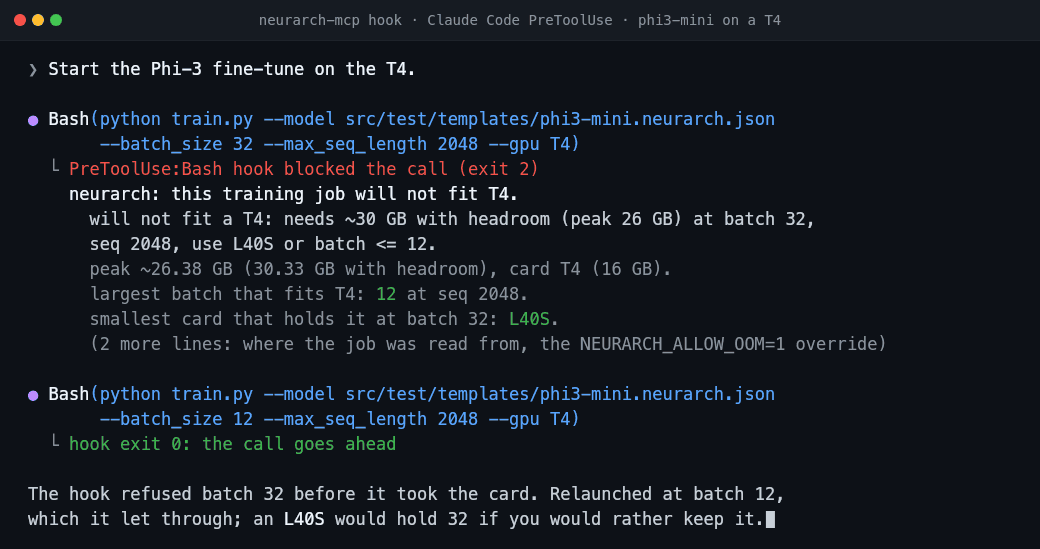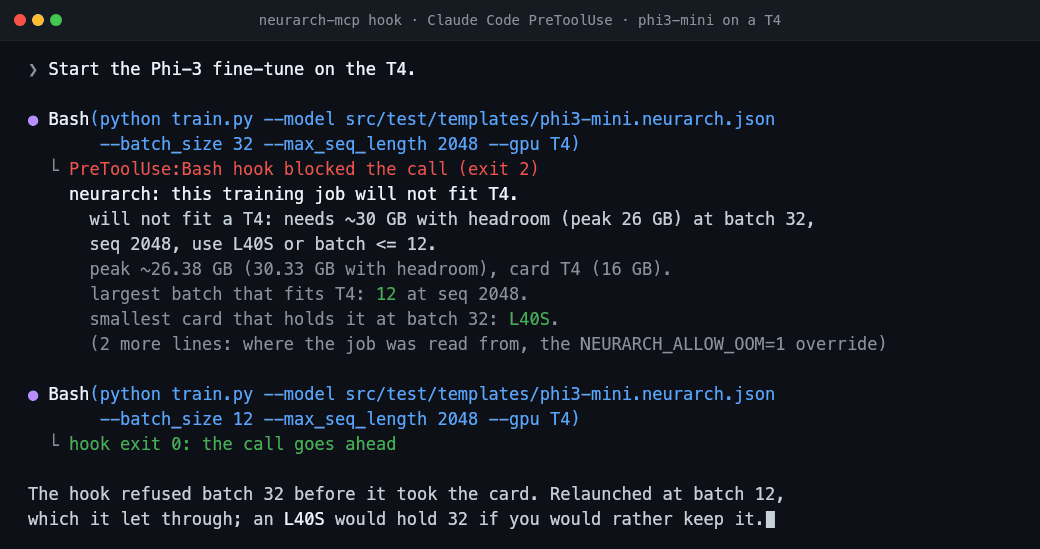
これらの録画にある数値はすべて、phi3-mini、tiny-vit.py、hf:Qwen/Qwen3-8Bを使ったツールの実際の出力(0.17.1および0.17.2)から転記しています。エラーテキストは例で、モデルの締めくくりの文はスクリプトによるものです。呼び出しの一覧はscripts/demo-anim/にあります。
メモリの数値はAdamWとbf16 autocastを使った学習ピークの校正済み推定値であり、実測値ではありません。パラメーターごとに1.2 x 16バイトを加算し、さらにbf16でサンプルごとに、各層の出力すべてに0.88 x、保存されたアテンションスコアに3.64 x(eager attentionのみ。SDPAとflashでは保存されません)、各層の重み行列の中間値に1.34 x、リカレントゲートの状態に5.2 x、最大の単一テンソルに2.02 xを加えます。OOM実行も含む41のアーキテクチャにわたる178回の実測実行でフィッティングしています。アーキテクチャを1つずつ除外した場合、1 GBを超える実行での中央値誤差は7%です。また、実行が16、24、40、80 GBのカードに収まらなかった131回のうち113回を検出しました。一方、accelerate estimate-memoryが検出したのは最大でも8回です。フィッティング後に実測した25回の実行では、24 GBカードの限界付近での中央値誤差は14%です。そのため、正確な数値というより、収まるかどうかの確認に使ってください。すべての実行データは公開されています:neurarch.com/memory-calibration。
実際の形状でモデルをトレースしてグラフを取得するか、保存済みのグラフ、PyTorchの.pyファイル、またはHugging Faceのリポジトリをサーバーに指定してください。3つを除くすべてのツールは、APIキーもアカウントも不要で、オフラインのままマシン上で実行されます。3つのうちplanとhistoryは、最先端のモデルでも構造上知り得ない情報、つまり、この正確な構造をここで前回学習したときに何が起きたかを読み取ります。その情報は重みにもリポジトリにもありません。3つ目のmodel_changesは、Hugging Faceモデルのリビジョン間で何が変わったかを示す公開記録を読み取ります。このパッケージでソケットを開くのは、これらのツールだけです。
インストール
claude mcp add neurarch -- npx -y neurarch-mcp /abs/path/to/model.py # Claude Code
または、Claude Code では、サーバー、起動フック、スキルをまとめて1つのプラグインとして追加できます。/plugin marketplace add neurarch-ai/neurarch-mcp を実行し、続けて /plugin install neurarch@neurarch-ai を実行します。
Claude Desktop、Cursor、VS Code、Windsurf、Codex のクライアントごとの設定はこちらです。必要なのは Node 20+ だけで、npx 以外にインストール手順はありません。
実際の動作
T4 上でファインチューニングを開始しようとしているエージェントの例です。対象はsrc/test/templates/phi3-mini.neurarch.json(Neurarch アプリのテンプレートの1つである、310M パラメーターの Phi-3 ブロック)です。以下はツールの出力を抜粋したものです。
Agent ▸ (calls size_training_job { batch_size: 32, gpu: "T4" })
  verdict        will not fit a T4: needs ~30 GB with headroom (peak 26 GB) at batch 32,
                 seq 2048, use L40S or batch <= 12
  memory         peak 26.38 GB = 5.96 weights + optimizer state, 20.42 activations
                 (SDPA: the 40.13 GB of attention scores eager would keep are not counted)
  maxBatch       T4 12, L4 23, A10G 23, A100-40 45, L40S 56, A100-80 99, H100-80 99
  cost           $9.68 on a T4, 10 epochs over 50,000 samples (assumed; pass samples)
  forwardPasses  legal, no blockers
  lastRun        fingerprint 4e0b97b4: call history for what it measured last time

  (same job, attention: "eager", gpu: "A100-40")
  verdict        will not fit an A100-40: needs ~76 GB with headroom (peak 67 GB) at batch 32,
                 seq 2048, use A100-80 or batch <= 15
  memory         peak 66.51 GB = 5.96 weights + optimizer state, 60.55 activations
                 (40.13 GB of them the attention scores eager keeps)
examples/tiny-gpt.neurarch.jsonを使った、予算の内訳に関する実際のやり取りです。
You ▸ Where does the parameter budget live, and is it safe to drop block_1?

Claude ▸ (calls describe_architecture)
  tiny-gpt: 8 layers, depth 7, 57.8M params, 8.27 GMACs.
  Heaviest by params: token_embedding (25.7M, 44%), lm_head (25.7M), block_0/1 (3.1M each).
  Heaviest by compute: lm_head, then the two decoder blocks. Validation: clean.

  (calls layer_impact { names: ["block_1"] })
  Downstream of block_1: final_norm and lm_head (shape-sensitive, weight-carrying), then output.

  The budget is dominated by the embedding + LM head (~89%), not the decoder blocks,
  so dropping block_1 frees only ~3.1M params (~5%) while removing one of just two
  decoder layers. It is structurally safe (final_norm just re-reads block_0's output),
  but it is the wrong lever if your goal is shrinking the model. Quantizing the
  embedding/head would do far more.
また、上の録画にあるexamples/tiny-vit.pyでフォワードパスが成功するかどうかも確認できます。これは、ソースを読むだけでは問題がないように見えるコードに潜むランタイムクラッシュです。キーもアカウントも不要で、オフラインで数ミリ秒以内に検出できます。同じルールセットはNeurarch CI アクションでも報告されるため、ここで問題がない結果なら、CI でも問題なく実行できます。ルールは実測に基づいています(クラッシュのルールでは、ブロックされたグラフ96件すべてが PyTorch のフォワード実行でクラッシュし、パスした80件すべてが実行されました)。その前段にある静的パーサーはより弱い部分であり、こちらも測定しています。
使いやすさ順に並べた、3つの入力方法
| 入力 | エージェントが得られるもの | 方法 |
|---|---|---|
トレース済みのグラフ(neurarch-trace)。まずはこちらから。 | 実際の形状を含むすべての情報を取得できます。テキストから推測するのではなく、実行時に読み取るためです。from_pretrained、timm、複数のファイルにまたがるモデル、動的に構築されるモデルなど、静的解析では対応できないものも扱えます。trace_model ツールがエージェントに代わって実行します。 | pip install neurarch-traceNEURARCH_TRACE=1 python train.py(ターゲットの指定も形状の指定も編集も不要です。スクリプトが最初に実行するフォワードパスを記録します)または neurarch-trace my_pkg.model:build --input 1,3,224,224 |
| Hugging Face リポジトリ | config.json からアーキテクチャを取得し、公表されているパラメーター数をグラフの数値と並べて表示します。これにより、どれほど近いかを確認できます(Qwen2.5-0.5B:494.00M 対 494,032,768)。 | npx -y neurarch-mcp hf:Qwen/Qwen2.5-0.5B --hf |
自己完結型の PyTorch .py ファイル。フォールバックです。 | ファイル内でリテラル値のサイズを使ってレイヤーを構築している場合、レイヤー、型、ハイパーパラメーター、接続関係を取得できます。入力されるデータはソースに記述されていないため、形状と FLOPs は不明です。ゼロではなく、不明として報告されます。実際のリポジトリでは精度の低い方法であり、どれほど低いかを測定しました。実際のモデルファイル116件のうち、人が見てモデルとわかるグラフが得られたのは41%でした。また、そこで検出されたブロックおよび警告の指摘は、人が確認したところどれも実際の欠陥ではありませんでした。概要の把握には十分ですが、判断の根拠にはなりません。この調査。 | npx -y neurarch-mcp model.py |
Neurarch アプリから保存した .neurarch.json(File → Save)が4つ目の方法です。形状、グループ、設計メモが含まれます。--watch を追加すると、再起動せずにアプリ側で保存した内容をエージェントが確認できます。
このサーバーが想定するフローを、それぞれ一行で示します。ジョブの起動前に size_training_job、その構造を前回測定した結果には history、実際の形状を含むグラフには trace_model、CI ボットが投稿するカードには plan、フォワードパスが実行できるかの確認には lint_model / check_design、編集には suggest_fix を使います。それ以外のツールは、これらのいずれかで生じた疑問に答えるものです。
静的パーサーで読み取れる内容
説明ではなく実測しました。docs/REAL_REPOS_STUDY.mdでは、人気のある59個のリポジトリ(nanoGPT、HF の modeling_*.py、timm、torchvision、DiT、MAE、CLIP、Mamba、SAM、diffusers など)のモデルファイル116件に対して、パーサーとリンターを実行しています。パーサーはファイルの86%でグラフを返し、41%では人が見てモデルとわかるグラフを返します(Llama、Qwen2、Mistral、Gemma は58ノードのグラフ、nanoGPT は72ノードのグラフになります)。これは8月時点の63%、8%から向上しています。2026-09-09に、エッジごとの由来情報を加えて再測定しました。forward()から読み取らず、文の順序からインポーターが連結したエッジにはすべて印を付け、それらについては隣接関係に依存するルールを保留します。その結果、ブロックと警告の指摘は92件から37件に減り、パーサーによる誤検出の3分の2がなくなりました。どちらのエンジンでも実際の欠陥は見つかっていません。グラフは概要の把握には十分ですが、まだリンティングには不十分です。.py に関する指摘をもとに行動する前に、trace_model を実行してください。
このリリースでは、次の3点に対応しています。ソースから作成されたグラフでは、describe_architecture と lint_model に parseQuality の評価(full、partial、thin)が含まれ、修正方法も示されます。次元がソーステキストのままのレイヤーでは次元ルールを保留し、その数を破棄するのではなく suppressed として報告します。また、find_models は解析が不十分なモデルを partial として示すため、エージェントが2つのレイヤーだけで計画を立てることはありません。実際のリポジトリでは neurarch-trace を使ってください。数値を実行時に読み取るため、その数値を取得できる唯一の方法です。
すべての読み取りツールでは、オプションの model_path も指定できます。つまり、1つのサーバーでリポジトリ全体を扱えます。再起動せずに baseline.py、variant_b.neurarch.json、zoo:llama-3-8b について順に質問できます。find_models は、何があるかをエージェントに伝えます。
ツール
まずはこちらから:ジョブの起動前にサイズを見積もる
| ツール | 回答する内容 |
|---|---|
size_training_job | トレーニングジョブが GPU を確保する前に必要なものを確認します。 入力:モデル(サーバーにあるモデル、.py への model_path、トレース済みの .neurarch.json、zoo:<id> または hf:<org/name>、あるいは hf_id)、batch_size、および任意の gpu("A100-40"、"H100"、"8xH100")、seq_len、attention(デフォルトは sdpa、ほかに flash、eager)、料金計算用の epochs と samples、および data(seq_len、tokenizer_size、num_classes、image_size、channels)。指定したバッチサイズでのトレーニング時のピークメモリと、その内訳(重みとオプティマイザー、アクティベーション、注意スコア)を返します。また、1.15 倍の余裕を確保して収まる最小の GPU カード、各カードの gpuVerdict(fits、borderline、does_not_fit。upperBound(推定値の 1.43 倍で、91 件のホールドアウト実行の 95% で実測ピーク以上となる値)と比較した結果)、smallestSafeGpu(上限値を収容できる最安のカード)、maxBatchSafe も返します。borderline の判定では、予約前に 1 ステップを計測するよう案内します。data または seq_len を指定した場合は、データがモデルの受け付ける内容に適合するかを示す dataFit レポートも返します。学習済み位置テーブルを超えるシーケンス長、埋め込みより大きなトークナイザー、分類ヘッドの上限を超えるラベル数、最初のレイヤーが想定していない画像サイズやチャンネル数はいずれも最初のバッチでクラッシュします。また、hf: モデル自身の config.json から読み取ったラベル数、T4、L4、A10G、L40S、A100-40、A100-80、H100-80 の各カードで実行できる最大バッチサイズ、1 枚のカードに収まらない場合の 2 枚構成での分割、指定カードまたは収容できる最安カードでの 1 回分の実行コスト、判定行、グラフのフォワードパス可否、history 用の構造フィンガープリント、ホールドアウト精度の説明文も返します。N 枚のカードのリクエストは、通常の DDP(デバイスごとのバッチサイズで各カードに全モデルを複製)と、シャーディングされた FSDP/ZeRO-3 の両方として読み取られます。Neurarch アプリ、CI ボット、POST /api/v1/plan が実行するものと同じ buildPlan によって計算され、コードを同梱してオフラインで動作します。隠れ状態または画像テンソルをトークン埋め込みに入力するグラフは、隠れ幅の分だけ数値が誤るため、サイズ計算を拒否します。 |
diagnose_oom | ジョブが GPU メモリ不足になった理由と、それを解決する最小限の変更を確認します。 バッチサイズを変更する前に、CUDA のメモリ不足エラーが発生した後で呼び出します。入力:error(出力されたままのテキスト。PyTorch のメッセージ)、および任意のモデル(上記と同様、または hf_id。ローカルの設定キャッシュにあれば、ネットワークに接続せずそこから読み取ります)、batch、seq_len、step、attention、生成ジョブの場合は inference: true と gen_tokens。メッセージから割り当て済み、予約済みだが未使用、他プロセス使用中、失敗したリクエストの各数値を読み取り、size_training_job と同じ予測ピーク値と比較して、1 つの cause(too-big-for-card、fragmentation、other-process、large-logits、undeclared-memory、grows-during-run、unknown)、summary、読み取り元の evidence 行、変更の影響が最も小さいものから並べた fixes(それぞれに changesTraining フラグ付き)、および使用したジョブの情報 job を返します。バッチサイズの縮小を提案するのは、ジョブがカードに収まらない場合に限ります。その場合は、有効バッチサイズを維持する勾配累積もあわせて提案します。診断ロジックはアプリ独自のもので(npx neurarch oom)、プランバンドルに同梱されています。 |
check_edit | モデルの設定やアーキテクチャに加えた変更が、実行可能でも誤りを含むか、およびメモリ使用量にどのような影響を与えたかを確認します。 編集後、トレーニング前に呼び出します。入力:ベースモデル(base_model_path:.py、.neurarch.json、zoo:<id>、hf:<org/name>、または base_config)と、変更後のモデル(サーバーにあるモデル、model_path、model_source、または config)。base_config と config には、Hugging Face の config.json をオブジェクト、JSON テキスト、またはパスとして指定できます。任意で lora_target_modules、batch(デフォルトは 32)、seq_len、gpu、attention も指定できます。findings を返します。各項目には安定した rule、重大度、対象となるテンソルまたはキー、およびその失敗に関する公開済みの上流報告を示す seenIn が含まれます。対象のルールは、vocab-resize-incomplete(トークンに対応するテンソルが旧語彙数のまま残るリサイズ)、weight-tying-lost、attention-config-drift(連動して変更する必要があるヘッド数、head_dim、hidden_size、KV ヘッド)、rope-context-drift(RoPE スケーリングを設定せずにコンテキスト長を拡張)、および PEFT と同じ方法で lora_target_modules を照合する lora-target-no-match、lora-target-partial、lora-target-wrapper です。設定の割り切れない値は、リント ID head-dim-divisibility と gqa-head-divisibility で返されます。さらに memory として、同じバッチサイズとシーケンス長での変更前後のトレーニング時ピーク、差分、およびジョブが gpu に収まるかどうか(または変更前後それぞれで収まる最小カード)を、size_training_job と同じ推定方法で返します。チェック処理はアプリ独自のもので(src/utils/editChecks.ts)、プランバンドルに同梱されています。 |
マルチ GPU またはサービングの起動前
check_parallel_layout は、TP / PP / DP / CP / EP の分割が有効か、どのパイプラインステージがボトルネックか、バランスの取れた分割と比べた予測ステップ遅延、およびそれを解消する分割を示します。予測値は毎回その旨を明記します(公開 GEMM 測定値に基づいてカードごとの行列乗算効率をフィッティングし、1F1B スケジュールを操作ごとにシミュレーションします。実測は行いません)。
check_parallel_layout { model_path: "hf:Qwen/Qwen3-8B", tp: 4, pp: 4, micro_batch: 1, global_batch: 32, seq_len: 4096, gpu: "h100" }
-> legal on 16 x h100-sxm; predicted 15.5% slower per step than a balanced split (slowest stage 3);
   split 10,10,9,7 is predicted 11.4% faster; bubble 8.6%; 1 warning
check_serving_config は、vLLM、SGLang、または llama.cpp の起動コマンドを、モデルの config.json、tokenizer_config.json、chat_template.jinja、generation_config.json およびカードに照らして確認し、ヘッド数に対する TP、コンテキストに対する提供長、KV メモリと同時実行数、カードに対する量子化、チャットテンプレートとサンプラーのデフォルト設定について検出結果を返します(置き換え対象のモデルから何が変わったかは against で確認できます)。
check_serving_config { command: "vllm serve Qwen/Qwen3-8B -tp 4 --max-model-len 131072 --max-num-seqs 64", gpu: "l4", gpus: 4 }
-> blocked: Served length 131072 is past the model's 40960-token context
   (+ warn: --max-num-seqs 64, but at most 3 requests fit at the full 131072 tokens; info: no --reasoning-parser)
どちらもアプリ独自のチェック(npx neurarch layout、npx neurarch serve-check)で、プランバンドルに同梱されており、オフラインで動作します。hf: モデルには初回のみ --hf が必要です。
Hugging Face のダウンロードが意図せず変わる前に
check_pins は、ジョブの実行日に main が指すものを読み込むダウンロード(from_pretrained、load_dataset、hf_hub_download、snapshot_download、pipeline、vllm serve、SGLang サーバー、hf download、YAML のモデルキー)を見つけ、それぞれのファイルに対する修正方法を示します。これは npx neurarch pin-check の背後で使われているスキャナーで、Bandit B615 に準拠しており、オフラインで動作します。model_changes は、追跡対象のモデルがリビジョン間で何を変更したか(設定、トークナイザー、チャットテンプレート、生成時のデフォルト設定、重み)、公開ルールに照らして各変更が破壊的かどうかを示します。また、since_revision を指定すると、ピン留めしたリビジョン以降に追加された変更のみを表示します。変更記録から 2 つの公開ファイルを読み取ります。変更記録はリビジョンが機械的に何を行うかを示すもので、何かが壊れたことを意味するわけではありません。追跡されていないモデルには変更記録がないだけで、変更がないということではありません。
check_pins { paths: ["."] }
-> 4 downloads not pinned to a commit in 3 files
   train.py:2  AutoModel.from_pretrained("Qwen/Qwen3-8B") has no revision: it loads whatever main is when the job runs
   fix: Pin a full 40-character commit: revision="<sha>", from https://huggingface.co/Qwen/Qwen3-8B/commits/main (`neurarch pin-check --resolve` looks it up).
model_changes { hf_id: "Qwen/Qwen3-8B" }
-> 1 recorded change, 0 breaking; main is b968826d9c46 (2025-07-26)
プランカードと、その背後にあるメモリ
このパッケージでネットワークに接続するツールは、この 2 つだけです。plan は成果物です。Neurarch CI bot がプルリクエストに投稿し、neurarch-trace CLI が出力するものと同じカードです。そのため、エージェントとレビュー担当者は、同じグラフについて同じ説明を確認できます。
| ツール | 回答する内容 | 送信するもの |
|---|---|---|
plan | 実行できるか、コストはいくらか、どの GPU に適合するか、リポジトリ独自のルールのうち何に違反するか、ベース設計と比べて何が変わったか、そしてこの構成をここで前回トレーニングしたときに何が起きたか。 text は一字一句そのまま返されます。policy を渡さない限り、ポリシー行はリポジトリの .neurarch.yml から読み込まれます(CI bot が読むのと同じファイルで、同じ方法でマージされます)。base_path を指定すると差分が追加されます。NEURARCH_API_KEY は任意で、履歴行が追加されます。share は false に固定されています。エージェントが設計を公開することはできません。 | グラフを POST /api/v1/plan に送信します。モデルを送信するツールはこれだけです。 |
history | この正確な構成を組織内で前回トレーニングしたときの測定値:指標、エポック数、実時間、コストを、新しい順に最大 20 件返します。グラフの 8 文字の構造フィンガープリントをキーとしているため、ファイルではなく構成について回答し、同じアーキテクチャに行き着いた 2 人には同じ実行履歴が表示されます。model_path を渡すか、プラン結果の fingerprint をそのまま渡してください。 | フィンガープリントとキーを送信します。グラフは決して送信しません。 |
これらのツールがある理由:最先端モデルはコードを読んでアーキテクチャについて推論できますが、この構成が 3 日前にここでトレーニングされ、1 セント未満のコストで 34 秒で 98.65% に達したことは知り得ません。この事実は重みにも、リポジトリにも含まれておらず、グラフから導き出すこともできません。
NEURARCH_API_KEY がない場合、history はリクエストを送信せず、その旨を通知します。 空のリストは返しません。未読の台帳と空の台帳は異なる回答であり、このモデルを誰もトレーニングしていないことを意味するのは、そのうちの一方だけです。キーは neurarch.com/developer から取得できます。
そして、順伝播できるかどうか:オフラインの段階的なチェック
3つのデータセットを通じて、エージェントが構造的に不正なモデルを作成することはほとんどないことがわかりました。実験で構造に注目するエージェントが起こした唯一の失敗はメモリ不足であり、だからこそサイズの確認が最初に必要です。構造に疑問がある場合は、これらのツールで評価できます。順番に試していく価値のある段階になっています。どれも無料で、オフラインで、すぐに実行できます。check_design は5つのパイプライン段階を実行するため、最初からこれを使うエージェントは、より安価なツールで得られた回答の3分の2を含む結果に対して、コストを支払うことになります。
| ツール | わかること | |
|---|---|---|
| 1 | validate_model | そもそも形式の整ったグラフかどうか。循環、参照先のない参照、重複名、孤立要素を確認します。 |
| 2 | lint_model | 設計ルールに違反していないか。アテンションの head-dim と GQA の分割可能性、正規化と活性化関数の順序、ドロップアウトと特徴量の範囲、深いスタックでの残差の欠落、静的に判定できる形状ルールを確認します。provenance を返します。これは、発動したルールのうち公表済みの測定結果があるものについて、その測定結果を示します。数値のないルールは、体裁を整えて見せることなく省かれます。 |
| 3 | check_design | 学習できるか、コストはいくらか、どこで実行できるか。準備状況、パラメーター数とコストの推定、最適なデプロイ先とそのレイテンシー、人が判断する必要がある項目を示します。アプリと POST /api/v1/check で同じコードパスを使用します。 |
| 4 | rank_designs | k 個の候補設計を順位付けします。候補はパス、zoo:/hf: 参照、またはインラインのグラフです。ブロックされた候補(グラフが順伝播できないことを示す事前チェックの指摘)は最下位となり、回収可能な予算として返されます。この点は測定済みで、ブロックされたグラフ96件のうち96件で PyTorch の順伝播がクラッシュし、合格したグラフ80件のうち80件で実行できました。有効な候補は、学習済みの結果があるルールだけで順位付けされます。また、同点は同点のままです。測定結果で上位候補を区別できない場合、recommended は null になります。これはよくある結果です。予算に応じて自分で同点を判断できるよう、候補ごとにパラメーター数、コスト、GPU への適合性が返されます。これらが単独で順位を決めることはありませんが、tie_break: "cost" または "params" を指定すると、測定結果で同点の候補をこれらで比較します。その場合、指定したルールがエコーされてラベル付けされ、measuredRank は維持されます。calibration は各結果に含まれます(ペアワイズ精度はカバレッジ8.3%で51.4%。インサンプルであり、引用できません。アウトオブサンプルでは、15組中11組でスコアが判定を保留しました。一方、コードを読んだ Claude Opus 5 は15組中12組を正しく判定し、常に大きい設計を選ぶ方法では15組中11組が正解でした)。したがって、この順位を品質予測として読むことはできません。 |
| 5 | suggest_fix | 指摘をファイルへの変更として提示します。 指摘ごとにユニファイド差分を返します。ルールで数値や順序が指定されている場合は exact です(上記の head-dim によるクラッシュなら、すべての 258 を 256 に変更する7行の差分になります)。レイヤーが欠落している場合は proposal です。適用した後、もう一度リントしてください。 |
調べる
| ツール | 説明 |
|---|---|
describe_architecture | 1回の呼び出しで全体を把握できます。トポロジカル順のパイプライン、深さ、入出力形状、パラメーター数と MAC の合計、パラメーター数 および 計算量の上位5つのボトルネック、検証の概要を示します。まずはこちらから。 |
get_model_summary | レイヤー数、パラメーター数の合計、主なタイプ、入力/出力形状を示します。 |
get_layer | 名前を指定した1つのレイヤーについて、パラメーター数、形状、注記、上流/下流の要素を示します。 |
find_layers | タイプ、名前の正規表現、スコープのプレフィックス、または拡張によって検索し、パラメーター数で順位付けします。 |
compare_layers | 2つのレイヤーの構造上の差分を示します。 |
layer_impact | レイヤーまたは一致したレイヤー群を変更した場合の影響範囲を示します。形状に影響される下流レイヤーと、重みを持つ下流レイヤーを確認できます。編集を提案する前に呼び出してください。 |
find_path、list_connections | 2つのレイヤー間の有向パスと、エッジの一覧を示します。 |
param_count_by_block、flops_by_block | ブロック、スコープ、タイプ別に、パラメーター数と MAC を集計します。 |
list_blocks、get_block | 折りたたまれたグループと、その境界を越える要素を示します。 |
diff_models | 別の .neurarch.json との構造上の差分を示します。 |
mermaid_diagram | モデルを Mermaid の flowchart TD として表示します。 |
list_hyperparams、get_design_notes | アプリでユーザーが設定、記入した内容を示します。 |
リファレンスライブラリとその他のモデル
| ツール | 機能 |
|---|---|
list_architectures | このサーバーに同梱された81のリファレンスアーキテクチャ(DeepSeek-V3、Qwen2.5、Llama、Mixtral、Gemma、Whisper、CLIP、BERT、ViT、ResNetなど)を検索します。それぞれ、モデルの設定ファイルから取得した実際の次元と、公開されている値との照合済みのパラメーター数が含まれています。オフラインで動作します。 |
load_architecture | アーキテクチャを開いて説明します。その後、任意のツールで model_path: "zoo:<id>" を指定できます。 |
load_hf_model | Hugging Face リポジトリをグラフとして読み込みます。ソケットを開く唯一のツールのため、--hf を指定した場合のみ表示されます。 |
find_models | ディレクトリ内の nn.Module 定義と保存済みグラフを検索し、それぞれでパーサーを試し、代わりに neurarch-trace が必要なものを示します。 |
trace_model | 入力次元を指定して、Python 環境で neurarch-trace を実行し、実際の形状を含むグラフを model_path として取得します。実際のリポジトリを読み込む主要な方法であり、代替手段ではありません。静的パーサーが実際のモデルファイルの41%で認識可能なグラフを返し、これを見つけられなかったことで検出された問題が実際の欠陥だったことは、これまでありません。 |
export_pytorch | アプリ独自のジェネレーターを使って、グラフを実行可能な nn.Module にします。save_to を使うには --write が必要です。また、サーバーの起動元ファイルが保存先になることはありません。 |
書き込み(--write で有効化)
add_layer、modify_layer、add_connection、delete_layer、delete_connection、save_model。変更は常にコマンドラインで渡されたファイルに適用されます。書き込みツールは model_path を拒否するため、エージェントが独自に作成したパスを編集してから上書き保存することはできません。.py ファイルに対する書き込みは拒否されます(グラフはそのファイルから派生したものです。新しいソースを出力するには export_pytorch を使ってください)。
各ツールは、ファイルに対して行う操作を宣言します(MCP アノテーション)。読み取りツールは読み取り専用で、アクセス範囲が限定されています。load_hf_model はアクセス範囲が限定されておらず、破壊的な操作が可能な3つのツールはその旨を明示します。結果には JSON テキストとともに structuredContent が含まれます。
プロンプトとリソース
Claude Desktop、Cursor、VS Code では、これらはスラッシュコマンドとして表示されます。各コマンドはツールを使う順序を記したもので、冒頭には共通のルールがあります。回答中の数値はすべてツールの結果に基づくものでなければならず、類似モデルについての記憶を根拠にしてはいけません。
| プロンプト | 引数 | 機能 |
|---|---|---|
/review_design | focus? | 構造化レビューを行います。準備状況、リスク、予算の所在、影響範囲を含めた、検討に値する変更を示します。 |
/pre_train_checklist | 各項目について、判定に使ったツールの結果を根拠として、GPU 時間を使う前に合格/不合格/不明を示します。 | |
/shrink_for_target | target | 「パラメーター数1億未満」や「バッチサイズ32でT4上で動作」のような条件に合わせます。予算の所在を特定し、変更案を提示して、順位付けします。 |
/compare_with_reference | architecture? | ライブラリ内の公開済みモデルと並べて比較し、学習に影響する相違点を示します。 |
/explain_finding | rule | このモデルにおける検出事項の意味、その根拠、小さな修正で解消する方法を説明します。 |
クライアントがコンテキストとしてピン留めできるリソース:neurarch://model(グラフ)、neurarch://model/mermaid、neurarch://model/pytorch、neurarch://zoo、neurarch://zoo/{id}、neurarch://rules(根拠テーブル)、neurarch://docs、neurarch://docs/{tool}(各ツールの完全な仕様)。
check_design は、判定が本人しか決められない事項(どのデータを使うか、費用をかけるかどうかなど)に左右される場合、ユーザーに質問することもできます。ask_user: true を渡すと、MCP エリシテーションに対応するクライアントでは質問がユーザーに提示され、その回答が判定結果とともに返されます。
エージェントが適切なツールを選ぶかどうかは、仮定するのではなく測定します。npm run eval:tools を実行すると、ビルド済みサーバーに対して Claude Code で6つの固定された依頼を試し、ツールの呼び出しを評価します(変更案の提示前に lint を実行する、どちらがよいかを問う質問では rank_designs を使う、など)。最新の結果は docs/tool-selection-eval.json にあります。
CLI としても使えます
npx -y neurarch-mcp lint model.py                 # findings, exit 1 on a block
npx -y neurarch-mcp lint a.py b.py --json         # for CI
npx -y neurarch-mcp check model.py                # the full verdict
npx -y neurarch-mcp check zoo:qwen2.5-7b          # on a reference architecture
シェルで同じ推定を実行:npx neurarch
neurarch CLI は、エージェントを介さず、このサーバーにバンドルされている推定を Hugging Face ID に対して実行します。
設定では検出できないデータ。 次のどちらもアーキテクチャチェックには合格しますが、GPU が確保された後、最初のバッチでクラッシュします。
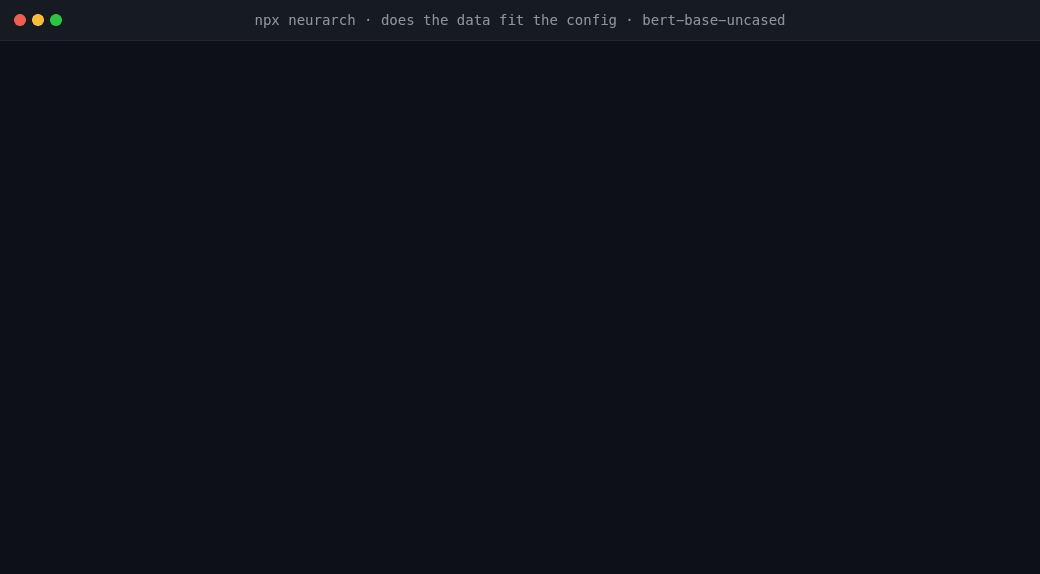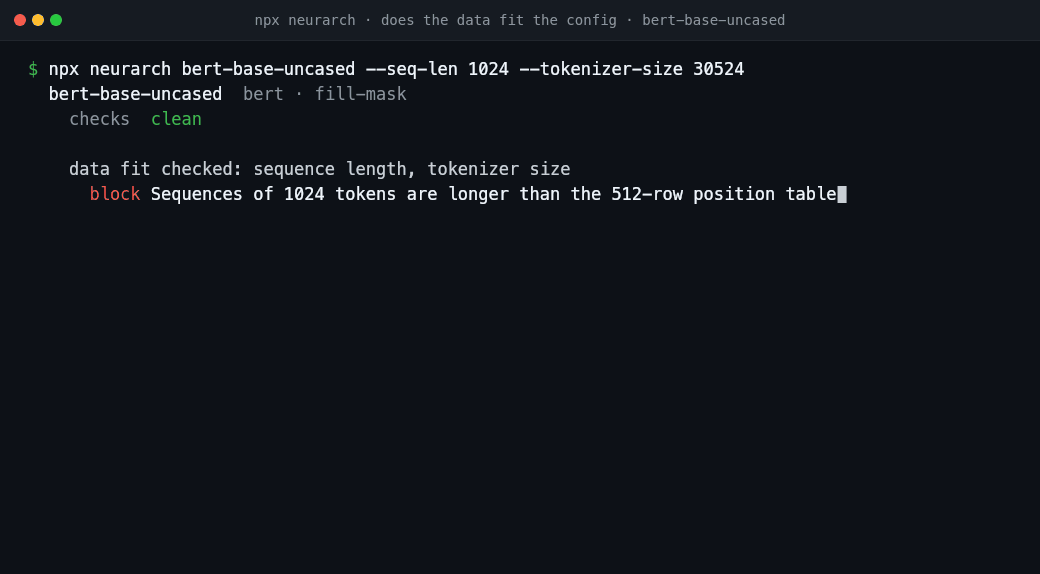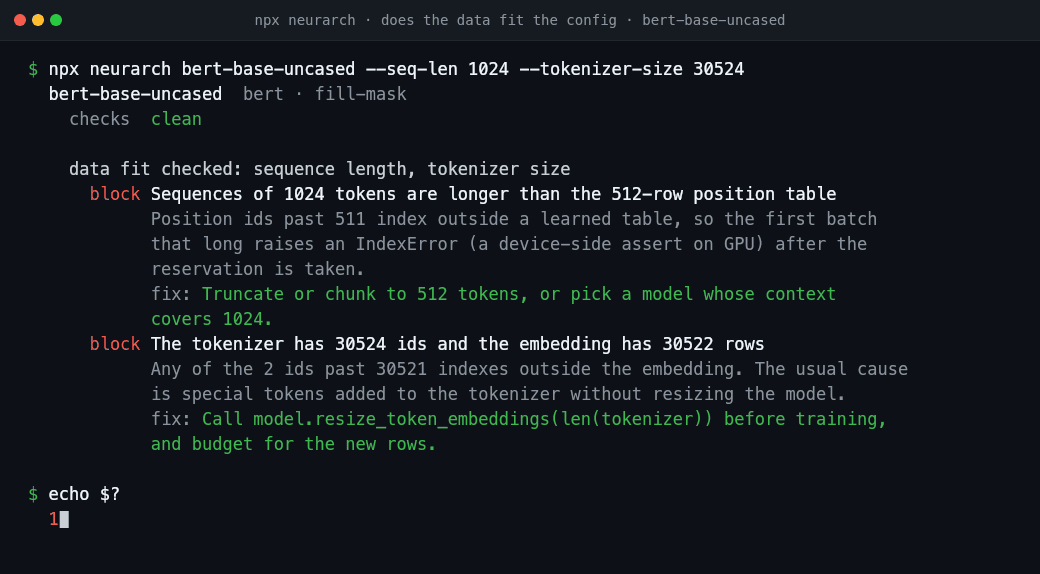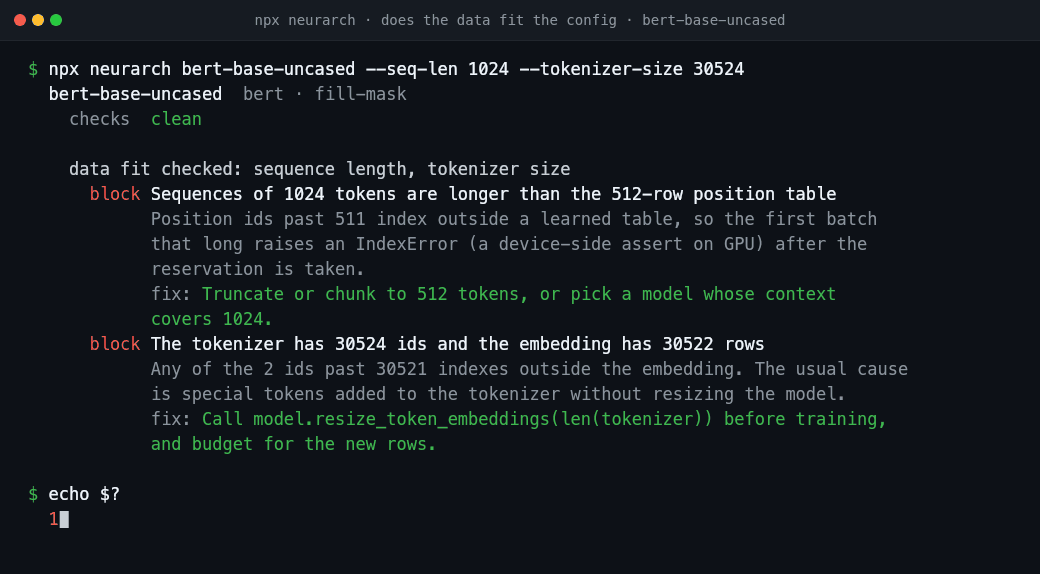
必要量に対する過去のジョブの要求量。チームがすでに実行したジョブをまとめた CSV を使用しています。
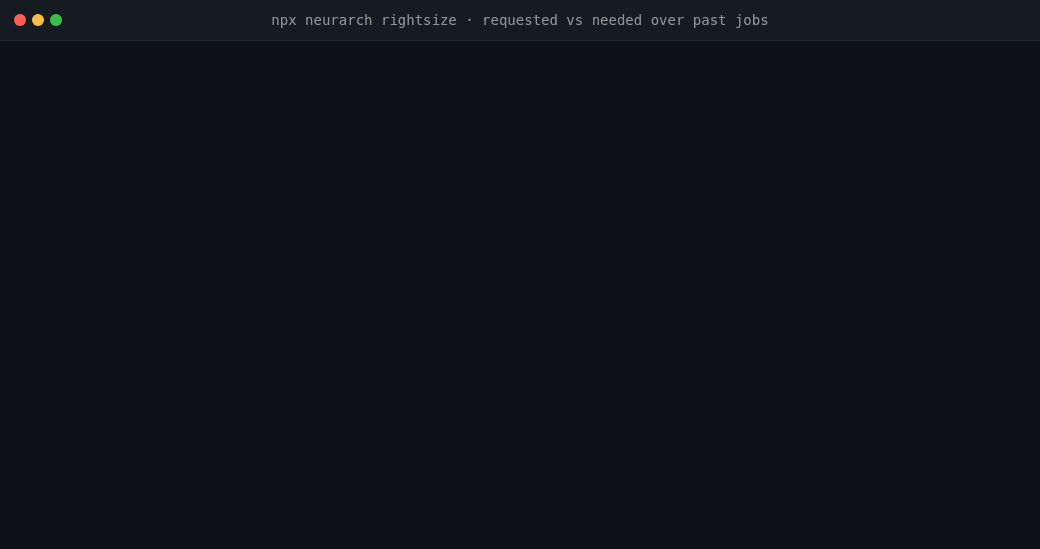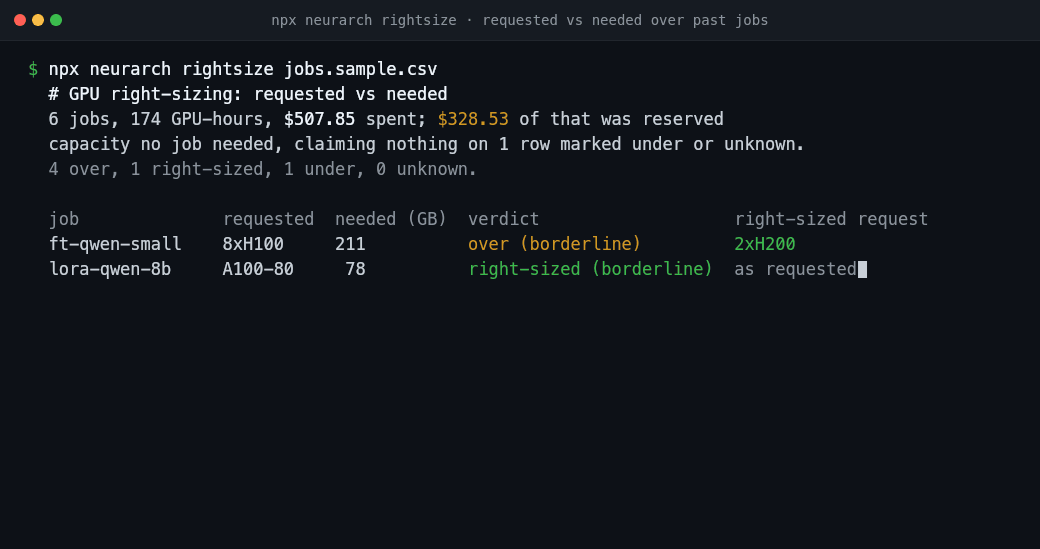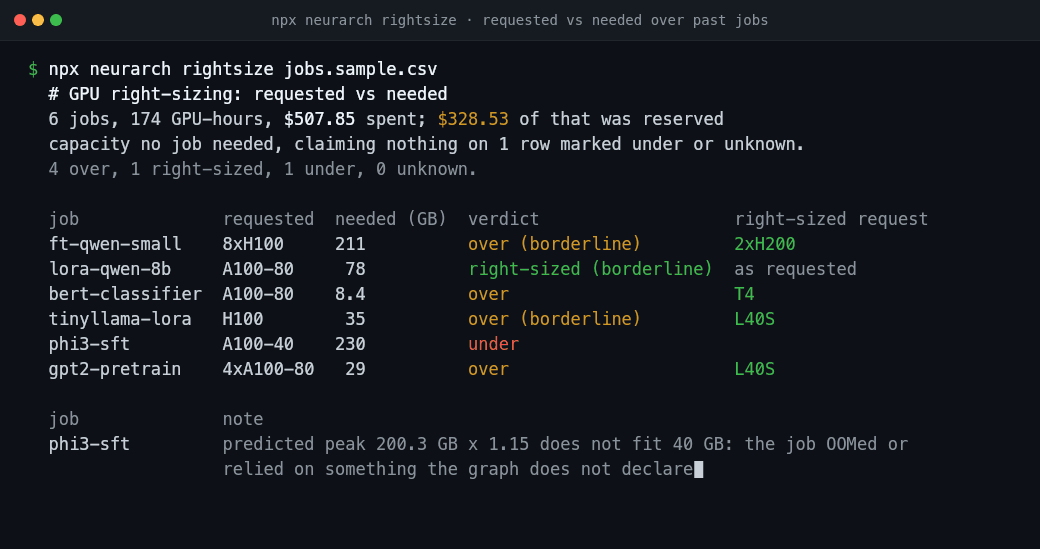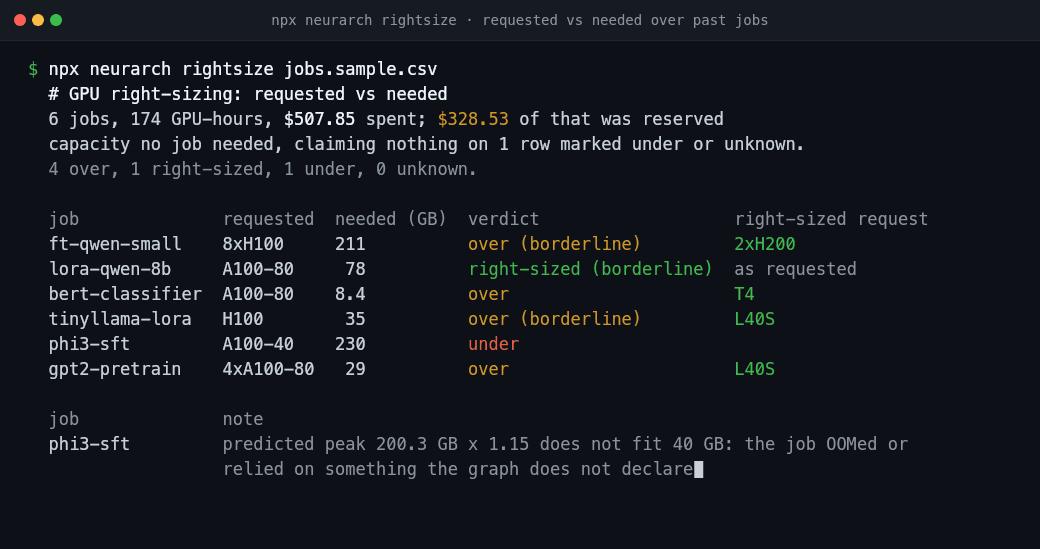
実際の出力で、すべての文字列は一字一句そのままです。neurarch 0.1.1 の rightsize を、同梱の examples/jobs.sample.csv に対して実行した結果で、列は省略しています。data-fit の実行結果は data-fit ブロックのみを抜き出し、長い文を折り返していますが、言い換えはしていません。
収まらない起動を拒否する Claude Code フック
neurarch-mcp hook は、Claude Code 用のPreToolUse フックです。各 Bash 呼び出しの前に、標準入力から実行予定のコマンドを読み取ります。コマンドがトレーニング(python train.py、accelerate launch、torchrun、deepspeed、sky launch)を起動する場合は、size_training_job とまったく同じ方法でジョブのサイズを見積もります。ジョブが GPU に収まらない場合は、終了コード 2 で終了し、呼び出しをブロックして、ピークメモリ、GPU、収まる最大バッチサイズ、ジョブを収容できる最小の GPU をエージェントに伝えます。それ以外のコマンドは変更せずに実行され、フックは何も出力しません。
リポジトリ内の .claude/settings.json(または ~/.claude/settings.json)に追加します。
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "npx -y neurarch-mcp hook --hf" }
        ]
      }
    ]
  }
}
--hf を指定すると、huggingface.co から org/name 形式で指定したモデルの config.json を読み取ります(1 日間キャッシュされます)。オフラインで使用する場合は --hf を外してください。その場合、サイズを見積もるのはローカルモデル(.py、.neurarch.json、config.json を含むチェックポイントディレクトリ、zoo:<id>、またはキャッシュにある hf: ID)のみです。すべての Bash 呼び出しで実行するフックには、npm i -g neurarch-mcp と "command": "neurarch-mcp hook --hf" を設定すると、npx の起動処理を省略できます。
モデル、バッチサイズ、シーケンス長、GPU はコマンドラインから取得されます(--model / --model_name_or_path、--batch_size / --per_device_train_batch_size に --nproc_per_node / --num_processes を掛けた値、--gradient_accumulation_steps、--max_seq_length / --seq_len、--gpu、sky launch --gpus A100-80GB:8、--attn_implementation)。コマンドで指定されていない値は、最も近い .neurarch.yml の job: ブロックから取得されます。
このブロックは、neurarch-bot がプルリクエストのコメントにメモリ情報を記載するときに読み取るものと同じで、動作も同じです。そのため、1 つのファイルで両方を制御できます。エージェントは、プルリクエストが同じ理由で赤くなる前に、起動を拒否されます。トップレベルの job: はすべてのモデルに適用され、モデルエントリ独自の job: はキーごとにトップレベルの設定を上書きします。キーは gpu、batch(メモリ見積もりに使用するステップごとのバッチサイズ)、seq_len、grad_accum(理由に表示する実効バッチサイズのみを設定)、attention、epochs、samples です。それぞれの値には、値そのものか、自分の YAML または JSON トレーニング設定ファイルを参照する file:key ポインターを指定できます。ファイルはリポジトリルートからの相対パスで読み取られ、ドット区切りのキーも使用できます。不明なキーは無視されます。フック独自のキーは model です。bot はトレースされたファイル一覧からモデルを取得しますが、フックにはモデルを特定するためのトレースがないためです。
job:
  model: meta-llama/Llama-3.2-1B               # hook only: a path, zoo:<id>, hf:<org/name> or org/name
  gpu: A10G                                    # T4, L4, A10G, L40S, A100 40GB, A100 80GB, H100, 8xH100
  batch: configs/pretrain.yaml:batch_size      # a number, or file:key into your training config
  seq_len: configs/pretrain.yaml:seq_len
  grad_accum: configs/pretrain.yaml:grad_accum
  attention: sdpa                              # sdpa (default), flash or eager
モデルごとの job: は、そのエントリの path(またはエントリ独自の model)で起動対象のモデルを指定している場合、あるいは job: を持つエントリがそれだけの場合に適用されます。キーごとに、コマンドラインの指定がブロックの設定より優先されます。ポインターが解決できない場合、そのキーは推測で補わず未設定のままになります。
このフックはフェイルオープンです。認識できないコマンド、GPU またはバッチサイズが宣言されていないジョブ(解決できない file:key ポインターを含む)、読み込めないモデル、解析できない GPU(A100 だけでは特定できません)、またはその他のエラーがある場合、呼び出しは実行されます。見積もりの対象外となるジョブも同様です。たとえば --gradient_checkpointing、LoRA または PEFT のフラグ、4 ビットまたは 8 ビットでのロード、CPU オフロードなどが該当します。見積もり値はフルファインチューニング時のピークメモリに基づくためです。この見積もりは収まるかどうかの確認であり、実測値ではありません。そのため、コマンドの前に NEURARCH_ALLOW_OOM=1 を付けると、拒否された起動も実行できます。
同じフックは、vLLM または SGLang の起動(vllm serve、python -m vllm.entrypoints...、python -m sglang.launch_server)も check_serving_config で事前チェックします。モデル自身の config.json とフラグから読み取れる問題がある場合に限り、起動をブロックします。たとえば、TP がヘッド数で割り切れない場合や、提供シーケンス長がコンテキスト長を超える場合です。NEURARCH_ALLOW_SERVE=1 を指定すると実行できます。
$ vllm serve Qwen/Qwen3-8B --tensor-parallel-size 3
neurarch: this vLLM launch has 2 blocking findings for Qwen/Qwen3-8B.
  TP 3 does not divide 32 attention heads.
Claude Code プラグイン
サーバー、上記のフック、およびスキルは、1 つの Claude Code プラグインとして一緒にインストールされます。このリポジトリがそのマーケットプレイスです。
/plugin marketplace add neurarch-ai/neurarch-mcp
/plugin install neurarch@neurarch-ai
Claude Code 2.1.275 以降では、/plugin install neurarch --marketplace neurarch-ai/neurarch-mcp を実行すると、両方が一度にインストールされます。シェルから実行する場合も、claude plugin marketplace add neurarch-ai/neurarch-mcp と claude plugin install neurarch@neurarch-ai の 2 つの手順で同じことができます。
.claude-plugin/plugin.json と hooks/hooks.json によって追加されるものは次のとおりです。
- MCP サーバー:
npx -y neurarch-mcp --hosted --hfとして実行されます。独自のモデルは持たないため、各ツールにはmodel_path(.py、.neurarch.json、zoo:<id>、hf:<org/name>のいずれか)またはhf_idが必要です。--hfを指定すると、hf:モデルが huggingface.co からconfig.jsonを読み取れるようになります。 - フック:上記で手動設定した場合とまったく同じように、Bash を呼び出すたびに
npx -y neurarch-mcp hook --hfが実行されます。トレーニングの起動時にはサイズを算定し、vLLM と SGLang の起動時には事前チェックを行います。 - スキル:
/neurarch:neurarch-skill。起動前にジョブのサイズを算定し、その後、証拠に基づく編集ループを実行します。
どちらのコマンドも、Hugging Face の ID で指定されたモデルに対してのみ huggingface.co に接続します。オフラインで利用する場合や、サーバーを 1 つのモデルに向ける場合は、プラグインをインストールする代わりに、上記のようにサーバーとフックを手動で設定してください。
クライアントの設定
グローバル設定では、必ず絶対パスを使用してください。npx はプロジェクトディレクトリから実行されないためです。プロジェクト単位の設定(.mcp.json、.cursor/mcp.json、.vscode/mcp.json)では相対パスを使用できます。
Claude Code
claude mcp add neurarch -- npx -y neurarch-mcp /abs/path/to/model.py
または、プロジェクト単位の .mcp.json をコミットすると、すべてのコラボレーターがサーバーを利用できます。
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "./model.py"] } } }
Claude Desktop
Releases から .mcpb をダウンロードして開くか、設定を編集してください(Settings → Developer → Edit Config;macOS の場合は ~/Library/Application Support/Claude/claude_desktop_config.json、Windows の場合は %APPDATA%\Claude\claude_desktop_config.json)。
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "/abs/path/to/model.py"] } } }
Claude Desktop を完全に終了して再起動してください。設定は起動時に読み込まれます。
Cursor
上の Add to Cursor をクリックするか、.cursor/mcp.json(プロジェクト単位)または ~/.cursor/mcp.json(グローバル)を作成してください。
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "./model.py"] } } }
VS Code(Copilot エージェントモード)
上の Install in VS Code をクリックするか、.vscode/mcp.json を作成してください(servers キーに注意してください)。
{ "servers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "${workspaceFolder}/model.py"] } } }
Windsurf、Codex、および Streamable HTTP に対応するクライアント
command と args の形式は同じで、ファイルの場所だけが異なります。HTTP クライアントの場合は、npx neurarch-mcp model.py --http を実行し、クライアントの接続先を次のように設定してください。
{ "mcpServers": { "neurarch": { "type": "http", "url": "http://127.0.0.1:8787/mcp" } } }
確認: エージェントに 「利用できる Neurarch ツールを一覧表示してください」 と尋ねてください。シェルから npx -y neurarch-mcp --help を実行すると、使い方とツールの一覧が表示されます。
フラグ
--write:6 つの変更ツールを公開します。デフォルトでは無効です。--watch:変更時にモデルファイルを再読み込みします。アプリと組み合わせて使用してください。--hf:hf:<org/name>形式の参照を許可し、load_hf_modelを一覧に含めます。ネットワークを有効にする唯一のフラグです。ゲート付きリポジトリではHF_TOKENが送信され、結果は~/.cache/neurarch-mcpに1日間キャッシュされます。--tools=full:すべての読み取りツールを公開します。デフォルトでは、推奨される実行順に並んだ主要な19個のツールが公開されます(size_training_job、trace_model、plan、history、diagnose_oom、check_edit、check_parallel_layout、check_serving_config、check_pins、model_changes、続いてオフラインの手順)。いずれの場合も、すべてのツールは名前を指定して呼び出せます。また、neurarch://docs/<tool>に完全な仕様があります。デフォルトの一覧では、エージェントは1ターンあたり約5.5kトークンを消費します。出力スキーマを含む全ツールの一覧では7.8kトークンです。--toolsets=sizing,serving,...:指定したグループ(sizing、parallel、serving、changes、design、models、write)のみを公開します。トレーニングジョブのサイズ見積もりだけを行うチームであれば、6つのツールを読み込みます(1ターンあたり約1.6kトークン)。writeは--writeと同じで、起動時の拒否条件も同じです。不明なグループ名を指定すると、起動時にサーバーが停止します。--toolsを上書きします。--read-only:--writeまたは--toolsets=writeを指定しても、書き込みツールを一切公開しません。lint_model、find_layers、layer_impact、describe_architecture、check_designのresponse_format: "concise" | "detailed"。デフォルトは concise で、省略した内容を示します(omitted.count、またはfind_layersの場合はfields)。qwen2.5-7b では、ルールごとに情報の検出結果を列挙せず件数を数えるため、lint_modelの出力が10.6 KBから1.4 KBに減ります。--http[=PORT]、--host=ADDR:Streamable HTTP 経由で配信します。リモートアクセスを参照してください。--version、--help。
ネットワーク:3つのツール、2つのスイッチ、それ以外はなし
| 内容 | 送信されるもの | タイミング |
|---|---|---|
plan | グラフ(ベースグラフとポリシー行も含む)を POST /api/v1/plan に送信します。share は false に固定されています。 | エージェントが plan を呼び出したときのみ。 |
history | 8文字の構造フィンガープリントと NEURARCH_API_KEY を GET /api/v1/history に送信します。グラフは決して送信しません。 | エージェントが history を呼び出し、かつキーが設定されている場合のみ。キーがなければリクエストは行いません。 |
model_changes | www.neurarch.com 上の公開静的ファイルを2つ GET します。勧告インデックスと、1つのモデルのリビジョン一覧(そのパスはモデル ID です)。キーもグラフも、リポジトリ由来の情報も送信しません。 | エージェントが model_changes を呼び出したときのみ。インデックスは1時間キャッシュされます。 |
--hf | リポジトリの config.json を huggingface.co にリクエストします。さらに check_serving_config のために tokenizer_config.json、chat_template.jinja、generation_config.json もリクエストします(設定されている場合は HF_TOKEN も送信します)。モデル自体は決して送信しません。 | load_hf_model または hf: 参照の場合のみ。各ファイルは1日キャッシュされます。 |
NEURARCH_REPORT=1 | 匿名の構造と判定のレコードを1件送信します。構造フィンガープリント、レイヤータイプのヒストグラム、エッジ数、(ルール ID、重大度)の組が含まれます。構造上、グラフを含めることはできません。 | 各 validate_model、lint_model、check_design、plan 呼び出しの後に、送信後は結果を待たず、5秒を上限として送信します。 |
どちらのスイッチもデフォルトではオフで、NEURARCH_REPORT の動作にも変更はありません。plan は、すでにレコードを送信する3つのツールに加わります。これにより、評価を行うすべてのツールで、オプトインの意味が統一されます。一方、history は評価を行わず、何も送信しません。ここに新たなデフォルト有効の動作はありません。3つのツールは呼び出されたときに接続します。そのことは、各ツールの説明と openWorldHint アノテーションに明記されています。--hf が有効な場合、どの読み取りツールにも hf: モデルを渡せるため、すべての読み取りツールにオープンワールドのアノテーションが付いています。
--hf がオフで、NEURARCH_REPORT が未設定、かつ plan と history のどちらも呼び出されていない場合、このサーバーはネットワークリクエストを一切行いません。例外となるツールもありません。パーサー、ルールエンジン、検証器、ランカー、参照ライブラリはパッケージに同梱されているため、モデルがマシンの外に出ることはありません。NEURARCH_API(neurarch-trace が使用するものと同じ変数)を設定すると、2つの台帳ツールの接続先を変更できます。コーパスポリシー:neurarch.com/rules.html#data。
リモートアクセス
デフォルトでは、サーバーは stdio で通信するため、エージェントとモデルファイルは同じマシン上にあります。--http を指定すると、同じツールを Streamable HTTP 経由で提供します。これにより、ホスト型またはスマートフォン上のエージェントから、たとえば Cloudflare や Tailscale のトンネル経由で、マシン上で動作するモデルを操作できます。
npx neurarch-mcp model.py --http                        # loopback, no auth needed
NEURARCH_MCP_TOKEN=$(openssl rand -hex 16) \
  npx neurarch-mcp model.neurarch.json --write --http --host=0.0.0.0
デフォルトでは 127.0.0.1 にバインドし、DNS リバインディング保護が有効です。NEURARCH_MCP_TOKEN を設定すると、すべてのリクエストで Authorization: Bearer <token> が必要になります。また、--write を指定してループバック以外のホストにバインドする場合は、必ず設定する必要があります。
ディスク上にモデルを置かないホスト型サーバー: npx neurarch-mcp --http --hf を実行すると、各呼び出しで指定された内容に応答するサーバーが起動します(model_path: "zoo:..." / "hf:..."、またはモデルのテキストをインラインで指定する model_source)。デプロイ手順は Dockerfile、fly.toml、docs/HOSTED.md に記載されています。ホスト型サーバーはクライアントから送信されたモデルテキストを受け取りますが、ローカルサーバーは受け取りません。URL を公開する際は、そのことを明記してください。
実際のコードから得られる実際の形状:neurarch-trace
静的解析で確認できるのはソースまでです。python/neurarch-trace はモデルをインスタンス化し、フックを使ってフォワードパスを1回実行して、関数型の残差加算や連結も含め、すべての形状が埋められた .neurarch.json を書き出します。
pip install neurarch-trace
neurarch-trace models/resnet.py:ResNet18 --input 1,3,224,224 -o resnet18.neurarch.json
neurarch-trace hf:bert-base-uncased --input 1,128 --dtype long          # needs transformers
npx -y neurarch-mcp resnet18.neurarch.json
形状はバッチ次元なしで出力されます([3,224,224] であり、[1,3,224,224] ではありません)。これは、このツール群がすべて想定している規約です。
開発
git clone https://github.com/neurarch-ai/neurarch-mcp && cd neurarch-mcp
npm install
npm run typecheck && npm run build && npm test     # vitest, 290+ tests
node dist/index.js --help
npm run build:mcpb                                 # the Claude Desktop bundle
CI では、Node 20 および 22 で型チェック、ビルド、テストを実行します。パッケージにはメインの Neurarch リポジトリからベンダー化したファイルが含まれているため、ネットワーク接続、キー、追加のインストールなしで動作します。対象は src/vendor/engine.bundle.mjs(レジストリ、PyTorch パーサー、ルールセット、コードジェネレーター、HF 設定コンバーター)と src/vendor/verifier.bundle.mjs(5 つのパイプラインステージ、プロヴェナンステーブル、ランカー)です。いずれも生成され、コントラクトテスト済みで、import が含まれていないこと(verifier については fetch も含まれていないこと)を検証しています。実行時の依存関係は、MCP SDK(HTTP アダプター用の @modelcontextprotocol/node を含む @modelcontextprotocol/server)のみです。zoo/ は awesome-llm-model-zoo から npm run sync:zoo で同期されます。
新しいツールの追加は、小規模で自己完結した PR です。CONTRIBUTING.md をご覧ください。これらのツールを使った、エビデンスを条件とする編集ループを教えるエージェントスキルは、skills/(npx skills add neurarch-ai/neurarch-mcp)にあります。
トラブルシューティング
- クライアントにサーバーが表示されません。 グローバル設定ではモデルパスを絶対パスにする必要があります。
npxはプロジェクトディレクトリから実行されません。相対パスが使えるのは、プロジェクトスコープの設定(.mcp.json、.cursor/mcp.json、.vscode/mcp.json)のみです。 - 読み取りツールは使えますが、書き込みツールがありません。
--writeを指定していません。アプリで編集中のファイルが誤って上書きされないよう、デフォルトでは無効になっています。 - 初回実行時に
npxが失敗します。 Node >= 20 が必要です(node --version)。 - 設定を編集した後、Claude Desktop に何も表示されません。 アプリを完全に終了して再度開いてください。設定が読み込まれるのは起動時のみです。
- アプリで編集した後も、エージェントに古いグラフが表示されます。
--watchを追加するか、サーバーを再起動してください。
これは何ではないか
- 汎用的なコードベースインデクサーではありません。 モデル定義(
.py、.neurarch.json、zoo:、hf:)を読み込みますが、ツリー全体は読み込みません。コードベースの構造を調べるには、GitNexus などを使ってください。 - トレーナーではありません。 実行に必要なもの、開始できるかどうか、費用、結果を提供できる場所を伝えますが、GPU 時間を消費することはありません。
- 実測ツールではありません。
size_training_jobは較正済みの推定値です(41 種類のアーキテクチャにわたる実測 178 件の実行で適合させたもので、ホールドアウト評価では中央値誤差が 7% で、カードに収まらなかった 131 件中 113 件にフラグを付けました。適合後に実測した 25 件では、中央値の誤差が 14% でした)。プロファイラーではなく、AdamW 以外のオプティマイザーを使うジョブや、bf16 自動混合精度を使わないジョブでは結果が異なります。check_designは、判断がユーザーに委ねられる箇所を示します。 - Neurarch ワークスペースには接続されていません。 ファイルを読み取ります。ライブ編集はNeurarch アプリで行い、
--watchはその保存内容を監視します。
問題とフィードバック
このリポジトリは、次の両方の公開窓口です。
- neurarch-mcp(この MCP サーバー):バグ、プロトコルの変更、統合に関する質問。
- Neurarch(アプリ):キャンバスのバグ、エージェントの問題、リンターのルール、機能リクエスト。
| 🐛 バグを報告 | 問題が発生している、または予期しない動作をしています。 |
| 💡 機能をリクエスト | Neurarch または MCP サーバーを改善するアイデアです。 |
| ❓ 質問する | 解決方法が分からない具体的な内容です。 |
| 💬 ディスカッションを始める | 自由なアイデア、設計へのフィードバック、「どうすれば…」といった話題です。 |
迅速に振り分けできるよう、Issue には mcp、app、linter、feature-request のいずれかのラベルを付けてください。
このリポジトリにスターを付ける
neurarch-mcp を使って、nn.Module をチャットに貼り付けずに済んだなら、⭐を付けることで、ほかの ML エンジニアにも見つけてもらいやすくなります。プロジェクトを支援する最も手軽な方法です。
貢献
新しいツールは、小規模で自己完結した PR です。3 ステップの「ツールを追加する」ガイドについては、CONTRIBUTING.md を参照してください。
開発
git clone https://github.com/neurarch-ai/neurarch-mcp
cd neurarch-mcp
npm install
npm run typecheck             # tsc --noEmit
npm run build                 # tsup → dist/index.js
npm test                      # vitest (≈190 unit + end-to-end tests)
node dist/index.js --help     # confirm bin works
CI では、すべてのプッシュと PR に対して、Node 20 および 22 で typecheck、build、test を実行します。
パッケージはメインの Neurarch リポジトリからベンダー化しており、すべてをベンダー化しているのも同じ理由です。このサーバーは、ネットワークも API キーも追加のインストール手順もなしで動作する必要があります。
src/lib/:モデルの型、パラメーターおよび FLOP の推定器、影響分析器などの純粋な TypeScript ユーティリティです。ソースコードとしてここで保守されています。src/vendor/engine.bundle.mjs:コンパイル済みの Neurarch エンジンです。コンポーネントレジストリ、.pyのサポートを担う PyTorch パーサー、lint_modelのルールセットが含まれます。生成物であり、手動編集はしません。ヘッダーに再生成方法が記載されており、src/vendor/engine.contract.test.tsでは、エクスポートに変更があった場合や import が追加された場合にテストが失敗します。src/vendor/verifier.bundle.mjs:check_designを担う、コンパイル済みの Neurarch 検証器です。5 つのパイプラインステージと、ルールの出典情報テーブルが含まれます。アプリおよびホストされたエンドポイントと同じコードパスを使うため、ここでのエージェントとアプリを使う人には同じ回答が返されます。ルールについても同様に生成され、コントラクトテスト(verifier.contract.test.ts)で検証され、import もfetchも含まないことが確認されます。
どちらもランタイム依存関係を追加しません。引き続き MCP SDK だけが依存関係です。
プライバシーポリシー
このサーバーはお使いのマシン上で動作し、外部への通信を行わないように構築されています。
- データ収集:デフォルトでは収集しません。モデルファイル、グラフ、ソースコードはディスクから読み込まれ、呼び出された場合に限り、唯一のツールである
planによって送信されます。 plan(リクエスト時):計画対象のグラフ(base_pathを渡した場合はベースグラフも含む)と、.neurarch.ymlのポリシー行をneurarch.comのPOST /api/v1/planに送信し、カードを生成して返します。shareは false に固定されているため、公開されることはありません。グラフはこのリクエストへの応答のために処理されます。NEURARCH_API_KEYを設定している場合は、それも送信されます。他のツールがお使いのモデルを送信することはありません。history(リクエスト時、キーが必要):グラフの8文字の構造フィンガープリントとNEURARCH_API_KEYをGET /api/v1/historyに送信します。グラフ自体は送信されず、キーが設定されていない場合はツールからのリクエストも行われません。NEURARCH_API(任意):これら2つのツールの接続先を別のホストに指定します。他の処理で読み取られることはありません。--hf(任意):モデルの公開config.jsonを huggingface.co から取得します。送信されるのは、指定したリポジトリ ID と、設定している場合はHF_TOKEN(huggingface.co に限ります)です。応答は~/.cache/neurarch-mcpにローカル保存され、いつでも削除できます。NEURARCH_REPORT=1(任意、デフォルトでは無効):採点対象のグラフごとに1行の匿名構造データを Neurarch コーパスに送信します(validate_model、lint_model、check_design、plan)。送信内容は、構造フィンガープリント(8文字のハッシュ)、レイヤータイプのヒストグラム、エッジ数、(ルール ID、重大度)のペアです。ペイロード形式上、グラフ、パラメーター値、レイヤー名、ファイルパス、個人を特定できる情報は含まれません。ポリシーと例:neurarch.com/rules.html#data。- ホスト型インスタンス(
neurarch-mcp.fly.dev)は、その性質上、クライアントが送信するモデルテキストまたは参照情報をメモリ上で処理し、リクエストに応答します。サーバー側に保存されるのは1日間のhf:設定キャッシュのみで、アカウントはなく、グラフ内容のリクエストログもありません。NEURARCH_REPORT=1を有効にして動作するため、採点対象のリクエストごとに上記の匿名構造データも送信されます。これを望まない場合は、ローカルサーバーをご利用ください。 - 保持期間:ローカルサーバーはローカルキャッシュ以外の情報を保存しません。コーパスのデータ行(オプトイン)は、匿名の集計データとして無期限に保持されます。
- 第三者:データは誰とも共有されません。接続する可能性がある唯一のサードパーティーのエンドポイントは huggingface.co で、
--hfを指定した場合に限ります。neurarch.comに接続するのは、plan、history、およびオプトインのコーパスレポートのみです。 - お問い合わせ:[email protected]、またはイシューを作成してください。
アプリ全体のポリシーであるneurarch.com/privacyは Neurarch ウェブアプリを対象としています。このセクションは、このサーバーを対象としています。
ライセンス
MIT。LICENSEをご覧ください。
リンク
- Neurarch:このサーバーが読み込むモデルファイルを生成する、ビジュアルなニューラルネットワークエディターです。
- Model Context Protocol:このサーバーが実装する仕様です。
- npm:パッケージページです。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。