ContextSmith について
ContextSmithは、コーディングエージェントを使う開発者向けのローカルコードコンテキストエンジンです。コード索引とハイブリッド検索を組み合わせ、指定したトークン予算内でタスクに関係するコードを返します。
主な機能
- 01ローカルリポジトリの索引作成
- 02語彙検索とセマンティック検索
- 03コードグラフとGit履歴
- 04トークン予算に合わせたコンテキスト構成
- 05シンボルの影響範囲と関係の検索
- 06コードメモの保存
活用シーン
- 01コーディングエージェントへのコードコンテキスト提供
- 02不慣れなリポジトリでの関連関数の特定
- 03シンボル変更前の呼び出し元の確認
- 04セッションをまたいだコード上の決定事項の保持
MCP 対応
MCPサーバーとして動作し、`get_context`、`search`、`find_symbol`、`impact`などのツールをMCPクライアントに提供します。回答前に索引を更新します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
10掲載時のツール一覧 · 4 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| task | string | はい | |
| budget_tokens | integer | いいえ |
詳細
ContextSmith
コーディングエージェントに、コードを増やすのではなく、適切なコードを与えましょう。
Claude Code、Cursor、Codex、そしてあらゆる MCP エージェントのためのローカルコンテキストエンジンです。リポジトリをコードグラフ、ハイブリッド検索、Git 履歴にインデックス化し、選択したトークン予算内に収まる、タスクに必要なコードを回答として提供します。



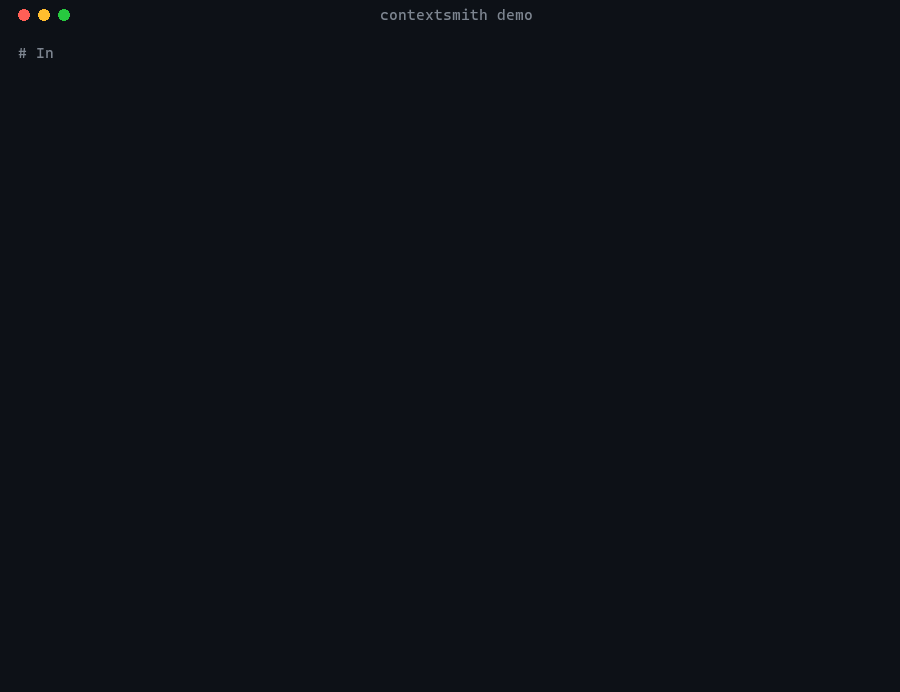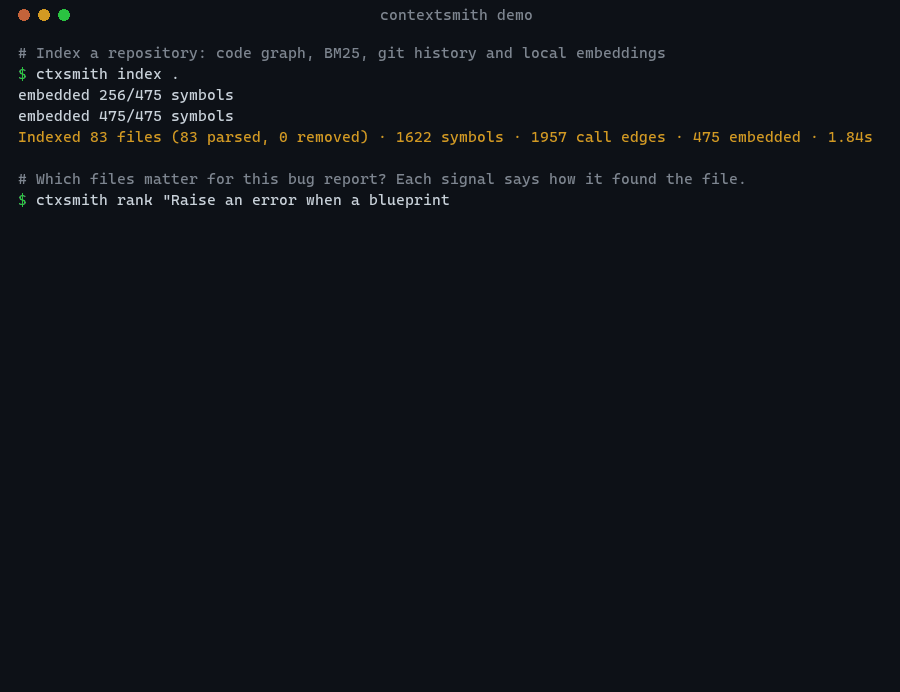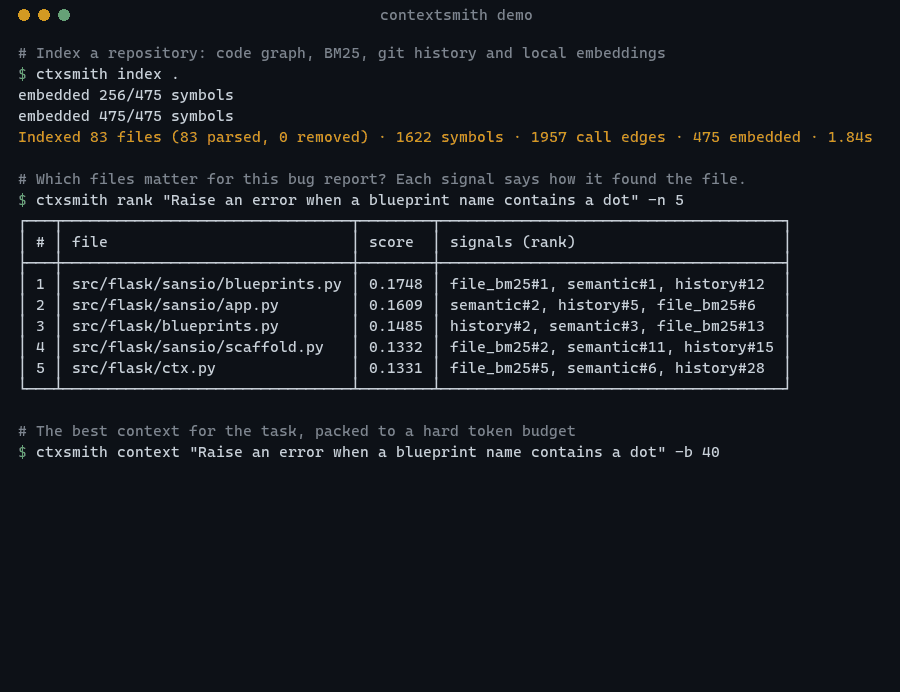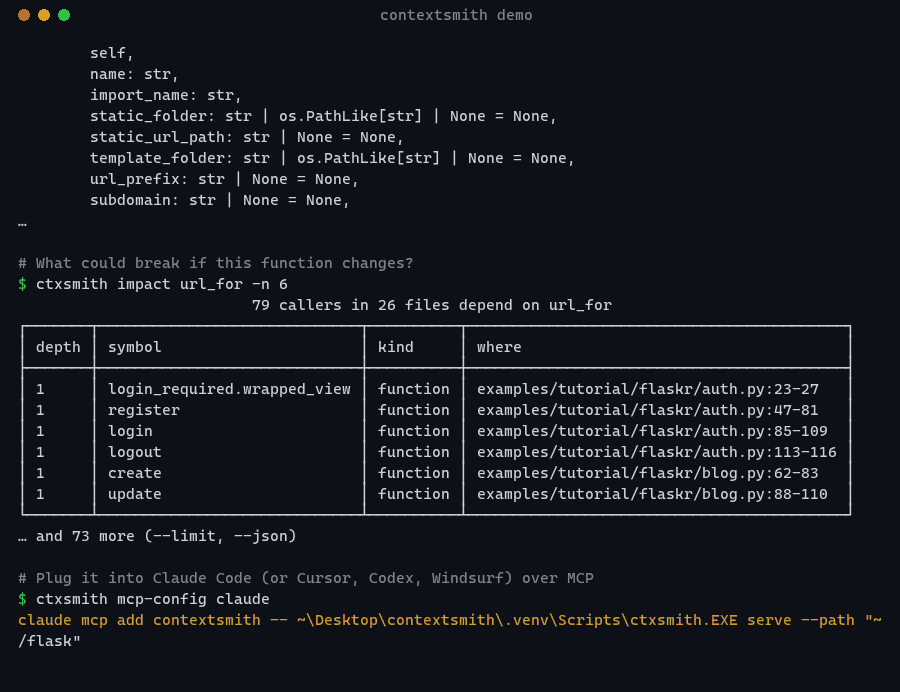
▶ 60 秒の動画を見る:インデックス化、コンテキストのパッキング、ライブ MCP 呼び出し、ベンチマークをご覧いただけます。
コーディングエージェントは、コンテキストウィンドウを誤ったコードに使ってしまいます。grep で検索し、ファイル全体を開き、修正が必要な関数にたどり着く前に容量が尽きてしまいます。しかも、読み込んだトークンごとに料金が発生します。ContextSmith ができるだけ的確に答えるのは、次の問いです。このタスクに対して N トークンを使うなら、エージェントはどのコードを読むべきか?
| 92% 実際のバグ修正のうち、4,000 トークンのコンテキストに正しいファイルが含まれていた割合 検索+ファイル全体の場合は 29% | 1.7x 変更すべき正確な行が表示される頻度がより高い 同じ予算で 48% 対 29% | 100% ローカル API キー不要、クラウド不使用、 コードがマシンの外に出ることはありません |
SWE-bench Lite の Django の課題 114 件を対象に測定しました。調整の工程で使用したことのない課題です。手法と全結果をご覧ください。
クイックスタート(60 秒)
pipx install "contextsmith[semantic]"      # or: pip install "contextsmith[semantic]"
cd your-repo
ctxsmith index                              # once; afterwards only changed files are re-read
ctxsmith context "Coupons are applied twice at checkout" --budget 4000
エージェントに接続します(コマンドを実行すると、お使いのマシンに合った正確な設定行が表示されます)。
ctxsmith mcp-config claude    # or: cursor, windsurf, codex
claude mcp add contextsmith -- ctxsmith serve --path /path/to/your-repo
以降、エージェントは自分で get_context を呼び出し、grep の代わりに、順位付けされ予算内に収められたコードを取得します。[semantic] エクストラがなくても、キーワード検索のみで機能します。
対象ユーザー
開発者
- 大規模なリポジトリでも、エージェントとの作業をより速く、より効果的に進められます。 エージェントはコードを探し回るのではなく、適切な関数から作業を始めるため、誤った編集や「見つけられませんでした」というやり取りが減ります。
- 不慣れなコードを理解できます。
ctxsmith context "where are payment retries handled?"を実行すると、関連する関数とファイル名、行番号が表示されます。 - 安全に変更できます。
ctxsmith impact charge_cardを実行すると、その関数を直接または間接的に呼び出すすべての箇所が一覧表示され、変更前に、変更によって影響を受ける可能性のある範囲を確認できます。 - 注意点を記録できます。
ctxsmith note add "never call without the account lock" --symbol charge_cardを実行すると、コードにメモを紐付けられます。このメモは、そのコードに関する今後のすべてのコンテキストに表示され、自分にもエージェントにも役立ちます。
チームと企業
| ニーズ | ContextSmith による対応 |
|---|---|
| 社外に持ち出してはならないコード(金融、医療、政府、企業の知的財産) | 開発者のマシン上ですべて実行されます。解析、検索、埋め込みはローカルで行われ、ネットワークを使用するのは、2 つの小さなオープンモデルを一度ダウンロードするときだけです。エアギャップ環境のマシン向けに、社内ミラーを作成することもできます |
| 予測可能な AI 支出 | すべての回答には、設定した固定のトークン予算があります。そのため、タスクごとのコンテキストコストは「エージェントが開いたもの次第」ではなく、一定です |
| すでに利用中のエージェントで動作 | 標準の MCP サーバーです。Claude Code、Cursor、Windsurf、Codex、Copilot エージェント、社内エージェントが同じインデックスを使用できます |
| オンボーディング | 新しいエンジニアとそのエージェントは、自然な言葉で質問し、適切なコードを見つけられます |
| コードレビューと CI | ctxsmith context "$PR_TITLE" -b 6000 を使うと、レビュー用ボットに PR が変更するコードと依存するコードを渡せます。ctxsmith impact NAME では影響範囲を確認できます |
| チームの知識 | 決定事項や不変条件を、誰かの頭の中ではなく、メモとしてコードの近くに保存できます |
| ベンダーロックインなし、調達不要 | MIT ライセンス(商用利用も可能)、リポジトリごとに単一の SQLite ファイル、実行するサーバーもアカウントも不要です |
一般的な導入手順:各開発者が pipx でインストールし、作業するリポジトリで
ctxsmith index を実行して、エージェントに MCP の設定を 1 行追加します。ホストするものはありません。
CI とオフライン環境の設定については、企業での利用をご覧ください。
AI ツールの開発者
ContextSmith は Python ライブラリとしても利用できます。独自のエージェント、 レビュー用ボット、社内アシスタントの検索レイヤーとして使用できます:
from contextsmith import Engine

eng = Engine("path/to/repo")
eng.index()
pack = eng.context("Fix the race when two users book the last seat", budget=6000)
prompt = f"{pack.text}\n\nTask: fix the race when two users book the last seat."
結果
テストでは、SWE-bench Lite の実際の GitHub issue を使い、その issue が作成されたコミットの状態でリポジトリをチェックアウトします(後のコードや履歴が漏れ込まないようにするためです)。issue の本文をツールに渡し、実際の修正で変更されたコードが返ってくるかを確認します。
Django での最終テスト:調整の各段階で一度も使われていない 114 件の issue。
| BM25、ファイル全体 | ContextSmith | |
|---|---|---|
| 修正対象のファイルが 1 位/上位 3 位/上位 5 位にランクイン | 50.9% / 70.2% / 77.2% | 51.8% / 79.8% / 85.1% |
| 修正対象のファイルが 4,000 トークンのコンテキスト内に含まれる | 28.9% | 92.1%(3.2 倍) |
| 修正で変更された正確な行が 4,000 トークン内に表示される | 28.9% | 48.1%(1.7 倍) |
| 検索時間(中央値、ノート PC の CPU、2,800 ファイルのリポジトリ) | 145 ms | 238 ms |
ベースラインでは、BM25 の順位に従って、予算が尽きるまでファイル全体を貼り付けます。これは「リポジトリを検索してファイルを開く」エージェントが行う方法です。ContextSmith は同じトークン数を、重要な関数と残りのファイルの概要に割り当てるため、適切なファイルがほぼ確実に含まれます。
すべての戦略とアブレーション
| 戦略 | R@1 | R@3 | R@5 | R@10 | 4k 内のファイル | 8k 内のファイル | 4k 内の行 | 8k 内の行 | ms |
|---|---|---|---|---|---|---|---|---|---|
| BM25、ファイル全体 | 50.9 | 70.2 | 77.2 | 84.2 | 28.9 | 49.1 | 28.9 | 49.1 | 145 |
| 字句(埋め込みなし) | 48.2 | 74.6 | 78.9 | 86.0 | 86.0 | 89.5 | 42.3 | 46.2 | 145 |
| 埋め込みのみ | 48.2 | 69.3 | 78.9 | 86.8 | – | – | – | – | 249 |
| ContextSmith(デフォルト) | 51.8 | 79.8 | 85.1 | 88.6 | 92.1 | 96.5 | 48.1 | 50.7 | 238 |
| + クロスエンコーダーによる再ランク付け | 34.2 | 73.7 | 81.6 | 91.2 | – | – | – | – | 1824 |
| git 履歴なし | 56.1 | 78.9 | 84.2 | 90.4 | – | – | – | – | 249 |
うまくいかなかったものも含め、アブレーションから分かること:
- 埋め込みには効果があります: 字句ランカーに埋め込みを追加すると、上位 5 位以内に入る割合は 79% から 85% に、正確な行のカバー率は 42% から 48% に上昇します。
- クロスエンコーダーによる再ランク付けは最上位の結果を悪化させます(52% → 34%)し、レイテンシーも 8 倍になるため、デフォルトでは無効にしており、実験的な機能として扱っています。一般的なウェブ検索向けの再ランカーは、issue とコードの関連性を理解できません。コードで学習させたものはロードマップに含まれています。
- Git コミット履歴の効果は一様ではありません: 調整に使ったリポジトリでは効果がありましたが、Django では履歴を削除すると recall@1 が 4 ポイント上昇します。デフォルト設定は Django の実行前に固定されていたため、テストセットを使った調整にならないよう、そのまま有効にしています。
- 8,000 トークンの場合、ファイル全体を使う方法でも正確な行の検出率はほぼ同等になります(49% 対 51%)。今回の Django の修正はすべて 1 ファイルを変更しており、この予算ならファイル全体が収まることも多いためです。
手法。 重みは、他の 8 つのリポジトリ(pytest、requests、flask、sphinx、pylint、xarray、astropy、seaborn)の 89 件の issue を使い、bench/tune.py と
bench/tune_pack.py によるグリッドサーチで決定し、Django を一度実行する前に固定しました。ctxsmith bench --repos django/django で再現できます(初回の実行には、ノート PC で約 2 時間かかります)。
仕組み
flowchart LR
    subgraph Index["ctxsmith index (incremental)"]
        TS["tree-sitter<br/>7 languages"] --> SYM["symbols · calls · imports"]
        SYM --> G["call graph<br/>PageRank"]
        SYM --> FTS["FTS5 BM25<br/>files · symbols · bodies"]
        SYM --> EMB["ONNX embeddings<br/>symbol summaries"]
        EMB --> VEC["sqlite-vec<br/>cosine index"]
        GIT["git log"] --> H["commit-message index<br/>co-change pairs"]
    end
    subgraph Query["get_context(task, budget)"]
        Q["task text"] --> S1["file BM25"] & S2["semantic kNN"] & S3["paths in task"] & S4["history BM25"]
        S1 & S2 & S3 & S4 --> RRF["reciprocal-rank<br/>fusion"]
        RRF --> KS["knapsack packer<br/>value per token"]
        KS --> OUT["≤ N tokens of code"]
    end
    Index -. one SQLite file .-> Query
リポジトリごとに1つのSQLiteファイルに、ファイル、シンボル、呼び出しとインポートのエッジ、3つのFTS5インデックス、Gitの統計情報、チームのメモ、ベクトルインデックス(sqlite-vecのvec0仮想テーブル。SQLiteで拡張機能を読み込めない環境ではnumpyのフォールバックが動作します)をすべて格納します。
検索(RAG)。 各シグナルがそれぞれファイルのランキングを作成し、逆順位融合で統合するため、ノイズの多い単一のシグナルに結果が左右されません。
| シグナル | 検出できるもの |
|---|---|
ファイル全体に対するBM25(camelCase/snake_caseを分割し、パスの重みを高く設定) | 正確な語彙 |
シンボルの要約に対するセマンティックkNN(BAAI/bge-small-en-v1.5、ONNX、CPU) | 異なる言葉で表現された同じ概念 |
タスク内で指定されたパス(トレースバック、「foo/bar.py内」など) | 明示的な参照 |
| 各ファイルのコミットメッセージに対するBM25 | 「以前、同様のバグ対応で変更されたファイル」 |
| 変更の共起、コールグラフの近傍、PageRank、名前の完全一致 | 重みとして利用可能。ベンチマークでファイルのランキングに悪影響があることが示されたため、デフォルトでは無効 |
重みは8つのリポジトリにまたがるSWE-bench Liteの89件の課題を使ったグリッドサーチ(bench/tune.py)で決定し、チューニングには使っていないDjangoで検証しました。
埋め込みの対象とその理由。 ファイル全体でも生のチャンクでもなく、関数またはクラスごとに短い要約を1つ作成します。要約にはパス、完全修飾名、シグネチャ、最初のdocstringの文が含まれます。ノートPCのCPUでは本文を埋め込む場合に比べて約30倍低コストで、「どの関数についての話か」を特定できます。ベクトルはコンテンツハッシュでキャッシュされるため、変更されていない関数は、再インデックス時やGitのチェックアウトをまたいでも再度埋め込まれません。テストファイルは対象外です。
実験的な再ランキング。 ctxsmith context --rerankは、クロスエンコーダー(ms-marco-MiniLM-L-6-v2)を使って上位20件のファイルを再評価します。ベンチマークでは悪影響が示されているため、デフォルトでは無効です(「結果」を参照)。
パッキング。 候補は関数本体(名前、docstring、本文で照合)、クラスの概要、ファイルの概要です。貪欲法によるナップサックアルゴリズムでトークンあたりの価値が最も高い候補を選び、同じファイルからの重複を割り引き、最終的にレンダリングされたテキストに対して予算を適用するため、回答が予算を超えることはありません。
常に最新の状態。 再インデックス時は何かを読み込む前にファイルサイズとmtimeを比較し、変更されたファイルだけを再解析・再埋め込みします。変更のない2,800ファイルのリポジトリなら、確認にかかる時間は約0.5秒です。MCP サーバーは回答前に(最短2秒間隔で)この処理を行うため、エージェントが古いインデックスから、編集したばかりのコードを読み取ることはありません。
エージェントから使用する(MCP)
ctxsmith mcp-config <client>を実行すると、使用環境に合った設定スニペットが表示されます。
Claude Code
claude mcp add contextsmith -- ctxsmith serve --path /path/to/repo
uvを使ってインストールせずに使用(サーバーはエージェントが開いたフォルダーをインデックスします):
claude mcp add contextsmith -- uvx --from "contextsmith[semantic]" contextsmith
Cursor、Windsurf、その他のクライアント(mcp.json):
{
  "mcpServers": {
    "contextsmith": { "command": "ctxsmith", "args": ["serve", "--path", "/path/to/repo"] }
  }
}
Codex(~/.codex/config.toml):
[mcp_servers.contextsmith]
command = "ctxsmith"
args = ["serve", "--path", "/path/to/repo"]
| ツール | 戻り値 |
|---|---|
get_context(task, budget_tokens) | タスクに最適なコードを、トークン予算に合わせてパッキング |
search(query) | 関数とクラスをランキング順に表示 |
find_symbol(name) | 定義されている場所 |
callers(name) / callees(name) | コールグラフ上の1ホップ先 |
impact(name) | 直接・間接に呼び出しているすべてのコード。変更によって影響を受ける可能性のある箇所 |
related_files(path) | コードで関連するファイルと、Gitで同時に変更されるファイル |
add_note(text, path, symbol) | 後続のセッションに伝えるべき決定事項や注意点 |
overview() | 言語、規模、中心的なファイル、変更頻度の高いファイル |
reindex() | 増分インデックスを強制的に再作成 |
CLI
| コマンド | 内容 |
|---|---|
ctxsmith index [PATH] [--no-semantic] | インデックスを作成します。差分更新に対応し、追加機能がインストールされている場合は埋め込みを有効にします |
ctxsmith context "task" -b 4000 | トークン予算内で最適なコンテキストを取得します |
ctxsmith rank "task" | 各ファイルを見つけたシグナルとともに、ファイルを順位付けして表示します |
ctxsmith search "query" | 関数とクラスを順位付けして表示します |
ctxsmith symbol / callers / callees NAME | 呼び出しグラフをたどります(スクリプトでは --json を使用します) |
ctxsmith impact NAME | NAME を変更した場合に、何が壊れる可能性があるかを表示します |
ctxsmith related FILE | コードで関連付けられているファイルと、一緒に変更されるファイルを表示します |
ctxsmith note add "text" --file F | 決定事項や注意点を記録します |
ctxsmith overview | 言語、規模、中心的なファイルと変更頻度の高いファイル、セマンティック機能の状態を表示します |
ctxsmith serve | stdio 経由で MCP サーバーを起動します |
ctxsmith mcp-config [claude|cursor|codex] | エージェント用の設定スニペットを表示します |
ctxsmith bench --repos django/django | SWE-bench Lite ベンチマークを自分で実行します |
Python API
from contextsmith import Engine

eng = Engine("path/to/repo")       # index stored in path/to/repo/.contextsmith/
eng.index()                        # incremental; returns counts and timings
pack = eng.context("Fix the race when two users book the last seat", budget=6000)
pack.text, pack.tokens, pack.files, pack.spans   # markdown, size, files, line ranges shown

eng.rank("seat double-booked").files  # ranked files, with the signals that found each
eng.search("seat reservation")     # ranked functions and classes
eng.impact("reserve_seat")         # transitive callers
eng.related_files("booking/models.py")
eng.add_note("Seats are locked per show, not per seat", path="booking/models.py")
設定
| 変数 | デフォルト |
|---|---|
CTXSMITH_EMBED_MODEL | BAAI/bge-small-en-v1.5(任意の fastembed テキストモデル。例:jinaai/jina-embeddings-v2-base-code) |
CTXSMITH_RERANK_MODEL | Xenova/ms-marco-MiniLM-L-6-v2 |
FASTEMBED_CACHE_PATH | ~/.cache/contextsmith/models |
インデックスは <repo>/.contextsmith/ に保存されます(自動的に git で無視されます)。semantic 追加機能がなくても、語彙ベースの機能はすべて動作します。
会社での利用
開発者ごとに導入する場合(通常の導入方法)。 pipx install "contextsmith[semantic]" を実行し、各リポジトリで ctxsmith index を実行して、各エージェントに ctxsmith mcp-config の設定行を 1 つ追加します。ホストするものも、アカウントも、セキュリティ対策が必要な共有サービスもありません。
CI でレビュー用ボットに、プルリクエストの対象コードを渡す場合。
# .github/workflows/pr-context.yml
name: PR context
on: pull_request
jobs:
  context:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }            # full history powers the git signals
      - uses: actions/setup-python@v5
        with: { python-version: "3.12" }
      - uses: actions/cache@v4               # reuse the index and the model between runs
        with:
          path: |
            .contextsmith
            ~/.cache/contextsmith/models
          key: contextsmith-${{ github.base_ref }}
      - run: pip install "contextsmith[semantic]" && ctxsmith index
      - run: ctxsmith context "$TITLE" --budget 6000 > pr-context.md
        env:
          TITLE: ${{ github.event.pull_request.title }}   # via env, never inline: no injection
      - uses: actions/upload-artifact@v4
        with: { name: pr-context, path: pr-context.md }
pr-context.md を使用するレビュー用モデルに渡すか、ctxsmith impact <function> の出力をコメントとして投稿すると、レビュー担当者が変更の影響範囲を確認できます。
オフライン環境やエアギャップ環境のマシン。
# on a machine with internet access (same OS and Python version as the target)
pip download "contextsmith[semantic]" -d wheels
ctxsmith index                     # downloads the embedding model (65 MB) once
# copy wheels/ and ~/.cache/contextsmith/models/ across, then on the offline machine:
pip install --no-index --find-links wheels "contextsmith[semantic]"
export HF_HUB_OFFLINE=1            # never try the network again
保存されるデータとその保存先。 リポジトリごとに 1 つの SQLite ファイルが <repo>/.contextsmith/ に保存されます。内容は、シンボル、検索インデックス、呼び出しグラフ、Git 統計とコミットメッセージ、メモ、埋め込みベクトルです。これは自動的に git で無視され、どこにもアップロードされません。ContextSmith はテレメトリを使用しません。ダウンロードされるのは、初回使用時の Hugging Face からのオープンな埋め込みモデル(semantic 追加機能がなければダウンロードされません)と、ctxsmith bench を実行した場合の公開ベンチマークのみです。
FAQ
コードが自分のマシンから外部に送信されますか? いいえ。解析、検索、埋め込み、MCP サーバーはすべてローカルで実行されます。エージェントは、読み込んだ他のファイルと同様に、受け取ったコンテキストをエージェント独自のモデルプロバイダーに送信します。ContextSmith は、そのコンテキストをより小さく、より関連性の高いものにするだけです。
どのくらい大きなリポジトリを扱えますか? ノート PC の CPU で Django(2,800 ファイル、38,000 個の関数とクラス)を測定したところ、コードグラフ、検索、Git インデックスを一から構築するのに 16 秒、初回にすべてを埋め込むのに約 3.5 分、クエリごとに 0.2 秒、変更の確認に 0.5 秒かかり、ディスク容量は 136 MB でした。初回実行後は、変更されたファイルだけを再解析し、再度埋め込みます。
エージェント独自の検索機能を置き換えますか? いいえ。より良い出発点を提供します。エージェントは引き続き任意のファイルを開けますが、grep から始めるのではなく、適切な関数から作業を始められます。
どのモデルを使用しますか? 埋め込みには BAAI/bge-small-en-v1.5(ONNX、CPU、65 MB)を使用します。CTXSMITH_EMBED_MODEL で変更できます。大規模言語モデルは使用しません。ContextSmith は情報を取得し、エージェントが推論します。
費用はいくらですか? 無料です。MIT ライセンスのため、商用利用も可能です。
本番環境で使用できる状態ですか? v0.1 です。Python 3.11~3.13 を使用して Windows、macOS、Linux でテストし、公開ベンチマークを実施しています。また、現時点で動作しない点についても明記しています(「結果」を参照)。Issue やプルリクエストを歓迎します。
対応言語
Python、JavaScript、TypeScript/TSX、Java、Go、Rustに対応し、tree-sitter で解析します。
比較
Graphify、codebase-memory-mcp、GitNexus、Serena、Claude Context は優れたツールです。ContextSmith との違いは次のとおりです。
| ContextSmith | |
|---|---|
| 「このタスクに最適なコンテキストを N トークン以内で」回答 | ✅ 予算に合わせてパックし、予算を超過しません |
| ベースラインとアブレーションを含む、公開済みの再現可能なベンチマーク | ✅ ctxsmith bench、評価対象外のリポジトリ |
| 語彙情報、セマンティック情報、Git 履歴を統合 | ✅ |
| 完全にローカルで動作し、API キー不要、SQLite ファイル 1 つのみ | ✅ |
| コードに固定され、コンテキストに表示されるチームノート | ✅ |
| 商用利用に適したライセンス | ✅ MIT |
ロードマップ
複数リポジトリのインデックス、ノートの古さの追跡、ファイルウォッチャー、グラフ表示、PR 影響レポート、対応言語の追加などを予定しています。アイデアやベンチマークに裏付けられたプルリクエストを歓迎します。CONTRIBUTING.md をご覧ください。
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。