
agent-eval について
agent-eval は、統計的な回帰テストで LLM エージェントのバージョンを比較する CLI、Python API、MCP サーバーです。有意性、効果量、信頼区間を示し、実際の挙動変化と実行ごとのばらつきを区別できます。
主な機能
- 01バージョン間のスコア分布比較
- 02Mann-Whitney U の p 値を報告
- 03Cohen's d の効果量を計算
- 04ブートストラップ信頼区間を生成
- 05CI で回帰をブロック
活用シーン
- 01プロンプト変更による挙動の変化を確認
- 02有意な回帰があればデプロイを阻止
- 03既存のスコアファイルでバージョンを比較
MCP 対応
stdio の MCP サーバーは `run` ツールを公開し、`agent-regress` CLI を実行して解析済み JSON 結果を返します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
エージェント評価




LLM エージェント向けの統計的回帰テストです。バージョン A とバージョン B をそれぞれ 50 回実行し、動作に実際の変化があったかどうかを示す p 値、効果量、95%信頼区間を取得できます。
pip install agent-regress-cli
(uv add と npm/npx ラッパーについては、以下のインストールで説明します。)
すべての評価フレームワークが見落とすテスト
プロンプトを変更しました。評価は引き続き合格しています。 しかし、エージェントのツール精度は 84%から 70%に低下しました。
これは本当の回帰でしょうか。それとも、LLM の実行ごとのばらつきでしょうか。
しきい値テストでは、この問いに答えられません。 agent-eval なら答えられます。
バージョン A でエージェントを 50 回、バージョン B でも 50 回実行します。 動作に実際の変化があったかどうかを示す p 値、効果量、95%信頼区間を取得できます。
p=0.003, Cohen's d=-0.61 -> REGRESSED (deploy blocked)
p=0.410, Cohen's d=0.021 -> STABLE (safe to ship)
メモ
広く利用されているオープンソースの LLM 評価フレームワークの 1 つである Promptfoo は、2026 年 3 月に OpenAI に買収されました。オープンソースを維持しつつ、チームは OpenAI の Frontier プラットフォームに加わりました。agent-eval は Apache 2.0 ライセンスで、セルフホスト可能であり、商用サービスに依存しません。統計コア(Mann-Whitney U、ブートストラップ CI、Cohen's d)が有料化されることはありません。
インストール
pip install agent-regress-cli
# or
uv add agent-regress-cli
# or, from Node/npx (thin wrapper around the same Python CLI)
npx agent-regress-cli
クイックスタート
30 秒で使い始める(CLI)
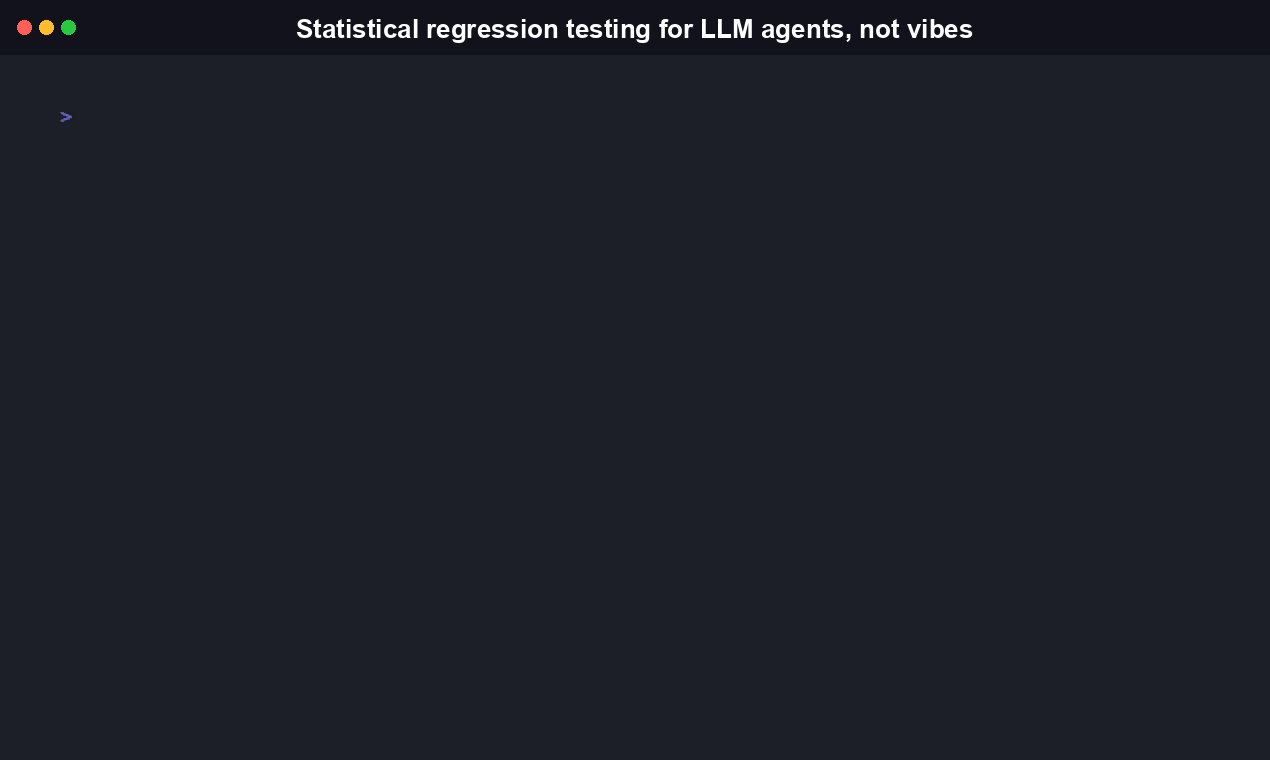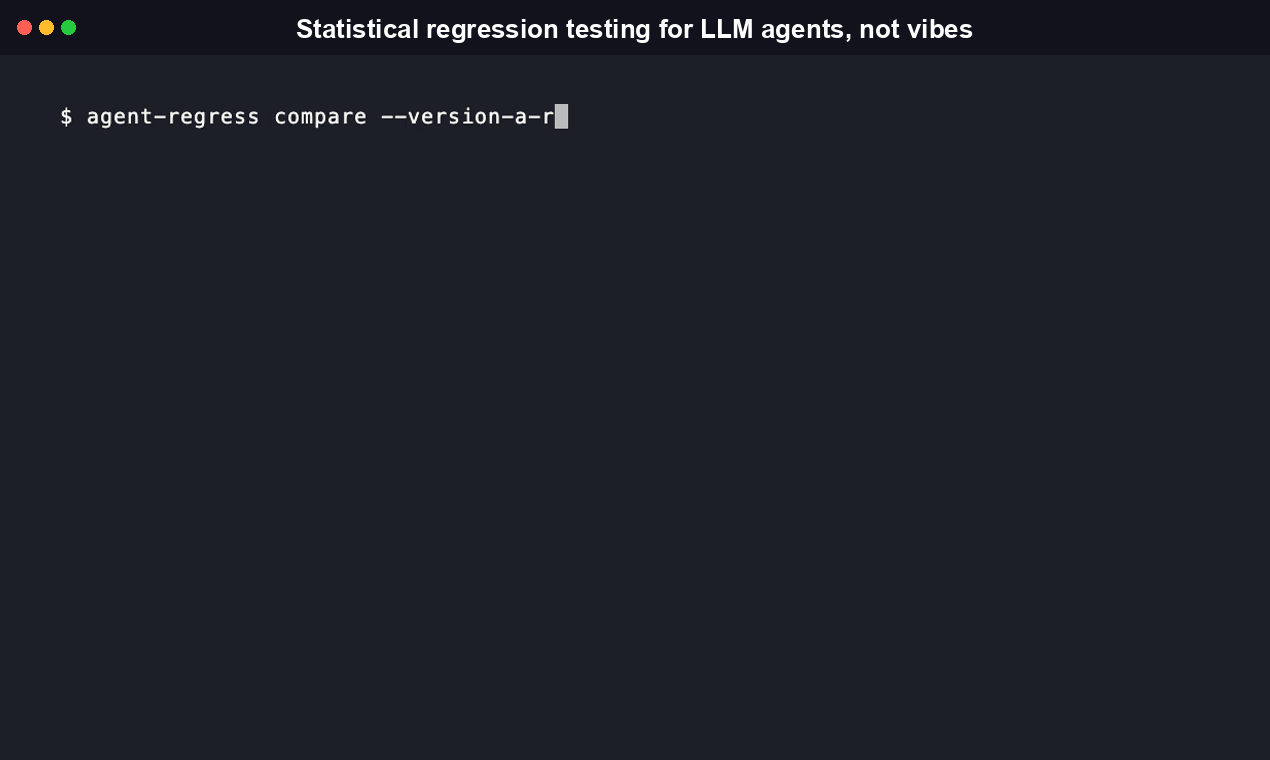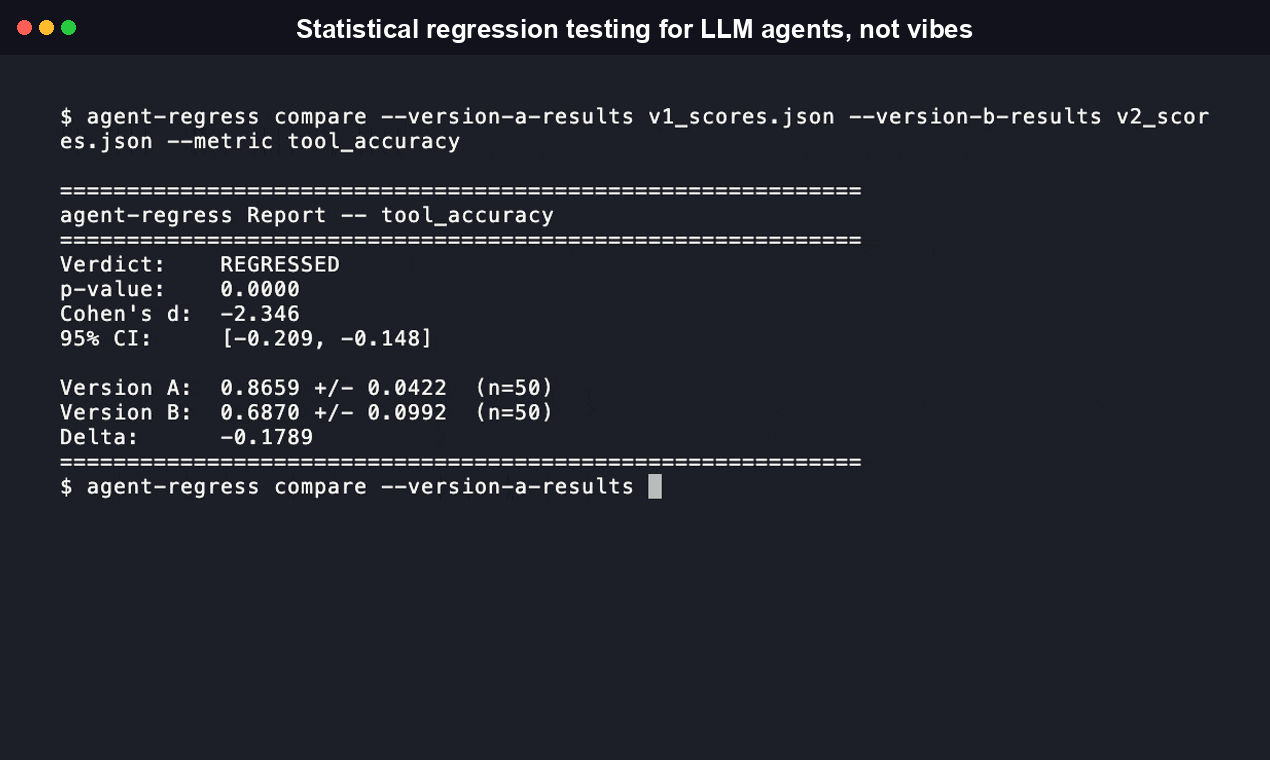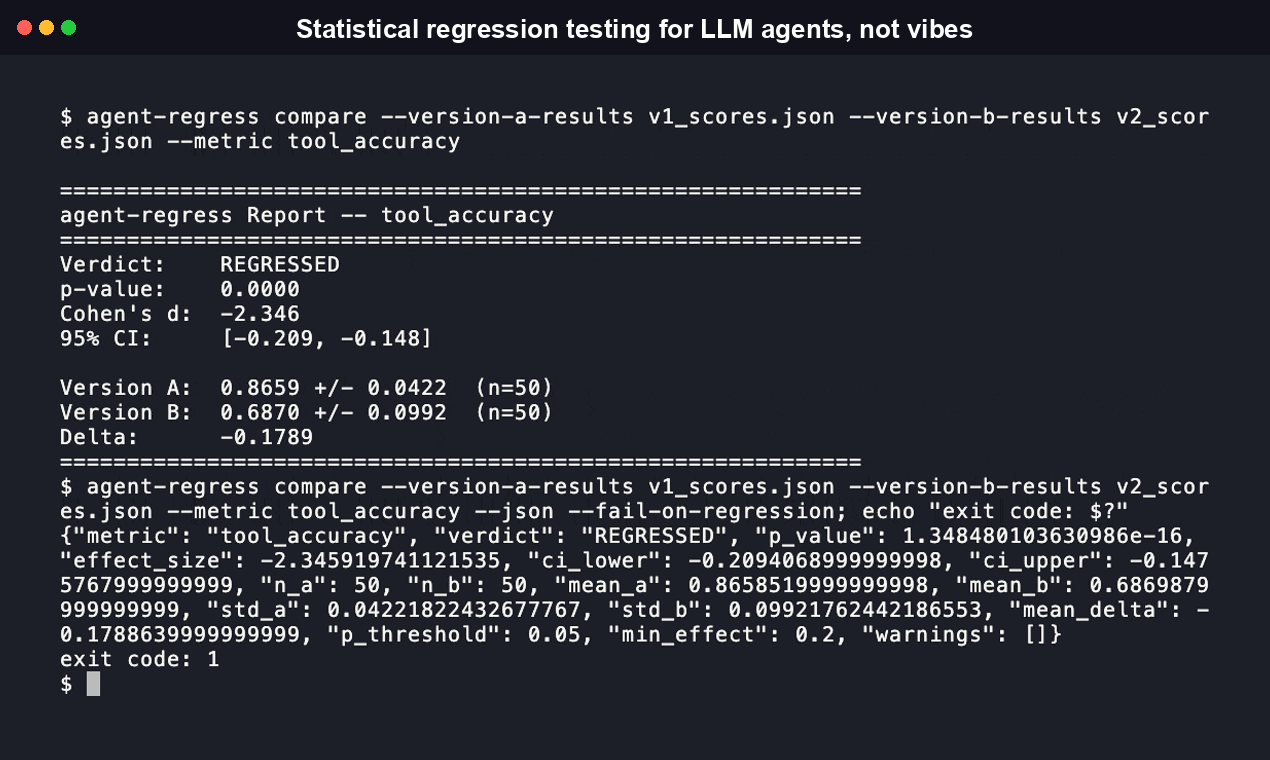
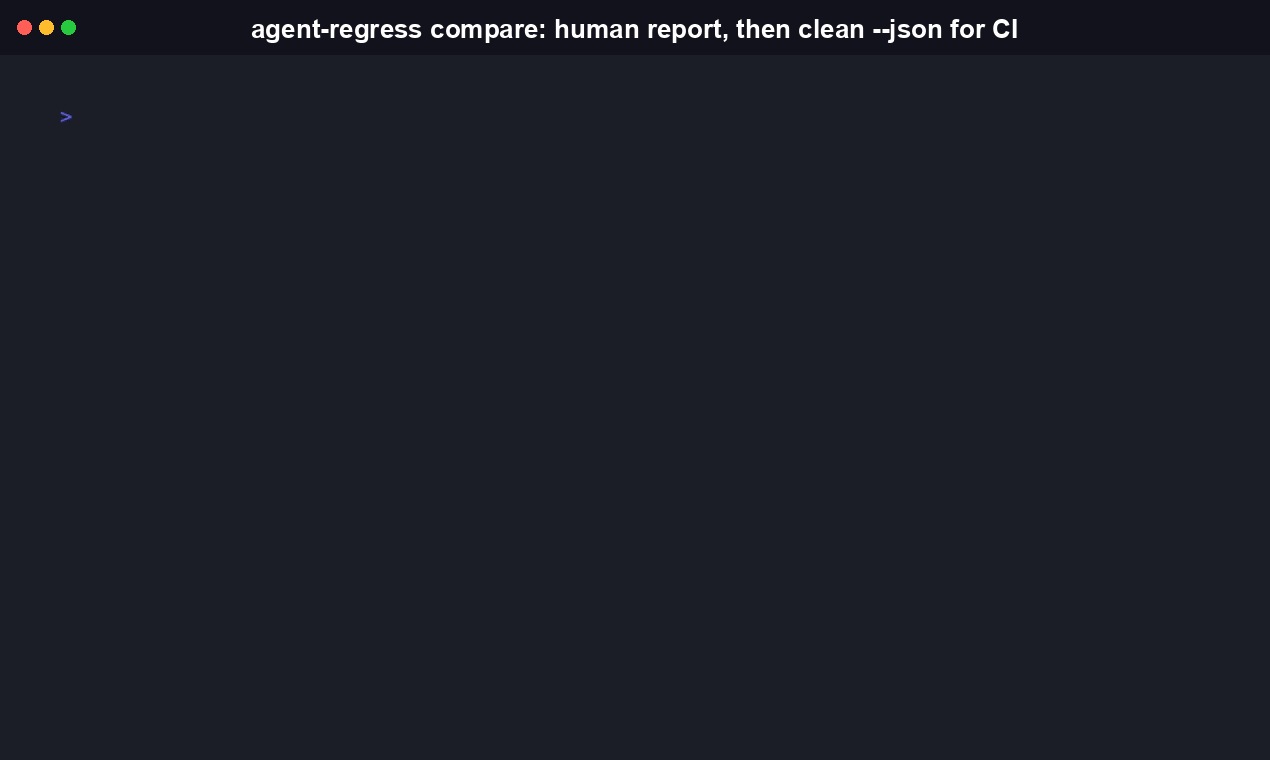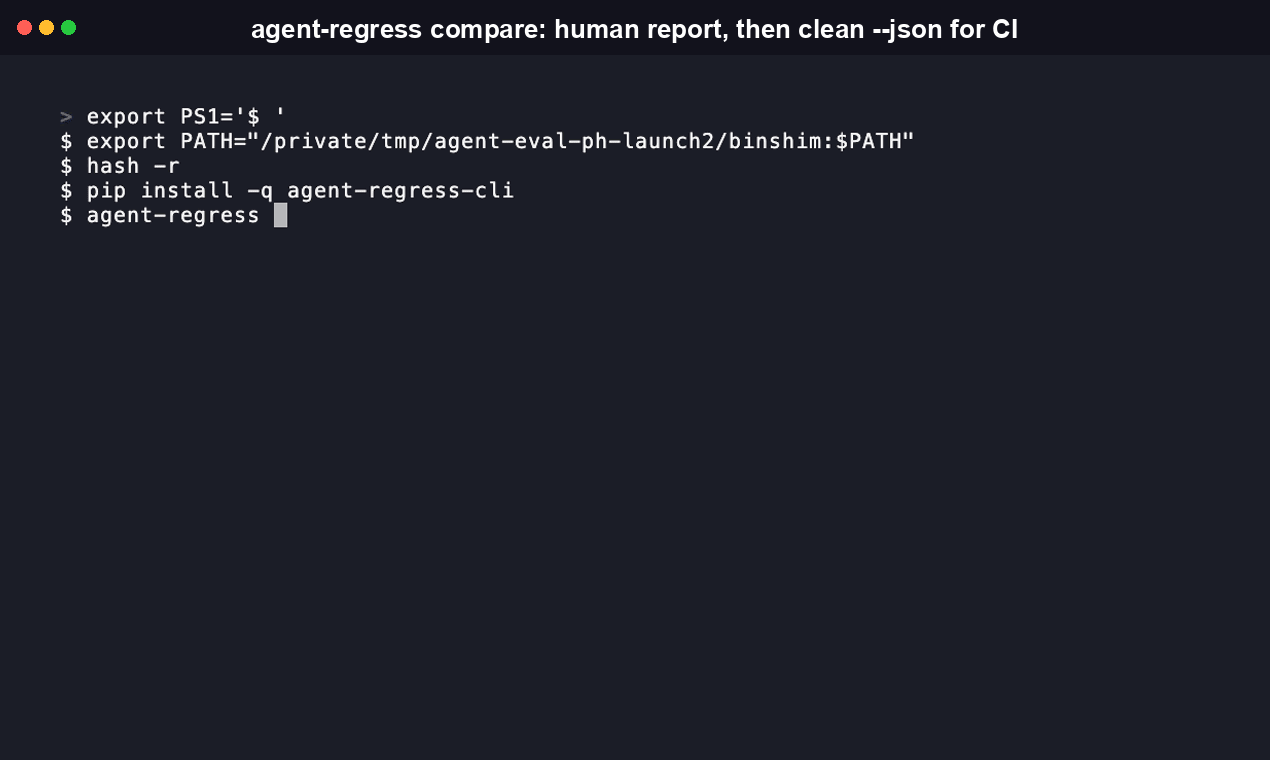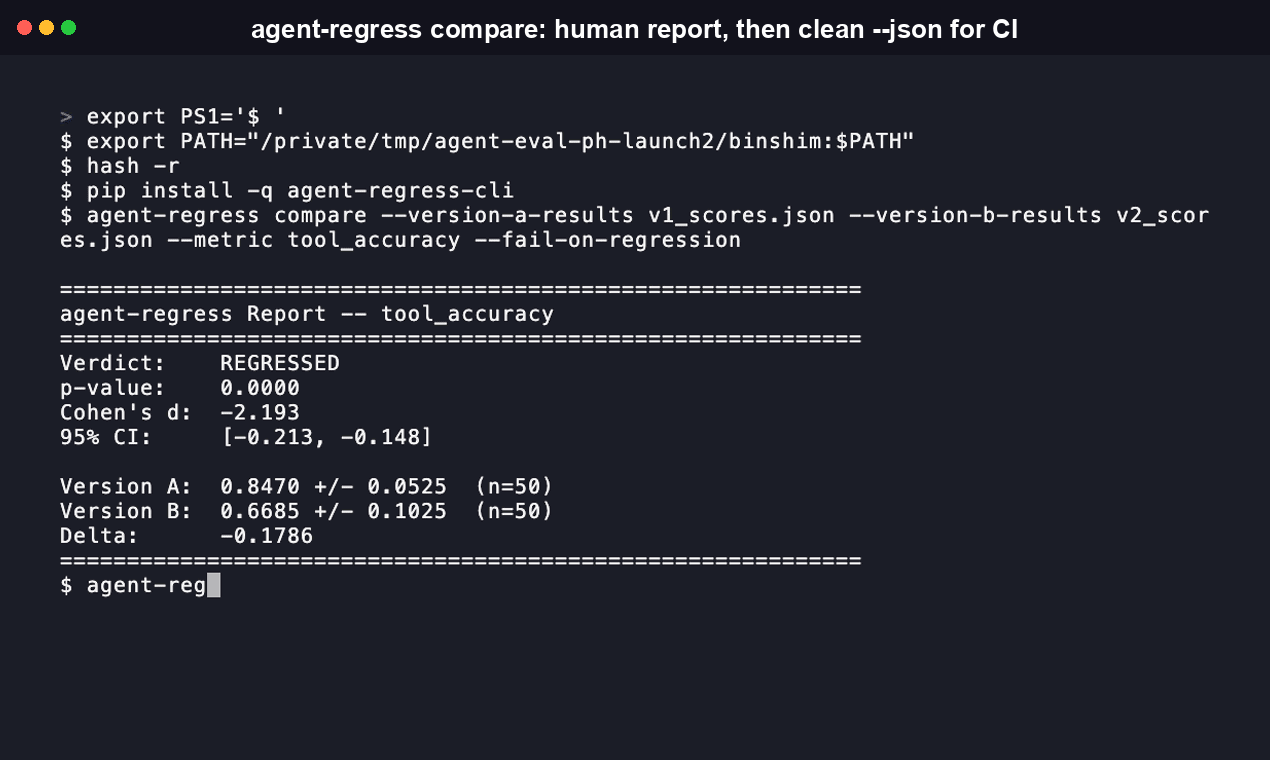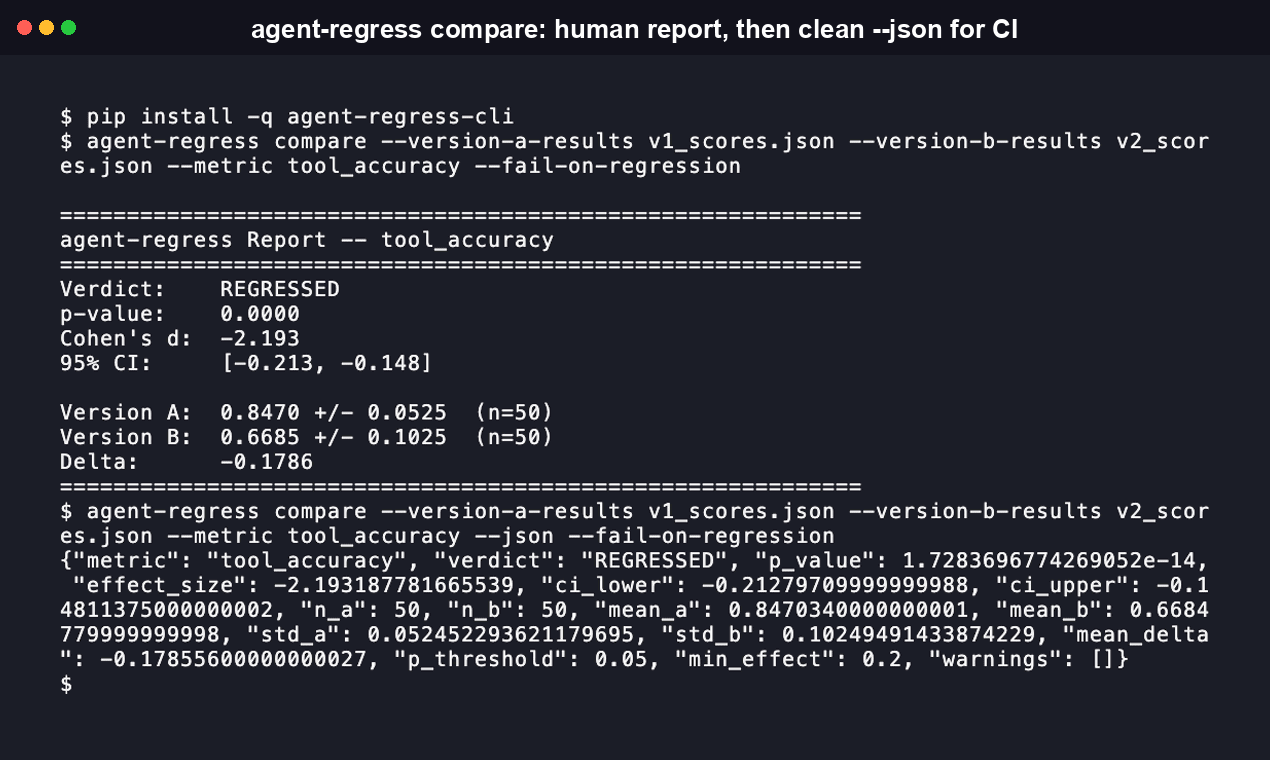
独自のハーネスで実行ごとのスコアをすでに取得していますか? CLI に、バージョンごとに 1 つずつ、スコアを格納した 2 つの JSON 配列を指定します。
pip install agent-regress-cli

agent-regress compare \
  --version-a-results v1_scores.json \
  --version-b-results v2_scores.json \
  --metric tool_accuracy

# ============================================================
# agent-regress Report -- tool_accuracy
# ============================================================
# Verdict:    REGRESSED
# p-value:    0.0000
# Cohen's d:  -2.193
# 95% CI:     [-0.213, -0.148]
#
# Version A:  0.8470 +/- 0.0525  (n=50)
# Version B:  0.6685 +/- 0.1025  (n=50)
# Delta:      -0.1786
# ============================================================
--json --fail-on-regression を追加すると、解析しやすいクリーンな出力が得られ、判定が REGRESSED の場合は終了コードが 0 以外になります。CI にそのまま組み込めます。
agent-regress compare のすべてのフラグ:
| フラグ | デフォルト | 説明 |
|---|---|---|
--version-a-results PATH | (必須) | バージョン A(ベースライン)の実行ごとのスコアを格納した JSON 配列へのパスです。 |
--version-b-results PATH | (必須) | バージョン B(候補)の実行ごとのスコアを格納した JSON 配列へのパスです。 |
--metric NAME | accuracy | 比較対象のメトリクス名です。レポートに表示されます。 |
--p-threshold P | 0.05 | Mann-Whitney U 検定の p 値に対する有意水準です。 |
--min-effect D | 0.2 | 統計的に有意な差を STABLE ではなく REGRESSED/IMPROVED と判定するための、最小 |Cohen's d| です。 |
--n-resamples N | 1000 | 信頼区間の算出に使用するブートストラップ再サンプリングの回数です(最小値:100)。 |
--json | オフ | 人が読みやすい形式の代わりに、レポートを単一の JSON オブジェクトとして標準出力に表示します。警告は引き続き標準エラー出力に送られるため、標準出力はクリーンで解析可能な JSON のままです。 |
--fail-on-regression | オフ | 判定が REGRESSED の場合、終了ステータス 1 で終了します(CI に便利です)。このフラグを指定しない場合、判定に関係なくコマンドは 0 で終了します。 |
トップレベルの agent-regress --version フラグは、インストール済みのバージョンを表示して終了します。
終了コード:
| コード | 意味 |
|---|---|
0 | 正常に実行されました。判定は REGRESSED、STABLE、IMPROVED、INSUFFICIENT_DATA のいずれかです。--fail-on-regression を指定しない場合、終了コードは判定を反映しません。 |
1 | --fail-on-regression が指定され、判定が REGRESSED でした。 |
2 | 使用方法またはデータのエラーです。引数が無効または不足している、サブコマンドが指定されていない、--version-*-results のファイルが存在しないか有効な JSON ではない、スコア配列が空または数値以外を含む、あるいは --p-threshold((0, 1) の範囲内である必要があります)、--min-effect(>= 0 である必要があります)、--n-resamples(>= 100 である必要があります)の値が許容範囲外の場合に発生します。 |
コードで使う(Python API)
スコアを事前計算する代わりに、自分でエージェントを実行しますか? Python API を使います。
from agent_regress import compare

# Any callable that takes a test case dict and returns a score 0.0-1.0
def agent_v1(test_case: dict) -> float:
    ...  # your existing agent

def agent_v2(test_case: dict) -> float:
    ...  # your updated agent

test_suite = [
    {"query": "find SKU for order 8823", "expected": "SKU-4492"},
    # ... more test cases
]

report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    metric="tool_accuracy",  # use any name except "accuracy" when agents return floats
)

print(report)           # structured output with p-value, CI, effect size
report.assert_stable()  # raises AssertionError if behavior regressed
エージェントがテキストを返しますか? スコアラーを渡すか、組み込みのものを使います。
from agent_regress import compare, exact_match_scorer, f1_scorer

# exact_match_scorer: 1.0 if str(output).strip() == str(expected).strip()
# f1_scorer: token-level F1 (multiset — handles repeated tokens correctly)
report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    scorer=exact_match_scorer,  # test_case must have an "expected" key
)
または、独自のものを作成します。
def my_scorer(output: str, test_case: dict) -> float:
    return 1.0 if output.strip() == test_case["expected"] else 0.0

report = compare(..., scorer=my_scorer)
MCP サーバー
agent-eval には Model Context Protocol サーバーが付属しているため、AI エージェント(Claude、Cursor、または MCP 対応クライアント)が、人が手動で CLI を実行することなく、統計的な回帰テストを直接実行できます。
追加パッケージをインストールします。
pip install "agent-regress-cli[mcp]"
MCP クライアントの設定に追加します(Claude Desktop の場合は claude_desktop_config.json)。
{
  "mcpServers": {
    "agent-eval": {
      "command": "uvx",
      "args": ["--from", "agent-regress-cli", "agent-regress-mcp"]
    }
  }
}
このサーバーは、指定されたサブコマンドと引数に --json を追加して agent-regress CLI を実行する run ツールを 1 つ公開し、解析済みの JSON 結果を返します。
run(["compare", "--version-a-results", "a.json", "--version-b-results", "b.json", "--metric", "accuracy"])
トランスポートは stdio なので、ホスティングする必要はありません。MCP クライアントがローカルのサブプロセスとしてサーバーを起動します。ソース: src/agent_regress/mcp_server.py。
DeepEval、Promptfoo、Braintrust では不十分な理由
| 機能 | Agent Evaluation | DeepEval | Braintrust | Promptfoo |
|---|---|---|---|---|
| 統計的なバージョン比較(p値) | はい | いいえ | いいえ | いいえ |
| 効果量のレポート(Cohen's d) | はい | いいえ | いいえ | いいえ |
| ブートストラップ法による95%信頼区間 | はい | いいえ | いいえ | いいえ |
| 分布シフトの検出 | はい | いいえ | いいえ | いいえ |
| Tau-bench pass^k ハーネス(k=1,4,8) | はい | いいえ | いいえ | いいえ |
| GAIA レベル1〜3の分割ハーネス | はい | いいえ | いいえ | いいえ |
| SWE-bench スキャフォールドスコアのハーネス | はい | いいえ | いいえ | いいえ |
| セルフホスト可能、SaaS不要 | はい | 一部 | いいえ | はい |
| サンプルサイズの警告 | はい | いいえ | いいえ | いいえ |
| コアライセンス | Apache 2.0 | MIT | プロプライエタリ | MIT† |
| クラウドアカウントが必要 | いいえ | 任意 | はい | いいえ |
| テストの種類 | 分布ベース | しきい値ベース | しきい値ベース | しきい値ベース |
†Promptfoo は2026年3月に OpenAI に買収されましたが、現在のライセンスの下でオープンソースのままです。
DeepEval は、個々のエージェントの応答が品質基準を満たすかをテストします。Agent Evaluation は、2つのエージェントバージョン間で挙動が有意に変化したかをテストします。これは異なる統計的な問いであり、しきい値テストでは答えられません。中核にある scipy の Mann-Whitney U 呼び出しは1行なので、どのSaaS評価プラットフォームでも追加できます。実運用を通じて時間とともに蓄積されるのは、バージョン固有のリグレッション履歴と、独立した結果検証を伴うコミュニティ管理のベンチマーク・リーダーボードです。
しきい値テストでは見逃し、統計的テストで検出できる実際のリグレッション
LangGraph
- #5243:新しい型付きの
context=API により、型なしのconfig['configurable']が置き換えられました。どちらの呼び出し方式でも単一の実行ならしきい値チェックを通過します。切り替えによって測定された挙動が変わったかを示せるのは、バージョンAとBの比較だけです。 - #4486:ノード/タスクレベルの結果キャッシュにより、繰り返しサンプリング時の分散が気付かないうちに隠される可能性があります。しきい値チェックでは結果がキャッシュに由来するかどうかは問題になりませんが、統計的比較には真に独立したサンプルが必要です。その前提を守るため、
agent-evalではキャッシュを無効化する仕組みを追加しました。
OpenAI Agents SDK
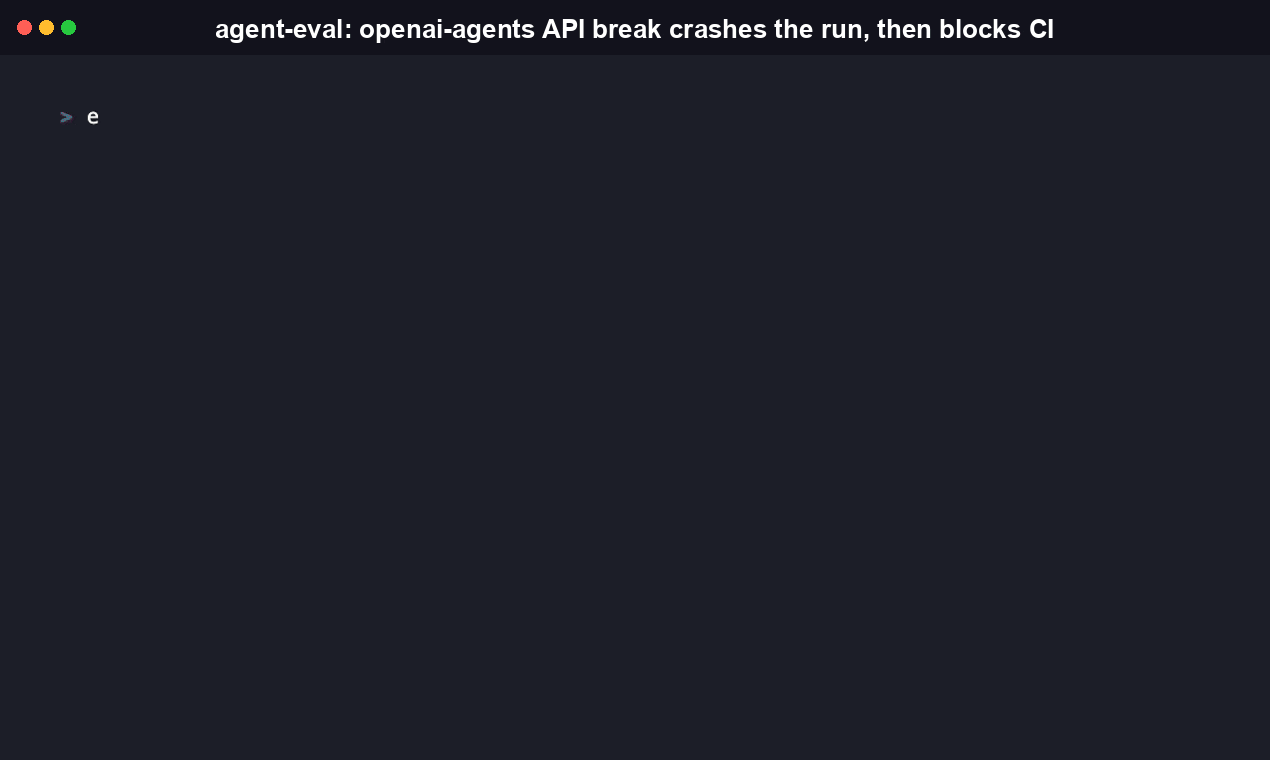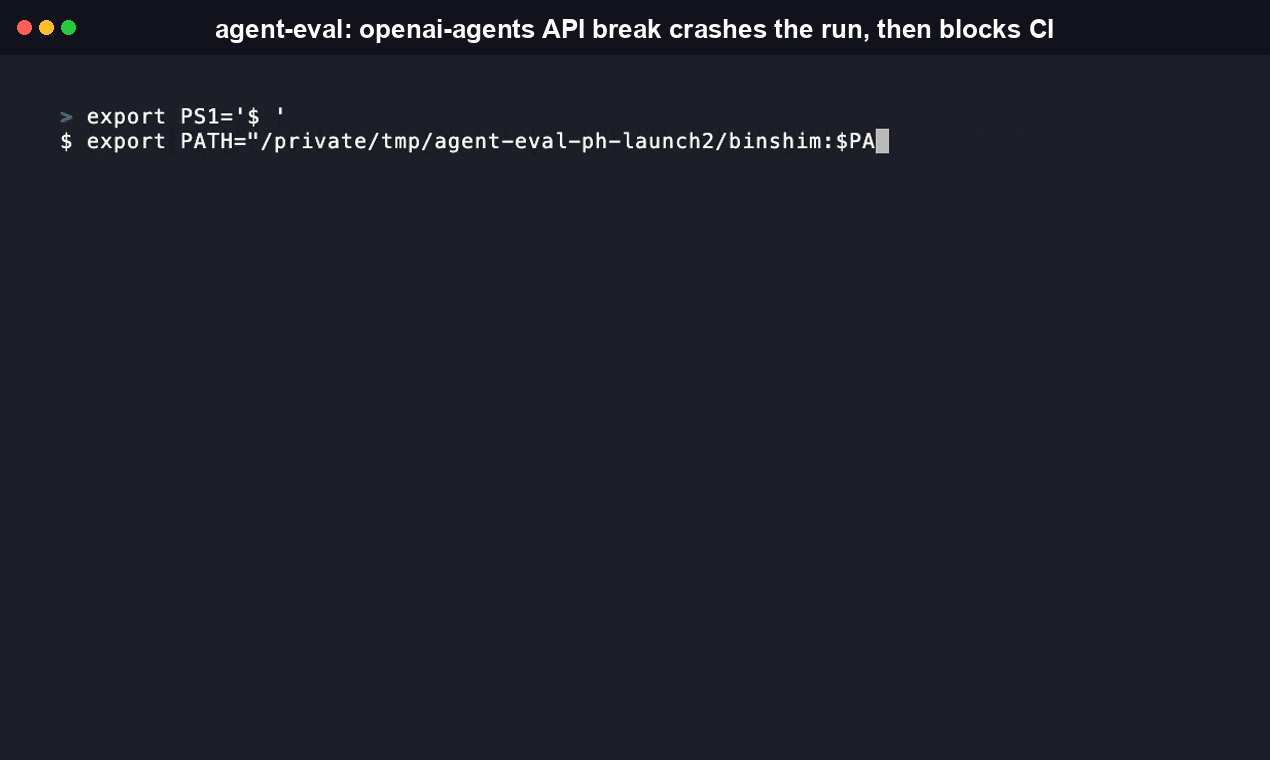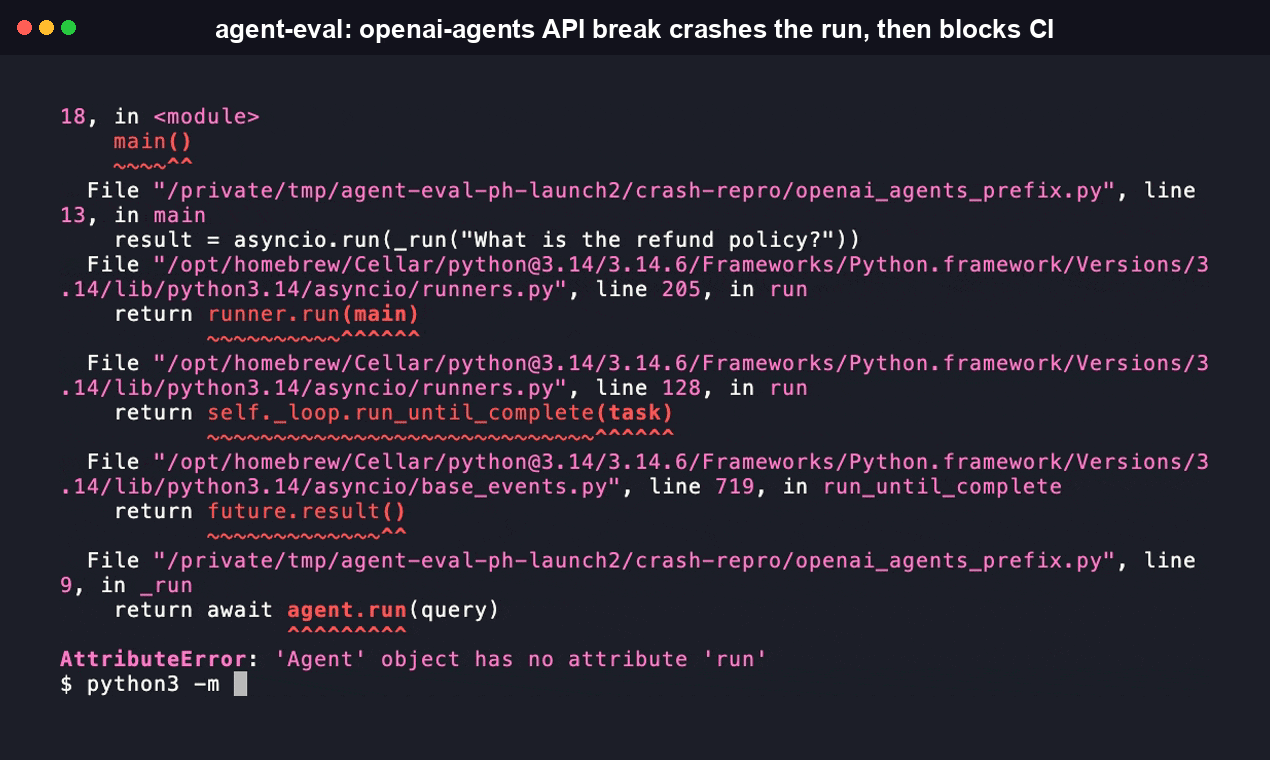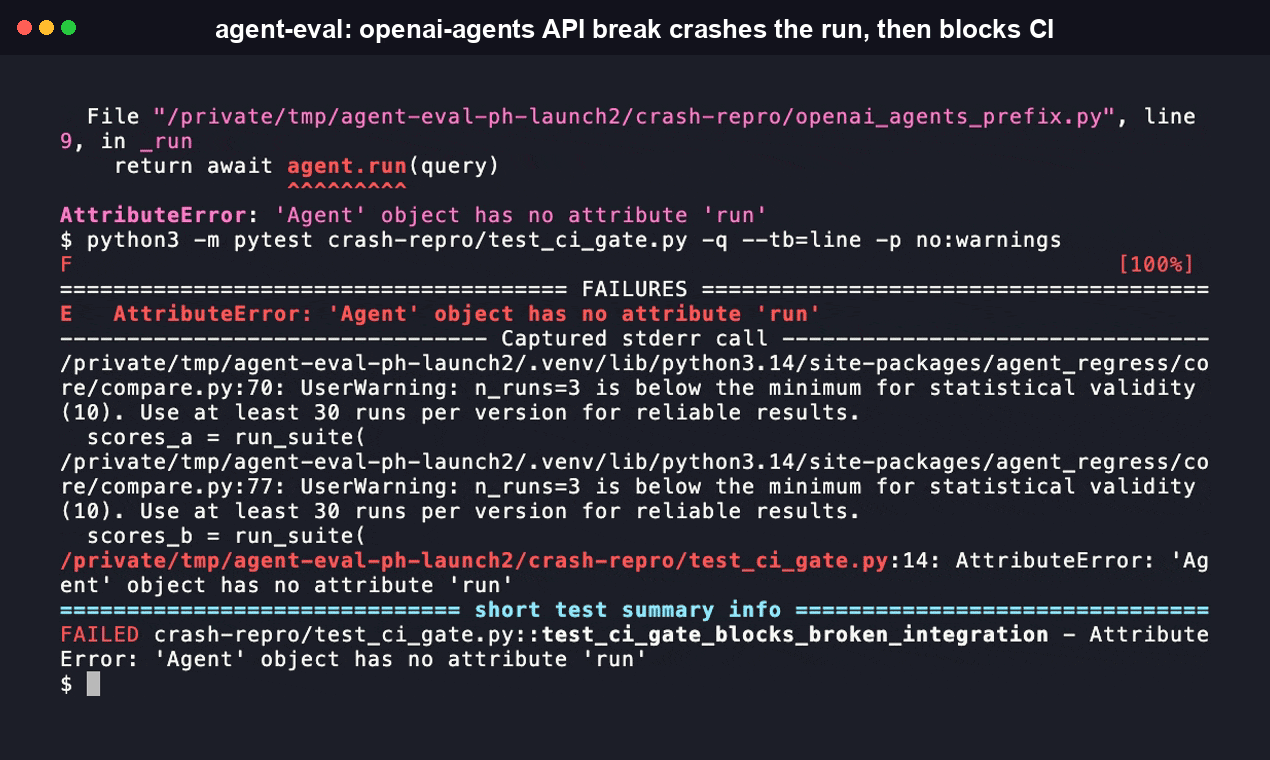
- #2463:エージェントをツールとして呼び出した際、親実行の
RunConfigが気付かないうちに破棄されていました。ネストされた呼び出しは通常どおりに見える応答を返すため、単一応答のチェックは通過します。リグレッションを明らかにできるのは、実行間の設定伝播を調べることだけです。 - #2214:画像/音声/ファイルのツール出力が、気付かないうちにテキストのみへと格下げされていました。テキストのみを扱うしきい値スコアラーには、添付ファイルが失われたことを検知する方法がありません。
CrewAI
- #6134:ファイルツールの応答で絶対ファイルシステムパスが漏れる問題に対するセキュリティ修正です。品質スコアラーが確認するのは回答が正しいかどうかであり、パスも漏れていないかどうかではないため、漏えいがあっても基準を通過します。
- #6236:ツールに任意の Pydantic
output_schemaが追加され、構造化されていないstr()出力から構造化JSONへと移行しました。スキーマが内部で変更されていても、しきい値スコアラーには旧形式と新形式のどちらも「妥当」に見える可能性があります。
こうしたリグレッションが、このプロジェクトのきっかけになりました。個別に文書化された14件のPR(LangGraph、CrewAI、OpenAI Agents SDKを対象とする29件のPR、239行の検証キャンペーンから抽出)の詳細は、docs/pr-analysis.md をご覧ください。
この問題を解決します
プロンプトを変更したとします。または、コスト削減のために GPT-4o から GPT-4o-mini に切り替えたとします。または、依存関係が知らないうちに更新されたとします。評価は引き続き合格します。固定しきい値に対して個々の応答をテストしているからです。動作が分布全体で変化したかどうかは検出できません。
精度が 3 ポイント低下したとしても、LLM のばらつきによるノイズかもしれませんし、実際のリグレッションかもしれません。統計的検定を行わなければ、どちらなのか判断できません。チームは小さな低下を無視して実際の問題を見逃すか、あらゆる変化をエスカレーションして誤警報に埋もれるかのどちらかです。
Agent Evaluation は、p 値と効果量で分布に関する問いに答えます。
============================================================
agent-regress Report -- tool_accuracy
============================================================
Verdict:    REGRESSED
p-value:    0.0031
Cohen's d:  -0.610
95% CI:     [-0.221, -0.067]

Version A:  0.8400 +/- 0.0601  (n=50)
Version B:  0.7000 +/- 0.0903  (n=50)
Delta:      -0.1400
============================================================
CI が失敗すると、アサーションエラーにデプロイをブロックするメッセージが表示されます。
AssertionError: REGRESSED: tool_accuracy dropped 16.7%
(p=0.003, Cohen's d=-0.61, 95% CI [-0.22, -0.07])
Version A: 0.840 +/- 0.060  (n=50)
Version B: 0.700 +/- 0.090  (n=50)
何も変わっていない場合:
Verdict:    STABLE
p-value:    0.4100
Cohen's d:  0.021
DeepEval、Promptfoo、Braintrust は、個々の応答がしきい値を満たすかどうかをテストします。いずれも、あるバージョンの動作分布が前回から有意に変化したかどうかには答えません。Agent Evaluation は、しきい値テストでは答えられない、この特定の統計的な問いに取り組みます。
CI に追加する:リグレッション時にビルドを失敗させる
方法は 2 つあります。どちらかを選んでください。
report.assert_stable() — インラインで、すでに compare() を呼び出した後に使用します。
# test_regression.py -- add to your existing test suite
from agent_regress import compare

def test_no_regression():
    report = compare(
        version_a=production_agent,
        version_b=staging_agent,
        test_suite=load_test_suite(),
        n_runs=50,
    )
    report.assert_stable(
        p_threshold=0.05,  # act on changes at p < 0.05
        min_effect=0.2,    # Cohen's d threshold -- ignore noise below 0.2
    )
RegressionGate — 再利用可能なゲートオブジェクトです。同じしきい値で複数の比較を実行する場合に便利です。
from agent_regress import compare, RegressionGate

gate = RegressionGate(p_threshold=0.05, min_effect=0.2)

def test_tool_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=suite, n_runs=50)
    gate.check(report)  # raises AssertionError on regression; warns if n < 30

def test_routing_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=routing_suite, n_runs=50)
    gate.check(report)
どちらの方法でも、バージョンごとの n < 30 では失敗させず警告し、n < 10 はデータ不足としてゲートをスキップします。この CI ゲートのしきい値(30)は、compare() 自体の一般的な検出力不足の警告(n < 50。詳しくはFAQを参照)より意図的に低く設定されています。50 回の実行を推奨するのは統計的検出力 80% を保証するためですが、このしきい値は、サンプルが本当に小さすぎる場合にビルドが暗黙のうちにゲートされるのを防ぐためのものです。
uv run pytest test_regression.py
統計的手法
Agent Evaluation は、3 つの統計的検定を組み合わせて使用します。
Mann-Whitney U 検定は、正規分布を仮定せずに 2 つのスコア分布を比較します。LLM のスコアはガウス分布ではありません。U 検定は分布に依存せず、実際のエージェント出力に見られる裾の長い分布や二峰性分布に対して堅牢です。
ブートストラップ信頼区間(1,000 回の再サンプリング、シード値 42)により、平均スコア差の 95% 信頼区間が得られます。信頼区間は変化の大きさを示します。たとえば、信頼区間が [-0.22, -0.07] の場合、実行あたりの真の精度低下は 7~22 パーセントポイントの範囲にあると 95% の確信を持てます。
Cohen の d(プールされた標準偏差)は、統計的有意性と運用上の有意性を区別します。p=0.001 で d=0.04 の変化は実際に存在しますが、意味のあるものではありません。p=0.06 で d=0.5 の変化は運用上大きなものですが、確認にはさらに多くのデータが必要です。デフォルトの CI ゲートは、p < 0.05 と d >= 0.2 の両方を満たす場合にのみ動作します。
詳しい手法については、docs/statistical-methods.mdを参照してください。
ベンチマーク
統計的検定のオーバーヘッドとは、比較自体の実行時間であり、エージェント呼び出しの時間ではありません。ボトルネックはエージェント呼び出しであり、統計処理ではありません。
Apple M3 Pro、Python 3.14、scipy 1.15、numpy 2.2 で測定:
| 操作 | バージョンごとに n=50 | バージョンごとに n=1,000 |
|---|---|---|
| Mann-Whitney U | 0.34ms | 0.47ms |
| ブートストラップ CI(1,000 回の再サンプリング) | 26ms | 31ms |
| compare() の統計処理オーバーヘッド全体 | 約 27ms | 約 32ms |
再現方法については、docs/benchmarks.mdを参照してください。
統合マトリクス
| フレームワーク | ステータス | インストール |
|---|---|---|
| LangGraph | リリース済み(v0.1) | pip install agent-regress-cli[langgraph] |
| OpenAI Agents SDK | リリース済み(v0.1) | pip install agent-regress-cli[openai-agents] |
| CrewAI | リリース済み(v0.1) | pip install agent-regress-cli[crewai] |
| LangChain LCEL | リリース済み(v0.1) | pip install agent-regress-cli[langchain] |
| AutoGen | 予定(v0.3) | |
| Vercel AI SDK (TypeScript) | 予定(v0.4) |
同じフレームワークの インストール済みバージョン 同士を比較する場合(インプロセスの設定同士ではなく)は、subprocess_runner() パターンについて
docs/cross-version-comparison.md をご覧ください。
警告
[crewai]エクストラについて:CrewAI 独自のメモリ/ナレッジ/RAG バックエンドにより、現在未修正の重大な CVE(GHSA-f4j7-r4q5-qw2c)を抱える ChromaDB が導入される場合があります。この脆弱性は、trust_remote_code=Trueで実行され、ネットワークに公開されているすべての ChromaDB サーバーに影響します。agent-eval自体が ChromaDB サーバーを起動、設定、公開することはないため、これは独自のCrewが ChromaDB を使用する場合にのみ関係します。修正がリリースされるまでは、trust_remote_code=Trueの ChromaDB インスタンスをネットワークに公開しないでください。
標準ベンチマーク
Agent Evaluation には、標準的なエージェントベンチマーク 3 種類のハーネスが用意されています。
Tau-bench pass^k は、独立した k 回の試行における信頼性を測定します。1 回のみのベンチマークでは性能低下を見落とします。k=1 で 60% の確率で成功するエージェントは、k=8 では 99.93% に達します。k=1 と k=8 の曲線が指標になります。
from agent_regress.benchmarks.tau_bench import TauBenchHarness

harness = TauBenchHarness(agent=my_agent, dataset=tau_bench_dataset)
results = harness.evaluate(k_values=[1, 4, 8])
GAIA Level 1-3 split は、タスクの難易度ごとに層別化します。全体の正解率では、難易度ごとの性能低下が隠れてしまいます。たとえば、Level 1 では役立つプロンプトの変更が、Level 3 では悪影響を及ぼすことがよくあります。
from agent_regress.benchmarks.gaia import GAIAHarness

harness = GAIAHarness(agent=my_agent, dataset=gaia_dataset)
results = harness.evaluate()  # returns list[GAIALevelResult], one per level
for r in results:
    print(f"Level {r.level}: {r.accuracy:.3f}  ({r.n_correct}/{r.n_questions})")
SWE-bench scaffold score は、フレームワークの貢献とモデルの貢献を切り分けます。
from agent_regress.benchmarks.swebench import SWEBenchHarness

harness = SWEBenchHarness(agent=my_agent, dataset=swe_dataset)
result = harness.evaluate()
print(f"scaffold pass rate: {result.scaffold_pass_rate:.3f}  ({result.n_resolved}/{result.n_instances})")
結果を投稿するには、leaderboard/README.md をご覧ください。
Docker で試す
git clone https://github.com/RudrenduPaul/agent-eval
cd agent-eval
docker compose up
次の 2 つのサービスを起動します。
- web(
http://localhost:8080)—web/serve.pyが提供するリーダーボード UI。leaderboard/results/*.jsonを読み込みます。 - example —
examples/01-basic-comparison/example.pyを実行し、比較レポートを標準出力に表示します。
インストールが正しく動作することを確認し、agent-regress を独自のエージェントに組み込む前にリーダーボード UI を確認するのに適しています。
セキュリティ
- サプライチェーン: リリースは GitHub Actions ワークフローでビルドおよび公開され、Sigstore で署名されます。また、すべての GitHub Release に CycloneDX SBOM が添付されます。(SLSA の来歴アテステーションはまだ生成されていません。これには
slsa-framework/slsa-github-generatorの採用が必要です。) - 脆弱性スキャン: すべての CI 実行で Trivy によるスキャンを行います(HIGH/CRITICAL のみを対象とし、未修正の脆弱性があれば終了します)。すべてのプッシュで CodeQL 静的解析を行います。
- 依存関係の固定: Dependabot がすべての GitHub Actions と Python の依存関係を最新の状態に保ちます。
- 脆弱性の報告: SECURITY.md — GitHub Security Advisories を通じて、脆弱性を非公開で報告してください。
リーダーボード
leaderboard/ ディレクトリでは、Tau-bench pass^k、GAIA、SWE-bench の結果をモデルおよびフレームワークごとにバージョン管理しています。leaderboard/schema.json に一致する JSON ファイルを含めて PR を作成すると、結果を投稿できます。マージ前に、結果は第三者によって再現されます。
leaderboard/README.md をご覧ください。
FAQ
agent-eval とは何ですか?通常の LLM 評価フレームワークと何が違いますか?
Agent Evaluation は、2 つのバージョン間でエージェントの動作が実際に変化したかを検出する統計ライブラリです。バージョン A で同じテストスイートを 50 回、バージョン B で 50 回実行すると、p 値(Mann-Whitney U)、効果量(Cohen's d)、スコア差のブートストラップ 95% 信頼区間を報告します。ほとんどの評価フレームワークは、単一の応答が固定の品質しきい値を満たすかを確認します。これに対して Agent Evaluation は、分布に関する問いに答えます。スコアの分布は有意に変化したのか、それとも単なる LLM の実行ごとのばらつきなのか、という問いです。
インストール方法と、対応しているプラットフォームを教えてください。
pip install agent-regress-cli または uv add agent-regress-cli を実行してください。Python 3.10~3.13 が必要です(pyproject.toml の分類情報に基づきます)。OS 固有のコードはないため、これらの Python バージョンが動作する環境であればどこでも実行できます。Node/npx ラッパー(npx agent-regress-cli。npm でも agent-regress-cli として公開されています)も利用できます。これは同じ Python パッケージを呼び出すため、Python ツールチェーン(または手動で pip install せずに一時的に実行できる uv/pipx)も利用可能である必要があります。どちらも見つからない場合は、対処方法を示すエラーが表示されます。
DeepEval、Promptfoo、Braintrust とはどのように違いますか?
詳しい比較は、上記の比較表をご覧ください。要約すると、DeepEval、Promptfoo、Braintrust はいずれも、個々の応答が固定の品質基準を満たすかをテストします。この 3 つのどれも、2 つのバージョン間で動作が変化したかという統計的な問いに対して、p 値、効果量、ブートストラップ信頼区間を報告しません。これは agent-eval が答えるために作られた、特定の統計的な問いです。
比較を実行したところ、統計的検出力が不十分という警告、または INSUFFICIENT_DATA という判定が出ました。これはどういう意味ですか?
どちらかのバージョンの実行回数が 50 回未満の場合、このライブラリは警告を表示します(処理は失敗しません)。これは、80% の検出力で中程度の効果(Cohen's d が 0.2)を確実に検出するために必要なサンプルサイズです。バージョンごとの実行回数が 10 回未満の場合、サンプルが小さすぎて統計的な結論を信頼できないため、REGRESSED/STABLE/IMPROVED の判定の代わりに INSUFFICIENT_DATA を返します。判断に使える判定を得るには、n_runs=50 以上で再実行してください。
agent-eval は LLM を呼び出したり、API キーを管理したりしますか?
いいえ。compare() は、ユーザーが指定する version_a と version_b という 2 つの呼び出し可能オブジェクトを受け取り、既存のエージェントコードをテストスイートに対して実行します。Agent Evaluation が自らモデルを呼び出すことはありません。また、統計モジュール(src/agent_regress/stats/)は、LLM を呼び出さず、純粋な Python と scipy のみを使う必要があります。そのため、統計処理の中核にはネットワーク依存関係がなく、認証情報の設定も不要です。
現在、どのエージェントフレームワークと連携できますか?
v0.1 では LangGraph、OpenAI Agents SDK、CrewAI、LangChain LCEL が提供されています(上記の連携一覧表をご覧ください)。それぞれ追加パッケージとしてインストールできます。例:pip install agent-regress-cli[langgraph]。AutoGen および Vercel AI SDK(TypeScript)との連携は計画中ですが、まだ提供されていません。
agent-eval は商用利用できますか?ライセンスは何ですか?
はい。Apache License 2.0 のもとでライセンスされており、商用利用、改変、配布が認められ、明示的な特許許諾も含まれています。著作権表示とライセンス表示を保持し、加えた変更を明記する必要があります。保証はありません。全文は LICENSE をご覧ください。
貢献
- PR を作成する前に CONTRIBUTING.md をお読みください
- 初心者向けの課題には GitHub でラベルが付いています
- 統計モジュール(
src/agent_regress/stats/)は、純粋な Python と scipy のみを使用する必要があります。LLM の呼び出しは一切禁止です - すべての PR で、
stats/のカバレッジ 95%、全体のカバレッジ 80% が必要です
設計に関する質問は GitHub Discussions へどうぞ。
Apache 2.0。貢献を歓迎します。
この成果を引用する
研究で Agent Evaluation を使用する場合は、次のように引用してください。
@software{paul2026agenteval,
  author = {Paul, Rudrendu and Nandy, Sourav},
  title = {Agent Evaluation: Statistical Regression Testing for LLM Agents},
  year = {2026},
  url = {https://github.com/RudrenduPaul/agent-eval},
  license = {Apache-2.0}
}
Rudrendu Paul と Sourav Nandy によって作成されました
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。