
agent-observability について
Agent Observability は、エージェントの HTTP 通信とトレースをローカルに記録し、API 呼び出しなしでオフライン再生します。対応フレームワークや HTTP クライアントを使い、障害の調査やフィクスチャベースの CI テストを行うチーム向けです。
主な機能
- 01生の HTTP リクエストとレスポンスを記録
- 02記録した実行をオフライン再生
- 03トレースの確認と差分比較
- 04不正な通信や Span の異常を検出
- 05ネットワークなしで CI にフィクスチャを利用
活用シーン
- 01ライブモデルを呼び出さずに障害を再現
- 02記録した 2 回の実行内容を比較
- 03CI でフィクスチャベースのエージェントテストを実行
MCP 対応
stdio の MCP サーバーは `run` ツールを公開し、`agent-trace` CLI を介して記録済みの実行を一覧表示、検査、再生します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
エージェントのオブザーバビリティ





エージェントのLLM呼び出しを一度記録すれば、オフラインで1ミリ秒未満で再生できます。API呼び出しも費用もゼロです。
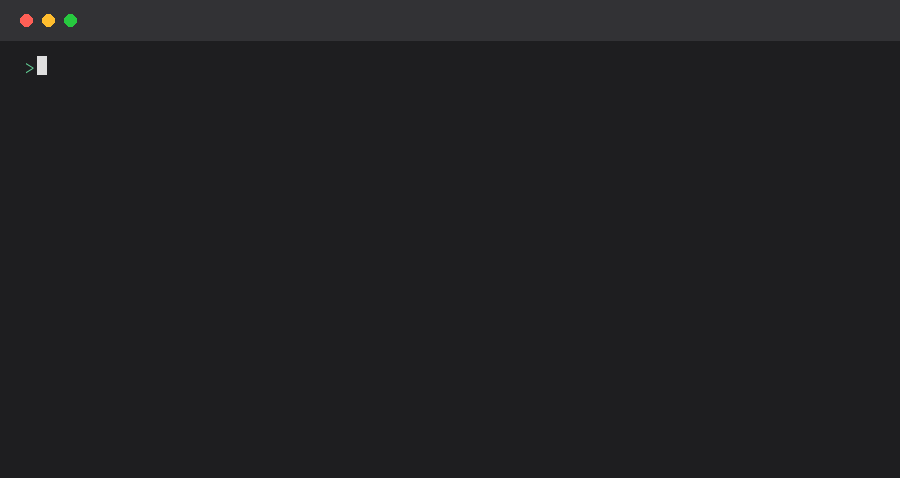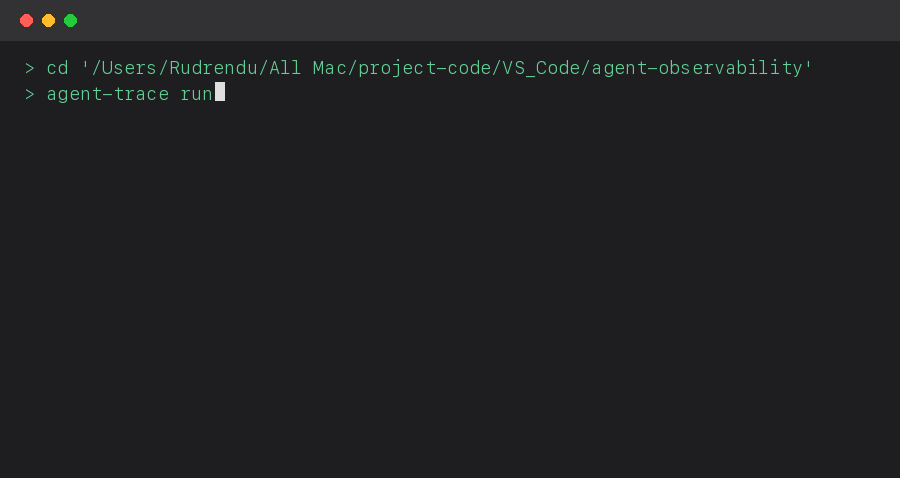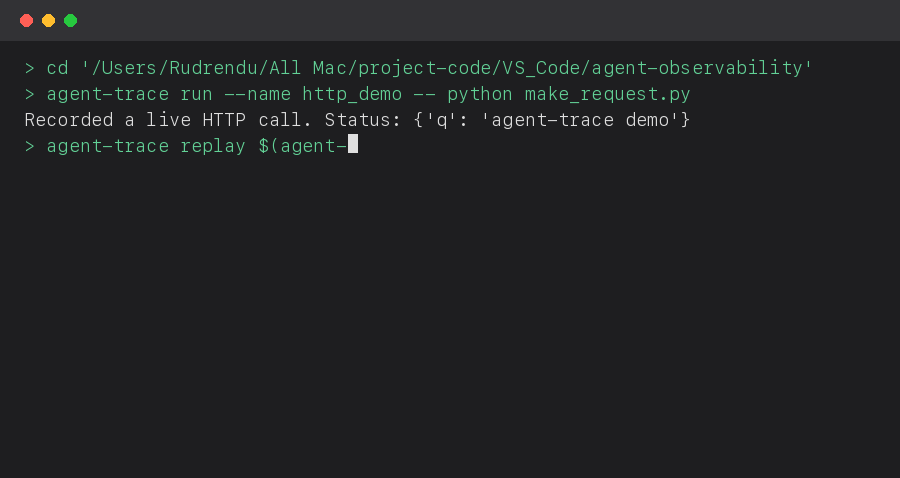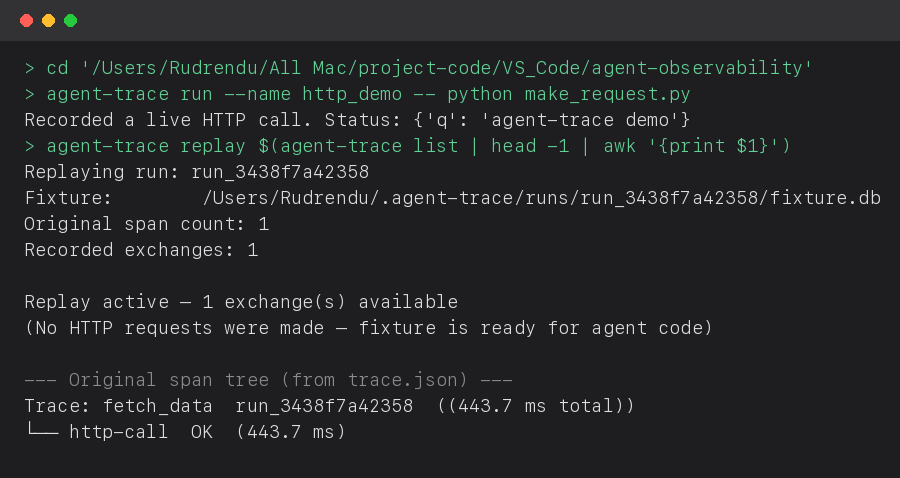
LangGraphエージェントがステップ8の後に失敗します。LangSmithを見れば、何が問題だったかは分かります。 再現するには、LLM呼び出しがさらに8回、時間がさらに30秒、API費用がさらに0.15ドルかかります。 一時的なモデル出力が原因の障害なら、そもそも再現できません。
Agent Observabilityがこの問題を解決します。 一度記録すれば、0.93ミリ秒でオフライン再生できます。API呼び出しも費用もゼロです。
Recording overhead:   0.011%   (0.090 ms added per LLM call)
Replay latency:       0.93 ms  mean (vs ~8,500 ms live on GPT-4o × 10 steps)
Replay fidelity:      100%     (response bytes byte-for-byte identical)
CI cost per replay:   $0
インストール
pip install agent-observability-trace-cli
# or
uv add agent-observability-trace-cli
LangGraphのサポート:
pip install agent-observability-trace-cli[langgraph]
OpenAI Agents SDKのサポート:
pip install agent-observability-trace-cli[openai-agents]
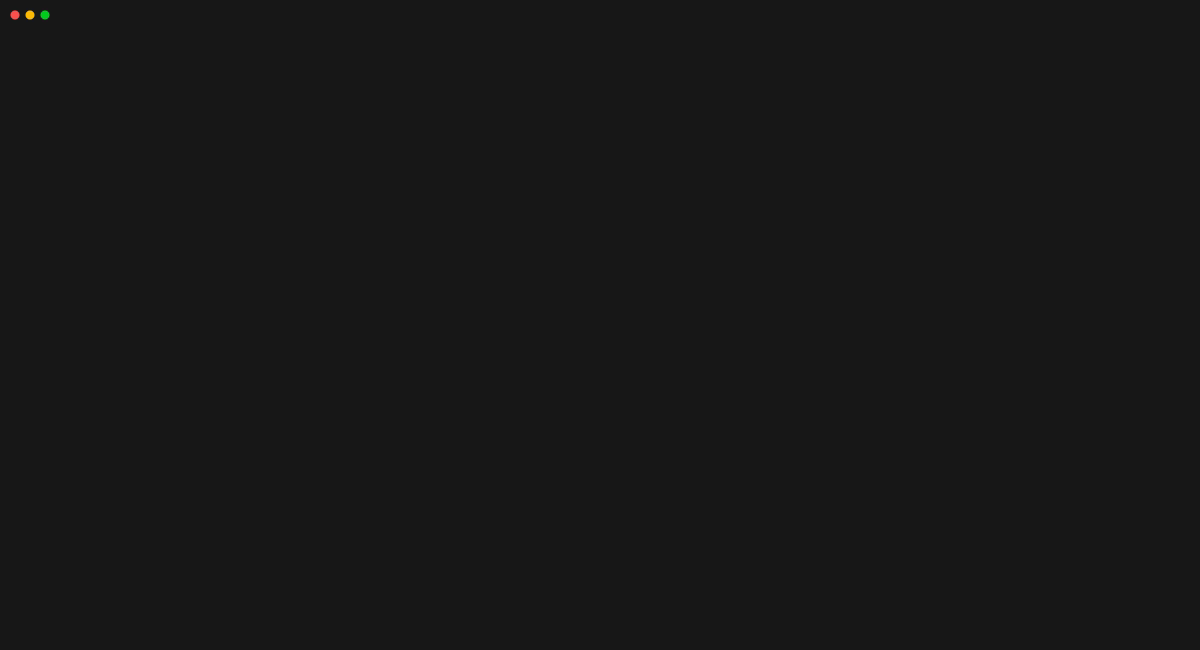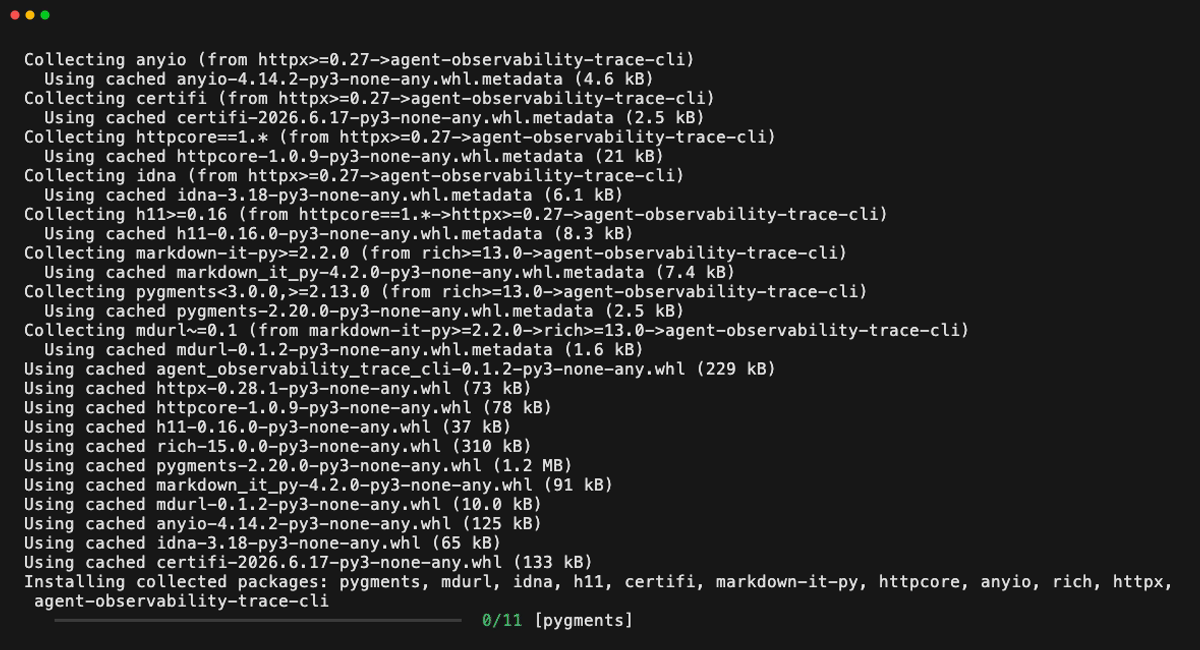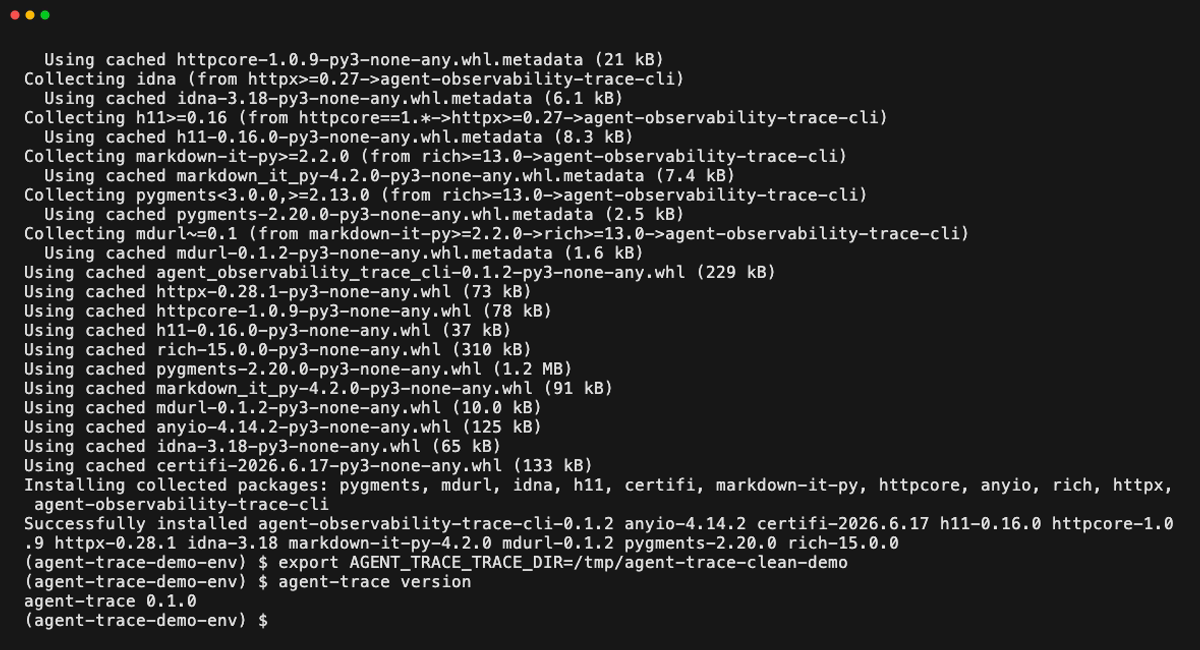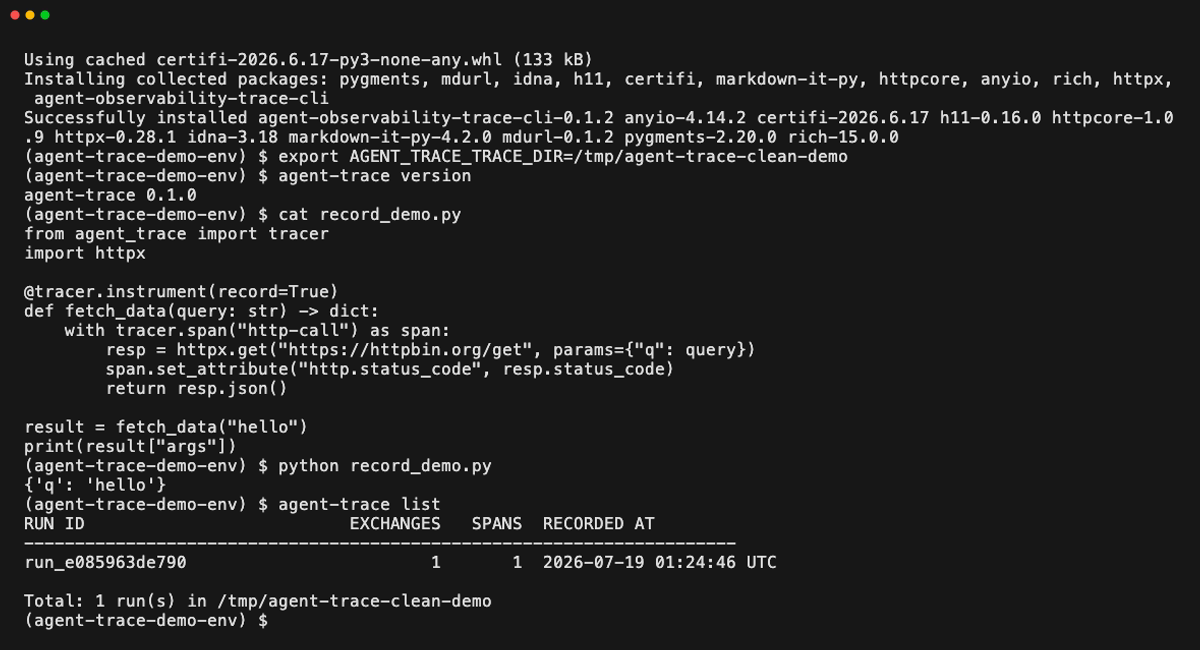
30秒で始めるCLIクイックスタート
# Record a live run (your script just needs `import agent_trace` somewhere)
agent-trace run --name my_agent -- python my_agent.py

# List recorded runs
agent-trace list

# Replay offline: zero network, zero cost
agent-trace replay run_<id>

# Show the trace for a run
agent-trace show run_<id>
list、inspect、diff、replay、runはすべて、機械で解析可能な出力を得られる--jsonに対応しています。そのため、オーケストレーションを行うエージェントやCIジョブは、人間が実行するのと同じ方法でこれらのコマンドを呼び出し、結果を解析できます。(run --jsonは、子プロセス自身の出力を構造化できないため、自身のステータスをstderrに、子プロセスの出力をstdoutに出力し、最後に最終的なJSONサマリー行を1行出力します。)showには独自の--jsonモードはありません。代わりに、--errors-onlyを指定して、失敗したスパンだけを出力するように絞り込めます。各サブコマンドのすべてのフラグについては、以下のCLIリファレンスを参照してください。
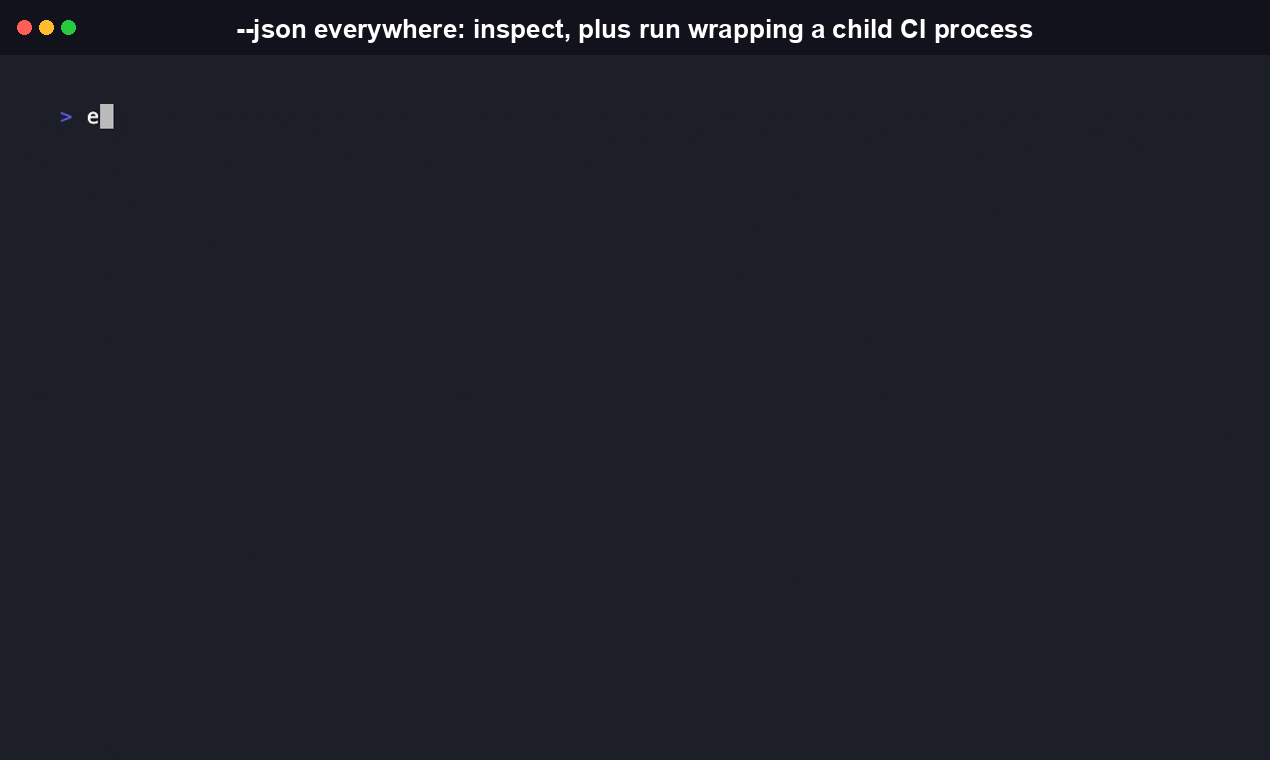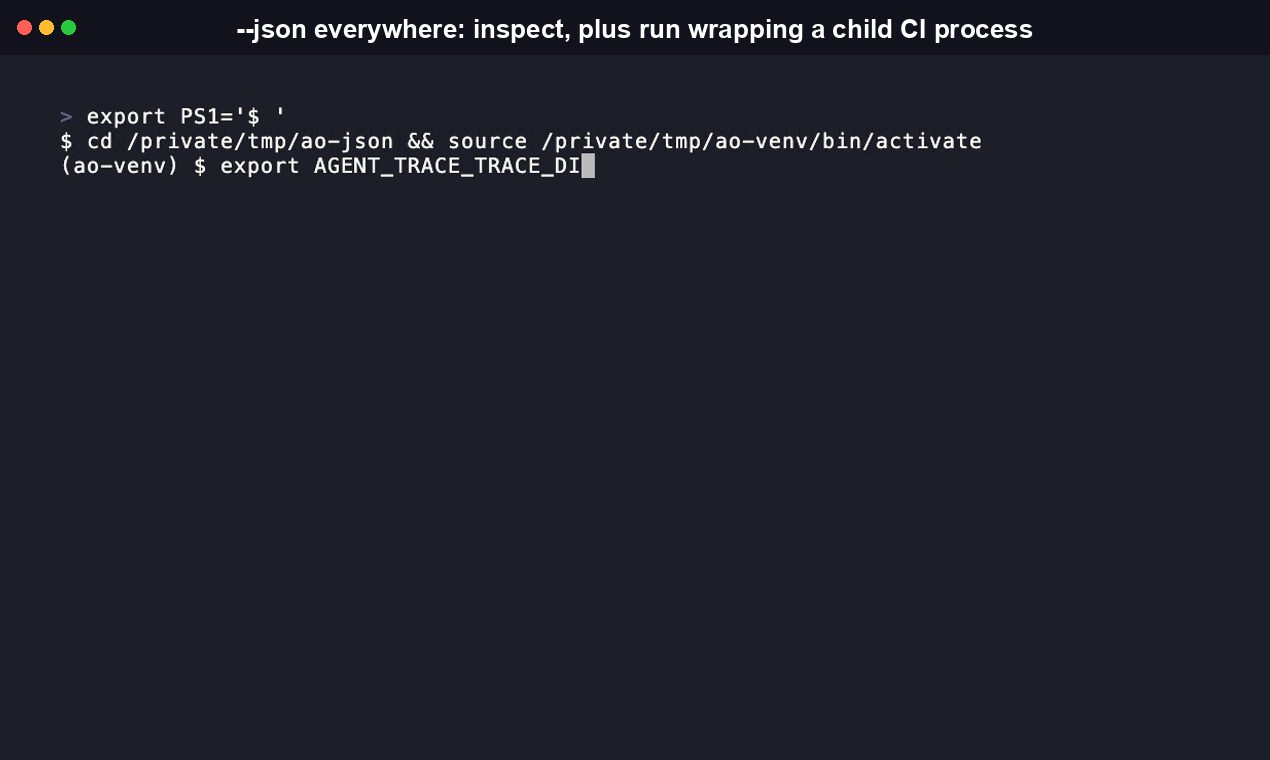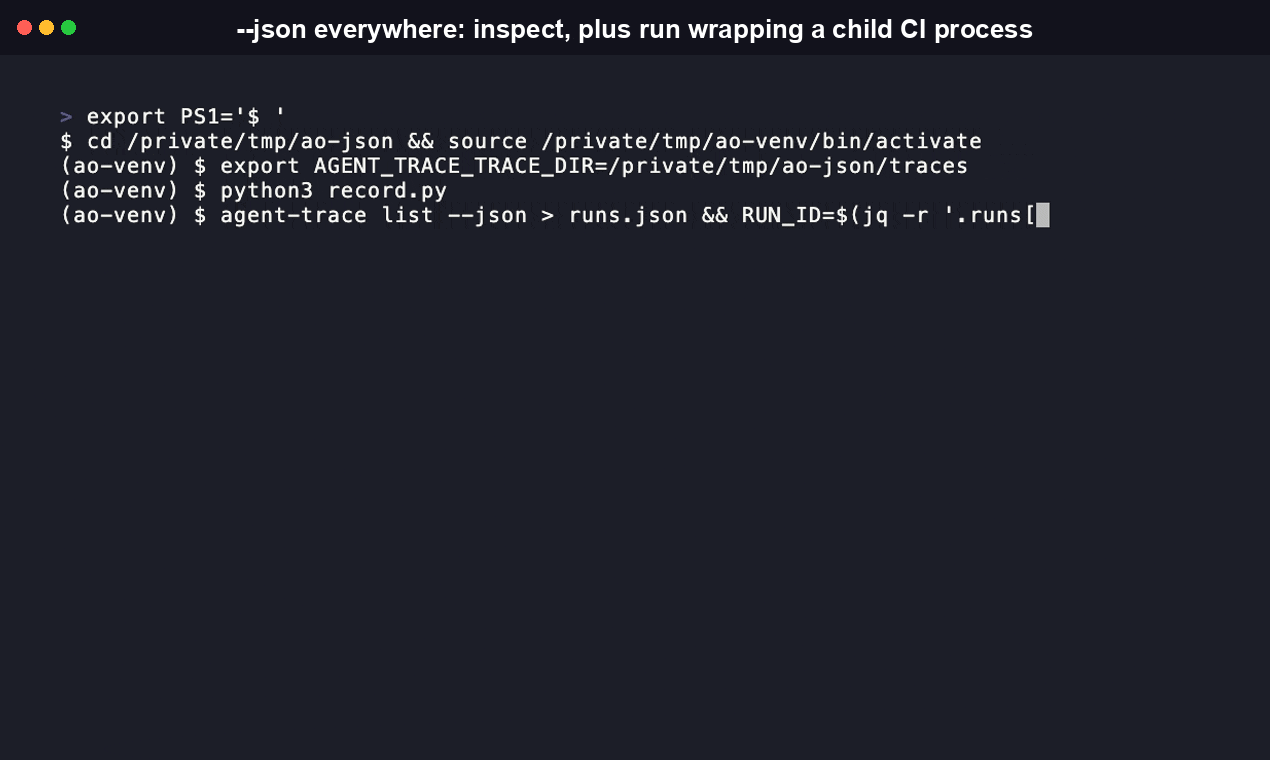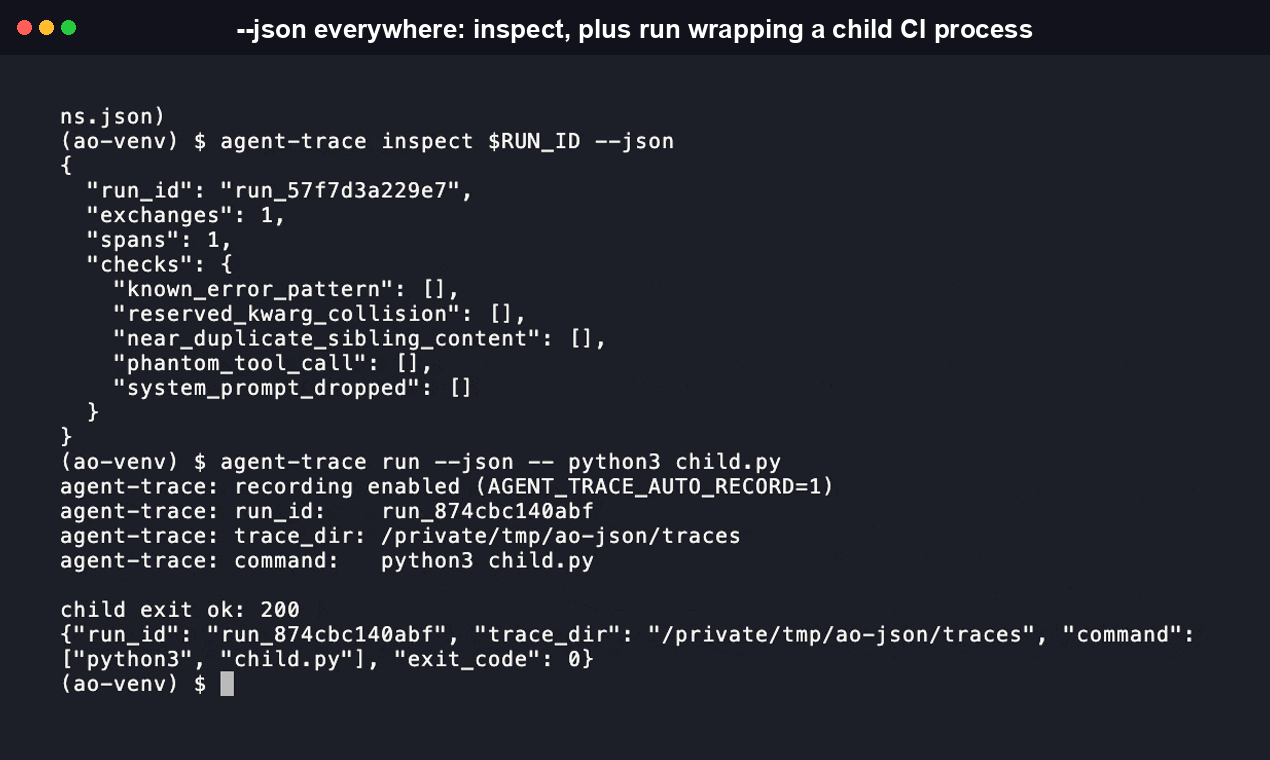
CLIではなく、プログラムから操作したい場合は、Python APIを使用してください。
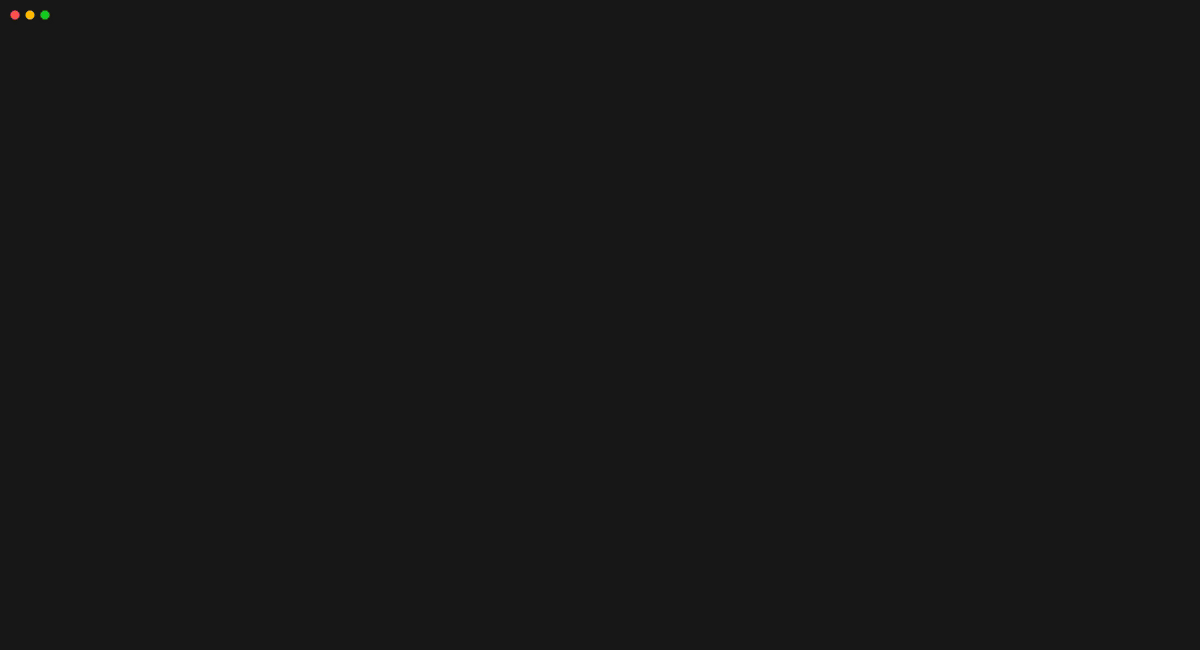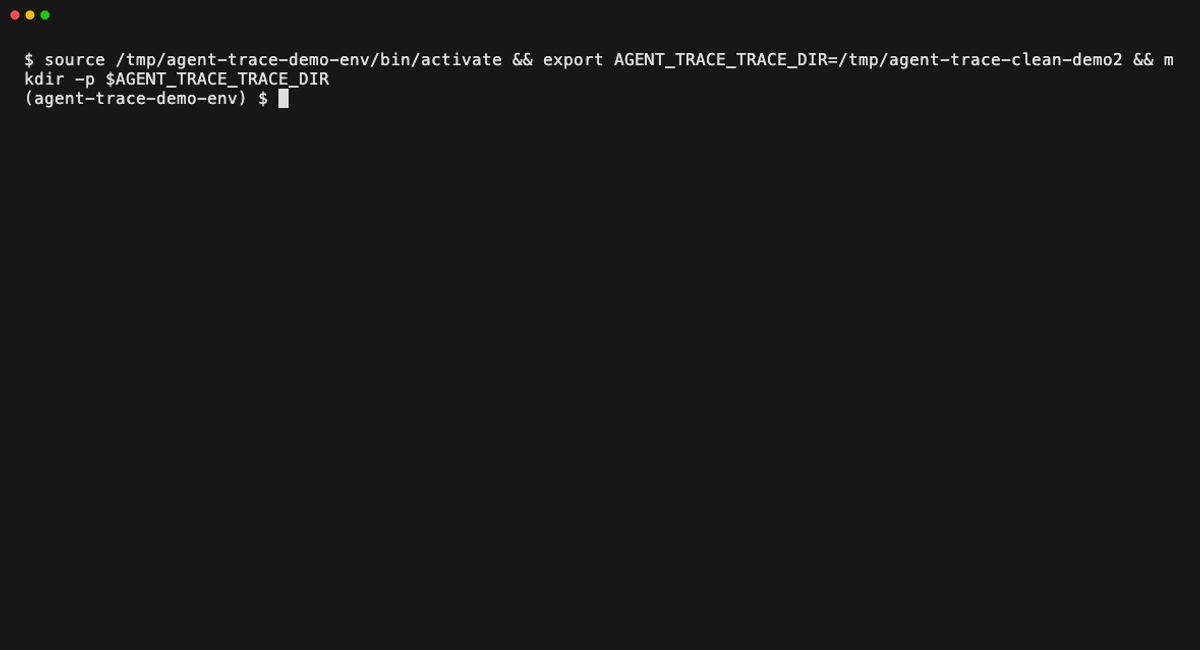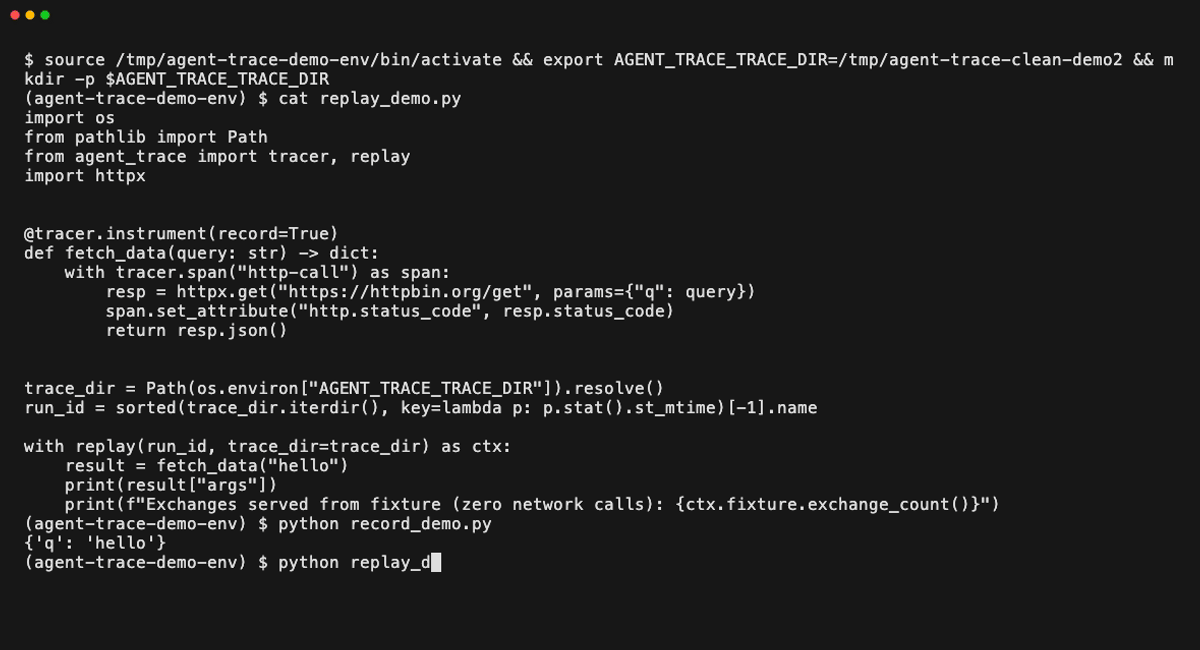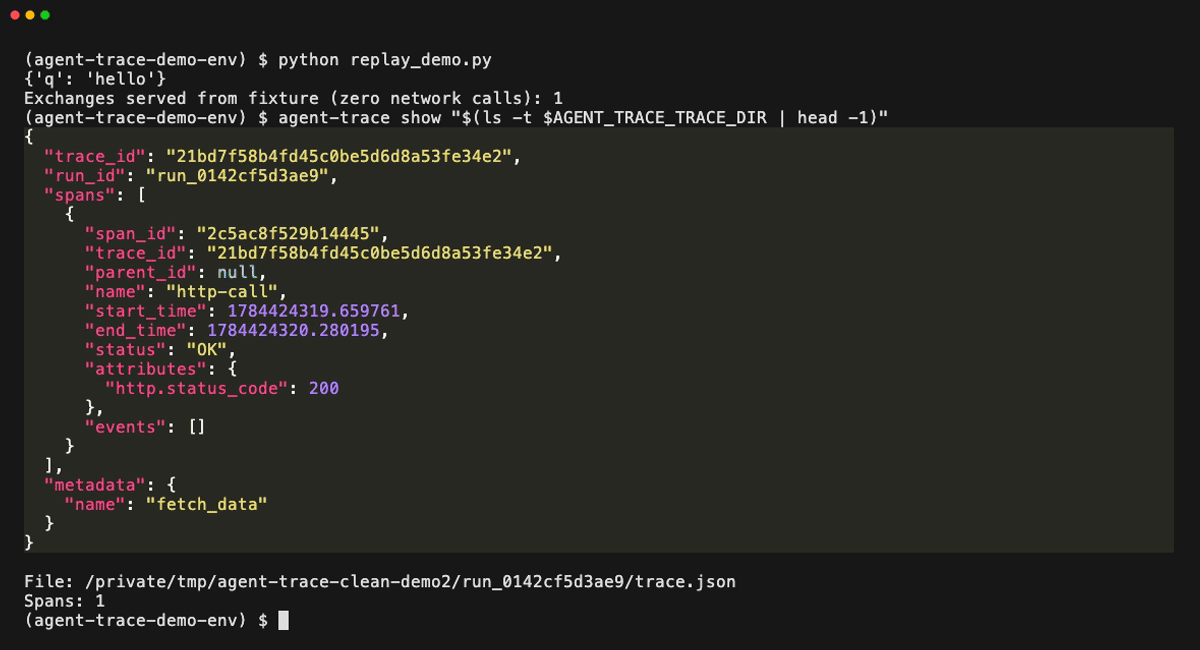
from agent_trace import tracer
import httpx

@tracer.instrument(record=True)
def fetch_data(query: str) -> dict:
    with tracer.span("http-call") as span:
        resp = httpx.get("https://httpbin.org/get", params={"q": query})
        span.set_attribute("http.status_code", resp.status_code)
        return resp.json()

result = fetch_data("hello")
# Trace and fixture saved to ~/.agent-trace/runs/run_<id>/
オフラインでリプレイできます。API呼び出しもトークンも不要です。
from agent_trace import replay

with replay("run_<id>") as ctx:
    result = fetch_data("hello")  # served from fixture, zero network
    print(result)                 # identical to the original run
ヒント
入力を保存して後でリプレイ時に取得するには、記録コンテキスト内で
ctx.fixture.set_metadata('input', query)を呼び出してください。
メモ
**同期クライアントと非同期クライアント:**Agent Observabilityは
httpx.Client、httpx.AsyncClient、requests.Sessionをインターセプトします。これには、OpenAI Python SDK v1.xおよびAnthropic SDKでデフォルトで使われる非同期クライアントも含まれます。パッチはリクエストのディスパッチ時に適用されるため、記録やリプレイの開始前に作成されたクライアントも対象になります(例:モジュールレベルのopenai.AsyncOpenAI()インスタンス)。
MCP サーバー
agent-observabilityにはModel Context Protocolサーバーが付属しています。AI エージェント(Claude、Cursor、またはMCP互換クライアント)は、人間が手動でCLIを実行しなくても、記録済みの実行を直接一覧表示、検査、リプレイできます。
追加機能をインストールします。
pip install "agent-observability-trace-cli[mcp]"
MCPクライアントの設定に追加します(Claude Desktopの場合はclaude_desktop_config.json)。
{
  "mcpServers": {
    "agent-observability": {
      "command": "uvx",
      "args": ["--from", "agent-observability-trace-cli", "agent-trace-mcp"]
    }
  }
}
サーバーはrunという1つのツールを公開します。このツールは、指定されたサブコマンドと引数に--jsonを付けてagent-trace CLIをシェルから実行し、解析済みのJSON結果を返します。
run(["list"])
run(["replay", "run_abc123def456"])
トランスポートにはstdioを使うため、ホストするものはありません。MCPクライアントがサーバーをローカルのサブプロセスとして起動します。ソース: src/agent_trace/mcp_server.py。
対応フレームワーク
LangGraph · OpenAI Agents SDK · CrewAI · AutoGen · LlamaIndex · Haystack · Agno · PydanticAI · Google GenAI
さらに、httpx.Client、httpx.AsyncClient、requests.Sessionにも対応しています。フレームワークは不要です。
CLIリファレンス
agent-traceには7つのサブコマンドがあります。すべてのサブコマンドで-h/--helpを指定すると、ここに記載されているのと同じ詳細を確認できます。
agent-trace version
インストールされているバージョンを表示して終了します。引数はありません。
agent-trace list
トレースディレクトリ内の記録済み実行をすべて一覧表示します(デフォルトは~/.agent-trace/runs、または$AGENT_TRACE_TRACE_DIR)。
| フラグ | デフォルト | 説明 |
|---|---|---|
--json | オフ | 人間が読みやすいテーブルの代わりに、機械可読なJSONを出力します。 |
agent-trace show <run_id>
実行の保存済みtrace.jsonを整形して表示します。
| 引数 | 必須 | 説明 |
|---|---|---|
run_id | はい | 実行ID。例:run_abc123def456。 |
| フラグ | デフォルト | 説明 |
|---|---|---|
--errors-only | オフ | ERRORステータスのスパンだけを、それぞれに捕捉された例外テキストとともに表示します。 |
showには--jsonモードはありません。構造化されたサマリーオブジェクトではなく、トレースを表示します(richがインストールされている場合は色付き、そうでない場合はプレーンなjson.dumps形式)。
agent-trace replay <run_id>
実行の再生モードに入り、結果のスパンツリーに加えて、ストリーミングのタイミング、HTTP エラーのやり取り、および show が出力するものと同じスパン間診断(エラー分類、重複したノードスパン、リトライの集中、誤って帰属されたスパン、チェックポイントの永続性、タスク数ゼロの更新)を出力します。
| 引数 | 必須 | 説明 |
|---|---|---|
run_id | はい | 実行 ID。例:run_abc123def456。 |
--json | いいえ | 人間が読みやすいスパンツリーの代わりに、構造化 JSON サマリー(フィクスチャのパス、スパン数/やり取り数、元のトレース)を出力します。 |
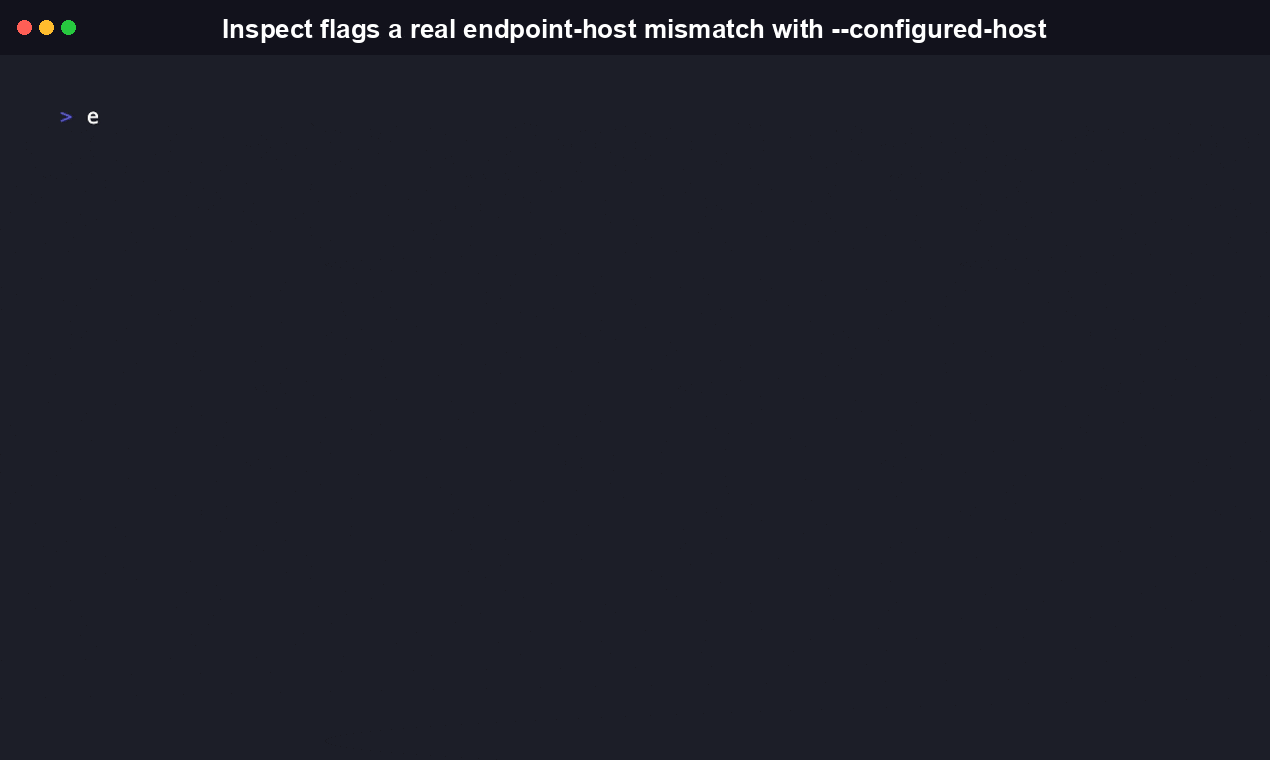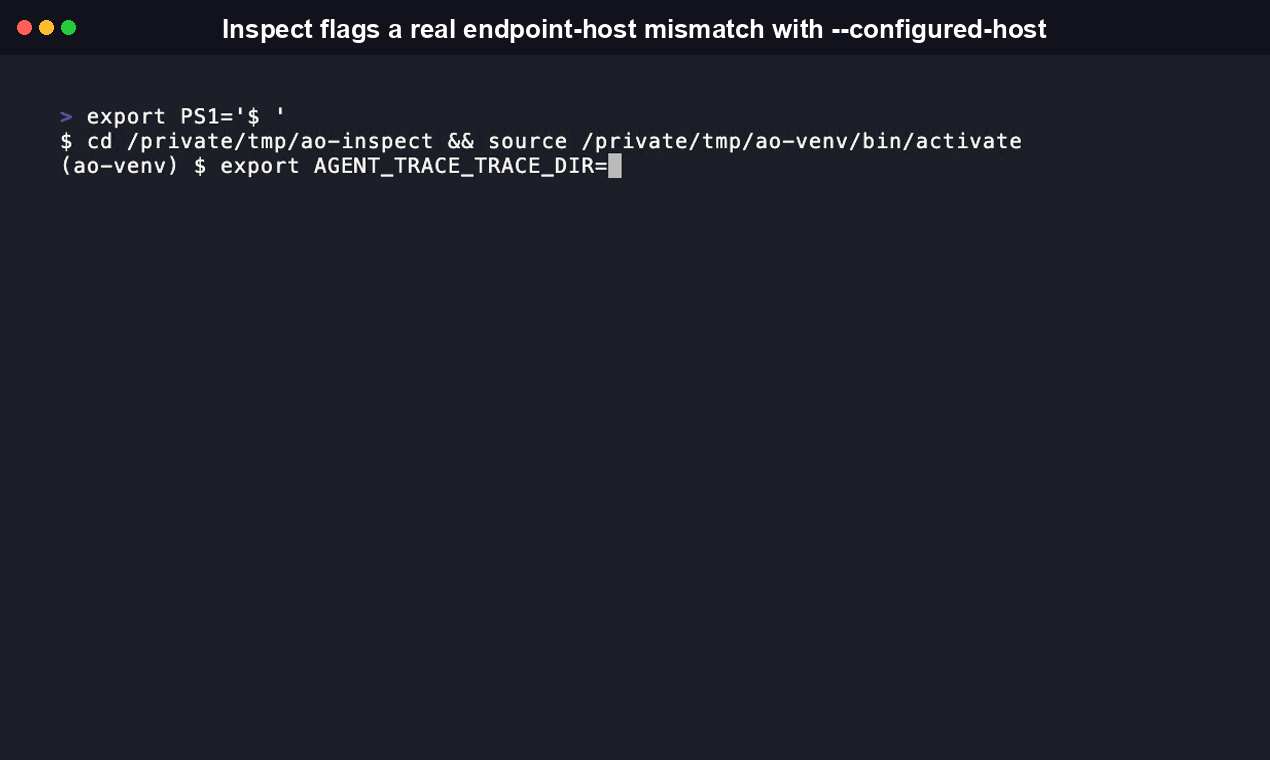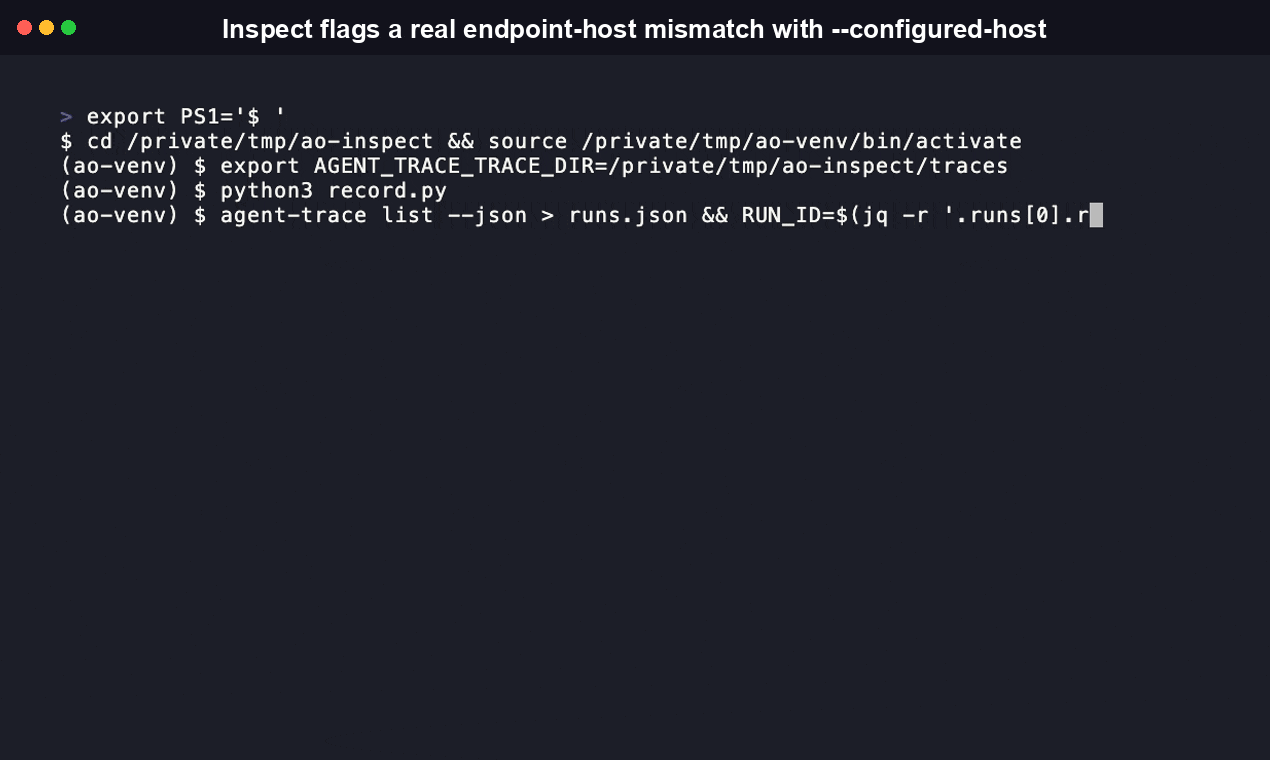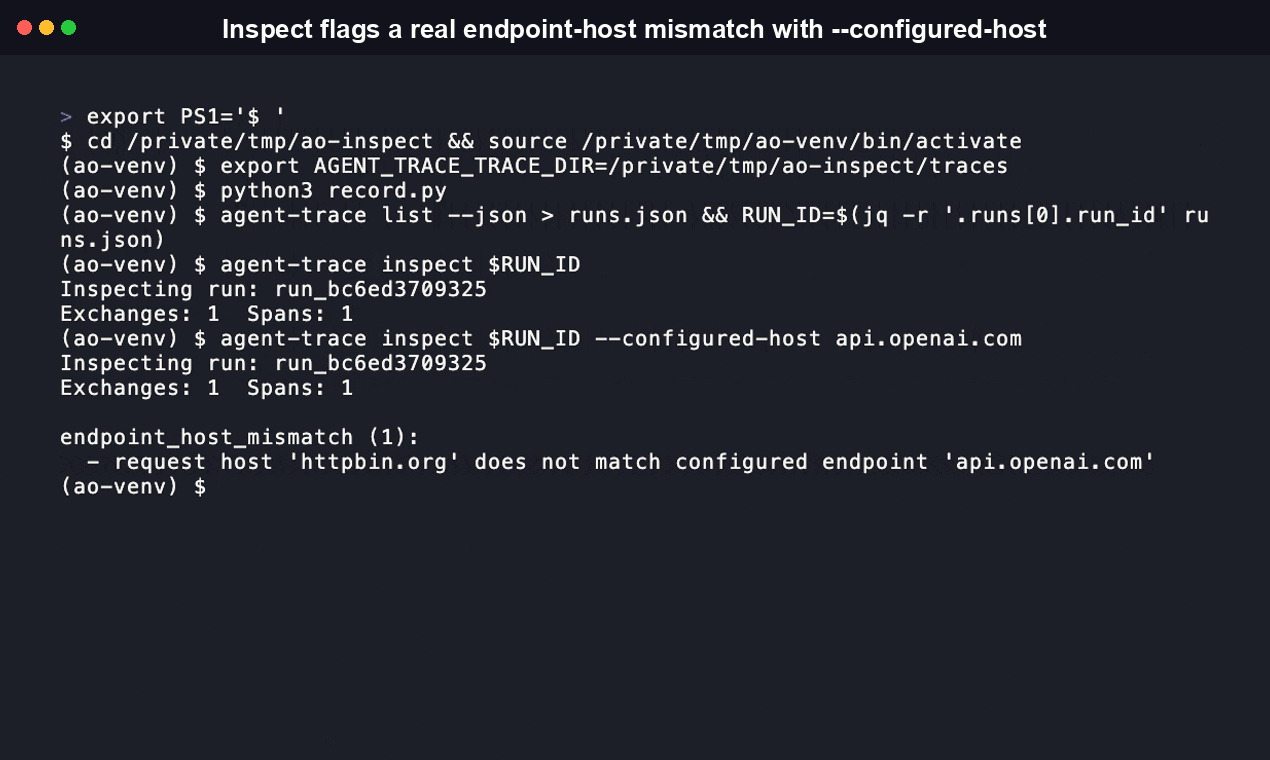
agent-trace inspect <run_id>
実行に対して、既知の不正なリクエスト/レスポンス形式とスパン間の異常を自動的に検出します。
| 引数 | 必須 | 説明 |
|---|---|---|
run_id | はい | 実行 ID。例:run_abc123def456。 |
| フラグ | デフォルト | 説明 |
|---|---|---|
--registered-tools | なし | 登録済みツール名をカンマ区切りで指定します。ツール呼び出し名のあいまい一致、ドット区切りの複合名、登録されていない ReAct アクション名、登録されていないツール呼び出し名のチェックを有効にします。 |
--configured-host | なし | フレームワークで設定された LLM エンドポイントのホストです。エンドポイントホスト不一致のチェックを有効にします。 |
--check-kwarg | なし | ワイヤー上に存在することが期待される、ドット区切りの kwarg パス(例:extra_body.chat_template_kwargs.thinking)です。存在しないリクエストを検出します。 |
--diff-field | なし | ワイヤー上には存在するが下流では欠落しているかを確認するレスポンスフィールドです。トップレベルのキー(例:usage)、または数値のリストインデックスを含むドット区切り/ネストされたパス(例:DeepSeek の reasoning_content など、プロバイダーフィールドの choices.0.message.reasoning_content)を指定します。 |
--diff-get-post-field | なし | 先行する GET レスポンスと、同じリソース ID を参照する、後続の因果関係にある POST リクエスト本文の間で比較するドット区切りのフィールドパス(例:instructions)です(issue #2620 を参照)。GPTAssistantAgent の POST /runs が、GET /assistants/{id} の戻り値と一致しなくなった instructions を送信し続けている場合など、古い値との不一致を検出します。 |
--diff-get-post-id-field | id | リソース ID に使われる GET レスポンスのフィールド名です。 |
--diff-get-post-post-id-field | --diff-get-post-id-field と同じ | 異なる場合に、同じリソース ID を参照する POST リクエスト本文のフィールド名(例:assistant_id)です。 |
--json | オフ | 人間が読みやすいフラグ一覧の代わりに、機械可読な JSON を出力します。 |
agent-trace diff <run_id_a> <run_id_b>
URL に基づいて照合した、記録済みの 2 つの実行のやり取りを比較し、リクエスト/レスポンス本文のフィールド単位の差分を強調表示します。また、共通の LangGraph thread_id に対する再起動と再開のチェックも行います(issue #161 を参照)。
| 引数 | 必須 | 説明 |
|---|---|---|
run_id_a | はい | 1 つ目の実行 ID。 |
run_id_b | はい | 2 つ目の実行 ID。 |
| フラグ | デフォルト | 説明 |
|---|---|---|
--json | オフ | 人間が読みやすい差分の代わりに、機械可読な JSON を出力します。 |
agent-trace run -- <command> [args...]
プロセス全体で記録を事前に有効化した状態(AGENT_TRACE_AUTO_RECORD=1)で子プロセスを実行します。そのため、そのプロセス内で最初に import agent_trace した時点で、langgraph dev のようなサードパーティ製 CLI が所有するプロセスであっても、エージェントのコードを一切変更せずに記録が開始されます。終了時には、子プロセス自身の終了コードを返します。
| フラグ | デフォルト | 説明 |
|---|---|---|
--run-id | ランダム(run_<12-hex-chars>)、開始時に表示 | 明示的な実行 ID です。 |
--name | auto-record | trace.json のメタデータに記録するトレース名です。 |
--json | オフ | agent-trace 自身のステータスを、最終行に JSON 形式で 1 行 stdout に出力します(ステータス行は代わりに stderr に出力されます)。子コマンドより前に指定する必要があります。例:agent-trace run --json -- langgraph dev。 |
child_command(位置引数) | なし | -- の後にあるすべての内容を子プロセスとして実行します。例:-- langgraph dev。コマンドラインの残りすべてを取得するため、--run-id/--name/--json は子コマンドの後ではなく、前に指定する必要があります。 |
問題点
LangGraph の実行がステップ 8 の後に失敗します。LangSmith または Langfuse のトレースで、何が問題だったかはわかります。しかし、再現するにはエージェント全体をもう一度実行しなければなりません。LLM 呼び出しがさらに 8 回、実行時間がさらに 30 秒、API コストがさらに 0.15 ドルかかります。特定のツール応答や一時的なモデル出力が原因で失敗した場合は、そもそも再現できません。変化し続ける対象を相手にデバッグすることになります。
Agent Observability は、HTTP トランスポート層でこの問題を解決します。 すべてのリクエストとレスポンスを、加工せずにローカルの SQLite ファイルへ記録します。リプレイでは、同じコードパス、同じスパンツリー、同じ失敗を、やり取りあたり 1 ミリ秒未満で、まったく同じバイト列を順番に返します。API 呼び出しは発生しません。
CI で使用:コストゼロでリプレイ
一度記録し、フィクスチャをコミットすれば、すべての CI 実行で API コストゼロのリプレイができます。
# tests/test_agent.py
import pytest
from pathlib import Path
from agent_trace import replay

FIXTURE_PATH = Path("fixtures/my_agent_run.db")

@pytest.mark.skipif(
    not FIXTURE_PATH.exists(),
    reason="Run: python scripts/record_fixture.py to generate the fixture"
)
def test_agent_answer():
    with replay(FIXTURE_PATH) as ctx:
        from my_module import my_agent
        result = my_agent("what is 2+2?")
    assert "4" in result
CI で AGENT_TRACE_NETWORK_GUARD=1 を設定します。フィクスチャにない HTTP 呼び出しはすべて、直ちに NetworkGuardError を発生させます。これにより、本番環境に反映される前にリグレッションを検出できます。
AGENT_TRACE_NETWORK_GUARD=1 uv run pytest tests/
これによって何を節約できますか?
10-step agent × $0.15 per run × 10 debug sessions per week = $15/week in API costs
With Agent Observability CI replay: $0/week

At scale (10 engineers, each debugging 3 failures/week):
Before: ~$45/week, ~5 hours/week waiting for live re-runs
After: $0/week, 0.93 ms per replay
LangSmith、Langfuse、Heliconeを使うだけではだめですか?
簡単に言うと、これらのツールでは何が起きたかを確認できますが、オフラインでは再現できません。 LangSmithのVCRカセットはPython + LangChain専用で、ワイヤー上のバイト列全体を記録せず、LangSmithアカウントが必要です。Agent ObservabilityはあらゆるPython HTTPクライアントで動作し、アカウント不要で、0.93 msで100%の忠実度でリプレイします。
LLMエージェント向けのオブザーバビリティツールの多くは観測専用です。何が起きたかのトレースは確認できますが、障害を再現するには、実際のAPIに対してエージェント全体を再実行する必要があります。
| 機能 | Agent Observability | LangSmith | Langfuse | Helicone | OpenLLMetry |
|---|---|---|---|---|---|
| ローカルのフィクスチャからオフラインでリプレイ | はい | 一部対応 ¹ | いいえ | いいえ | いいえ |
| あらゆるHTTPクライアントで動作 | はい | いいえ | いいえ | いいえ | いいえ |
| APIキーなしでCIリプレイ | はい | 一部対応 ¹ | いいえ | いいえ | いいえ |
| リプレイ時の決定論的なスパンタイミング | はい | いいえ | いいえ | いいえ | いいえ |
| 生のHTTPリクエスト/レスポンスのバイト列を記録 | はい | いいえ | いいえ | はい | いいえ |
| スパンレベルのトレース | はい | はい | はい | はい | はい |
| OTLPエクスポート(Jaeger、Grafana Tempo) | はい | いいえ | はい | いいえ | はい |
| オープンソースのコア | はい | いいえ | はい | いいえ | はい |
| ローカルのみで動作し、サーバー不要 | はい | いいえ | セルフホスト | いいえ | セルフホスト |
¹ LangSmithには、Python + LangChain専用のLANGSMITH_TEST_CACHE/VCRカセット(langsmith[vcr])があります。api.openai.comへのHTTP通信は記録しますが、任意のHTTPクライアントには対応せず、ワイヤーレベルのバイト列全体を記録せず、LangSmithアカウントが必要です。
LangSmithを選ぶ場合は、チームでLangChainを使用しており、データセット管理、プロンプトのバージョン管理、人によるフィードバックのループが必要な場合です。
Langfuseを選ぶ場合は、Postgresベースの強力なストレージを備えた、完全なオープンソースでセルフホスト可能なオブザーバビリティスタックが必要な場合です。
OpenLLMetryを選ぶ場合は、チームですでにOpenTelemetryを運用しており、新しいオブザーバビリティシステムを追加せずに標準のgen_ai.*スパンを使いたい場合です。
Agent Observabilityは、ダッシュボードや評価パイプラインの代替ではありません。特定の障害が発生した実行を、LLM APIのコストなしで再現するという、より根本的な課題を解決します。あらゆるPython HTTPクライアントで構築されたエージェントが対象です。
Dockerで試す
Agent ObservabilityはOTLPスパンを出力します。トレースツリーを確認するには、ローカルのオブザーバビリティスタックを実行してください。
git clone https://github.com/RudrenduPaul/agent-observability
cd agent-observability
docker compose up -d
3つのサービスが起動します(すべて任意です)。
- Jaeger(
http://localhost:16686):OTLPスパンの取り込みとトレースUI - Grafana(
http://localhost:3000):ダッシュボードとアラート - Tempo(ポート3200):長期トレースストレージのバックエンド
次に、エクスポーターの送信先をコレクターに設定します。
from agent_trace.exporters.otlp import OTLPExporter

# 4317 = OTLP gRPC ingestion endpoint
exporter = OTLPExporter(endpoint="http://localhost:4317")
exporter.export(trace)
記録/リプレイで捕捉できる実際の障害
- ステップ6で一時的なモデル出力が発生し、後続のツールが失敗します。再実行では再現できませんが、リプレイなら簡単に再現できます。
- ステップ3のレート制限レスポンスによって、サイレントなフォールバック経路が実行されます。これは記録されたフィクスチャのバイト列でのみ確認でき、ライブでの再実行では確認できません。
- HTTPディスパッチ前のツールスキーマのシリアライズエラーは、インターセプターに到達しないにもかかわらず、
LangGraphTracer.on_llm_errorで捕捉されます(「既知の制限事項」を参照)。 - 並列ブランチ内でツールの順序が非決定的になります。リプレイでは障害を引き起こした正確な順序が固定されるため、新たに実行した結果ではなく、実際の実行をデバッグできます。
- GeminiからのgRPCユニキャストストリームレスポンスは、特定のチャンク境界でのみ失敗します。ライブのストリーミング呼び出しを毎回再試行する代わりに、一度記録してバイト単位でリプレイできます。
既知の制限事項
Agent Observability のキャプチャモデルは、HTTP インターセプターをベースとし(src/agent_trace/integrations/ 配下の統合では、計測されたフレームワークコールバックも使用)、プロセス内で動作します。このモデルには実際に制限があり、問題に直面した後ではなく、事前に把握できるよう、ここで明示します。
-
プロセス内のみです。 記録と再生は、
agent_traceをインポートした Python プロセス内で行われます(httpx.Client(transport= RecordingTransport(...))、session.mount(..., RecordingAdapter(...))、またはReplayEngine.replay()のモンキーパッチ。src/agent_trace/interceptor/を参照)。自分で実行またはデプロイしていないサードパーティのホスト型サービス(例:ベンダー独自のホスト型チャットアシスタント)が行う呼び出しを監視または再生することはできません。監視できるのは、自分のプロセスからの送信呼び出しのみです。 -
gRPC の対応範囲は一部に限られます。
src/agent_trace/interceptor/grpc_hook.pyは、httpxを完全に迂回する Gemini/Vertex AI のトラフィックをキャプチャするため、grpc.secure_channel/grpc.insecure_channel(およびgrpc.aioの同等のもの)にパッチを適用します。単項-単項呼び出し(例:GenerateContent)と同期の単項-ストリーム呼び出し(例:StreamGenerateContent)は、完全に記録および再生されます。クライアントストリーミングと双方向ストリーミングの gRPC 呼び出し、およびgrpc.aioのすべてのストリーミング呼び出しはキャプチャされません。これらは記録中も、再生を試みた場合も、インターセプトされずにライブネットワークへ直接送信されます。 -
リクエストオブジェクトが作成された時点でキャプチャが始まります。
RecordingTransport. handle_request/AsyncRecordingTransport.handle_async_request(httpx_hook.py)とRecordingAdapter.send(requests_patch.py)が実行されるのは、完全に構築されたhttpx.Request/PreparedRequestがそれらに届いてからです。それより前に発生する例外、たとえば SDK がツールのスキーマをシリアライズしている間、ヘッダーを構築している間、その他の方法で呼び出しを組み立てている間に発生する例外や、さらに前の通常の Python オブジェクト構築中(例:抽象クラスを誤ってインスタンス化した際のabc.ABCMetaによるTypeError)に発生する例外は、インターセプターのキャプチャ範囲より上流で完結するため、フィクスチャの行は一切生成されません。ただし、組み込み済みのフレームワーク統合に独自のエラーコールバック(例:LangGraphTracer.on_llm_error)がある場合、例外がそのフレームワーク独自のtry/exceptを通じて伝播すれば、HTTP より前の例外も引き続きキャプチャされます。したがって、「インターセプターから見えない」ことは「どこからも見えない」ことと同じではありません。例外がフレームワーク統合を通過するよう組み込まれているかどうかによります。 -
フレームワーク独自の印字・表示コードは監視できません。 フレームワーク独自の
verbose=Trueログによってトリガーされる、ローカルのロギング/印字/表示機構(例:richの Console 出力や IPython/Jupyter の表示フック)内で発生する例外には、HTTP トラフィックもフレームワークコールバックの対象範囲もありません。既存または計画中のキャプチャ機構(HTTP インターセプター、MCP stdio トランスポートフック、フレームワーク統合のいずれも)は、この種の障害を監視しません。
セキュリティ
- サプライチェーン: リリースは GitHub Actions(
release.yml)を通じてビルドおよび公開されます。Sigstore OIDC 署名による SLSA Level 2 の来歴情報は正常に検証されることが確認されています(すべての配布アーティファクトについて、実際に生成された.sigstore.jsonバンドルがあります)。SBOM(CycloneDX JSON および XML)も生成され、署名済みアーティファクトとともに GitHub リリースに添付されます。 - 脆弱性スキャン:
dependabot.ymlにより、pip の週次更新と GitHub Actions の月次バージョン更新のプルリクエストが作成されます。このリポジトリでは、Dependabot のセキュリティアドバイザリーアラート、シークレットスキャン、シークレットスキャンのプッシュ保護がすべて有効になっています。 - フィクスチャの安全性:
~/.agent-trace/runs/内のフィクスチャファイルには、API キーやプロンプトの内容を含む、HTTP リクエストとレスポンスの本文全体が保存されます。.gitignoreに.agent-trace/と*.dbを追加してください。 - 脆弱性の報告: SECURITY.md — 脆弱性は
[email protected]に報告してください。48 時間以内に回答します。
警告
本番環境の API キーを使って生成したフィクスチャは、絶対にコミットしないでください。フィクスチャファイルにはリクエストとレスポンスの本文全体がそのまま保存されるため、コミットすると実際の API キーやプロンプトの内容が Git の履歴に漏れるおそれがあります。
既知の上流アドバイザリー
-
chromadb(オプションの[crewai]エクストラのみ): 認証前のコードインジェクション脆弱性に関する GHSA があり、chromadb 1.0.0 から現時点での最新リリース(1.5.9)までが影響を受けます。上流の修正(chroma-core/chroma PR #7237)は 2026-07-07 にマージされましたが、それ以降 PyPI ではリリースされていないため、現在、固定できる修正済みバージョンはありません。chromadbはオプションのcrewai統合エクストラ(pip install agent-observability-trace-cli[crewai])によってのみインストールされ、デフォルトではインストールされません。また、このプロジェクトが HTTP API を公開した Chroma サーバーを実行することもないため、実際の悪用経路(攻撃者がアクセスできる/api/v2/.../collectionsエンドポイント)は、このパッケージの通常の使用には当てはまりません。[crewai]エクストラをインストールし、別の場所で独自の Chroma サーバーを実行している場合は、上流のアドバイザリーを確認し、修正済みリリースが公開され次第chromadbを更新してください。今後のロードマップ: chromadb に修正を含むリリースが公開され次第、直ちに
chromadbをそのバージョンに固定します。次回の予定されているセキュリティレビューまでに修正がリリースされず、[crewai]エクストラの実際の利用がごくわずかな場合は、この問題を完全に解消するため、エクストラ自体を削除することを代替策として検討しています。
よくある質問
Agent Observability とは何ですか。また、一般的な LLM トレーシングツールとはどのように異なりますか?
これは Python ライブラリおよび CLI(agent-trace)で、エージェントが行うすべての HTTP リクエストとレスポンスをそのままローカルの SQLite フィクスチャに記録し、後からネットワーク呼び出しなしで同じ内容を再生します。LangSmith、Langfuse、Helicone、OpenLLMetry など、ほとんどのトレーシングツールは実行中に何が起きたかを表示します。Agent Observability ではさらに、稼働中の API に触れることなく、まったく同じ実行をオフラインで決定論的に再現できます。これら 4 つのツールとの機能比較の詳細は、上記の「LangSmith、Langfuse、Helicone ではだめなのですか?」をご覧ください。
決定論的な記録/再生は、実際にはどのように機能しますか?
記録時には、トランスポート層(src/agent_trace/interceptor/)で httpx.Client、httpx.AsyncClient、requests.Session にパッチを適用し、送信されるすべてのリクエストとレスポンスを生のバイト列として fixture.db に保存します。再生時には FixtureClock(src/agent_trace/core/clock.py)をインストールし、元の順序で同じバイト列を返すため、コードパス、スパンツリー、タイムスタンプがすべて元の記録と一致します。上記のベンチマーク値(記録時のオーバーヘッド 0.011%、再生の平均レイテンシー 0.93ms、忠実度 100%)は、このリポジトリの benchmarks/test_overhead.py、benchmarks/test_replay_vs_live.py、benchmarks/test_fidelity.py に基づいています。uv run pytest benchmarks/ を実行すれば、ご自身でも確認できます。
インストール方法と、対応しているプラットフォームを教えてください。
pip install agent-observability-trace-cli または uv add agent-observability-trace-cli でインストールできます。Python 3.10 以降が必要で、依存関係は httpx と rich のみです。コンパイル済み拡張機能は使わないため、これらのホイールが利用できる環境であればどこでもインストールできます。CI(.github/workflows/ci.yml)は、Python 3.10 から 3.13 までの各バージョンで、Ubuntu、macOS、Windows においてパスします。npx/npm を利用するチーム向けに、npm ラッパーの agent-observability-trace-cli(このリポジトリの npm/ にソースがあります)も公開していますが、内部では Python CLI を呼び出すため、Python パッケージもインストールする必要があります。
特に LangSmith と比べると、どう違いますか?
LangSmith の LANGSMITH_TEST_CACHE(langsmith[vcr] による VCR 形式のカセット)が、最も近い組み込み機能です。Python と LangChain でのみ利用でき、任意の HTTP クライアントではなく api.openai.com への HTTP 呼び出しをキャプチャします。また、ワイヤーレベルの完全なバイトデータは記録されず、LangSmith アカウントが必要です。Agent Observability は、あらゆる Python HTTP クライアントに加え、gRPC、aiohttp、botocore、WebSocket のトラフィック向けの専用インターセプターに対応しています。完全なリクエストとレスポンスのバイトデータをローカルに記録し、アカウントやホスト型サービスは不要です。すでに LangChain を利用しており、トレースに加えてデータセット管理、プロンプトのバージョン管理、ヒューマンフィードバックのループが必要であれば、LangSmith を選んでください。使用している SDK を問わず、特定の失敗した実行を API コストゼロで再現することが目的であれば、Agent Observability を選んでください。
リプレイで一致するフィクスチャエントリーが見つからない場合はどうなりますか?
AGENT_TRACE_NETWORK_GUARD=1 を設定すると、フィクスチャに存在しないリクエストは、実際の呼び出しへ暗黙にフォールバックせず、直ちに NetworkGuardError を発生させます。最もよくある原因は、記録またはリプレイのコンテキストに入る前に HTTP クライアントを作成していることです。パッチが適用されるのは、start_trace/replay ブロック内で作成されたクライアントだけだからです。部分的な gRPC ストリーミングの対応や、インターセプターに到達しない HTTP 前の例外など、制限事項の全項目については、上記の「既知の制限」を参照してください。
Python 以外のフレームワークで構築されたエージェントもキャプチャできますか?
いいえ。キャプチャ機能は、Python の HTTP トランスポートインターセプターと、src/agent_trace/integrations/ にあるインテグレーション(LangGraph、CrewAI、AutoGen、LlamaIndex、Haystack、Agno、PydanticAI、Google GenAI など)向けに計測されたコールバックで構成されています。対象となるのは、独自の Python プロセスからのトラフィックのみです。他の言語で構築されたエージェントや、自分で稼働させていないサードパーティのホスト型サービスによる呼び出しは、キャプチャの対象外です。
フィクスチャファイルをバージョン管理にコミットしても安全ですか?
デフォルトでは安全ではありません。fixture.db には HTTP リクエストとレスポンスの本文がすべて含まれるため、ヘッダーやペイロードに現れた API キーやプロンプトの内容も含まれます。.agent-trace/ と *.db を .gitignore に追加し、本番環境の API キーで記録したフィクスチャは決してコミットしないでください。フィクスチャをコミット済みの CI テスト用アセットとして保持したい場合は、先にシークレットを削除またはマスキングしてください。
商用利用は無料ですか?
はい。このプロジェクトは Apache 2.0 ライセンス(LICENSE を参照)で公開されており、ライセンスに定められた帰属表示と通知の条件に従うことで、クローズドソース製品内での利用を含め、商用利用、改変、再配布が認められています。別途有料のプランや商用ライセンスはありません。
コントリビューション
- PR を開く前に CONTRIBUTING.md をお読みください
- 初心者に適した課題には、GitHub Issues でラベルが付いています
- リプレイエンジン(
src/agent_trace/_replay/)には、80%のテストカバレッジが必要です(正確性が重要なため) - インターセプター(
src/agent_trace/interceptor/)には、80%のテストカバレッジが必要です - 設計に関する質問やアイデアには GitHub Discussions をご利用ください
Apache 2.0。コントリビューションを歓迎します。
Rudrendu Paul と Sourav Nandy によって開発されました
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。