
memtrust について
memtrustは、Agentのメモリバックエンドを評価する開発者や研究者向けの独立したベンチマークツールです。共通の評価を複数のバックエンドで実行し、生ログとJSONレポートを出力します。Agentから実行できるMCPサーバーも含みます。
主な機能
- 01複数のメモリバックエンドを共通評価
- 02矛盾検出と圧縮後の忠実度をテスト
- 03JSONレポートと要約を生成
- 04ベンチマークのレシートを署名・検証
- 05MCPツールからベンチマークを実行
活用シーン
- 01メモリバックエンド間の評価結果を比較
- 02事実の矛盾への対応を確認
- 03圧縮後の再構成忠実度を測定
- 04エージェントからテストを実行してレポートを取得
MCP 対応
付属のMCPサーバーは単一の`run`ツールを公開し、`memtrust run`を実行して解析済みJSONレポートを返します。stdioを使い、MCPクライアントがローカルのサブプロセスとして起動します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
memtrust




エージェントのメモリバックエンドはそれぞれ、異なるテストを異なる方法で測定したベンチマーク値を公開しています。memtrust は4つすべてに同じ評価を実行し、生のログを公開します。ベンダー自身が実施した評価ではなく、ベンダーを対象に実行します。
pip install memtrust-cli
memtrust run --backends mempalace,mem0,zep,openviking --eval all
(実行するだけでなく、このリポジトリへの貢献に関心がある場合は、開発を参照してください。クローンから pip install -e ".[dev]" を実行します。)
目次: これが存在する理由 · できること · コマンド · ベンダー独自の数値を信頼する場合との違い · 矛盾の検出 · 圧縮の忠実度 · 時間的 KG の境界 · 全体像 · ベンチマーク · GitHub Actions の使用方法 · セルフホスト · インストール · ホスト型レイヤー · バックエンドの対応状況 · 開発 · FAQ · ライセンス · 成功事例
これが存在する理由
最近、エージェントメモリのバックエンドを比較したことがあれば、それぞれが異なるベンチマークで異なる方法により測定された、異なる精度の数値を最初に掲げていることに気づいたでしょう。MemPalace のコミュニティ自身も、この問題を公に指摘しています。MemPalace リポジトリの Issue #27 は、2026 年 4 月 7 日に作成され、現在も未解決です。Haiku によるリランキングで測定した、目玉となる LongMemEval 100% という数値が、リポジトリ独自のベンチマークスクリプトでは再現できず、検証不能として README から削除されたことが記録されています。あちこちで引用されている別の 96.6% という数値は、実際には生のモードで ChromaDB のデフォルト埋め込みが大部分を担っており、MemPalace 独自のアーキテクチャによるものではありません。「ロスレス」圧縮の主張(「AAAK」モード)も、実際には同じ LongMemEval のスコアを 96.6% から 84.2% に下げており、12.4 ポイントの差があります。この報告の問題を修正しようとした内部のプルリクエスト 2 件、#433 と #729 は、どちらも 2026 年 4 月 12 日にマージされないままクローズされました。#729 は作成から 7 分以内にクローズされました。この記事の執筆時点で、この Issue には 232 件の高評価リアクションと 39 件のコメントがあります。
これは、MemPalace やその他のバックエンドが機能しないという意味ではありません。ベンダー以外の誰も、すべての選択肢に対して同じテストを同じ方法で実行し、生のログを公開していなかったということです。
memtrust はそれを行います。LongMemEval、LoCoMo、およびこのプロジェクト専用に作られた拡大中の評価群を実行します。この記事の執筆時点で、その数は 17 件で、すべて CLI の --eval フラグに登録されています。このプロジェクトの実際の目的を理解するうえで、特に重要なのは次の 2 つです。
矛盾検出です。LongMemEval も LoCoMo も、本番環境のエージェントの下でメモリシステムが稼働しているときに本当に重要となる問い、つまり新しい事実が古い事実と矛盾したらどうなるのかをテストしていません。バックエンドは矛盾にフラグを立てるのでしょうか。監査証跡も残さず、古い事実をひそかに上書きするのでしょうか。たまたま最初に取得したほうのバージョンを返すのでしょうか。このプロジェクトが追跡している 4 つのバックエンドは、どれもこの点の数値を公開していません。もう 1 つは、圧縮/ラウンドトリップの忠実度です。これは、上記の「ロスレス」のような主張を直接検証するために作られています。コンテンツを保存して取得し、意味的な精度ではなく、文字どおりの再構成忠実度をスコア化します。評価はバックエンドが公開する運用モードごとに行います(MemoryBackendAdapter.supported_modes を参照)。この仕組みにより、MemPalace の有効な認証情報を持つ貢献者は、mem pal ace/mempalace#27 に記録された圧縮モードでの 12.4 ポイントの精度低下を、単に引用するのではなく、実際に再現できます。この記事の執筆時点では、どちらも実際の MemPalace インスタンスに対して実行されていません。ただし、どちらもセルフホストされた mem0ai のインストールに対しては実行済みです。下記の「ベンチマーク」を参照してください。その他の評価項目――ランキング品質、クラッシュ復旧、抽出品質、埋め込みのドリフト、規模/ボリュームの負荷テスト、ロック競合、統計の精度、孤立データのクリーンアップ、結果の一貫性、移行のロールバック、フィルターインジェクション、リソース同期の安全性、時間的 KG 境界の検出――は、それぞれ追跡対象の 4 つのバックエンドに対する実際のバグ報告をきっかけに生まれました。全件の一覧は、下記の「成功事例」を参照してください。
現時点の状況をまとめると、次のとおりです。 1 つのバックエンド(セルフホストされた mem0ai)のライブベンチマーク結果。これには、このプロジェクトが数値を得ようとした際に見つかった、mem0 のデフォルト設定に実在するバグも含まれています。また、MemPalace、Mem0、Zep/Graphiti、OpenViking に対して個別に報告された 197 件の実際の GitHub Issue とプルリクエストを、このコードベースで根本原因まで特定しました。その内訳は、PASS が 55 件(28%)、PARTIAL が 16 件(8%)、実際の機能不足が 42 件(21%)、該当なしが 84 件(43%)です。すべての判定は、修正を作成した担当者とは別のレビュー担当者が再検証しています。
できること
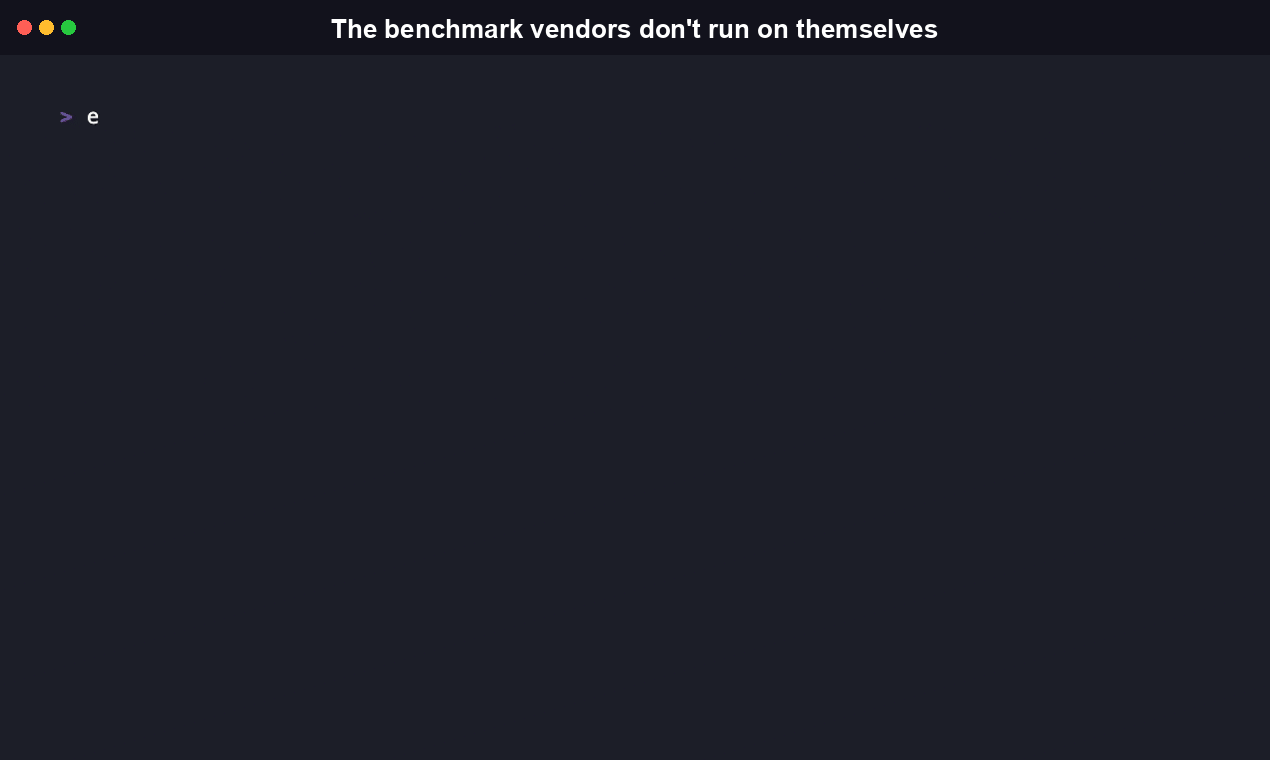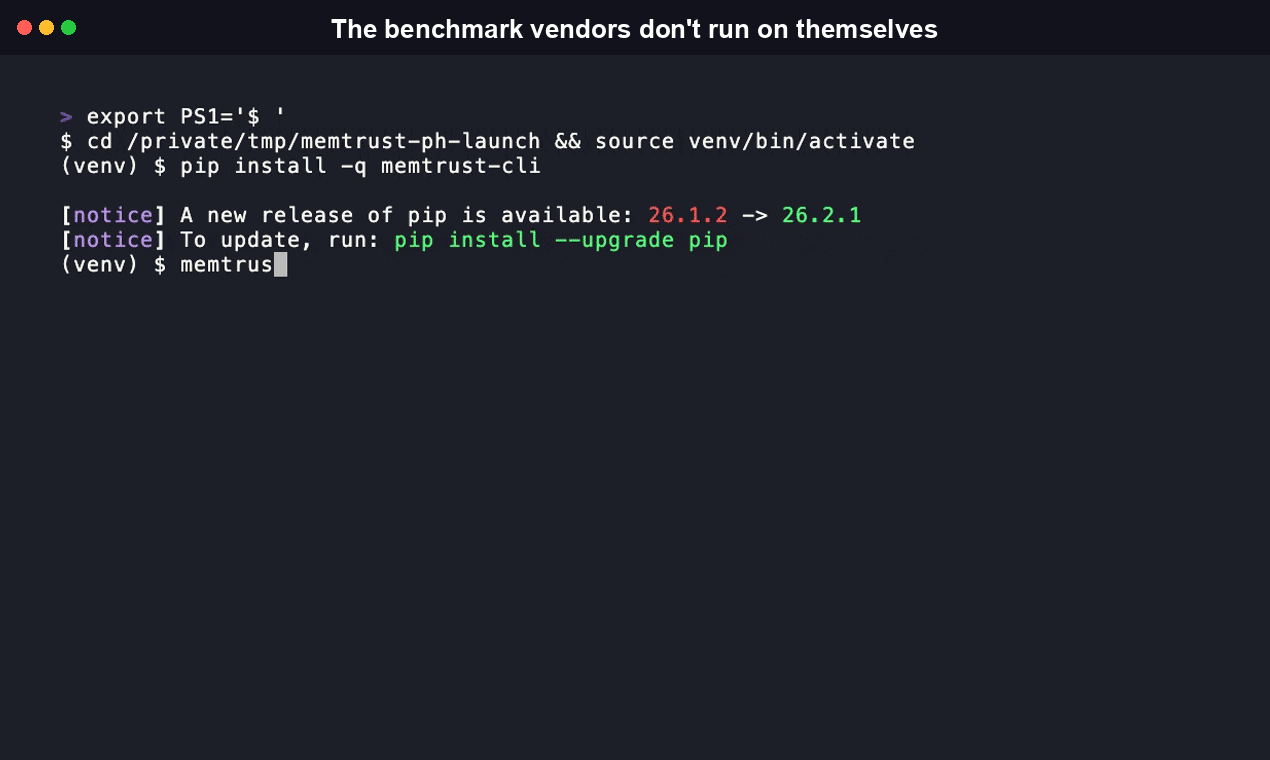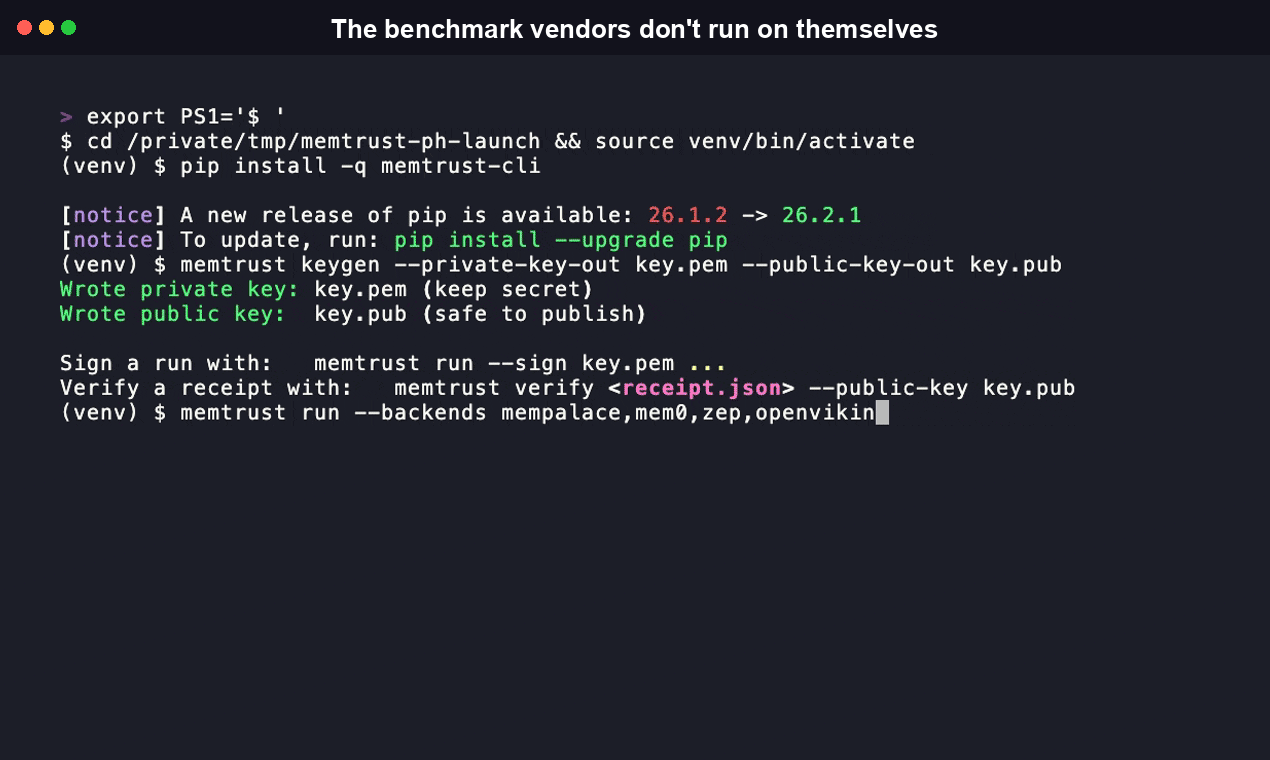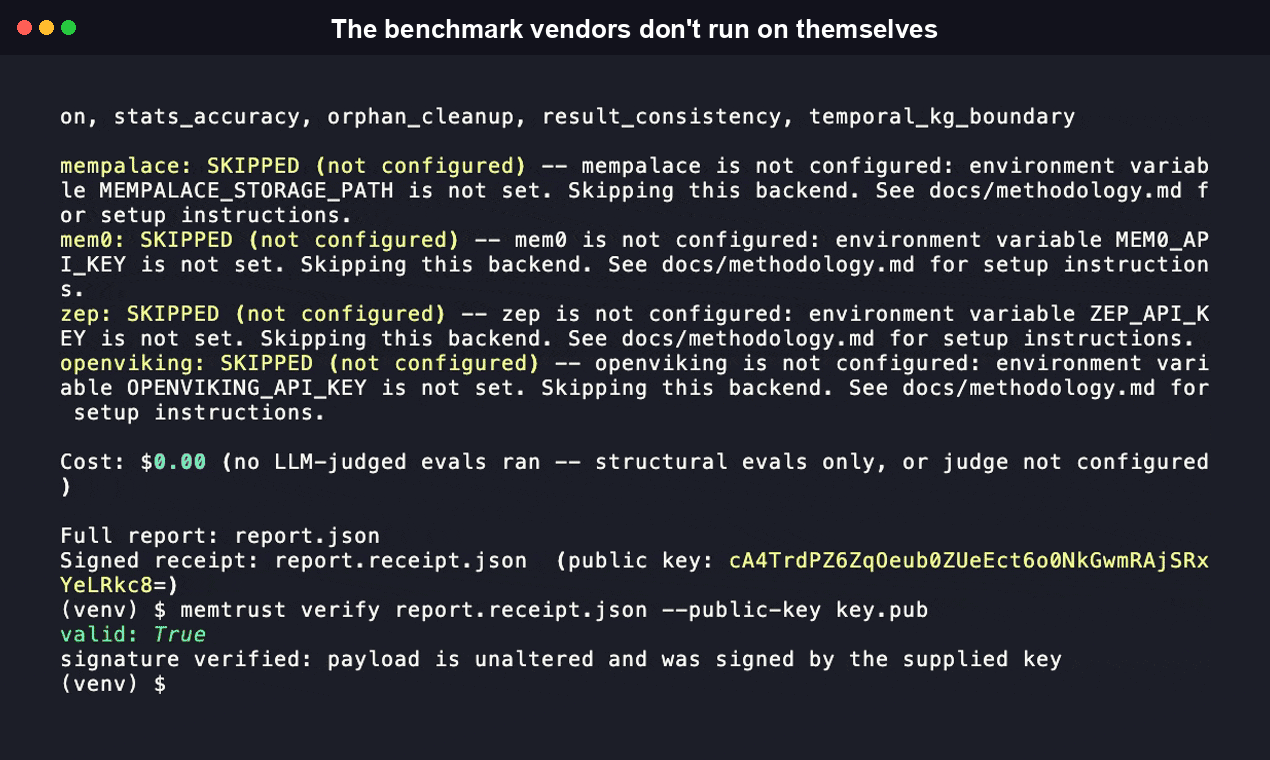
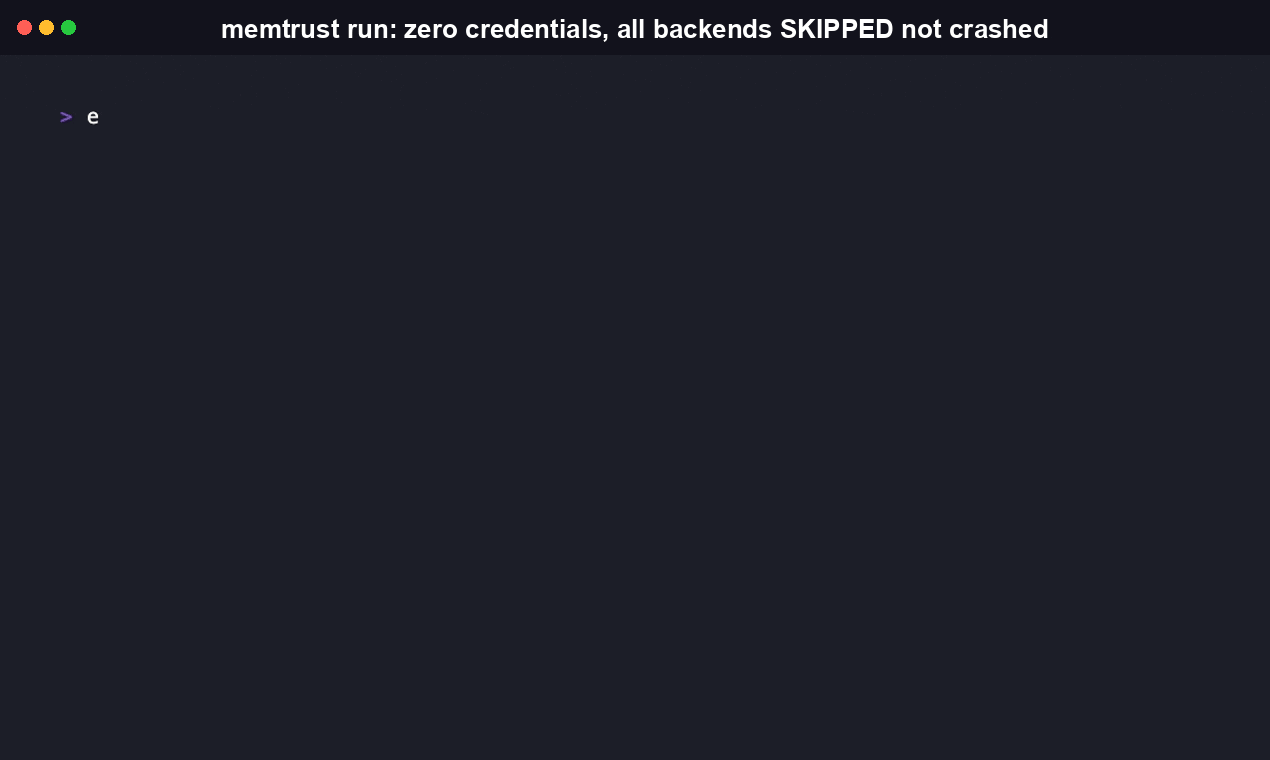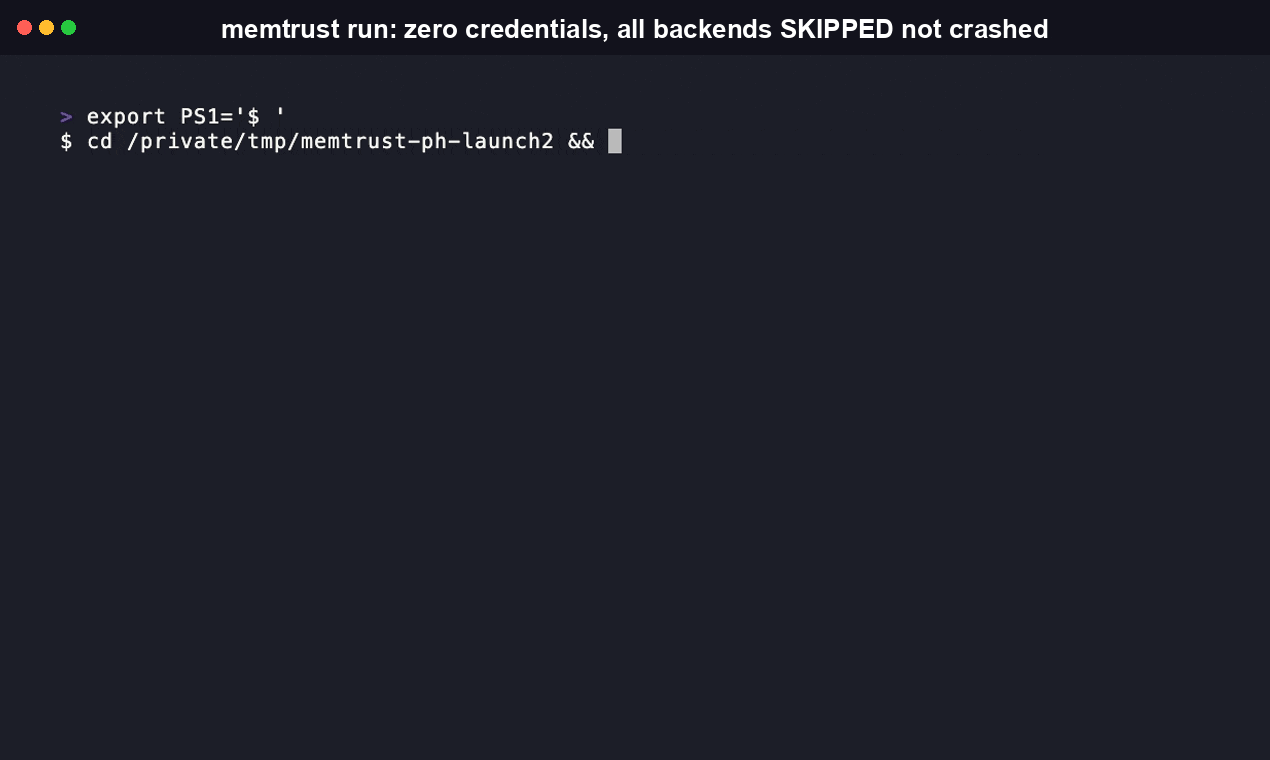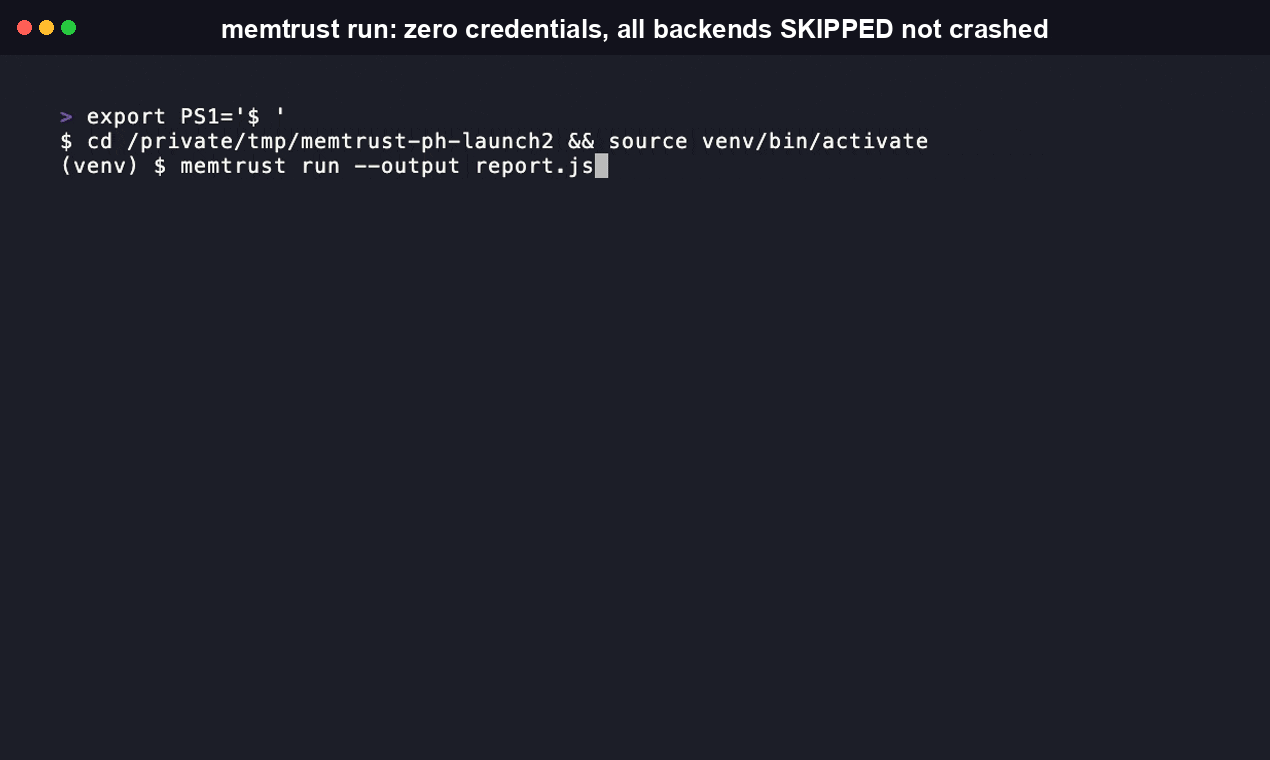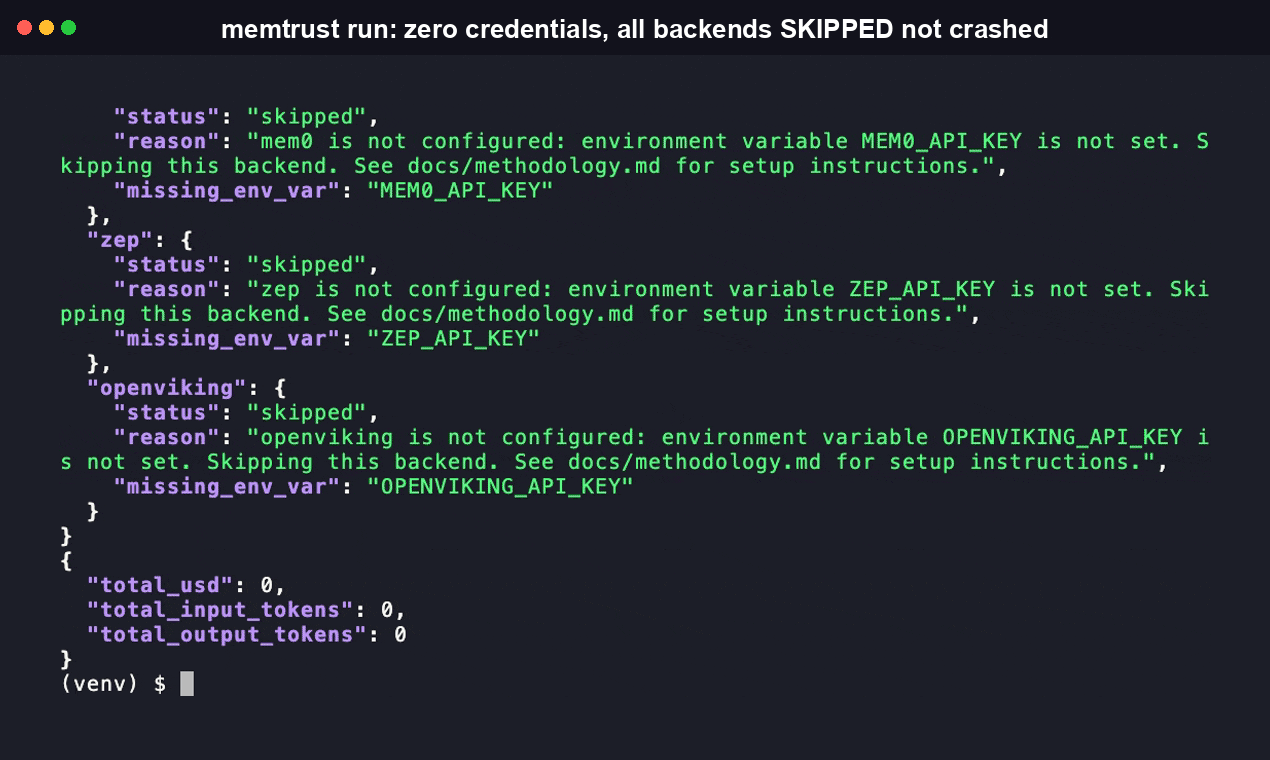
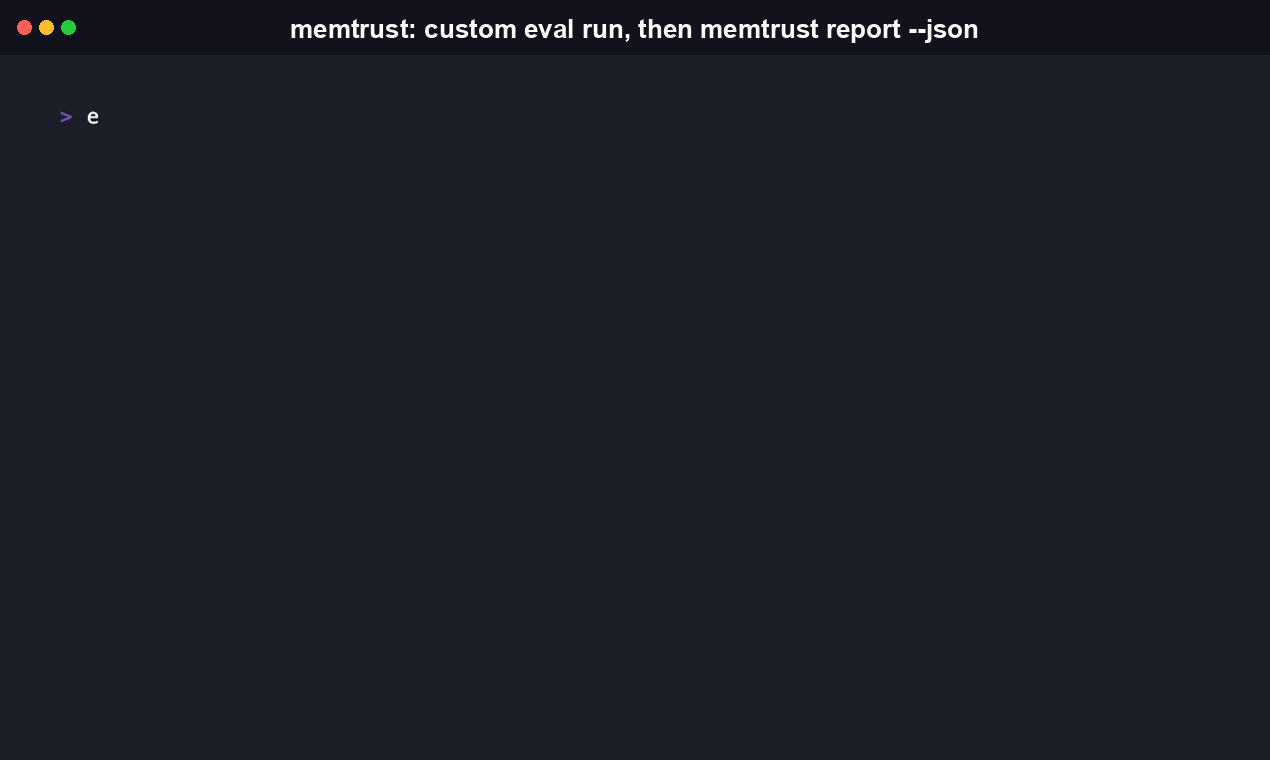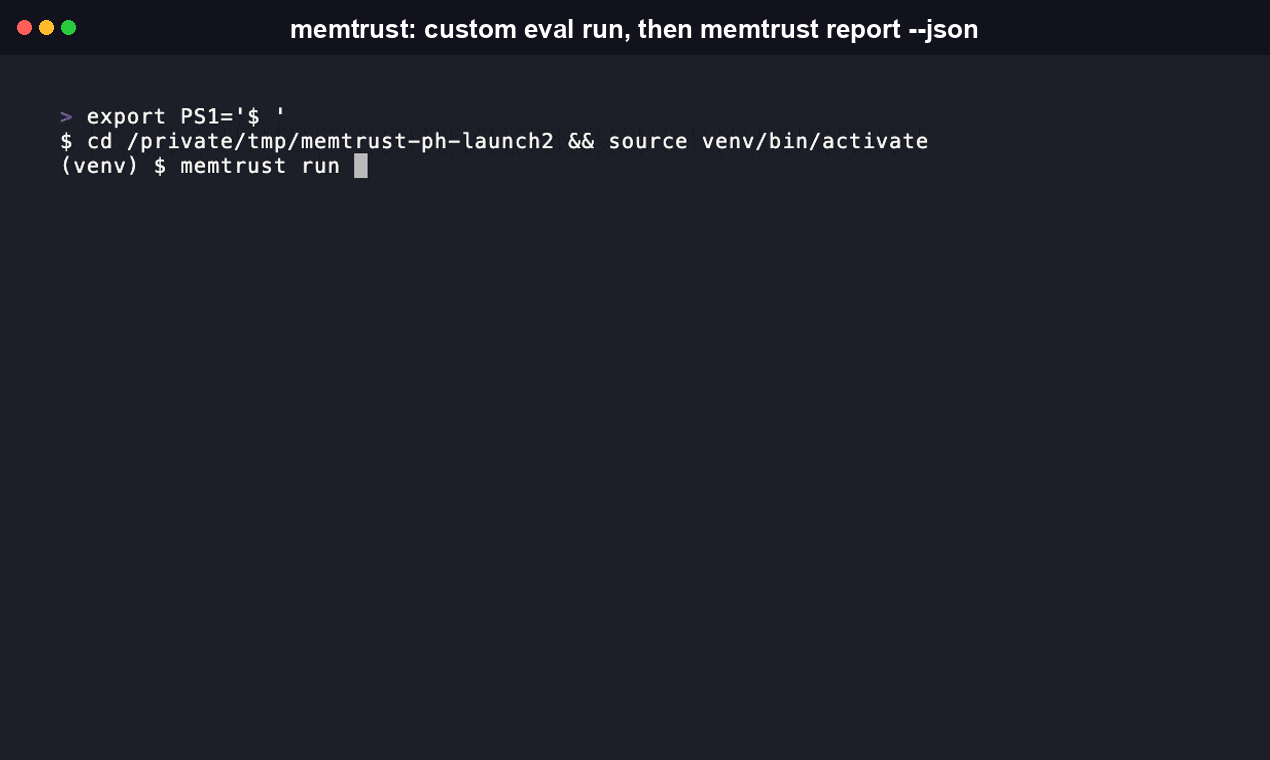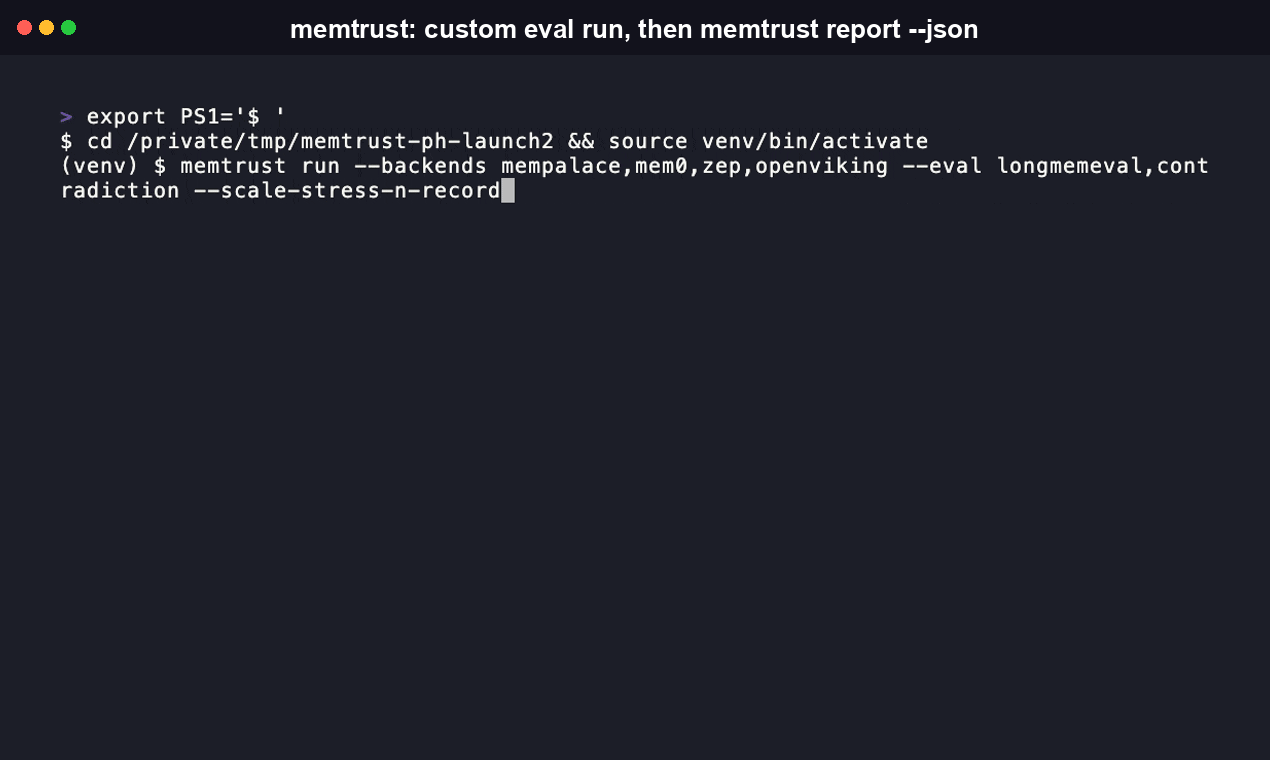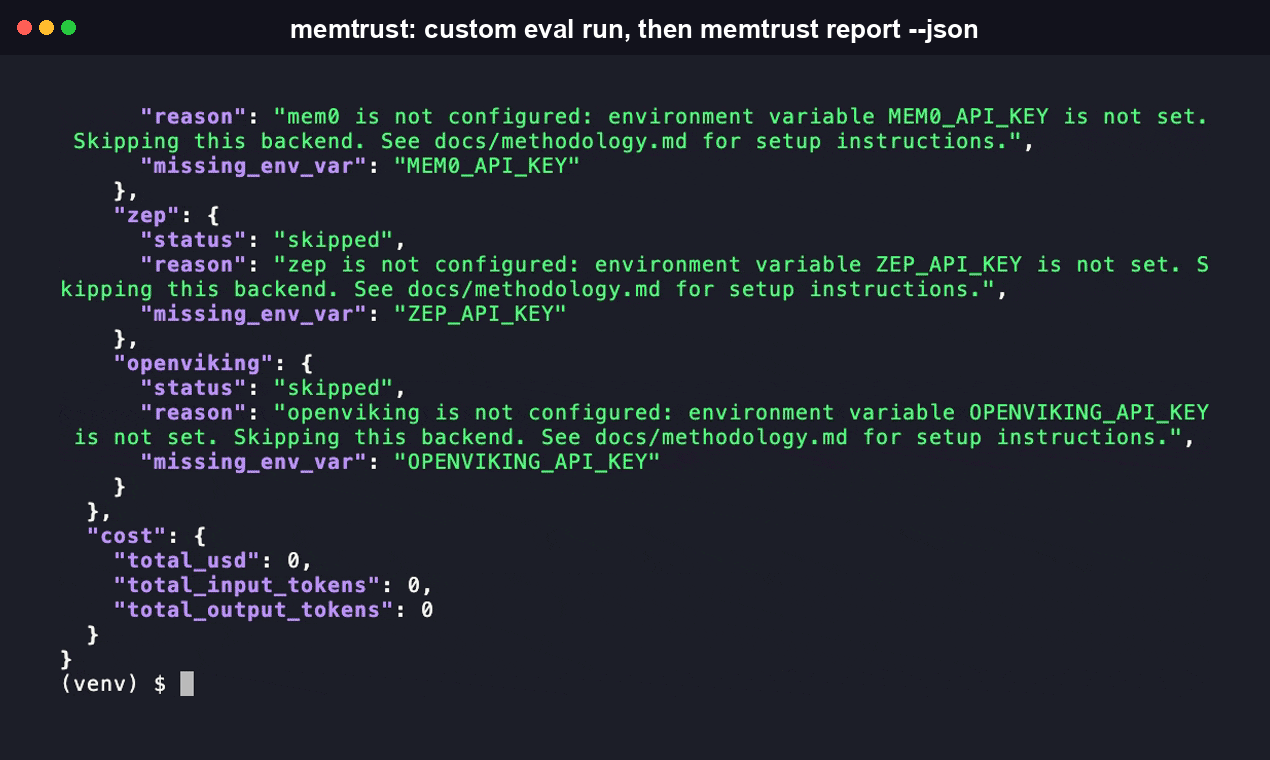
以下のすべてのコマンドは、ベンダー API キーを一切設定せずに、このリポジトリに対して実際に実行し、表示されている出力を生成しました。ここにシミュレーションはありません。
$ memtrust run --backends mempalace,mem0,zep,openviking --eval all
memtrust 0.3.4 -- run_id=mt_2026-08-04T061759Z
Backends: mempalace, mem0, zep, openviking   Evals: longmemeval, locomo, contradiction,
resource_sync_safety, compression, ranking_quality, scale_stress, embedding_drift, crash_recovery,
extraction_quality, migration_rollback, filter_injection, lock_contention, stats_accuracy,
orphan_cleanup, result_consistency, temporal_kg_boundary

mempalace: SKIPPED (not configured) -- mempalace is not configured: environment variable
MEMPALACE_STORAGE_PATH is not set. Skipping this backend. See docs/methodology.md for setup
instructions.
mem0: SKIPPED (not configured) -- mem0 is not configured: environment variable MEM0_API_KEY is not
set. Skipping this backend. See docs/methodology.md for setup instructions.
zep: SKIPPED (not configured) -- zep is not configured: environment variable ZEP_API_KEY is not set.
Skipping this backend. See docs/methodology.md for setup instructions.
openviking: SKIPPED (not configured) -- openviking is not configured: environment variable
OPENVIKING_API_KEY is not set. Skipping this backend. See docs/methodology.md for setup
instructions.

Cost: $0.00 (no LLM-judged evals ran -- structural evals only, or judge not configured)

Full report: memtrust-report-2026-08-03.json
これは、認証情報のない新規クローンでの、再現可能な実際の動作です。すべてのバックエンドが SKIPPED を報告し、コマンドは正常に終了し、有効な JSON レポートが書き込まれます。memtrust --version は、現在はインストール済みのバージョンを正しく出力し、pip show memtrust-cli の結果と一致します。以前のリリースでは、正しくインストールされていても 0.0.0+unknown と出力されていました。これは、実際のインストール済みディストリビューション名が memtrust-cli であるのに、src/memtrust/__init__.py が importlib.metadata.version("memtrust") を読み込んでいたためです。修正された瞬間にバグを黙って消し去ることは、このプロジェクトが他の人のベンチマークに対してまさに異議を唱えようとしている種類の編集だからこそ、削除せず、記録として以下の FAQ に残しています。実際にテストしたいバックエンドに対応する環境変数(MEM0_API_KEY、ZEP_API_KEY、OPENVIKING_API_KEY、MEMPALACE_STORAGE_PATH)を設定すると、そのバックエンドはスキップされず、実際の稼働中の API に対して実行されます。
評価ロジック自体は、同梱の合成フィクスチャに対するオフラインテストと、複数のアダプターについてはネットワーク境界のみをモックした、実際にインストールされたベンダーパッケージに対するテストによって、テストスイートで検証されています。
$ pytest --cov=memtrust --cov-report=term-missing
... (33 module rows total; the 11 most relevant to this README are shown below)
Name                                                          Stmts   Miss  Cover
-------------------------------------------------------------------------------------
src/memtrust/adapters/base.py                                   290      1    99%
src/memtrust/adapters/mempalace_adapter.py                      265     15    94%
src/memtrust/adapters/mem0_adapter.py                            140     12    91%
src/memtrust/adapters/mem0_direct_adapter.py                     281     34    88%
src/memtrust/adapters/openviking_adapter.py                      178     18    90%
src/memtrust/adapters/zep_graphiti_adapter.py                     63      3    95%
src/memtrust/adapters/zep_graphiti_selfhosted_adapter.py         165     24    85%
src/memtrust/evals/contradiction.py                              127      2    98%
src/memtrust/evals/compression.py                                 86      1    99%
src/memtrust/evals/temporal_kg_boundary.py                        90      3    97%
src/memtrust/receipt.py                                          118     10    92%
-------------------------------------------------------------------------------------
TOTAL                                                            4167    265    94%

590 passed, 8 skipped in 5.92s
これは抜粋であり、表全体ではありません。リポジトリ内で最もカバレッジが低いモジュールである evals/mempalace_metadata_scale.py(70%)は、上記の11件には含まれていません。モジュールごとの内訳全体を確認するには、ご自身でコマンドを実行してください。
33個のソースモジュール全体で590件のテストが成功し、ステートメントカバレッジは全体で94%、矛盾検出評価では98%、圧縮/ラウンドトリップ忠実度では99%、時間的 KG 境界評価では97%、アダプターレイヤーでは85~99%です。スキップされた8件は、オプションの mempalace-direct エクストラがインストールされている場合にのみ実行される、実際の mempalace パッケージに対するテストです(pip install -e '.[dev,mempalace-direct]')。すべてのテストでは HTTP またはワイヤーレイヤーをモックするか、インメモリのフェイクバックエンドを使用しており、実ネットワークには一切接続しません。ただし、アダプターテストのかなりの割合で、実際にインストールされたベンダークラスを直接インポートして実行しています(mem0ai==2.0.12 の埋め込みモデルおよびベクトルストアのモジュール、またオプションの mempalace-direct エクストラが有効な場合は、実際の mempalace.mcp_server 関数)。ライブラリ全体ではなく、ネットワークまたはワイヤークライアントの最外部境界のみをモックしています。この環境には graphiti-core がインストールされていないため、セルフホスト可能なアダプターのテストは、実際のクラスではなく、実際のパッケージで確認されたメソッドシグネチャに合わせて手書きした Protocol ダブルを使用して実行されます。どの主張がどの種類の検証に基づいているかは、docs/methodology.md のアダプター信頼度表をご覧ください。
コマンド
$ memtrust --help
Usage: memtrust [OPTIONS] COMMAND [ARGS]...

  memtrust: an independent, reproducible benchmark harness for agent-memory
  backends.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  keygen  Generate a new Ed25519 keypair for signing `memtrust run`...
  report  Read a prior `memtrust run` JSON report and print a formatted...
  run     Run the eval suite against the requested backends.
  verify  Verify a signed receipt produced by `memtrust run --sign`.
| コマンド | フラグ | 動作 |
|---|---|---|
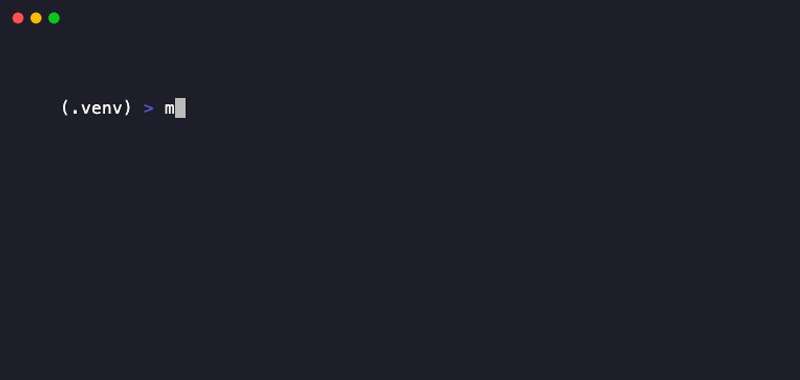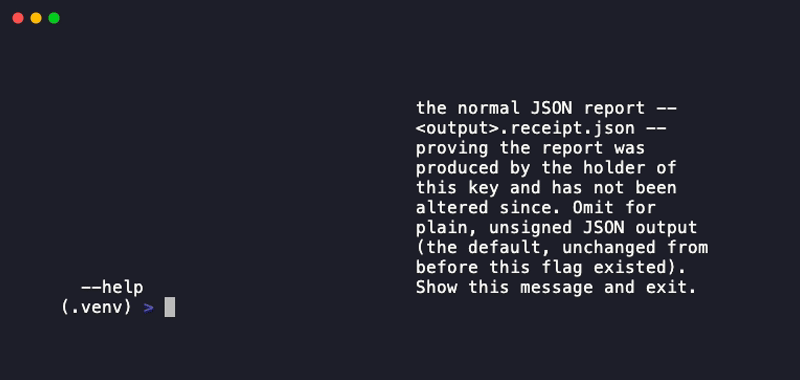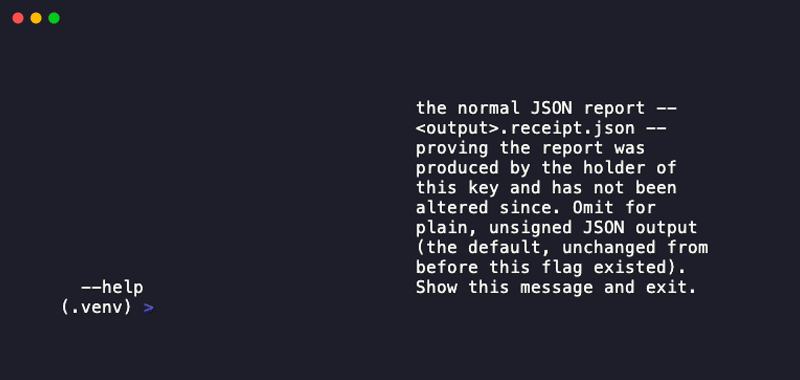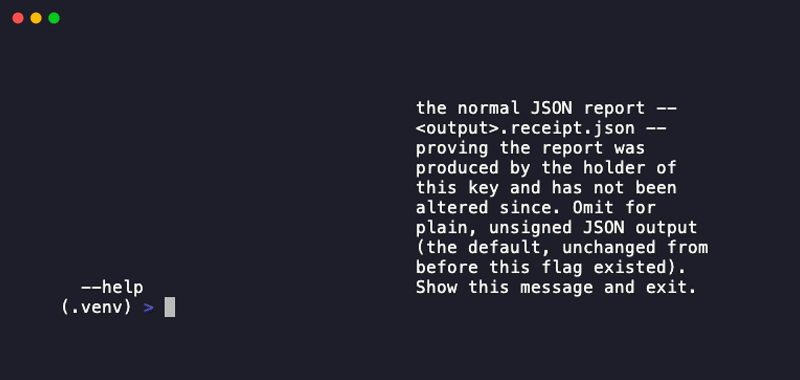
memtrust run | --backends TEXT カンマ区切りのリスト、または all(デフォルトは all) · --eval TEXT longmemeval,locomo,contradiction,resource_sync_safety,compression,ranking_quality,scale_stress,embedding_drift,crash_recovery,extraction_quality,migration_rollback,filter_injection,lock_contention,stats_accuracy,orphan_cleanup,result_consistency,temporal_kg_boundary からカンマ区切りで指定、または all(デフォルトは all) · --output FILE(デフォルトは ./memtrust-report-<date>.json) · --locomo-dataset-path FILE は、バンドルされた合成フィクスチャの代わりに、実際にダウンロードした locomo10.json を LoCoMo 評価に使用します(memtrust は実際のデータセットをバンドルも自動取得もしません) · --locomo-exclude-question-ids-file FILE は、正解ラベルに問題があることが分かっている LoCoMo の質問 ID をスコアリングから除外します · --scale-stress-n-records INTEGER(デフォルトは 500)は、スケール負荷評価で保存して再クエリする合成レコードの件数を設定します · --sign FILE は、レポートと同じ場所に署名付きの <output>.receipt.json を書き込み、指定された Ed25519 秘密鍵の所有者がレポートを生成したことを証明します | 指定されたバックエンドに対して評価スイートを実行します。認証情報の環境変数が設定されていないバックエンドは SKIPPED と表示され、実行は続行されます。このコマンドは認証情報の不足でクラッシュすることはありません。temporal_kg_boundary は mempalace バックエンド(kg_add/kg_invalidate/kg_query を接続する唯一のアダプター)にのみ適用されます。他のバックエンドに対して指定すると、エラーではなく not_applicable が報告されます。 |
memtrust report REPORT_PATH | 以前の JSON レポートへの位置引数パス · --json は、書式付きの要約ではなく、解析したレポートを JSON として出力します | memtrust run が書き込んだレポートを読み込み、書式付きの要約を出力します。 |
memtrust keygen | --private-key-out FILE(デフォルトは memtrust-key.pem) · --public-key-out FILE(デフォルトは memtrust-key.pub) · --force は既存の出力ファイルを上書きします | run --sign でレポートに署名するための新しい Ed25519 鍵ペアを生成します。 |
memtrust verify RECEIPT_PATH | --public-key FILE(または MEMTRUST_RECEIPT_PUBLIC_KEY 環境変数) · --json は結果を JSON として出力します | memtrust run --sign が生成した署名付きレシートを検証します。改ざんされたレシートや一致しないレシートは検証に失敗します。 |
memtrust --version | -- | インストールされているバージョンを出力します。 |
上記の各行は、このリポジトリで memtrust --help、memtrust run --help、
memtrust report --help、memtrust keygen --help、memtrust verify --help を実行して得られた内容です。
ここに記載されている内容に創作はありません。
MCP サーバー
memtrust には Model Context Protocol サーバーが付属しており、AI エージェント (Claude、Cursor、または MCP 互換クライアント)が、人手で CLI を実行することなく、 メモリバックエンドのベンチマークを直接実行できます。
追加パッケージをインストールします。
pip install "memtrust-cli[mcp]"
MCP クライアントの設定に追加します(Claude Desktop の場合は claude_desktop_config.json)。
{
  "mcpServers": {
    "memtrust": {
      "command": "uvx",
      "args": ["--from", "memtrust-cli", "memtrust-mcp"]
    }
  }
}
このサーバーは run という 1 つのツールを公開します。このツールは指定された引数で
memtrust run をシェルから実行し(memtrust には --json フラグがないため、ラッパーは
非公開の一時 --output ファイルに書き込み、その内容を読み戻します)、解析済みの JSON レポートを返します。
run(["--backends", "mempalace", "--eval", "stats_accuracy"])
トランスポートは stdio なので、ホストするものはありません。MCP クライアントがサーバーをローカルの
サブプロセスとして起動します。ソース:src/memtrust/mcp_server.py。
ベンダー独自の数値を信頼する場合との違い
memtrust が追跡する各バックエンドは、それぞれ独自のベンチマーク数値を公開しています。しかし、同じベンチマークを同じ方法で採点し、同じ厳密さでホールドアウトデータを扱っているものはありません。memtrust は、代わりに自分を信頼するよう求めるのではなく、生のログを読むよう求めます。各実行の手法、プロンプトテンプレート、データセットのバージョン、採点基準はすべて docs/methodology.md で公開され、生成に使用したコードとともにバージョン管理されています。手法に問題があれば、ベンダー内部の評価パイプラインに埋もれたものではなく、具体的なファイルと行を示して指摘できます。
汎用の LLM 評価フレームワーク(promptfoo、DeepEval、RAGAS など)は成熟しており広く使われていますが、メモリバックエンド用のアダプター抽象化や、矛盾検出の評価機能を標準で備えているものはありません。これらは RAG の品質、レッドチームテスト、汎用的なプロンプト評価向けに作られており、時間とともに変わる事実を異なるメモリシステムがどのように扱うかを比較するためのものではありません。memtrust は意図的に対象を絞り、より具体的に設計されています。
エコシステム(ベンチマークではなく、確認済みの情報)
本稿執筆時点で実際に公開され、確認できる数値(gh api repos/<org>/<repo>)であり、memtrust による実行スコアではありません。正確性と矛盾への対応に関する比較は、実行によって実際に結果が得られるまで、以下の「ベンチマーク」セクションに記載します。
| バックエンド | GitHub のスター数 | 自己申告による説明 |
|---|---|---|
| MemPalace | 58,032 | "最も多くのベンチマークを実施したオープンソースの AI メモリシステム。しかも無料です。" |
| Mem0 | 62,450 | "AI エージェント向けのユニバーサルメモリレイヤー" |
| Zep / Graphiti | 29,526 | "AI エージェント向けのリアルタイムナレッジグラフを構築" |
| OpenViking | 27,859 | "AI エージェント向けの自己進化型コンテキストデータベース。エージェントのメモリ、ナレッジ RAG、スキルを統合します。" |
これらの数値からは、矛盾する事実をどのバックエンドが正しく処理するかは分かりません。それこそが、ハーネスを開発した理由です。スター数が示すのは採用状況であり、正確性ではありません。
本当に重要な評価:矛盾の検出
LongMemEval と LoCoMo はどちらも想起を測定します。つまり、バックエンドが以前に伝えた事実を記憶できるかどうかです。それは必要ですが、十分ではありません。さらに難しいのは、2つの事実が矛盾するときにバックエンドがどう対応するかという問題です。会議が午後2時だと伝えたあと、午後3時に変更になったと伝えた場合、変更を検出するのでしょうか。黙って上書きするのでしょうか。それとも、先に取得したほうを返すのでしょうか。memtrust の分類器は、ある事実を保存し、それと矛盾する事実を保存してから問い合わせを行い、アダプター自体が報告する矛盾シグナルを信頼するのではなく、実際に取得された内容に両方の値が含まれているかを確認します。この分類の仕組みの詳細については、src/memtrust/evals/contradiction.py と docs/methodology.md の採点ロジックのセクションを参照してください。
もう一つの誇大な見出し――圧縮の忠実度を検証する評価
mempalace/mempalace#27 には、別々の誇大な主張が一つではなく二つ記録されています。上記で説明した LongMemEval のスコア差と、「ロスレス」という圧縮の主張です。後者は、圧縮モードで動作させた実環境では 12.4 パーセントポイント低い値を示しました。これまで memtrust では、この二つ目の数値を再現できませんでした。共有インターフェースを通じて、アダプターに「モード X とモード Y で実行する」と指定する方法がなかったためです。MemoryBackendAdapter.store()/query() は、オプションの mode: str | None パラメーターを受け取るようになりました。また、MemoryBackendAdapter.supported_modes を使うと、アダプターが実際に認識するモード文字列を宣言できます(MemPalaceAdapter.supported_modes は ("raw", "AAAK") で、mempalace/mempalace#27 自身が使用している二つの名前です。これらの名前の正確な由来と信頼性に関する注意事項については、src/memtrust/adapters/mempalace_adapter.py を参照してください)。モードにバリエーションのないアダプターは、このパラメーターを受け取って無視するため、これは後方互換性を保った純粋な追加変更です。
src/memtrust/evals/compression.py は、バックエンドが報告する各モードで、保存してから取得する一連の処理を実行し、それぞれの処理を直接的かつ決定論的な文字単位の類似度比率(difflib.SequenceMatcher を介した fidelity_ratio())で評価します。これは LLM による判定ではありません。「ロスレス」という主張は、意味的な同等性ではなく、文字どおりの再構成に関する主張だからです。これにより、実際の MemPalace 認証情報を持つコントリビューターが memtrust run --eval compression を指定して実行し、「raw と AAAK」の忠実度の差を直接再現できるようになります。本稿執筆時点では、この評価は実際に稼働している MemPalace インスタンスに対して実行されていません。実際に稼働しているセルフホスト版 mem0ai のインストールに対しては実行済みです(平均忠実度は 31.6%。「ベンチマーク」を参照してください)。まだ実環境で測定していない他のすべての評価とバックエンドにも当てはまる、実際の認証情報に関する同様の注意事項については、docs/methodology.md を参照してください。
MemPalace 自身のバグから作成した評価:時間的 KG の境界検出
MemPalace/mempalace#1913(コントリビューター ggettert によるマージ済み PR#1914 で修正)では、実際に発生した具体的なバグが報告されました。_temporal_filter_sql の as_of 時点クエリでは両端を含む閉区間が使われていたため、valid_to がクエリの as_of と完全に同じ時刻の事実も一致していました。kg_invalidate(ended=T) の直後に、まったく同じ境界時刻で kg_add(valid_from=T) を実行して事実の変更を手作業で行います。これは、MemPalace の修正前のエージェント向けガイダンスがすべての呼び出し元に指示していたパターンそのものです。このとき as_of=T のクエリは、終了したばかりの事実と開始したばかりの後継の事実の両方を同時に返すため、単一の値を持つ事実に対して、エラーも出さずに矛盾する答えを2つ報告します。src/memtrust/evals/temporal_kg_boundary.py は、MemPalaceAdapter の kg_add()/kg_invalidate()/kg_query() に対して、この手作業による一連の操作をそのまま再現し、新しい TemporalBoundarySignal 分類体系を使って結果を分類します。これは、時間をまたぐ矛盾や順位付けの順序に関する問題ではなく、1つの時刻を共有する2つの事実という、範囲が狭く構造も異なる単一の障害を扱うため、ConflictSignal および RankingSignal とは別の分類です。
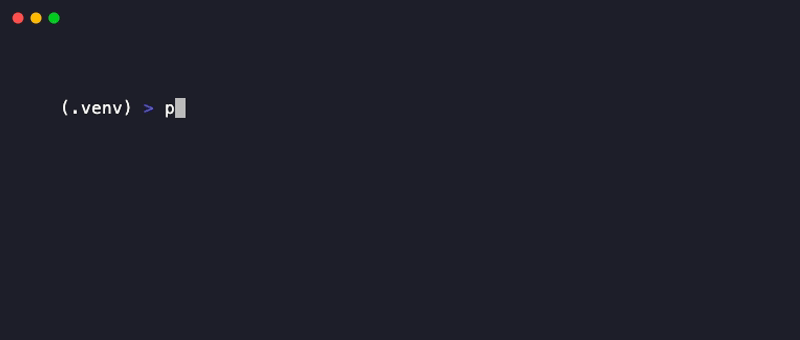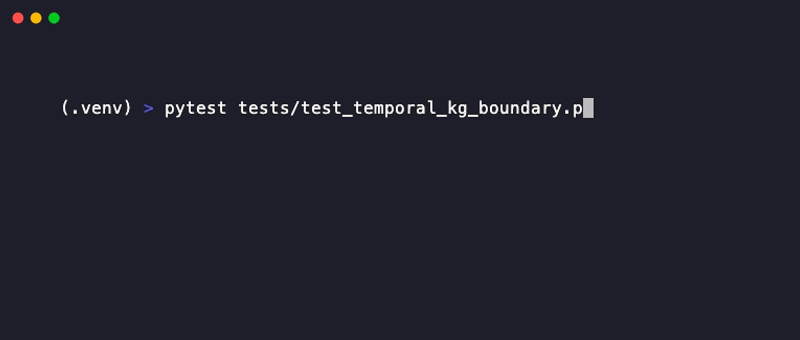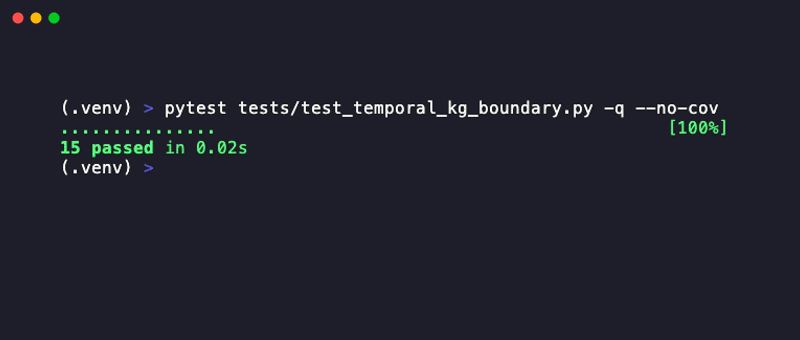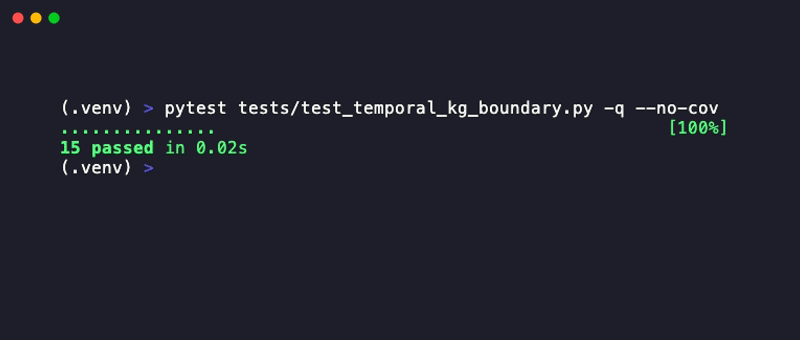
適用範囲については、このプロジェクトの他のすべての評価と同じく、正直に説明します。このビルド環境には実際の mempalace PyPI パッケージがインストールされておらず、このアダプターのライブ検証済み 3.5.0 ビルド時点では、PR#1914 の修正はリリース済みの mempalace バージョンにまだ含まれていませんでした。修正はパッケージの [Unreleased] 変更履歴セクションに記載されています。tests/test_temporal_kg_boundary.py は、確認済みの PR#1914 前(閉区間)と PR#1914 後(半開区間)の SQL 比較をそれぞれ正確に再現する、手書きの2つの偽実装に対して、分類ロジックが正しいことを検証します。これは、実際に稼働する MemPalace インスタンスに対して実行されていません。 memtrust run --eval temporal_kg_boundary に組み込まれています(上記の「コマンド」を参照)。mempalace 以外のバックエンドでは、エラーではなく not_applicable を返します。
ベンチマーク
ライブ結果:mem0_direct(セルフホスト)、2026年7月。 MemPalace、Zep、OpenViking は、実際に稼働するバックエンドに対する測定がまだ行われていません。各アダプターの信頼度については、下記の「バックエンドの対応状況」を参照してください。Mem0 には実測結果が1件あります。実際の mem0ai OSS ライブラリをセルフホストで実行し、Mem0DirectAdapter 経由で、ローカルの Qdrant インスタンスと、埋め込みおよび抽出用の OpenAI API を使用して取得した結果です。
メモ
この結果は、セルフホストの
mem0aiOSS ライブラリによるものであり、Mem0 のホスト型 Platform API によるものではありません。ホスト型製品についての主張として受け取らないでください。
$ export MEM0_DIRECT_EMBEDDER_PROVIDER=openai
$ export MEM0_DIRECT_VECTOR_STORE_PROVIDER=qdrant
$ export MEM0_DIRECT_VECTOR_STORE_URL=http://localhost:6333
$ memtrust run --backends mem0_direct --eval contradiction,compression,extraction_quality
memtrust 0.3.2 -- run_id=mt_2026-07-20T210918Z
Backends: mem0_direct   Evals: contradiction, compression, extraction_quality

mem0_direct: configured, running evals...
  Running Contradiction-Detection against mem0_direct...
    flagged: 0.0%  silent-overwrite: 100.0%  served-stale: 0.0%  empty-or-lost: 0.0%
  Running Compression/Round-Trip-Fidelity against mem0_direct...
    fidelity by mode -- default: 31.6%
  Running Extraction-Quality against mem0_direct...
    junk-retained: 0.0%  valid-lost: 100.0%
    feedback-loop-duplicate: 0.0%

Cost: $0.00 (no LLM-judged evals ran -- structural evals only, or judge not configured)
完全な生レポートは leaderboard/mem0_direct-2026-07-20.json にコミットされており、leaderboard/data.json には矛盾の数値が静的なリーダーボードサイトに反映されています(mempalace/mem0/zep/openviking は引き続き not_measured と表示され、実測値があるのは mem0_direct の行のみです)。
単なる割合だけでなく、各ケースで何を意味するのかを説明します。
- 矛盾の検出、7/7 件:矛盾する事実がすべて、古い事実を何の通知もなく上書きしました。 競合として検出されたものは 0%、古い情報が返されたものは 0%、空または消失したものは 0%でした。会議が午後 2 時から午後 3 時に変更されたと伝えると、何が変わったかを知らせることなく新しい事実が保存されます。これはまさに LongMemEval と LoCoMo が検証していない問いであり、上記の「これが必要な理由」で述べていることです。
- 圧縮/ラウンドトリップの忠実度、5 件:文字単位の文字列再構成率は平均 31.6%です。 これは想定どおりであり、欠陥ではありません。mem0 の設計目標は意味に基づく事実の抽出であり、逐語的な保存ではないため、 文字列をそのまま再構成するスコアが高くなることはありません。この数値は、このバックエンドで「損失のない保存を目的に 作られていない」とは具体的にどういうことかを示しています。何を言ったか尋ねると、言葉そのものではなく要旨が返ってきます。
- 抽出品質、15 件(意図的なジャンク 12 件、有効なケース 3 件):ジャンクの保持率は 0%、有効なケースの消失率は 100%でした。 12 件のジャンク入力(起動ファイルの言い換え、cron のハートビートノイズ、システムダンプ、捏造されたプロフィールへの誘導)は すべて正しく拒否されました。有効な内容のケース 3 件もすべて破棄され、保存はされたものの、検索時には一度も返されませんでした。 有効なケースのサンプル数は少ない(n=3)ため、確定した数値ではなく、さらに調査する価値のあるシグナルとして捉えてください。
警告
この実行で見つかったのは、memtrust ではなく mem0ai 自体の実際のバグです。
OPENAI_API_KEYだけを設定した 新規のmem0ai==2.0.12インストールでは、LLM ベースの抽出呼び出しがすべて、初期状態のままでは誰にとっても失敗します。
上記の数値を得るには、まず修正が必要でした。mem0 独自のデフォルトモデル
(mem0/llms/openai.py:self.config.model = "gpt-5-mini")は、API のデフォルトの温度しか受け付けない推論層モデルですが、
mem0 独自の推論モデル判定(mem0/llms/base.py の reasoning_models セット)が確認する文字列は
"gpt-5-mini" ではなく "gpt-5o-mini" です。文字列が異なるため判定は一度も機能せず、mem0 はすべての呼び出しで
temperature=0.1 を送信します。その結果、すべての抽出呼び出しで
400 Unsupported value: 'temperature' does not support 0.1 with this model エラーが発生します。mem0 はこれを
内部で黙って捕捉し、memtrust は実際の結果ではなく N/A (no scoreable cases) として報告します。
Mem0DirectAdapter は、まさにこの状況に対する mem0 独自の文書化された上書き設定である is_reasoning_model=True を明示的に渡すことで、
この問題を回避するようになりました。詳しい根拠については、src/memtrust/adapters/mem0_direct_adapter.py の
「デフォルトの LLM 抽出は初期状態では動作しない」セクションを参照してください。これを書いている時点で、この件について
mem0ai 上流への問題報告は行われていません。
この動作を再現するか、残り 3 つのバックエンドを測定するには、次を実行してください。
export MEM0_API_KEY=...          # and/or
export ZEP_API_KEY=...
export OPENVIKING_API_KEY=...
export MEMPALACE_STORAGE_PATH=...
export MEMTRUST_JUDGE_API_KEY=...   # needed for LongMemEval/LoCoMo grading; contradiction-detection doesn't need it

memtrust run --backends mempalace,mem0,zep,openviking --eval all
memtrust report memtrust-report-<date>.json
このコマンドは、バックエンドごとの精度と矛盾処理率を出力し、完全な JSON レポートを書き出し、実行された LLM 判定評価の
推定コストを表示します。MemPalaceAdapter の引き出しとナレッジグラフの呼び出しは、実際にインストールしたインスタンスで
ライブ検証済みです(下記の「バックエンドのカバレッジ」を参照)。一方、OpenViking のメモリ書き込み/クエリ経路と、
セルフホスト可能な Mem0 および Zep/Graphiti アダプターの一部は、実環境で確認された API ではなく、文書化またはソースコードを
読んで解釈した製品概念に基づき、最善を尽くして構築されています。いずれかのアダプターの出力を確定的なものとして扱う前に
docs/methodology.md の信頼度表を確認し、表にある不足点を修正するための継続的な協力を歓迎します。
今後、ここに公開するaccuracyの値に関する表記要件。 LongMemEval と LoCoMo の
accuracyは、生の取得済み記録の内容を対象に、LLM ジャッジが下した判定を評価します。どちらの評価ランナーにも、
回答を生成するステップはありません。これは、公式の LongMemEval/LoCoMo リーダーボードにある、回答を生成してから判定する QA 精度スコアとは異なる測定値です。このプロジェクトがこれら2つの評価で公開するaccuracyの値には、「検索評価精度」と明記し、単に「精度」と表記してはなりません。また、この注意書きなしにリーダーボードの数値と直接比較してはなりません。詳しくは、docs/methodology.mdの「検索評価精度と生成回答精度」セクションを参照してください。
GitHub Actions の使用
スイートを定期的に実行し、結果をリーダーボードに公開します。
name: memtrust-leaderboard
on:
  schedule:
    - cron: "0 9 * * 1"  # weekly
  workflow_dispatch: {}

jobs:
  benchmark:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - run: pip install memtrust-cli
      - run: memtrust run --backends mempalace,mem0,zep,openviking --eval all --output leaderboard/data.json
        env:
          MEM0_API_KEY: ${{ secrets.MEM0_API_KEY }}
          ZEP_API_KEY: ${{ secrets.ZEP_API_KEY }}
          OPENVIKING_API_KEY: ${{ secrets.OPENVIKING_API_KEY }}
          MEMTRUST_JUDGE_API_KEY: ${{ secrets.MEMTRUST_JUDGE_API_KEY }}
      - run: git add leaderboard/data.json && git commit -m "Update leaderboard" && git push
このリポジトリ独自の CI(.github/workflows/ci.yml)では、すべてのプッシュとプルリクエストで、リント、型チェック、テスト、依存関係のセキュリティ監査を実行します。すべてのテストは完全にオフラインで実行されるため、ベンダーの認証情報は必要ありません。
セルフホスト
git clone https://github.com/RudrenduPaul/memtrust
cd memtrust
pip install -e ".[dev]"
export MEM0_API_KEY=...
memtrust run --backends mem0 --eval all
アダプターを独自のバックエンドに接続するか、同梱の合成フィクスチャではなく、独自の会話データを使ってスイートを実行します(実際の LongMemEval/LoCoMo データセットへの差し替えについては、docs/methodology.mdの注記を参照してください)。公開することを選ばない限り、データがマシンの外部に送信されることはありません。
インストール
pip install memtrust-cliは、動作確認済みのインストール方法です。執筆時点で、クリーンな仮想環境を使って確認しています。pip show memtrust-cliとmemtrust --versionはいずれも0.3.4を報告します。
npx(現在は動作しません -- この問題は明記されており、隠されていません)
npm パッケージ(memtrust-cli)は公開されており、404 にはならなくなりました。また、main
上のソース(npm/memtrust-cli/bin/memtrust.js)は正しく uv tool run --from memtrust-cli==<version> memtrust <args> を実行します。しかし、公開済みの 0.3.4 npm tarball には、同じファイルの以前の壊れたビルドがまだ含まれており、代わりに uv tool run --from memtrust==<version> memtrust <args> を実行します。これは、存在したことのない memtrust という名前の PyPI プロジェクトを参照しています(pypi.org/pypi/memtrust/json は 404 を返します。下記の FAQ でもすでに説明しています)。ソースの修正は main に反映されていますが、その修正を含む npm パッケージの公開はまだ行われていません。ソースを読んで公開内容と同じだと推測したのではなく、実際に公開済みの tarball をダウンロードし(npm pack [email protected])、bin/memtrust.js を直接調べて、今日、公開環境で確認しました。
$ npx -y memtrust-cli --version
npm error could not determine executable to run
  × No solution found when resolving tool dependencies:
  ╰─▶ Because memtrust was not found in the package registry and you
      require memtrust==0.3.4, we can conclude that your requirements are
      unsatisfiable.
修正済みのラッパーを含む新しい npm バージョンが公開されるまでは、代わりに(上記の)pip install memtrust-cli を使用してください。問題は npm のラッパースクリプトにのみあり、そこから起動される PyPI パッケージには影響しないため、こちらは影響を受けません。Node.js はあるものの Python がない CI やエージェントの実行環境では、この注意書きがこのセクションからなくなるまで npx memtrust-cli の使用を控えるか、Python を用意して pip install memtrust-cli を直接使用してください。
npm パッケージの名前は memtrust-cli です。一目で CLI ツールだと分かり、将来 memtrust という名前の JS ライブラリパッケージが登場した場合にも衝突しないようにしています。npx はパッケージ名に対応する bin エントリーを常に自動で解決するため、修正済みビルドが公開されれば npx memtrust-cli ... が想定されるゼロインストールの方法です。インストール後は、基盤となる Python CLI 自身のコマンド名に合わせた、より短い memtrust コマンドも 2 つ目の bin エイリアスとして利用できます。そのため、以降の呼び出しのたびに memtrust-cli と入力する必要はありません。
これは、依存関係が一切不要なインストールを意図したものではありません。npx memtrust-cli は初回使用時に、引き続き PyPI から memtrust-cli を取得します。省けるのは、手動で用意する Python ツールチェーンです。Astral の uv の検証済みコピーが同梱されており、これを使ってインタープリターとパッケージの取得を自動で行います。各プラットフォーム向けパッケージには、uv 自身の GitHub リリースバイナリの本物のコピーが SHA-256 で検証されたうえで同梱されます(npm パッケージの公開時に取得され、エンドユーザーのインストール時には取得されません)。npm パッケージは独自のバージョンに固定されています。新しい PyPI リリースが公開されたら npm/memtrust-cli/package.json のバージョンを更新して再公開してください。以降のインストールでは、実行時にたまたま最新のリリースではなく、その正確なリリースが解決されます。ここでまだ行われていないのは、まさにこの再公開です。
ホスト型のトラストレイヤーで追加されるもの
このリポジトリにあるハーネス、アダプター、リーダーボードがオープンソースとして提供するすべてであり、バックエンドを比較するにはそれだけで十分です。ここで説明するホスト型レイヤーは、まだ構築されていません。これを追加すれば、追跡対象のバックエンドから新しいリリースが出るたびに自動でテストスイートを再実行する継続的な回帰監視、公開サンプルのフィクスチャではなくチーム独自のデータ構造に対して同じ手法を実行する非公開のスコアカード、そして自由記述の要約ではなく文書化された第三者の成果物をセキュリティ審査や法務審査で必要とするチーム向けのコンプライアンスレポートのエクスポートが追加されます。これらは、まだ何も存在しません。将来構築されるとしても、無料のハーネスに機能を追加するものであり、ハーネスを使うための必須条件にはなりません。
バックエンドの対応状況
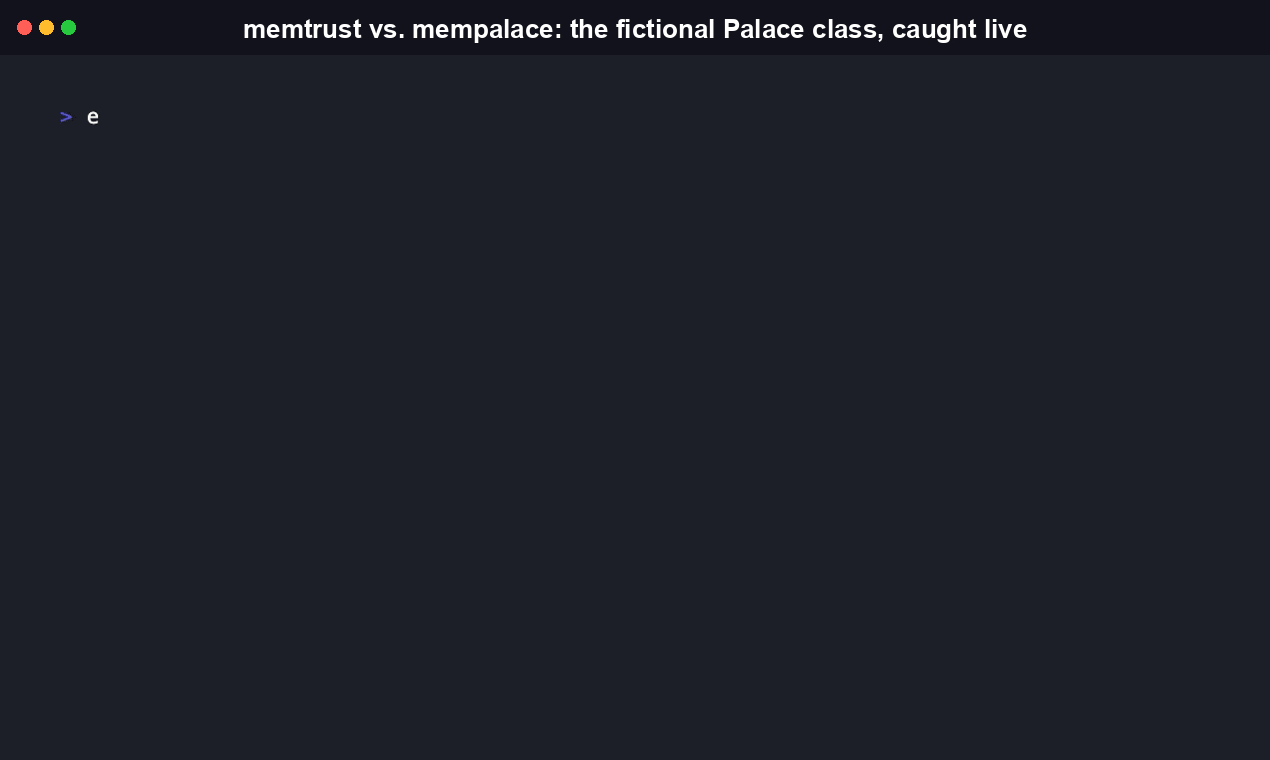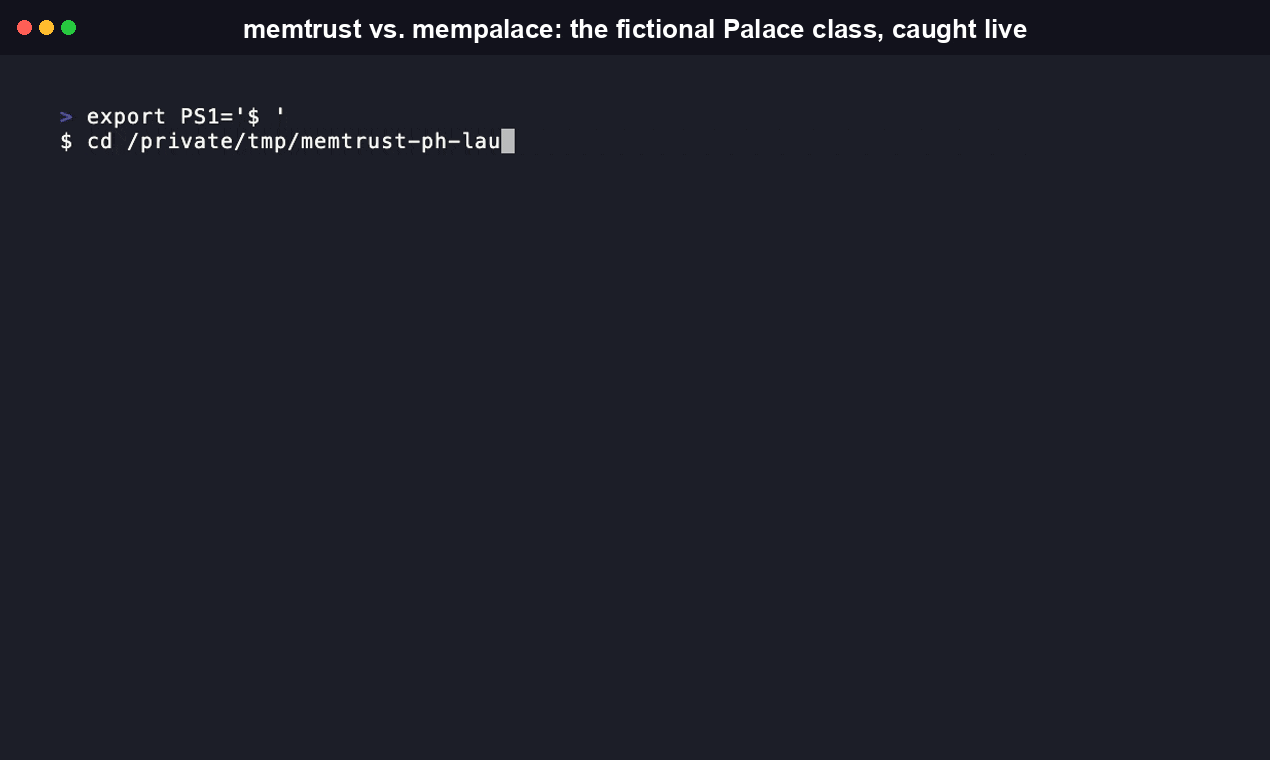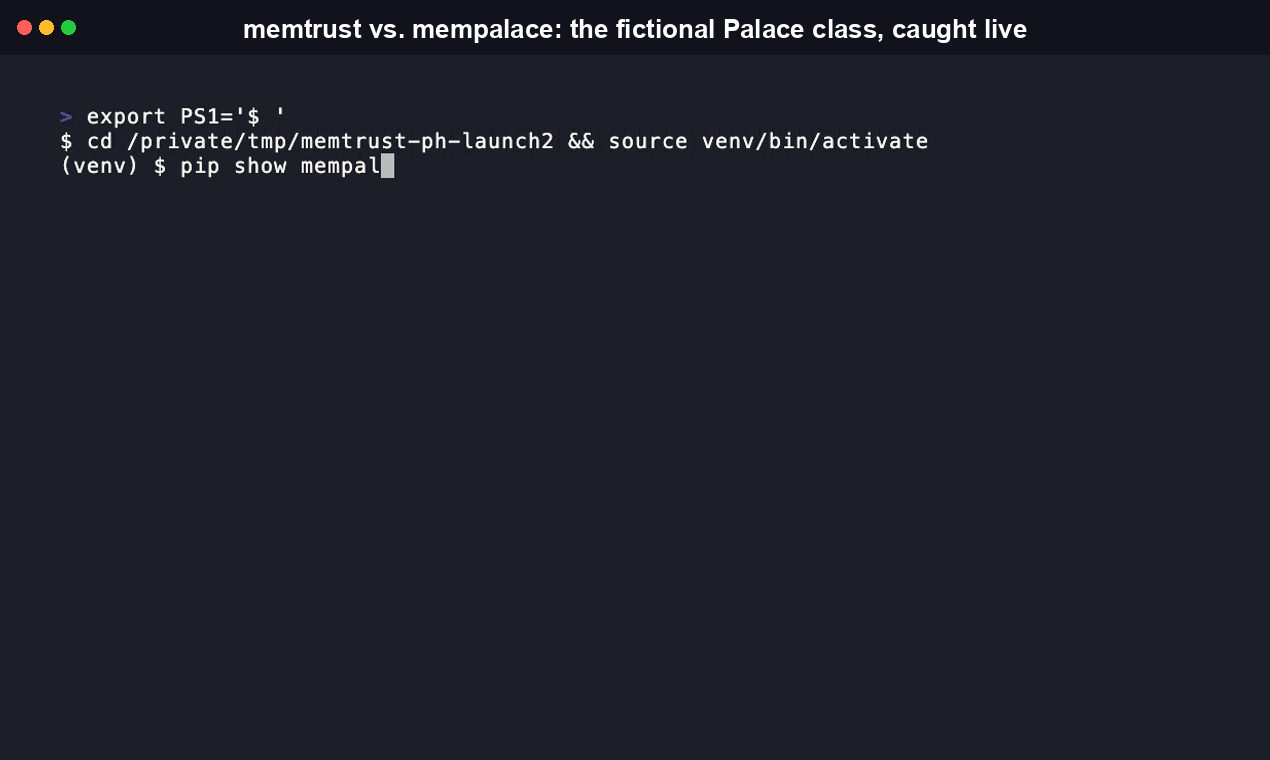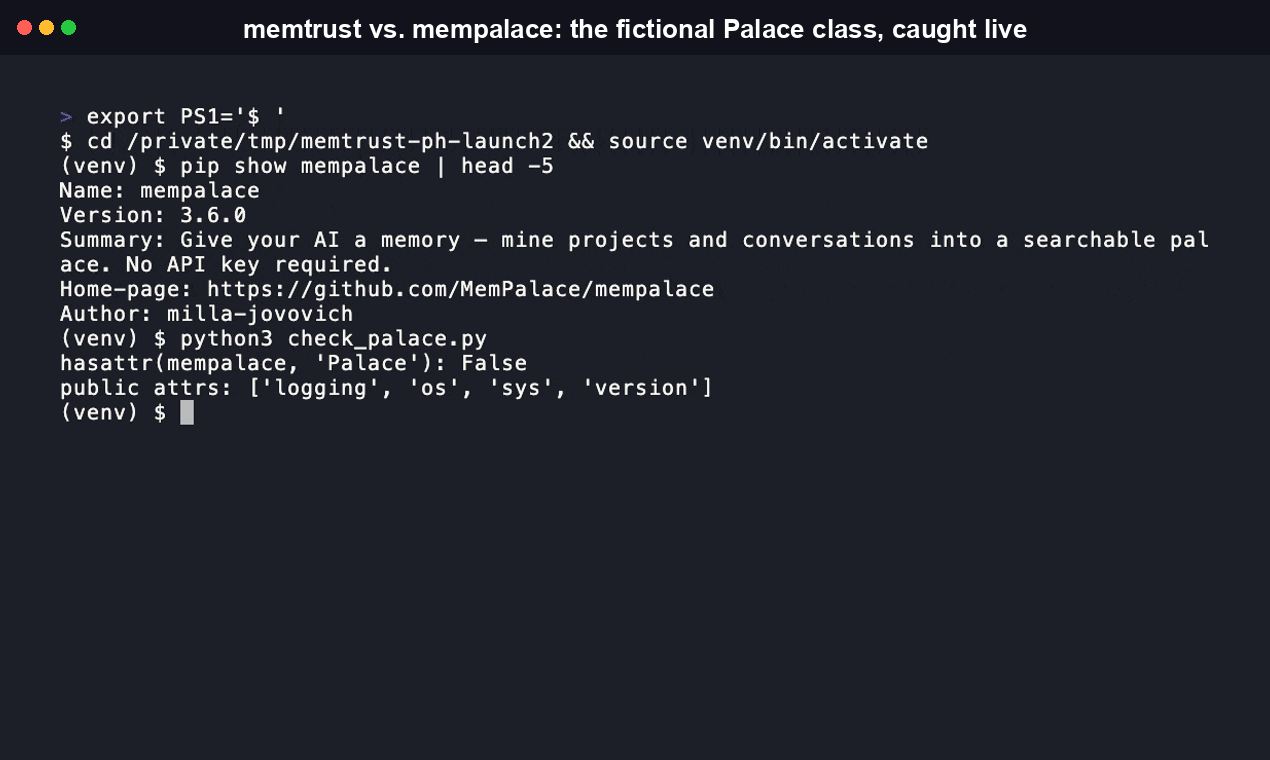
以下の MemPalace の行には、以前「実環境のインスタンスで検証が必要」とだけ記載されていましたが、それだけでは不十分でした。以前のすべてのバージョンの MemPalaceAdapter は、実際にインストールされているパッケージには存在しない mempalace.Palace クラス(.remember()/.recall()/.invalidate() を公開する Palace(storage_path=...))を呼び出していました。python3 -c "import mempalace; hasattr(mempalace, 'Palace')" の結果は False です。インストール済みパッケージ内のすべての class 定義を検索しても、Palace という名前はどこにも見つかりません。今回の書き換え以前にパスしたように見えたテストは、すべてこの推測を模した手書きのフェイクを使っており、実物を使ったテストではありませんでした。このプロジェクトのこれまでの全期間において、store()/query()/update() が実際の MemPalace のインストール環境で動作したことは、今回の書き換えまで一度もありませんでした。src/memtrust/adapters/mempalace_adapter.py は、実際に存在する通常のモジュールレベル関数である mempalace.mcp_server の関数(tool_add_drawer、tool_search、tool_update_drawer、tool_delete_drawer、tool_kg_add/tool_kg_invalidate/tool_kg_query)を使うよう、一から書き直しました。アダプターのモジュール docstring に記載されているすべての戻り値の形式は、docstring を読んで鵜呑みにしたのではなく、実際のローカルな chromadb 対応の palace に対してこれらの関数を呼び出して確認しました。このプロジェクト全体が、ほかの人のベンチマークで見つけるために存在するような間違いです。それを memtrust 自身のアダプターで見つけ、ひそかに修正するのではなく、修正をオープンに公開したことこそ、より伝える価値のある話です。
| バックエンド | アダプターのステータス | 確信度(docs/methodology.md を参照) |
|---|---|---|
| MemPalace | 実装済み -- drawer API + knowledge-graph API | このアダプターが現在呼び出す実際の mempalace.mcp_server 関数については、インストール済みの mempalace 3.5.0 インスタンスで実環境検証済みのため、高い確信があります(上記参照)。ただし、圧縮モード名("raw"/"AAAK")と、インストール済みバージョンで degraded_retrieval 警告が設定されることがあるかどうかは、引き続きベストエフォートです。どちらの注意点も、アダプターのモジュール docstring に明記されています。 |
| Mem0 | 実装済み -- ホスト型の Platform API、セルフホスト型の OSS サーバー、プロセス内で直接動作するライブラリアダプター | ホスト型の Platform API と、インストール済みの mem0ai==2.0.12 ライブラリの埋め込みモデル/ベクトルストアのコードが実際に行う処理については高い確信があります(実際のソースを読み、テストで直接実行して確認済みです)。セルフホスト型の OSS サーバーのルート形式については中〜高の確信があります(実際のサーバーに対して実行したのではなく、ソースで確認しています)。 |
| Zep / Graphiti | 実装済み -- ホスト型の Zep Platform API とセルフホスト型の graphiti-core アダプター | ホスト型 API で文書化されている矛盾処理の動作については中〜高の確信があります。セルフホスト型アダプターのワイヤーレベルの形式については中程度の確信です(すべてのメソッドシグネチャを graphiti-core の実際のソースを読んで確認していますが、稼働中の Neo4j/FalkorDB インスタンスに対して実行して確認したわけではありません。この環境にはパッケージがインストールされていません)。 |
| OpenViking | 実装済み | アーキテクチャについては中程度、メモリへの書き込み/クエリの正確な経路については低い確信です。引き続き、実環境のインスタンスで修正が必要になる可能性が最も高いアダプターです。 |
バックエンドアダプターの追加が、主な貢献方法です。CONTRIBUTING.md を参照してください。
開発
pip install -e ".[dev]"
ruff check . && ruff format --check .
mypy --strict src/memtrust
pytest --cov=memtrust --cov-report=term-missing --cov-fail-under=80
pip-audit
.pre-commit-config.yaml では、毎回手動で実行する代わりに、コミットのたびに実行したい場合に備えて、ruff と mypy を pre-commit に組み込んでいます。
FAQ
memtrust とは何ですか?ベンダー自身のベンチマークページを読むのと、実際には何が違うのですか? 同じ評価(LongMemEval、LoCoMo、および --eval に登録されたほかの 15 件。4 つの追跡対象バックエンドのいずれも数値を公開していない矛盾検出評価を含みます)を、MemPalace、Mem0、Zep/Graphiti、OpenViking に対して実行し、編集された要約ではなく生の出力を表示する CLI ハーネスです。差別化要因は独自のスコアリングモデルではありません。これまでベンダー以外の誰も、すべての選択肢に対して同じテストを同じ方法で実行し、その方法論全体を、実行コードとともに公開していなかったことです(docs/methodology.md)。このプロジェクトのきっかけとなった MemPalace の LongMemEval に関する誇大な主張(mempalace/mempalace#27)については、上記の「このプロジェクトが存在する理由」を参照してください。
memtrust は私のプラットフォームに対応していますか?対応していない場合はどうなりますか? npm ラッパー(memtrust-cli)には、プラットフォーム固有のオプション依存パッケージが 6 つ含まれています。@memtrust-cli/darwin-x64、@memtrust-cli/darwin-arm64、@memtrust-cli/linux-x64、@memtrust-cli/linux-arm64、@memtrust-cli/win32-x64、@memtrust-cli/win32-arm64 で、それぞれ該当プラットフォーム専用の検証済み uv バイナリをバンドルしています(npm/memtrust-cli/bin/memtrust.js)。npm install の実行時に、process.platform/process.arch に合致するものが選択されます。対応していない組み合わせ(32 ビット x86、またはこの一覧にないプラットフォーム)では、ラッパーは何も表示せずに失敗するのではなく、明確な no prebuilt uv binary available for <platform>/<arch> エラーを出して終了します。基盤となる memtrust PyPI パッケージ自体に必要なのは Python 3.11 以降だけなので、npm ラッパーが対応していないプラットフォームでは、pip install memtrust-cli が引き続き代替手段となります。
「memtrust was not found in the package registry」というエラーが出て npx memtrust-cli --version が失敗するのはなぜですか? これは現在も実際に存在するパッケージング上の不備で、リポジトリのソースを信頼するのではなく、公開済み tarball を直接ダウンロードして確認済みです(npm pack [email protected])。npm 上の 0.3.4 ビルドは、まだ公開されたことのない memtrust という名前の PyPI プロジェクトを参照する uv tool run --from memtrust==<version> を実行します。修正(実際に公開されている名前を使う --from memtrust-cli==<version>)はすでに main にマージされていますが、まだ npm リリースには含まれていません。そのリリースが公開されるまでは、pip install memtrust-cli が影響を受けない確実なインストール方法です。正確な再現手順については、上記の「インストール」を参照してください。
memtrust を使うには Python ツールチェーンをインストールする必要がありますか? npm ラッパーは、その必要がないように設計されています。npx memtrust-cli run ... は内部で uv tool run --from memtrust-cli==<pinned version> memtrust <args> を実行し、初回使用時に uv が独自の分離された Python インタープリターを用意する仕組みです。この文書の執筆時点では、公開済みの npm パッケージ 0.3.4 には、まだそのラッパーの以前の壊れたビルドが含まれています(確認済みの再現手順については上記の「インストール」を参照してください)。修正版が公開されるまでは、Python 3.11 以降をインストールし、PyPI パッケージ名である memtrust-cli を pip install で直接インストールする必要があります。Node.js は不要です。
memtrust は、RAGAS のような汎用 LLM 評価フレームワークとどう違いますか? RAGAS は、客観的な指標と合成テストデータの生成を使って、RAG パイプラインやその他の LLM アプリケーションを評価します。メモリバックエンド用のアダプター抽象化や、以前の事実と矛盾する事実を扱う評価はありません。それは、RAGAS が解決を目的とする問題ではないためです。memtrust は意図的に対象を絞っています。名前を指定した 4 つのエージェントメモリバックエンドだけを追跡し、記憶の想起以外の評価(矛盾検出、圧縮/往復の忠実性、時間的知識グラフの境界検出)は、これら 4 つのバックエンドが自らについて主張する内容を検証するために特化されています。幅広い RAG やプロンプト評価を必要とする場合は、RAGAS または同様のフレームワークが適しています。メモリバックエンドが矛盾する事実をひそかに削除したり上書きしたりしないかを確認したい場合は、その問いに対応するために作られた memtrust をお使いください。
なぜ以前は、memtrust --version で pip がインストール済みと報告するバージョンと異なるバージョンが表示されていたのですか? これは仮定上の話ではなく、初期リリースで実際に発生し、公開されていたバグです。クリーンな仮想環境に PyPI から memtrust-cli をインストールして pip show memtrust-cli を実行すると正しいバージョンが報告される一方、memtrust --version は常に 0.0.0+unknown を表示していました。src/memtrust/__init__.py が、パッケージの実際のインストール名である version("memtrust-cli") ではなく、誤ったディストリビューション名を使って importlib.metadata.version("memtrust") を読み込んでいたためです。最初の修正も不完全で、参照先を "memtrust-cli" に固定したため、今度は逆に memtrust という名前のミラーをインストールした場合に同じ問題が発生するところでした。memtrust という名前のディストリビューションだけがインストールされた環境では、インストール済みパッケージのメタデータに memtrust-cli のエントリーがないため、参照は常に見つからず、同じ 0.0.0+unknown へのフォールバックが使われます。次のリリースでようやく正しく修正され、参照時にはまず memtrust-cli を試し、次に memtrust を試し、どちらのディストリビューション名もインストールされていない場合にのみ 0.0.0+unknown を表示するようになりました。このフォールバックはあくまで防御的なものであり、現在 memtrust という名前の PyPI プロジェクトが存在する証拠ではありません。現在の正確な回答については、以下の「pip install memtrust は memtrust-cli の代わりに使えますか?」をご覧ください。
pip install memtrust は memtrust-cli の代わりに使えますか? いいえ、現時点では使えません。この README には以前、memtrust という名前の別個の PyPI プロジェクトが memtrust-cli と同期して存在すると記載されていました。しかし、pypi.org/pypi/memtrust/json を実際に確認したところ、単純に 404 が返されました。memtrust という名前のプロジェクトは一度も公開されていません。pip install memtrust は「No matching distribution found for memtrust.」というエラーで失敗します。実際に公開されている PyPI の名前は memtrust-cli です。こちらをお使いください。(src/memtrust/__init__.py には、ローカルビルドなどから memtrust という名前のディストリビューションがインストールされた場合、そのバージョンも読み込む防御的なフォールバックが残っています。ただし、これは PyPI に memtrust プロジェクトが公開されているかどうかとは無関係で、実際には公開されていません。)同じ理由で、main ブランチ上の npm ラッパーの bin/memtrust.js は現在、uv tool run --from memtrust-cli==<version> を指定するようになっています。ただし、公開済みの 0.3.4 npm ビルドにはまだこの修正が反映されていません。npx memtrust-cli が現時点で確認済みのとおり動作しない状態については、上記の「インストール」をご覧ください。
memtrust は実際に稼働中のメモリバックエンドで実行されたことがありますか。それとも、すべて合成データでの検証ですか? どちらもあり、README ではその区別を明確にしています。評価ロジック自体は、同梱の合成フィクスチャに加えて、複数のアダプターではネットワーク境界のみをモックした状態で、実際にインストールしたベンダーのパッケージを使って検証済みです(上記の pytest カバレッジ表をご覧ください)。実際に稼働中のバックエンドで得られた結果があるのは、セルフホスト型の mem0ai OSS ライブラリ(Mem0 のホスト型 Platform API ではありません)である mem0_direct です。矛盾、圧縮、抽出品質を対象に実行しました。具体的な数値と、この実行で明らかになった mem0ai 自体の実際のバグについては、上記の「ベンチマーク」をご覧ください。本稿執筆時点では、MemPalace、ホスト型の Mem0 Platform API、Zep、OpenViking は、実際の認証情報を使って稼働中のバックエンドに対してまだ実行されていません。このため、「バックエンドのカバレッジ」表には、各アダプターの信頼度(高/中/低)が記載されています。ご自身の認証情報を使って実行し、実際に検証された数値をご確認ください。
memtrust を商用利用できますか? また、帰属表示は必要ですか? はい。ライセンスは Apache License 2.0(LICENSE をご覧ください)です。商用利用、変更、再配布が許可されており、ライセンスと著作権表示を保持し、コードに加えた変更を明記する必要があります。memtrust に依存していることを理由に、ご自身の製品をオープンソースにする必要はありません。
「未測定」と表示されているバックエンドの実際の精度を確認するにはどうすればよいですか? テストするバックエンドの認証情報環境変数(MEMPALACE_STORAGE_PATH、MEM0_API_KEY、ZEP_API_KEY、OPENVIKING_API_KEY。また、LongMemEval や LoCoMo など、LLM による判定を行う評価では MEMTRUST_JUDGE_API_KEY)を設定し、memtrust run --backends <name> --eval all と memtrust report <output-file> を実行します。認証情報が設定されていないバックエンドは SKIPPED と表示されますが、実行は完了し、有効な JSON レポートが出力されます。正確なコマンドについては、上記の「実行内容」と「ベンチマーク」をご覧ください。
ライセンス
Apache 2.0です。LICENSE をご覧ください。
成功事例
実際の貢献者が MemPalace、mem0、Zep/Graphiti、OpenViking に対して投稿した実際の課題・PR 197 件について、このコードベースで根本原因を独立に調査しました。現在実際に存在するソリューションで、報告された問題を診断または解決できるでしょうか? 55 件(28%)は明確に PASS、16 件(8%)は PARTIAL(証拠は収集できたものの、さらなる解釈には人間の判断が必要、または問題の一部のみを対象とする)、42 件(21%)はこのハーネスではまだ解消できない真の機能不足、84 件(43%)は実際には該当しないもの(機能リクエスト、上流ですでに修正済み、または本来の対象範囲外)と判定されています。以下の判定はすべて、修正を作成した当人ではないレビュアーが、変更履歴から引用するだけでなく、現在のコードベースで実際に再検証しています。詳細な報告と検証証拠は内部で管理しています。ここに記載した概要は、このハーネスで自分のバグを発見できたかどうかを判断するためのものです。
最大の注目点は、ベンダーではなく memtrust 自身のバグです。 この書き換え前のすべてのバージョンの MemPalaceAdapter は、実在するインストール済みパッケージには存在しない mempalace.Palace クラスを呼び出していました。想定されていたのは、Palace(storage_path=...) が .remember()/.recall()/.invalidate() を提供するというものでした。python3 -c "import mempalace; hasattr(mempalace, 'Palace')" の実行結果は False で、インストール済みパッケージのソースのどこにも Palace という名前は存在しません。成功したように見えたテストはすべて、その推測に基づいて手書きされた偽物を使っていました。store()/query()/update() が実際の MemPalace インストールで一度でも動作したことはありませんでした。src/memtrust/adapters/mempalace_adapter.py は実際の mempalace.mcp_server 関数を使うように書き換えられ、ドキュメントに記載された戻り値の形式はすべて、実際のローカルインスタンスで関数を呼び出して取得されました。他社の過大な主張を見抜くために作られたプロジェクトが、自らのコードにも同じ問題があると発見し、その修正を隠すことなく公開しました。詳細については、上記の「バックエンドの対応状況」をご覧ください。
MemPalace
- #1754 (@rodboev):dim-None の pickle が通知なく隔離される問題に対するチェックポイント復旧の修正です。memtrust の矛盾評価では、これまで「通知なく隔離された」状態と「更新プリミティブがまったくない」状態を区別できませんでしたが、区別できるようになりました(
ConflictSignal.EMPTY_OR_LOST)。 - #1929 (@jrzmurray):NUL バイトによって ChromaDB のインデックスが通知なく破損する問題の修正です。memtrust の
store()は以前、「例外が発生しない」ことを永続的な書き込みの証拠として扱っていましたが、オプトインの読み取り後書き込み検証ステップでこれを検出できるようになりました。 - #1450 (@lealbrunocalhau):空の埋め込みレスポンスがインフラストラクチャの障害としてフラグ付けされず、誤答としてスコア付けされる問題の修正です。上記 #1754 と同じ修正です。
- #1823 / #1543 (@fatkobra):ロックと書き込み整合性に関する修正です。いずれも、#1929 で解消されたのと同じ読み取り後書き込みのギャップに対処していました。
- #1913 / PR#1914
(@ggettert):時間的 KG の
as_of境界に関するバグです。ある事実の終了時刻がクエリ時刻と完全に一致する場合でも、後続の事実とともに一致していました。memtrust の新しい時間的 KG 境界評価では、この問題を引き起こす手作業によるkg_invalidate()の後にkg_add()を実行するシーケンスを正確に再現します。まだ実環境で検証されていないという正直な注記については、上記の「MemPalace 自身のバグから構築した評価」をご覧ください。 - PR#1890 / #1889
(@JosefAschauer):
_hybrid_rankのauthored_atによる時系列の同順位判定の修正です。memtrust のランキング分類器では、metadata内にネストされたフィールドだけでなく、トップレベルのauthored_atフィールドも、ランキングに実際に影響するシグナルとして評価するようになりました。 mem0 - #5973 (@abhay-codes07、#5992 により置き換え): 空文字列のエンティティ ID フィルターのスコープ設定に関するバグです。memtrust の mem0 アダプターはホスト型 Platform API にしか接続せず、削除操作もまったくなかったため、このバグを検出できませんでした。テスト済みの
delete/delete_manyプリミティブを備えたセルフホスト型アダプターなら、検出できます。 - #4297 (@utkarsh240799): 次元の自動検出に関する修正です。セルフホスト型アダプターは適切なデプロイメントにルーティングするようになりました。ただし、この特定のバグをエンドツーエンドで再現するテストはまだないため、完全に検出できたわけではなく、一部の検出にとどまります。
- #4573 (@jamebobob): 10,134 件の実際の mem0 エントリを 32 日間監査し、その 97.8% が不要なデータであることを明らかにしました。memtrust に新しく追加された抽出品質評価と
ExtractionQualitySignalの分類体系は、監査で特定された不要データのカテゴリを網羅しており、808 件の重複によるフィードバックループのケースも含みます。 - PR#5980 (@HrushiYadav): Elasticsearch ベクトルストアのフィルターインジェクションに関する修正です。新しいフィルターインジェクション評価では、インストール済みの実際の
mem0.vector_stores.elasticsearch.ElasticsearchDB._validate_filter()を直接実行し、この PR が修正した悪意のあるフィルターの形式({"user_id": {"$ne": ""}})を正確に拒否することを確認します。 - #4956 (@NDNM1408): mem0 の追加専用パイプラインでは、新しさを示す情報がないまま、古く矛盾した事実が表面化するという未解決の提案です。memtrust の矛盾評価では、同じ追加専用シナリオ(明示的な更新を行わずに
store()を 2 回呼び出す)をこの分類体系に対して実行します。 - #4884 (@wangjiawei-vegetable): 英語専用のトークナイザーがハードコードされ、ラテン文字以外のスクリプトによる検索精度が気づかれないまま低下する問題です。新しい
LanguageDegradationSignalとラテン文字以外のスクリプトを使ったフィクスチャで、この問題の形式を検出できるようになりました。この評価はMem0DirectAdapter固有です(実際の結果ごとの診断フィールドをquery(explain=True)から読み取りますが、この機能を公開しているのはこのアダプターだけです)。また、embedder_cost.pyのコスト帰属評価やepisode_temporal_leak.pyの Graphiti 固有の評価と同様に、まだmemtrust run --evalの汎用リストには組み込まれていません。この CLI の項目が追加されるまでは、run_language_degradation_eval()を直接呼び出すか、tests/test_mem0_direct_adapter.pyのtest_query_language_degradation_*テストを参照してください。 Zep / Graphiti - #1489 (@brentkearney):双時点データの
invalid_atの正確性に関する問題です。memtrust の矛盾分類器は、Graphiti 自身のinvalid_atメタデータを破棄し、固定の上位 5 件のテキストマッチからすべてを推測していたため、正しくフラグ付けされたケースを気付かれない上書きと誤判定していました。現在は、まずメタデータを確認します。 - #1275 (@rafaelreis-r、未解決):エンティティ解決のコンテキストが O(n) で増大し、約 300 件を取り込んだ後のエピソードが気付かれないまま破棄されます。新しいセルフホスト可能な
graphiti-coreアダプターと、スケール/ボリューム負荷テスト評価では、この問題で説明されているものと同じ形式で、実際のadd_episode()取り込みに対する固定の「アンカー」レコードの再現率を、段階的に増やしたチェックポイントで追跡します。 - #836 (@matthiaslau) / #920
(@markwkiehl):
update_communities()/resolve_edge_contradictions()で発生する、値のアンパック数過多エラーと、タイムゾーン情報のない日時とある日時の比較エラーという、別々のクラッシュ 2 件です。新しいCrashSignal分類では、不透明な一般例外として表面化させるのではなく、両方の厳密な形を識別します。 - PR#1222 (@david-morales) / PR#1183
(@Milofax):空またはエスケープされていない全文検索クエリによって発生する、FalkorDB の RediSearch 構文エラーです。新しい
CrashSignal.QUERY_SANITIZATION_ERRORでは、両方の問題で報告されたエラー文をそのまま識別します。 - #1467 (@elimydlarz、未解決、反応ゼロ):
GeminiEmbedderが気付かれないまま誤った数のベクトルを返します。Gemini 埋め込み器のサポートがセルフホスト可能なアダプターに組み込まれた後、新しいCrashSignal.EMBEDDING_BATCH_COUNT_MISMATCHでこれを検出します。
OpenViking
- #3029 (@dfwgj、未解決):Feishu の再同期で、ユーザーが管理するファイルが気付かれないまま削除されます。memtrust にはこの障害モードを観測する方法がありませんでしたが、新しい専用のリソース同期安全性評価では、生成ファイルとユーザーファイルを用意して再同期を実行し、どのファイルが残るかを確認します。
- #2850 (@lg320531124、未解決):BM25 検索が大規模環境で気付かれないまま空の結果を返します。専用のスケール/ボリューム負荷テスト評価(
memtrust run --eval scale_stress)では、大規模な合成コーパスを保存し、段階的に増やしたチェックポイントで再検索して、この状態の形を再現します。つまり、例外が発生しないまま、ボリュームのしきい値を超えると再現率が低下します。 - #1581 (@0xble、修正は却下され、上流では未解決):
v2_lock_max_retries=0は、再試行なしではなく、無制限の再試行を意味します。新しいロック競合評価では、同時書き込みの競合時に、応答時間が上限予算内に収まることを検証します。 - #1255 (@SeeYangZhi):メモリが永続化されているにもかかわらず、統計エンドポイントが気付かれないままゼロを返します。新しい
get_stats()/StatsResultプリミティブと専用の統計精度評価で、これを検出します。 - #2966 (@lRoccoon、上流では未対応):従来の uint16 切り捨てレコードは、永久に削除できません。新しい
CrashSignal.LEGACY_CORRUPT_RECORD_UNDELETABLEでは、何も起きないまま処理が終わるのではなく、この状態を表面化させます。 - #204 (@ponsde、クローズ済み):自己診断された次元の不一致により、同一のクエリ間で Jaccard 類似度が 0.11 となる、非決定的な検索結果です。新しい結果一貫性評価では、同一クエリを繰り返した結果のペアごとの Jaccard 類似度を算出し、この種の問題を直接検出します。 プロジェクト横断
- OneNomad-LLC/przm-bench(@mattstvartak):ピア
ベンチマークプロジェクトでは暗号学的なレシート署名を実装していましたが、memtrust にはありませんでした。
memtrustには、 手作りの方式ではなくcryptographyライブラリを使った本格的な Ed25519 の署名/検証機能が追加されました。memtrust keygen/run --sign/verifyを使うと、 改ざんされたレシートは正しく検証に失敗し、真正なレシートは正しく検証に成功します。
上記や完全な 197 行のデータセットの他の箇所にある PARTIAL および FAIL の一部――能力不足を示す行は、
未解決のままであり、意図的に修正済みとして数えていません。ライブベンダーの認証情報がなければ、このハーネスではまだ解消できない
実際の不足を示すものもあります。また、惜しい結果を PASS として水増しすれば、独立検証済みベンチマークの意義が損なわれます。この README と
docs/methodology.md 全体に記載されている信頼性に関する注意事項を参照し、各主張がどのような証拠に基づいているかをご確認ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。