Scaffold について
Scaffold は、コードベースをナレッジグラフに変換し、ファイル、クラス、関数の間の構造的な関係を記録する RAG システムです。AI エージェントに大規模プロジェクトを理解させ、保守させたい開発チーム向けです。
主な機能
- 01コードベースのナレッジグラフ化
- 02ベクトルとグラフの両方の表現を保持
- 03LLM とエージェントへの正確なコンテキスト注入
- 04Neo4j Web UI による可視化
活用シーン
- 01コード変更前にアーキテクチャ情報をエージェントに提供
- 02Python プロジェクトの保守とリファクタリングの支援
- 03AI ツール向けの手作業によるコンテキスト準備の削減
MCP 対応
本プロジェクトは MCP サーバーのエンドポイントを提供し、Cursor などの MCP クライアントが URL で接続してコンテキスト検索機能を利用します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
docker run -i --rm -e CHROMA_SERVER_HOST -e CHROMA_SERVER_PORT -e CHROMA_COLLECTION_NAME -e NEO4J_USER -e NEO4J_PASSWORD -e NEO4J_URI -e PROJECT_PATH ghcr.io/beer-bears/scaffold:latestCHROMA_SERVER_HOSTCHROMA_SERVER_PORTCHROMA_COLLECTION_NAMENEO4J_USERNEO4J_PASSWORDシークレットNEO4J_URIPROJECT_PATHローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ghcr.io/beer-bears/scaffold:lateststdioツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細




Scaffoldは、大規模なコードベースに対する開発チームの関わり方を一新するために設計された、特化型のRAG(検索拡張生成)システムです。従来のドキュメント作成やAIを活用した開発における実際の課題から生まれたScaffoldは、AIエージェントが複雑なソフトウェアプロジェクトを効果的に構築、保守、修復するために必要な構造的基盤を提供します。
課題
現代の開発チームは、次の3つの重大な問題に直面しています。
- ドキュメントの劣化: 正確で最新の技術ドキュメントを維持するには、継続が困難なほどの手作業が必要です。
- AIのコンテキスト不足: LLMはプロジェクト固有のアーキテクチャやビジネスロジックを把握していないため、非効率な手動でのコンテキスト提供が必要です。
- 知識の分断: システムに関する重要な理解が、チームメンバーの退職とともに失われる暗黙知としてのみ存在しています。
私たちのソリューション
Scaffoldはソースコードをグラフデータベースに保存される生きたナレッジグラフへと変換します。これにより、次のようなインテリジェントなコンテキストレイヤーを実現します。
- コードエンティティ間の構造的な関係を取得します。
- コードベースのベクトル表現とグラフ表現の両方を維持します。
- LLMとAIエージェントへの正確なコンテキスト注入を可能にします。
- 構築、保守、リファクタリングのワークフローをサポートします。
物理的な足場と同様に、Scaffoldは優れたものを作り上げるために必要な一時的な支えを提供し、作業が完了すると役目を終えます。
はじめに
Scaffoldを実行する方法は主に2つあります。ニーズに最も合った方法を選択してください。
オプション1:ビルド済みDockerイメージで実行(ユーザーにおすすめ)
Scaffoldを最もすばやく実行できる方法です。GitHub Container Registryの公式ビルド済みイメージを使用するため、ソースコードリポジトリをクローンする必要はありません。設定ファイルを2つ作成するだけです。
Scaffoldを最もすばやく実行できる方法です。GitHub Container Registryの公式ビルド済みイメージを使用するため、ソースコードリポジトリをクローンする必要はありません。設定ファイルを2つ作成するだけです。
1. プロジェクトディレクトリを準備する
プロジェクト設定用の新しいフォルダーを作成します。
mkdir my-scaffold-server
cd my-scaffold-server
2. 設定ファイルを作成する
my-scaffold-serverディレクトリに、次の2つのファイルを作成します。
docker-compose.yaml:
services:
  scaffold-mcp:
    image: ghcr.io/beer-bears/scaffold:latest
    container_name: scaffold-mcp-prod
    env_file:
      - .env
    tty: true
    ports:
      - "8000:8080"
    depends_on:
      - neo4j
    volumes:
      - ./codebase:/app/codebase

  chromadb:
    image: chromadb/chroma:1.0.13
    container_name: scaffold-chromadb
    restart: unless-stopped
    volumes:
      - chroma_data:/data

  neo4j:
    image: neo4j:5
    container_name: scaffold-neo4j
    restart: unless-stopped
    environment:
      NEO4J_AUTH: "${NEO4J_USER:-neo4j}/${NEO4J_PASSWORD:-password}"
    volumes:
      - neo4j_data:/data
    ports:
      - "7474:7474"
      - "7687:7687"

volumes:
  chroma_data:
  neo4j_data:
.env:
# ChromaDB Settings
CHROMA_SERVER_HOST=chromadb
CHROMA_SERVER_PORT=8000
CHROMA_COLLECTION_NAME=scaffold_data

# Neo4j Credentials
NEO4J_USER=neo4j
NEO4J_PASSWORD=password
NEO4J_URI=bolt://neo4j:password@neo4j:7687

# Absolute path to your codebase
PROJECT_PATH=<ABSOLUTE_PATH_TO_YOUR_CODEBASE>
3. アプリケーションを実行する
Docker Compose を使用して、すべてのサービスを起動します。
docker-compose up -d
Scaffold が起動し、コードベースのコードの分析を開始します。
オプション 2:ソースからビルドする(開発者向け)
この方法は、リポジトリをクローンし、Docker イメージをローカルでビルドしたい開発者向けです。Scaffold への貢献やカスタマイズを行う場合、またはセルフホストモードですべてのコンテナを一度に実行する場合に適しています。
この方法は、リポジトリをクローンし、Docker イメージをローカルでビルドしたい開発者向けです。Scaffold への貢献やカスタマイズを行う場合、またはセルフホストモードですべてのコンテナを一度に実行する場合に適しています。
1. プロジェクトをセットアップする
まず、リポジトリをクローンし、プロジェクトディレクトリに移動します。
git clone https://github.com/Beer-Bears/scaffold.git
cd scaffold
次に、用意されているサンプルから環境ファイルを作成します。
cp .env.example .env
2. コードベースを追加する
分析する Python プロジェクトを codebase ディレクトリに配置します。
# Create the directory if it doesn't exist
mkdir -p codebase

# Copy your project files into it
cp -r /path/to/your/python/project/* ./codebase/
または、.env ファイルを編集し、PROJECT_PATH 変数にホストマシン上のプロジェクトの絶対パスを設定できます。
3. アプリケーションを実行する
Docker Compose を使用して、アプリケーションスタック全体を起動します。--build フラグを指定すると、ローカルのソースコードから新しい Docker イメージがビルドされます。
docker-compose up --build -d
Scaffold を利用する
どちらかの方法でコンテナが起動したら、システムを利用できます。
A. MCP クライアントを設定する(例:Cursor)
クライアントの mcp.json ファイルに Scaffold サーバーを追加します。
{
  "mcpServers": {
    "scaffold-mcp": {
      "url": "http://localhost:8000/mcp"
    }
  }
}
B. ナレッジグラフを確認する
Neo4j の Web UI にアクセスして、コードベースのグラフを視覚的に確認します。.env ファイルに記載されている認証情報を使用してください(デフォルト:neo4j / password)。
URL: http://localhost:7474/
C. API リクエストを直接送信する
curl を使用して、MCP エンドポイントを直接テストすることもできます。
curl -N -X POST http://localhost:8000/mcp/ \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{
    "jsonrpc": "2.0",
    "id": "1",
    "method": "tools/call",
    "params": {
      "name": "get_code_entity_information",
      "arguments": {
        "entity_name": "MyClassName"
      }
    }
  }'
MCP の説明も確認して、Docker コマンドの設定を参照できます。
仕組み
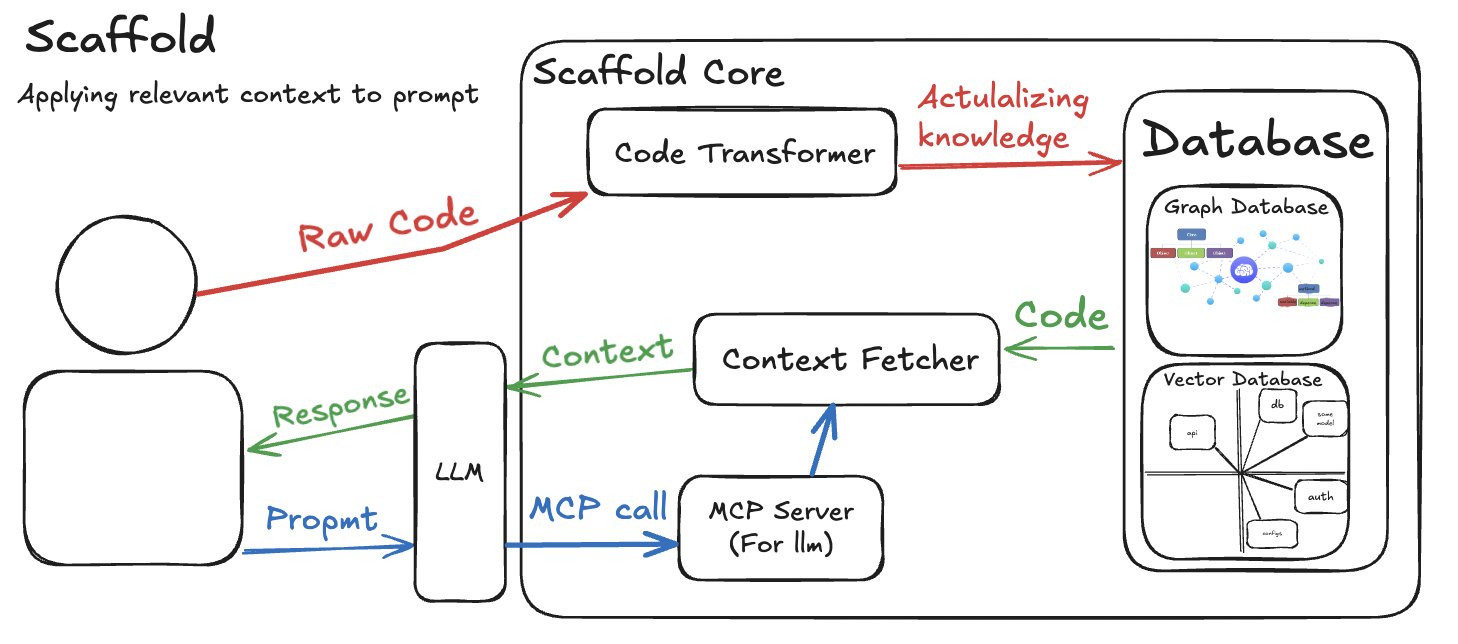
アーキテクチャ概要
アーキテクチャ図を表示
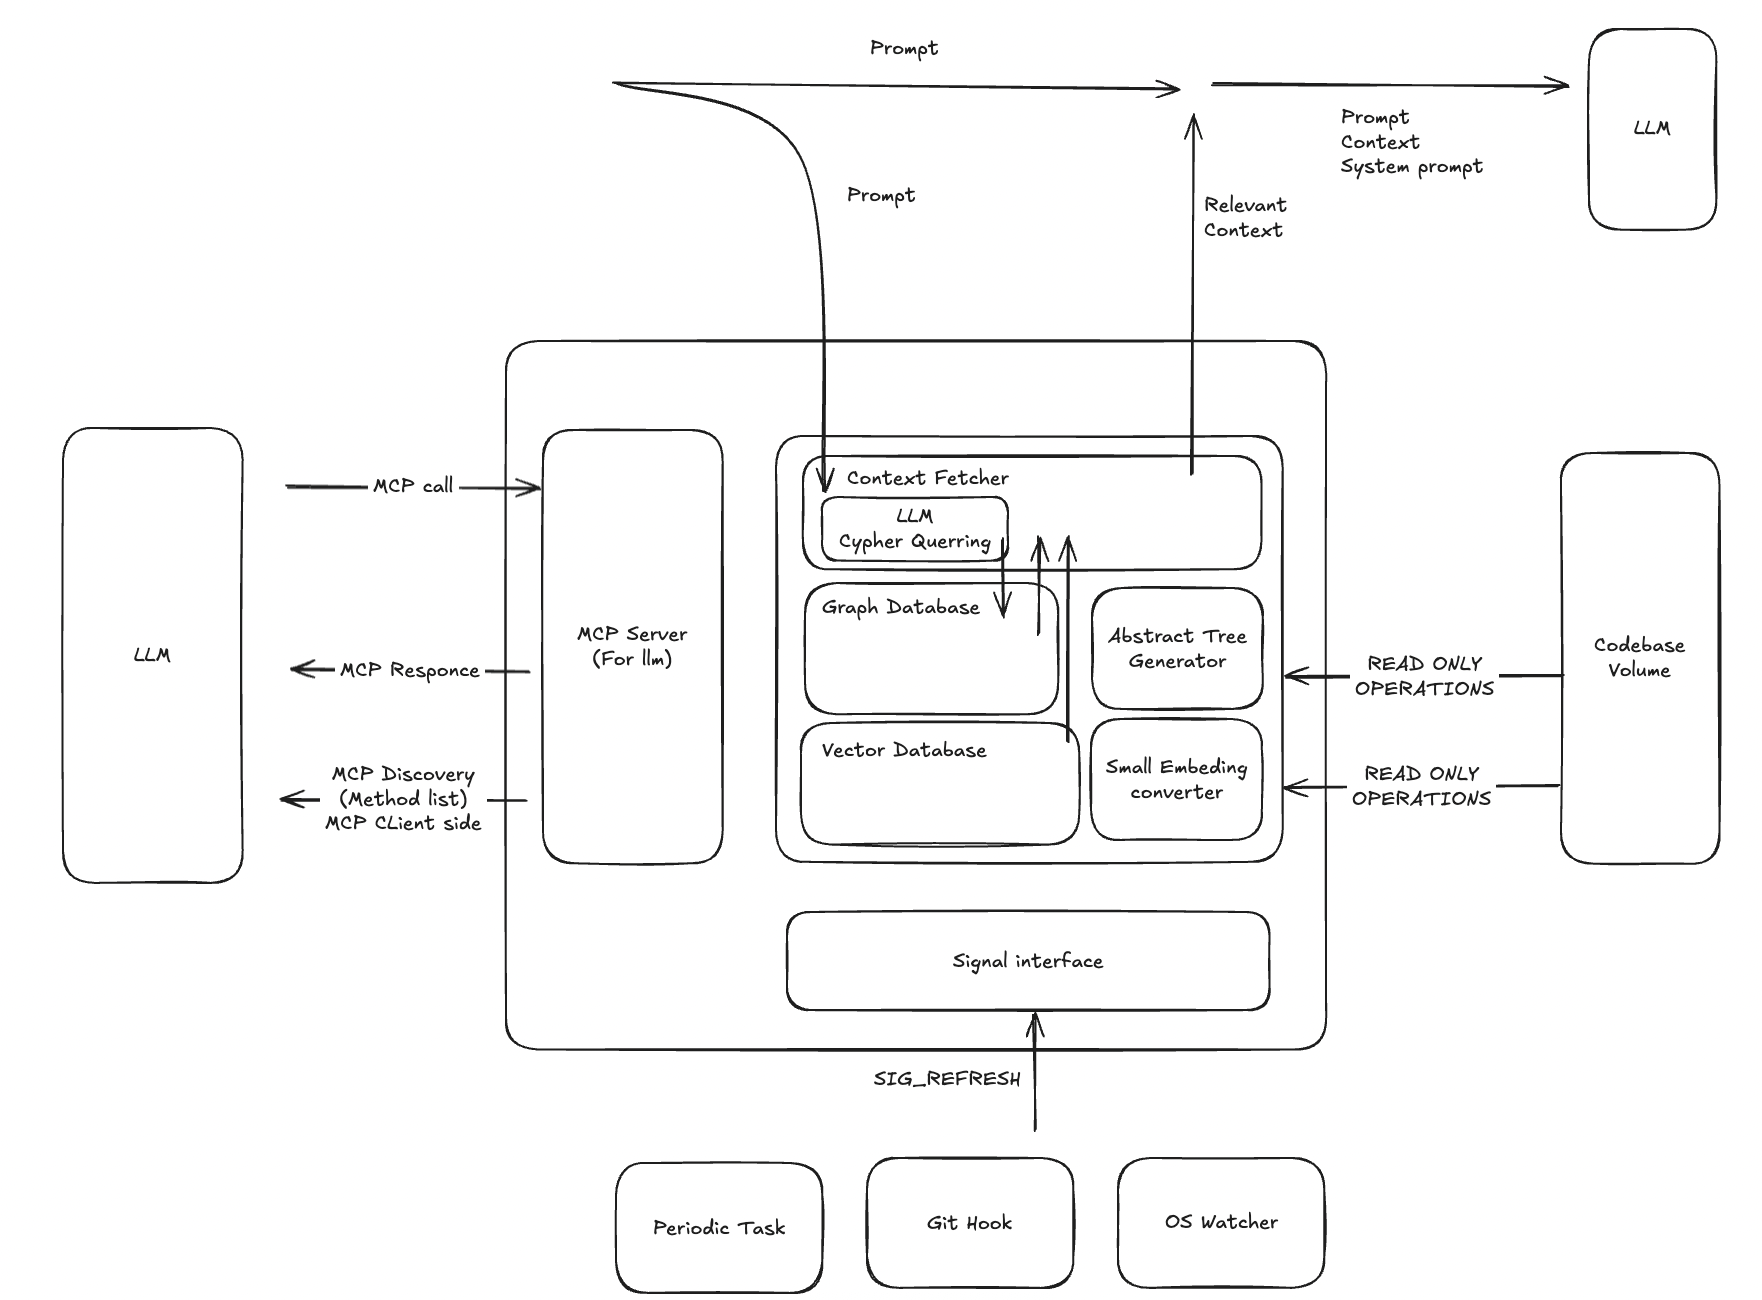
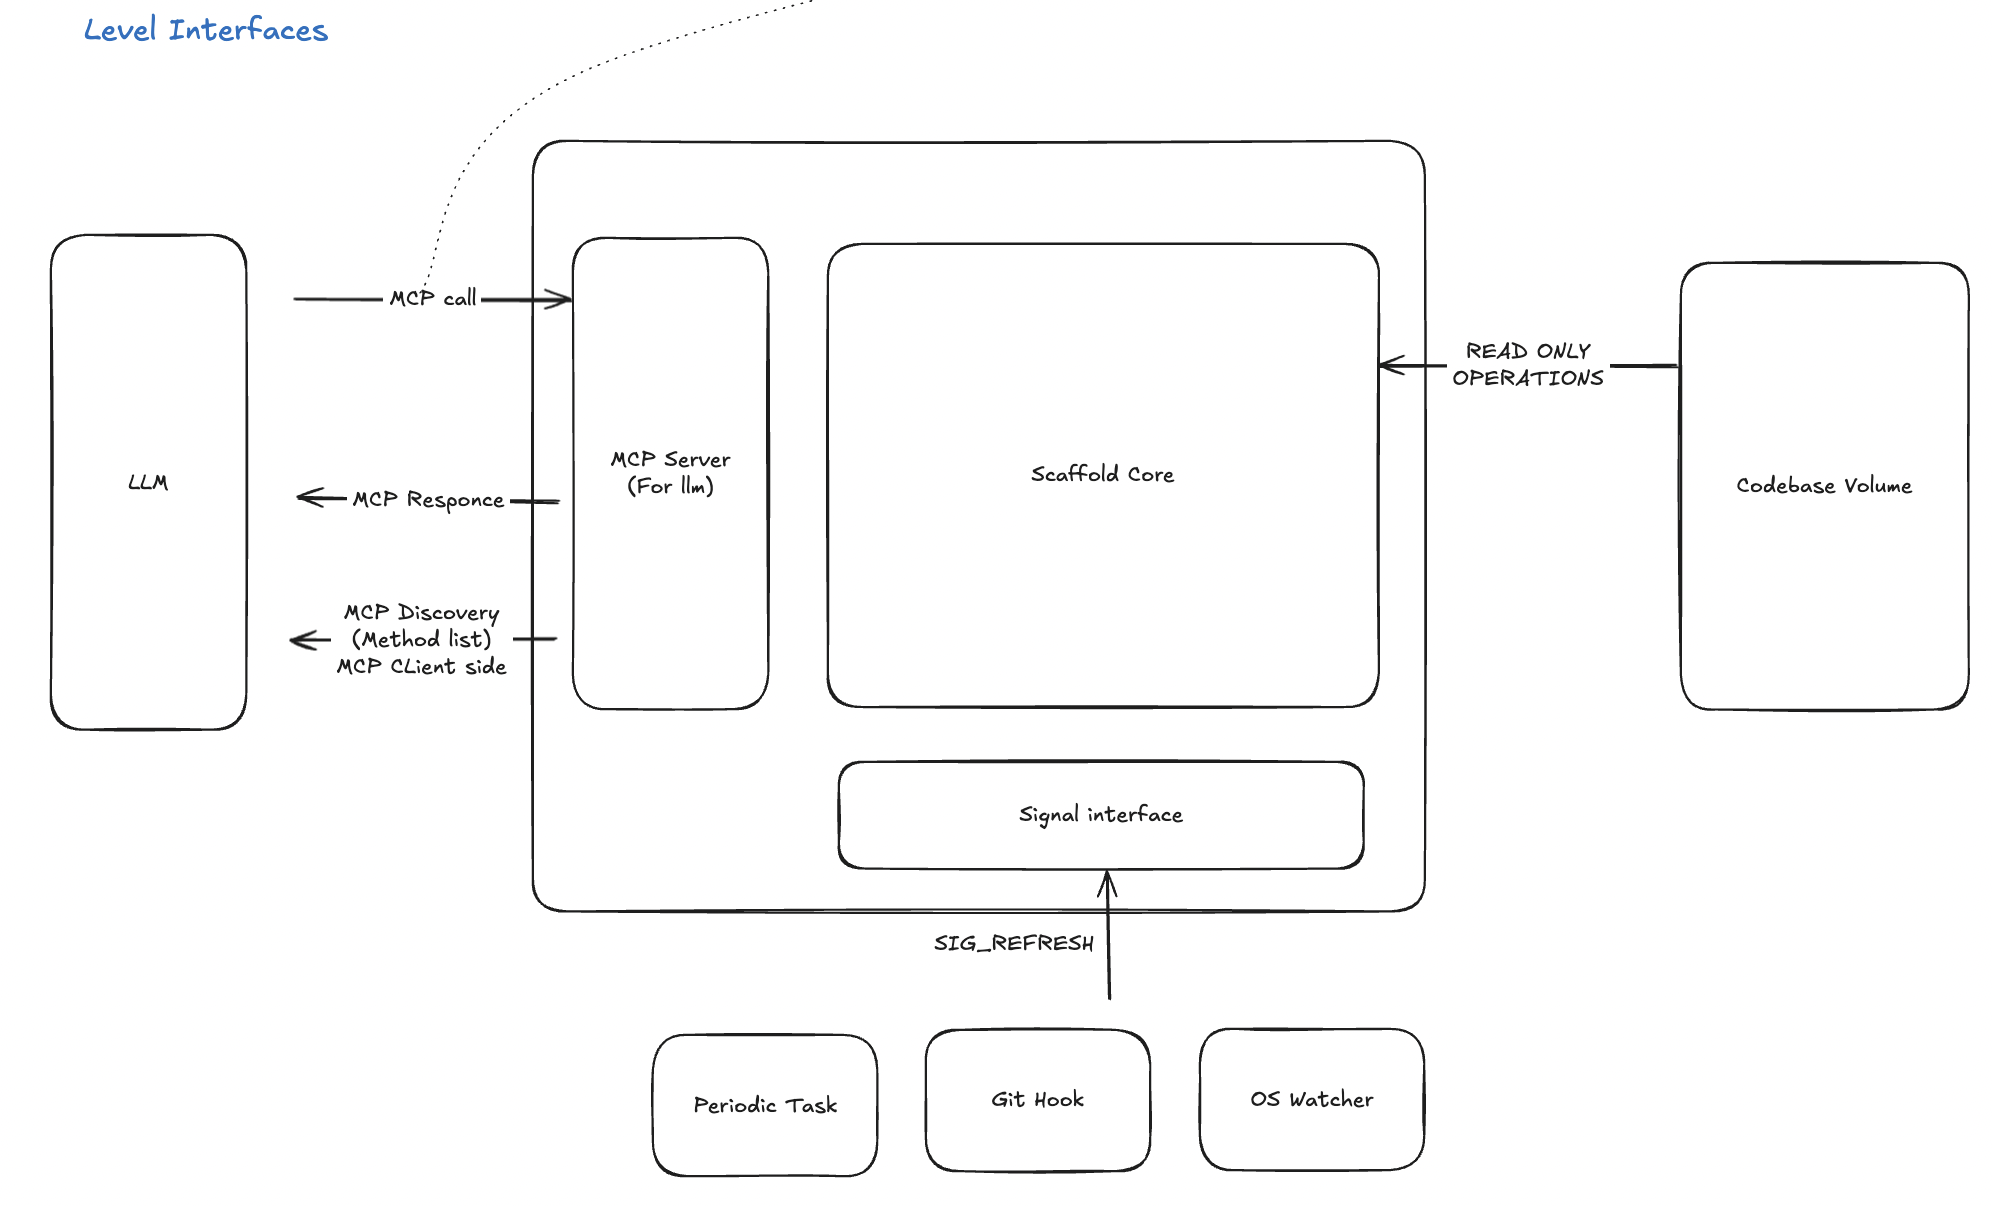
ユースケースとインターフェースの図
その他の図を表示
ユースケース図
インターフェース図
プロジェクト構成
.
├── docs
│   ├── img       # Static Images
│   └── research  # Research reports
└── src
    ├── core      # RAG Context Fetching Algorithms
    ├── database  # Graph/Vector Database Logic
    ├── generator # Abstract Tree Generator
    ├── mcp       # MCP Interface
    └── parsers   # AST Parcers
FAQ
RAG(検索拡張生成)とは何ですか?
RAG(検索拡張生成)は、次の方法で大規模言語モデル(LLM)を強化する技術です。
- 外部のナレッジソースから関連情報を取得します
- 取得した情報でLLMのコンテキストを拡張します
- より正確で、コンテキストを踏まえた応答を生成します
学習データのみに依存する従来のLLMとは異なり、RAGシステムは最新のプロジェクト固有の情報にアクセスし、実際のコードベースのコンテキストに基づいて応答することで、ハルシネーションを減らします。
Graph RAGはどのように機能しますか?
Graph RAGは、知識をグラフデータベース内の相互に関連するエンティティとして表現することで、従来のRAGを拡張します。これにより、システムはテキストの断片だけでなく、それらの構造的な関係(例:この関数が別の関数をcallsする、このクラスが別のクラスをinherits fromする)も理解して取得できます。この構造的なコンテキストは、複雑なソフトウェアエンジニアリングタスクにおいて非常に役立ちます。
リソース
コントリビューション
Scaffoldはオープンソースプロジェクトです。コミュニティからのコントリビューションを歓迎します。バグの報告、機能についての議論、コードの提出など、皆さんのご協力を大切にしています。
まずは**コントリビューションガイドライン**をお読みください。開発環境のセットアップ方法、テストの実行方法、プルリクエストの提出方法について説明しています。
ライセンス
このプロジェクトはMITライセンスの下でライセンスされています。詳細はLICENSEファイルをご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。