Semble について
Semble はコーディングエージェント向けのローカルコード検索ライブラリ、CLI、MCP サーバーです。CPU 上でローカルパスや GitHub リポジトリを検索し、インデックスをキャッシュして関連コードを返します。API キーや外部サービスは不要です。
主な機能
- 01自然言語とコードによる検索
- 02ローカルと Git リポジトリの検索
- 03ファイル位置から関連コードを検索
- 04キャッシュと差分インデックス更新
- 05API キー不要の CPU 動作
活用シーン
- 01コードベースの実装箇所を探す
- 02関連リポジトリを横断検索
- 03既知のファイルと行から類似コードを探す
- 04コーディングエージェントに関連スニペットを提供
MCP 対応
Semble は MCP クライアントに `search` と `find_related` ツールを提供します。エージェントはローカルパスや HTTPS の Git URL を検索でき、インデックスは必要時に作成され、ローカルファイルの変更に応じて更新されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
2掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| mode | enum | いいえ | 検索モード。ほとんどのクエリでは 'hybrid' が最適です。hybrid | semantic | bm25 |
| query | string | はい | 自然言語またはコードクエリ。 |
| repo | any | いいえ | インデックス作成と検索に使用する Git URL(例:https://github.com/org/repo)またはローカルパス。起動時にデフォルトインデックスが設定されていない場合は必須です。初回呼び出し後はインデックスがキャッシュされるため、繰り返しのクエリは高速になります。 |
| top_k | integer | いいえ | 返す結果の数。 |
詳細
翻訳後に原文が更新されています。最新の内容は原文をご確認ください。
エージェント向けの高速かつ高精度なコード検索
grep+read と比べてトークンを約99%削減


Semble は、エージェント向けに構築されたコード検索ライブラリです。必要なコードスニペットだけを即座に返し、grep+read と比べてトークンを約99%削減します。コードベース全体のインデックス作成と検索は、ほとんどのリポジトリで最初から最後まで1秒未満で完了します。コード特化型トランスフォーマーと同等の検索品質を実現しながら、インデックス作成は約480倍、クエリ処理は約23倍高速です(ベンチマークを参照)。すべてCPU上で動作し、APIキー、GPU、外部サービスは不要です。MCP サーバー、AGENTS.md 経由の CLI ツール、または専用のサブエージェントとして利用でき、あらゆるコーディングエージェント(Claude Code、Cursor、Codex、OpenCode など)が任意のリポジトリに即座にアクセスできます。
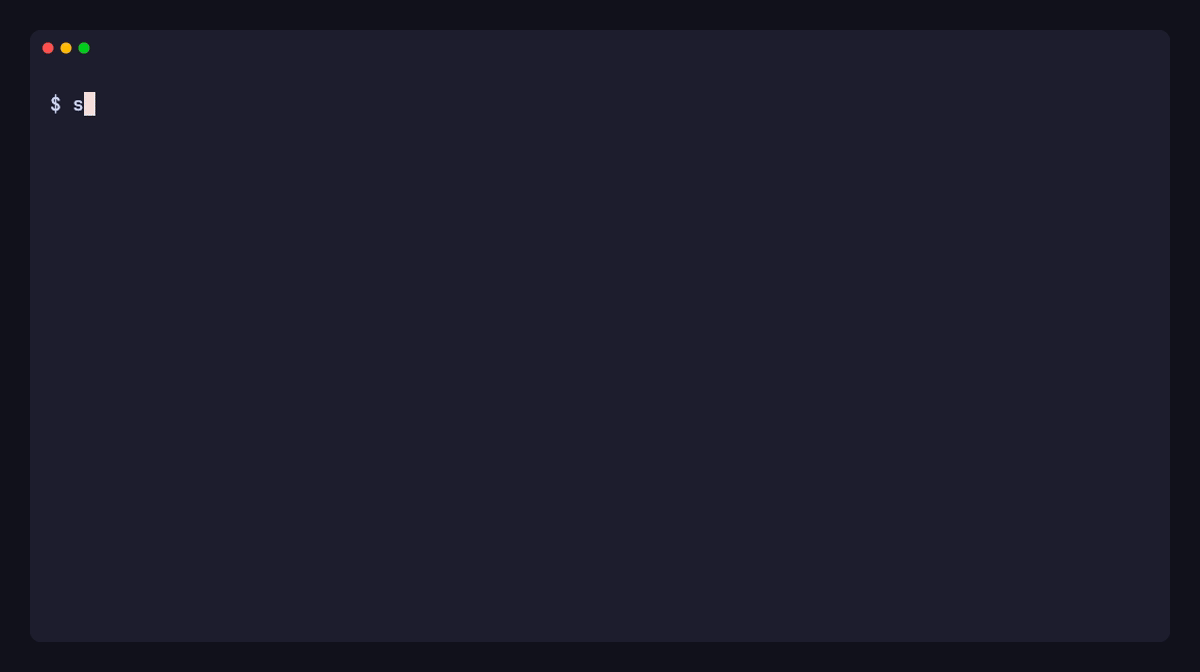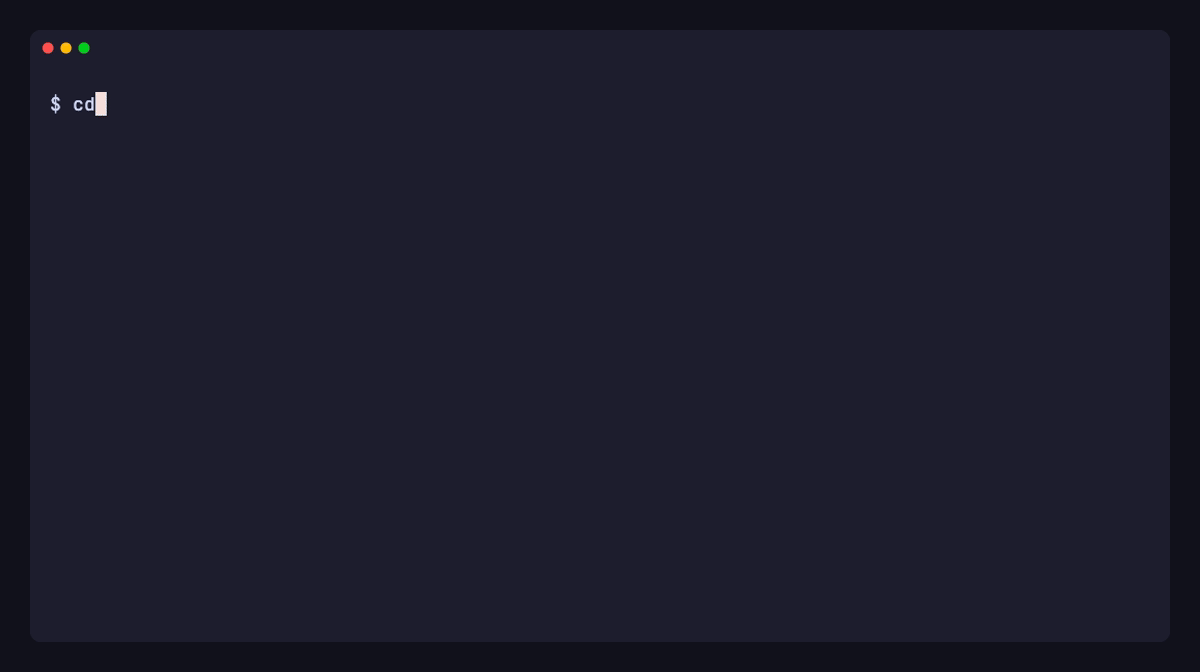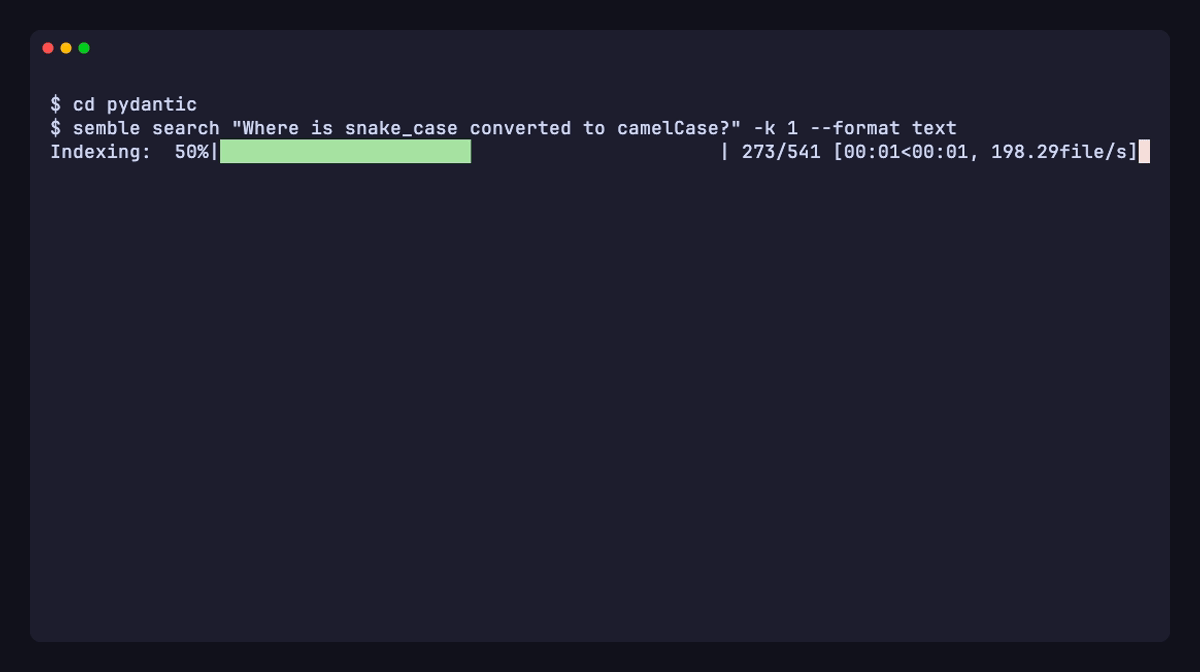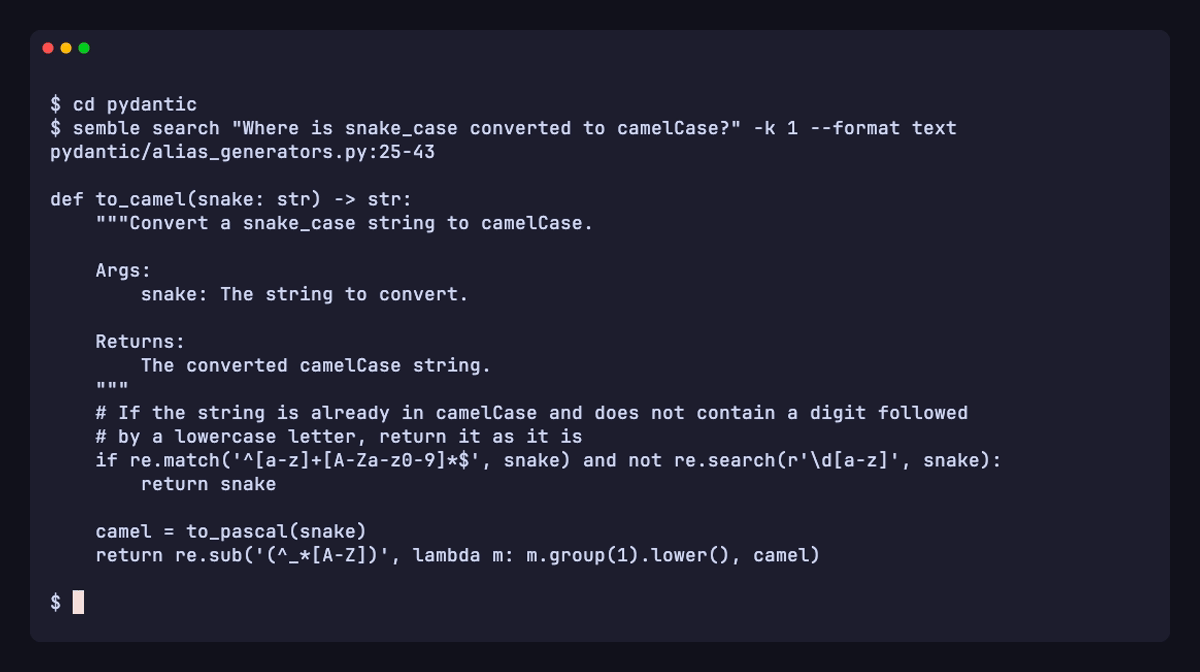
クイックスタート
エージェントは自然言語(例:"How is authentication handled?")で Semble にクエリを送信し、grep やファイル全体の読み込みを行わずに、関連するコードスニペットだけを取得します。
最も手早く始めるには、対話型インストーラーを使用します。uv をインストールしてから、次を実行します。
uv tool install semble
semble install
semble install は、Claude Code、Codex、OpenCode など、インストール済みのコーディングエージェントを検出し、有効にする連携機能を選択できるようにします。
- MCP サーバー:エージェントが Semble を直接ツールとして呼び出せるようにします。
- 指示:CLI の使い方に関するガイダンスを AGENTS.md / CLAUDE.md に追加します。
- サブエージェント:専用の
semble-searchサブエージェントをインストールします。
設定を元に戻すには、semble uninstall を実行します。
手動での設定手順(エージェントごとの MCP 設定、AGENTS.md のスニペット、サブエージェントのファイル)については、インストールのドキュメントを参照してください。
Semble の更新
uv tool upgrade semble   # upgrade
uv cache clean semble    # for MCP users (restart your MCP client after)
無人インストール
サンドボックス環境またはスクリプト環境では、--agent と、必要に応じて --type を指定してプロンプトを省略できます。
semble install --agent claude --type mcp subagent --yes
--agent には1つ以上のエージェント ID(例:claude、codex、pi)を指定できます。--type には mcp、instructions、subagent、all(デフォルト:all)を指定できます。--yes は確認プロンプトを省略します(完全な非対話型実行には --agent が必要です)。
- 高速:平均的なリポジトリを約 500 ms でインデックス化し、クエリに約 1 ms で回答します。すべて CPU 上で実行されます。
- 高精度:ベンチマークで NDCG@10 0.855 を達成しています。コードに特化したトランスフォーマーモデルに匹敵する精度を、はるかに小さなサイズと低コストで実現します。
- トークン効率:関連するチャンクのみを返すため、grep+read と比べてトークンを約 99% 削減できます。
- セットアップ不要:API キー、GPU、外部サービスは不要で、CPU 上で動作します。
- MCP サーバー:Claude Code、Cursor、Codex、OpenCode、VS Code、およびその他の MCP 対応エージェントで動作します。
- ローカルとリモート:ローカルパスまたは git URL を 1 つ、あるいは複数指定して、関連するリポジトリをまとめて検索できます。
CLI
Semble はスタンドアロン CLI としても利用できます。スクリプト内や、MCP セッションなしで検索結果を取得したい場合に便利です。インデックスは初回実行時に作成されてキャッシュされ、ファイルの変更時に自動的に無効化されます。
# Search a local repo (index is built and cached automatically)
semble search "authentication flow" ./my-project

# Search a remote repo (cloned on demand)
semble search "save model to disk" https://github.com/MinishLab/model2vec

# Search several repos at once (results are prefixed with the repo name)
semble search "invoice endpoint" ./service-a ./service-b

# Limit results
semble search "save model to disk" ./my-project --top-k 10

# Search docs/config/everything instead of just code
semble search "deployment guide" ./my-project --content docs   # or: config, all

# Find code similar to a known location
semble find-related src/auth.py 42 ./my-project

# Show only the first N lines of each result's snippet (0 = path/line range only)
semble search "authentication flow" ./my-project --max-snippet-lines 10
--content は code(デフォルト)、docs、config、または all を受け付けます。--format は json(デフォルト)または text を受け付けます。path を省略した場合はカレントディレクトリがデフォルトになり、git URL も指定できます。semble が $PATH にない場合は、代わりに uvx --from "semble[mcp]" semble を使用してください。semble --version(または -V)を実行すると、インストールされているバージョンが表示されます。
複数のパスまたは URL を渡すと、それらを 1 つのコーパスとして検索するため、リポジトリ A からのクエリでリポジトリ B に定義されたエンドポイントを見つけられます。各インデックスはリポジトリごとにキャッシュされ、クエリ時に統合されます。結果のパスにはリポジトリ名が接頭辞として付加され(service-b/api/invoices.py)、出力には接頭辞から絶対パスまたは URL への対応を示す repos マップが含まれます。既知の場所からすべてのリポジトリを横断して検索するには、接頭辞付きのパスを find-related に渡します。
インデックス化するファイルの制御
Semble は .gitignore と .sembleignore ファイルを読み取り、インデックス化するファイルを決定します。どちらのファイルも標準的な gitignore 構文を使用し、パターンは統合されます。.sembleignore を使えば、.gitignore に手を加えずに Semble 固有のルールを追加できます。ルールは再帰的に適用されるため、サブディレクトリ内の .sembleignore はそのサブツリーに適用されます。
ファイルを除外する: .gitignore と同じ方法でパターンを追加します。
# .sembleignore
generated/     # exclude generated dir
*.pb.go.       # exclude Go protobuf files
デフォルト以外の拡張子を含める: 拡張子のパターンの先頭に ! を付けると、Semble がデフォルトではインデックス化しないファイルも強制的に含められます。
# .sembleignore
!*.proto       # include Protobuf files
!*.cob         # include COBOL files
semble file-types を実行すると、コンテンツタイプごとにインデックス化される拡張子を確認できます。一覧にない拡張子(.json や .csv などのデータファイルを含む)はデフォルトではインデックス化されませんが、上記のように ! パターンを使って強制的に含められます。
また Semble は、無視ファイルの設定にかかわらず、よく知られたソース以外のディレクトリ(node_modules/、.venv/、dist/、build/、__pycache__/ など)を常にスキップします。
節約量
semble savings を実行すると、すべての検索を通じて Semble が節約したトークン数を確認できます。
semble savings
  Semble Token Savings
  ════════════════════════════════════════════════════════════════════════

  Total saved:  ~714.2M tokens  (94%)
  Total calls:  14.3k
  Efficiency:  ███████████████████████░  94%

  By Period
  ────────────────────────────────────────────────────────────────────────
  Period             Calls           Saved  Ratio
  ────────────────────────────────────────────────────────────────────────
  Today                198    ~1.4M tokens  ███████████████████████░  95%
  Last 7 days        13.1k  ~707.2M tokens  ███████████████████████░  94%
  All time           14.3k  ~714.2M tokens  ███████████████████████░  94%

  By Call Type
  ────────────────────────────────────────────────────────────────────────
  #     Call type            Calls  Share
  ────────────────────────────────────────────────────────────────────────
  1.    search               14.1k  ████████████████    99%
  2.    find_related           205  █░░░░░░░░░░░░░░░     1%
  ════════════════════════════════════════════════════════════════════════
節約量は次のように計算されます。呼び出しごとに、Semble は返されたチャンクを含む一意なファイルの合計文字数と、返されたスニペットの文字数を記録します。推定節約トークン数は (file chars − snippet chars) / 4(1 トークンあたり 4 文字)です。これは控えめな推定です。ベースラインでは、コーディングエージェントが不慣れなコードを調査する際によく行う方法である、該当ファイル全体の読み込みを想定しています。
ストレージ
デフォルトでは、Semble の節約統計と保存済みインデックスは、OS のキャッシュフォルダー(macOS では ~/Library/Caches/semble/、Linux では ~/.cache/semble/、Windows では %LOCALAPPDATA%\semble\Cache\)に保存されます。保存先を変更するには、環境変数 SEMBLE_CACHE_LOCATION に、保存先となるキャッシュフォルダーのフルパス(例:~/my-folder/my-caches/semble)を指定します。
初回使用時には、Semble が Hugging Face から埋め込みモデルもダウンロードし、標準の Hugging Face キャッシュ(デフォルトでは ~/.cache/huggingface/、または $HF_HOME が設定されている場合はその場所)に保存します。これは一度だけ行われ、ネットワークへの接続が必要です。
キャッシュデータを削除するには、semble clear を使用します。semble clear index(保存済みインデックス)、semble clear savings(使用状況の統計)、semble clear orphans(ディスク上に存在しなくなったリポジトリのインデックス)、または semble clear all(すべて)を実行します。
ライブラリの使用方法
Semble は、プログラムからアクセスするための Python ライブラリとしても使用できます。カスタムツールの構築や、検索機能を独自のコードに直接統合する場合に便利です。
from semble import ContentType, SembleIndex

# Index a local directory (code only, the default)
index = SembleIndex.from_path("./my-project")

# Index docs and prose (markdown, rst, etc.)
index = SembleIndex.from_path("./my-project", content=ContentType.DOCS)

# Index everything (code, docs, and config)
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS, ContentType.CONFIG])

# Index code and docs together
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS])

# Index a remote git repository
index = SembleIndex.from_git("https://github.com/MinishLab/model2vec")

# Merge indexes from several repos into one (chunk paths are prefixed with the repo name)
index = SembleIndex.merge([("./service-a", SembleIndex.from_path("./service-a")), ("./service-b", SembleIndex.from_path("./service-b"))])

# Search the index with a natural-language or code query
results = index.search("save model to disk", top_k=3)

# Find code similar to a specific result
related = index.find_related(results[0], top_k=3)

# Each result exposes the matched chunk
result = results[0]
result.chunk.file_path   # "model2vec/model.py"
result.chunk.start_line  # 127
result.chunk.end_line    # 150
result.chunk.content     # "def save_pretrained(self, path: PathLike, ..."
多数のファイルをインデックスする必要がある場合、CLI と MCP サーバーは 4 つのワーカープロセスでファイルをチャンクに分割します(SEMBLE_INDEX_WORKERS で数を設定でき、0 で無効になります)。Python API ではデフォルトで無効です。有効にするには、SEMBLE_INDEX_WORKERS を設定し、各ワーカーがスクリプトを再インポートするため、if __name__ == "__main__": ブロック内から Semble を呼び出してください。
MCP サーバー
Semble は MCP サーバーとして動作するため、エージェントはネイティブのツール呼び出しで任意のコードベースを直接検索できます。リポジトリは必要に応じてインデックス化され、キャッシュされます。ローカルパスは、ファイルの変更時に自動で再インデックスされます。
| ツール | 説明 |
|---|---|
search | 自然言語またはコードのクエリでコードベースを検索します。repo にはローカルパスまたは https:// の Git URL を指定します(複数のリポジトリをまとめて検索する場合はリストを指定します)。content には code、docs、config、all のいずれかを指定します(デフォルト:code)。 |
find_related | ファイルパスと行番号を指定すると、その位置のコードと意味的に類似したチャンクを返します。 |
エージェントごとのセットアップ手順については、インストールのドキュメントを参照してください。
ベンチマーク
19 言語の 63 個のリポジトリにわたる約 1,250 件のクエリで品質と速度をベンチマークし(左)、同等の再現率における grep+read と比較したトークン効率も測定しています(右)。
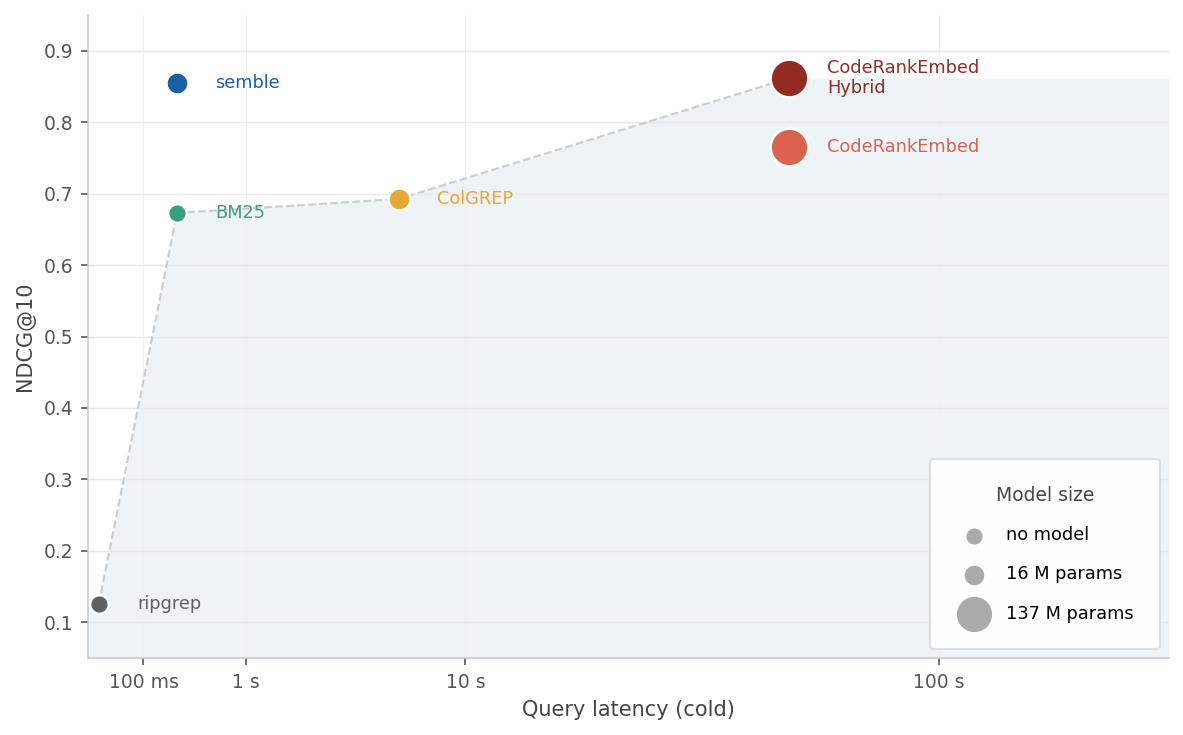 | 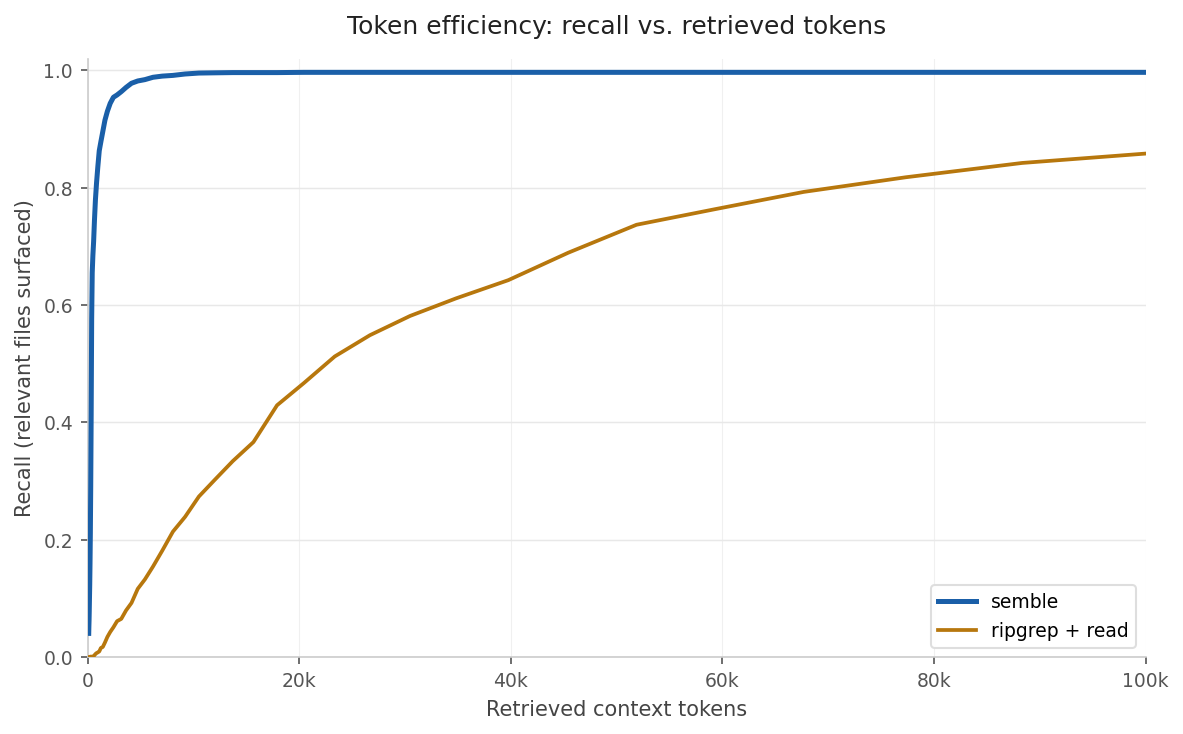 |
品質ベンチマーク(左)では、検索品質(NDCG@10)と合計レイテンシを評価します。Semble は、137M パラメーターの CodeRankEmbed と同等の品質を保ちながら、インデックス作成を 480 倍高速に行います。トークン効率ベンチマーク(右)では、各手法が特定の再現率に達するために必要なトークン数を測定します。Semble は平均でトークン数を 99% 削減し、わずか 2k トークンで再現率 96% に達します。一方、grep+read は再現率 85% に達するために、100k のコンテキストウィンドウ全体を必要とします。言語ごとの結果、アブレーション、詳細な手法については、ベンチマークを参照してください。
仕組み
Semble は tree-sitter を使って各ファイルをコードを考慮したチャンクに分割し、相補的な 2 つの検索手法で各クエリとチャンクを照合してスコアを付けます。意味的類似性には、コードに特化した potion-code-16M-v2 モデルを使用した静的な Model2Vec 埋め込みを使い、識別子や API 名の字句的一致には BM25 を使います。2 つのスコアリストは、Reciprocal Rank Fusion(RRF)で統合されます。
統合後、コードを考慮した一連のシグナルで結果を再ランキングします。
ランキングシグナル
- 適応的な重み付け。 記号のようなクエリ(
Foo::bar、_private、getUserById)では字句検索の重みを高め、自然言語のクエリでは意味検索と字句検索のバランスを保ちます。 - 定義のブースト。 クエリされたシンボルを定義するチャンク(
class、def、funcなど)は、単にそのシンボルを参照するだけのチャンクより上位にランク付けされます。 - 識別子の語幹。 クエリのトークンを語幹化し、チャンク内の識別子の語幹と照合して、一致するものを含むチャンクに追加の重みを与えます。たとえば、
parse configを検索すると、parseConfig、ConfigParser、config_parserを含むチャンクがブーストされます。 - ファイルの一貫性。 同じファイルの複数のチャンクがクエリに一致する場合、そのファイルをブーストし、文脈から外れた単一チャンクではなく、ファイル全体の関連性が結果の上位に反映されるようにします。
- ノイズのペナルティ。 テストファイル、
compat//legacy/のシム、サンプルコード、.d.tsの宣言スタブは順位を下げ、正規の実装が先に表示されるようにします。
埋め込みモデルは静的で、クエリ時に Transformer のフォワードパスを実行しないため、これらの処理はすべて CPU 上で数ミリ秒以内に完了します。
インデックスは初回の検索時に自動的にディスクへキャッシュされます。2 回目以降は、Semble がファイルツリーを走査して更新日時を比較し、追加、削除、変更されたファイルだけを段階的に再インデックスします。インデックス全体の再構築が行われるのは、インデックス設定が変更された場合に限られます(たとえば、モデル、チャンク化、キャッシュ形式が変更される Semble のアップグレード後など)。MCP モードでは、ファイルの変更に応じてインデックスが自動的に確認、更新されるため、セッション中も検索結果が最新の状態に保たれます。
カスタムモデルの使用
別のモデルを使用する場合は、SEMBLE_MODEL_NAME 環境変数にローカルパスまたは Hugging Face リポジトリを設定します。このパスはそのまま読み込まれるため、Model2Vec 互換モデルが含まれている必要があります。これは、実行時に Hugging Face にアクセスできない場合に特に便利です。
謝辞
AI コードレビュー・プラットフォームを無料で利用できるようにしてくださった Greptile に感謝します。
ライセンス
MIT
引用
研究で Semble を使用する場合は、以下を引用してください。
@software{minishlab2026semble,
  author       = {{van Dongen}, Thomas and Stephan Tulkens},
  title        = {Semble: Fast and Accurate Code Search for Agents},
  year         = {2026},
  publisher    = {Zenodo},
  doi          = {10.5281/zenodo.19785932},
  url          = {https://github.com/MinishLab/semble},
  license      = {MIT}
}
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。