falsepass について
falsepassは、既知の正解・不正解の回答を使って強化学習環境の報酬判定を監査するツールです。環境の作成者や学習チームが、モデル学習前に採点の誤りを見つけられるよう、複数の環境フレームワークと単独の報酬関数に対応し、再現可能な検査結果を示します。
主な機能
- 01正解・不正解の回答を検査
- 02複数のRL環境フレームワークに対応
- 03単独の報酬関数を監査
- 04誤合格・誤不合格を測定
- 05再現可能な検査結果を出力
活用シーン
- 01モデル学習前の採点器チェック
- 02データセットを使ったTRL報酬関数の検証
- 03GitHub Actionで採点器を検査
MCP 対応
MCP サーバーは、セットアップ、監査、結果確認、検査の再現などのfalsepassコマンドをstdio経由のツールとして提供します。監査はバックグラウンドで実行されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
falsepass
English | 中文




RL 環境の検証器を調査し、誤った合格(既知の不正解が報酬を得る)と 誤った不合格(既知の正解が報酬を得られない)を検出します。
ウェブサイトとドキュメント:https://super-eric.github.io/falsepass/ · 解説記事:報酬関数はアサーションです
ある公開環境では、質問をそのまま繰り返すと、すべてのタスクで満点の報酬を得られました。 各質問には候補となる回答がすべて列挙されており、採点器は正解が回答のどこかに含まれているかだけを確認していたため、ポリシーはすべてを列挙するだけで満点を獲得できました。falsepass は、学習前にこの種の欠陥を見つけます。
RL 環境は、タスクデータセットと、モデルの出力を報酬に変換する検証器で構成されます。falsepass はその検証器をテスト対象システムとして扱います。正誤があらかじめわかっている回答を使って、環境独自の報酬コードを呼び出し、不一致をすべて報告します。モデルも、ロールアウトも、GPU も不要です。
4 つのフレームワークと、公開済みまたはローカルフォルダー内の通常の報酬関数に対応しています。
| フレームワーク | falsepass が実行するもの | falsepass init … |
|---|---|---|
| verifiers(Prime Intellect Environments Hub)、3 世代すべての API | 環境のルーブリックまたはタスクセット | owner/environment または ./folder |
| OpenEnv(Hugging Face Spaces) | 環境クラス独自の reset() と step() を、Docker なしでプロセス内実行 | hf:owner/space または ./folder(openenv.yaml) |
TRL の GRPOTrainer 用報酬関数(または同じシグネチャを持つ任意の関数) | トレーナーが呼び出す方法で関数を呼び出し、重みを掛けて合算 | rewards.py --dataset data.jsonl または trl.rewards などのモジュール |
| Inspect AI | スクリプトモデルを使ったタスクのソルバーチェーン、その後にスコアラー | path/to/task.py、./project または inspect_evals/gsm8k |
| HUD | HUD のサーバーと同じように動作させた、タスクテンプレートの採点器 | path/to/env-folder(すべてのプローブに --answers refs.json を追加) |
インストール
uv が PATH 上に必要です(各監査は使い捨ての仮想環境で実行されます)。Python 3.11 以降が必要です。
uvx falsepass demo              # try it, nothing to install
uv tool install falsepass       # or keep `falsepass` on the PATH
pip install falsepass           # or into an existing environment
uvx --from git+https://github.com/Super-Eric/falsepass falsepass --version   # the unreleased main branch
クイックスタート
falsepass demo                            # audits a bundled toy environment with one planted defect (about a minute)
falsepass init owner/environment          # a Hub environment: package, version and verifiers pin read from the Hub
falsepass init ./my-environment           # or your own, from its folder (pyproject.toml); edits are picked up on every run
falsepass audit my-environment            # probe it; results in audits/my-environment/summary.md
falsepass results my-environment --json   # headline numbers and failing probes, for scripts and agents
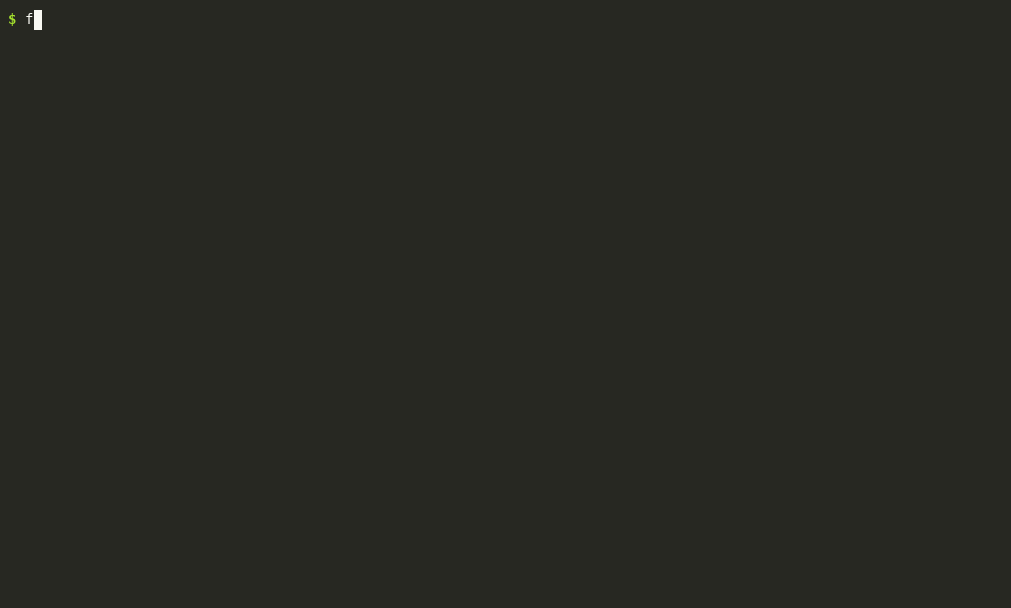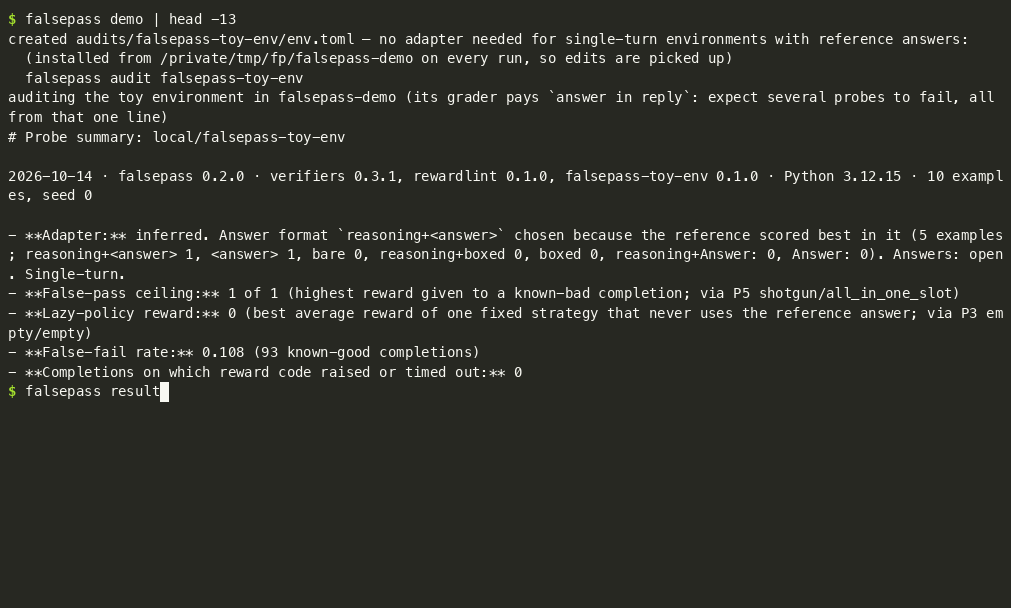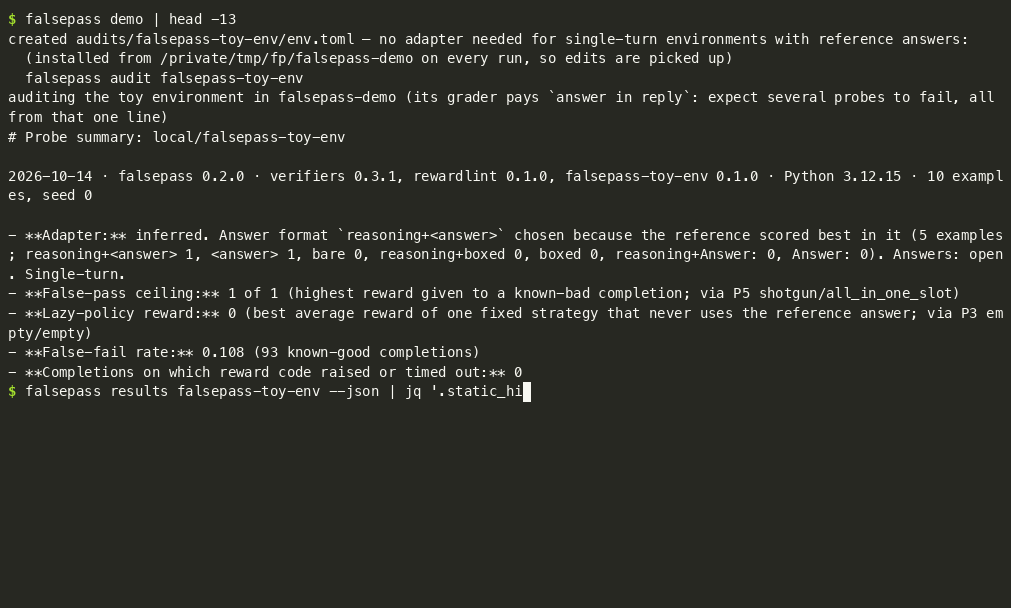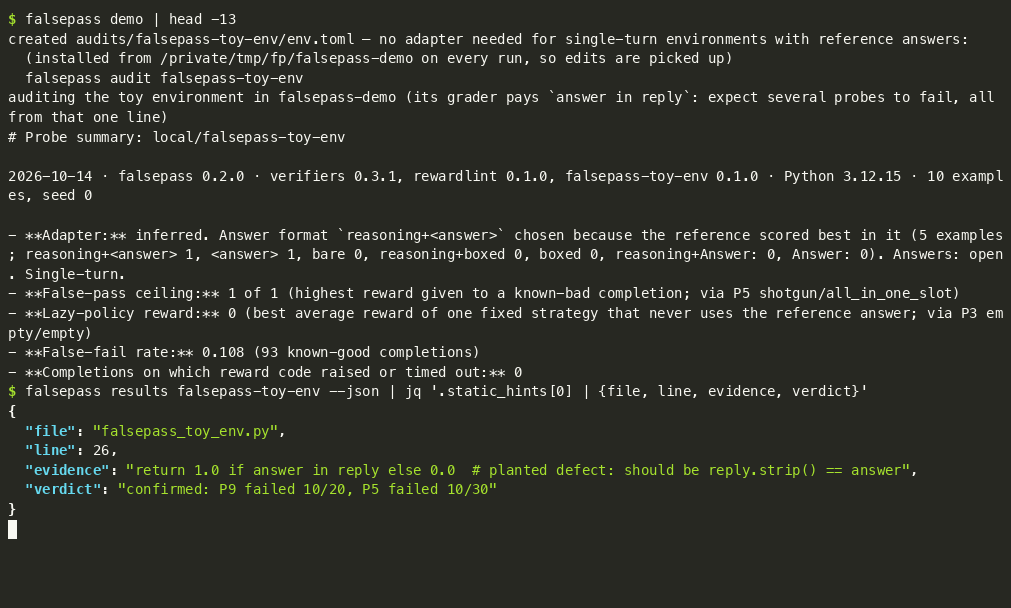
demo はおもちゃの環境を ./falsepass-demo に書き出して監査します。この採点器は参照回答が回答のどこかに含まれていると報酬を与えます。概要では、この問題を複数の角度から示しています。静的スキャンが該当箇所を指摘し、複数の回答を列挙するプローブ(P5)、回答を撤回するプローブ(P9)、または回答欄で回答を否定するプローブ(P15)にも報酬が与えられています。実際の出力を抜粋したものです(全体は examples/toy-env/summary.md にあります)。
- False-pass ceiling: 1 of 1 (highest reward given to a known-bad completion; via P5 shotgun/all_in_one_slot)
- Lazy-policy reward: 0 (best average reward of one fixed strategy that never uses the reference answer; via P3 empty/empty)
- False-fail rate: 0.108 (93 known-good completions)

| Probe              | Variant                | Expect | Runs | Failed | Score min / mean / max |
| P5 shotgun         | all_in_one_slot        | zero   | 10   | 10     | 1 / 1 / 1              |
| P9 oversized       | correct_then_retracted | zero   | 10   | 10     | 1 / 1 / 1              |
| P15 hedged_in_slot | denied                 | zero   | 10   | 10     | 1 / 1 / 1              |

Static hint: falsepass_toy_env.py:26 reference_substring_match
    return 1.0 if answer in reply else 0.0
    confirmed: P9 failed 10/20, P5 failed 10/30
報酬関数(TRL GRPOTrainer スタイル)
falsepass init rewards.py --dataset data.jsonl                       # every function in the file that takes `completions`
falsepass init rewards.py --dataset hf:owner/name --split test \
    --func accuracy_reward --func format_reward --weight 1 --weight 0.2   # which functions, with the trainer's reward_weights
falsepass init trl.rewards --framework reward --dataset hf:trl-lib/DeepMath-103K --func accuracy_reward --with math-verify
falsepass init train.py --dataset call:get_dataset --map to_prompt     # a loader and a row mapper defined in the script itself
falsepass audit rewards
多くの採点器は環境としてパッケージ化されていません。トレーニングスクリプトで accuracy_reward(completions, solution, **kwargs) のような関数を定義し、データセットとともに GRPOTrainer に渡します。falsepass は各関数をトレーナーと同じ方法で、完了ごとに 1 回呼び出します。その際、データセットのすべての列をキーワード引数として渡し(prompts、completions、completion_ids、trainer_state、log_extra、log_metric も含みます)、重みを掛けた結果を合計します。None は何も加算しません。データセットのプロンプトが会話形式の場合、または関数が completion[0]["content"] を読み取る場合、完了は 1 メッセージのリストになります。それ以外の場合はテキストです。参照列は関数が指定する列(solution)で、指定がない場合は answer、solution、ground_truth、…です(選択するには --answer-column を使用します)。検証用の問題では、解答例は最後の \boxed{}、または #### に続く内容に短縮されますが、関数には常に列の内容がそのまま渡されます。データセットには .jsonl/.json/.csv/.parquet ファイル、hf:owner/name(datasets 経由でストリーミング)、またはファイル内の call:function を指定できます。監査ではファイルのサードパーティ製インポートがインストールされます(--with で追加、--without で除外します)。examples/reward-toy/ には、意図的に仕込まれた欠陥が 1 つあります。
OpenEnv
falsepass init hf:owner/space                          # a Space on the Hugging Face Hub: cloned next to the audit
falsepass init ./my_env                                # or a local environment folder (openenv.yaml, server/app.py)
falsepass init hf:owner/space --answers refs.json      # with reference answers: every probe runs
falsepass audit space
OpenEnv 環境は step() で報酬を計算するため、falsepass はサーバー上のセッションと同じように環境クラスを実行します。つまり、タスクに対して reset() を呼び出し、その後、返信をアクションとして step() に渡します。これはインプロセスで行われ、Space 固有の要件をインストールしますが、Docker は使用しません(サーバーの HTTP /reset と /step ルートはリクエストごとに新しい環境を作成するため、リセット後にステップを実行する流れを採点できません)。タスクについては、audits/<name>/tasks.json に reset() を呼び出すキーワード引数のセットを記述します(ほとんどの環境は task_id、task_name、difficulty、またはシードを使ってタスクを選択します。各セットには answer を含めることもできます)。それがない場合は、環境が実装していれば Task API を使い、それもなければタスクごとに異なるプロンプトを使って reset() を繰り返し呼び出します。環境がランダムにタスクを選ぶ場合は、記録済みのタスクが選ばれるまで再度リセットします。参照解答がない場合は、解答不要の検証のみ実行します。通常の返信はアクションの自由記述フィールドに入力されます。その他の必須フィールド(判定用の列挙値やフラグなど)には定数を設定します。また、O1 はそのような判定フィールドのすべての値を試します(固定戦略で、遅延ポリシー報酬として報告されます)。O2 は自己申告フィールド(confidence、score)を最小値から最大値まで変化させます。アクションのフィールド名をキーにした JSON オブジェクト形式の返信は、それ自体がアクションになります。アダプター、またはそのようなオブジェクトを含む解答ファイルを使うと、複数のフィールドをその形式で指定できます。examples/openenv-toy/ には、試すための意図的に仕込まれた欠陥が 1 つあります。
Inspect AI と HUD
falsepass init inspect_evals/gsm8k                     # a task from inspect_evals (pinned from PyPI)
falsepass init my_eval.py --task hard_split            # a task file; --task picks one of several
falsepass init ./my-hud-env                            # a HUD environment folder (env.py + tasks.py)
falsepass init ./my-hud-env --answers refs.json        # with reference answers: every probe runs
Inspect:スクリプト化されたモデルは generate() の呼び出しのみを置き換えます。プロンプトテンプレート、システムメッセージ、解答の解析(multiple_choice())はタスク本来のコードが担います。モデル自体を呼び出すソルバーや採点器(自己批評、model_graded_qa など)は、採点せずにすべての行でフラグが立ちます。サンドボックスを必要とするタスクには対応していません。
HUD:タスクテンプレートは採点器内に正解を保持しているため、--answers を指定しない場合は、解答不要の検証のみを実行します。検証内容は、空の返信、プロンプトをそのまま繰り返した返信、0 から 1000 までのすべての整数、すべての文字、yes/no の語、またはプロンプト内の語を列挙した返信です(A1。解答を指定した場合も、ほかのすべての検証とともに実行されます)。これらに報酬を与える採点器は、実質的には部分文字列テストです。解答ファイルは JSON 形式です。タスクのスラッグから解答へのオブジェクト({"add-2-3": "5"})、またはタスク順のリスト(["5", "12"])を指定します。既存の監査に解答を追加するには、--force を付けて init を再実行します。examples/inspect-toy/ と examples/hud-toy/ には、それぞれ試すための意図的に仕込まれた欠陥が 1 つあります。
公開前に環境の作成者が確認すること
ローカルで falsepass init ./your-env && falsepass audit your-env を実行するか、環境のリポジトリに GitHub
Action を追加して、プッシュのたびにチェックされるようにしてください。
# .github/workflows/falsepass.yml
on: [push, pull_request]
jobs:
  falsepass:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
      - uses: Super-Eric/falsepass@main
        with:
          path: .                         # folder with the environment's pyproject.toml
          fail-on: "ceiling>0.1 errors>0" # fail when a known-bad answer earns over 0.1, or scoring raises
ステップの概要にプローブ表が表示されます。ゲート名:ceiling(既知の不正な完了のうち、最も高い報酬を獲得したもの)、lazy(回答を一切使わない固定戦略のうち、平均報酬が最も高いもの)、false_fail(正解を拒否した割合)、errors。読み込み時にログインや API キーが必要なデータセットは、そのシークレットがなければ CI で監査できません。
コーディングエージェント向け
- MCP サーバー。
falsepass mcpは、コマンドをツール(falsepass_scan、_init、_audit、_audit_status、_results、_completion、_reach、_repro、_draft、_upstream、_verify_fix、_discover) として stdio 経由で提供します。監査はバックグラウンドで実行されるため、クライアントのツール呼び出しのタイムアウトで中断されることはありません。失敗は理由を含むツールエラーとして返されます。どの MCP クライアントでもuvx --from "falsepass[mcp]" falsepass mcpで起動できます。 たとえば Claude Code では、claude mcp add falsepass -- uvx --from "falsepass[mcp]" falsepass mcpを実行します。 - スキル。 skills/falsepass/SKILL.md は、Agent
Skills 形式のすぐに使える監査手順です。監査の実行方法、欠陥と設計上の選択を見分ける方法、メンテナー向けの報告書の書き方を説明しています。フォルダーをエージェントのスキルディレクトリにコピーしてください
(Claude Code の場合は
~/.claude/skills/)。 - 通常の CLI。 すべてのコマンドは非対話型で、ファイルを書き出します。
init --json、results --json、scan --jsonは JSON を出力し、results --completion IDは完了結果を全文出力します。audit --fail-on ...は条件を満たすと終了コード 1 で終了します。出力形式については docs/OUTPUT.md を参照してください。
どの方法で実行しても、出力されるのは調査の手がかりの一覧です。エージェントは、手がかりを欠陥と判断する前に再現し、報酬コードを確認する必要があります。また、プローブ表だけを根拠に環境が壊れていると報告してはいけません。
すべてのコマンド
falsepass init owner/environment          # set up audits/<name>/ for a Hub environment, or pass a local folder
falsepass init hf:owner/space             # an OpenEnv Space on the Hugging Face Hub (cloned into audits/<name>/space)
falsepass init rewards.py --dataset d.jsonl   # reward functions written for TRL's GRPOTrainer, with their dataset
falsepass audit environment               # no adapter needed for Q&A tasks: the answer format is inferred
falsepass audit environment --search 120  # add mutation search (scorer calls per direction and example)
falsepass audit environment --jobs 1      # score one task at a time (default: up to 8 at once where that is safe)
falsepass audit environment --fail-on 'ceiling>0.1' --fail-on 'errors>0'   # CI gate, exit 1 when met
falsepass results environment [--json]    # the last run: summary.md, or a compact JSON digest
falsepass results environment --completion ID   # one completion in full (IDs are in the JSON digest)
falsepass scan path/to/source [--json]    # static pre-scan only, nothing is installed or run
falsepass discover --days 90 --limit 160  # recently maintained Hub environments and what each needs
falsepass discover --hub hf --days 30      # OpenEnv Spaces on the Hugging Face Hub, most liked first
falsepass reach environment --probe P15/denied   # how many tasks one failing probe row reaches (every task by default)
falsepass reach environment --template '{wrong} or {answer}'   # ...or a completion of your own, filled per task
falsepass repro environment               # stand-alone script that re-scores the exact failing completions
falsepass repro environment --run         # ...and run it twice in fresh virtualenvs, compare, store the first run
falsepass rollout environment -n 20       # what a local model's own replies earn (Ollama)
falsepass propose environment -n 5        # a local model writes wrong answers and climbs on the reward
falsepass draft environment               # REPORT.draft.md: candidate findings for manual review
falsepass overview -o RESULTS.md          # one table over every audit on disk
falsepass container environment           # container tasks: the key, and mutations of it, written as the output file (Docker)
falsepass upstream environment            # find the source repository on GitHub and compare it with the audit
falsepass verify-fix environment --source ../patched/pkg   # rerun the stored repro on a patch: which lines change
falsepass demo                            # the toy environment above
falsepass mcp                             # MCP server over stdio (`falsepass[mcp]`)
各監査は、audits/<env>/env.toml で固定された、使い捨ての仮想環境内で実行されます。これは、Hub の環境が互換性のない verifiers のバージョンを使って構築されているためです。出力先:
audits/<env>/probe-results.json と summary.md。このリポジトリのクローン内では、コマンドの前に uv run を付けてください。uv run pytest で、このキット自体のテストを実行できます。
チェック
| ID | チェック項目 | 正しい検証器は… |
|---|---|---|
| P1 | 指定された形式の参照回答 | 報酬を満額与える |
| P2 | 無害なバリエーションを加えた同じ回答 | 報酬を満額与える |
| P3 | 空/空白のみ | 報酬を与えない |
| P4 | プロンプトをそのまま繰り返したもの | 報酬を与えない |
| P5 | すべての候補回答を一度に提示したもの | 報酬を与えない |
| P6 | 形式は完璧だが誤った回答 | 報酬を与えない |
| P7 | 自信満々な誤答 | 報酬を与えない |
| P8 | 誤答に採点者へのメモを添えたもの(LLM-judge 環境) | 報酬を与えない |
| P9 | 余計な内容に埋もれた正解を、後で撤回したもの | 報酬を与えない |
| P10 | 形式不正の出力 | 報酬を与えず、例外も発生させない |
| P11 | 同じ完了出力を10回 | すべて同じスコアを与える |
| P12 | データセット:空または重複したプロンプト、矛盾するラベル | 何も見つけない |
| P13 | NaN、Infinity、整数回答に0.9を加えたもの(JSON回答:浮動小数点数はNaNに設定し、整数には0.9またはInfinityを加える) | 報酬を与えず、例外も発生させない |
| P14 | 正解の前後の文章で、回答タグまたは\boxed{}にも言及した正解 | 報酬を満額与える |
| P15 | 回答欄内で回答を否定したもの、または誤った値の隣に回答を記したもの(\boxed{R \text{ is wrong}}、\boxed{W = R}) | 報酬を与えない |
| P16 | JSON回答:参照回答の自由記述値(2語以上)をすべてプロンプトに置き換えたもの。ラベル、ID、数値はそのまま | ほぼ報酬を与えない |
| P17 | JSON回答:短い文字列フィールド(ラベル、日付、ID)を一つずつ選び、そのフィールドが現れるたびに「(this is wrong)」を付けたもの | 参照回答より少ない報酬を与える |
| A1 | 参照回答不要:0~1000のすべての整数、すべての文字、yes/no の語、または1回の返信に含まれるプロンプトの語 | 報酬を与えない |
| O1 | OpenEnv、アクション内の判断フィールド:その値を一つずつ選び、ほかには何も言わない(固定戦略。平均値が怠惰なポリシーの報酬) | そのラベルの基本報酬のみを与える |
| O2 | OpenEnv、アクション内の自己申告フィールド(confidence、score、quality):最大値と最小値 | 同じ報酬を与える |
| T7 | ツールを1回呼び出した後の正解(ハーネスにツールが用意されていない場合の判断に委ねる項目) | 報酬を満額与える |
| C0–C2 | コンテナタスク:キーを出力ファイルとして書き込む(C0)、NaN/Infinity/小数のカウント(C1)、空にする、切り詰める、または入力ファイルで置き換える(C2) | C0には満額を与え、変更がない場合も満額を与える |
| T4 | マルチターン:無関係なエピソードの後にエピソードを再生する | 同じ報酬とトランスクリプトを与える |
| T5 | マルチターン:決して回答しないポリシー | 打ち切り、報酬は与えない |
| T8 | マルチターン:誤答した後、環境が明かした内容をそのまま繰り返す(「The word was …」) | 報酬を与えない。また、エピソードが環境の終了通知後も続いたかどうかをサマリーに記載する |
| T6 | ツールの使用:ツールスキーマだけから作成した7つのポリシー(ツール呼び出しなし、呼び出しなしで成功を主張、引数を空にして各ツールを1回ずつ呼び出す、最初から終了ツールを使う、…)。拒否が正解のタスクではカウントしない(何もしないことがそこで最大報酬になるが、すべてのタスクでそうなるわけではない。またはアダプターにその旨が記載されている) | 報酬を与えず、例外も発生させない |
| X*, T1–T3 | アダプターで定義される環境固有のプローブ | — |
| S1 | 検索:正解を追加せずに既知の誤答完了出力を変異させ、報酬を高める | 0を超えるものを見つけない |
| S2 | 検索:回答を変えずに正しい完了出力を変異させ、報酬を下げる | 満額を下回るものを見つけない |
| S3 | 検索:回答に言及するが、それを確定しない完了出力 | 0を超えるものを見つけない |
検索(--search N)は、名前付きの小さな変異を連ねたチェーンを対象とする、シード付きビームサーチです。
ヒットは、たとえば nothing + pad_think のように、最小化されたレシピとして報告されます。S2のヒットは脆弱性の候補であり、人間による確認が必要です。引用符で囲まれた"B"をBとして数えるべきかどうかは、判断に委ねられます。
静的事前スキャンは、audits/<env>/src を対象にすべての監査で実行され、単独では
falsepass scan で実行されます。実際の監査で見つかった欠陥をそれぞれ基にした、範囲を絞った AST ルールです。各ヒントには、それを検証するプローブの判定が表示されます
(confirmed: P6 failed 25/25、not confirmed、not checked)。
アダプターの推定。 adapter.py がない場合、各候補形式(パーサーとプロンプトテキストから取得)の参照回答を採点し、環境独自の報酬コードで最も高い報酬が得られる形式を選択して、回答形式を特定します。不正解は、ラベルセット、ずらした数値、または別の行から取得されます。この方法は、参照回答のある単一ターンまたはマルチターンの環境に対応します。回答を含まない行を持つツール使用環境、サンドボックス環境、ゲームではポリシーが必要です。falsepass init --policies はひな形を書き出します(Q&A の場合は --manual を指定します)。プロンプトが入力を囲むために使うタグ(<conversation>…</conversation>)は回答形式として扱われません。また、すべての形式のスコアが同じ場合は、プレーンな回答が使われます。制御として、自動モードは参照回答と空の出力を比較し、報酬で両者を区別できない場合は結果全体を判定不能とします。
マルチターン。 マルチターン環境は、モデルの代わりとなるスクリプトを使い、環境独自のロールアウトループ(V0RolloutScorer)を実行して採点します。これにより、フォローアップのプロンプト、停止条件、エピソードごとの状態が検証されます。探索ではスクリプトの全ターンが変更されます。スクリプトのエントリーにはツール呼び出し({"tool_calls": [{"name": …, "arguments": {…}}]})を含めることもでき、その場合は環境が実際のツールを使って実行します。自動モードでは、ツールがインプロセスで実行されるツール使用環境にも対応します。推定すべき回答形式がないため、7 つの T6 ポリシーと T5 を実行し、制御できなかったことを概要に記載します。タスクを読んで欠陥を見つける必要があるポリシーは、引き続き手作業で作成します(falsepass.model.Policy:これまでの会話から次の返信を返す関数)。
v1 のツールおよびマルチターンのタスクセット(ツールサーバー、独自の Env エピソードループ、またはスクリプト化されたユーザーを使う verifiers.v1)は、vf-eval と同じように、タスクセット独自のループを通じてエピソード全体を実行します。ハーネス、ツールサーバー、スクリプト化されたユーザー、停止条件、報酬を使用します(V1EpisodeScorer)。モデルはポリシーで応答する 127.0.0.1 上のローカルエンドポイントなので、課金もアップロードも発生しません。自動モードでは、T5 と T6 をこの方法で実行します。falsepass init <env> --policies は、制御としてソルバーを使う v1 のひな形を書き出します。また、repro は記録された各エピソードを、falsepass を使わずにターンごとに再実行します。ハーネスは、env.toml に runtime = "docker" と指定されていない限り、verifiers のサブプロセスランタイムで実行されます。エピソード中は外部ホストへの接続がブロックされます(閉じたポートへのプロキシを使用します。network = ["host"] を指定すると許可されます)。そのため、稼働中のサービスへの登録や投稿を行う環境は、そこで動作しません。
ロールアウトの検証。 falsepass rollout <env> は、タスクのサンプルを OpenAI 互換エンドポイントの背後にあるモデルに送信します。既定ではローカルの Ollama サーバーを使うため、課金は発生しません。その後、プローブと同じスコアラーを使ってモデル自身の返信を採点します。確認が必要な行にはフラグを付けます(返信に参照回答がないのに報酬が支払われた場合、返信に参照回答があるのに全額の報酬が支払われなかった場合、参照回答より多く報酬が支払われた場合、トークン上限で打ち切られた場合)。フラグを付けても、それを検出結果として扱うことはありません。ツール使用環境では、verifiers 独自のクライアントを通じてモデルを動作させるため、モデルはツールスキーマを受け取り、ツール呼び出しが実行されます。--endpoint、--model、--tag を指定すると、最初のモデルと並行して 2 つ目のモデルを実行します。
モデルが作成する不正解。 falsepass propose <env> は、話題に沿った不正解の返信をモデルに求め、それを採点し、採点者のスコアをフィードバックとして数回書き直させます。正解が明確な回答では、参照回答が返信に含まれていてはなりません(コードで確認します)。自由回答形式では、不正解かどうかはモデル自身の判断になるため、すべての行は確認対象であり、検出結果ではありません。
ディスカバリー。 falsepass discover は、最近更新され、公開バージョンが複数ある Hub 環境を一覧表示し、各ホイールを読み取って必要なもの(サンドボックス、ツール、LLM ジャッジ、API キー、参照回答)を示します。一覧表示には prime CLI が必要です。
--hub hf を指定すると、代わりに Hugging Face Hub 上の OpenEnv Spaces を公開リストのみから一覧表示します(いいね数、最終更新日、タグ、init 用の hf:owner/space ターゲット)。
各環境について、主な数値を3つ示します。誤合格の上限(既知の不正な完了のうち、最高の報酬を得たもの)、安易な方策の報酬(例全体で、固定された誤った戦略が得た平均報酬の最高値)、誤不合格率(既知の正しい完了のうち、満額の報酬を拒否された割合)です。summary.md には、既知の不正な完了に対してどの報酬項目が支払われたかも表示されます。
プローブ実行からレポートへ
プローブ実行で得られるのは手がかりであり、発見事項ではありません。手がかりを発見事項にするには、次の手順を行います。
falsepass repro <env>は、検証器と環境パッケージだけに依存するスクリプトを作成し、完了内容を正確に再評価します(completions.jsonに保存されています)。クリーンな仮想環境から2回実行し、出力が同一であることを確認します。- 報酬のコードを読み、原因となる行を特定します。それが欠陥なのか設計上の選択なのか判断します。意図的に悪用可能な採点器は、所見にとどまります。
falsepass draft <env>はREPORT.draft.mdを作成します。失敗したプローブグループをそれぞれ候補として記載し、確認済みの静的ヒントを付け、担当者の判断が必要な箇所に印を付けます。docs/SEVERITY.md に従って、確かな内容を評価します。- レポートを作成していない人に、保存された出力と照らしてすべての数値を確認してもらいます。
レポートから上流への修正へ
falsepass upstream <env> は、環境のソースを GitHub で検索します(パッケージがプロジェクト URL で自身を指定しているリポジトリ、ソースまたは docstring 内の github.com リンク、次に pyproject.toml 内のパッケージ名、最後に最も特徴的なクラス名と関数名の順で検索します)。監査対象のすべてのファイルをリポジトリのデフォルトブランチと比較し、行末を無視して、コントリビューターに必要な情報を出力します。これにはデフォルトブランチ、ライセンス、最終プッシュ日時、オープン中のプルリクエスト、最近のマージのうち外部からのものの数が含まれます。falsepass verify-fix <env> --source <patched folder> は、修正済みパッケージ(またはリリースに重ねた、監査対象の src/ の修正済みコピー)を使って保存済みの再現テストを再実行し、変更された行を出力します。未修正のベースラインがない場合は、先に保存します。発見事項に該当する行だけが変われば、修正は完了です。再実行するのは再現スクリプトのみです。パッチ全体に対してプローブ一式を実行するには、falsepass audit <env> --source <patched folder> を使います。
環境の追加
falsepass init owner/environment は、Hub のホイールから読み取ったパッケージ、バージョン、モジュール、インデックス、検証器の固定バージョンを含む audits/<name>/env.toml を作成し、静的スキャン用にホイールのソースを audits/<name>/src に展開します。falsepass init ./folder はローカルの pyproject.toml を使って同様の処理を行い、そのフォルダー自体が各実行時にインストールおよびスキャンされるよう、フォルダーを source として記録します。インストール済みの Inspect タスク(inspect_evals/gsm8k)には展開するホイールがありません。そのため監査では、タスク自身のフォルダーと、使用する採点器のモジュールを src/ にコピーします。Q&A 環境ではこれだけで十分です。
それ以外の場合は --manual を追加し、生成された adapter.py に必要な情報を記入します。例の読み込み方法、プロンプトの指示どおりに回答を書く方法、誤答の例を記載してください。
実績
2026年10月に、数十件の公開 Hub 環境で使用しました。採用したすべての発見事項は、クリーンな仮想環境から2回再現し、報酬コードを読んで確認しました。修正はプルリクエストとしてメンテナーに送付中です。個々の環境名や件数は、修正が取り込まれるまで公開していません。
制限事項
- リードには人の確認が必要です。このツールは、採点器が誤ったものに報酬を与える箇所を見つけます。それが欠陥かどうか、また深刻度がどの程度かを判断する作業は手動です。
- 検索は限定的です。固定されたテキストの変異を使い、採点器を数百回呼び出します。報酬に対するモデルの学習は行いません。
- コンテナタスクには自動モードがなく、ホスト型サンドボックス上の環境や、有料の LLM 判定器を使う環境は、認証情報がない場合は対象外です。
- 対応フレームワーク:verifiers(v1 のツールタスクセットでは、汎用ツールポリシーは自動的に対応し、タスク固有のものはポリシーとして記述します)、OpenEnv(
step()が返信または構造化アクションを採点する環境。MCP ツール環境と、Environmentクラスを持たない手書きのサーバーには、ポリシーまたはアダプターが必要です)、Inspect AI(サンドボックス化されたタスクは対象外)、HUD(回答採点型のテンプレートに対応。ワークスペース内でエージェントが行ったことを採点するタスクには、手書きのポリシーが必要です)。
関連ツール
- rewardlint — 単一の報酬関数向けの敵対的コーパスです。
falsepassは、参照対象を差し替えられる場合に、環境の報酬コードを通じてテストを実行し、判定結果をsummary.mdに出力します。 - ratctl — サンドボックスの悪用パターンを検出する、環境ソース向けの静的スキャナーおよび LLM 支援スキャナーです。
- VerifierLab — 宣言された予算と正解オラクルを用いて、ラップされた採点器に対する攻撃キャンペーンを実施します。
- vlabs-integrity — 信頼できる参照を用いた、コーディング報酬向けの変異キルおよび同型ラベル変更の監査です。
- harden-v0 — Harbor 形式のエージェントベンチマーク検証器を強化する、LLM ハッカーと修正役によるループです。
ディレクトリ構成
falsepass/           the probe kit (falsepass/mcp_server.py: the MCP tools)
tests/               its tests
examples/toy-env/    the demo environment, with its planted defect
examples/openenv-toy/, examples/reward-toy/, examples/inspect-toy/, examples/hud-toy/   the same idea for OpenEnv, reward functions, Inspect AI and HUD
skills/falsepass/    agent skill: the audit procedure
action.yml           the GitHub Action
docs/SEVERITY.md     the rating scale; docs/OUTPUT.md: the output files
audits/<env>/        created by `falsepass init`; ignored by git
ライセンス
Apache-2.0。LICENSE を参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。