all2md について
all2mdは、開発者や文書を扱う人向けの変換・処理ツールで、コマンドライン、Python API、MCPサーバーから利用できます。多様な形式の読み取り、変換、検索、比較、分割に対応し、分割結果には見出しやページ情報が付与されます。
主な機能
- 0140以上の形式を読み取り・変換
- 02形式をまたいだ検索と差分比較
- 03文書を見出しや意味単位で分割
- 04コマンドラインとPython APIを提供
- 05変換品質を測定しCIゲートを設定
- 06MCP経由で文書を読み取り・編集・保存
活用シーン
- 01PDFやOffice文書をMarkdownに変換
- 02契約書やスライドから情報を検索
- 03出典付きのRAG用チャンクを準備
- 04AIアシスタントでフォルダー内の文書を検索・編集
MCP 対応
クライアント向けに文書の読み取り、保存、編集、検索、差分比較、アウトライン取得を行うMCPサーバーを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
5掲載時のツール一覧 · 3 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| source | string | はい | 統一された source パラメーター。次の形式を自動検出します:ファイルパス(読み取り許可リスト内に存在する場合)、data URI(data:...)、Base64 文字列、またはプレーンテキストコンテンツ。必須。 |
| section | any | いいえ | 抽出するセクション名(任意。見出しと大文字・小文字を区別せずに照合)。指定すると、そのセクションのみが返されます。 |
| pdf_pages | any | いいえ | PDF ソースのみを対象とするページ指定。例:'1-3'(1~3 ページ)、'1,3,5'(指定ページ)、'1-3,5,10-'(範囲と個別ページ)、'1-'(1 ページ目から最後まで)。 |
| format_hint | any | いいえ | 判別が難しい場合(拡張子のないファイルなど)に使用する形式ヒント(任意)。選択肢:auto(デフォルト)、pdf、docx、pptx、html、eml、epub、ipynb、odt、odp、ods、xlsx、csv、rst、markdown、txt。 |
詳細

all2md
PDF、Office ファイル、電子書籍、メールなど、40 種類以上の形式を読み込み、変換、検索、チャンク化できます。Markdown への変換も、元の形式への変換も可能です。Python から、ターミナルから、AI アシスタントから利用できます。





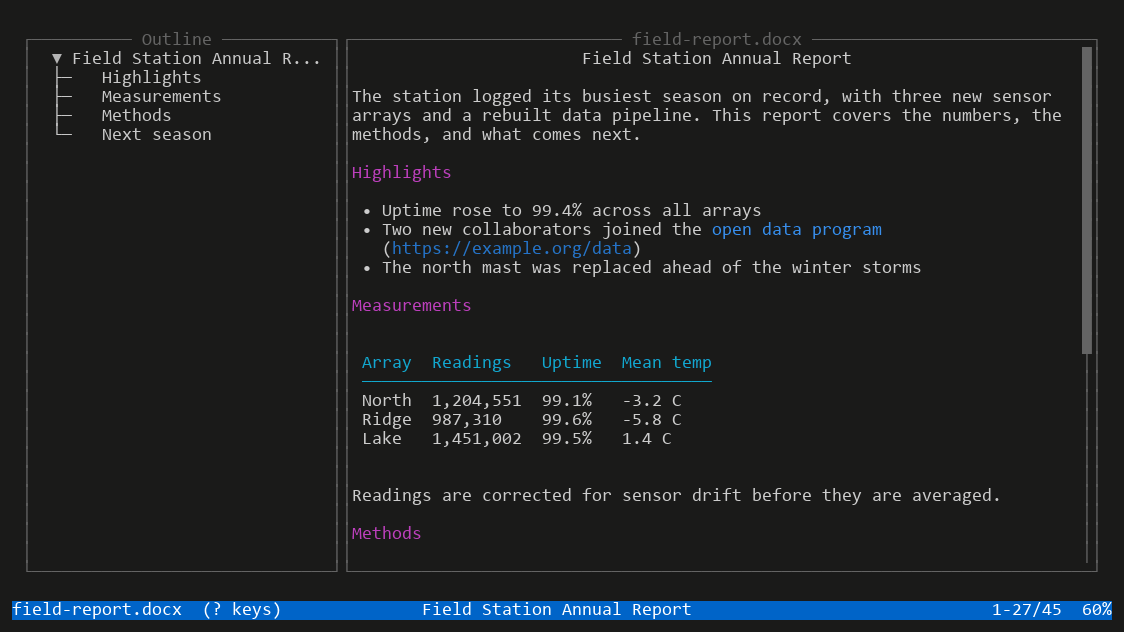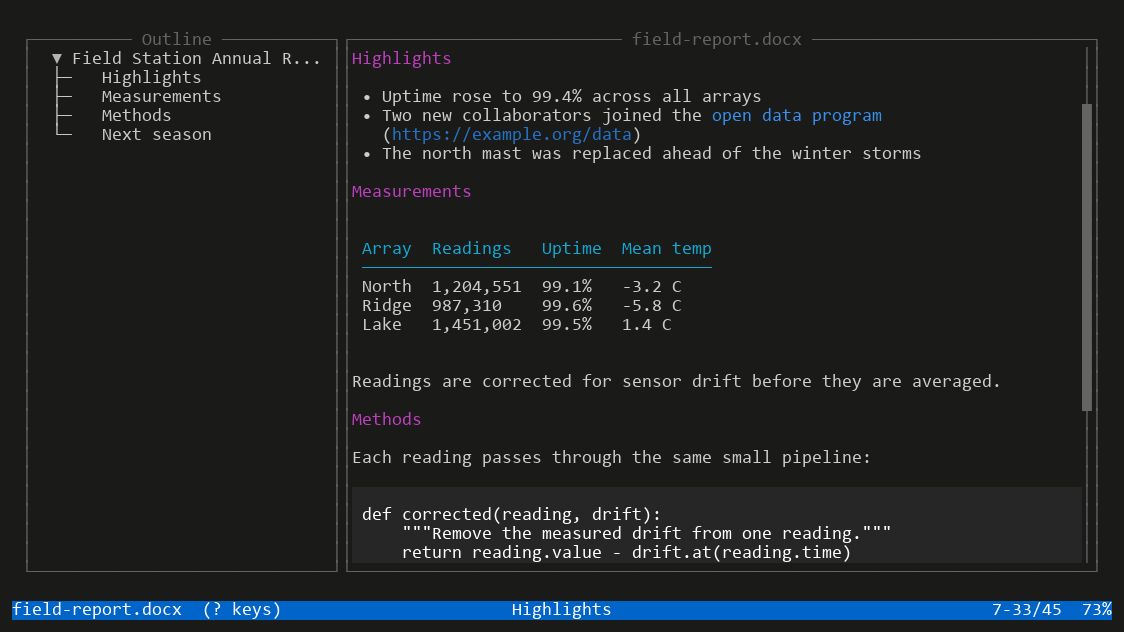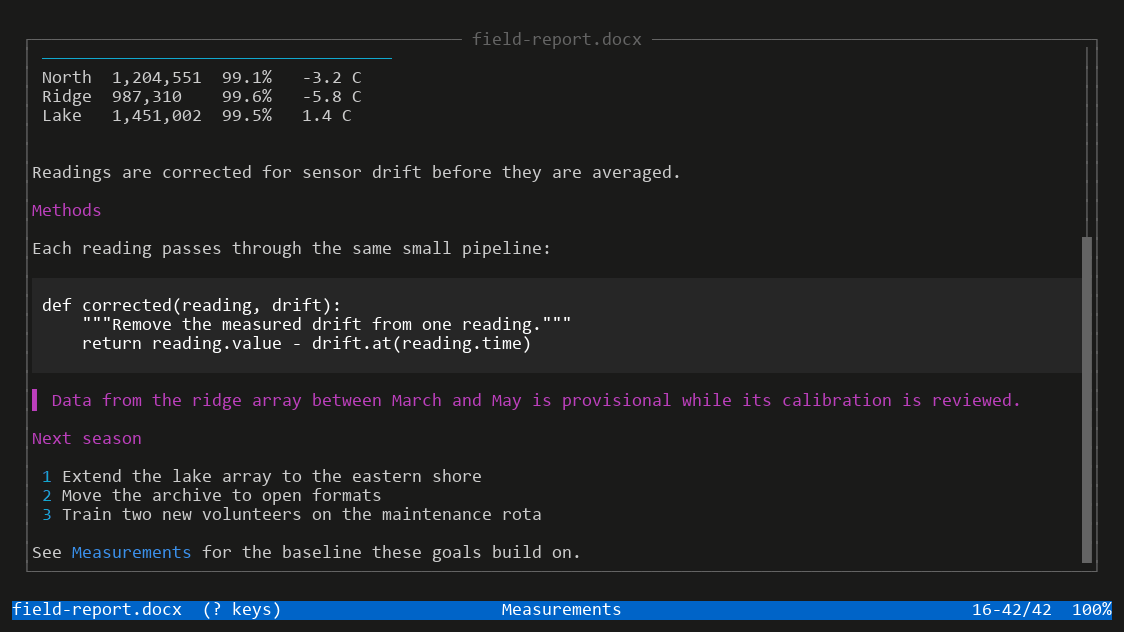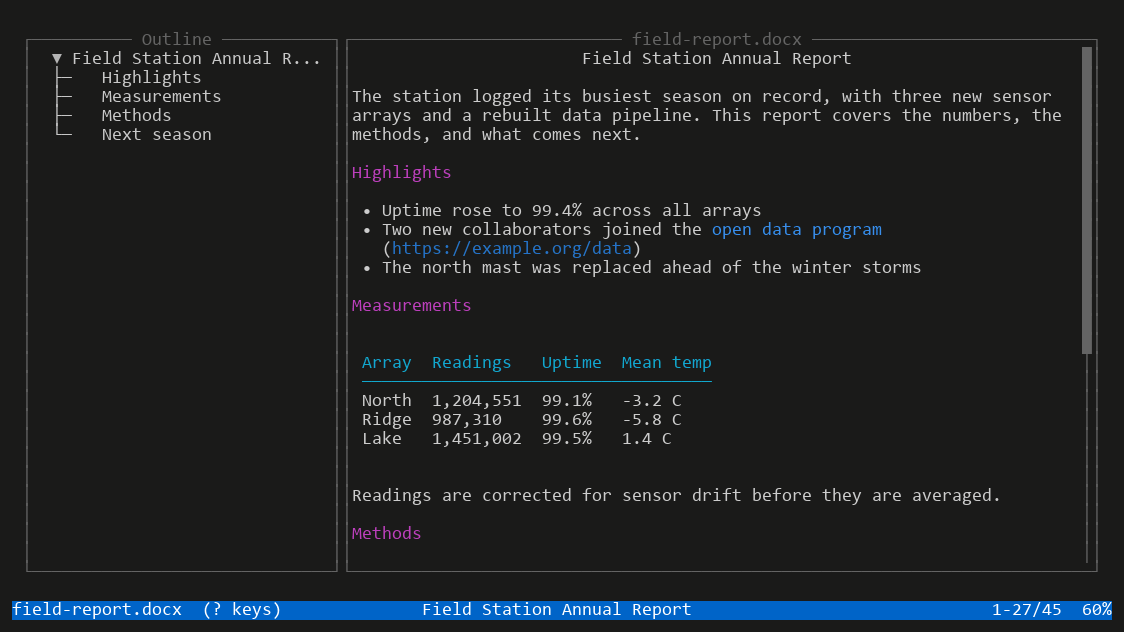
all2md read を使ってターミナルで読み込んだ Word 文書。
10 秒で試す
uv を使えば、事前のインストールは不要です。
uvx --from "all2md[all]" rcat report.pdf          # read any document in the terminal
uvx --from "all2md[all]" all2md report.docx       # print it as Markdown
all2md、rcat、all2md-mcp サーバーを PATH に含め、ツールとして使い続けることもできます。
uv tool install "all2md[all]"
ライブラリとして使うこともできます。
uv add "all2md[pdf,docx]" # or: pip install "all2md[pdf,docx]"
from all2md import to_markdown

markdown = to_markdown("report.pdf")
使い方を選ぶ
| やりたいこと | まず試すもの | 詳細 |
|---|---|---|
| ターミナルを離れずに文書を読む | rcat report.docx、all2md read docs/ | ターミナルで文書を読む |
| ファイルを 1 つでも 1,000 個でも、双方向に変換する | all2md ./inbox -r --output-dir ./md | 変換 |
| Python コードで文書を解析する | to_markdown("report.pdf") | Python API |
| PDF、Word ファイル、スライド資料内のテキストを検索する | all2md grep "deadline" contracts/ -r | 文書内を検索 |
| RAG パイプラインに文書を渡す | all2md chunk handbook.pdf | RAG とチャンク化 |
| Claude などのアシスタントからファイルを扱う | ワンクリックで使える Claude Desktop 拡張機能 | AI アシスタント(MCP) |
| 出力をどこまで信頼できるか把握する | all2md report scan.pdf | 測定済みの忠実度 |
ターミナルでドキュメントを読む
rcat はドキュメント用の cat です。PDF、Word、PowerPoint ファイル(97-2003 形式の .doc と .ppt も)、スプレッドシート、電子書籍、メール、ノートブック、man ページなど、all2md が読み込めるあらゆる形式を、見出し、表、シンタックスハイライト付きコード、リンクとそのリンク先、脚注、数式、補足情報とともに表示します。ブラウザーもオフィススイートも不要で、SSH 経由でも動作します。Markdown を読むのに glow を、Word ファイルを読むのに doxx を使っているなら、rcat はあらゆる形式に対応する同じようなツールです。
rcat report.docx                              # read a Word document
rcat deck.pptx --outline                      # just the slide titles
rcat handbook.pdf --extract "Installation"    # one section, by heading
rcat contract.pdf --pager                     # page through it
curl -sL https://example.com/spec.pdf | rcat -
長いドキュメントには、all2md read(または rcat -i)を使うと、上に示したインタラクティブビューアーが開きます。テキストの横にアウトラインが表示され、見出し間を移動でき、画面上のリンクを確認できます。フォルダーを指定すると、その中のドキュメントがツリー表示されます。
all2md read handbook.pdf
all2md read docs/            # choose from the documents in a folder
ブラウザーを使いたい場合は、all2md view report.docx でスタイル付きの HTML プレビューを開き、all2md serve ./docs -r でフォルダー全体をオンデマンド変換により配信し、all2md edit notes.md でブラウザーエディターを開いてファイルに保存できます。
スタイル機能には cli_extras エクストラが、ビューアーには tui が必要です。all2md[all] には両方が含まれています。詳しくはビューアーのドキュメントをご覧ください。
コマンドラインからドキュメントを変換する
対応するあらゆる形式から Markdown へ、また Markdown から DOCX、PDF、PPTX、HTML、EPUB などへ変換できます。
all2md report.pdf > report.md                     # to Markdown on stdout
all2md answer.md --out answer.docx                # Markdown (an LLM's output, say) to Word
all2md ./inbox -r --output-dir ./markdown -p 4    # a whole tree, four at a time
all2md ./inbox -r --output-dir ./markdown --watch # keep converting as files arrive
all2md scan.pdf --pdf-ocr-enabled                 # scanned pages, through OCR
各コンバーターのすべてのオプションは、CLI フラグ(all2md --help)または設定ファイルのキー(all2md config generate)で指定できます。すべてのファイルコマンドで - を使うと stdin から読み込み、stdout に書き込めるため、all2md をパイプラインに組み込めます。Word ドキュメントは Word での表示どおりに出力されます。変更履歴はポリシーに従って処理され、コメントとそのアンカー、脚注、フィールドの結果、結合セル、Word が実際に表示するリスト番号も保持されます。
CLI リファレンスとチートシートをご覧ください。
Python API
一般的な用途には to_markdown() を、任意の 2 つの形式間の変換には convert() を、解析したドキュメントの操作には to_ast() を使います。
from all2md import to_markdown, convert, to_ast, from_ast

markdown = to_markdown("report.pdf", pages="1-3", flavor="gfm")
convert("notes.md", "notes.docx", target_format="docx")

doc = to_ast("report.docx")          # a typed document tree
html = from_ast(doc, target_format="html")
コアに依存関係はありません。各形式のエクストラは、その形式に必要なものだけを取り込みます。オプションは型付きデータクラス(PdfOptions、DocxOptions など)または通常のキーワード引数で指定でき、AST 変換(remove-images、heading-offset、独自の変換など)は解析とレンダリングの間に組み込めます。新しい形式や変換は、エントリーポイントから追加できます。
コーディング環境を使う LLM の場合、all2md llm-help を実行すると、LLM 向けに書かれた使用方法が表示されます。また、all2md install-skills を実行すると、Claude Code、Cursor などで使うスキルとしてインストールできます。
Python API ガイド、AST ガイド、examples/pythonをご覧ください。
あらゆるドキュメント内を検索する
grep は PDF や .docx の中までは検索しません。all2md grep は、よく使われるフラグを指定して、さまざまな形式を組み合わせて検索できます。
all2md grep -i "termination" contracts/ -r            # every format in the tree
all2md grep -C 2 "deadline" contracts/ -r --rich      # with context, highlighted
all2md search "renewal terms" ./contracts --keyword   # ranked BM25 search
all2md search "who approved the budget" ./minutes --hybrid
all2md diff draft-v1.docx draft-v2.pdf                # a colored diff, across formats
ベクトル検索とハイブリッド検索には search エクストラが必要です。繰り返し実行する際に解析済みドキュメントを再利用するには、--cache(または ALL2MD_CACHE=1)を追加します。
RAG とチャンク分割
all2md chunk は、変換と分割を一度に行います。各チャンクにはセクション見出しと元のページ範囲が含まれるため、回答の出典箇所を示せます。
all2md chunk handbook.pdf --strategy semantic --max-tokens 512 --overlap 64 > chunks.jsonl
import all2md

for c in all2md.chunk("handbook.pdf", strategy="semantic", max_tokens=512, overlap=64):
    print(c.chunk_id, c.section_heading, c.page, c.token_count)
戦略は 11 種類あります(セマンティック、見出し、セクション、トークン、文、段落、コードなど)。表とコードブロックは分割せず、出力はあらゆるベクトルストアですぐに使える JSONL 形式です。正確なトークン数の計算には、chunk エクストラの tiktoken を使用します。chunk コマンドをご覧ください。
AI アシスタントにドキュメントを渡す
all2md にはModel Context Protocolサーバーが付属しているため、Claude のようなアシスタントは PDF や Office ファイルを読み取ったり、Word ドキュメントを作成したり、ファイルを直接編集したり、フォルダーを検索したり、2 つのバージョンを比較したりできます。コードを書く必要はありません。
Claude Desktop の場合(Python やターミナルは不要です):
- 最新リリースから
all2md.mcpbをダウンロードします。 - Claude Desktop → Settings → Extensions を開き、ファイルをページにドラッグします。
- all2md が使用できるフォルダーと、ファイルの書き込みを許可するかどうかを選択します。
- そのフォルダー内のドキュメントについて Claude に質問します。
その他の MCP クライアントと開発者向けの設定
このサーバーは、io.github.thomas-villani/all2md として MCP Registry に登録されています。自分で実行する場合は、uvx を使用します(インストールは不要です)。
{
  "mcpServers": {
    "all2md": {
      "command": "uvx",
      "args": ["--from", "all2md[all]", "all2md-mcp", "--temp", "--enable-from-md"]
    }
  }
}
または、uv tool install "all2md[mcp]" でインストールし、"command": "all2md-mcp" を使用します。[mcp] エクストラには、PDF、Word、PowerPoint、Excel、HTML、EPUB、ODF、reStructuredText のサポートが含まれます。すべての機能を使うには [all] を使用してください。
ツール: read_document_as_markdown、save_document_from_markdown、edit_document に加え、読み取り専用の search_documents、diff_documents、get_document_outline を利用できます。
オプションとセキュリティモデルについては、MCP ドキュメントをご覧ください。
実測による忠実度
all2md の変換品質は、独立した正解データとの比較で測定されており、単に主張されているものではありません。各ベンチマークの評価パスには、測定が本来失敗すべき場合にどのような結果になるかを示す対照テストが公開されています。
- デジタル生成 PDF: PubMed Central の出版社版 PDF を、同じ場所に登録されている JATS XML と照合して評価します。
- スキャンページ: OCR の評価パスでは、981 ページの OmniDocBench を人手によるアノテーションと照合します。
- ラウンドトリップ: Markdown → 形式 → Markdown の変換では、すべてのプルリクエストで、このリポジトリ自身のドキュメントについて忠実度 100 を維持する必要があります。
他のコンバーターとの比較では、PubMed Central の論文 103 件を封印済みのホールドアウトデータセットとして使用し、同じ評価基準で採点しました(2026-08-29 時点)。
| all2md | pymupdf4llm 1.28.2 | Docling 2.120.3 | |
|---|---|---|---|
| 抽出可能なテキストの再現率 | 97.3% | 97.1% | 96.2% |
| 生成された誤テキスト(低いほど良好) | 0.55% | 6.26% | 2.05% |
| 保持された表のテキスト | 73.1% | 60.7% | 79.3% |
表については、Docling の学習済みテーブルモデルが依然として優れています。比較評価パスでは、全結果、評価の前提条件、および結果の適用範囲に関する注意事項を確認できます。その他の内容については、変換の忠実度をご覧ください。
同じ方法で、ご自身のドキュメントも評価できます。
all2md report scan.pdf                        # a reference-free "quality card"
all2md roundtrip notes.md --via docx          # convert, parse back, score what survived
all2md optimize hard.pdf --sample-pages 5     # auto-tune the settings for a difficult file
CI 品質ゲート
同じスコアを GitHub Action として実行できます。ドキュメントがきれいに変換できなくなった場合、ビルドは失敗します。
- uses: thomas-villani/[email protected]
  with:
    paths: docs/**/*.md
    roundtrip-fail-under: 97
一致するファイルがない場合、しきい値が設定されていない場合、またはドキュメントをまったく変換できない場合は、何も通知せずに成功とするのではなく失敗します。また、しきい値が実際の最低水準を大幅に下回っていて、検出が決して作動しない可能性がある場合は警告します。アクションのドキュメントをご覧ください。
対応形式
- ドキュメント: PDF、DOCX、DOC、PPTX、PPT、ODT、ODP、RTF、EPUB、FB2、CHM
- Web とマークアップ: HTML、MHTML、Markdown、reStructuredText、AsciiDoc、Org-Mode、LaTeX、MediaWiki、Textile、DokuWiki、BBCode、man ページ
- データとスプレッドシート: XLSX、ODS、CSV/TSV、JSON、YAML、TOML、INI、OpenAPI/Swagger
- メール: EML、MBOX、Outlook(MSG/PST/OST)、Evernote(ENEX)
- ノートブックとコード: Jupyter、および約 200 種類のソースコード・設定ファイル形式
- アーカイブ: ZIP、TAR、7Z、RAR など。
.gz、.bz2、.xzは、格納されているファイルの形式として変換されます - カスタム出力: Jinja2 テンプレートを使用した任意のテキスト形式
全形式一覧(入力/出力/必要なエクストラ)
| Format | File Extensions | Input (Parse) | Output (Render) | Dependencies Extra | | ----------------------------- | --------------------------------------------- | :-----------: | :-------------: | ------------------ | | **PDF** | `.pdf` | ✅ | ✅ | `pdf`, `pdf_render`| | **Word Document** | `.docx` | ✅ | ✅ | `docx` | | **Word 97-2003 Document** | `.doc`, `.dot` | ✅ | (N/A) | (built-in) | | **PowerPoint Presentation** | `.pptx` | ✅ | ✅ | `pptx` | | **PowerPoint 97-2003** | `.ppt`, `.pps`, `.pot` | ✅ | (N/A) | (built-in) | | **HTML** | `.html`, `.htm` | ✅ | ✅ | `html` | | **MHTML Web Archive** | `.mhtml`, `.mht` | ✅ | (N/A) | `html` | | **Email Message** | `.eml` | ✅ | (N/A) | (built-in) | | **MBOX Mailbox Archive** | `.mbox`, `.mbx` | ✅ | (N/A) | (built-in) | | **Outlook Message/Archive** | `.msg`, `.pst`, `.ost` | ✅ | (N/A) | `outlook` | | **Jupyter Notebook** | `.ipynb` | ✅ | ✅ | (built-in) | | **EPUB E-book** | `.epub` | ✅ | ✅ | `epub` | | **FictionBook 2.0 (FB2)** | `.fb2` | ✅ | (N/A) | `fb2` | | **CHM (Compiled HTML Help)** | `.chm` | ✅ | (N/A) | `chm` | | **OpenDocument Text** | `.odt` | ✅ | ✅ | `odf` | | **OpenDocument Presentation** | `.odp` | ✅ | ✅ | `odf` | | **OpenDocument Spreadsheet** | `.ods` | ✅ | (N/A) | `odf` | | **Excel Spreadsheet** | `.xlsx` | ✅ | (N/A) | `xlsx` | | **CSV / TSV** | `.csv`, `.tsv` | ✅ | ✅ | (built-in) | | **Rich Text Format** | `.rtf` | ✅ | ✅ | `rtf` | | **LaTeX** | `.tex`, `.latex` | ✅ | ✅ | `latex` | | **AsciiDoc** | `.adoc`, `.asciidoc`, `.asc` | ✅ | ✅ | (built-in) | | **reStructuredText** | `.rst` | ✅ | ✅ | `rst` | | **Org-Mode** | `.org` | ✅ | ✅ | `org` | | **MediaWiki** | `.wiki`, `.mw` | ✅ | ✅ | `wiki` | | **Textile** | `.textile` | ✅ | ✅ | (built-in) | | **BBCode** | `.bbcode`, `.bb` | ✅ | (N/A) | (built-in) | | **DokuWiki** | `.doku`, `.dokuwiki` | ✅ | ✅ | (built-in) | | **Man Page (man(7))** | `.1` to `.9`, `.man` | ✅ | ✅ | (built-in) | | **Evernote Export** | `.enex` | ✅ | (N/A) | `enex` | | **Safari Web Archive** | `.webarchive` | ✅ | (N/A) | `html` | | **JSON** | `.json` | ✅ | ✅ | (built-in) | | **YAML** | `.yaml`, `.yml` | ✅ | ✅ | (built-in) | | **TOML** | `.toml` | ✅ | ✅ | (built-in) | | **INI / Config** | `.ini`, `.cfg`, `.conf` | ✅ | ✅ | (built-in) | | **OpenAPI/Swagger** | `.yaml`, `.yml`, `.json` | ✅ | (N/A) | `openapi` | | **Plain Text** | `.txt`, `.text` | ✅ | ✅ | (built-in) | | **Source Code** | nearly 200 extensions (`.py`, `.js`, etc.) | ✅ | (N/A) | (built-in) | | **Archive Formats** | `.tar`, `.tgz`, `.7z`, `.rar`, etc. | ✅ | (N/A) | (built-in) | | **Single Compressed File** | `.gz`, `.bz2`, `.xz` (e.g. `ls.1.gz`) | ✅ | (N/A) | (built-in) | | **ZIP Archive** | `.zip` | ✅ | (N/A) | (built-in) | | **Jinja2 Templates (Custom)** | User-defined (`.jinja2`, `.j2`) | ❌ | ✅ | `jinja2` |all2md list-formats を実行してインストール環境で対応している形式を確認するか、形式のドキュメントをご覧ください。
インストール
| 使用目的 | インストール方法 |
|---|---|
| CLI とビューアーを使用する | uv tool install "all2md[all]" |
| まず一度試す | uvx --from "all2md[all]" rcat FILE |
| ライブラリを使って開発する | uv add "all2md[pdf,docx,html]" または pip install "all2md[pdf,docx,html]" |
| MCP サーバーを実行する | 上記の Claude Desktop 拡張機能、または uv tool install "all2md[mcp]" |
all2md check-deps を実行すると、インストール環境で処理できる形式がわかります。
ワンクリックインストールスクリプト、OCR、レイアウト解析などの追加機能
インストールスクリプト。 これらのスクリプトは uv をセットアップし(必要に応じてインストールします)、all 追加機能付きで CLI をグローバルにインストールします。
# macOS / Linux
curl -LsSf https://raw.githubusercontent.com/thomas-villani/all2md/main/scripts/install.sh | sh
# Windows (PowerShell)
powershell -ExecutionPolicy Bypass -c "irm https://raw.githubusercontent.com/thomas-villani/all2md/main/scripts/install.ps1 | iex"
インストールを最小限にするには、スクリプトをダウンロードして、必要な追加機能を指定します。sh install.sh pdf,docx,html または .\install.ps1 -Extras pdf,docx,html を実行してください。
特定の用途向けの追加機能:
uv add "all2md[cli_extras]"     # terminal styling for --rich / rcat, progress bars, watch mode
uv add "all2md[tui]"            # the interactive viewer, all2md read
uv add "all2md[pdf,ocr]"        # OCR for scanned PDFs (Tesseract; needs the system binary)
uv add "all2md[pdf,ocr-easyocr]" # ...or binary-free EasyOCR (downloads models on first use)
uv add "all2md[pdf_layout]"     # ML layout analysis for difficult PDFs
uv add "all2md[search]"         # vector and hybrid search
uv add "all2md[chunk]"          # real token counts for chunking
uv add "all2md[outlook]"        # Outlook MSG (PST/OST also need: pip install libpff-python)
一覧はインストールガイドをご覧ください。
よくある質問
all2md は Pandoc とどう違いますか? all2md は Python ネイティブで、プログラムからの利用、LLM パイプライン、ターミナルでのドキュメント閲覧向けに構築されています。Pandoc は出版関連の幅広い機能や、引用などの学術向け機能が充実しています。両者は互いをうまく補完します。
スキャンした PDF にも対応していますか?
はい。all2md[pdf,ocr](システムバイナリが不要な場合は ocr-easyocr)をインストールし、--pdf-ocr-enabled を指定してください。PDF にテキストレイヤーがない場合は、all2md report で確認できます。
Markdown 以外の形式で出力できますか? はい。DOCX、PDF、PPTX、HTML、EPUB、ODT、RST、LaTeX などに出力できます。また、Jinja2 テンプレートを使って任意のテキスト形式で出力することもできます。
形式を追加するにはどうすればよいですか?
パーサーを作成し、ConverterMetadata でその内容を記述して、all2md.converters エントリーポイントに登録します。examples/pluginsをご覧ください。
コントリビューション
バグ報告、機能のリクエスト、ドキュメントやコードの改善を歓迎します。開発環境のセットアップについては、CONTRIBUTING.mdをご覧ください。パーサーの変更はベンチマークのレーンに基づいて評価されます。変換の忠実度もご覧ください。
質問やバグ報告はGitHub Issuesへお寄せください。ドキュメントはRead the Docsでご覧いただけます。
ライセンス
MIT。LICENSEをご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。