PDF Card MCP について
PDF Card MCP は、長い PDF の読解、引用、確認に使うローカル優先の MCP サーバー兼 CLI です。出典リンク付きカード、ページプレビュー、図表や数式の画像を含む、持ち運べる HTML リーダーを生成します。
主な機能
- 01PDF を単体 HTML リーダーに変換
- 02カードと出典ページ・テキストの連携
- 03表・図・数式の切り抜き
- 04リーダー注釈の検証と公開
- 05メモとハイライトの Markdown 出力
- 06既定でローカル処理
活用シーン
- 01長い研究 PDF をカード単位で読む
- 02出典ページと照合して引用を確認
- 03公開注釈付きの静的リーダーを共有
- 04PDF の読書メモをエクスポート
MCP 対応
MCP サーバーはローカル PDF のパスを受け取り、PDF 変換、リーダー注釈の検証、静的リーダーバンドルの公開ツールを提供します。任意の sampling ではホストモデルが制約付きのスタイルやカード境界の変更を提案でき、検証によって原文が保持されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
PDF Card MCP



PDF Card MCP は、容量の大きなローカル PDF を、持ち運び可能でソースにリンクされた HTML リーダーに変換する、ローカルファーストの MCP サーバー兼 CLI です。MCP ホストは、PDF パスの変換、メモやハイライトの検証、注釈付き静的リーダーバンドルの公開を依頼できます。コンバーターはソーステキストを保持し、検証用にソースページをレンダリングし、検出した表、図、ディスプレイ数式を画像として切り抜き、元の PDF の配色からリーダー向けの安全なスタイルを導き出して、アセットを失うことなくデバイス間で移動できるスタンドアロン HTML ファイルを書き出します。
デフォルトの変換はローカルで実行され、ホスト型サービスは必要ありません。オプションの MCP サンプリングには、意図的に制限が設けられています。ホストモデルは、検証済みのスタイルトークンを選択したり、カード境界を整える操作を提案したりできますが、生の CSS やソーステキストの書き換えは拒否されます。
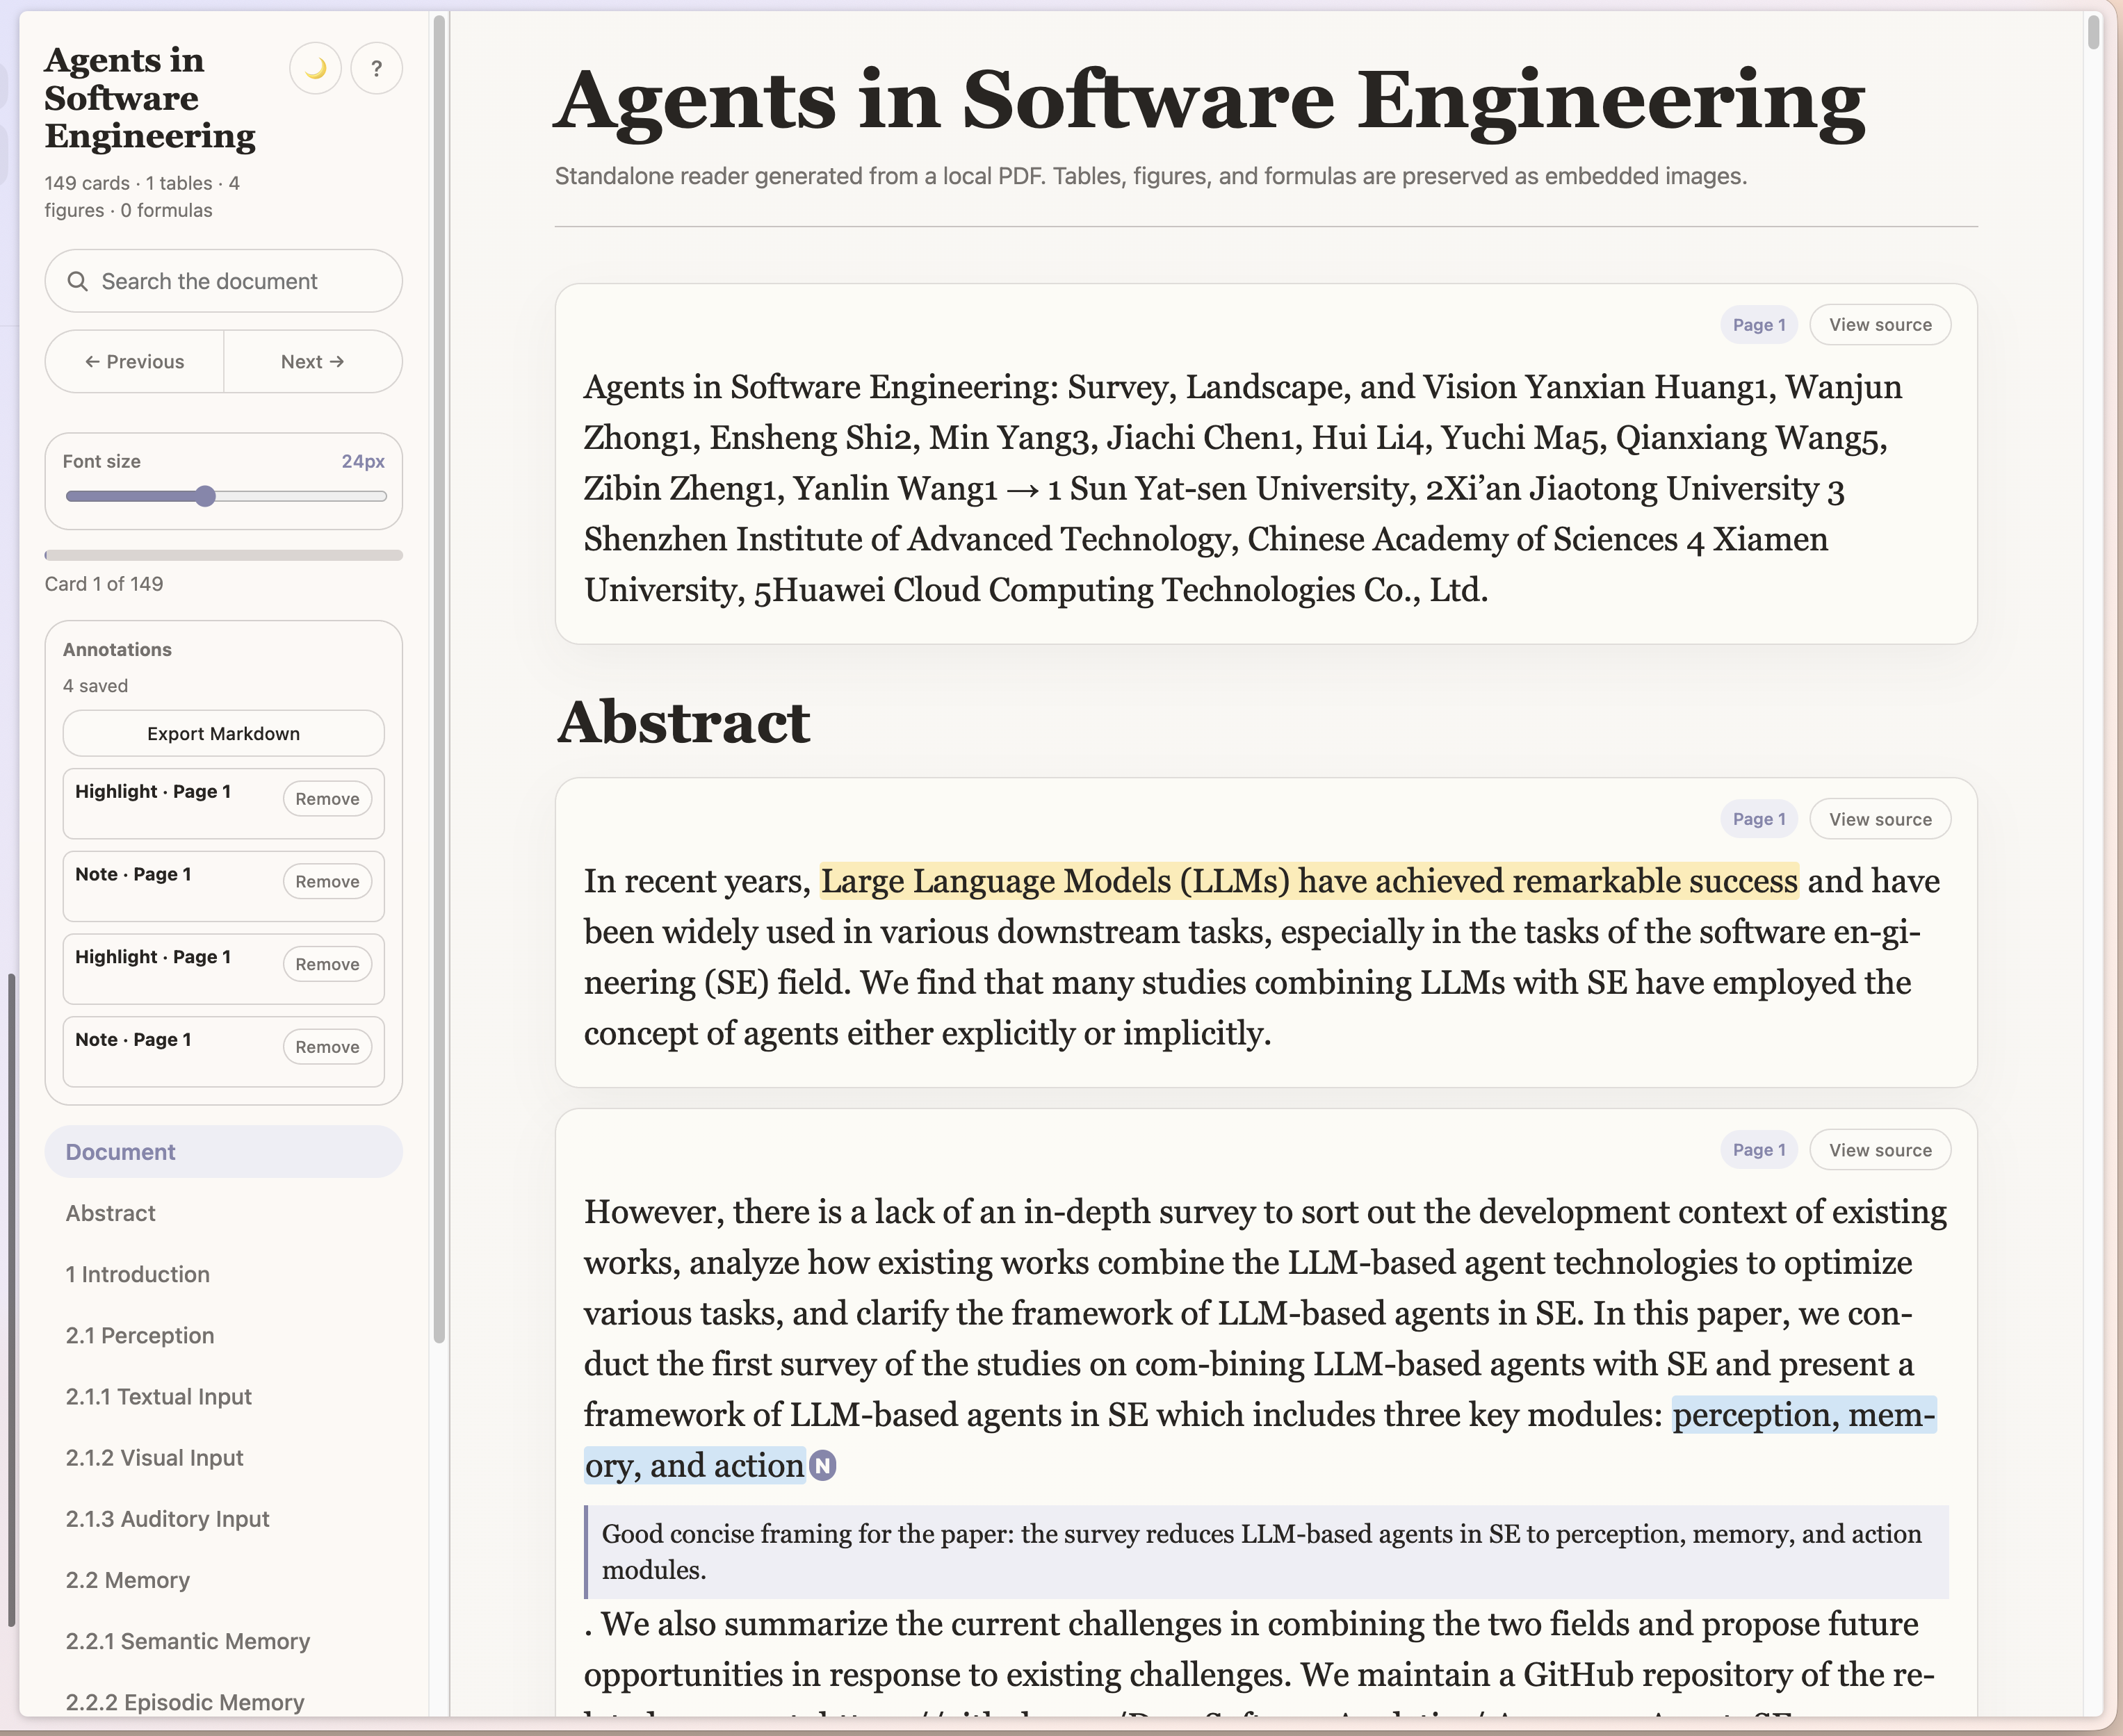
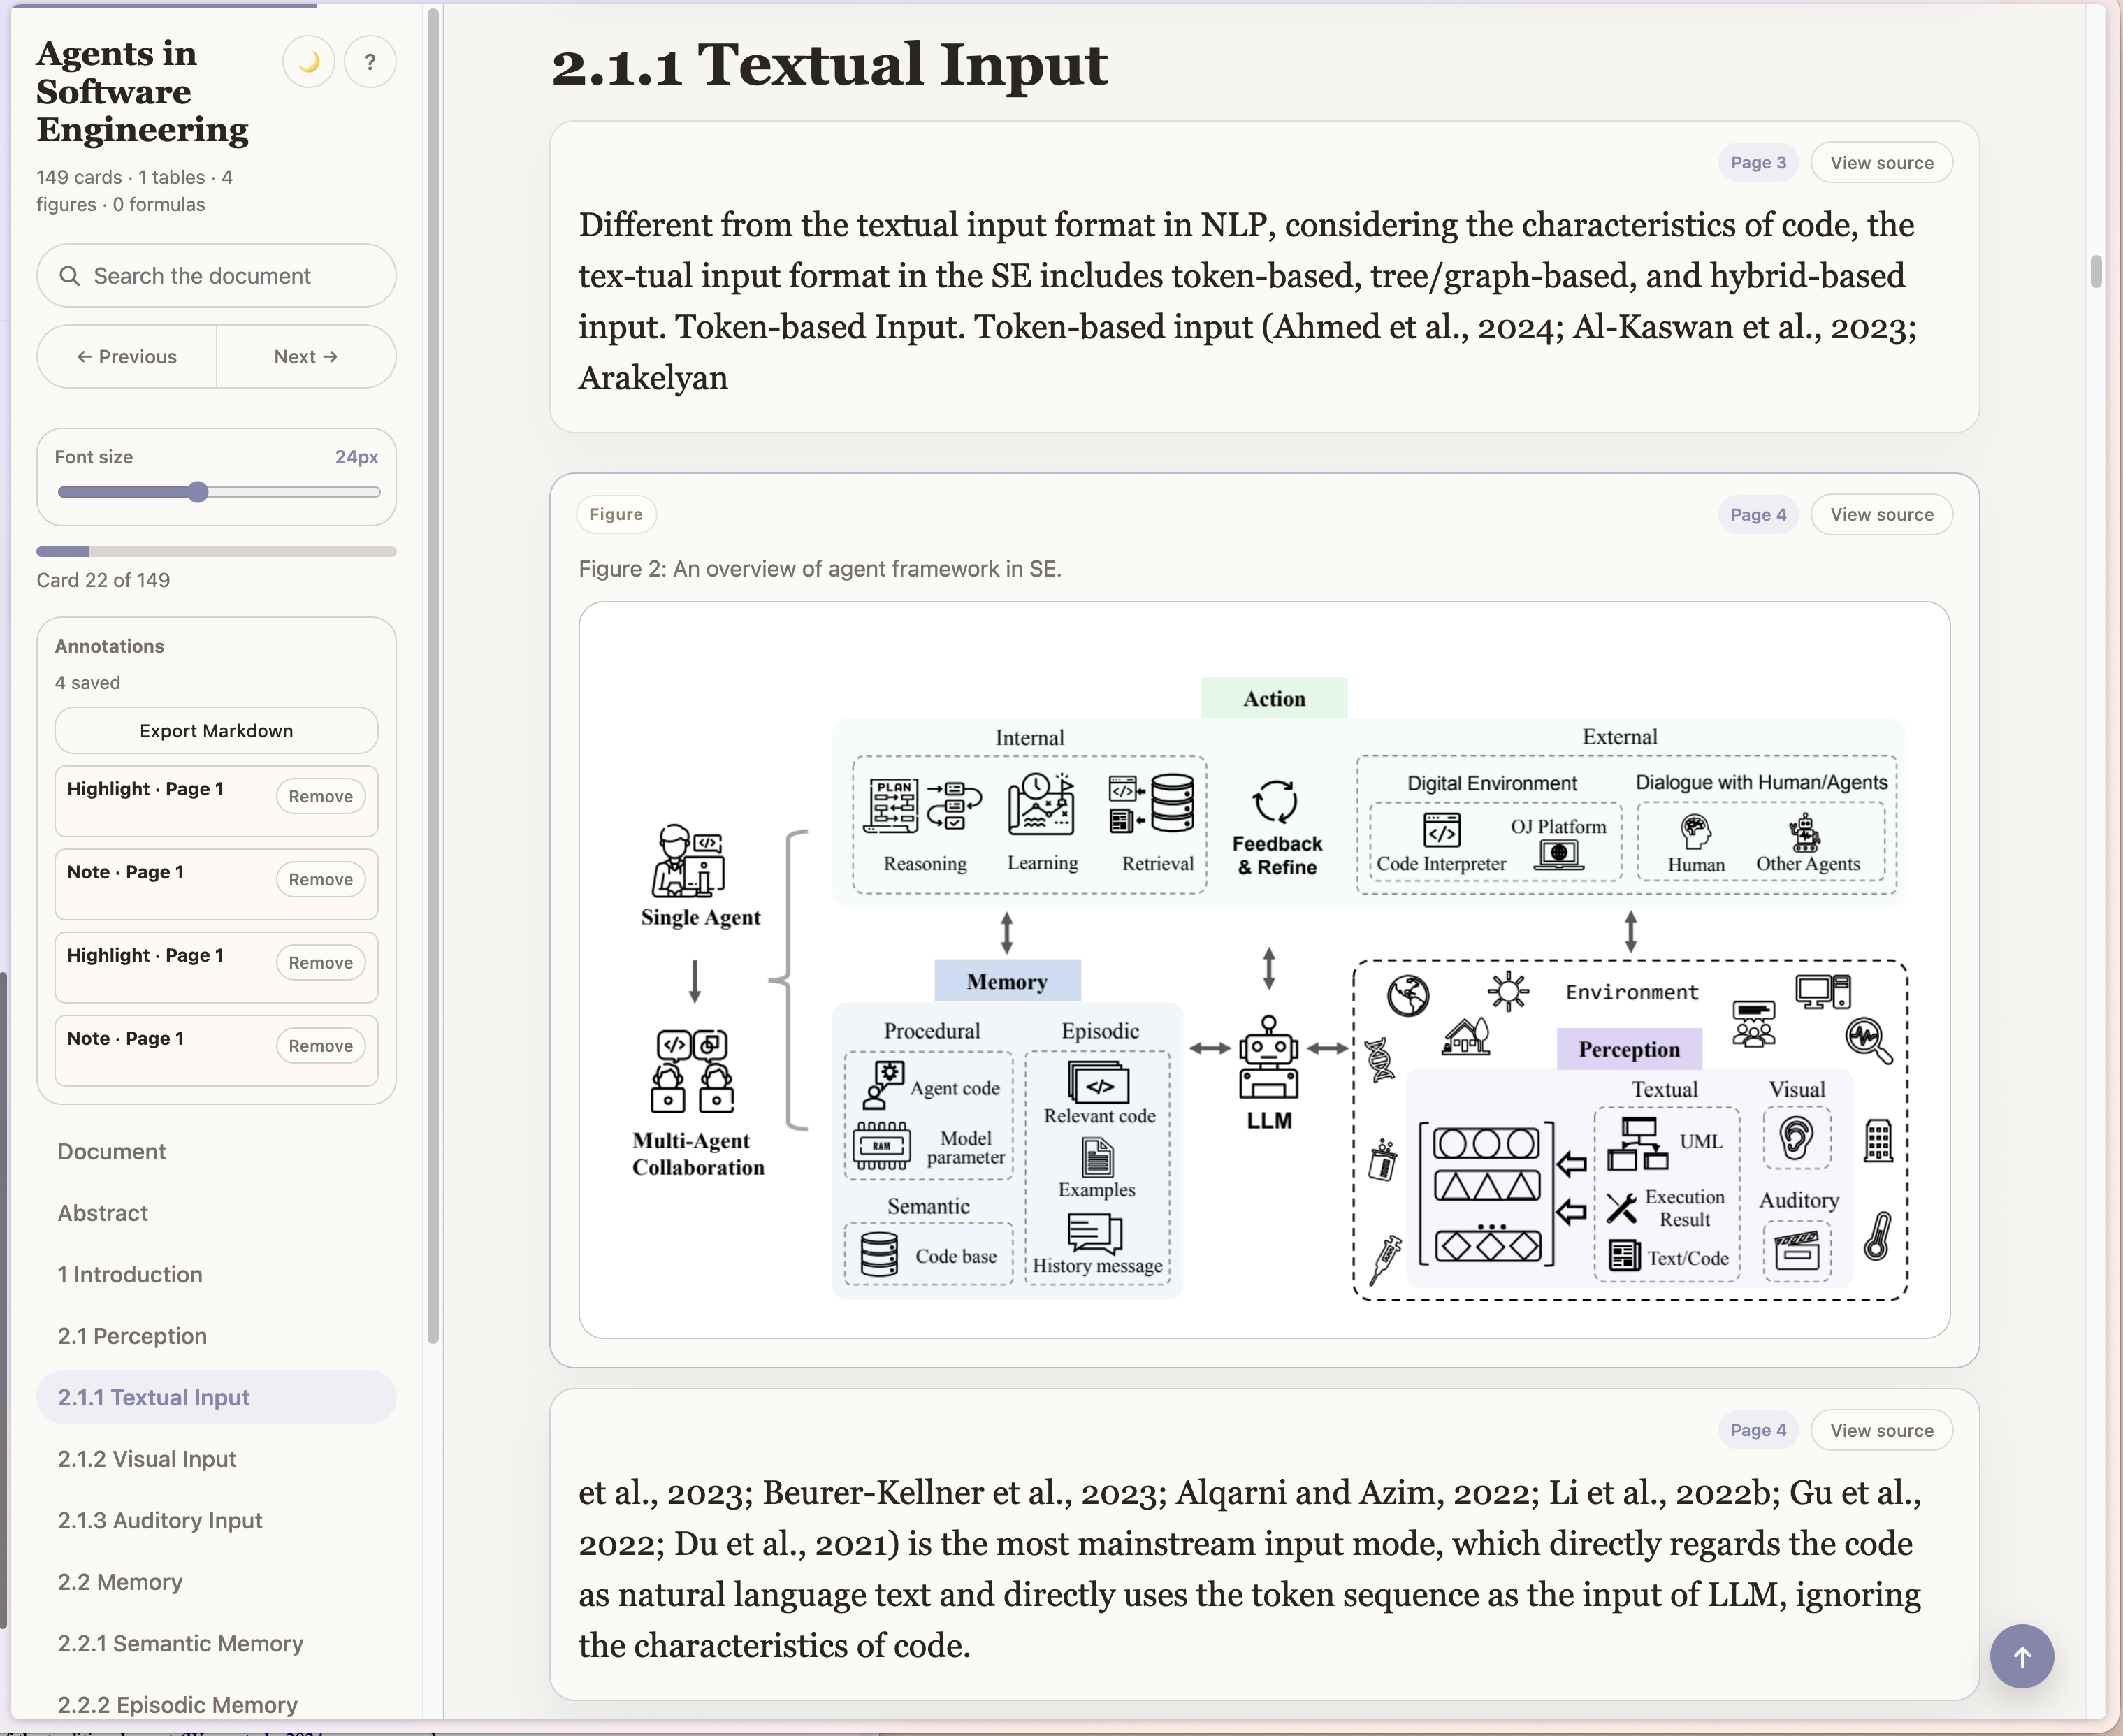
デフォルトのリーダーは、快適に読めるよう設計されています。大きな文字、小さなカード、検索、セクションナビゲーション、前後の移動操作、キーボード操作、フォントサイズスライダー、ソースページのプレビューを備えています。
PDF Card MCP は、実際に読んだり、引用したり、確認したりする必要がある PDF を対象としています。長い文書をソースにリンクされた小さなカードに変換し、表、図、数式を忠実な画像の切り抜きとして保持し、自分のメモやハイライトを Markdown としてエクスポートできます。
クイックインストール(ワンクリック)
PDF Card MCP は Python サーバーのため、ランタイムが必要です。最初にインストールするものは uv だけです。Python を管理してくれるため、自分でインストールする必要はありません。以下のすべてのインストール方法で必要となる前提条件はこれだけです。
# macOS / Linux
curl -LsSf https://astral.sh/uv/install.sh | sh
# Windows (PowerShell)
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"
次に、ワンクリックでサーバーを追加します。ボタンから、公開されている pdf-card-mcp パッケージを uv 経由で実行します。
Claude Code(ターミナル):
claude mcp add pdf-card -- uvx --from pdf-card-mcp pdf-card-mcp-server
Claude Desktop(ターミナル不要、前提条件なし):最新リリースから pdf-card-mcp-desktop.mcpb をダウンロードし、ダブルクリックして拡張機能としてインストールします。このバンドルでは uv ランタイムが宣言されているため、Claude Desktop が Python と依存関係をインストールします。この方法では、上記の uv の手順は不要です。
インストール後、新しいサーバーを認識させるため、クライアントを再起動するか、クライアント内で MCP サーバーを再読み込みしてください。
実際のスクリーンショット
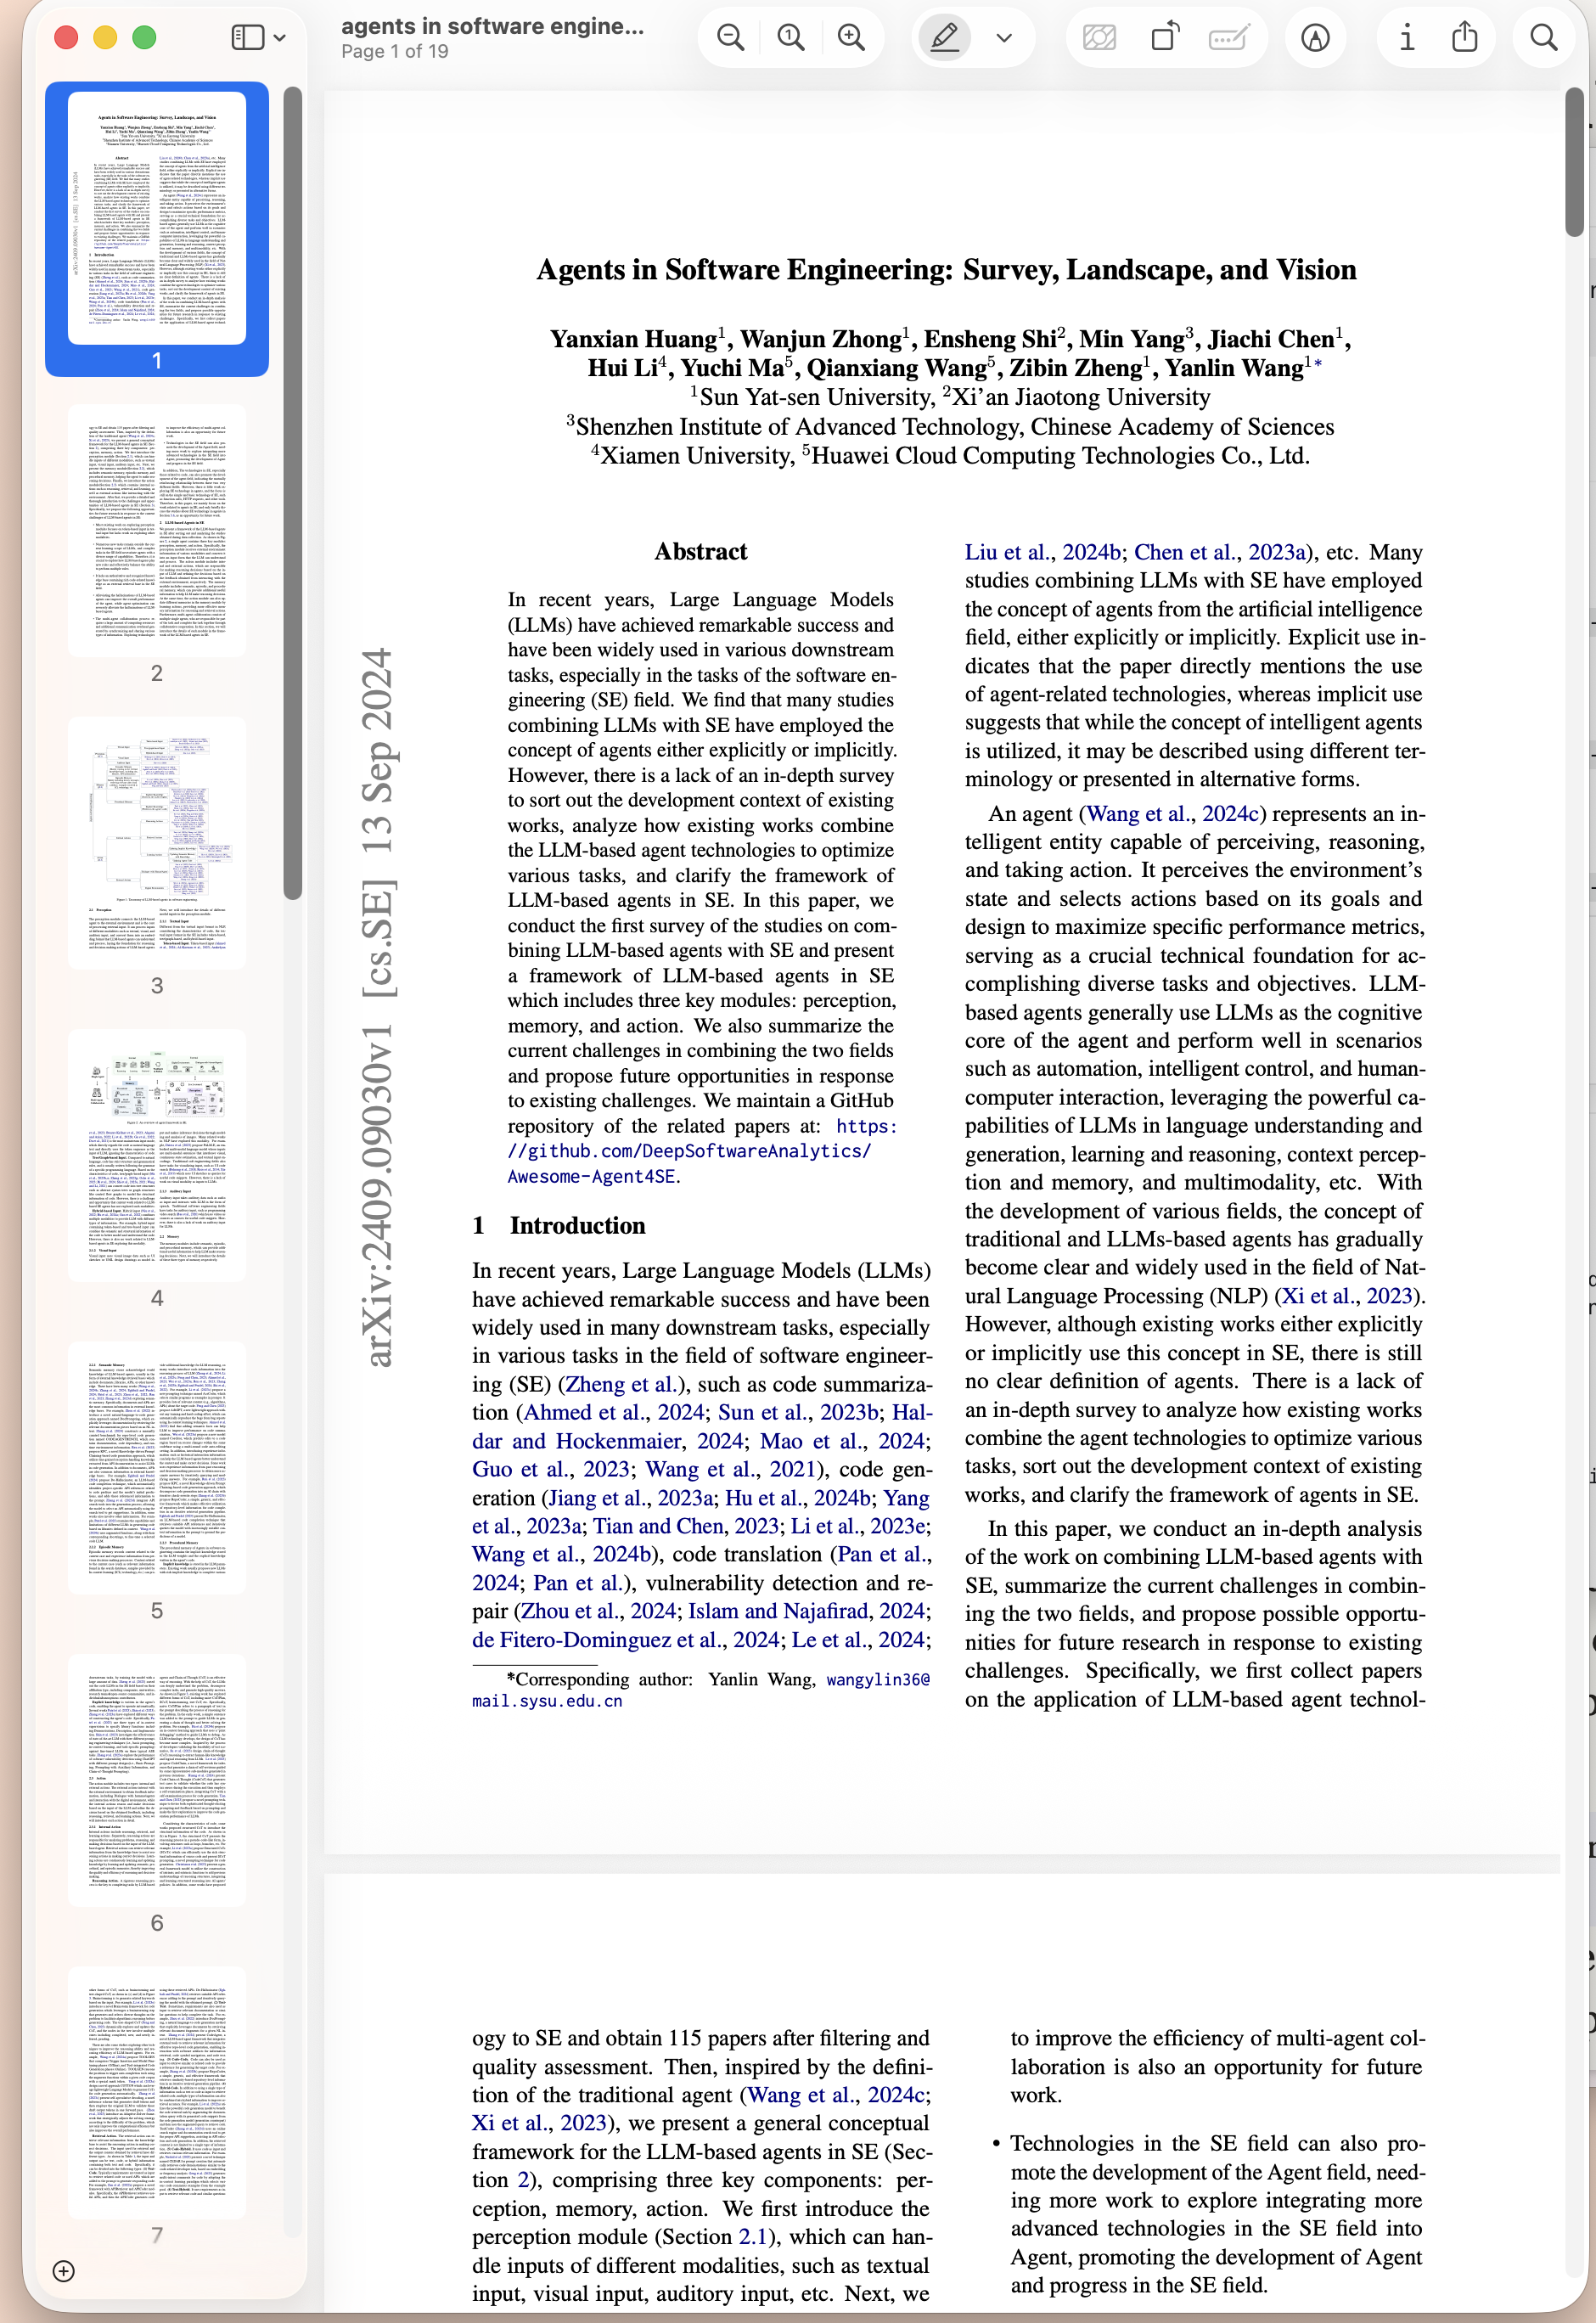
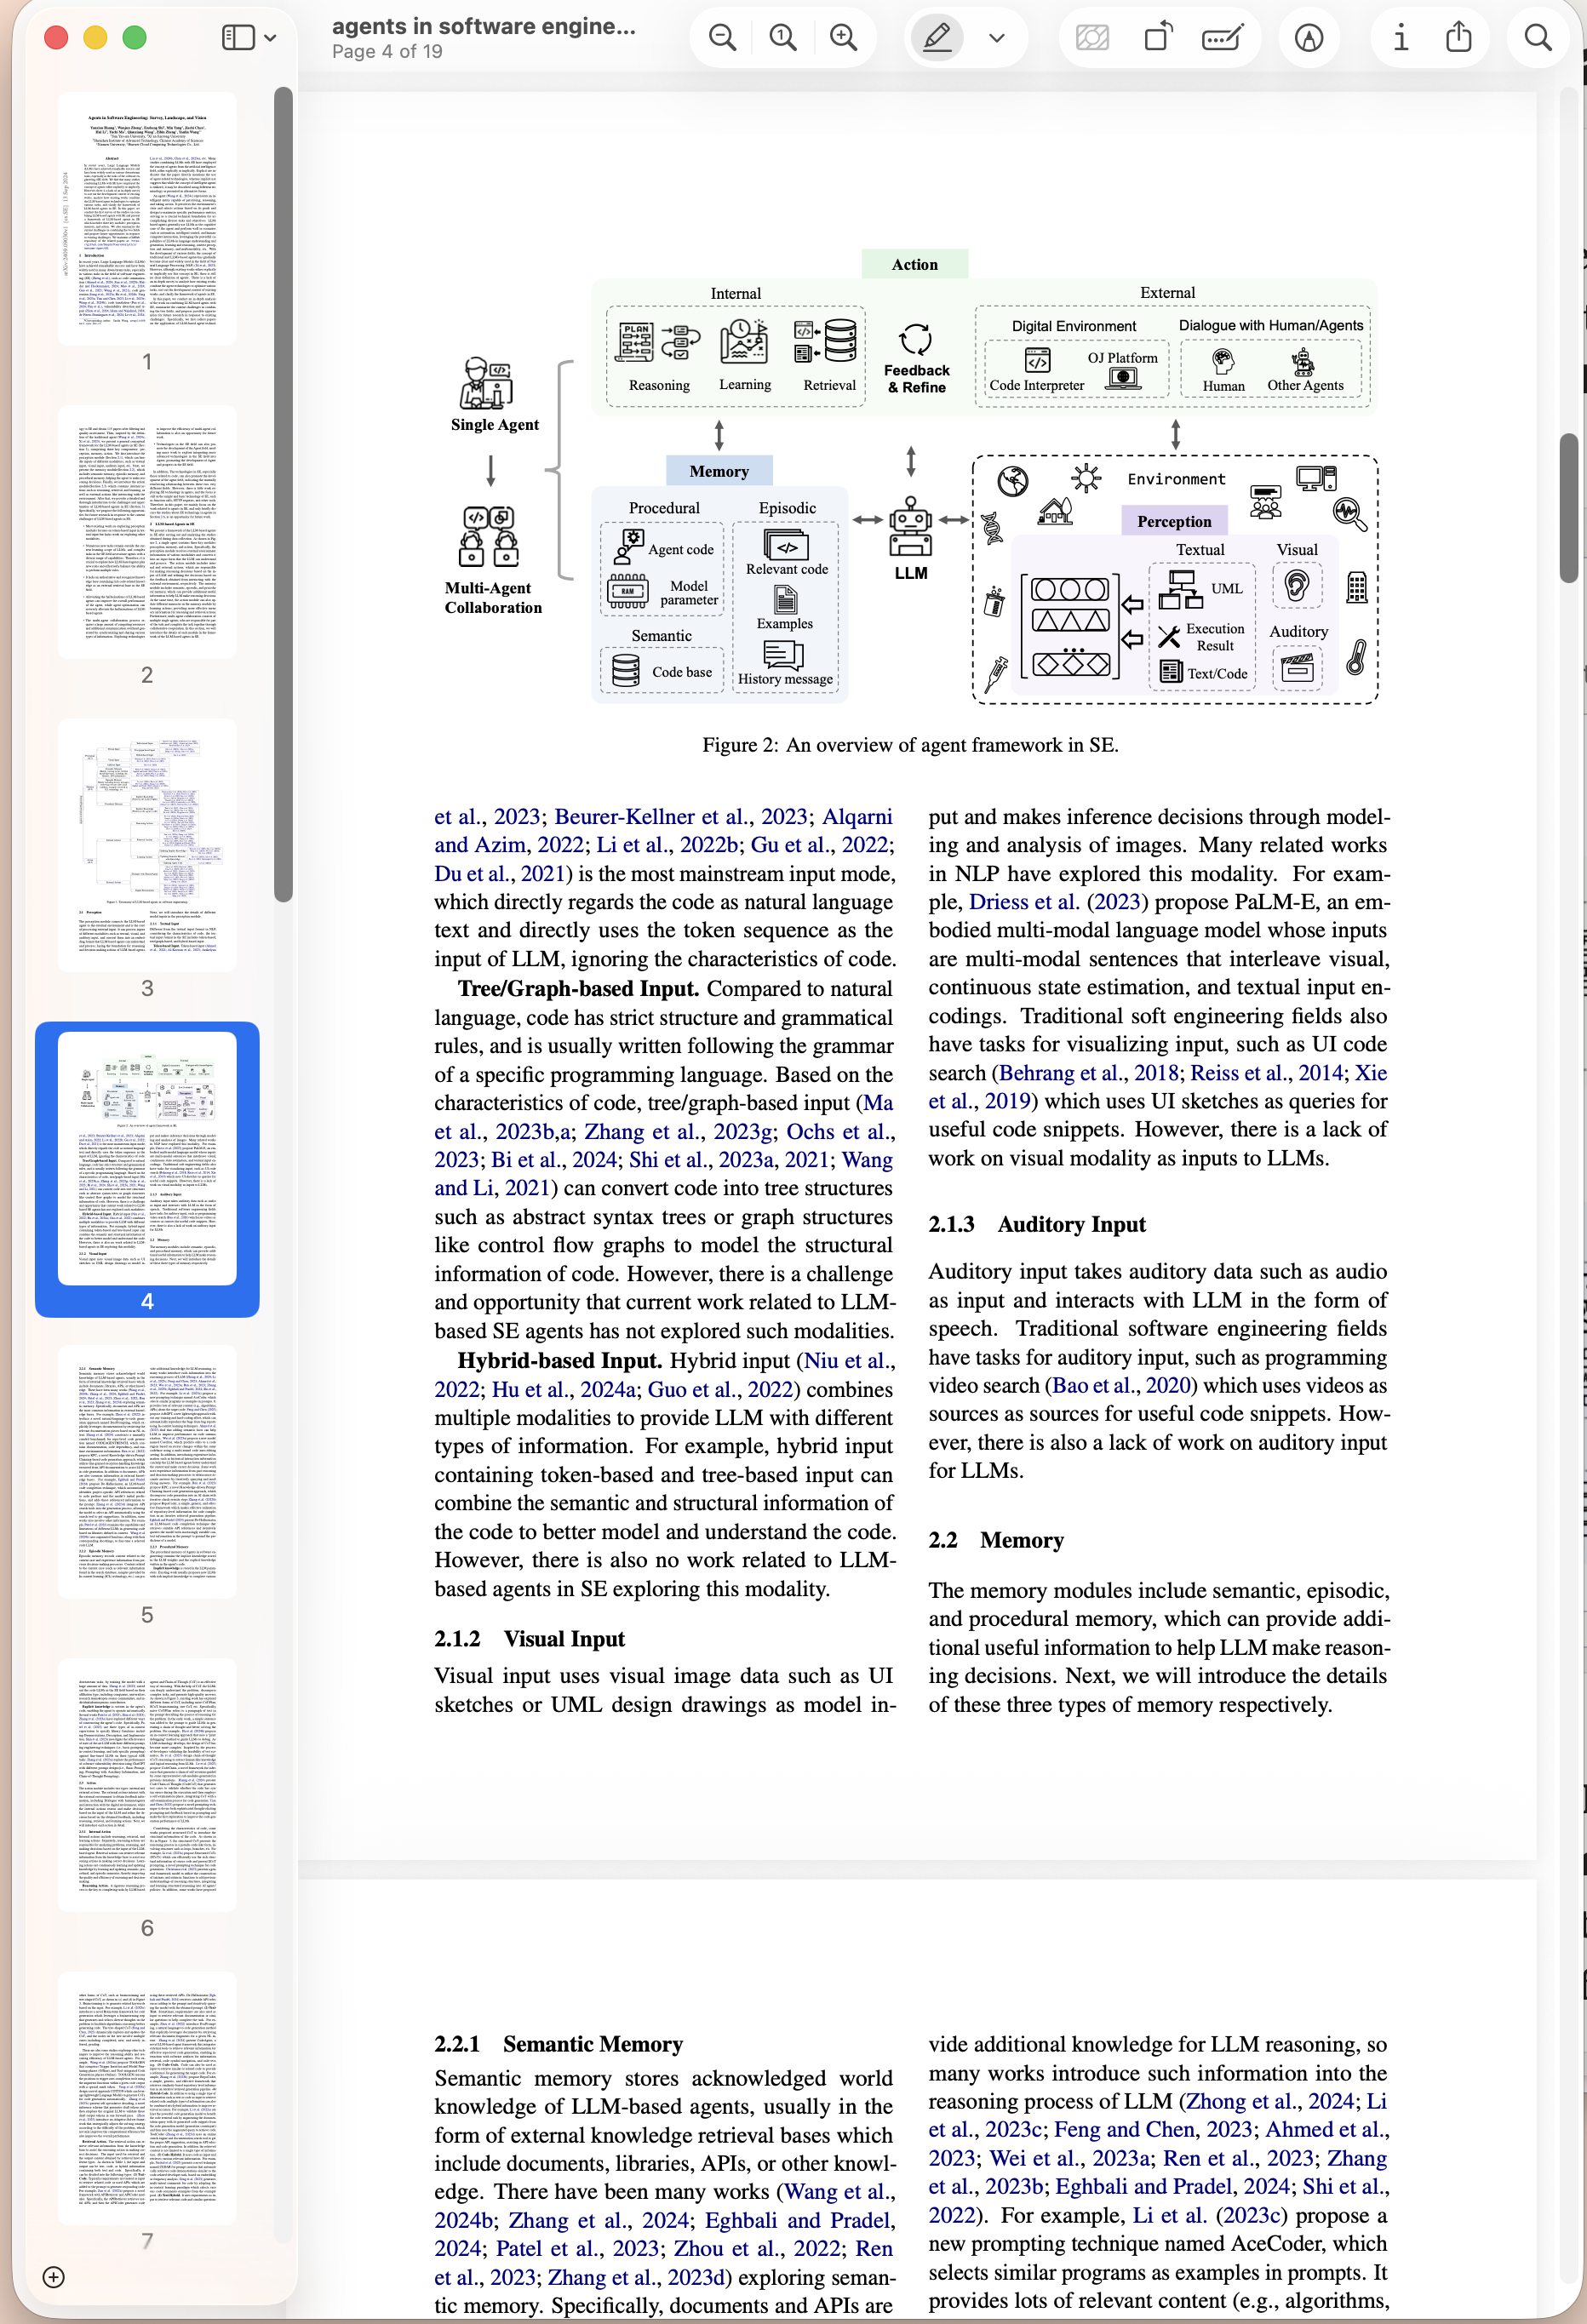
これらのスクリーンショットは、Agents in Software Engineering 用に生成されたリーダーと、 比較用に横並びで開いた同じソース PDF のものです。
| 生成されたリーダー | 元の PDF |
|---|---|
 |  |
 |  |
簡単な使用例
ローカル PDF をポータブルな HTML リーダーに変換します。
pdf-card-mcp ./paper.pdf --output ./out/paper-reader.html
PDF 由来のスタイルを使うには、明示的なサブコマンド形式を使用します。
pdf-card-mcp convert ./paper.pdf \
  --output ./out/paper-reader.html \
  --style-engine pdf
MCP サーバーを実行し、互換性のあるホストがローカル PDF のパスからリーダーを生成できるようにします。
python -m pdf_card_mcp.server
選択した公開注釈を含む、読み取り専用の静的リーダーを公開します。
pdf-card-mcp publish ./out/paper-reader.html \
  --annotations ./paper.annotations.json \
  --output ./published/paper-reader.html
出力の概要
| 出力 | 内容 |
|---|---|
paper-reader.html | CSS、JavaScript、ページ画像、検出された切り抜きを埋め込んだスタンドアロンリーダーです。 |
paper.manifest.json | カード、ページ、警告、ソースアンカーの構造化メタデータです。 |
| Markdown エクスポート | リーダー UI で作成したメモとハイライトです。 |
| 公開バンドル | 公開注釈を共有するための、読み取り専用の静的 HTML またはディレクトリバンドルです。 |
ステータス
これは初期段階のオープンソース実装です。現在はテキストレイヤーを持つ PDF に便利で、
pdfplumber によるベストエフォートの表検出、pypdfium2 による制約の少ないラスター描画、
およびオプションで利用できる gmft による、より高機能なローカル表検出に対応しています。
スキャンされた PDF には、オプションの OCR サポートが必要です。
インストール
ほとんどの方には、上記のワンクリックインストールをおすすめします。 パッケージを直接インストールするには、PyPI から次のコマンドを実行してください。
python -m pip install pdf-card-mcp
または、リポジトリから未リリースの最新変更を直接インストールします。
python -m pip install "pdf-card-mcp @ git+https://github.com/velyan/pdf-card-mcp.git"
ローカルで開発する場合:
git clone https://github.com/velyan/pdf-card-mcp.git
cd pdf-card-mcp
python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install -e ".[dev]"
MCPB のパッケージ化には uv をおすすめします。
uv sync
uv run pdf-card-mcp path/to/document.pdf --output out/document.html
より高精度な表の切り抜きを行う場合は、オプションのローカル ML 表検出器をインストールしてください。
uv sync --extra table-ml
uv run --extra table-ml pdf-card-mcp path/to/document.pdf --table-engine gmft
MCP クライアントでの使用
uvx を使って、Claude Code またはその他の CLI 互換 MCP クライアントに追加します(uv が必要です)。
claude mcp add pdf-card -- uvx --from pdf-card-mcp pdf-card-mcp-server
汎用 MCP ホストの設定:
{
  "mcpServers": {
    "pdf-card": {
      "command": "uvx",
      "args": ["--from", "pdf-card-mcp", "pdf-card-mcp-server"]
    }
  }
}
PyPI リリース前にローカルで開発する場合は、クライアントがこのチェックアウトを参照するように設定します。
{
  "mcpServers": {
    "pdf-card-local": {
      "command": "uv",
      "args": [
        "--directory",
        "/path/to/pdf-card-mcp",
        "run",
        "python",
        "-m",
        "pdf_card_mcp.server"
      ]
    }
  }
}
Claude Desktop では、最新の GitHub リリースから .mcpb バンドルをインストールすることもできます。
Docker/レジストリスキャナー
このリポジトリには、Glama などのレジストリがサーバーをビルドして標準入出力経由で起動し、MCP ツールのスキーマを検査できるよう、最小限の Dockerfile が含まれています。サーバーは引き続きローカルのファイルパスで動作するため、コンテナのユーザーは、ツールで読み取りまたは書き込みを行いたい PDF と出力ディレクトリをマウントする必要があります。
docker build -t pdf-card-mcp .
docker run --rm -i \
  -v "$PWD/examples:/docs" \
  pdf-card-mcp
CLI の使用方法
pdf-card-mcp path/to/document.pdf --output examples/out/document.html
コマンドは次のファイルを書き出します。
document.html:CSS、JavaScript、表の切り抜き、図の切り抜き、数式の切り抜き、ソースページ画像を埋め込んだスタンドアロンリーダーです。document.manifest.json:画像ペイロードを埋め込まない構造化メタデータです。
明示的なサブコマンド形式もサポートされています。
pdf-card-mcp convert path/to/document.pdf --output examples/out/document.html
注釈、ハイライト、静的公開
生成されたリーダーには、ローカルの注釈オーバーレイが含まれます。
- ハイライトは、選択したソーステキストです。
- 注釈は、選択したソーステキストと、入力した独自の注釈テキストです。
テキストカード内のテキストを選択して、Highlight または Note を選び、Export Markdown を使うと、読みやすい .annotations.md ファイルをダウンロードできます。リーダー UI からのインポートは、現時点では意図的に公開していません。
注釈とハイライトはユーザーが作成したデータであり、ソースから生成される
document.manifest.json とは別に保持されます。
より低レベルの CLI と MCP 公開ツールでは、注釈を埋め込んだ読み取り専用の静的リーダーを作成する際に、構造化された注釈バンドルを引き続き受け付けます。リーダーに対してそのバンドルを検証します。
pdf-card-mcp validate-annotations examples/out/document.html document.annotations.json
公開注釈を含む、共有可能な静的リーダーを公開します。
pdf-card-mcp publish examples/out/document.html \
  --annotations document.annotations.json \
  --output published/document-reader.html
--output が .html ファイルではなくディレクトリの場合、コマンドは静的バンドルを書き出します。
index.htmlreader.manifest.jsonreader.annotations.jsonbundle.json
公開時には、デフォルトで visibility: public の注釈のみが含まれ、ローカルの
source_pdf パスは削除され、公開されるリーダーは読み取り専用として表示されます。公開出力にローカルの非公開メモを含める場合に限り、--include-private を使用してください。含める注釈をリーダーに紐付けられない場合、公開は失敗します。公開前に validate-annotations を実行して、不一致を確認してください。
MCP ツール
MCP サーバーは、同じローカルコンバーターを利用する自動化レイヤーです。MCP クライアントからローカルのファイルパスを受け取り、生成されたリーダーのパス、マニフェストのメタデータ、警告、公開および検証の結果を返します。
サーバーは次の 3 つのツールを公開します。
convert_pdf_to_card_html
validate_reader_annotations
publish_reader_bundle
入力:
pdf_path:ローカル PDF のパスです。output_path:省略可能な HTML 出力パスです。title:省略可能なタイトルの上書き値です。standalone:デフォルトはtrueです。アセットフォルダーへの出力は今後のリリースで対応予定です。ocr:pytesseractがインストールされている場合に使用する、省略可能な OCR フォールバックです。max_pages:省略可能な処理ページ数の上限です。theme:デフォルトはsoftです。style_engine:fixed、pdf、samplingのいずれかです。デフォルトはpdfです。fixedは元のソフトパレットを維持し、pdfはソース PDF から上限付きの色とタイポグラフィのヒントをローカルで導出し、samplingはホスト LLM にローカルのヒントから検証済みのスタイルトークンを選択させます。table_engine:auto、pdfplumber、gmftのいずれかです。autoは、インストールされている場合にgmftを使用します。text_engine:char_geometryまたはpdfplumber_wordsです。デフォルトはchar_geometryです。結合された単語をそのまま信頼するのではなく、PDF の文字位置から欠落したスペースを修復します。postprocess_engine:noneまたはsamplingです。デフォルトはnoneです。samplingを設定すると、MCP サーバーはカードの境界のみを整える操作をホスト LLM に依頼し、ソーステキストが完全に保持されていることを検証してから、生成されたリーダーを書き換えます。MCP クライアントがサンプリングに対応していない場合は、警告とともに決定論的な出力が返されます。model_cache_dir:ローカル ML テーブルモデルの重みを保存する、省略可能なキャッシュディレクトリです。offline:キャッシュ済みのオプション ML モデルのみを使用します。
validate_reader_annotations は、メモ/ハイライトのサイドカーファイルを生成済みのリーダーに対して検証します。
publish_reader_bundle は、既存の生成済みリーダーと省略可能な注釈サイドカーファイルから、公開可能な静的 HTML ファイルまたはディレクトリバンドルを書き出します。
サンプリングによる後処理の範囲は意図的に限定されています。カードの境界について、ホスト LLM は結合、見出しの抽出、前付け/脚注の分類を提案できますが、Python による検証で、ソーステキストの書き換え、削除、捏造、並べ替えを伴う操作は拒否されます。style_engine=sampling の場合、ホスト LLM は上限付きのスタイルトークンとパレット候補 ID のみを選択できます。生の CSS、JavaScript、任意の色は返せません。サンプリングが利用できない場合、リーダーには決定論的な PDF 由来のスタイルが維持され、警告が返されます。
サーバーをローカルで実行します。
python -m pdf_card_mcp.server
MCPB のパッケージ化
このリポジトリは、ルートディレクトリを直接パッケージ化できる構成になっています。
python scripts/build_mcpb.py --variant all
これにより、3 つのバンドルがビルドされます。
dist/pdf-card-mcp-lite.mcpbとdist/pdf-card-mcp.mcpbは、MCP レジストリと Smithery ディレクトリとの互換性のためにserver.type = "python"を宣言します。フルバンドルには、さらにtable-mlエクストラがインストールされます。これらはuv経由で実行されるため、ホスト側(またはユーザー側)でuvを用意する必要があります。dist/pdf-card-mcp-desktop.mcpbは(manifest.uv.jsonで)server.type = "uv"を宣言します。Claude Desktop が Python と依存関係を管理するため、エンドユーザーは前提条件なしでダブルクリックしてインストールできます。これは、上記のワンクリックインストールのセクションからリンクされているバンドルです。
どのバンドルにも ML モデルの重みは含まれていません。offline=true を設定して事前にキャッシュを用意していない限り、gmft は初回使用時にモデルをローカルにダウンロードしてキャッシュします。
プライバシー
デフォルトの PDF 処理はローカルで行われます。決定論的なコンバーターは、ドキュメントの内容をアップロードしたり、外部 API を呼び出したりしません。ユーザーが OCR の依存関係をインストールしている場合、オプションの OCR もローカルで実行されます。
MCP 経由で style_engine=sampling または postprocess_engine=sampling を有効にすると、検証済みのスタイルトークンまたは境界操作のプランを生成するために、ホストの LLM が制限されたスタイルヒントやカードのテキスト断片を受け取る場合があります。ドキュメント由来のテキストをローカルプロセスの外部に送信したくない場合は、決定論的な fixed/pdf スタイルと postprocess_engine=none を使用してください。
公開されたリーダーには、抽出した PDF テキスト、元ページの画像、表/図/数式の切り抜き画像、および含まれている公開用の注記やハイライトが含まれる場合があります。ソースドキュメントの内容と注釈を共有する権利がある場合に限り、生成したリーダーを公開してください。
動作の仕組み
変換パイプライン(ページのレンダリング、表/図の切り抜き、重なりの抑制、テキストカードの結合、単独で動作する HTML 出力を含む)を視覚的に解説したドキュメントについては、docs/how-it-works.html をご覧ください。
表の処理方法
検出されたすべての表は、画像カードとしてレンダリングされます。コンバーターは pdfplumber を使って表の領域を検出し、より精度の高いローカル検出が必要な場合は、オプションで gmft/Table Transformer を使用できます。その後、pypdfium2 を使って、元ページの表領域のみをラスター化し、PNG に変換します。キャプションはリーダーのテキストと代替テキストとして保持されますが、表自体は画像のままにすることで、レイアウトや数値の位置合わせが変換後も維持されます。
ドキュメントに表への言及があるものの、信頼できる表領域が見つからない場合、マニフェストに警告が含まれるため、呼び出し元はソースページを確認するかどうかを判断できます。
数式の処理方法
PDF 内で中央揃えの数式らしいテキストブロックとして認識される場合、ディスプレイ数式は画像カードとして扱われます。抽出された数式文字列は代替テキスト/検索用のメタデータとして保持されますが、リーダーにはソースの切り抜き画像を表示するため、下付き文字、上付き文字、矢印、数式の間隔が忠実に保たれます。
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。