FrankenSurf について
FrankenSurf は AI エージェント向けの Web 読み取り・検索ツール群です。コストの低い順にツールを試してページを検証し、ページデータと試行記録を返します。MCP、Python、コマンドラインで利用でき、サイトのマッピングやクロールにも対応します。
主な機能
- 01コスト順に Web 読み取りツールを試行
- 02ページを検証し試行記録を出力
- 03検索結果の検索と検証
- 04サイトの読み取り、マッピング、クロール
- 05任意の有料フォールバックと上限設定
- 06プロファイルと人による引き継ぎに対応
活用シーン
- 01アクセス制限のあるページをエージェントで読み取る
- 02トピックや日付で検索結果を絞り込む
- 03サイトのページを Markdown にクロール
- 04読み取り失敗時に使用ツールとコストを確認
MCP 対応
MCP サーバーは Web 読み取り、検索、サイトのマッピングやクロールのツールを公開し、ページ品質情報とツールの試行記録も返します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
19掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| url | string | はい | |
| items | any | いいえ | |
| module | any | いいえ | |
| render | any | いいえ | |
| schema | any | いいえ | |
| profile | any | いいえ | |
| identity | any | いいえ | |
| provider | any | いいえ | |
| freshness | any | いいえ | |
| lightning | any | いいえ | |
| card_images | any | いいえ | |
| expect_terms | any | いいえ | |
| main_content | any | いいえ | |
| allow_archive | any | いいえ | |
| allow_handoff | any | いいえ | |
| include_images | any | いいえ | |
| module_override | any | いいえ | |
| try_harder_than | any | いいえ | |
| acquisition_policy | any | いいえ | |
| allow_real_browser | any | いいえ |
詳細

Frankensurf
41 個のウェブツールを組み合わせた、AI エージェント向けの 1 回の read() 呼び出し。
最も安価なツールから試し、すべてのページを検証し、試行ごとに記録を残します。



ウェブサイト · ドキュメント · クイックスタート · ベンチマーク · 開発した理由
どのウェブツールにも苦手なサイトがあり、そのサイトはツールごとに異なります。Frankensurf は すべてのツールの前段に位置し、エージェントからの呼び出しを 1 回にまとめます。最も安価なツールから試し、ページが 実在することを確認します。サイトに拒まれた場合にのみ、より強力なツールへ切り替え、 取得方法の記録とともに、ページのデータをきれいな形で返します。
| 安価なツールから試行 プレーンな HTTP、Jina Reader、ローカルブラウザー、無料のステルスブラウザー、ホスト型ブラウザーの順に試し、許可されている場合にのみ有料 API を使います。 | すべてのページを検証 チャレンジページ、ログイン画面、または検索結果が読み込まれていない検索ページは、成功ではなく失敗として扱います。 | 処理内容を明示 各結果には、実行したツール、所要時間、費用、処理を停止した理由が記録されます。 |
クイックスタート
Linux、macOS、または WSL 経由の Windows で使える Python 3.12 以降が必要です。アカウントもキーも必要ありません。
pip install "frankensurf[mcp]"
frankensurf install        # every free tool: browsers, stealth browsers, local search, Crawl4AI
frankensurf read "https://www.walmart.com/search?q=air+fryer" --explain
読み取りでは、実際のページが取得できるまで順に試します。
https://www.walmart.com/search?q=air+fryer
  ✗ http                   CAPTCHA                0.4s
  ✗ local                  CAPTCHA                1.5s
  ✓ camoufox               got the page           15.6s

air fryer - Walmart.com
24,192 characters via camoufox, complete (107 results), free
frankensurf install は playwright install と同じように動作します。インストールするツール名だけを指定し
(frankensurf install search chromium)、Linux でブラウザーのシステムライブラリも一緒にインストールするには
--with-deps、インストール済みの場所を確認するには --list を追加し、削除するには
frankensurf uninstall all を実行します。Docker は不要です。各リリースは、新規の Ubuntu および macOS マシンに PyPI からインストールして検証しています。
使い方
エージェントから、MCP サーバーとして利用できます(クライアントごとのセットアップ):
claude mcp add frankensurf -- frankensurf-mcp
Python から:
import frankensurf as fs

page = fs.read("https://example.com/pricing")
if page.ok:
    print(page.title, page.text[:500])
else:
    print("couldn't read it:", page.failure)    # {"code": "CAPTCHA", "message": ...}

pages = fs.batch(urls, links=True)               # paced per site, in order
hits = fs.search("playwright python tutorial", recency="month")
page = await fs.aread(url)                       # aread, abatch, asearch inside async code
長時間稼働するサービスでは、1つの Runtime を開いたままにします:async with Runtime() as web: await web.read(url)。
マップとクロール: fs.map(url) はサイトの URL を一覧表示します。fs.crawl(url, limit=50) は、その一部を Markdown として読み取ります。
エージェントモード(pip install "frankensurf[agent]"、任意の LiteLLM モデル):fs.ask("question") は検索、読み取り、ソース付きの回答を行い、読み取れなかった内容も伝えます。fs.extract(urls, schema=...) と fs.summarize(url) も利用できます。
エージェントモード。
Docker では、ネットワーク全体で1回インストールするだけです:docker run -p 3002:3002 -e FRANKENSURF_API_KEY=... ghcr.io/yail259/frankensurf
(Docker)。
Firecrawl URL を指定できるあらゆるツールから(GPT Researcher、Hermes Agent、OpenClaw、Open WebUI、Dify、LibreChat、n8n、LangChain、LlamaIndex など):
frankensurf serve を実行し、http://127.0.0.1:3002 を指定します(セットアップ)。
コマンドラインから:
frankensurf read https://example.com --markdown
frankensurf search playwright python tutorial --recency week
frankensurf watch https://news.ycombinator.com/ --link-pattern 'item\?id=\d+'
Claude Code のプラグインとして(MCP サーバーと、Claude にその使い方を教えるスキル):
/plugin marketplace add yail259/frankensurf
/plugin install frankensurf@frankensurf
LangChain、OpenAI Agents SDK、CrewAI から(pip install "frankensurf[langchain]" など):
from frankensurf.agent_tools import langchain_tools   # or openai_agents_tools, crewai_tools
tools = langchain_tools()                              # frankensurf_read, frankensurf_search
取得できるのは回答ではなく、生のページデータです。テキストまたは Markdown、JSON-LD、ページ独自の JSON、画像、そしてレシートが含まれます。ページの意味はエージェントが判断します。期待した結果でなければ、retry_of=<trace_id> を指定して再度リクエストすると、Frankensurf はすでに試したツールをすべてスキップします。
ベンチマーク
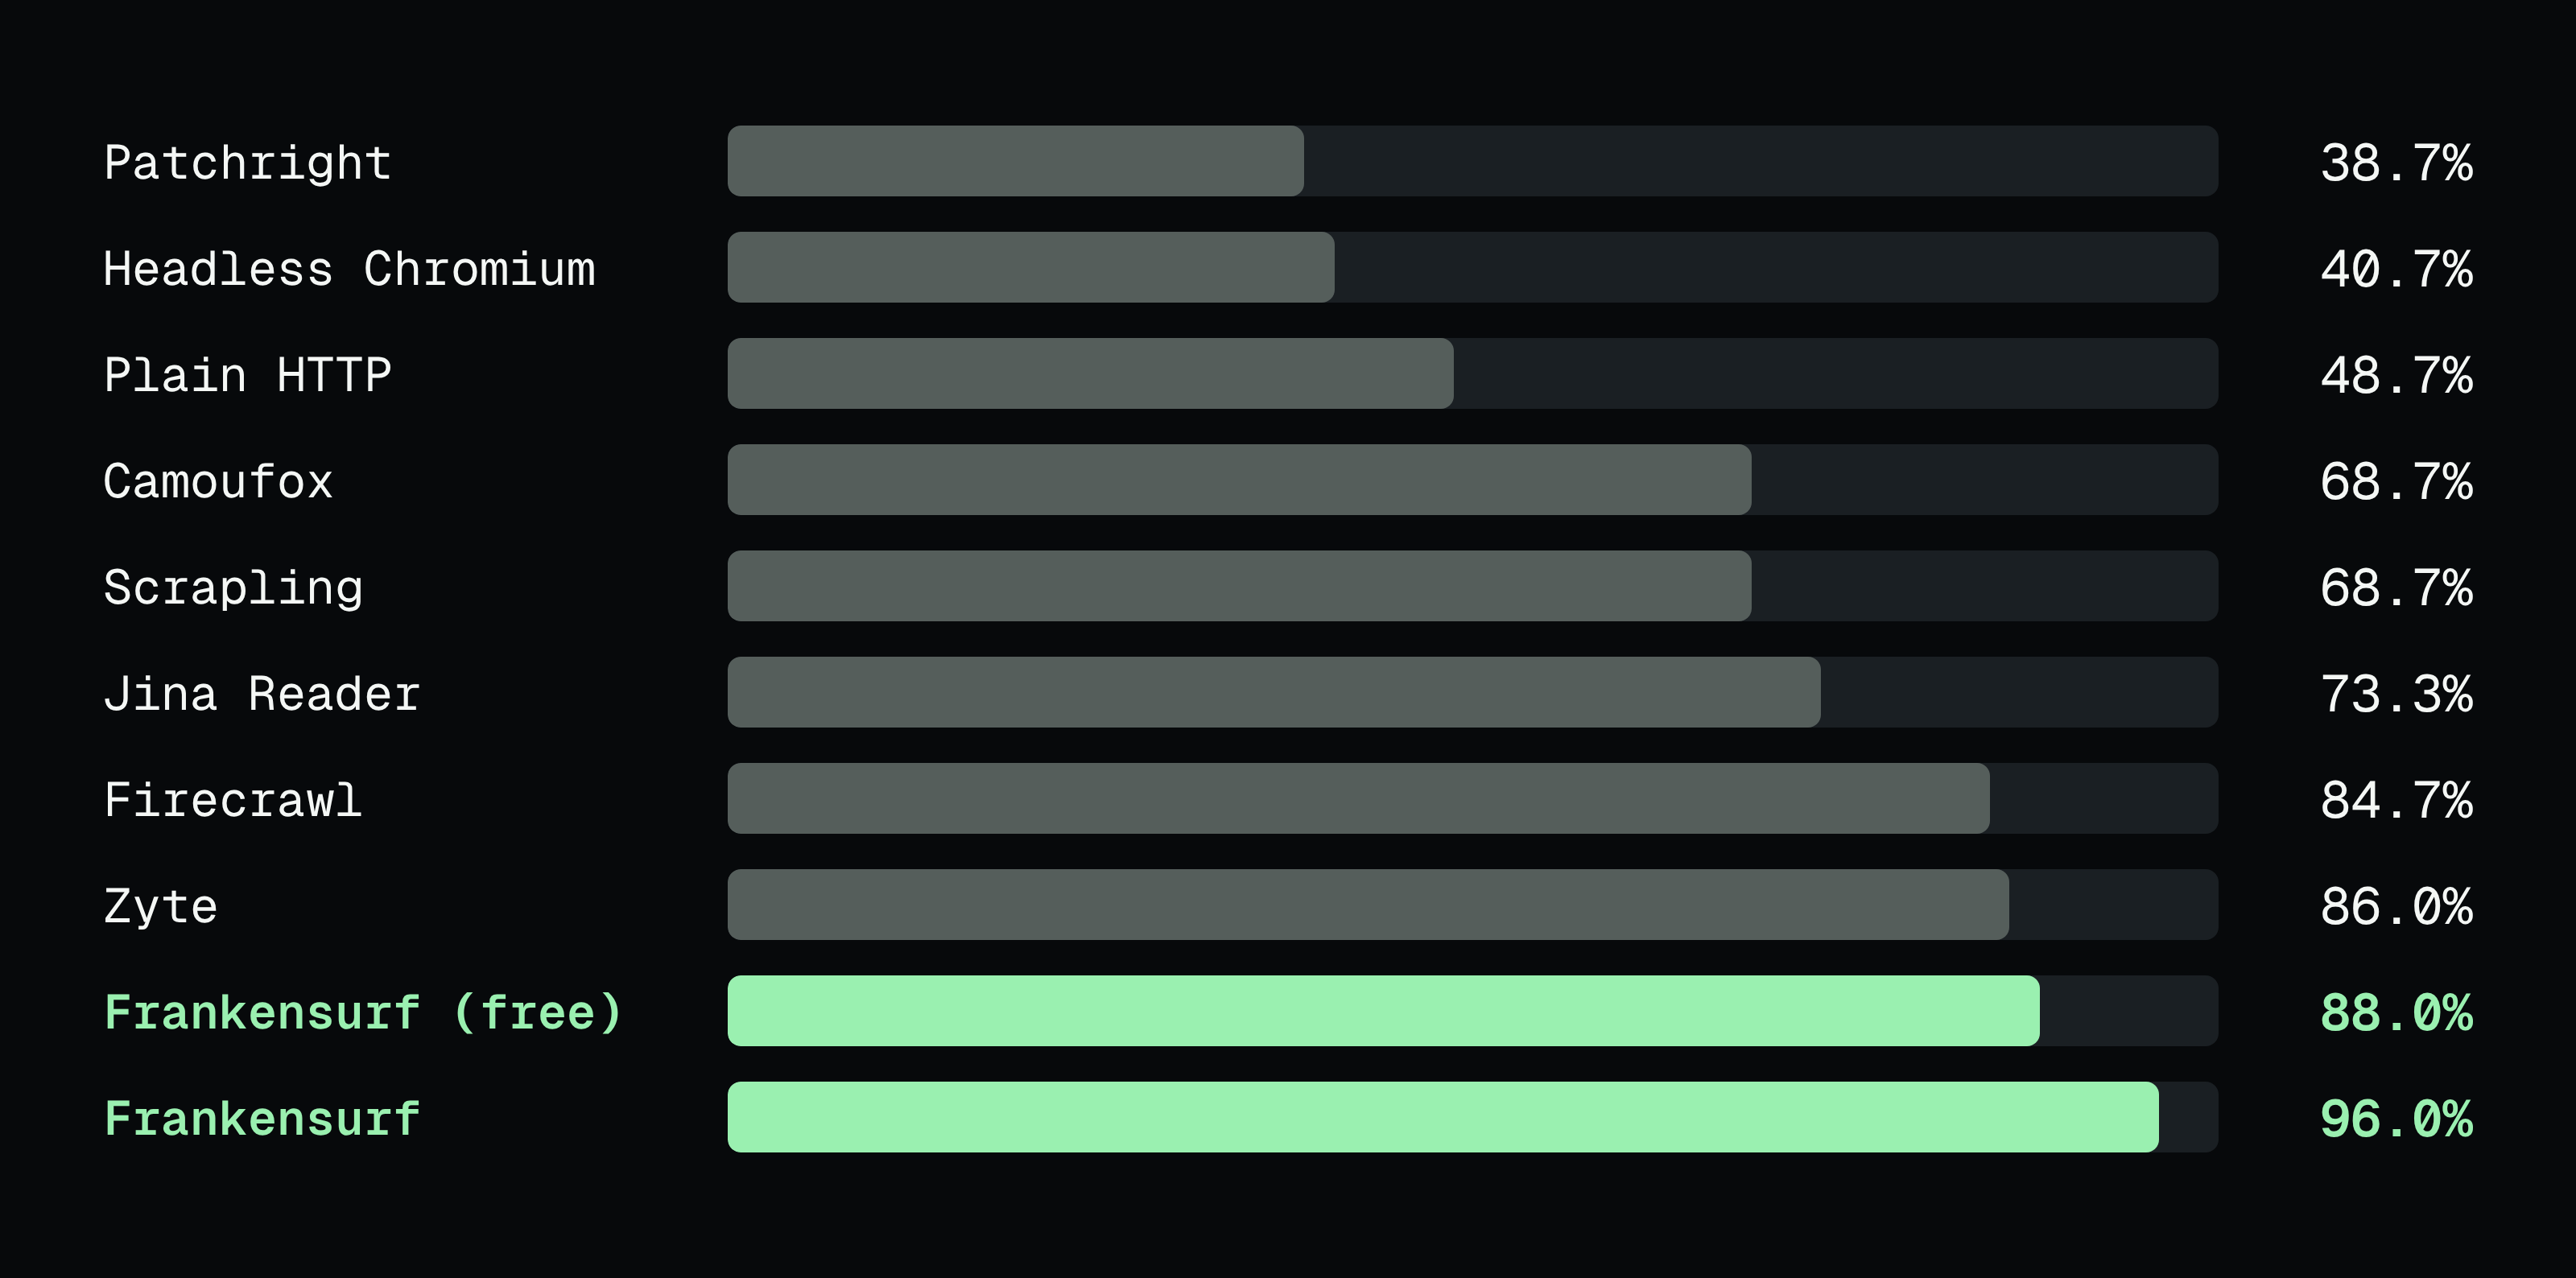
正しいページ1,000件あたりのコスト: Frankensurf の無料ツールでは手数料 $0、月額 $5 のサーバー費用の約 $0.01(正答率 87~88%)です。有料フォールバックを使うと $0.22(96%)、Firecrawl 単独では Scale プランで $0.71、Standard で $0.98(85%)です。 算出方法。
scripts/toolbench.py は各ツールを単独で実行してから、同じページに対し、同じコンテンツチェックを使って Frankensurf を実行します。最新のセットは、15 カテゴリーから選んだ 150 サイトです。どのサイトも内容を読む前に選び、一度だけ読み込みました(2026 年 10 月 11 日。生データの行は benchmarks/2026-10-11/ にあります)。
| ツール | 読み取れたサイト | 中央値 | 1,000 件あたりのコスト |
|---|---|---|---|
| 通常の HTTP のみ | 48.7% | 1.2 s | 無料 |
| Camoufox のみ | 68.7% | 10.9 s | 無料 |
| Jina Reader のみ | 73.3% | 1.5 s | 無料 |
| Firecrawl のみ | 84.7% | 4.6 s | $4.28 |
| Zyte のみ | 86.0% | 10.7 s | 未報告 |
| Frankensurf、無料ツールのみ | 88.0% | 3.6 s | $0 |
| Frankensurf、有料フォールバックあり | 96.0% | 2.9 s | $0.98 |
- Frankensurf は Firecrawl が読み取れなかった 17 サイトを読み取り、Firecrawl が読み取れて Frankensurf が読み取れなかったサイトはありませんでした。
- 有料ツールを一切使わなくても、単独で使った場合に最も優れた有料ツールと同等です(88.0% 対 86.0%、84.7%。150 サイトでは、この差は誤差の範囲内です)。
- 読み込みに時間がかかるページでは、さらに遅くなります。遅いほうから 10% のページでは、読み込みに複数のツールを使うため 25.7 s かかります。Firecrawl は 10.6 s です。
- 一度だけの結果ではありません。前日のセットでは 95.3% 対 85.3%、それ以前の新しいセットでは 89.5% 対 80.3%、88.5% 対 74.1% でした。
同じ 150 サイトでの全ツールの結果
| ツール | 読み取れたサイト | 中央値 | 1,000 件あたりのコスト |
|---|---|---|---|
| Patchright のみ | 38.7% | 4.1 s | 無料 |
| ヘッドレス Chromium のみ | 40.7% | 2.7 s | 無料 |
| 通常の HTTP のみ | 48.7% | 1.2 s | 無料 |
| Camoufox のみ | 68.7% | 10.9 s | 無料 |
| Scrapling のみ | 68.7% | 8.5 s | 無料 |
| Jina Reader のみ | 73.3% | 1.5 s | 無料 |
| Firecrawl のみ | 84.7% | 4.6 s | $4.28 |
| Zyte のみ | 86.0% | 10.7 s | 未報告 |
| Frankensurf、無料ツールのみ | 88.0% | 3.6 s | $0 |
| Frankensurf、有料フォールバックあり | 96.0% | 2.9 s | $0.98 |
中央値は読み取れたページを対象とし、コストは正しく読み取れたページ 1,000 件あたりです。ZenRows と Scrapfly は、プランのクレジットを使い切ったため対象外です。クラウドの新しい VM から実行した場合、データセンターの IP アドレスはサイトにブロックされやすいため、無料ツールでは 82.0%、ライトニングモードでは中央値 1.2 s で 84.0% でした。 ベンチマークを参照してください。
セルフホスト版 Firecrawl との比較
Firecrawl もオープンソースなので、自分で実行する場合に公平に比べるには、セルフホスト版の Firecrawl がどう動作するかを見る必要があります。ドキュメントによると、セルフホスト版ではクラウド版のアンチボットレイヤーである Fire-engine を利用できません。同じ 150 サイトを使い、2026 年 10 月 23 日に、1 台のマシン上で両サーバーを Docker で実行し、サイトごとに最初に読み込む側を交互に入れ替えて、両方で各サイトを読み込みました。
| セルフホスト版 Firecrawl 2.11.604 | Frankensurf 0.52.0(無料ツール) | |
|---|---|---|
| 正しく読み取れたページ | 150 件中 89 件 | 150 件中 126 件 |
| 間違ったページを対象ページとして返した件数 | 18 | 5 |
| 何も返さなかった件数 | 43 | 19 |
| 読み込み中のメモリ使用量 | 約 4.2 GB、コンテナー 6 個 | 1.4 GB、コンテナー 1 個 |
| 中央値、両方が読み取れたページ | 4.2 s | 4.8 s |
| 両方が読み取れたページのうち、遅いほうから 10% | 9.8 s | 17.8 s |
| ページを諦めるまでの時間(中央値) | 1.5 s | 16.5 s |
- Frankensurf はセルフホスト版 Firecrawl が読み取れなかった 38 サイトを読み取り、Firecrawl が読み取れて Frankensurf が読み取れなかったサイトは 1 件でした。
- 遅いページで時間がかかり、諦めるまでの時間も長いのは、より多くのページを読み取るための代償です。セルフホスト版 Firecrawl が一度だけ試して停止するところで、Frankensurf はステルスブラウザーまで段階的に切り替え、返す前に各ページをチェックします。
- データ、スクリプト、セットアップについては、
benchmarks/2026-10-23-self-hosted-firecrawl/を参照してください。frankensurf compare urls.txt --against http://localhost:3002を使って、ご自身のページで実行できます。
検索
search はまず無料のソースを利用し、各結果を確認します。トピックに合っているか、適切な種類のページか、指定した日付範囲内かをチェックします。有料ツールを許可した場合に限り、Exa、Brave、Tavily、Serper などの有料ソースも加わります。ツールの判定を隠したブラインド評価(結果をまとめてシャッフルし、どのツールが取得したかを伏せる)では、有用な結果が上位5件に含まれる数は次のとおりです。
| ブラインドセット7(120件のクエリ) | 有用な結果(5件中) | 1,000件あたりの費用 |
|---|---|---|
| Frankensurf、有料を許可 | 4.67 | $9.38 |
| Exa のみ | 4.66 | $9.50 |
| Frankensurf、無料(ローカル検索エンジンあり) | 3.83 | $0 |
無料では、検索性能で Firecrawl を上回ります。35件のクエリで優れ、5件で劣りました。有料を許可すると、Exa と同等です。ローカル検索エンジン(Docker を使わない SearXNG の frankensurf install search)により、無料プランの性能が大幅に向上します。v0.41 では無料検索がさらに改善されました。新しいブラインドセットの120件のクエリで、v0.40 より優れていたのは41件、劣っていたのは12件でした(有用な結果は5件中3.42件対2.71件、benchmarks/2026-10-14-search-v041/)。詳細はbenchmarks/2026-10-13-search/をご覧ください。
ほかにできること
読み取り:品質評価、主要コンテンツ、読み取りの高速競争、PDF
- すべての読み取りには
receipt.qualityが含まれます。値はgood、partial、poorのいずれかで、paywall、menus、placeholderなどのフラグも付くため、エージェントはページを正しく取得できたかどうかを判断できます。 --schema product.json(MCP のschema)を指定すると、ページの JSON-LD、マイクロデータ、メタタグ、独自の JSON から JSON Schema を作成してextractedに格納し、必須フィールドが不足している間は、より強力なツールに処理を引き継ぎます(構造化フィールド)。--main(MCP のmain_content=True)を指定すると、メニュー、フッター、バナーを除いた記事本文のmain_textが追加されます(pip install "frankensurf[main]"を使うと最適です)。- 3 秒経ってもページを取得できない場合、無料のツールをさらに 2 つ並行して実行し、最初に取得できた完全なページを保持します(
--lightningを指定すると最初から競争させます)。 - URL が「見つかりません」と応答した場合、そのサイト独自の検索で調べます。その場合は
receipt.rescuedで確認できます。 - それでもアクセスできない場合は、お使いのマシン上の Chrome(専用プロファイルを使用し、ユーザー自身のプロファイルは使いません)を許可するか(
--real-browser)、2 つ目の接続を使用してください(FRANKENSURF_EGRESS)。
検索:検索分野、ブール検索クエリ、ローカルエンジン
- すべての検索ソースで
--site、--exclude-domain、--recency、--regionを指定でき、公式の無料 API を利用する検索分野(news、reference、discussions、qa、code、papers、books)は--verticalで指定できます。 - モニタリング形式のクエリ(
"Acme" OR "Acme Corp" (acquisition OR layoffs))は、対象となる企業名に基づいて評価されます。結果が不十分な場合は、企業名だけで 1 回再試行します。 --mode mergeを指定すると、すべての検索ソースに一度に問い合わせて、結果を統合します。frankensurf search-engine start|stop|statusでローカルの SearXNG を管理できます。再起動後は、検索時に自動で再起動されます。
エージェント:スキル、プロファイル、引き継ぎ、サイトモジュール
- 同梱のスキルは、エージェントにツールの使い方を教えます。MCP サーバーはこれを指示として送信し、
frankensurf skill installは~/.claude/skillsにインストールします。 - **プロファイル:**一度ログインすると、どのツールからもそのセッションを使えます。モデルに Cookie やキーが見えることはありません。
- **人間への引き継ぎ:**CAPTCHA や 2FA など、人間にしか解除できない場合は、ページを開いて対応を促し、その後処理を続行します。
- **サイトモジュール:**エージェントがサイトについて学んだ内容をデータとして保存します。
frankensurf module discover URL --query "desk lamp" --saveはサイトの検索機能を見つけ、結果を読み取ってモジュールを保存します。以降、そのサイトで検索すると、構造化されたitemsが返されます。 - サイトの知識を共有:
frankensurf share syncは、コミュニティが学習した、どのツールがどのサイトを読み取るかという情報から同期を始めます。share exportは、確認して提供できるよう、自分の情報を書き出します(どちらも任意です)。 frankensurf watch-sites URL… --since DATEは、サイトが公開しているフィードやサイトマップから新しいページを一覧表示します。
有料ツールと予算
キーがなくてもすべて利用できます。有料ツールはオプトイン方式で、サイトが無料ツールをブロックした場合にのみ、成功の可能性が高く、料金の安いものから順に使われます。キー(例:FIRECRAWL_API_KEY)を設定して --paid を渡すと、有料ツールを利用できます。読み取りの上限額は --max-cost USD で設定します。Python では allow_paid_fallbacks と max_cost_usd を使います。有料ツールと予算を参照してください。
ページを取得する方法はすべて、段階の一つです。通常の HTTP と Markdown ネゴシエーション、ブラウザー、ステルスブラウザーと署名付きリクエスト、ホスト型ブラウザー、有料 API、そして最後に、目に見えるブラウザーで壁を越える人まであります。読み取りは最も安価な段階から始まり、ページに拒まれた場合にのみ次の段階へ進みます。すべてのツールはプラグインなので、新しいツールを別の段階として追加できます。
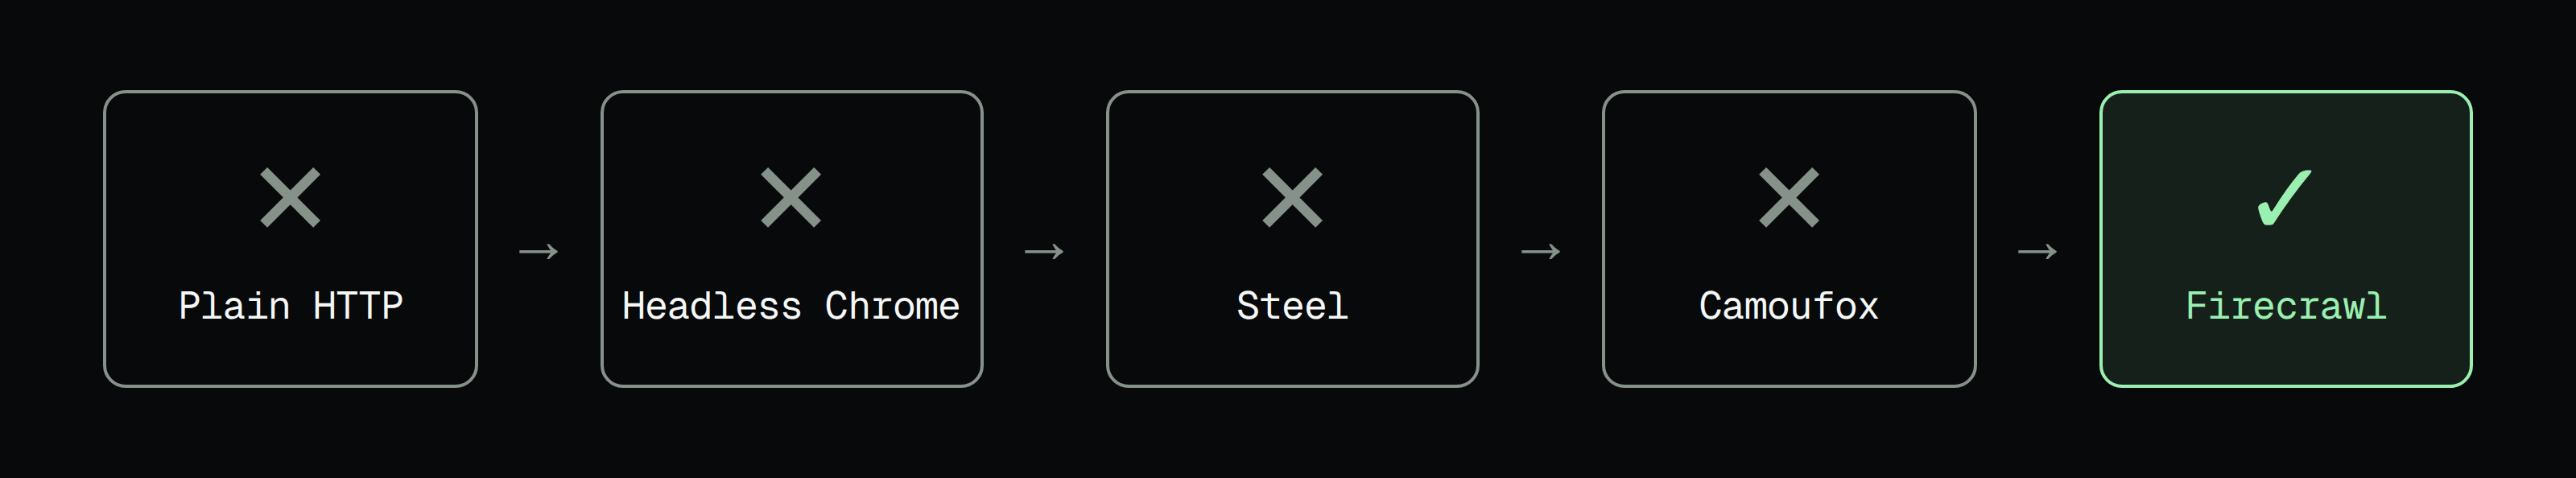
エスカレーションの仕組みと インテグレーションの全一覧をご覧ください。
既知の壁
まだアルファ版のため、今でもアクセスできないサイトがあります。
- 有料ツールが必要です: 無料ツールのみでスポットチェックしたところ、Etsy、Home Depot、Yelp、Crunchbase、G2 はすべての無料ツールをブロックしました。
- これまでのところ、すべてに対応できています: Shopee、Temu、Idealista。
- ログインなしで閲覧できるソーシャルサイト: LinkedIn、X、YouTube、Threads、Bluesky、Reddit は問題なく読み取れます。Instagram、TikTok、Facebook、Pinterest では公開ページの枠組みしか表示されず、投稿の閲覧にはログインが必要です。
- ログインが必要なページ(フィードや注文履歴など)には、 プロフィールが必要です。
- 時間がかかる場合もあります: ほとんどの読み取りは数秒で完了しますが、10 回に 1 回は複数のツールを試すことになり、25 秒以上かかります。
読み取れないサイトを見つけましたか? 報告してください。報告はすべてテストケースになります。
開発
python3 -m venv .venv
.venv/bin/pip install -e '.[test,mcp]'
.venv/bin/frankensurf install
PYTHONPATH=.:src .venv/bin/pytest -q
製品設計は SPEC.rst に、コントリビューターのルールは AGENTS.md に記載されています。新しいツールはプラグインとして追加し、Core に分岐を設けないでください。プラグインの作成と、examples/frankensurf-plugin-example の例をご覧ください。ウェブサイトとドキュメントは site/ にあります。
ライセンス
Apache-2.0 です。LICENSEをご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。