skeletongraph について
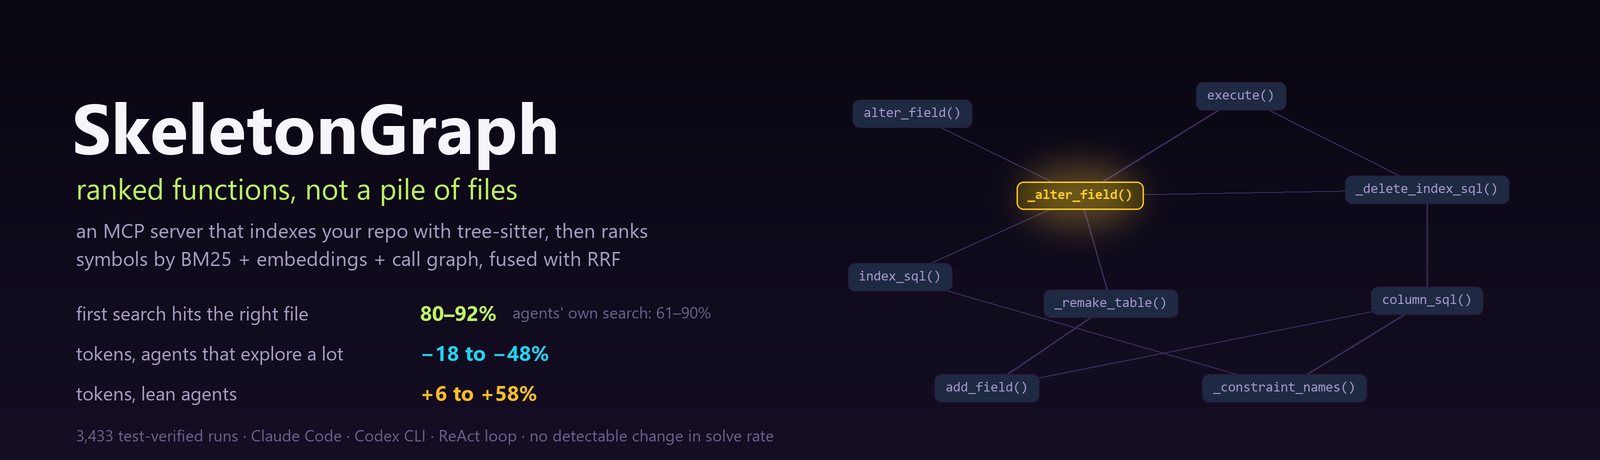
SkeletonGraphはtree-sitterでLLMを使わずにリポジトリを解析し、関連関数をランキングしてMCP経由でコーディングエージェントに提供します。エージェント対応IDE向けで、タスクのルーティングや準備を行うCLIも備えています。
主な機能
- 01tree-sitterによる関数単位のインデックス
- 02BM25・埋め込み・構造情報による順位付け
- 03呼び出しグラフによる候補拡張
- 04MCP検索サーバー
- 05CLIでのルーティングと実行
- 06インデックスの差分更新
活用シーン
- 01コーディングエージェント向けの関数検索
- 02コード変更後のインデックス更新
- 03タスク用コンテキストファイルの作成
- 04CLIからのコーディングタスク振り分け
MCP 対応
関連関数をファイル名と行番号とともに返すMCPコンテキストサーバーを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細



対応




解析対象


SkeletonGraph は tree-sitter でリポジトリをインデックス化します。LLM は使いません。そして MCP 経由で、コーディングエージェントにタスクに関連する関数をランキング順に提示します。 また、より優れたコード検索によって、コードを修正するエージェントが実際に何を得られるのかを、2 つの本番用エージェント、2 つの Claude の振る舞いの条件、2 つのベンチマークにわたって検証した研究のためのツールでもあります。簡潔な答えは以下のとおりです。トークン比率よりも実用的で、耳の痛い内容です。

tree-sitter で一度インデックスを作成し(LLM 不要)、3 つのシグナルで同じシンボルを順位付けし、逆順位融合で順位付けされた関数をファイル名と行番号とともに返し、MCP 経由でエージェントに提供します。
わかったこと
エージェントなし、オープンウェイトモデルを使った制御されたエージェントループ内、そして Claude Code(探索的設定と軽量設定)および Codex CLI 内で、同じリトリーバーを利用できるあらゆる設定で実行しました。SWE-bench Verified と、汚染を除去した SWE-rebench を対象に、3,433 回のエージェント実行を行い、プロジェクトのテストを実行してすべてのパッチを検証しました。さらに、エージェントを使わない検索評価を 500 件実施し、エージェントの比較はすべてタスクごとにペアにしました。評価対象は Python リポジトリです。
1. すべてのエージェント独自の検索よりも、コードを的確に見つけます
エージェントなしで、SWE-bench Verified の 100 タスクを対象にしたファイル単位の結果です。
| ランカー | MRR | recall@5 | recall@10 |
|---|---|---|---|
| grep | 0.159 | 0.236 | 0.348 |
| BM25 | 0.482 | 0.626 | 0.719 |
sg-rerank(BM25 + 構造) | 0.518 | 0.701 | 0.824 |
| BM25 + dense | 0.551 | 0.714 | 0.843 |
sg-fusion(BM25 + dense + 構造) | 0.658 | 0.785 | 0.856 |
すべてのタスクを対象にエージェント内で実行した場合、SkeletonGraph による最初の検索で、修正対象のファイルが見つかったタスクの割合は 80~92% でした。一方、エージェント独自の最初の検索では 61~90% でした(エージェントが実際に検索を呼び出したタスクに限ると、87~96% に対して 60~93%)。最も差が大きかったのは Codex で、呼び出されたタスクの 71% で正しいファイルが最初に見つかり、エージェント独自の検索では 32% でした。
2. しかしエージェントはすでに正しいコードを見つけていたため、その改善は修正に反映されません
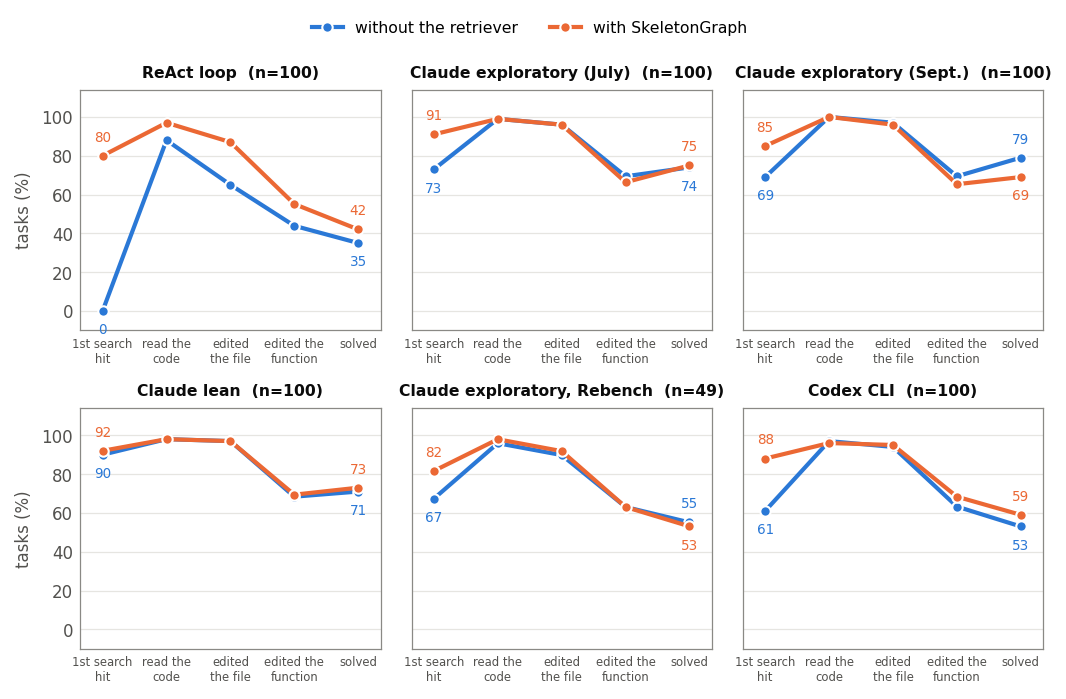
SkeletonGraph の有無にかかわらず、本番エージェントはタスクの 96~100% で正しいファイルのコードを読み取っており、SWE-bench Verified では通常、最初のツール呼び出しで実行していました。また、タスクの 88~97% でそのファイルを編集しました。関数単位では、完璧とは程遠いものの(修正対象の関数を編集した割合は 63~69%)、SkeletonGraph を使っても改善はありませんでした。2 つの実験群で結果が異なった 69 タスクのうち、61 タスクでは両方の実験群がすでに正しいファイルを編集していました。異なるのは変更を加えた場所ではなく、変更が正しかったかどうかです。本番エージェントの設定で、検索による解決率の統計的に有意な改善は確認されませんでした。自力でコードを見つけられないことが多いエージェント、つまり検索を使わない実験群がタスクの 65% で正しいファイルを編集した制御ループだけは改善しました(解決数は 35 → 42 でしたが、統計的に有意ではありません)。
3. 変わるのはコストです。そして方向を決めるのはエージェントです
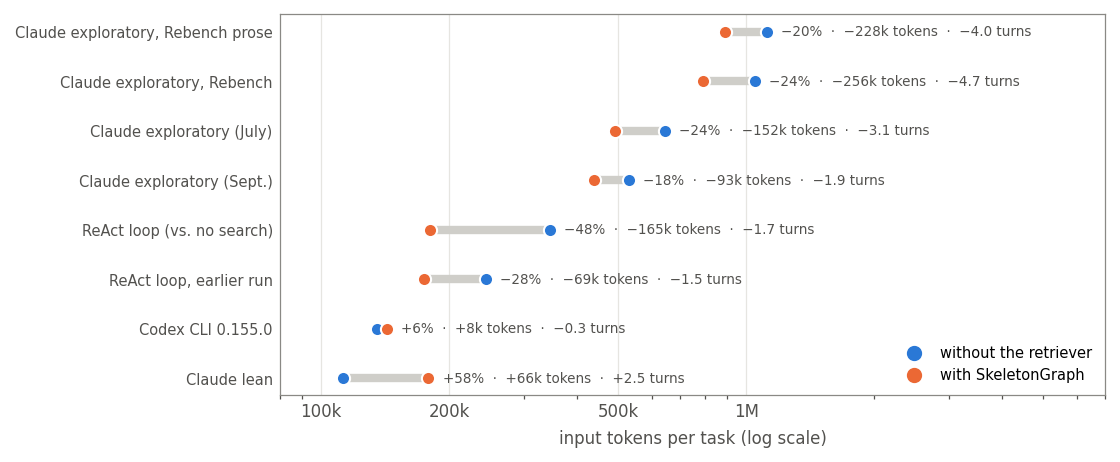
| 設定 | エージェント単体でのタスクあたりのトークン数 | SkeletonGraph 使用時 |
|---|---|---|
| Claude exploratory、SWE-rebench | 1,048,603 | −24%(−256k トークン、−4.7 ターン、−12¢) |
| Claude exploratory(July) | 644,504 | −24%(−152k トークン、−3.1 ターン、−6¢) |
| Claude exploratory(September) | 530,478 | −18%(−93k トークン、−1.9 ターン、−3¢) |
| ReAct loop(オープンウェイトモデル) | 344,642 | −48%(−165k トークン、−1.7 ターン、−1¢) |
| Codex CLI 0.155.0 | 134,955 | +6%(+8k トークン、−0.3 ターン、−0.4¢) |
| Claude lean | 112,813 | +58%(+66k トークン、+2.5 ターン、+2¢) |
エージェントが検索、読み込み、再確認に多くの時間を費やす場合、SkeletonGraph はその作業を置き換えてコストを削減します。一方、すでに1、2回の呼び出しでコードを見つけられる場合は、リトリーバーが追加されるため、コストが少し増えます。増加分は小さく、上限があります。削減効果は、エージェントが本来費やしていたコストに応じて大きくなります。
4. エージェントは使っている間にも変化します
3週間隔で開いた2つのClaude Codeウィンドウを比較すると、同じタスクとプロンプトで、exploratory(2.1.274)からlean(2.1.278)へと変わる間に、組み込みエージェントのタスクあたりのツール呼び出し回数は10.9回から4.7回になり、読み込む量は5分の1に減り、編集後にコードを実行したタスクは40件から2件になりました。また、最初の検索で正しいファイルを先頭に見つけたタスクは59件から85件に増えました。同じリトリーバーバックエンドでも、より軽量な統合では、タスクあたり93kトークンの削減から66kトークンの増加へと変わりました。製品リリース、利用可能なツール、アカウントに読み込まれたスキル、統合、そしておそらく提供されるモデルも同時に変わりました。この変化を2つの動作環境として説明することはできますが、バージョン番号だけに原因を帰することはできません。この変動性も結果の一部です。評価の有意な単位は、完全なバージョン管理されたエージェント環境です。
使用する場合に知っておくべきこと
- タスクの解決数ではなく、最初の検索の改善を期待してください。 現在の最先端エージェントのボトルネックは、見つけたコードを正しい修正につなげることです。リトリーバーはこの課題には対応しません。
- 削減効果はエージェント環境全体によって異なります。 大きな効果があるのは、よく探索するエージェントとタスクです。軽量なエージェントでは、小さなオーバーヘッドに変わることがあります。ご自身の環境で測定してください。
- 統合手順にもトークンが必要です。 Codex では、同梱の統合は通常版の8kトークンに対し、タスクあたり53kトークンを追加しましたが、解決率に検出可能な違いはありませんでした。
信頼区間と注意事項を含むすべての結果は
docs/RESULTS.md に、再現方法は
eval/README.md に記載されています。2026年7月のプレプリントで報告したのは、最初のClaude Codeリリース期間のみです。
SkeletonGraph には2つの製品インターフェースがあります。
- SG IDE:Cursor、Claude Code、Copilot、Codex、 Antigravity、Windsurf、その他のエージェント型 IDE 向けの MCP コンテキストサーバー。
- SG CLI:ルート設定、準備、ドライラン、プロバイダー実行、コストを考慮したモデル選択を行うターミナルパイプライン。
仕組み
SkeletonGraph はリポジトリを解析し、関数レベルの構造、ファイルをまたぐ呼び出しグラフ、PageRank の中心性を LLM 呼び出しなし で生成します。処理は決定論的で低コストであり、編集のたびにすぐ再構築できます。クエリ時には、課題で指定されたシンボルを解決し、呼び出しグラフを外側へたどって、BM25、コード埋め込み、構造的な確認という3つのシグナルで候補を順位付けし、相互順位融合で統合します。
prompt -> (optional) retrieval planner -> classify task -> find target nodes -> expand graph -> assemble packet
製品のデフォルトである sg-rerank は、軽量なインデックスを使用するため、密な検索部分を省略します。sg-fusion はそれを追加し、検索ベンチマーク(上の表)で最も高い順位を獲得しています。
インストール
pip install skeletongraph           # core: indexing, MCP server, CLI (no API key needed)
pip install "skeletongraph[llm]"    # + litellm for sg run --execute / sg summarize --tier cloud
pip install "skeletongraph[all]"    # everything, including the evaluation harness
クイックスタート:SG IDE
Cursor、Claude Code、Copilot、Codex、Antigravity、またはその他の MCP 対応コーディング環境をすでに利用している場合は、この方法を使ってください。
cd your-project
sg init
sg build
sg doctor
sg init は、選択した IDE 用の MCP 設定とエージェントの指示ファイルを書き込みます。SG IDE に API キーは必要ありません。推論と編集には引き続き IDE のサブスクリプション/モデルを使い、SkeletonGraph が検索を提供します。
対応している IDE のセットアップ先は次のとおりです。
| IDE | 統合方法 | モデルの切り替え |
|---|---|---|
| Cursor | MCP + ルール | IDE 内で手動 |
| Claude Code | MCP + CLAUDE.md | /model コマンド |
| GitHub Copilot | MCP + 指示 | IDE 内で手動 |
| Codex | MCP + AGENTS.md | エージェント内で手動 |
| Antigravity | MCP + ルール | IDE 内で手動 |
| Windsurf | MCP + ルール | IDE 内で手動 |
クイックスタート:SG CLI
ターミナルを中心としたコンテキストおよびモデルルーティングのパイプラインを使いたい場合は、この方法を使ってください。
cd your-project
sg build
sg route "fix the auth token validation bug"
sg prepare "fix the auth token validation bug" --out .skeletongraph/context.md
sg run "fix the auth token validation bug" --dry-run
sg route、sg prepare、sg run --dry-run に API キーは必要ありません。
プロバイダーを呼び出すには、次のようにします。
sg config --cli-provider anthropic
$env:ANTHROPIC_API_KEY = "..."
sg run "fix the auth token validation bug" --execute
有料プロバイダーのキーを使わず、ローカルでテストするには、次のようにします。
ollama pull qwen3-coder:latest
ollama serve
sg config --cli-provider local
sg run "fix the auth token validation bug" --dry-run
sg run "fix the auth token validation bug" --execute
ローカル実行は、低コストでパイプラインをテストすることを目的としています。ベンチマークがローカルモデルを対象としている場合を除き、品質ベンチマークにはプロバイダーモデルを使ってください。
モデルの依存関係、事前ウォームアップ、インデックスの最新状態の維持
SG は初回使用時に、どちらも sentence-transformers を介して、小型の埋め込みモデルを2つダウンロードします(必須の依存関係であり、オプションではありません)。
jinaai/jina-embeddings-v2-base-code(SG_DENSE_MODEL)—fusion/sg_searchの意味的な検索処理に使われます。sg warmの実行時、またはエージェントが初めて高密度検索クエリを実行したときに読み込まれます。trust_remote_code=Trueで読み込まれます(Jina は HF Hub で独自のモデリングコードを配布しています)。これは、他のtrust_remote_codeモデルと同様に、そのモデルリポジトリのコードを実行します。all-MiniLM-L6-v2(SG_EMBED_MODEL)— インデックス作成時の信頼度スコアの同点判定にのみ使われる、別の小型モデルです。sg warmではなく、初回のsg build時に自動的にダウンロードされます。
どちらのモデルも、マシンで初めて使う際にはインターネット接続が必要です。それ以降はローカルにキャッシュされるため(Hugging Face のモデルキャッシュに加え、SG 独自のコンテンツハッシュキャッシュである、密な検索処理用の .skeletongraph/dense_cache と、信頼度の同点判定用の .skeletongraph/embeddings.npz)、以降のビルドは増分処理になります。実際にテキストが変更された関数だけが再度埋め込まれます。
エージェントを起動する前に事前ウォームアップして、エージェントが初めて実際に検索する際ではなく、セットアップ中にコストがかかるようにしてください。
sg build                 # parse + structural index (no LLM, fast)
sg warm --path .          # prebuild BM25 + dense caches (one-time; minutes on CPU)
sg warm --path . --mode rerank   # skip the dense leg entirely (no embedding cost)
これを行わない場合、エージェントが最初に実行する sg_search 呼び出しで、エンコードの初回実行コストがその場で発生します。大規模なリポジトリでは、高密度検索処理の内部タイムアウト(デフォルトでは 20 秒の SG_DENSE_TIMEOUT_S)を超えることがあります。その場合、完全に失敗するのではなく、結果は警告なしに2つのシグナル(語彙的+構造的)に劣化します。事前ウォームアップを行えば、このフォールバックに頼らずに済みます。
ファイルの変更に合わせてインデックスを最新に保つ方法は2つあります。作業スタイルに合わせて選んでください。
sg update --path .        # one-shot: re-index only files that changed since last build
sg watch --path .         # background daemon: auto-reindexes on save (needs `pip install "skeletongraph[daemon]"`)
sg watch は、開発中に手間をかけずに使える方法です。短時間に連続する保存をデバウンスし、sg update と同じ増分更新処理を呼び出すため、手動で再ビルドしなくても、ファイルの編集がインデックスに反映されます。
モデルルーティング
SkeletonGraph は、IDE 向けのモデルラベルと CLI のプロバイダーモデル名を分けています。
IDE では、モデルのティアは推奨です。
| ティア | 典型的な用途 |
|---|---|
| SLM | ドキュメント、説明、簡単な検索 |
| MLM | 通常のコーディング、デバッグ、テスト、レビュー |
| LLM | アーキテクチャ、大規模な移行、信頼度の低いタスク |
CLI の実行では、SkeletonGraph はプロバイダーのモデル名にルーティングできます。
sg config --cli-provider anthropic
sg config --cli-provider openai
sg config --cli-provider google
sg config --cli-provider local
動的ルーティングでは、タスクモード、信頼度、候補数、トークンサイズ、複雑さを使用します。コードを変更する作業では、デフォルトで MLM を下限として維持し、性能の低いモデルに安全でないコード編集をさせることでコストを削減することはありません。検索計画では、強力なモデルの実行前に、小型モデルを使って AST/要約に基づく対象候補を提案できます。
IDE 連携
sg init と sg build の実行後、SG を MCP サーバーとして登録し、IDE フックを設定します。
sg install --ide claude-code   # Claude Code: hooks + MCP server + CLAUDE.md rules
sg install --ide cursor        # Cursor: MCP + .cursor/rules/skeletongraph.mdc + hooks
sg install --ide cline         # Cline: MCP config + rules block
sg install --ide roo           # Roo: MCP config + rules block
sg install --ide copilot       # GitHub Copilot: MCP + copilot-instructions.md
sg install --ide windsurf      # Windsurf: MCP + .windsurfrules
sg install --ide zed           # Zed: MCP config + rules block
sg install --ide continue      # Continue: MCP config + rules block
sg install                     # auto-detect all installed IDEs
codex と antigravity はエイリアスとして受け付けられ、現在は Copilot 形式の MCP インストーラー経由で処理されます。
その他の MCP 対応クライアントを使用する場合、または手動で設定する場合は、生のサーバー設定(sg serve --path /path/to/your/project)について
mcp.example.json を参照してください。上記で測定した「plain」連携は、ツールの説明と結果からガイダンステキストを削除する SG_MCP_PLAIN=1 を設定してサーバーを起動し、ルールとフックを設定する sg install を実行せずに登録したものです。
インストール後、エディターを再起動してください。SkeletonGraph はバックグラウンド MCP サーバー(sg serve --path .)として実行され、IDE が自動的に接続します。
MCP ツール
エージェントには 7 つのツールが公開されます。
| ツール | 呼び出すタイミング | 戻り値 |
|---|---|---|
sg_overview | セッション開始時 — セッションごとに 1 回 | 制約 + PageRank 順の上位 N 件の関数 + 最近のターン + インデックス統計 |
sg_search "query" | 主要な検索 | 本文の抜粋 + 概要 + 1 ホップ先の呼び出し元を含む上位 3 件の一致結果、シグネチャ + 概要を含む上位 4 件目以降の一致結果 |
sg_get "fqn" | 正確な FQN がわかっている場合 | シグネチャ + 概要 + 1 ホップ先の呼び出し元 + 呼び出し先 |
sg_expand "target" | sg_search の結果よりも多くの本文が必要な場合 | 関数全体の本文 / ファイル / 行範囲(トークン数の上限あり) |
sg_constraint list / propose | 変更を提案する前 | 確認済み + 提案されたプロジェクトルール |
sg_log | 最近のセッションターンを確認する場合 | 変更されたファイルを含む直近 N 件のターンの概要 |
sg_decision | 設計や実装の選択を行ったとき(採用または却下とその理由) | コンテキストの圧縮後も保持されるように記録されます — 後で sg_log(kind="decision") で呼び出せます |
スマートなコンテキストルーティング。 各 UserPromptSubmit で、SG はプロンプトを分類し(architecture / explain / decision / debug / test / review / general)、.skeletongraph/ 内の該当する MD ファイルを含めます。たとえば、設計やリファクタリングに関する問い合わせでは architecture.md のみを、コードベースについての問い合わせでは project.md のみを含めます。制約 + セッションダイジェスト + 関連する関数は常に挿入されます。
コールドスタート。 MCP ツールの呼び出し時に .skeletongraph/ インデックスが存在しない場合、SG は最初の呼び出し時に自動でビルドします(設定の auto_build_on_query を参照)。
CLI リファレンス
インデックス作成とステータス
| コマンド | 目的 |
|---|---|
sg init [--agent cursor] | プロジェクト、IDE プリセット、MCP、制約を設定します |
sg index | インデックスを全件作成します(sg build のエイリアス) |
sg index --incremental | 変更されたファイルのみを再インデックスします |
sg build | 詳細な出力付きでインデックスを全件作成します |
sg update | インデックスを差分更新します |
sg status | インデックスのステータスを表示します |
sg doctor | インデックス、ルーティング、プロバイダー、Ollama の準備状況を確認します |
sg overview | プロジェクトの概要:主要な関数、制約、セッション |
sg install [--ide <name>] | IDE フックと MCP 設定を書き込みます |
検索
| コマンド | 目的 |
|---|---|
sg search "query" | BM25 とグラフによる検索(API キー不要) |
sg get "fqn" | 関数のシグネチャ、概要、呼び出し元を取得します |
sg expand "target" | 関数本体/ファイル/行範囲を展開します |
制約とセッション
| コマンド | 目的 |
|---|---|
sg constraint list | すべての制約を一覧表示します |
sg constraint propose "text" | 提案を追加します |
sg constraint confirm <id> | 提案を decisions.md に反映します |
sg constraint remove <id> | 制約を削除します |
sg constraint aggregate | IDE ルールファイルからインポートします |
sg log [--last-n 10] | 最近のセッションのやり取りを表示します |
要約
| コマンド | 目的 | API キー |
|---|---|---|
sg summarize --tier local | Ollama Tier-0.5(無料、デバイス上で実行) | 不要 |
sg summarize --tier cloud | クラウド LLM Tier-1 | プロバイダーのキー |
sg summarize --tier cloud --force | すべての関数を再要約します | プロバイダーのキー |
モデルのルーティングと実行
| コマンド | 目的 | API キー |
|---|---|---|
sg route "task" | タスクモード、ティア、推奨モデルを表示します | 不要 |
sg run "task" --dry-run | ルーティングされた実行を計画します | 不要 |
sg run "task" --execute | 設定済みのプロバイダーを呼び出します | プロバイダーまたはローカル |
sg config [--agent cursor] | IDE と CLI のモデルを設定します | 不要 |
sg config --cli-provider anthropic | CLI の実行プロバイダーを設定します | 不要 |
バックグラウンドでのインデックス作成
| コマンド | 目的 |
|---|---|
sg watch | デーモン:保存時にファイルを自動で再インデックスします |
sg run --execute のプロバイダー出力は .skeletongraph/runs/ に書き込まれます。
Python API
from skeletongraph.engine import SGEngine

engine = SGEngine(project_root=".")
result = engine.query("fix the content-length bug", delivery="cli")

print(result.context_text)
print(result.query_mode)
print(result.model_tier)
print(result.recommended_model)
print(result.routing_reason)
リポジトリの構成
src/skeletongraph/      the package
  parser/                 AST extraction (tree-sitter)
  graph/                  dependency graph and ranking
  storage/                .skeletongraph persistence
  retrieval/              classification, resolution, model routing
  assembly/               context packet construction
  session/                memory and dedup
  server/                 MCP server
  install/                per-IDE hook + MCP config writers (`sg install`)
  hooks/                  IDE hook handlers
  llm/                    LiteLLM wrapper for optional CLI execution
  cli/                    Click commands
  engine.py               unified query pipeline
tests/                  unit tests (pytest)
eval/                   the evaluation harness — see eval/README.md
  datasets/               the frozen task sets
docs/
  RESULTS.md              every result, with confidence intervals and caveats
  assets/                 README images and the script that draws the banner and hero
結果の再現
タスクセット、すべてのエージェント用ドライバー、検証、すべての数値と図表を生成するスクリプトなど、すべてが eval/ にあります。各実行の記録とトランスクリプトは数ギガバイトに及ぶため、git ではなくタグ付きリリースで公開されています。計算済みの結果は eval/results_summary.json にあるので、これらのデータがなくても図表を再生成できます。
pip install -e ".[all]"
python -m eval.scripts.make_submission_figures
ライセンス
SkeletonGraph は MIT License のもとで公開されています。商用プロジェクトでも個人プロジェクトでも、自由に使用、変更、配布できます。
引用
SkeletonGraph が研究に役立った場合は、プレプリントを引用してください。
@misc{doke2026skeletongraph,
  title  = {SkeletonGraph: A Zero-LLM Structural Retrieval Engine for Coding Agents,
            and Why Its Gains Land in the Cost Tail, Not the Median},
  author = {Doke, Yash},
  year   = {2026},
  note   = {Preprint, Research Square},
  doi    = {10.21203/rs.3.rs-10749266/v1},
  url    = {https://doi.org/10.21203/rs.3.rs-10749266/v1}
}
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。