Omneum について
Omneum は、AI エージェントのパイプライン向けオープンソースのコンテキスト評価ツールで、Python SDK または MCP サーバーとして利用できます。出典情報と依存関係から主張の裏付けと出典の信頼性を評価し、生テキストの解釈や追加のモデル呼び出しを行いません。
主な機能
- 01主張の裏付けと出典の信頼性を評価
- 02出典間の依存関係を考慮
- 03出典と系譜のメタデータを利用
- 04トークン予算内でコンテキストを選択
- 05SQLite に永続化してローカル実行
- 06PostgreSQL への任意デプロイ
活用シーン
- 01検索後の証拠品質の評価
- 02共通出典による証拠の重複を削減
- 03予算内でコンテキストチャンクを選択
- 04弱い証拠を追加検証に回す
MCP 対応
Omneum は MCP サーバーとして動作し、MCP クライアントをインストール済みのローカル評価サービスに接続します。ツールを通じて、マッピング済みの観測データの評価とコンテキストチャンクの選択を行えます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Omneum とは
AI エージェント向けのオープンソースのコンテキスト評価ツールです。



エージェントは、RAG パイプライン、ウェブ検索、API、データベース、ファイル、メモリシステム、他のエージェントなど、多様なソースから日常的にコンテキストを組み立てています。しかし、何十もの生データの断片を単一のコンテキストウィンドウに詰め込むと、モデルは整理されていない情報の山を扱うことになりかねません。
ほとんどのエージェントは、より多くのコンテキストを取得することに重点を置いています。Omneum は、モデルに届くコンテキストが整理され、信頼できるものになるようにすることに重点を置いています。
⚡ AI エージェント向けの高速なコンテキスト監査。
評価レイテンシの中央値は 33 ms: Apple M5 で、250 件の観測、3 つの独立したソース、84 件の主張を対象に測定しました。追加の LLM 推論やモデル判定のステップはありません。
依存関係を考慮: 複数の取得済みコンテキスト断片が、同じ上流ソースの情報を繰り返している場合に検出します。
デフォルトでローカル: 環境内で完全に実行される、内容を参照しないグラフアルゴリズムです。SQLite による永続化と、オプションの PostgreSQL デプロイに対応しています。
クイックスタート
Python パッケージをインストールします。
pip install omneum
付属のデモを実行します。
python -m omneum.demo
evaluate.py を作成し、単一の主張に対する 3 件の観測を評価します。2 つのソースは、同じ上流ドキュメントを参照しています。
import omneum
from omneum.explanations import explain_evaluation

observations = [
    {
        "url": "https://a.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": ["https://sec.example"],
    },
    {
        "url": "https://b.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": ["https://sec.example"],
    },
    {
        "url": "https://c.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": [],
    },
]

result = omneum.evaluate(observations)
print(explain_evaluation(result))
実行します。
python evaluate.py
出力:
Omneum Evaluation
Evaluation latency: 1.6 ms

Fy2025 gross revenue

  4200000000
  Support: 0.67
  Supporting sources: 3
  Estimated independent support: 2.00
  Dependency signal coverage: 1.00

  Explanation:
    3 sources support this claim, with an estimated 2.00 independent sources. The available dependency signals indicate that some supporting sources are related.
evaluate() は Omneum のグラフベースの評価アルゴリズムをプロセス内で実行し、ソースの信頼性と主張の裏付けスコアを計算するとともに、ソース間の依存関係を考慮して調整します。
生の取得テキストを扱う場合は、オプションの extract_observations() API を使って、評価の前に LLM で構造化された主張を抽出します。Python SDK を参照してください。
Omneum を選ぶ理由と仕組み
最新のエージェントパイプラインでは、モデルに渡すコンテキストを決定するために、さまざまな手法が使われています。
意味的類似性(ベクトルデータベース)。 プロンプトに最も近いように見えるテキストが選ばれます。
意味的再ランキング。 取得したコンテキストを、クエリとの関連性に基づいて並べ替えます。
LLM-as-a-Judge。 LLM が取得したコンテキストを読み、一連の指示に照らして評価するよう指示されます。
これらの手法はコンテキストの選択に非常に効果的ですが、関連性はコンテキストの品質を測る一つの側面にすぎません。
チャンクには、矛盾した情報や古い情報が含まれていることがあります。複数の取得済みチャンクが重複排除されていなかったり、同じ上流ソースを共有しているにもかかわらず、互いに独立しているように見えたりする場合もあります。これがコンテキストの肥大化につながります。品質の低い情報がコンテキストウィンドウの容量を消費し、本来ならより質の高い情報に使えたはずの領域が失われます。
Omneum は、主張とその根拠となるソースとの関係をモデル化する、グラフベースの数学的分析を用いて、こうした制約の多くに対処します。重要なのは、すべてのソースがそれぞれ独立して情報を得たと単純に仮定しない点です。同じ情報が複数のソースに広がっていることはよくあります。依存関係を追跡しなければ、エージェントは独立した5件の観察と、同じ情報を5回繰り返したものとを区別できません。
エージェントパイプラインでは、取得したコンテキストとともに、構造化されたメタデータもすでに扱われています。Omneum は利用可能な来歴とリネージのメタデータを使ってソース間の依存関係を推定し、その推定値をソースの信頼性と主張の裏付けスコアの計算に反映します。
これらのスコアは、コンテキストの意味内容を解釈せずに計算されます。たとえば、次のような主張を評価する場合:
「Acme は2025年に42億ドルの収益を報告しました。」
その裏付けスコアは、それを裏付けるソースの信頼性によって決まります。そして、そのソースの信頼性は、それらが裏付ける主張から得られます。
この定義は循環しているように見えますし、実際に循環しています。それでも、信頼性を明確に定義できるため、強く裏付けられたコンテキストと、裏付けの弱いコンテキストを区別するのに役立ちます。
Omneum の本番用推論アルゴリズムは、これらの信頼性スコアと裏付けスコアを計算します。実験と研究を見る →
Omneum の位置づけ
Omneum は Python SDK を通じてローカルで実行するか、Model Context Protocol (MCP) サーバーとして実行できます。既存の検索またはランキングスタックに、軽量な検索後評価レイヤーを追加します。推論リクエストも、追加のモデル呼び出しも必要ありません。
検索/ツール → 再ランキング(任意) → Omneum による評価 → エージェントの制御フロー → LLM
Omneum はコンテキスト品質のシグナルを返し、エージェントはワークフロー全体を通して、エビデンスを考慮した判断を行います。
MCP のインストール
注: このチュートリアルでは Python 3.11–3.14 を前提としています。その他の言語向けの SDK は現在サポートされていません。
サポート対象プラットフォーム:
| プラットフォーム | 対応 |
|---|---|
| macOS(Apple Silicon / arm64) | ✅ |
| macOS(Intel / x86_64) | ✅ |
| Linux(Ubuntu 22.04+ / x86_64) | ✅ |
1. ローカル評価器をインストールする
インストーラーを実行して、ローカル評価器を設定します。
omneum install
通常のログインアカウントから omneum install を実行してください。コマンドを sudo で実行しないでください。
インストーラーは、評価器のリリースをダウンロードして検証する間、非特権で動作します。デーモンのバージョンは、インストール済みの Python パッケージのバージョンに固定されます。たとえば、Omneum 1.0.3 は v1.0.3 のデーモンアセットのみを受け付けます。latest を解決したり、別のリリースにフォールバックしたりすることはありません。
アーカイブは、インストール前にリリースの SHA256SUMS と照合して検証されます。チェックサムがない場合、ダイジェストが一致しない場合、想定外のアーカイブエントリ、リンク、またはパストラバーサルが含まれる場合、アーカイブ内のものを実行する前にインストールを中止します。
管理者アクセスが要求されるのは、マシンレベルのサービスファイルをインストールするときだけです。Ubuntu では、次の場所にある管理対象ランタイムが含まれます。
/opt/omneum
また、次の場所にあるパブリッククライアント設定も含まれます。
/etc/omneum/config.toml
評価器はシステムサービスとして動作します。これは、VOPRF 秘密鍵をログインアカウントおよび MCP プロセスから隔離するためです。macOS では launchd で、Ubuntu では別のサービス ID を使用して systemd で動作します。
omneum-server は、MCP クライアントをインストール済みのローカルサービスに接続します。インストーラーは最後に、この経路を通じて VOPRF リクエストを送信し、設定済みの公開鍵に照らして応答を検証します。サービスが起動しているだけでは、インストールが成功したことにはなりません。
サービスアカウント、ソケット、インストール先のパス、カスタムエンドポイント、障害処理については、docs/guides/installation.md を参照してください。
2. MCP クライアントを接続する
MCP クライアントの設定に Omneum を追加します。
{
  "mcpServers": {
    "omneum": {
      "command": "omneum-server"
    }
  }
}
MCP クライアントを再起動して、エージェントで Omneum のツールを使えるようにします。
MCP クライアントが omneum-server を見つけられない場合は、command に command -v omneum-server が返す絶対パスを設定してください。
3. 接続を確認する
エージェントに Omneum の ping ツールを呼び出すよう依頼してください。成功すると "status": "ok" が返され、エージェントが Omneum MCP サーバーに接続できることを確認できます。
評価の実行
Omneum の Python SDK とローカル MCP サーバーを使用して、取得したコンテキストを評価します。
1. 取得したコンテキストをマッピングする
ContextMapper を使用して、取得したレコードを Omneum の観測値にマッピングします。この例では 3 つのソースを使用し、そのうち 2 つは同じ上流のドキュメントを参照しています。
import asyncio
from datetime import datetime, timezone

from omneum.mcp import StdioServerParameters
from omneum import (
    ContextMapper,
    OmneumClientConfig,
    Source,
    open_stdio_client,
)

now = datetime.now(timezone.utc)

records = [
    {
        "id": "obs-1",
        "raw_text": "Acme reported FY2025 gross revenue of $4.2 billion.",
        "url": "https://example.com/report-a",
        "value": 4_200_000_000,
        "upstream": ["https://example.com/filing"],
        "observed_at": now,
    },
    {
        "id": "obs-2",
        "raw_text": "FY2025 gross revenue for Acme was $4.2 billion, per the filing.",
        "url": "https://example.org/report-b",
        "value": 4_200_000_000,
        "upstream": ["https://example.com/filing"],
        "observed_at": now,
    },
    {
        "id": "obs-3",
        "raw_text": "Acme's FY2025 gross revenue totaled $4.2 billion.",
        "url": "https://example.net/report-c",
        "value": 4_200_000_000,
        "upstream": [],
        "observed_at": now,
    },
]

mapper = ContextMapper(
    source=lambda r: Source(kind="web_document", identifier=r["url"]),
    entity_namespace=lambda r: "company",
    entity=lambda r: "acme",
    attribute=lambda r: "fy2025_gross_revenue",
    value="value",
    observation_id="id",
    observed_at="observed_at",
    upstream_sources=lambda r: [
        {"kind": "web_document", "identifier": url}
        for url in r["upstream"]
    ],
)
正規化は SDK が処理します。正規化を参照してください。
2. コンテキストを評価する
omneum-server に接続し、evaluate_mapped() を呼び出します。
async def main():
    config = OmneumClientConfig.from_local_deployment()
    server = StdioServerParameters(command="omneum-server")

    async with open_stdio_client(config, server=server) as client:
        evaluation = await client.evaluate_mapped(
            records,
            mapper,
        )
        print(evaluation.explanation)


asyncio.run(main())
両方の Python コードブロックを evaluate_mcp.py に保存してから、次を実行します。
python evaluate_mcp.py
評価と、ローカルに保持されているチャンクの選択を 1 回の操作で行うには、
evaluate_mapped() の呼び出しを次のように置き換えます。
from omneum import DependencyEstimatorConfig
from omneum.context_selection import claim_id

observations = mapper.map_many(records)
chunks = [
    {"chunk_id": record["id"], "raw_text": record["raw_text"],
     "claim_ids": [claim_id(observation.claim)]}
    for record, observation in zip(records, observations)
]
estimator = DependencyEstimatorConfig(
    upstream_weight=1.0, citation_weight=0.0, assertion_lineage_weight=0.0,
    ownership_weight=0.0, temporal_weight=0.0, graph_weight=0.0,
    temporal_window_seconds=7200.0,
)
result = await client.evaluate_context_with_chunks(
    observations, chunks, estimator=estimator, token_budget=200,
    strategy="coverage_support",
)
evaluation = result["evaluation"]
selected_chunks = result["chunks"]
context = result["context"]
evaluation には、ソースの信頼性、主張の裏付け、評価テレメトリが保持されます。
chunks には、選択された {chunk_id, score, raw_text} レコードのみが効用の高い順に含まれます。context も同じ順序でレンダリングされます。生テキストはクライアントのメモリ内にとどまり、MCP リクエストには含まれません。利用するエージェントが独自にモデルリクエストを組み立てます。
デフォルトの予算では、チャンクヘッダーを含め、Unicode の単語と句読点を数えます。モデル固有の計算を行うには、count_tokens=your_token_counter を渡してください。戦略は retrieval、max_support、mean_support、coverage_support です。カバレッジ選択では、最終的なチャンク効用とは別に限界利得が記録されます。
3. 評価結果
evaluation.explanation は、確認用に評価結果をフォーマットします。
Omneum Evaluation
Evaluation latency: 10.6 ms

Fy2025 gross revenue

  4200000000
  Support: 0.67
  Supporting sources: 3
  Estimated independent support: 2.00
  Dependency signal coverage: 1.00

  Explanation:
    3 sources support this claim, with an estimated 2.00 independent sources. The available dependency signals indicate that some supporting sources are related.
3 つのソースが同じ値を報告していますが、そのうち 2 つは共通の上流ドキュメントを参照しています。Omneum はこの依存関係を特定し、3 つすべてを独立した証拠として扱うのではなく、独立した支持ソースの数を 2.00 と推定します。
エージェントはこの結果を使用して、追加の情報取得を開始したり、応答を生成する前に実行を検証ステップに戻したりできます。
結果のフィールドについては、評価スキーマを参照してください。
統合
Python SDK と ContextMapper を使用して、Omneum をエージェントに追加します。
フレームワークの例:
フレームワークに依存しないワークフローの全体例については、 エンタープライズポリシーの例を参照してください。
オプション:Omneum Network への貢献(クローズドベータ)
Omneum はデフォルトでローカルに動作します。生のコンテキストをアップロードすることなく、共有 Omneum Context Graph に観測データを提供することを選択できます。
ネットワークへの貢献は、エージェントの各デプロイメントにまたがる共有の証拠ベースの構築に役立ち、単一のインストールにとどまらない Context Graph の拡張につながります。
貢献では、RFC 9497 VOPRF を介したプライバシー保護型の暗号リンクを使用します。ネットワークへの貢献はデフォルトで無効です。ローカル評価には不要です。
ホスト型 Network への登録は現在、承認済みのベータ参加者に限定されています。
開始するにはネットワークへの貢献を有効にする(MCP)を、技術的な詳細についてはネットワークへの貢献の仕組みを参照してください。
データモデルと評価
観測データ
コンテキストは単なるテキストチャンクの集まりではありません。Omneum は、エージェントが遭遇した情報を観測データとして表現します。観測データは、構造化データとその来歴を保持する不変のレコードです。最初にサポートされる型である主張観測データは、主張、そのソース、および評価に必要なメタデータを記録します。
Observation(
    observation_id="obs-1",
    source=source,
    claim=claim,
    observed_at=datetime.now(timezone.utc),
)
観測データは、ソースの所有者、タイムスタンプ、引用、上流ソースとの関係、主張の系譜など、利用可能な来歴とメタデータを保持します。複数の主張観測データが同じ主張を裏付けたり、値の不一致を報告したりしても、統合または上書きされることはありません。観測データは、何が真実かについて生成された判断ではなく、報告された証拠を保持します。
ソース
ソースは、主張の発生元を示します。各ソースには、複数の観測データにわたって同じソースを識別するための kind と正規化された identifier があります。ソースは、ウェブドキュメント、データベース、内部サービス、その他の情報プロバイダーを表すことができます。
Source(
    kind="web_document",
    identifier="https://example.com/acme-filing",
)
クレーム
クレームは、取得したコンテキスト(テキストチャンクやツールの出力など)から抽出された具体的な主張を表します。各クレームは、entity_namespace、entity、attribute、value で構成されます。統合エージェントまたは検索パイプラインがこれらのフィールドを抽出し、ContextMapper が Omneum のデータモデルにマッピングします。
Claim(
    entity_namespace="company",
    entity="acme",
    attribute="fy2025_gross_revenue",
    value=4_200_000_000,
)
ソースの依存関係
複数のソースが同じクレームを報告しても、それぞれが独立した裏付けを提供しているとは限りません。Omneum は、上流の系譜、引用、主張の系譜、所有者の共有、タイムスタンプ、グラフ構造に基づいて、ソースの依存関係を推定します。
推定されたソースの依存関係は、各クレームに対する独立した裏付けを算出する際に、関連するソースの寄与度を調整します。
ContextMapper
ContextMapper は、エージェントおよび検索パイプラインの構造化データを Omneum の観測モデルにマッピングします。既存のレコードから、ソース識別子、クレームフィールド、タイムスタンプ、出所メタデータを読み取る方法を定義します。
ContextEvaluation
ContextEvaluation は、ソースの依存関係を考慮して調整したソースの信頼性スコアとクレームの裏付けスコアを、競合情報および出所情報とともに返します。
evaluation = await client.evaluate_mapped(
    records,
    mapper,
)
print(evaluation.explanation)
パフォーマンスと精度
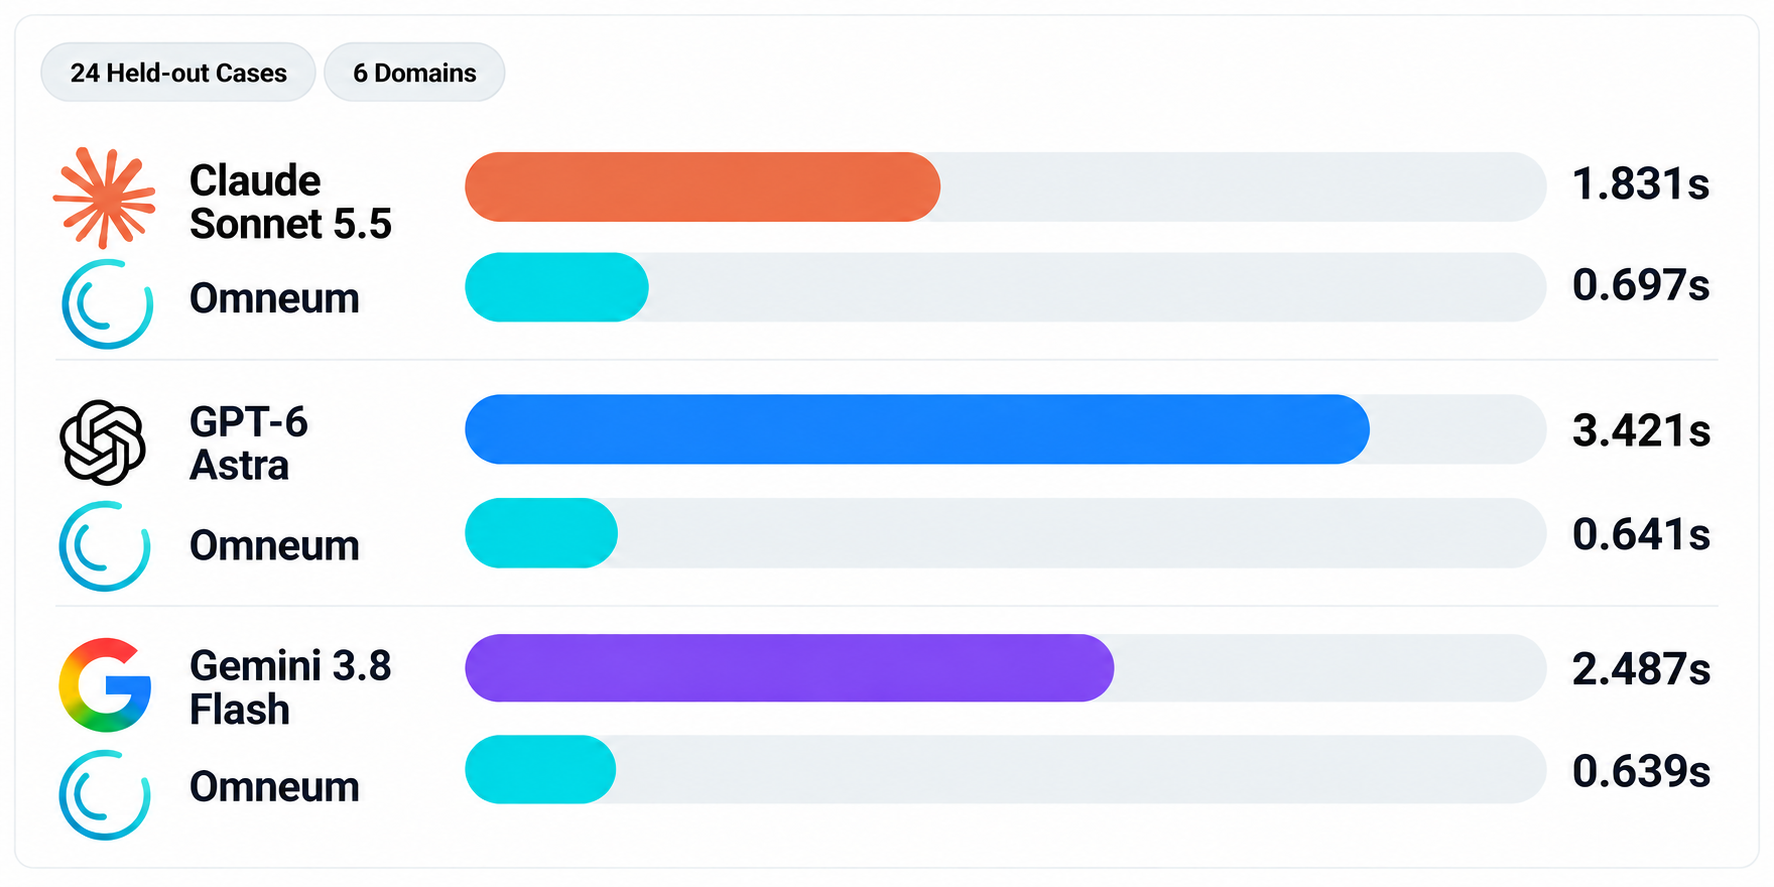
コーディングエージェント、エンタープライズ RAG、調査・分析エージェント、マルチエージェントシステム、データ分析エージェント、サポート・運用エージェントの6つの領域にわたる、24件のホールドアウトケースで評価しました。
セマンティックリランカー
多様なエージェントのワークフローにおいて、セマンティックリランカーと組み合わせた場合に、Omneum がエビデンスの選択をどの程度改善するかを測定します。
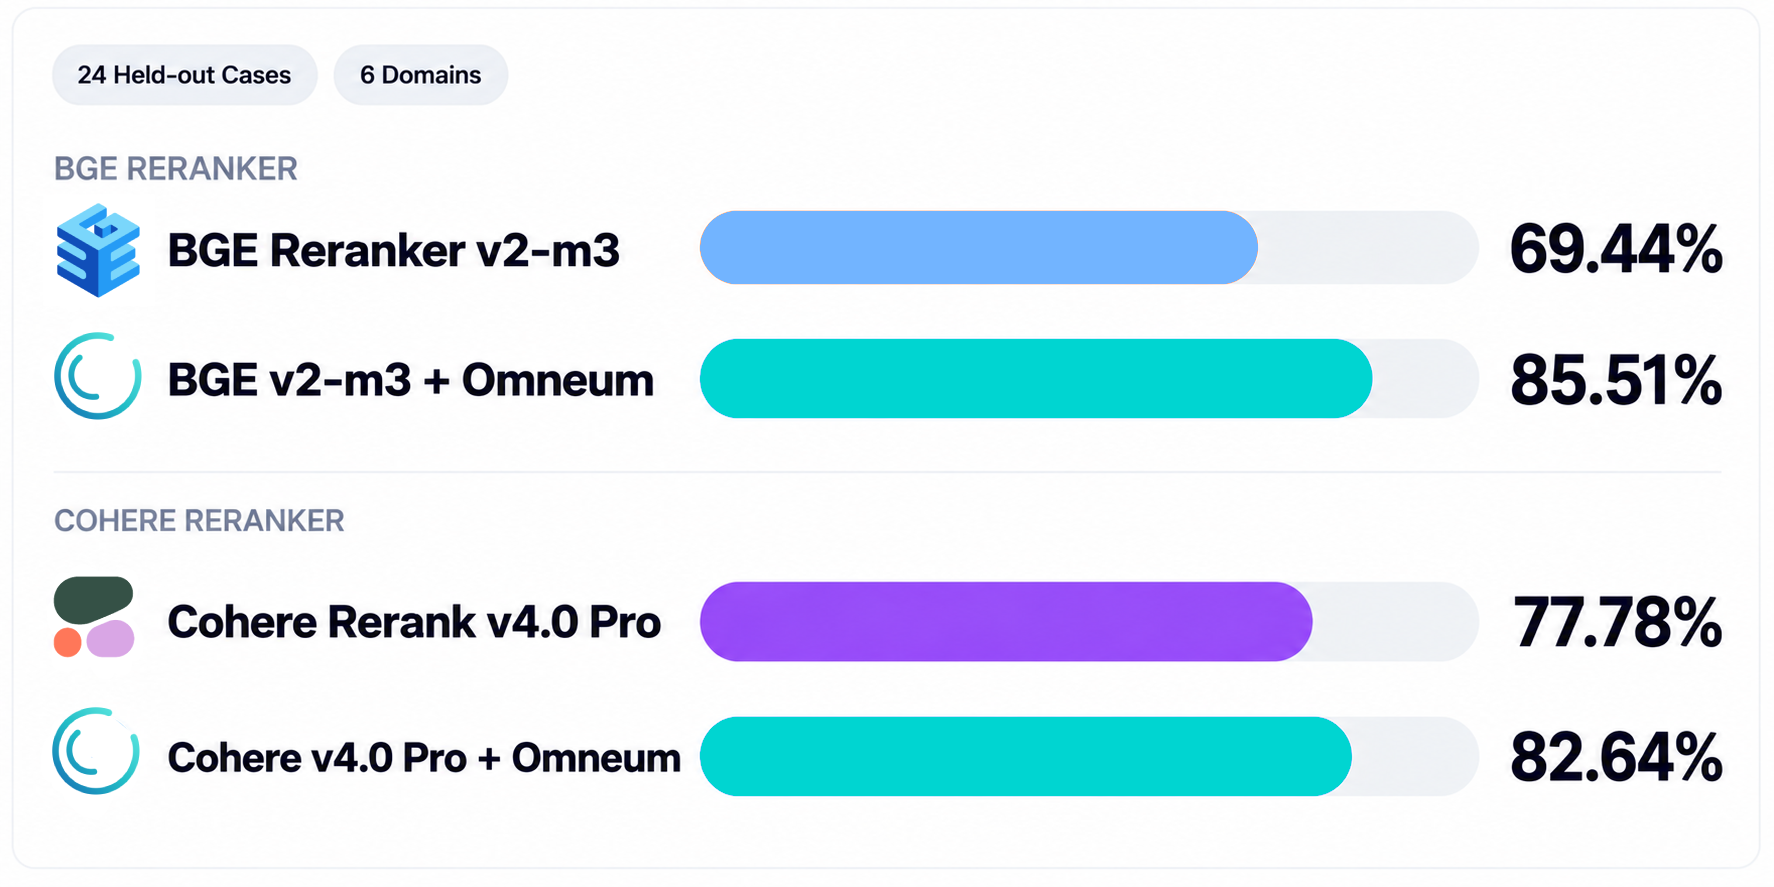
| 構成 | 精度 ↑ | 再現率 ↑ | 回答精度 ↑ | 選択 p50 ↓ | E2E p50 ↓ | 生成トークン数 ↓ | 生成コスト ↓ |
|---|---|---|---|---|---|---|---|
| BGE Reranker v2-m3 | 69.44% | 47.46% | 91.67% | 201 ms | 2.467s | 11,941 | $0.074618 |
| BGE + Omneum | 85.51% | 59.31% | 87.50% | 660 ms | 3.020s | 11,595 | $0.070662 |
| Cohere Rerank v4.0 Pro | 77.78% | 53.99% | 87.50% | 151 ms | 2.634s | 11,577 | $0.071242 |
| Cohere + Omneum | 82.64% | 55.72% | 79.17% | 624 ms | 3.176s | 11,535 | $0.070654 |
コストには、下流の生成 API の推定使用料のみが含まれます。リランカー API の料金とローカルの計算コストは含まれません。どちらの比較でも、Omneum は選択精度と再現率を向上させます。
最先端 LLM の判定モデル
各 LLM 判定モデルは、同じモデル固有のベンチマーク設定で Omneum と比較して評価されます。
| 設定 | 適合率 ↑ | 再現率 ↑ | 回答精度 ↑ | 選択 p50 ↓ | E2E p50 ↓ | 生成トークン数 ↓ | 生成コスト ↓ |
|---|---|---|---|---|---|---|---|
| BGE + Claude Sonnet 5.5 判定モデル | 92.36% | 65.24% | 95.83% | 1.831s | 4.165s | 11,356 | $0.068208 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.697s | 3.141s | 11,811 | $0.072822 |
| BGE + GPT-6 Astra 判定モデル | 92.78% | 65.45% | 92.50% | 3.421s | 5.849s | 111,247 | $0.658998 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.641s | 2.983s | 115,119 | $0.698310 |
| BGE + Gemini 3.8 Flash 判定モデル | 94.44% | 66.28% | 95.83% | 2.487s | 4.924s | 114,250 | $0.686916 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.639s | 3.130s | 115,535 | $0.702470 |
コストには、下流の生成 API の推定利用料のみが含まれます。LLM 判定モデルの推論コストとローカルのコンピューティングコストは含まれません。Omneum は、最先端の LLM 判定モデルに対して、選択の品質と下流の回答精度で競争力を保ちながら、選択レイテンシを 2.6~5.3 倍低減し、追加の LLM 推論ステップも必要としません。
詳細な評価: 手法 · コーディングエージェント · エンタープライズ RAG · リサーチエージェント · マルチエージェントシステム · データ分析 · サポート業務
本番環境
Omneum は、デフォルトのローカルストレージバックエンドとして SQLite を使用します。外部データベースを使用するデプロイでは、PostgreSQL もサポートされています。
| コンポーネント | 実装 |
|---|---|
| MCP サーバー | ローカルの omneum-server プロセス |
| 評価器 | 管理対象のローカルデーモン |
| ローカルデータベース | SQLite |
| グラフモデル | source、claim、observation、dependency のリレーショナルテーブル |
| 外部データベース | PostgreSQL |
| グラフ拡張機能 | Apache AGE |
| サービスマネージャー | macOS では launchd、Ubuntu では systemd |
| 暗号技術 | RFC 9497 VOPRF、Ristretto255-SHA512 |
ローカルインストールでは、context.db が自動的に作成されます。
macOS
~/Library/Application Support/Omneum/context.db

Linux
~/.local/share/omneum/context.db
安全でないデータディレクトリの祖先を持つ新しいデフォルトグラフの場合、Omneum は
~/.omneum/data/context.db を使用します。既存のグラフと明示的に指定されたパスが、
通知なく移動されることはありません。共有ディレクトリの権限も保持されます。
外部データベースを使用するデプロイでは、PostgreSQL を設定できます。PostgreSQL のデプロイでは、Apache AGE がグラフ投影を提供します。
ストレージスキーマとデプロイオプションについては、docs/storage.md を参照してください。
セキュリティとプライバシー
Omneum はコンテキストをローカルで評価します。omneum-server、評価デーモン、および context.db はローカル環境内で実行されます。
| コンポーネント | 境界 |
|---|---|
| コンテキスト | ローカル評価パスに渡されます |
| コンテキストグラフ | ローカルの context.db に保存されます |
| VOPRF 秘密鍵 | 評価デーモンが保持します |
| MCP プロセス | 評価器の秘密鍵を読み取ることはできません |
| ソースペイロード | グラフ内に格納する必要はありません |
| Omneum Network | 取り込み API を通じた任意の提供 |
Omneum は MCP セッションをまたいで、ローカルのコンテキストグラフを保持します。
application data
      │
      ▼
  omneum-server
      │
      ├── evaluator daemon
      │
      └── context.db
ローカルでの永続化と Omneum Network への提供は、個別に設定します。
| オプション | 動作 |
|---|---|
| ローカルでの永続化 | 観測データを context.db に書き込みます |
| ネットワークへの提供 | 取り込み API を通じて、仮名化された観測データを Omneum Network に送信します |
ネットワークへの提供については Omneum Network を、コンテキストグラフの保存については Local Persistence をご覧ください。
外部評価
外部評価は、テスト入力と Omneum の出力とともに evals/ で公開されています。
SearchTS。 SearchTS 0.13.0 は、curl_cffi 経由の thenewstack.io と stealth-browser 経由の go.dev から、同じ Go 1.22 に関する主張を取得しました。Omneum は両方の取得データについて、元の final_url と fetched_at の値を受け取りました。評価では、独立したサポートの推定値 2.00、ペアごとの依存度 0.0000、依存シグナルのカバレッジ 0.25 が返されました。結果 →
Jawz。 5 つのソースと 10 件の主張にまたがる、14 件の金融観測データを用いた Omneum 1.0.3 の独立評価です。FRED の系譜を宣言した場合、依存度スコアは 1.00 になりました。系譜を省略すると、平均依存度は 0.70 から 0.42 に低下し、推定器 v4 は共有系列のペア間に部分的な依存関係(0.10)を検出しました。無関係な対照データは 0.00 のままでした。実行は、ネットワークから隔離された Linux Docker 環境で決定論的でした。結果 →
Bastra Recall。 Recall は、30 件のメモリを用いた合成ハーネスに対して、Omneum 1.0.3 の dependency-estimator-v4 を実行しました。1 つの上流ソースを共有する 4 件のメモリは、実効的な独立サポート 1.0 に集約され、独立した 3 つのソースは 3.0 のままでした。時間のみを変化させたテストでは、タイムスタンプが同一の場合の実効ソース数 2.5 から、48 時間後の 3.0 まで連続的に変化しました。また評価では、v1 → v2 → v3 → v4 の場合に依存関係が 1.0 ではなく 1.6 となる、未解決の系譜チェーンのケースも明らかになりました。これは、現在、依存関係が直接の系譜エッジ間でのみ計算されるためです。結果 →
コントリビューション
コントリビューションを歓迎します。CONTRIBUTING.md をご覧ください。
セキュリティ上の問題を発見した場合は、公開の Issue を作成せず、SECURITY.md に記載された非公開の報告手順に従ってください。
ライセンス
Omneum は、MIT License の下でオープンソースとして公開されています。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。