GroundLens について
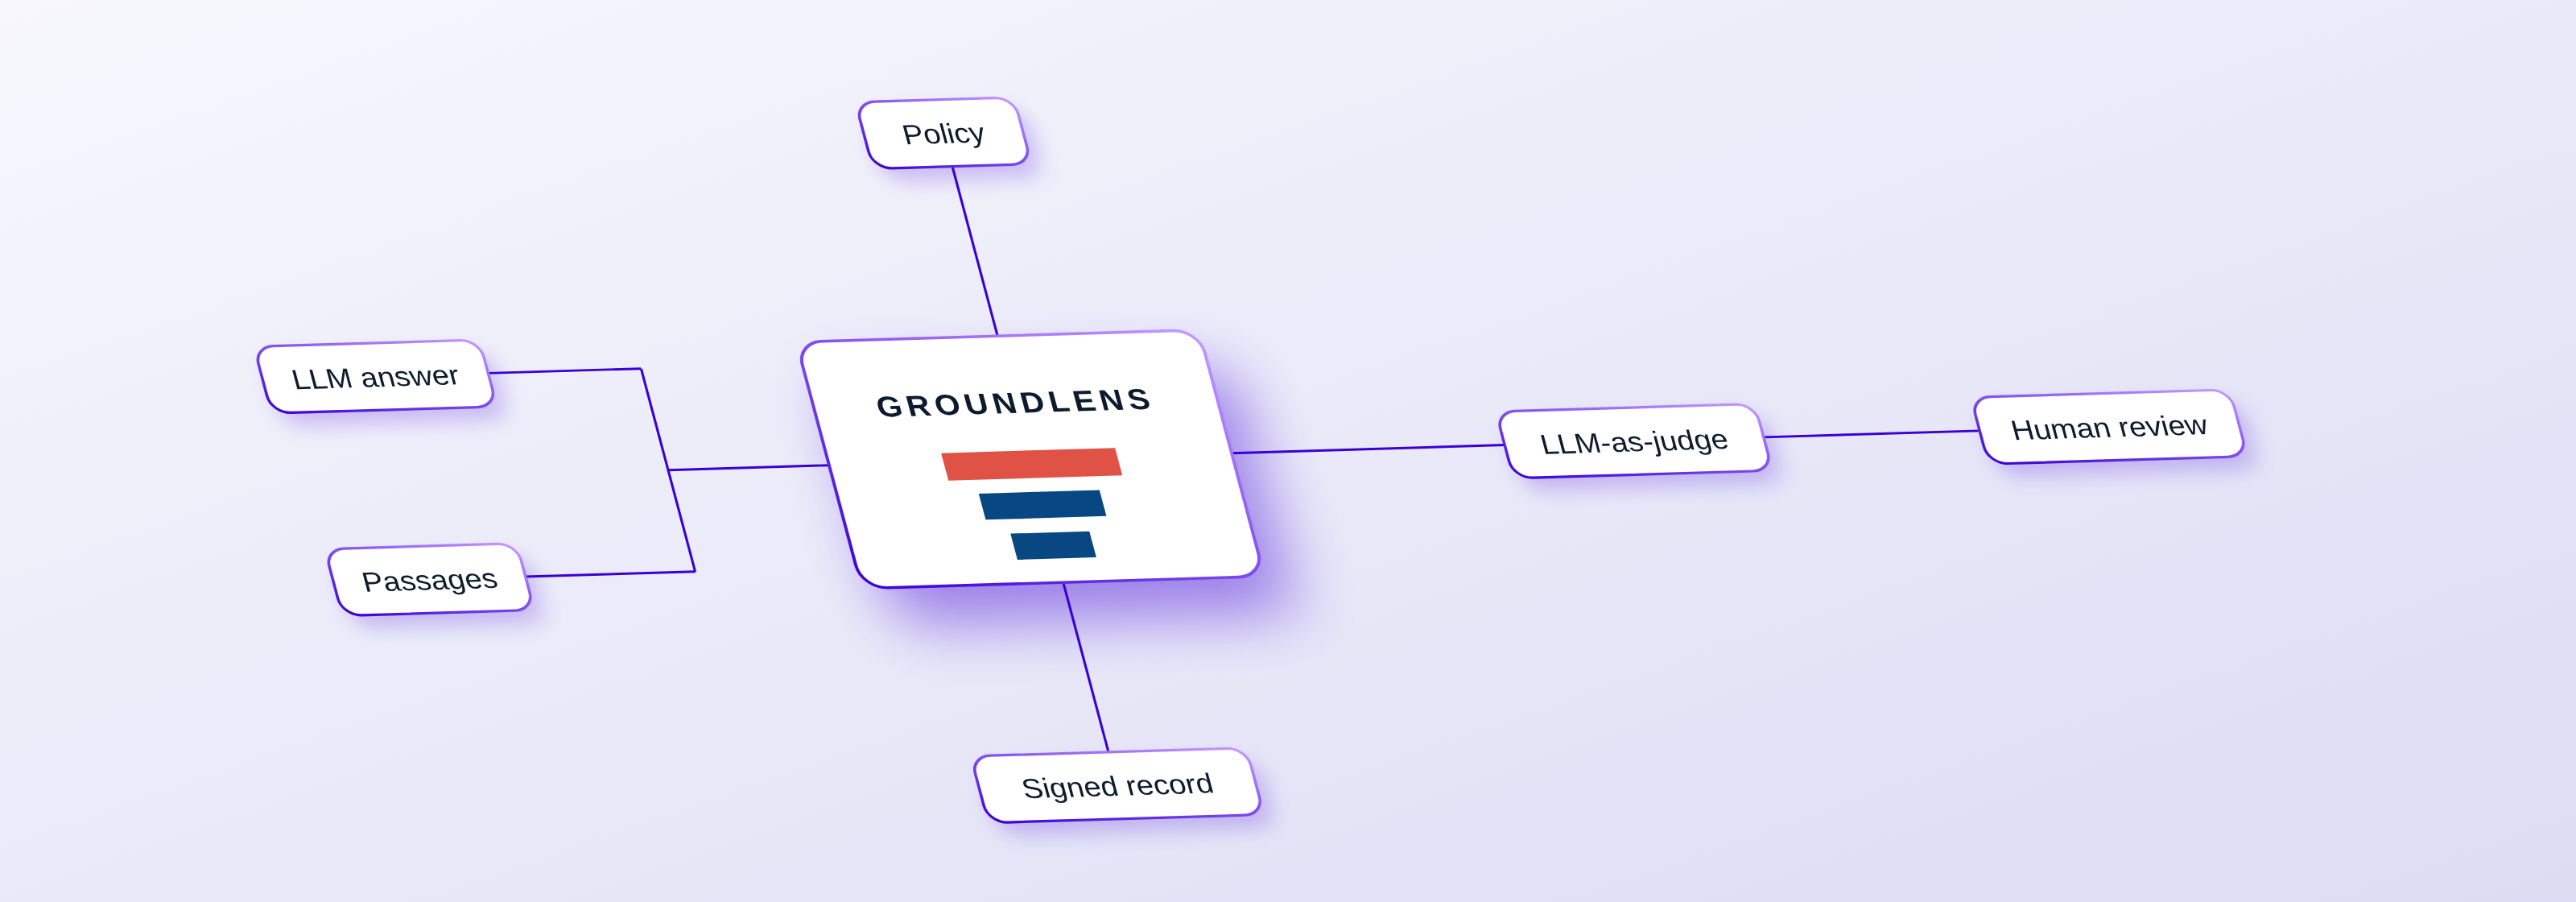
GroundLensは、数値、範囲、意図を決定論的に検査し、LLMの回答を根拠となる文章と照合してPASS、REVIEW、FAILを返します。回答検証を監査したいチーム向けで、判定を返す前に署名付きの連鎖レコードを保存します。
主な機能
- 01数値、範囲、意図の決定論的な検査
- 02理由付きのPASS、REVIEW、FAIL判定
- 03署名付きレコードの追記専用チェーン
- 04判定を引き上げることだけができる任意のLLM判定器
- 05LangfuseとOpenTelemetryによる可観測性
活用シーン
- 01返答前の、文書に基づく回答の検証
- 02署名付きレコードを使った検証判定の監査
- 03LangfuseまたはOpenTelemetryでの検査結果の追跡
MCP 対応
GroundLensはstdio経由で、読み取り専用ツール`verify_answer`、`verify_run`、`verify_records`を提供します。任意のリモートMCPエンドポイントも`verify_answer`を公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
LLM の回答を守るガードレール


GroundLens は、AI の回答をお客様のドキュメントと照合します。
数値、対象者、そして質問に答えているかを確認します。
初見の財務に関する回答では、誤った回答 4 件中 3 件を検出しました。
数値を含む公開情報の主張では、根拠のないものの半数を検出しました。
チェック 1 回あたり約 10 ms。決定論的で、処理に LLM は関与しません。1
🤔 すでに LLM による判定を実行していますか?そのままお使いください。GroundLens はまず厳密なチェックを行い、FAIL は判定に進みません。判定器が見るのは、厳密なチェックで却下できなかった回答だけです。 | 決定論的 | まず厳密にチェックし、LLM による判定は不要 |
| 証明可能 | 署名付き記録による PASS、REVIEW、FAIL | |
| 測定可能 | お客様の回答を使って、合格したもののエラー率を測定 | |
| ポータブル | Rust エンジン:すべての OS で同じハッシュ |
対応サービス




クイックスタート
# pip install groundlens
import groundlens as gl

verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"))
record = verifier.check(answer="Revenue was €42.1 million.", passages=["Revenue reached €41.2 million."])
print(record.decision, record.reasons)
FAIL ['c2: groundlens.numeric contradicted: €42.1 million not in sources; nearest 41200000 EUR in ctx-0 (relative distance 0.021)']
ローカルで実行されます。アカウント、API キー、モデル、ネットワークは不要です。署名済みの記録は、check が戻る前に records/ に保存されます。
統合
同じチェックをスタックに組み込みます。
Langfuse · pip install "groundlens[langfuse]"
from langfuse import get_client
verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"), observers=[gl.integrations.langfuse(get_client())])
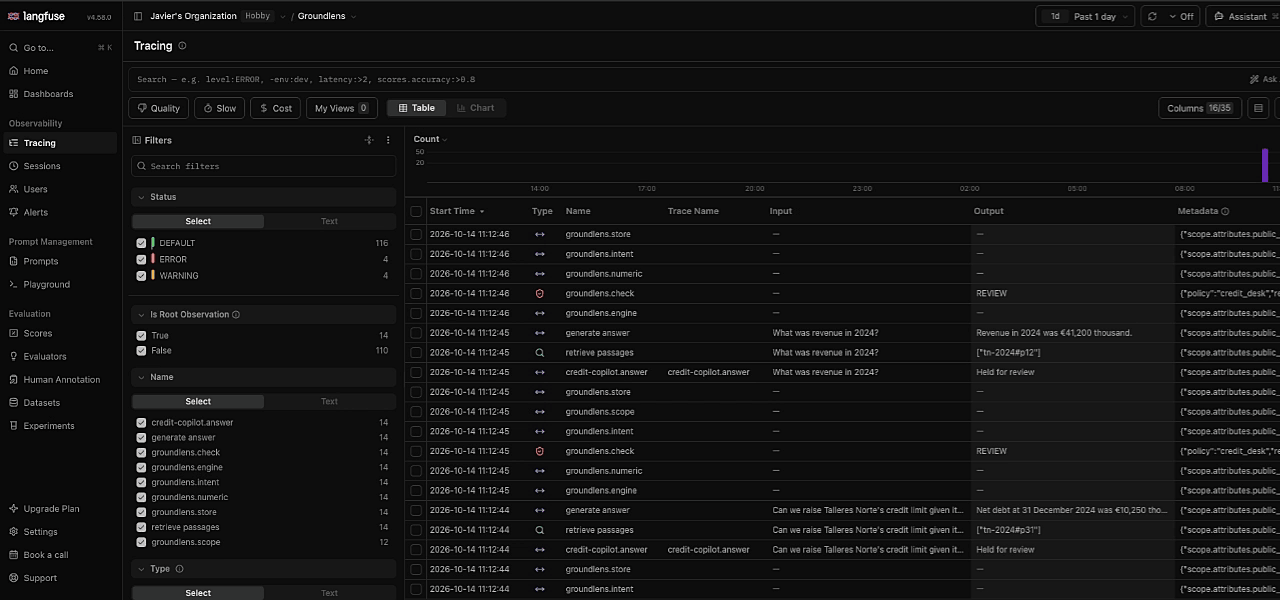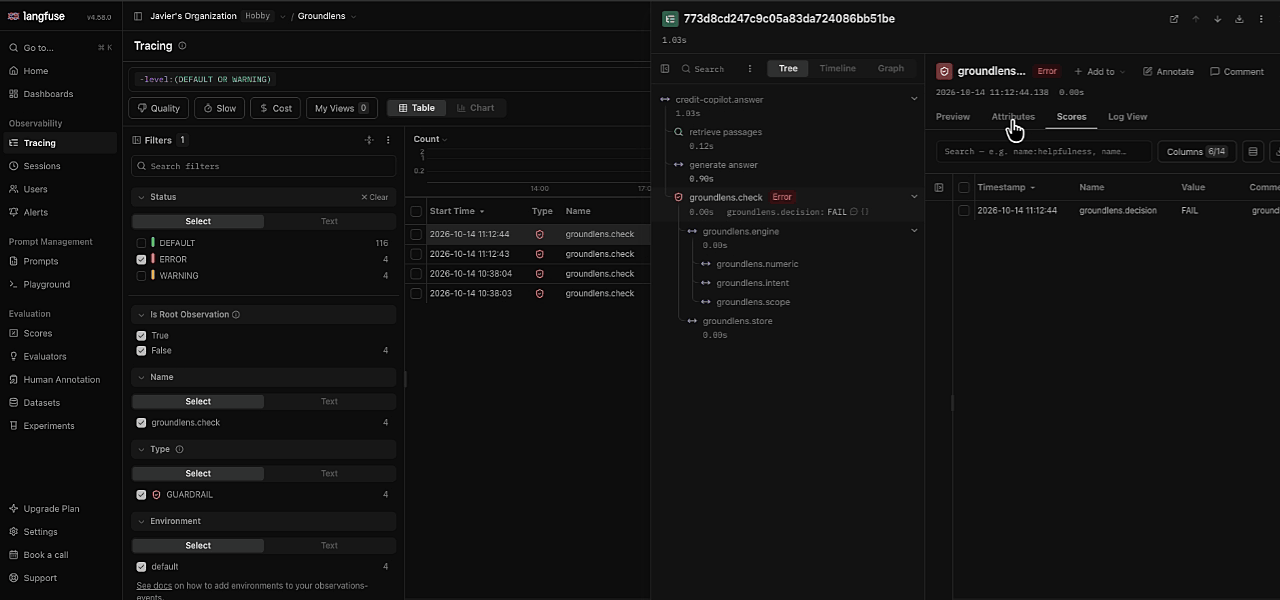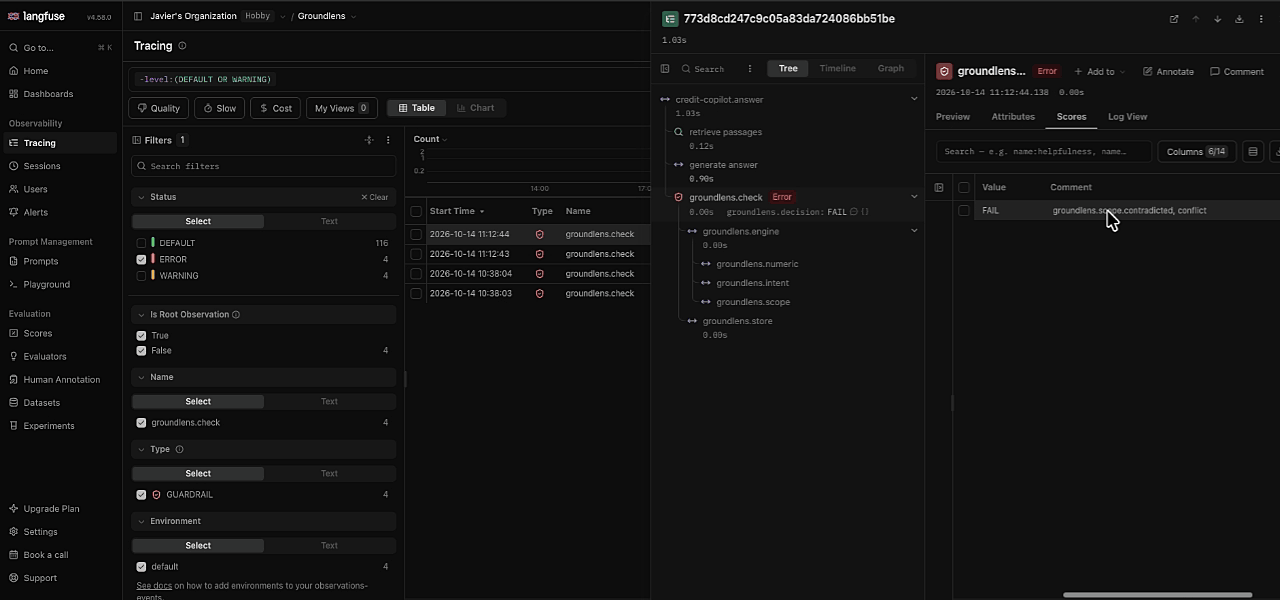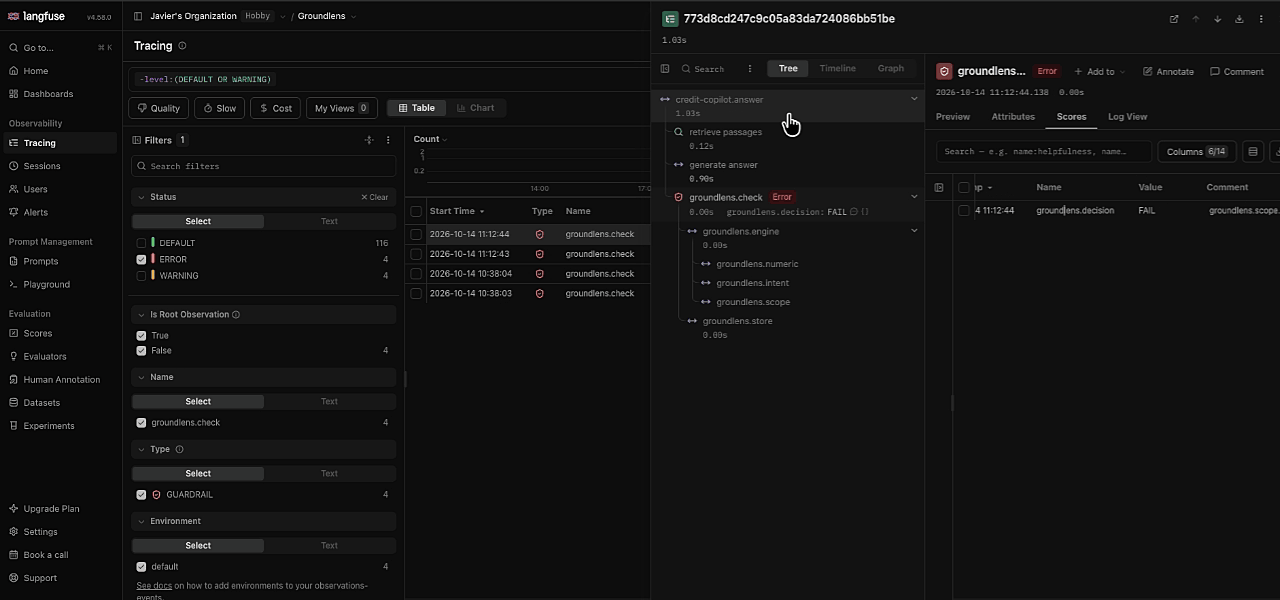
回答を生成したオブザベーション内で check を呼び出すと、そのトレースに次の情報が追加されます。
- スコア
groundlens.decision: チェックとトレースに付与されるカテゴリ値PASS、REVIEW、FAIL。この値でトレースを絞り込み、グラフ化し、エクスポートできます。 - オブザベーション
groundlens.check: タイプはguardrailです。理由はステータスメッセージとして、1 行に 1 つずつ表示されます。レベルは Langfuse 独自のスケールに従い、PASSはDEFAULT、REVIEWはWARNING、FAILはERRORです。 - チェックのメタデータ: 判定、理由コード(
groundlens.scope.contradicted)、ポリシー、および署名済み記録の ID とハッシュが含まれます。 - ジャッジ: 独自のモデル呼び出しの横に、モデル名を含む
generationオブザベーションが記録されます。 - スパン: 検証器ごとに 1 つ、さらにストアのスパンが記録され、それぞれの所要時間が含まれます。Log View ではミリ秒単位で表示されます。
- SDK: Python v3 と v4 に対応しています。Langfuse Cloud とセルフホスト版 Langfuse 4.58 でテスト済みです。
Grafana と OpenTelemetry · pip install "groundlens[otel]"
verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"), observers=[gl.integrations.otel()])
スパンとメトリクスは、アプリケーションですでに設定されているプロバイダー(Tempo、Prometheus、または任意の OpenTelemetry バックエンド)経由で送信されます。
-
メトリクス:
groundlens_decisions_total{decision, policy}、groundlens_reasons_total{reason, decision}、groundlens_check_duration_seconds{stage}。stage はtotal、engine、judge、sign、storeです。 -
スパン:
groundlens.decision、groundlens.reasons、記録 ID とハッシュを含むgroundlens.check。検証器ごとの子スパン、ジャッジ(gen_ai.*)、ストアのスパンも記録されます。 -
ダッシュボード: 画像に表示されているものです。
gl.integrations.grafana_dashboard()は JSON ファイルのパスを返します。Dashboards → New → Import からインポートしてください。 -
PromQL、失敗した回答の割合:
sum(rate(groundlens_decisions_total{decision="FAIL"}[15m])) / sum(rate(groundlens_decisions_total[15m])) -
失敗率が 5 % を超えたときのアラート:
- alert: GroundLensFailRateHigh expr: sum(rate(groundlens_decisions_total{decision="FAIL"}[15m])) / sum(rate(groundlens_decisions_total[15m])) > 0.05 for: 10m -
試してみる:
docker run -p 3000:3000 -p 4318:4318 grafana/otel-lgtmを実行し、続けてpython examples/observability/credit_copilot.py grafana --minutes 5を実行します。Tempo と Prometheus を使用する Grafana 12 でテスト済みです。
Claude、Codex、Cursor、VS Code などの MCP クライアント · uvx --from "groundlens[mcp]" groundlens mcp
アシスタントは回答する前に、自身の下書きをチェックします。stdio 経由で、読み取り専用の 3 つのツールを利用できます:verify_answer、verify_run、verify_records。uv が必要です。
-
Claude Code(プラグイン:MCP サーバーと、確認するタイミングをClaudeに伝えるスキル):
claude plugin marketplace add groundlens-dev/groundlens claude plugin install groundlens@groundlens -
Codex:
codex mcp add groundlens -- uvx --from "groundlens[mcp]" groundlens mcp -
任意のMCPクライアント(Claude Desktop、Windsurf、Zedなど):
{ "mcpServers": { "groundlens": { "command": "uvx", "args": ["--from", "groundlens[mcp]", "groundlens", "mcp"] } } }パッケージをインストール済みであれば(
pip install "groundlens[mcp]")、"command": "groundlens-mcp"だけで十分です。 -
インストール不要: Hugging Face Spaceも、
verify_answerを備えたリモートMCPサーバーです。https://groundlens-groundlens.hf.space/gradio_api/mcp/で利用できます。
OpenClaw · clawhub install groundlens
OpenClawのスキルレジストリであるClawHubにあるスキルです。アシスタントがドキュメントから取得した数値を含む回答を送信する前に、ドラフトに対してgroundlens verifyを実行します。
- **PASS:**回答が送信されます。
- **FAIL:**ソースに基づいて数値を修正し、再度確認します。
- **REVIEW:**確認できなかった数値を明示して、回答が送信されます。
APIキーも2つ目のモデルも不要で、マシン上で動作します。このスキルはplugins/groundlens/skills/groundlensにあり、Claude Codeプラグインと同じものです。OpenClawでは、openclaw mcp addを使ってMCP サーバーを直接利用することもできます。
レコードの保存先 · sink=
check()は、署名付きレコードが保存された後にのみ結果を返します。保存できない場合、check()は例外を発生させ、判定は返されません。各シンクはチェーンを保持します。各レコードには、その前のレコードのハッシュが含まれます。
| シンク | 渡すもの | 追記専用に保つ方法 |
|---|---|---|
gl.sinks.jsonl("records/") | ディレクトリまたは.jsonlパス | レコードごとに1行のJSONを書き込み、ディスクにフラッシュして、書き込みごとにロックします。開発環境および単一マシン向けです |
gl.sinks.s3_object_lock(boto3.client("s3"), "bucket") | S3クライアントと、Object Lockを有効にして作成したバケット | レコードごとに1オブジェクトを書き込み、既存のオブジェクトがある場合は書き込みません。retain_days=を指定すると保持日が追加されます(デフォルトはCOMPLIANCEモードです) |
gl.sinks.azure_blob(container_client) | azure.storage.blob.ContainerClient | レコードごとに1つのBlobを書き込み、上書きしません。コンテナーに時間ベースのイミュータビリティポリシーを設定してください |
gl.sinks.postgres(psycopg.connect(...)) | 任意のDB-API接続 | レコードごとに1行を保存します。テーブルが存在しない場合は作成され、キーによって同じ位置への二重書き込みやチェーンの分岐を防ぎます |
import boto3
verifier = gl.Verifier(
    signer=gl.signers.aws_kms(boto3.client("kms"), key_id),           # the key never leaves KMS
    sink=gl.sinks.s3_object_lock(boto3.client("s3"), "audit-records", retain_days=3650),
)
複数のプロセスで使う場合は、それぞれに独自のチェーン(chain="worker-3")を割り当て、groundlens record verifyでまとめて検証してください。GroundLensはこれらのSDKに依存しません。すでに使用しているクライアントを渡すだけです。Postgres、S3 Object Lock、AWS KMS、Azure Blob、PKCS#11は、CIで実際のソフトウェア(Postgres、MinIO、LocalStack、Azurite、SoftHSM)を使ってテストされています。Azure Key Vaultにはエミュレーターがなく、実験的な機能です。
## LLM-as-a-judge
厳密なチェックでは、数値が誤っている、計算間違いがある、別の企業の数値である、または尋ねたものとは別の種類である、といった問題を検出できます。しかし、正しい表の誤った行から取得した実在の数値や、文章中で一度も述べられていない文までは検出できません。そのためには、読み取るモデル、つまりジャッジを接続します。GroundLens にモデルは同梱されていません。すでに使用しているクライアントを渡してください。
from openai import OpenAI

verifier = gl.Verifier(
    "credit_desk.yaml",                                       # a policy that allows a judge, below
    judge=gl.judges.openai_compatible(OpenAI(), "gpt-4.1"),
    sink=gl.sinks.jsonl("records/"),
)
| アダプター | クライアント |
|---|---|
gl.judges.openai_compatible(client, model) | openai.OpenAI、または同じ API を備えたサーバー:vLLM、Ollama、独自のゲートウェイ(base_url=) |
gl.judges.azure_openai(client, deployment) | openai.AzureOpenAI |
gl.judges.bedrock(client, model_id) | boto3.client("bedrock-runtime") |
同梱のポリシーではジャッジを使用できないため、ジャッジを使用するポリシーにはその旨が記載されています。
id: credit_desk
version: 1.0.0
extends: eu_ai_act_high_risk_v1
verifiers:
  forbidden: []          # allow llm_judge.*
judge:
  required: true         # no judge, or a judge that fails: REVIEW
  contradicted: REVIEW   # or FAIL
  unsupported: REVIEW
ジャッジはエスカレーションできますが、PASS にはできません。 各文に supported、unsupported、contradicted、uncertain のいずれかのラベルを付けます。supported だけでは何も解決しないため、ジャッジが間違っていたり、文章に同意するよう誘導されていたりしても、厳密なチェックに通らない回答が通過することはありません。タイムアウト、エラー、不正な形式の応答は REVIEW になります。
送信内容をそのまま確認できます。 回答ごとに、固定テンプレート(groundlens.judge/1)を使ってプロンプトを1つ作成します。プロンプトには、PASS の意味、スコープ、質問、回答、出典情報を含むすべての文章が含まれます。文章はその中に含められないマーカーで囲まれるため、文章内のテキストは指示ではなくデータとして扱われます。groundlens judge show-template を実行すると、どこにも何も送信する前に、正確なプロンプトを表示できます。
記録には経緯が残ります。 テンプレート ID、プロンプトのハッシュ、プロバイダーが回答したとするモデル、応答のハッシュに加え、各文のラベル、引用した文章、その1行の理由が記録されます。Langfuse では、ジャッジは独自のモデル呼び出しの隣に generation として表示されます。
アーキテクチャ
GroundLens では、検証を決して混在しない5つの部分、クレーム、検証器、エビデンス、ポリシー、記録に分割します。
- 回答をクレームに分割します。各数値と各文を、文字オフセットとともに取り出します。
- 検証器は各クレームを文章と照合し、判定ではなくエビデンス(
supported、contradicted、unsupported)を返します。同梱の検証器は厳密です。数値(正確な分数、ロケール、単位、再計算した合計と比率)、スコープ、意図、そして独自のルールを検証します。ジャッジを接続している場合は、固定テンプレートを通じて、すでに使用しているモデルに確認します。 - エビデンスグラフには、各検証器が各クレームについて示した内容と、検証器間で意見が食い違っている箇所が保持されます。
- お客様が所有する YAML ファイルであるポリシーが、エビデンスを
PASS、REVIEW、FAILのいずれかの判定に変換し、その理由を示します。 - 記録には、入力のハッシュ、エビデンス、ポリシーのハッシュ、判定が保存されます。記録は前の記録につながれ、署名されます。
checkが戻る前に保存され、オブザーバーへの通知はその後に行われます。
エンジンは Rust で実装され、Python ホイール(abi3、Python 3.10 以降)として配布されます。また、Python なしで記録を検証するスタンドアロンの glv バイナリも付属します。エンジンはプロセス内で動作し、サーバー、ネットワーク、実行時依存関係はありません。Rust からは cargo add groundlens、バイナリは cargo install groundlens-cli を実行してください。
## パラメーター
Verifier のパラメーター | 選択肢 |
|---|---|
policy | groundlens_default_v1(デフォルト)、eu_ai_act_high_risk_v1、または extends でいずれかを継承する独自の YAML |
signer | local_key(開発用)、aws_kms、azure_key_vault、pkcs11 |
sink | jsonl、s3_object_lock、azure_blob、postgres |
judge | openai_compatible(OpenAI、vLLM、Ollama など)、azure_openai、bedrock。任意 |
observers | integrations.langfuse、integrations.otel、または独自のもの |
locale、rounding | 数値の読み取り方と比較方法 |
check のパラメーター | |
|---|---|
answer、passages | 必須。passages は文字列、または (id, text, provenance) |
question | 意図のチェックを有効にします。回答が求められた種類と単位を示しているかを確認します |
scope | リクエストの対象({"entity": "ACME"}):別のエンティティの数値が含まれている場合は不合格になります |
risk_class | チェック結果にかかわらず、人によるレビューに回すようポリシーで指定できるクラス |
ポリシー
チェックによってエビデンスが生成されます。ポリシーは、そのエビデンスの意味、つまり何を不合格とするか、何を人に回すか、PASS によって何が許可されるかを決定します。これは、所有者であるお客様がコードとともに管理し、バージョン管理する短い YAML ファイルです。同じ回答でも、ポリシーが異なれば異なる判定になることがあり、どちらも正しい判定です。その違いは、文書化されたリスク許容度を反映しています。
GroundLens には、次の 2 つのポリシーが付属しています。
| ポリシー | 対象 |
|---|---|
groundlens_default_v1(デフォルト) | あらゆるアプリケーション。矛盾する数値やスコープ外の数値は不合格となり、種類や単位が誤った回答はレビューに回されます。モデルによる判定はありません。 |
eu_ai_act_high_risk_v1 | EU AI Act の Annex III に該当するシステム。同じルールを適用し、各判定を Art. 15(1) の正確性、Art. 14(4)(a) の人間による監督、Art. 12(1) の記録管理に対応付けます。 |
独自のポリシーを作成する
付属のポリシーを拡張し、異なる部分だけを記述します。
id: credit_desk
version: 1.2.0
extends: eu_ai_act_high_risk_v1
pass_means: "may be shown to the analyst as a summary of the filing"
locale: es-ES                     # how the documents write numbers: 1.234,56
rounding: half_even               # how a recomputed figure may round
scope:
  required: [entity]              # every request must name the borrower
  missing_scope: REVIEW           # or FAIL; never PASS
risk_classes:
  default: credit_information
  mandatory_review: [credit_limit_change]   # always seen by a person
verifier = gl.Verifier("policies/credit_desk.yaml")
verifier.check(answer=a, passages=p, scope={"entity": "Talleres Norte"}, risk_class="credit_limit_change")
| キー | 設定内容 |
|---|---|
extends | ベースとして使用する付属ポリシー。マップはキーごとにマージされ、リストは置き換えられます。独自の id と version を設定する必要があります。 |
pass_means | PASS によってアプリケーションで何が許可されるかを一文で記述します。Verifier の PASS は公開の決定ではありません。ここでは、PASS が何を意味するのかを示します。 |
locale、rounding | 数値の読み取り方と比較方法:half_up、half_even、within_last_digit。ここに記述した値は、リクエストの値より優先されます。 |
scope | すべてのリクエストに含める必要があるキーと、キーが欠けている場合の扱い。 |
risk_classes | 常にレビューに回すクラス。ポリシーに記載されていないクラスはエラーとなるため、タイプミスによってレビューを回避することはできません。 |
verifiers | 各チェックを required、recommended、optional、fallback、forbidden のどれにするか。 |
decision | 回答を不合格にできる検証器、レビューに回す検証器、未解決または矛盾する主張の扱い。 |
judge | ジャッジが必須かどうか、およびそのラベルで可能な処理。LLM-as-a-judge を参照してください。 |
regulatory_mapping | 各判定のエビデンスとなる管理策と条項を、独自の管理策 ID で指定します。 |
不明なキーは無視されず、エラーになります。ルールのスペルを間違えても、何も起こらないまま処理されることはありません。
失敗は PASS ではありません
| 状況 | 判定 |
|---|---|
| 丸めルールに従って、数値がパッセージの内容と矛盾している | FAIL |
| スコープ外のパッセージにしか数値が記載されていない | FAIL |
| 必須のスコープキーが欠けている | REVIEW(ポリシーで指定されている場合は FAIL) |
| レビューが必要なリスククラス | チェック結果にかかわらず REVIEW |
| チェックを実行できなかった、またはジャッジがタイムアウトしたか失敗した | REVIEW |
| レコードを保存できない | 例外が発生し、判定は行われません |
最終判定は、すべてのチェックのうち最も厳しい結果になります。
ポリシーを確認する
groundlens policy lint policies/credit_desk.yaml                # errors before you deploy
groundlens policy show --resolved policies/credit_desk.yaml     # every default filled in
解決済みポリシーのハッシュは、そのポリシーが判定するすべてのレコードに記録されるため、各判定を、その根拠となった正確なルールまでたどれます。
ポリシーを変更する前に、測定を行う必要があります。
groundlens measureは、判定結果を知らない状態でチームがラベル付けした少数のサンプルをもとに、通過した回答のうち誤りのある回答の割合を、リスククラスごとの 95 % 信頼区間と判定ごとのコストとともに推定します。groundlens replayは、過去のトラフィックに新しいポリシーを適用し、判定が変わるものを一覧表示します。
どちらのレポートにも署名が付与されます。詳しくは、ポリシーの作成をご覧ください。
セキュリティ
GroundLens はモデルと判定の間に位置し、その記録は証拠として使われます。そのため、攻撃の標的になり得ます。攻撃者は、誤った回答を通過させたり、後から記録を改ざんしたりしようとする可能性があります。
| 脅威 | 対策 |
|---|---|
| 誤った回答が通過する | デフォルトの経路ではモデルを使わず、厳密なチェックを実施します。エラーやタイムアウトは決して PASS ではなく REVIEW となり、レコードが保存されなければ判定も行われません |
| パッセージに隠された指示が判定者を誘導する | パッセージは、バージョン管理された固定テンプレート内で区切られたデータとして扱われます。判定者ができるのはエスカレーションのみで、敵対的テストも実施します |
| レコードが編集、削除、並べ替えられる | SHA-256 コンテンツハッシュ、ハッシュチェーン、署名を使用します。groundlens record verify は公開鍵だけでオフライン検証を行います |
| 署名鍵が漏えいする | 鍵は AWS KMS、Azure Key Vault、または PKCS#11 HSM(ECDSA P-256)に保管され、GroundLens が鍵を保持することはありません |
| 2 つの書き込み元がチェーンを分岐させる | すべてのシンクで条件付き書き込みを行います。競合に負けた書き込みは上書きせず、再試行します |
| 検証機能を通じてデータが外部に流出する | エンジンにはネットワーク関連のコードがなく(cargo-deny により HTTP および TLS のクレートを禁止)、他のシステムには渡されたクライアントを通じてのみアクセスします |
| 悪意のある入力によってパーサーが枯渇する | 正規表現 DoS を防ぐ、上限付きの数値文法を使用します。すべてのパーサーにファジングを実施します |
| リリースが改ざんされる | CI の依存関係を固定してハッシュ化し、SLSA Build Level 3 の来歴情報、署名付きリリースバイナリ、OpenSSF Scorecard を使用します |
脆弱性は、GitHub のセキュリティアドバイザリから非公開で報告してください。SECURITY.mdをご覧ください。
コントリビューション
GroundLens が回答を誤った場合、その事例こそが何より価値のあるコントリビューションです。チェック、コネクター、ドキュメントへの貢献も歓迎します。始め方については、CONTRIBUTING.mdをご覧ください。
オープンソース
すべて Apache-2.0 です。エンジン、チェック、ポリシー、コネクター、コマンドライン、MCP サーバーが含まれます。検証の証拠は、誰もが当社のソフトウェアや許可なしに確認できる必要があります。それを実現できるのは、検証機能がオープンソースである場合に限られます。
## お問い合わせ
開発者へのお問い合わせは、[email protected] までお願いします。
1. GroundLens 6.0.5、デフォルトポリシー、判定器なし。金融関連の回答: GroundLens の開発中には使用していない、FinQA の 10-K ページを対象にした RAG(e5 の埋め込み、上位 4 件の文章)による Claude Haiku の実際の回答 189 件。多段階の質問を対象としています。各回答を、GroundLens を知らされていない状態で、固定の文書化された基準に照らして言語モデル(Claude Opus 5.5、claude-opus-5-5)が 2 回ずつ判定し、不一致だった 3 件については 3 回目の判定を実施しました。ラベルは GroundLens の実行前に確定しました。22 件の回答が誤りでした(9 件に 1 件):そのうち 17 件が FAIL または REVIEW となりました(77%、95% CI 57~90%)。合格した 129 件の回答のうち、誤りは 5 件でした(3.9%、95% CI 1.7~8.8%)。その代償として、189 件中 60 件(32%)が FAIL または REVIEW となり、その中には正解だった 110 件のうち 38 件が含まれていました。新しいプロセスでのチェック時間の中央値は 10.6 ms です。公開された主張: LLM-AggreFact のテスト分割(11 セットからの主張と文書のペア 29,320 件、人手によるラベル付け)を使用しました。GroundLens の開発中には使用していません。数値を含む裏付けのない主張 1,616 件のうち、796 件が FAIL または REVIEW となりました(49%、95% CI 47~52%)。合格した数値を含む主張のうち、裏付けのないものは 16.3%で、チェック前の 25.4%から減少しました。数値を含まない主張はすべて合格しました。GroundLens はそのような主張の誤りを一つも検出できませんでした。チェック時間の中央値は 4.0 ms です。効果がなかったセットを含むすべての結果については、BENCHMARK.md をご覧ください。
Copyright Groundlens 2026
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。