lm について
Houtini LM は、Claude などの MCP クライアントが、ローカル LLM、OpenAI のモデル、LiteLLM ルーター、OpenRouter などの OpenAI 互換エンドポイントに限定的な作業を任せられる MCP サーバーです。トークンコストを抑えたい開発者や、コードの第二の意見を求めたい開発者に向いています。計画と判断は Claude が担当し、返された結果を Claude が確認します。
主な機能
- 01別モデルへの草案作成とレビューの委任
- 02ソースファイルを Claude のコンテキストに読み込まない処理
- 03ローカルサーバー、OpenAI、LiteLLM、OpenRouter に対応
- 04モデルごとの出力上限と思考モードの調整
- 05discover と list_models によるエンドポイントの確認
- 06LiteLLM エイリアスから実モデルのコンテキスト長を取得
活用シーン
- 01コードレビューや第二の意見を別モデルに依頼
- 02テストスタブ、ドキュメント文字列、コミットメッセージの生成
- 03ローカル GPU モデルで非公開コードの草案を作成
MCP 対応
Houtini LM 自体が MCP サーバーであり、Claude Code、Claude Desktop、Cursor などの MCP クライアントに委任用のツールを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
npx -y @houtini/lmHOUTINI_LM_ENDPOINT_URLBase URL of the OpenAI-compatible API endpoint (e.g. http://localhost:1234, https://openrouter.ai/api). Legacy alias: LM_STUDIO_URL.HOUTINI_LM_API_KEYシークレットBearer token for API authentication (no auth if blank). Legacy aliases: LM_STUDIO_PASSWORD, LM_PASSWORD, OPENROUTER_API_KEY.HOUTINI_LM_MODELModel identifier to use for requests (auto-detected if not set). Legacy alias: LM_STUDIO_MODEL.HOUTINI_LM_PROVIDEROptional provider override: 'openrouter' forces OpenRouter-specific handling (attribution headers, reasoning.exclude, no inference serialisation). Auto-detected from the endpoint URL when possible.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
8掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| seed | integer | いいえ | 決定論的サンプリングシード。同じシードとプロンプトなら、再現可能な出力が得られます。テストに便利です。 |
| stop | string|array | いいえ | 停止シーケンス。生成中に指定したシーケンスが出現すると停止します(最大 4 個)。 |
| model | string | いいえ | 任意:特定のモデル ID に固定します(例:OpenRouter の "nvidia/nemotron-3-nano-30b-a3b:free"、LM Studio の "qwen.qwen3-coder-30b-a3b-instruct")。設定すると自動ルーティングより優先されます。モデル数が多く、自動ルーティングの選択精度が低いプロバイダーで便利です。 |
| top_k | integer | いいえ | 上位 K 個のトークンのみからサンプリングします(例:40)。0/省略 = 無効。 |
| top_p | number | いいえ | 核サンプリング、範囲は 0~1(例:0.9)。値が低いほど出力が絞られます。temperature の代替です。 |
| system | string | いいえ | ローカル LLM のペルソナ。具体的に指定してください。「helpful assistant」ではなく「Senior TypeScript dev」とします。 |
| message | string | はい | タスクです。期待する出力形式を具体的に指定してください。コード/コンテキストはすべて含め、省略しないでください。 |
| max_tokens | number | いいえ | 応答のトークン予算です。設定しないでください。省略すると、サーバーが稼働中モデルのコンテキストウィンドウを確認し、その 25% を割り当てます(例:128k のコンテキストを持つモデルでは約 32,000 トークン)。ほとんどすべての呼び出しに適した値です。256/512/1024 のような小さな上限は推論モデルの性能を損ないます(目に見える出力の前に、隠れた思考で予算を使い切るため)。そのため 4,096 未満の値は無視され、動的な予算が適用されます。非常に長い出力のために上限を引き上げる場合のみ設定してください。 |
| json_schema | object | いいえ | 構造化 JSON 出力を強制します。JSON Schema オブジェクトを指定すると、レスポンスはそのスキーマに準拠した有効な JSON であることが保証されます。例:{"name":"result","schema":{"type":"object","properties":{"answer":{"type":"string"}},"required":["answer"]}} |
| temperature | number | いいえ | 事実確認/コードには 0.1、分析には 0.3(デフォルト)、創作には 0.7 を指定します。コードでは 0.5 未満にしてください。 |
| repeat_penalty | number | いいえ | 繰り返しペナルティ、範囲は 0~2(1 = オフ、通常は約 1.1)。 |
| presence_penalty | number | いいえ | OpenAI スタイルの存在ペナルティ、範囲は -2~2。 |
| frequency_penalty | number | いいえ | OpenAI スタイルの頻度ペナルティ。範囲は -2~2。 |
詳細
Houtini LM (@houtini/lm) - Claude Code の作業をローカル LLM、OpenAI GPT-5/6、ルーター、または低価格のクラウドモデルに委任



Houtini LM は、Claude(または任意の MCP クライアント)が範囲の限定された作業を別のモデルに委任できる MCP サーバーです。GPU 上のローカル LLM、OpenAI の最新 GPT モデル、LiteLLM ルーター、OpenRouter、低価格のクラウド API などを利用しながら、使い慣れた AI プラットフォームで作業を続けられます。トークン料金を抑えられるほか、必要なときにいつでもコードをレビューする第 2 のモデルを利用できます。
クイックナビゲーション
新機能 | 利用する理由 | インストール | さまざまなモデルへの対応 | 委任する作業 | ツール | フッターの読み方 | 設定 | 互換性のあるエンドポイント | マニュアル
大規模なリファクタリングのために Claude Code を夜通し動かし続け、トークン料金が負担になっていたことが、このツールを作ったきっかけです。支出の大部分は、ボイラープレートの生成、コードレビュー、コミットメッセージの作成、フォーマット変換など、Claude の推論能力やツールアクセスを必要とせず、優れたモデルなら問題なく処理できる範囲の限定されたタスクに使われていました。
そこで、Claude には設計役として計画立案、複数ファイルにわたる変更、判断を任せ、houtini-lm は草案の作成を、稼働中の任意のモデルに渡します。机の下の GPU マシンで動かす Qwen、OpenAI から直接利用する GPT-5 や GPT-6、LiteLLM ルーターの背後にあるモデル、OpenRouter の 300 種類以上のモデル、あるいは 100 万トークンあたりわずかな料金の DeepSeek などを利用できます。返されたものはすべて Claude が QA します。
このツールを作った理由と、日々の使い方について詳しく知りたい方は、開発の経緯と使い方を詳しく紹介した記事をご覧ください。
3.3 の新機能
houtini-lm が対応するのは、ローカル GPU だけではなくなりました。OpenAI に直接接続すれば、間にルーターを挟まずに GPT-5、GPT-6、o シリーズの推論モデルを利用できます。これらのモデルは、オープンモデルがすべて受け付けるパラメーター(max_tokens、temperature)を拒否するため、houtini-lm は max_completion_tokens だけを送信します。また、エンドポイントから出力上限が報告されない場合は、モデル自身のエラーメッセージからその値を取得し、画像、音声、モデレーションの各モデルは一覧から除外します。LiteLLM ルーターに接続すると、各エイリアスの背後にある実際のモデルと、その正確なコンテキストウィンドウおよび出力上限を読み取るため、ローカルモデルとホスト型モデルが混在する環境でも正しくサイズとプロファイルを設定できます。思考モードは auto、off、on から選択できるようになりました。実際のデプロイをもとに作成した Docker ガイドも追加され、マニュアルには作業ごとのページがあります。詳しくは変更履歴をご覧ください。
houtini-lm を使う理由
詳しく説明する前に、結論からお伝えします。お気に入りの AI プラットフォームはそのまま使いながら、最先端モデルを必要としない作業に最先端モデル並みの料金を払わずに済みます。
わかりやすいメリットはコストです。Claude が code_task_files でレビューを委任すると、ソースファイルは houtini-lm プロセスによって読み取られ、そのまま別のモデルに送られるため、Claude のコンテキストウィンドウには一切入りません。Claude は短いツール呼び出しを送り、短い回答を読み取るだけです。実際の TypeScript ソースファイルでベンチマークを行いました。
| タスク | Claude が直接読み取る場合 | 委任した場合 | 削減率 |
|---|---|---|---|
| コードレビュー(1,352 行) | 14,466 トークン | 769 トークン | 95% |
| アーキテクチャレビュー(2,022 行) | 20,014 トークン | 983 トークン | 95% |
| 外部リポジトリのレビュー(581 行) | 5,344 トークン | 741 トークン | 86% |
| コードの説明(833 行) | 8,678 トークン | 744 トークン | 91% |
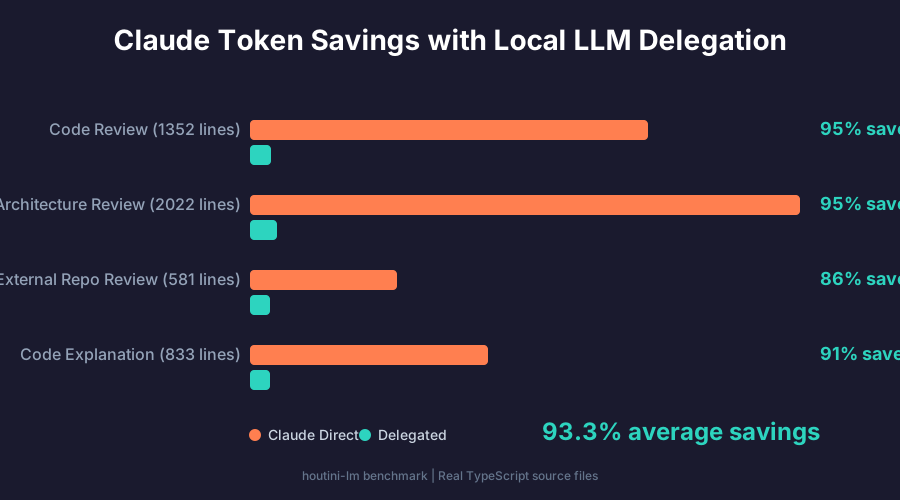
セッション全体では平均 93.3% の削減になります。公平を期すと、1 行の質問やコミットメッセージのような小さなタスクでは、ツール呼び出しのオーバーヘッド(約 250 トークン)が回答とほぼ同じ大きさなので、あまり削減できません。ファイルの読み取りを伴う作業であれば、つまり実際のコーディングセッションの大半では、すぐに元が取れます。LM_STUDIO_URL=http://your-server:1234 node scripts/benchmark.mjs を使えば、ご自身の環境でも同じベンチマークを実行できます。
もうひとつ、わかりにくいメリットは、別の視点を得られることです。別のモデルは異なる見落としをするため、ほとんどコストをかけずに意見を求められます。実際、このリポジトリの 3.3.0 リリースは、好例です。Claude に houtini-lm 経由で gpt-6-astra(LiteLLM ルーター経由)を使わせ、リリース自体の 14,000 トークンの差分をレビューさせました。すると、実際のバグが 3 つ見つかりました。ルーターのプローブが一時的な 429 を永続的な「ルーターではない」という結果としてキャッシュする問題、出力上限が上書きされる問題、モデル一覧キャッシュの競合です。リリース前に 3 つとも修正しました。新たに追加したテストファイル 3 つのうち 2 つも同じ方法でドラフトを作成し、コミット前に Claude がレビューしました。
特に効果が大きいのはコードレビューです。レビューはまさに、範囲が限定され、たくさん読み、少しだけ書く作業であり、安価なモデルが得意とする仕事だからです。そこから用途はさらに広がります。テストのスタブ、ドキュメント文字列、コミットメッセージ、変更履歴のドラフト、フォーマット変換、モックデータ、型定義、RAG パイプライン用の埋め込み、正規表現の簡単な妥当性確認、Claude がひとつの案に決める前の 3 つのアプローチのブレインストーミングなど、さまざまです。
トレードオフは処理時間です。ローカル推論は通常、最先端モデルより 3~30 倍遅いため、委任が有効なのは、あらゆる作業ではなく、範囲が限定され自己完結したタスクです。ローカルモデルならコードのプライバシーを保て、トークンごとの費用もかかりません。クラウドモデルは安価で、どちらも Claude の利用枠やレート制限には影響しません。
仕組み
Claude Code, Claude Desktop, Cursor... (orchestrator)
   |
   |-- Reasoning, planning, architecture, tool use --> your main AI platform
   |
   +-- Bounded grunt work --> houtini-lm --HTTP/SSE--> any OpenAI-compatible endpoint
       . Code review & second opinions       LM Studio, Ollama, vLLM, SGLang, llama.cpp
       . Test stubs & boilerplate            LiteLLM routers
       . Commit messages & docs              OpenRouter (300+ models)
       . Format conversion & mock data       DeepSeek, Groq, Cerebras, OpenAI...
       . Embeddings for RAG pipelines
Claude が設計者、もう一方のモデルがドラフト作成者となり、返ってきたものはすべて Claude が確認します。
インストール
Node 22.5 以降と、OpenAI 互換のエンドポイントが必要です。LM Studio、Ollama、vLLM、SGLang、LiteLLM ルーター、または OpenAI、DeepSeek、Groq などのクラウド API キーを利用できます。同じマシンで LM Studio を起動している場合、Claude Code ではコマンドを 1 つ実行するだけです。
claude mcp add houtini-lm -- npx -y @houtini/lm
これで完了です。LM Studio はデフォルトで localhost:1234 で待ち受けます。houtini-lm はまずここを確認するため、Claude はすぐに処理を委任できます。それ以外の場所を使う場合は、URL(エンドポイントで必要ならキーも)を設定してください。
claude mcp add houtini-lm \
  -e HOUTINI_LM_ENDPOINT_URL=http://192.168.1.50:1234 \
  -e HOUTINI_LM_API_KEY=your-key-if-needed \
  -- npx -y @houtini/lm
OpenAI も同様に使えます。OpenAI には多数のモデルが掲載されていて、ルーティングのスコアはどれも同じになるため、使用するモデルを指定してください。
claude mcp add houtini-lm \
  -e HOUTINI_LM_ENDPOINT_URL=https://api.openai.com \
  -e HOUTINI_LM_API_KEY=sk-... \
  -e HOUTINI_LM_MODEL=gpt-5.2 \
  -e HOUTINI_LM_SERIALISE=0 \
  -- npx -y @houtini/lm
Installing houtini-lm では、別のマシン上の GPU、OpenAI などのクラウド API、OpenRouter、LiteLLM ルーター、Claude Desktop などの MCP クライアントへの接続方法に加え、動作確認と更新の方法をすべて説明しています。コンテナーで実行したい場合は、Running houtini-lm in Docker で、通常の docker run -i と、Docker の MCP Gateway 経由で HTTP サービスとして提供する方法の両方を説明しています。ローカルモデルを使うのが初めてですか?まずはGetting startedをご覧ください。16、32、64、96、128 GB の VRAM に適したモデルについて説明しています。
すべてが正しく接続されていることを確認するには、Claude に houtini-lm の discover ツールを実行するよう依頼してください。バージョン、検出されたエンドポイント、現在アクティブなモデル、コンテキストウィンドウのサイズが表示されます。
houtini-lm が異なるモデルを扱う方法
オープンソースの LLM は、どれも同じではありません。コンテキストウィンドウ、出力上限、プロンプトテンプレート、回答前に思考するかどうか、そして思考内容をどの程度報告するかがそれぞれ異なるため、houtini-lm のコードの多くは、接続先を判断して、それに合わせて調整することに関するものです。houtini-lm が異なるモデルを扱う方法 に詳しい説明があります。ここでは概要を紹介します。
起動時に houtini-lm は、サーバーにロード済みかダウンロード済みかを問わず、利用可能なすべてのモデルを問い合わせます。そして、各モデルのアーキテクチャ、ライセンス、チャットテンプレートを HuggingFace で調べ、そのすべてを SQLite にキャッシュするため、次回以降はすぐに起動できます。よく把握しているファミリー(Qwen、Nemotron、Granite、LLaMA、GLM、GPT-OSS、DeepSeek、Gemma、Kimi、OpenAI のホスト型 GPT モデル)には、厳選したプロファイルがあります。各ファミリーにはそれぞれ固有の温度設定、出力制約、思考ブロックの処理が適用されます。一方、OpenAI のホスト型推論モデル(GPT-5/6、o-series)には、受け付けるパラメーターのみが送られます。list_models を実行すると、全体像を確認できます。
Loaded models (ready to use):

  nvidia/nemotron-3-nano
    type: llm, arch: nemotron_h_moe, quant: Q4_K_M, format: gguf
    context: 200,082 (max 1,048,576), by: nvidia
    Capabilities: tool_use
    NVIDIA Nemotron: compact reasoning model optimised for step-by-step logic
    Best for: analysis tasks, code bug-finding, math/science questions
    HuggingFace: text-generation, 1.7M downloads, MIT licence

Available models (downloaded, not loaded):

  qwen3-coder-30b-a3b-instruct
    type: llm, arch: qwen3moe, quant: BF16, context: 262,144
    Qwen3 Coder: code-specialised model with agentic capabilities
    Best for: code generation, code review, test stubs, refactoring
    HuggingFace: text-generation, 12.9K downloads, Apache-2.0
出力予算は、各呼び出しで実際に送信されるモデルに基づいて決まります。max_tokens を指定しない場合、呼び出しにはそのモデルのコンテキストウィンドウの 25%が割り当てられます。ただし、モデルに宣言された出力上限や、プロンプトの横に残された余裕を超えることはないため、ホスト型モデルが拒否するリクエストを送ることはありません。また、下限も設けています。MCP クライアントは 256 のような小さな上限を指定しがちで、推論モデルの思考を途中で妨げてしまうため、HOUTINI_LM_MIN_TOKENS=0 を設定しない限り、4,096 未満の値は無視されます。
思考を有効にするかどうかは、HOUTINI_LM_THINKING で決められます。デフォルトの auto では、切り替えに対応していると判定されたモデル(Qwen3、Gemma 4、Nemotron、DeepSeek R1、GLM-4、gpt-oss)の思考がオフになります。Claude が推論を担当し、もう一方のモデルが下書きを作成する構成に適しています。off にすると、すべての呼び出しで思考がオンになります。バックエンドが、名前から判別できない思考モデルを提供している場合に必要です。on にすると、すべての呼び出しで思考が有効になります。時間とトークンを消費しますが、バグの調査や議論の検証には役立ちます。どの設定を選んでも、houtini-lm は思考モデルの出力予算を増やし、回答から <think> ブロックを取り除きます。そのため、推論内容によって回答が空になることはありません。
複数のモデルが利用できる場合、houtini-lm はタスクの種類に照らして各モデルを評価し、最適なモデルを選びます。ただし、モデルのロードには数分かかるため、別のモデルに切り替えるのではなく、より適したモデルを提案します。大規模なカタログでは、未知のモデルはすべて同じスコアになるため、最初に一覧表示されたモデルが選ばれます。HOUTINI_LM_MODEL でモデルを固定するか、個別の呼び出しで model を渡してください。
LiteLLM ルーターを指定すると、/model/info も読み込みます。これにより、各エイリアスの背後にある実際のモデル(私の local エイリアスは qwen3.6-27b)と、ホスト型モデルの場合は実際のコンテキストウィンドウおよび出力上限が分かります。各エイリアスは、実際のモデルに基づいてプロファイリングとサイズ設定が行われます。ルーターが大量に一覧表示する TTS、画像、動画のモデルは除外され、レート制限エラーが発生した場合はバックオフ付きで再試行されます。単一の GPU は同時に 1 つのリクエストしか処理できないため、呼び出しはデフォルトで 1 件ずつキューに入れられます。OpenRouter ではキューをスキップします。OpenAI、ルーター、または vLLM のようなバッチ処理バックエンドでは、HOUTINI_LM_SERIALISE=0 を設定してキューを無効にできます。
引き継ぐタスク
最適な候補は、範囲が限定され、明確に定義されていて、入力と出力がはっきりしているものです。
| タスク | 別のモデルでうまくいく理由 |
|---|---|
| コードレビュー | ソース全体を貼り付ける(またはパスを渡す)だけで、バグを尋ねられます |
| 計画へのセカンドオピニオン | 何も確定せず、ほとんどコストがかかりません |
| テストのスタブを生成 | ソースを入力し、テストを出力します |
| 関数の説明 | 要約にはツールへのアクセスは必要ありません |
| コミットメッセージの下書き | 差分を入力し、メッセージを出力します |
| 形式の変換 | JSON を YAML に、snake_case を camelCase に変換します |
| モックデータの生成 | スキーマを入力し、データを出力します |
| 型定義の作成 | ソースを入力し、型を出力します |
| 構造化 JSON 出力 | 文法によって制約されるため、構築時点で有効です |
| テキスト埋め込み | セマンティック検索、RAG パイプライン |
コードベース全体にわたる推論、ツールへのアクセス、複数ステップのオーケストレーションが必要な作業は、すべて Claude に任せます。たとえば、アーキテクチャ上の意思決定、ファイルの読み書き、テストの実行と結果の解釈、複数ファイルにわたるリファクタリング計画、ほかのツールを呼び出す必要がある作業です。ツールの説明は、大きなタスクを始めるときに Claude が委任を計画するよう促す内容になっており、思い出したときだけ使うようにはなっていません。
ツール
ツールは8つあります。パラメーターの詳細はツールの詳細をご覧ください。
| ツール | 用途 |
|---|---|
chat | 主力ツールです。タスクを送信して回答を得ます。 |
custom_prompt | システム、コンテキスト、指示を分けて指定します。ローカルモデルでは、すべてを1つのメッセージに詰め込むよりも安定して優れた結果が得られます。ある週末、同じレビュータスクの一連のバッチを両方の方法で実行してしっかり検証したところ、3部構成のほうが毎回勝ちました。 |
code_task | コードに合わせて調整されたシステムプロンプトと、モデルファミリーごとの温度設定を使ったコード分析です。 |
code_task_files | code_task と同様ですが、houtini-lm がディスクからファイルを直接読み込むため、ソースが Claude のコンテキストを通過しません。読み取れないファイルは呼び出しを失敗させずにインラインで報告され、事前推定器は、実測データからタイムアウトすると判断した入力を拒否します。 |
embed | /v1/embeddings 経由のテキスト埋め込みです(Nomic Embed は堅実な選択肢です)。 |
discover | ヘルスチェックです。エンドポイント、アクティブなモデル、コンテキストウィンドウ、出力上限、実際の呼び出しで測定可能になった後の実測速度を確認できます。 |
list_models | サーバー上のすべてのモデルを、読み込み済み・ダウンロード済みの状態とプロファイルを含めて表示します。 |
stats | モデルカタログなしで、セッションおよび累計のオフロード量と、モデルごとのパフォーマンスを表示します。 |
推論ツール(chat、custom_prompt、code_task、code_task_files)はすべて、呼び出すモデルを固定する任意の model、max_tokens、サンプリング制御(temperature、seed、stop、top_p、top_k、repeat_penalty、frequency_penalty、presence_penalty)を受け取ります。chat と custom_prompt は json_schema も受け取り、回答が JSON Schema に準拠するよう強制します。LM Studio では文法ベースのサンプリングが使われるため、モデルが括弧を閉じるのを覚えていることに期待する必要はありません。
{
  "json_schema": {
    "name": "code_review",
    "schema": {
      "type": "object",
      "properties": {
        "issues": {
          "type": "array",
          "items": {
            "type": "object",
            "properties": {
              "line": { "type": "number" },
              "severity": { "type": "string" },
              "description": { "type": "string" }
            },
            "required": ["line", "severity", "description"]
          }
        }
      },
      "required": ["issues"]
    }
  }
}
Claude ではなく独自のスクリプトから houtini-lm を操作する場合は、HOUTINI_LM_STRUCTURED=1 を設定してください。各推論結果には JSON として読み取れる structuredContent ブロック(回答、モデル、トークン、タイミング、品質フラグ)も含まれます。Claude Code では、ブロックがある場合、モデルにはそのブロックだけが表示されるため、設定はオフにしておいてください(詳細はツールのページをご覧ください)。
フッターを読む
すべての応答の末尾には、SSE ストリーム自体から計算されたフッターが付きます。
---
Model: nvidia/nemotron-3-nano | 279→303 tokens (12 reasoning / 291 visible) | TTFT: 485ms, 58.0 tok/s, 5.2s
📊 First measured call on nvidia/nemotron-3-nano: 58.0 tok/s, 485ms to first token - use this to gauge whether to delegate longer tasks.
💰 Offloaded - this session: 4,283 tokens / 7 calls · lifetime: 147,432 tokens / 213 calls
初回呼び出しの行はセッションごとにモデルごとに一度表示されます。これは合成されたウォームアップではなく、実際のタスクに基づくベンチマークです。💰 の行は呼び出しごとに更新され、もう一方のモデルが処理したトークン(プロンプトと補完、推論を含む)を数えます。これは Claude が行わずに済んだ作業量であり、Claude の節約トークン数を示すものではありません。その正確な指標となるのが上記のベンチマークです。モデルが推論トークンを報告すると、トークン数は推論と表示分に分かれ、思考モデルが非表示の推論にどれだけの予算を費やしているかを確認できます。
問題が発生した場合は、品質行にその内容が表示されます。部分的な結果の場合は TRUNCATED(接続が停止した場合、タイムアウトエラーではなく、届いた内容が返されます)、予算を使い切った場合は hit-max-tokens、推論が削除された場合は think-blocks-stripped、サーバーが使用量を報告しなかった場合は tokens-estimated です。問題のない出力には品質行が付きません。
モデルごとの速度とトークン数は ~/.houtini-lm/model-cache.db に保持されます。そのため、discover では新しいセッションの初回呼び出しから実測の tok/s と初回トークンまでの時間が表示され、stats では累計値が表示されます。このデータは、意図的にお使いのワークステーションに固有のものです。委任の判断には、他の人のベンチマークではなく、お使いのハードウェアを反映すべきだからです。実際には、セッションが長くなるほど Claude はより多くの作業を委任します。オフロードされたトークンが約 5,000 に達すると、さらに委任できる作業を探し始めます。
良い結果を得る
Qwen、Llama、Nemotron、GLM は、今やコーディングベンチマークで非常に優れたスコアを出しています。また、良い結果と悪い結果の差は、ほとんどの場合、モデルよりもプロンプトにあります。私はこの点にかなり時間をかけて取り組んできました。要点は次のとおりです。ローカルモデルは入力が途中で切れていると詳細を作り上げるため、コードは完全な形で送り、途中に ... を含む断片ではなく、関数全体を送ってください。小型モデルには出力形式(「JSON 配列を返してください」など)を明示します。モデルに具体的なペルソナ(「メモリ安全性を重視する Rust のエキスパート開発者」は「親切なアシスタント」よりも明らかに良い結果になります)を与え、すべきことだけでなく、してはいけないことも伝えます。また、コードを生成する場合は、関数本体の周辺にあるインポート、型、シグネチャも含めてください。
長時間のジョブも、チャンクに分けてください。ほとんどの MCP クライアントでは、ツール呼び出しは約 60 秒でタイムアウトします。houtini-lm はストリームのチャンクごとに進捗通知を送ってタイマーをリセットさせますが、すべてのクライアントやゲートウェイが通知を中継するわけではありません。出力が約 500~900 トークンの呼び出しなら、制限時間内に余裕をもって完了します。委任の技術では、修正に使う逐語的なエコーパターンなども含め、さらに詳しく説明しています。
インストールを確認する
npm run shakedown
scripts/shakedown.mjs は、8 つのツールのうち stats 以外の 7 つをエンドツーエンドで実行し、各呼び出しの実測 TTFT、tok/s、トークン数、推論の内訳を表に出力します。十分な性能のマシンなら、1 分もかかりません。
Summary

   7/7 steps passed on LM Studio, model=nvidia/nemotron-3-nano

| Tool              | OK  | TTFT (ms) | tok/s  | Tokens in→out        | Reasoning | Notes
| chat              | ✅  |      891  |   36.9 | 48→104               |        —  | answered
| custom_prompt     | ✅  |      872  |   43.9 | 170→333              |        —  | 5 valid items
| code_task         | ✅  |      857  |   41.6 | 180→189              |        —  | tests generated
| code_task_files   | ✅  |   11028   |   39.5 | 6891→3000            |        —  | cross-referenced
| embed             | ✅  |      —    |     —  | —                    |        —  | 768-dim vector

   Tokens offloaded: 10,915 (prompt: 7,289, completion: 3,626, reasoning: 0)
レイテンシの数値よりも品質レビューを希望する場合は、houtini-lm を接続した Claude のセッションに SHAKEDOWN.md を貼り付けてください。Claude が同じ手順を実行し、速度だけでなく出力のレポートも作成します。
設定
ほとんどのセットアップでは、最初の2つか3つだけ設定すれば十分です。ファイルアクセスとキューイングの制御を含む全項目については、設定をご覧ください。
| 変数 | デフォルト | 説明 |
|---|---|---|
HOUTINI_LM_ENDPOINT_URL | http://localhost:1234 | OpenAI互換APIのベースURLです。/v1は含めません。 |
HOUTINI_LM_API_KEY | (なし) | 認証が必要なエンドポイント用のベアラートークンです。 |
HOUTINI_LM_MODEL | (自動検出) | 呼び出し時にモデルが指定されていない場合に使用するモデルです。ルーターや大規模なカタログでは、モデルを固定してください。 |
HOUTINI_LM_FALLBACK_MODELS | (なし) | OpenRouter専用です。プライマリモデルでエラーが発生した場合(レート制限、ダウンタイム、モデレーションによる拒否、コンテキストの超過)に、順番に試すモデルIDをカンマ区切りで指定します。請求はリクエストを処理したモデルに基づき、フッターにそのモデルが表示されます。 |
HOUTINI_LM_THINKING | auto | auto、off、onのいずれかです。Thinking:auto、off、onをご覧ください。 |
HOUTINI_LM_SERIALISE | 1 | OpenAIなどのクラウドAPI、クラウドモデルの前段にあるルーター、ネイティブにバッチ処理するバックエンド(vLLM、SGLang)では、0に設定してください。 |
HOUTINI_LM_MIN_TOKENS | 4096 | 呼び出し元が指定するmax_tokensの下限です。任意の値を使用するには、0に設定してください。 |
互換性のあるエンドポイント
OpenAIの/v1/chat/completions APIに対応していれば、どのエンドポイントでも動作します。
| 対象 | URL | 備考 |
|---|---|---|
| LM Studio | http://localhost:1234 | デフォルト設定で、設定は不要です。v0 APIを通じて豊富なメタデータを利用できます。セットアップガイド |
| Ollama | http://localhost:11434 | 思考モデル(qwen3、deepseek-r1)は、Ollamaのdelta.reasoningチャネルを通じて処理されます。セットアップガイド |
| vLLM | http://localhost:8000 | OpenAI APIをネイティブに利用できます。セットアップガイド |
| SGLang | http://localhost:30000 | コンテキストを繰り返し使用する作業に適しています。はじめにをご覧ください。 |
| LiteLLMルーター | http://localhost:4000 | 自動検出されます。エイリアスの解決、実際の制限の読み取り、チャット非対応モデルの除外、429エラー時のバックオフに対応します。 |
| llama.cpp | http://localhost:8080 | サーバーモード |
| OpenAI | https://api.openai.com | GPT-5、GPT-6、oシリーズには、各モデルが受け付けるパラメーターだけが送信されます。画像、音声、モデレーションの各モデルは一覧から除外されます。モデルを固定してください。 |
| OpenRouter | https://openrouter.ai/api | 300以上のモデルを自動検出し、並列リクエストを許可します。 |
| DeepSeek | https://api.deepseek.com | トークンあたりの料金が非常に安価です。 |
| Groq | https://api.groq.com/openai | 高速です。 |
| Cerebras | https://api.cerebras.ai | 非常に高速です。 |
| OpenAI互換API全般 | 任意のURL | URLとAPIキーを設定してください。 |
マニュアル
この README は概要です。詳しい説明は以下のページをご覧ください。
| ページ | 内容 |
|---|---|
| houtini-lm のインストール | ローカル、リモート GPU、クラウド、OpenRouter、LiteLLM、Claude Desktop、その他のクライアント、更新など、すべてのインストール方法 |
| Docker で houtini-lm を実行する | docker run -i での実行、または Docker の MCP Gateway の背後で HTTP 経由で提供する方法と、検証で見つかった落とし穴 |
| houtini-lm がさまざまなモデルを扱う方法 | 検出、プロファイル、思考(自動、オフ、オン)、出力予算、ルーティング、LiteLLM ルーター、パラメーターを拒否するモデル |
| 設定 | すべての環境変数、呼び出しごとの設定、状態の保存場所 |
| ツールの詳細 | 8 つすべてのツール:パラメーター、フッターの読み方、max_tokens の下限 |
| 委任の技術 | 委任する内容とその伝え方、逐語的な反復パターン、マイクロ分割、推論モデルの予算 |
| トラブルシューティング | 空の応答、タイムアウト、コンテキスト長による 400 エラー、キューイング、ルーターの症状 > 原因 > 解決方法 |
| はじめに | ローカルモデルをゼロから始める方法:LM Studio または Docker、小型モデルの得意分野、VRAM に適したモデル |
| LM Studio、Ollama、vLLM のセットアップ | バックエンドのガイド。それぞれ、気づかないうちに失敗する原因となる落とし穴を解説しています |
| 動作確認テスト | エンドツーエンドの確認方法。スクリプトとして、または Claude 用のプロンプトとして実行できます |
| 開発者ガイド | アーキテクチャ、コントリビューション、リリースプロセス |
開発
git clone https://github.com/houtini-ai/houtini-lm.git
cd houtini-lm
npm install
npm test             # build + unit tests
npm run shakedown    # end-to-end self-test against a live endpoint
DEVELOPER.md では、アーキテクチャ、推論モデルのパイプライン、バックエンドの検出、SQLite パフォーマンスキャッシュ、新しいツールやバックエンドの追加方法について説明しています。houtini-lm がうまく扱えないモデルファミリーがあれば、discover の出力を添えて Issue を作成してください。確認します。
うまくいくことを願っています。使ってみた感想をぜひお聞かせください!
ライセンス
Apache-2.0
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。