Llm Usage & Cost Tracker について
llm-usage-mcpは、複数のプロバイダーを使う開発者向けのローカル優先型LLMコストトラッカーです。呼び出しをローカルのSQLiteに記録し、MCPツールとCLIで支出確認、価格比較、プロバイダーの推奨を行います。
主な機能
- 01呼び出しとコストをローカルSQLiteに記録
- 02Anthropic、OpenAI、DeepSeek、Qwenに対応
- 03支出を集計して確認
- 04モデル価格を比較し予算に応じて推奨
- 05ローカルプロキシでAPI使用量を捕捉
活用シーン
- 01複数プロバイダーのLLM支出を集約
- 02プロジェクト、モデル、期間別にコストを分析
- 03モデルごとのワークロード価格を試算
- 04ローカルプロキシ経由でAPI使用量を記録
MCP 対応
stdioのMCPサーバーとして7つのツールを提供し、支出照会、プロバイダー比較、価格取得、モデル推奨、プロバイダー一覧、使用量の手動記録に対応します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
llm-usage-mcp
LLM の使用量とコストを追跡 — ローカル優先の支出ウォッチドッグ


英語 | 中文
月末になって、指の隙間から恐る恐る見るホラー映画のように、LLM API の請求額を扱うのはもうやめましょう。すべてのプロバイダーにわたる LLM 呼び出しの実際のコストを、1 か所で、自分のマシン上で把握できます。コーディングエージェント(MCP)に尋ねるか、コマンド(CLI)を入力してください。
これはコストの計測ツールであり、ルーターではありません。支出額と、ワークロードに適したプロバイダーを示しますが、呼び出しの内容を変更することはありません。ルーターやモデルランキングツールと併用できます。
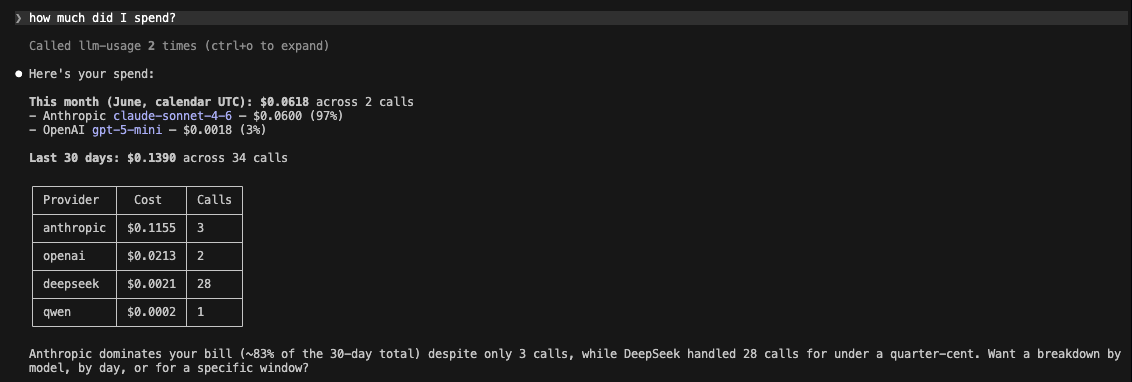
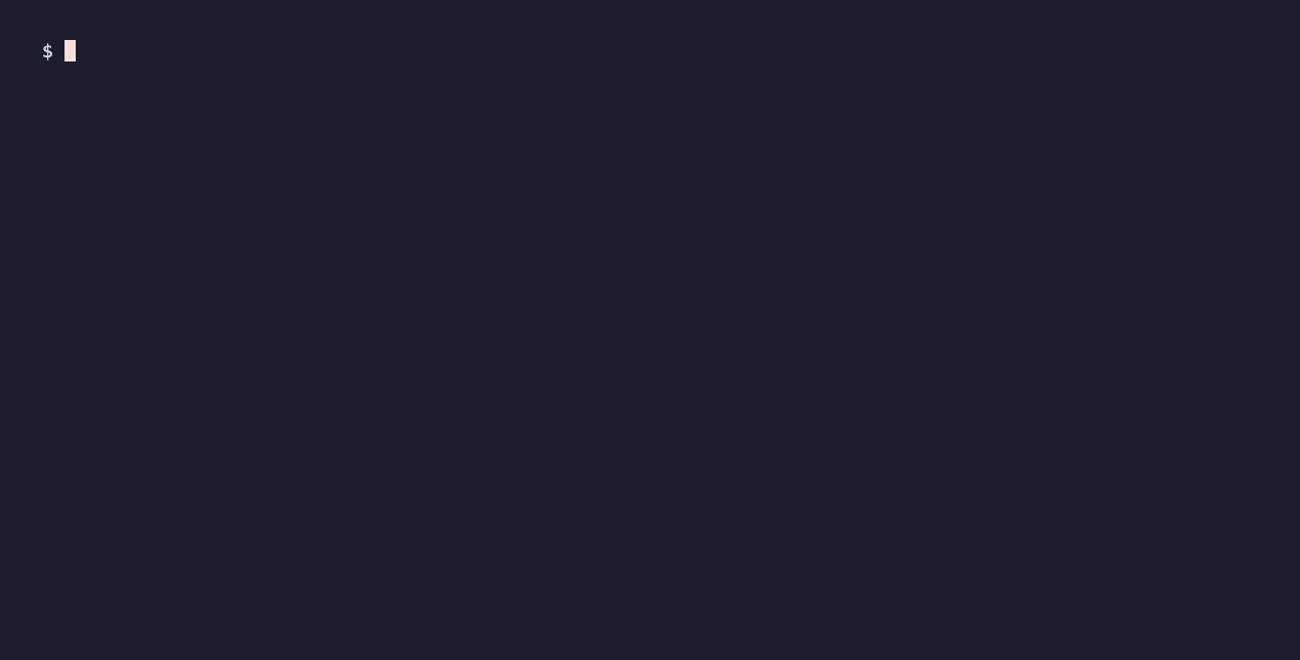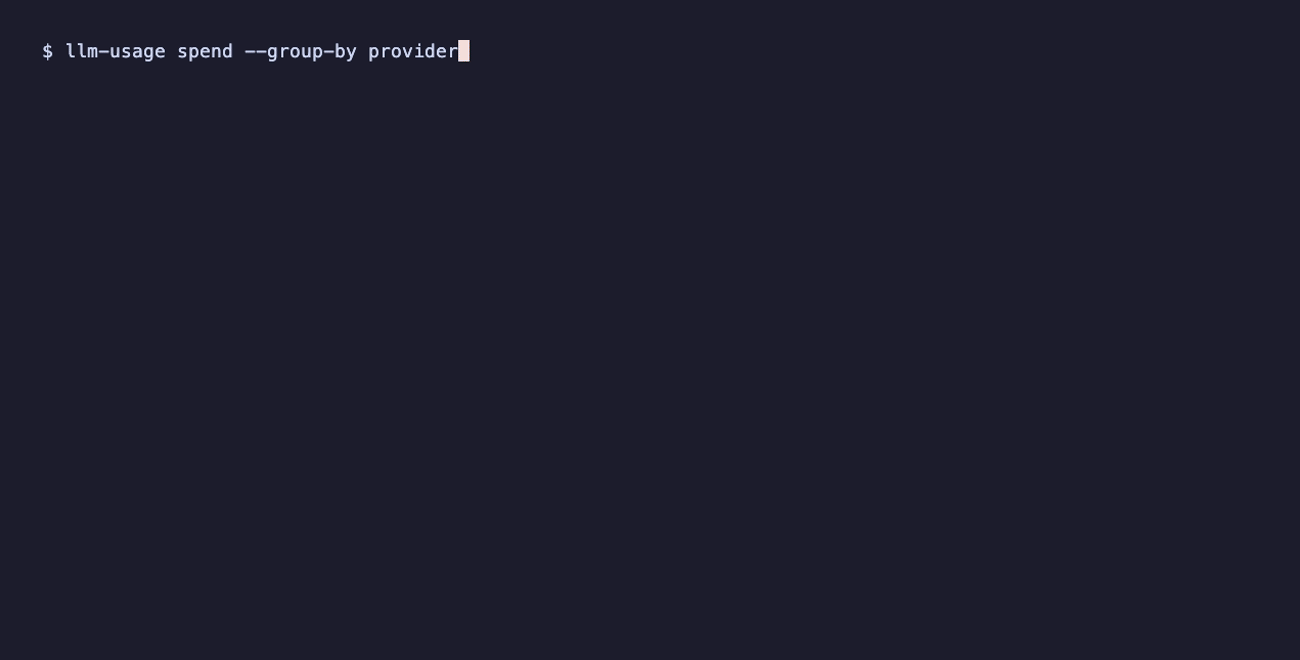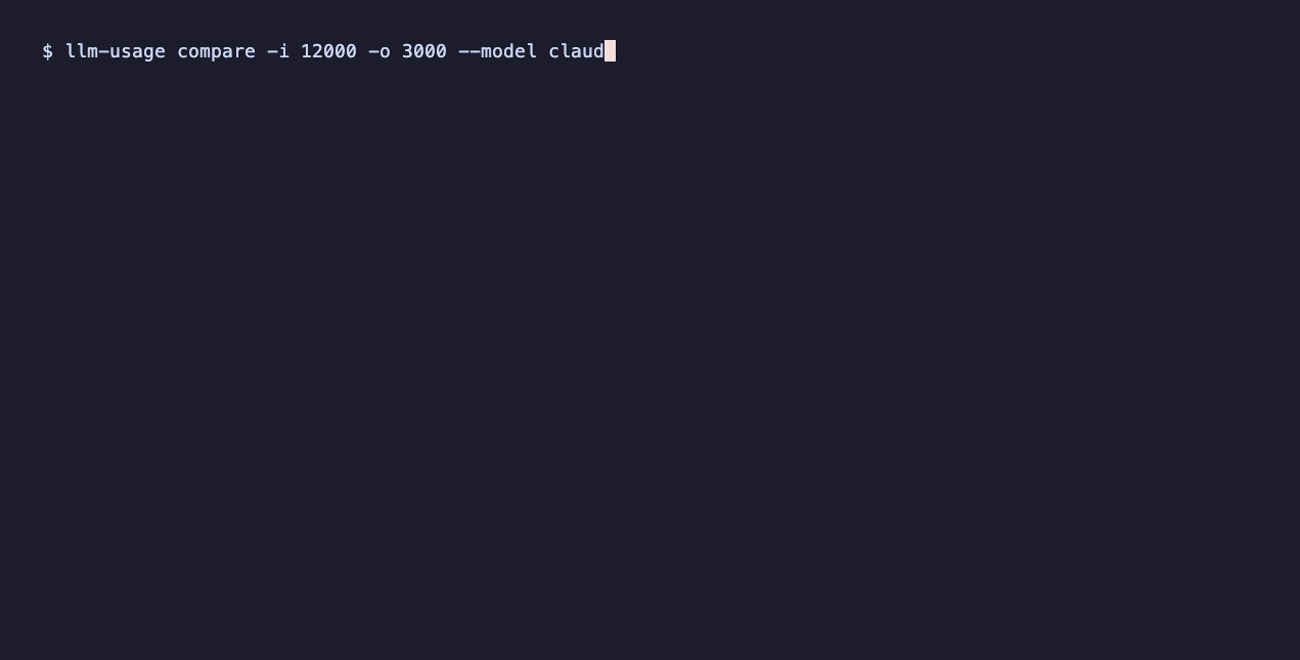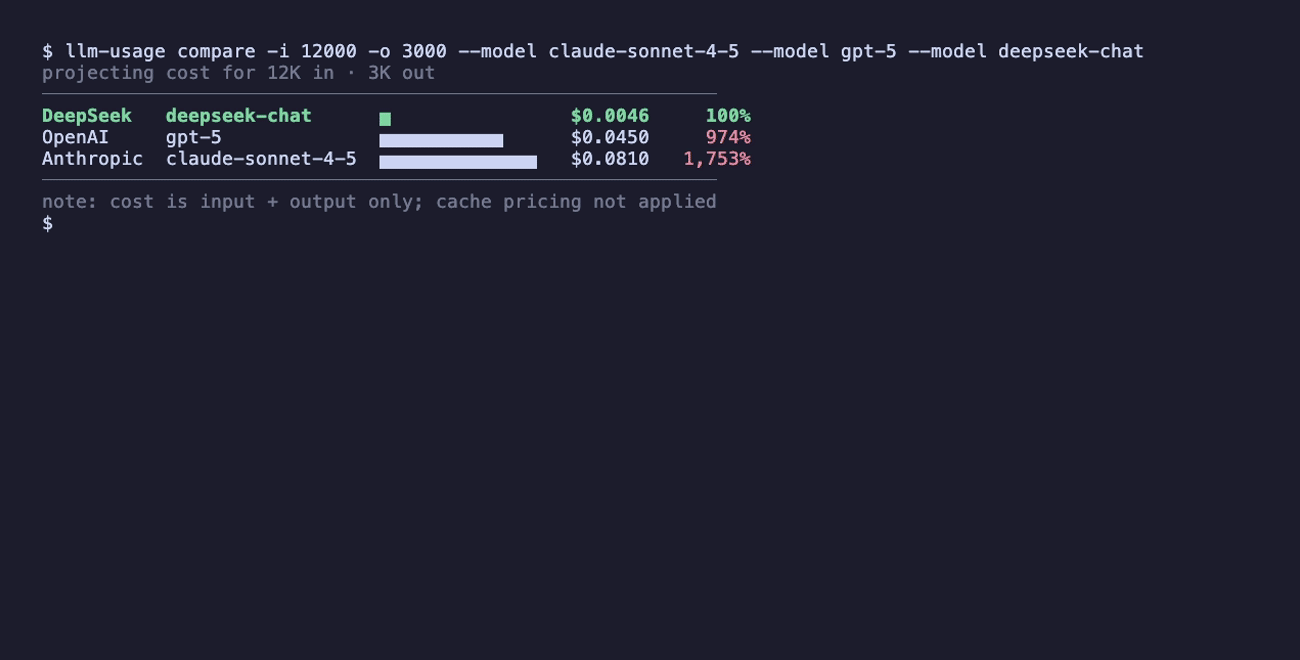
ターミナルから直接確認することもできます。プロバイダー別の今週の支出や、モデルを決める前のプロバイダー間のコスト比較を表示できます。
これが役立つ理由
Claude、GPT に加え、Qwen や DeepSeek のような中国のモデルなど、複数のプロバイダーの LLM を利用しているとします。それぞれの請求は個別のダッシュボードに、独自の通貨と、「キャッシュされたトークン」の料金に関する独自のルールで表示されます。そのため、「いくら使っていて、何に使っているのか?」というごく簡単な質問に答えるだけでも、4 つのブラウザーにログインし、人民元から米ドルへの為替レートを調べ、「キャッシュされたコンテキストトークンの割引」が実際に何を意味するのかを、深夜に計算しながら読み解かなければなりません。多くの人は、月末に請求額を見て驚かないよう祈るだけです。
llm-usage-mcp は、すべての呼び出しを 1 つのローカルストアに記録し、呼び出し時点でプロバイダーごとに正確なコストを計算して、2 つの方法で結果を返します。
- コーディングエージェントに尋ねる。 これは MCP サーバーなので、Claude Code、Cursor、または任意の MCP クライアントに、平易な英語で 「今週、Claude にいくら使った?」 や 「入力 10k/出力 2k の呼び出しでは、どのプロバイダーが最も安い?」 と尋ねられます。
- または、コマンドを入力する。 こちらは CLI でもあるため、エージェントを介したやり取りを避けたいときは、
llm-usage spend、llm-usage compare、llm-usage recommendを実行できます。
そして、作業の邪魔をしません。
- ローカル優先。 SaaS も、サインアップも、テレメトリーもありません。
~/.llm-usage/usage.dbに SQLite ファイルがあるだけです。プライバシーは設定ではなく、機能です。 - 複数プロバイダーに対応し、中国のモデルも含みます。 Anthropic、OpenAI、DeepSeek、Qwen の 4 つすべてで、ストリーミングと非ストリーミングに対応しています。DeepSeek と Qwen も、後付けではなく、Anthropic や OpenAI と同じ記録経路を使います。さらに多くのプロバイダー(Gemini、Bedrock、Moonshot など)にも対応予定です。
クイックスタート
git clone から最初の呼び出しを記録するまで、わずか 2 分です。ここでは記録、つまり呼び出しを記録する方法を説明します。データの確認は次のセクションで説明します。
1. インストール
uv(または pipx)を使って PyPI からインストールします。これにより、3 つのコンソールスクリプトが PATH に追加されます。
uv tool install llm-usage-mcp # or: pipx install llm-usage-mcp
ソースを直接いじりたい場合は、代わりにクローンして同期します。
git clone https://github.com/zhaoyue722/llm-usage-mcp.git
cd llm-usage-mcp
uv sync
どちらの方法でも、3 つのコンソールスクリプトを利用できます。
llm-usage— 複数のコマンドを備えた CLI です。以下のコマンドラインから使用する(CLI)を参照してください。llm-usage-mcp— stdio MCP サーバーです。llm-usage-proxy— 旧バージョンとの互換性を保つための別名です。llm-usage proxyと同じです。
以下のクイックスタートでは
uv run …(ソースから実行するワークフロー)を使います。PyPI からインストールした場合は、スクリプトがすでにPATHに追加されています。uv runの部分を省き、claude mcp add llm-usage -- llm-usage-mcpで MCP サーバーを登録してください。
2. 少なくとも 1 つの API キーを設定する
実際に使用するプロバイダーのキーだけが必要です。プロキシはキーがなくても起動しますが、キーが設定されていないプロバイダーへのリクエストは、ルートごとに 503 configuration_error を返します。
export ANTHROPIC_API_KEY=sk-ant-...
# and/or:
export OPENAI_API_KEY=sk-...
export DEEPSEEK_API_KEY=sk-...
export DASHSCOPE_API_KEY=sk-...   # Qwen
環境変数の詳細については、docs/configuration.mdを参照してください(または .env.example を .env にコピーして値を入力してください)。
3. キャプチャプロキシを実行する
uv run llm-usage-proxy
ループバックのみ(127.0.0.1:5525)にバインドするため、ネットワークからアクセスされることはありません。プロキシが API キーをサーバー側で保持するため、クライアントがキーを持つ必要はありません。
4. コーディングエージェントをプロキシに接続する
プロキシはプロバイダーごとに 1 つのルートを公開します。クライアント側で対応する *_BASE_URL 環境変数を設定してください。
| プロバイダー | クライアントの環境変数 | 値 |
|---|---|---|
| Anthropic | ANTHROPIC_BASE_URL | http://127.0.0.1:5525 |
| OpenAI | OPENAI_BASE_URL | http://127.0.0.1:5525/openai/v1 |
| DeepSeek | DEEPSEEK_BASE_URL(または任意の OpenAI-SDK の base-url オーバーライド) | http://127.0.0.1:5525/deepseek/v1 |
| Qwen | DashScope の OpenAI 互換 base | http://127.0.0.1:5525/qwen/v1 |
例 — プロキシ経由で呼び出しをルーティングして Claude Code を起動します。
ANTHROPIC_BASE_URL=http://127.0.0.1:5525 claude
5. キャプチャを確認する
エージェント経由(またはプロキシを指定した任意のクライアント経由)で呼び出しを行い、記録されたことを確認します。
uv run llm-usage spend
すべての呼び出しは、トークン数、コスト、レイテンシ、冪等性を確保するための request_id とともに ~/.llm-usage/usage.db に記録され、ヘッドラインにも表示されます。これで一連の流れは完了です。一方でキャプチャし、もう一方で回答を受け取ります。
利用料金を確認する
呼び出しがキャプチャされるようになったら、2 つの方法で結果を確認できます。同じデータ、同じ数値なので、そのときに合った方法を選んでください。
コーディングエージェントに尋ねる(MCP)
Claude Code に MCP サーバーを登録します。
claude mcp add llm-usage -- uv --directory $(pwd) run llm-usage-mcp
そのセッション内で、自然な英語で尋ねるだけです。
今日、Anthropic にいくら使いましたか?入力 10k/出力 2k の呼び出しで、最も安いプロバイダーはどれですか?
Claude が適切なツールを選び、数値を読み上げます。stdio 経由で 7 つのツールが公開されます。パラメーターと戻り値の完全な形式については、docs/spec.mdを参照してください。
| ツール | 用途 |
|---|---|
query_spend | 指定期間の合計とグループ別の集計(プロバイダー/モデル/プロジェクト/タグ/日ごと)。 |
usage_summary | today/week/month/year の概要 — 合計、上位 N 件のプロバイダーとモデル、最大コストの呼び出し。 |
compare_providers | 想定するワークロード(入力/出力トークン数)を指定し、価格が設定されたすべてのモデルをコスト順に並べます。 |
recommend_provider | 指定された予算内で利用できる、価格が設定された最安のモデルを選びます。 |
get_pricing | 同梱されている価格スナップショットを確認します。 |
list_providers | プロバイダー、そのモデル、OpenAI 互換フラグを一覧表示します。 |
record_usage | 手動で記録する方法です。キャプチャプロキシを使わない場合に呼び出しを記録します。 |
query_spend と usage_summary は、部分的なストリームの行が合計に影響しないよう、デフォルトで include_failed=false になっています。必要に応じてパラメーターで有効にできます。
コマンドライン(CLI)から
同じ質問に答える CLI です。1 つの llm-usage コンソールの下に 8 つのサブコマンドを用意しており、エージェントに尋ねるより入力したほうが速い場合に使えます。
以下の例では、
llm-usageがPATHに含まれていることを前提としています。source .venv/bin/activateを実行するか、uv tool install .を実行してください。そうでない場合は、各コマンドの前にuv runを付けます(例:uv run llm-usage spend)。
$ llm-usage
 Local-first LLM spend capture + query, exposed over MCP.

 Commands
   proxy      Run the local LLM capture proxy on 127.0.0.1.
   compare    Project the cost of a hypothetical workload across every priced model.
   models     Browse the local pricing catalog.
   recommend  Recommend the cheapest priced model for a workload + budget.
   spend      Show recorded spend over a calendar period.
   status     Snapshot of the local install: DB, proxy, providers, pricing.
   providers  List configured providers with key state, wire-format, model count.
   about      Show version, author, license, and the project homepage.
| コマンド | 答える質問 |
|---|---|
compare | このワークロードでは、どのモデルが最も安いですか? |
models | 100 万トークンあたりの実際の料金はいくらですか? |
recommend | 残り $0.04 です。予算を使い果たさずに済むモデルはどれですか? |
spend | たった今、いくら使いましたか? |
status | すべて正常に動作していますか? |
providers | ローカルでは何が設定されていますか? |
about | これは何ですか? バグはどこに報告すればよいですか? |
proxy | キャプチャプロキシを実行します(llm-usage-proxy と同じです)。 |
すべてのコマンドに共通する規則:
--jsonは、対応する MCP ツールが返すものと同じ Pydantic 形式を出力します。そのままjqに渡せます。--color {auto,always,never}はNO_COLORと TTY の判定に従います。配色は暖色系でコントラストを抑えたダークテーマなので、夜 11 時でも目に優しい設計です。- フィルターフラグ(
--provider、--model)では、プロバイダー名は大文字と小文字を区別せず、モデル名は区別します。許可リストとして機能する場合は、繰り返し指定できます。 --version/-Vはバージョンを出力して終了します。--install-completion {bash|zsh|fish|powershell}はタブ補完スクリプトをインストールします。シェルを一度再起動すれば、すべてのフラグを<Tab>で補完できます。
compare
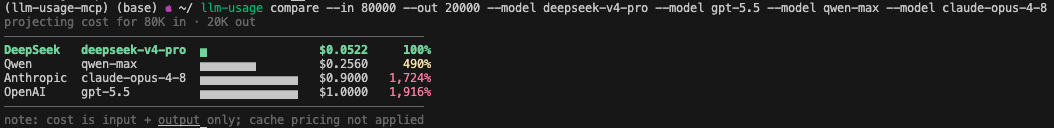
n 個の入力トークンと m 個の出力トークンを使う呼び出しの予測コストに基づいて、料金が設定されたすべてのモデルを順位付けします。最安のモデルが先頭で、最安モデルとのコスト差をパーセントで表示します。デフォルト表示では、モデルファミリーのルートと料金の両方が同じ行をファミリー単位でまとめます。そのため、gpt-5-mini と gpt-5-mini-2025-08-07 は ×2 の付いた 1 行にまとまります。カタログのすべての行を表示するには --all を指定します。
# How does an 8k-in / 2k-out call price out today?
$ llm-usage compare --in 8000 --out 2000

# Just OpenAI's models:
$ llm-usage compare --in 8000 --out 2000 --model gpt-5-mini --model gpt-5-nano

# Same projection, JSON for a script:
$ llm-usage compare --in 8000 --out 2000 --json | jq '.ranked[0]'
models
カタログを閲覧するコマンドです。compare と似ていますが、「自分のワークロードではいくらかかるか?」ではなく、「このモデルの料金はいくらか?」に答えます。100 万トークンあたりの料金を、デフォルトではプロバイダー名のアルファベット順に表示します。--sort input または --sort output に切り替えると、入力または出力のどちらかで最も安いモデルを確認できます。ほとんどのモデルにはキャッシュ料金が設定されておらず、空の列は表示幅を無駄にするため、キャッシュ料金は指定するまで非表示です(--cache)。
# Full catalog, deduped.
$ llm-usage models

# OpenAI's nano models only, with cache rates:
$ llm-usage models --provider openai --match nano --cache

# Cheapest input rate first — quick "what's the floor right now?":
$ llm-usage models --sort input
recommend
モデルを 1 つ選びます。--provider、--model、--budget で絞り込み、条件に合うモデルのうち最も安いものと、次点の 2 つを返します。説明文には、どのような前提を置き、何を選んだかが示されるため、盲目的に信頼せず妥当性を確認できます。
# Cheapest priced model, full stop.
$ llm-usage recommend

# Anything Anthropic that fits under one cent for a 1k/1k call:
$ llm-usage recommend --provider anthropic --budget 0.01

# Of these three specific candidates, which wins?
$ llm-usage recommend --model gpt-5-mini --model claude-sonnet-4-6 --model qwen-max
v1 ではコストのみで順位付けします。--task は省略可能で、説明文に表示されますが、選択には影響しません(このツールは LLM ではないため、自由記述を解釈できません)。
spend
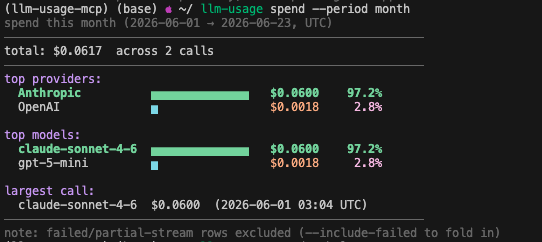
SQLite を読み取ります。デフォルト表示は usage_summary の概要で、合計金額、利用額上位 3 プロバイダー、利用額上位 3 モデル、最も高額な単一の呼び出しを表示します。--group-by を指定すると、集計表示に切り替わります。
# Headline for this week.
$ llm-usage spend

# This month grouped by model, JSON for a dashboard:
$ llm-usage spend --period month --group-by model --json | jq

# Spend on a specific project tag, day-by-day:
$ llm-usage spend --group-by day --project my-side-thing
期間の境界は UTC の暦に基づきます。today は UTC 00:00 以降、week は月曜日以降、month は月初以降、year は 1 月 1 日以降です。失敗した行やストリームが途中で終了した行は、デフォルトでは除外されます。含めるには --include-failed を指定します。
status
1 画面に 4 つのセクションを表示します。データベース、キャプチャプロキシ、プロバイダー、料金です。「すべて正常に動作していますか?」を確認するコマンドです。読み取り専用のため、プロキシや MCP サーバーを一度も起動していない新規インストール環境で実行すると、ファイルを黙って作成せずに database not initialized と表示します。
$ llm-usage status

# Skip the network probe (offline, CI, slow link):
$ llm-usage status --no-net

# Machine-readable for a healthcheck script:
$ llm-usage status --json
providers
プロバイダーごとの設定ビューです。status の Providers ブロックよりも詳細で、ワイヤ形式のフラグ(openai-compat: yes/no)と、各プロバイダーの価格設定済みモデルをすべて列挙する任意の --models 展開が追加されます。
$ llm-usage providers
$ llm-usage providers --models   # expand each provider with its model list
about
最初に表示されるパネルです。バージョン、作成者、ライセンス、プロジェクトのホームページが表示されます。--version に対応する、人向けの情報です。各項目はインストール済みパッケージのメタデータから読み取られるため、PyPI に表示される内容と一致します。
$ llm-usage about

# Machine-readable, for a script or an issue template:
$ llm-usage about --json
対応プロバイダー
| プロバイダー | 認証 | 非ストリーミング | ストリーミング | キャッシュ料金 |
|---|---|---|---|---|
| Anthropic | x-api-key | はい | はい | cache_creation + cache_read |
| OpenAI | Bearer | はい | はい | ネストされた prompt_tokens_details.cached_tokens |
| DeepSeek | Bearer | はい | はい | prompt_cache_hit_tokens / _miss_tokens |
| Qwen(DashScope) | Bearer | はい | はい | OpenAI 互換エンドポイントでは通常省略されます |
今後さらに追加予定です。 Google Gemini、AWS Bedrock、Moonshot(Kimi)、Zhipu GLM、MiniMax などは、docs/post_v1_providers.md で計画されています。
料金情報の取得元。 料金情報は、LiteLLM の料金 JSON を必要な部分に絞って取り込んだスナップショットで、GitHub Actions(refresh-pricing.yml)により毎週更新されます。LiteLLM にまだ掲載されていないモデルは、pricing_overrides.json を使ってローカルで補完されます。
設定
設定はすべて環境変数(またはリポジトリのルートにある .env ファイル)で行います。デフォルト値は適切に設定されているため、プロキシの起動に必須の設定はありません。詳細なリファレンスは docs/configuration.md をご覧ください。特に変更する可能性が高い設定は次の3つです。
| 変数 | デフォルト値 | 用途 |
|---|---|---|
LLM_USAGE_DB_URL | sqlite:///$HOME/.llm-usage/usage.db | ローカルデータベースの保存場所です。 |
LLM_USAGE_PROXY_PORT | 5525 | キャプチャプロキシのポート(ループバックのみ)です。 |
LLM_USAGE_<PROVIDER>_BASE_URL | 各プロバイダーの公式エンドポイント | プロバイダーの接続先をリバースプロキシ/ゲートウェイに変更します。ネットワークが制限された地域で便利です。 |
Docker
最小構成の Dockerfile が含まれていますが、これは Glama などの自動 MCP レジストリ検証専用です。パッケージ化されたサーバーが起動し、MCP のイントロスペクションに応答することを検証します。サーバーの実行には、引き続きローカルで uvx llm-usage-mcp を使う方法を推奨します。これはローカル優先のツールであり、ホスト型サービスではありません。
ライセンス
MIT。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。