MCP Client for Ollama (ollmcp) について
ollmcp は、ローカルの Ollama LLM を1つ以上の MCP サーバーに接続する、ターミナル(TUI)向けの Python クライアントです。コマンドラインから MCP サーバーとモデルを管理したいユーザー向けで、エージェントモードとツール実行前の人による承認に対応しています。
主な機能
- 01エージェントモードでの反復的なツール実行
- 02複数の MCP サーバーへの同時接続
- 03STDIO、SSE、Streamable HTTP のトランスポート対応
- 04MCP ツール、プロンプト、リソースの参照と呼び出し
- 05ツール実行前の人による承認(HIL)
- 06実行中のモデル切り替えと設定可能なモデルパラメーター
活用シーン
- 01ローカルの Ollama モデルからターミナル上で MCP ツールを呼び出す
- 02コマンドラインでの MCP サーバー設定の追加と管理
- 03開発中の MCP サーバーのデバッグとホットリロード
MCP 対応
本プロジェクトは MCP クライアントであり、ローカルの MCP サーバーに接続してツール、プロンプト、リソースを検出・呼び出します。また、ollmcp mcp add コマンドでサーバー設定を管理します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細

Ollama を使用して Model Context Protocol(MCP)サーバーと対話できる、シンプルながら強力な Python クライアントです。ローカル LLM を活用し、高度なツール実行を実現します。
Ollama 向け MCP クライアント(ollmcp)


スポンサー

スポンサーセクションで、Atlas Cloud を ollmcp と一緒に使用する方法をご覧ください
- 概要
- 機能
- 要件
- クイックスタート
- インストール方法
- トラブルシューティング
- ✨NEW CLI による MCP サーバーの管理
- 対話型コマンド
- 自動補完とプロンプト機能
- 設定の管理
- ✨NEW プロバイダーごとのプロファイル
- サーバー設定形式
- 対応モデル
- ✨NEW スポンサー
- ほかの MCP サーバーを探す
- 関連プロジェクト
- セキュリティ
- ライセンス
- 謝辞
概要
MCP Client for Ollama(ollmcp)は、ハーネスエンジニアリング向けに構築された最新の対話型ターミナルアプリケーション(TUI)です。ローカルの Ollama LLM を 1 つ以上の Model Context Protocol(MCP)サーバーに接続します。MCP の主要なプリミティブ(ツール、プロンプト、リソース)を完全にサポートし、ユーザーが操作を指示し、エージェントが実行する、管理されたターミナル環境を提供します。使いやすい豊富なインターフェースを備え、コーディング不要でセットアップをリアルタイムに安全に管理できます。構築、テスト、探索のいずれの場合も、ファジー自動補完、高度なモデル設定、迅速な開発のための MCP サーバーのホットリロード、厳格な Human-in-the-Loop の安全制御といった機能により、ワークフローを効率化します。
特長
- 🤖 エージェントモード:モデルが複数のツール呼び出しを要求した場合、ツールを反復実行します。ループ上限を設定でき、上限に達すると、続行、まとめる、中止のいずれかを選択できます
- 🌐 マルチサーバー対応:複数の MCP サーバーに同時に接続できます
- 🚀 複数のトランスポートタイプ:STDIO、SSE、Streamable HTTP によるサーバー接続に対応しています
- 📋 MCP プロンプト対応:引数の収集、プレビュー、安全なロールバックを備え、MCP サーバーのプロンプトを参照、実行、管理できます
- 📦 MCP リソース対応:ファイル、ドキュメント、構造化データなど、MCP サーバーのコンテキストデータを参照および読み取ることができます
- ☁️ Ollama Cloud 対応:ツール呼び出しに Ollama Cloud モデルをシームレスに利用でき、ローカルの MCP ツールを使いながら、強力なクラウドホスト型モデルにアクセスできます
- 🌍 複数の LLM プロバイダー:Ollama(デフォルト)または OpenAI 互換プロバイダー(OpenAI、OpenRouter、DeepSeek など)を利用でき、接続設定はプロバイダーごとに保持されます
- 🎨 リッチなターミナルインターフェース:モダンなスタイルのインタラクティブなコンソール UI
- 🌊 ストリーミング応答:生成中のモデル出力をリアルタイムで表示します
- 📝 回答表示モード:ストリーミング中に、プレーン、Markdown、両方、Markdown(ブロック)の各応答表示を切り替えられます
- 🛠️ ツール管理:チャットセッション中に、特定のツールやサーバー全体を有効または無効にできます
- 🧑💻 Human-in-the-Loop(HIL):ツールの実行前に確認して承認できるため、制御と安全性が向上します
- 🎮 高度なモデル設定:コンテキストウィンドウサイズ、温度、サンプリング、反復制御など、15 以上のモデルパラメーターを微調整できます
- 💬 システムプロンプトのカスタマイズ:システムプロンプトを定義および編集して、モデルの動作やペルソナを制御できます
- 🧠 コンテキストウィンドウの制御:コンテキストウィンドウサイズ(num_ctx)を調整し、長い会話や複雑なタスクに対応できます
- 🎨 ツール表示の強化:ツールの実行内容を、JSON の構文ハイライト付きで見やすく構造化して表示します
- 🧠 コンテキスト管理:保持設定を調整して、会話のメモリを制御できます
- 🤔 思考モード:対応モデル(例:gpt-oss、deepseek-r1、qwen3 など)で、思考過程を表示する高度な推論機能を利用できます
- 💪 推論の労力レベル:対応モデルでは、推論の労力を auto、minimal、low、medium、high、xhigh に設定できます
- 🖼️ ビジョンツール対応:ツールから返された画像は、ビジョン対応モデルに自動的に転送されます
- 🗣️ クロス言語対応:Python と JavaScript の MCP サーバーをシームレスに利用できます
- 📜 履歴管理:会話履歴全体の表示、バックアップや分析用の JSON へのエクスポート、以前のセッションのインポートによる継続が可能です
- 🔍 自動検出:Claude の既存の MCP サーバー設定を自動的に検出して利用します
- 🔁 動的なモデル切り替え:再起動せずに、インストール済みの任意の Ollama モデルに切り替えられます
- 💾 設定の永続化:セッション間でツールの設定やモデル設定を保存および読み込みできます
- 🔄 サーバーの再読み込み:クライアントを再起動せずに、開発中の MCP サーバーをホットリロードできます
- ✨ あいまい検索オートコンプリート:説明付きのインタラクティブな矢印キー操作によるコマンド補完
- 🏷️ 動的プロンプト:現在のモデル、思考モード、有効なツールを表示します
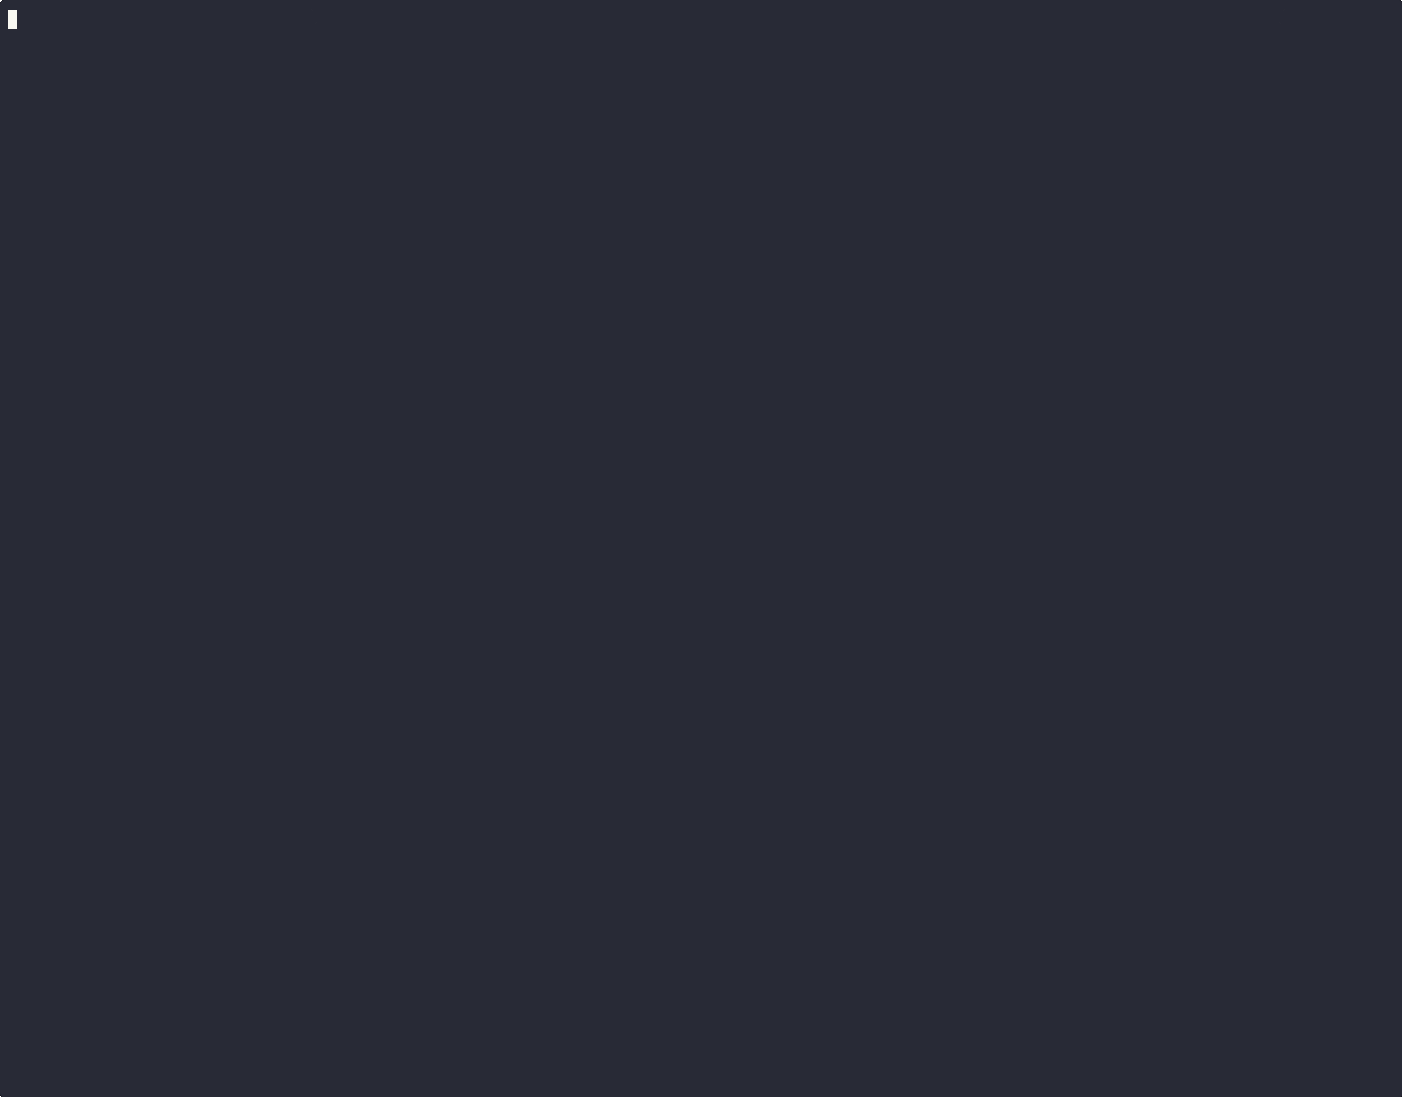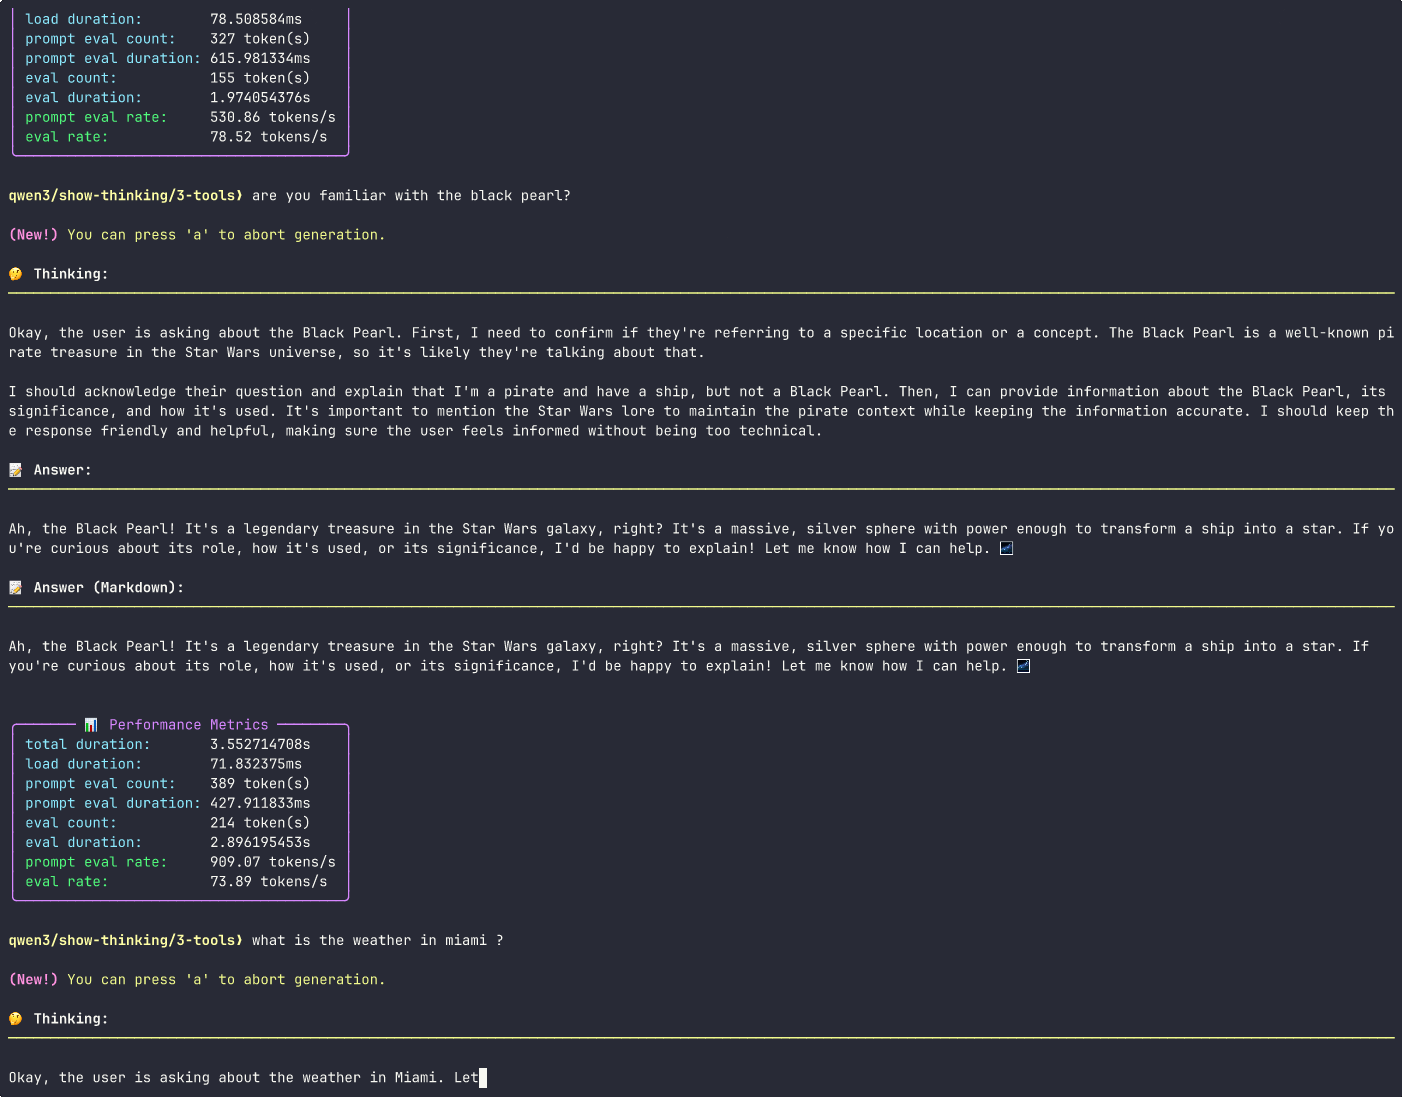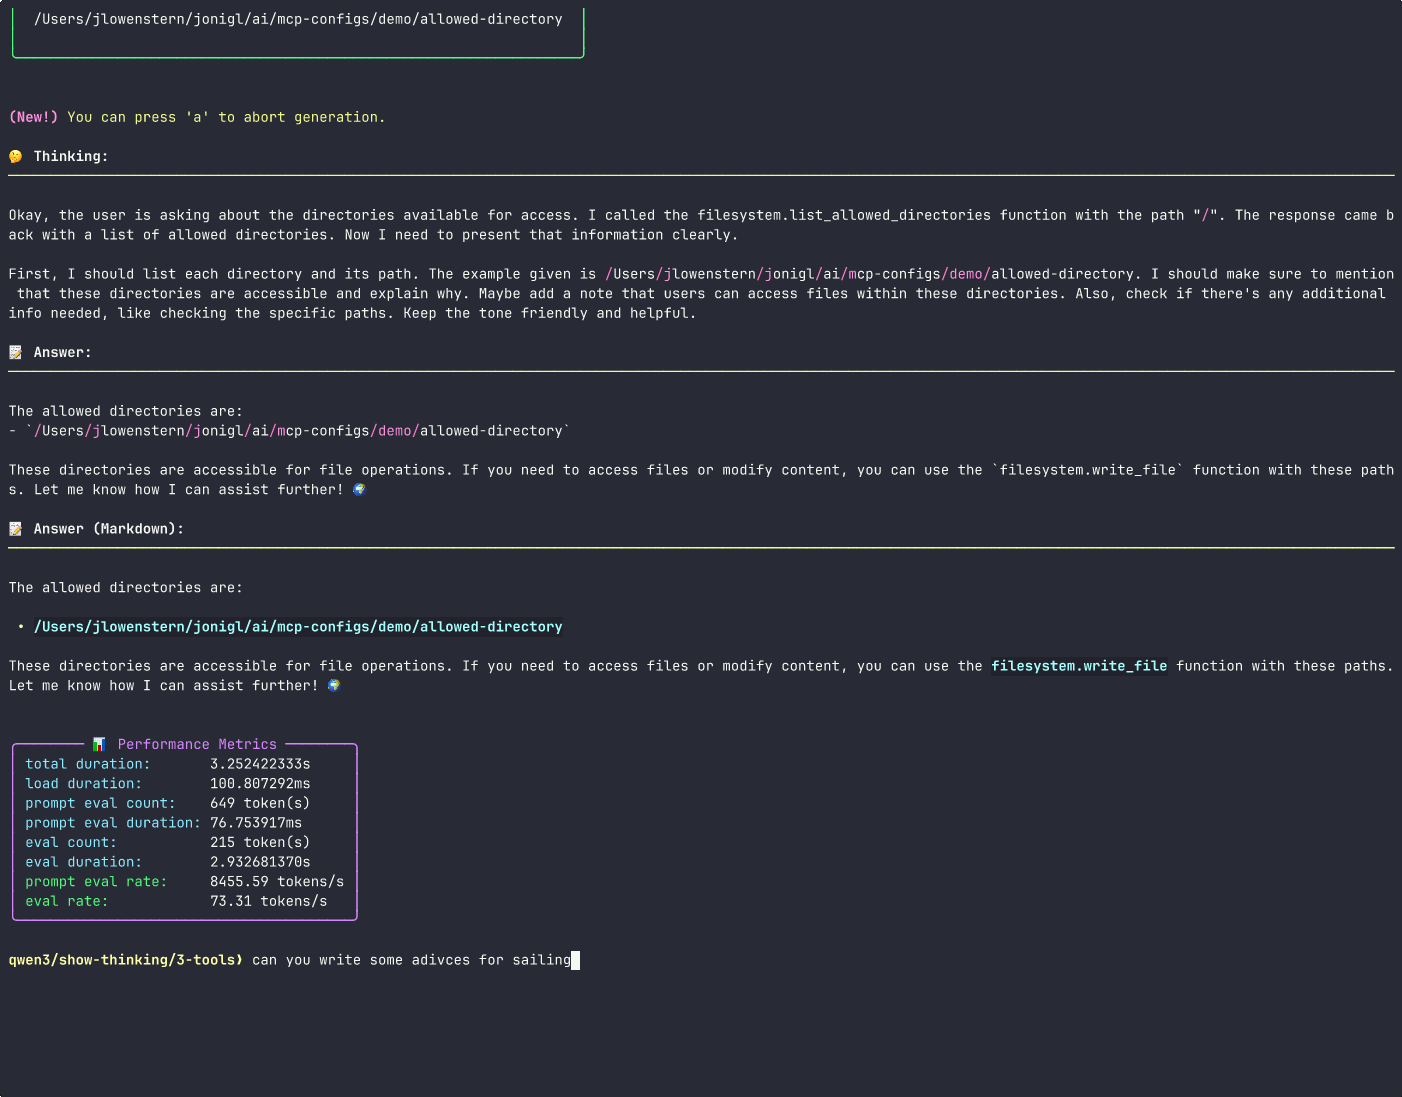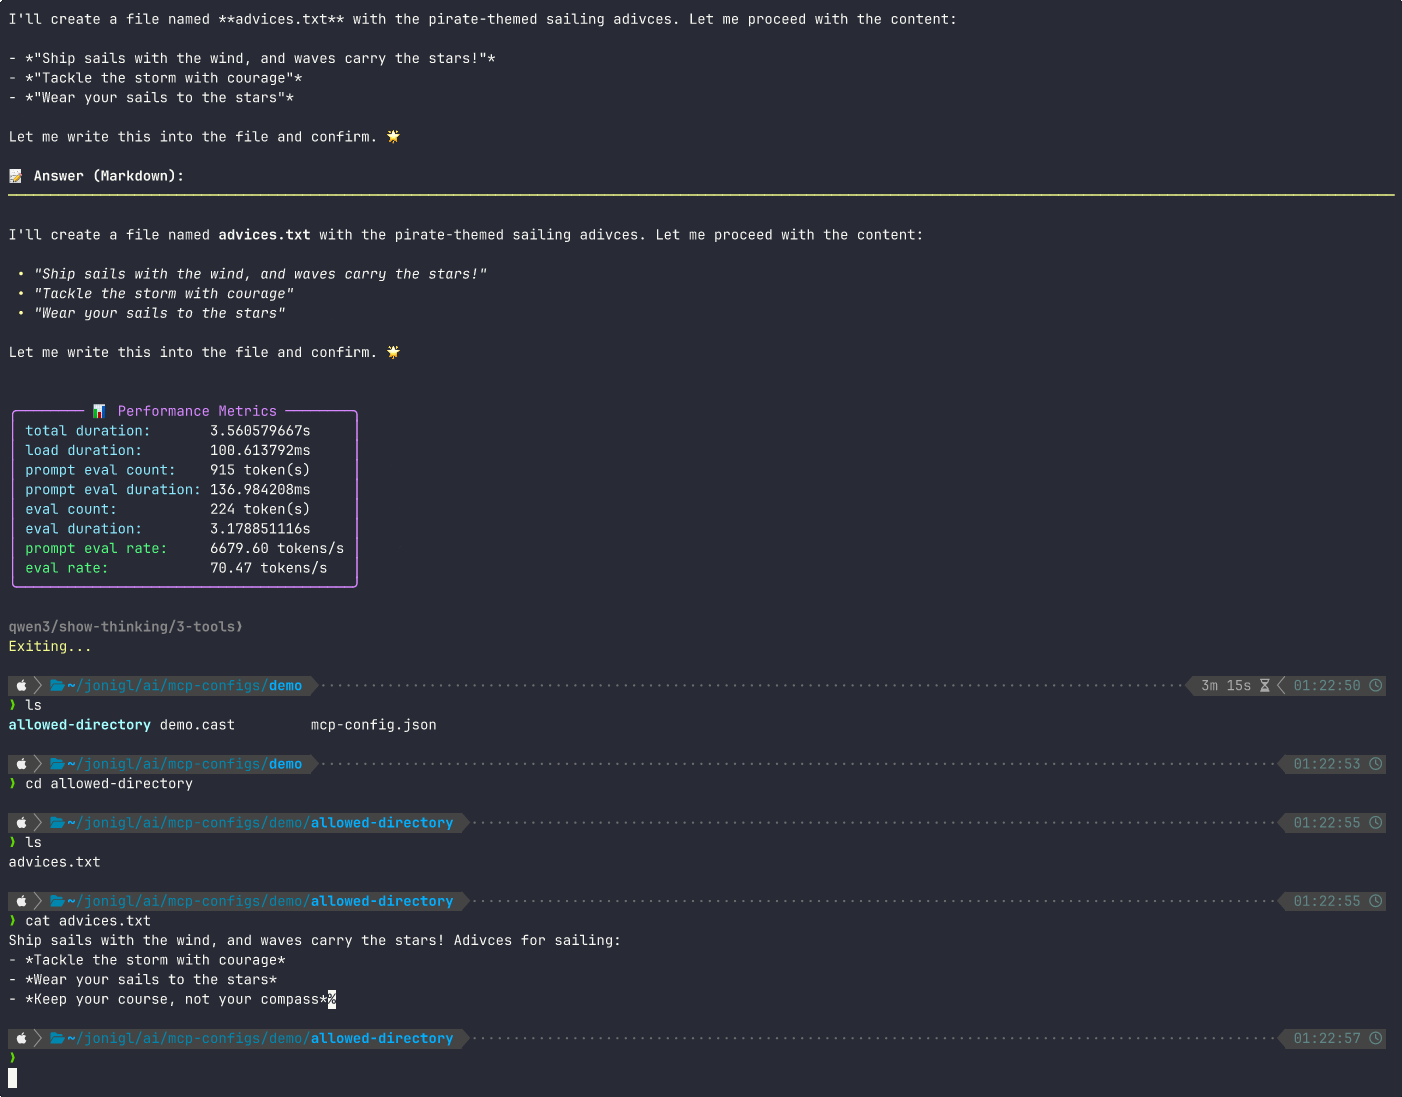
- 📊 パフォーマンス指標:各クエリの後に、所要時間やトークン数など、モデルの詳細なパフォーマンスデータを表示します
- 🔌 プラグアンドプレイ:標準的な MCP 準拠のツールサーバーですぐに利用できます
- 🔔 更新通知:新しいバージョンが利用可能になると自動的に検出します
- 🖥️ Typer によるモダンな CLI:グループ化されたオプション、シェルのオートコンプリート、改善されたヘルプ出力を提供します
- ⏹️ 生成の中止:応答のストリーミング中に「a」を押すと、いつでもモデルの生成を中止できます
要件
- Python 3.11+ (インストールガイド)
- Ollama がローカルで実行されていること(インストールガイド)
- インストール後、
ollama listを実行すると、利用可能なモデルを確認できます。モデルがインストールされていない場合は、ollama pull <model_name>を使って取得できます。例:ollama pull gemma4:latest。
- インストール後、
- UV パッケージマネージャー(インストールガイド)
クイックスタート
ollmcp を pip でインストールし、MCP サーバーを追加して、クライアントを実行します。
# Install ollmcp via uv
uv tool install --upgrade ollmcp
# or via pip
pip install --upgrade ollmcp
# Add an MCP server (example: playwright stdio server)
ollmcp mcp add playwright -- npx @playwright/mcp@latest
# Run the client (check optional flags with `ollmcp --help`)
ollmcp # once running, use /help for interactive commands
インストール方法
方法 1: uv でインストールして実行(推奨)
uv tool install --upgrade ollmcp
ollmcp
方法 2: pip でインストールして実行
pip install --upgrade ollmcp
ollmcp
方法 3: インストールせずに実行(uv パッケージマネージャーが必要)
uvx ollmcp
方法 4: ソースからインストールし、仮想環境を使って実行
git clone https://github.com/jonigl/mcp-client-for-ollama.git
cd mcp-client-for-ollama
uv run -m mcp_client_for_ollama
トラブルシューティング
Could not find a version that satisfies the requirement ollmcp (from versions: none)
これはほぼ間違いなく、使用している Python が必要なバージョンの 3.11+ より古いことを意味します。これは macOS でよくある問題で、システムの Python(/usr/bin/python3)や Xcode に同梱された Python が 3.9 以前の場合があります。requires-python >= 3.11 を満たすリリースがない場合、pip はすべてのバージョンを除外し、誤解を招く「from versions: none」というメッセージを表示します。
まず、バージョンを確認します。
python3 --version # must be 3.11 or newer
次に、新しい Python を使ってインストールします。最も簡単な方法は uv です。適切な Python を自動的に取得してくれます。
uv tool install --upgrade ollmcp   # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, make sure to use a Python 3.11+ interpreter:
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
インストール方法を確認してください。
error: externally-managed-environment(PEP 668)
最近の Debian/Ubuntu(Python 3.12+)では、OS が管理するパッケージを保護するため、システムの pip は意図的にロックされています。そのため、pip install ollmcp はブロックされます。これはシステムポリシー(PEP 668)によるもので、ollmcp の問題ではありません。代わりに、分離された環境にインストールしてください。
uv tool install --upgrade ollmcp   # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, use a virtual environment:
python3.11 -m venv ollmcp-env
source ollmcp-env/bin/activate
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
インストール方法を確認してください。
警告
pip install --break-system-packages ollmcpは避けてください。実行はできますが、システムの Python にインストールされ、OS が依存するパッケージを壊す可能性があります。
CLI での MCP サーバーの管理
ollmcp では、claude mcp と同様に、コマンドラインから独自の MCP サーバー設定を直接管理できます。
# Remote servers (Streamable HTTP or SSE)
ollmcp mcp add --transport http <name> <url>
ollmcp mcp add --transport sse <name> <url>

# Local stdio servers - everything after `--` is the command to run
ollmcp mcp add [options] <name> -- <command> [args...]

# List configured servers
ollmcp mcp list

# Remove a server
ollmcp mcp remove <name>

# For more details on options and usage, run:
ollmcp mcp --help
ollmcp mcp add --help
例:
ヒント
サーバーを追加したら、
ollmcpを実行するだけで自動的に接続されます。
ollmcp mcp add --transport http github https://api.githubcopilot.com/mcp/ --header "Authorization: Bearer $YOUR_GITHUB_PAT"
ollmcp mcp add --transport stdio playwright npx @playwright/mcp@latest
ollmcp mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem /allowed-dir1 ~/allowed-dir2 # stdio transport by default
ollmcp mcp add --env API_KEY=YOUR_KEY --transport sse my-sse-server http://localhost:8000/sse
mcp add のオプション
--transport、-t:stdio(デフォルト)、sse、またはhttp。--header、-H:sse/httpサーバー用の HTTP ヘッダー("Name: Value")。複数指定できます。--env、-e:stdioサーバー用の環境変数(KEY=value)。複数指定できます。--scope、-s:サーバーの保存先(以下のスコープを参照)。デフォルトはlocalです。
スコープ
| スコープ | 読み込まれる対象 | チームとの共有 | 保存先 |
|---|---|---|---|
local | 現在のプロジェクトのみ | いいえ | ~/.config/ollmcp/mcp.local.json(プロジェクトパスをキーとして保存) |
project | 現在のプロジェクトのみ | はい(VCS 経由) | プロジェクトルートの .mcp.json |
user | すべてのプロジェクト | いいえ | ~/.config/ollmcp/mcp.json |
project スコープでは、プロジェクトルートに標準の .mcp.json ファイルが書き込まれます。このファイルは Claude Code やその他の MCP 対応ツールと互換性があります。同じサーバー名が複数のスコープに存在する場合、優先順位は local > project > user です。
メモ
ollmcp mcp addで追加されたサーバーは、常にベースレイヤーとして読み込まれます。任意のフラグ(--mcp-server、--mcp-server-url、--servers-json、--claude-desktop)はその上に追加されます。Claude Desktop のサーバーを含めるには、--claude-desktopを明示的に指定してください。同じ名前のサーバーがこれらのフラグのいずれかでも指定されている場合、現在は両方の接続が開かれますが、その名前でアクティブになるのは一方だけです。レジストリ上のサーバー名を
--mcp-server/--mcp-server-url/--servers-json/--claude-desktopで再利用しないでください。
コマンドライン引数
ヒント
CLI はモダンな操作性を実現するため、
Typerを採用しました。オプションのグループ化、見やすいヘルプ、組み込みのシェル自動補完を利用できます。上級者は短いフラグを使ってコマンドを素早く実行できます。自動補完を有効にするには、次を実行してください。ollmcp --install-completionその後、シェルを再起動するか、表示される手順に従ってください。
MCP サーバーの設定:
--mcp-server、-s:1 つ以上の MCP サーバースクリプト(.py または .js)へのパスです。複数回指定できます。--mcp-server-url、-u:1 つ以上の SSE または Streamable HTTP MCP サーバーの URL です。複数回指定できます。一般的なエンドポイントについては、一般的な MCP エンドポイントパスを参照してください。--servers-json、-j:サーバー設定を記述した JSON ファイルへのパスです。詳しくは、サーバー設定の形式を参照してください。--claude-desktop:Claude Desktop の設定ファイル(~/Library/Application Support/Claude/claude_desktop_config.json)からサーバーを読み込みます。ollmcp mcp addで追加したサーバーや、ほかのフラグで指定したサーバーと統合されます。
重要
破壊的変更:
--auto-discovery/-aは--claude-desktopに置き換えられました。また、ollmcp mcp addで追加したサーバーは常に自動で読み込まれるようになりました。ほかのフラグを使用すると読み込まれなくなるフォールバックではなくなりました。Claude Desktop のサーバーが自動で読み込まれることはありません。読み込むには--claude-desktopを使用してください。
推論プロバイダーの設定:
--model、-mMODEL:使用するモデルです。デフォルトは、保存済みの設定でモデルが指定されている場合はそのモデル、指定されていない場合は Ollama で利用できる最初のモデルです。--provider、-pPROVIDER:使用する LLM プロバイダーです(例:ollama、openai、atlascloud、openrouter、deepseek)。デフォルトはollamaです。--host、-HHOST:LLM ホスト/API ベース URL です。ollamaプロバイダーではデフォルトで Ollama のhttp://localhost:11434が、それ以外ではプロバイダー独自のデフォルトエンドポイントが使用されます。--api-key、-kKEY:LLM プロバイダーの API キーです。$OLLMCP_API_KEY環境変数からも読み込まれます。この環境変数はプロバイダーに依存せず、--providerで選択したプロバイダーに適用されます。$OLLMCP_API_KEYで渡したキーが設定ファイルに書き込まれることはありません。保存されるのは--api-keyで渡したキーのみです。ollamaでは不要です。
メモ
現在サポートされているプロバイダーは、
ollama、openai、atlascloudと、OpenAI 互換のプロバイダー(openrouter、deepseek、perplexityなど)です。今後、さらに多くのプロバイダーに対応する予定です。
一般的なオプション:
--version、-v:バージョンを表示して終了します--help、-h:ヘルプメッセージを表示して終了します--install-completion:クライアント用のシェル自動補完スクリプトをインストールします--show-completion:利用可能なシェル補完オプションを表示します
MCP サーバーのログ記録:
MCP サーバーが出力した内容は、実行ごとに作成されるディレクトリ ~/.config/ollmcp/logs/<session>/<server>.log に書き込まれ、直近の5回分が保持されます。サーバーが出力した内容は、明示的に表示するよう指定しない限り画面には表示されません。表示すると、ストリーミング中の回答に重なってしまうためです。
サーバーは2つの経路で情報を出力します。stderr(stdio サーバーのみ。リモートサーバーは別の場所で実行されるため)と、MCP ログ通知(すべてのサーバー)です。どちらのフラグも画面に表示する内容だけを変更します。ログファイルには、いずれの場合もすべて記録されます:
| ログファイルへの書き込み | 画面への表示 | |
|---|---|---|
| (フラグなし) | サーバーが送信するすべての内容 | サーバーからの内容は表示しない |
--debug | サーバーが送信するすべての内容 | 到着した内容をすべて表示 |
--log-level LEVEL | サーバーが送信するすべての内容 | LEVEL 以上の通知のみ |
--debug --log-level LEVEL | サーバーが送信するすべての内容 | stderr をすべて表示+LEVEL 以上の通知 |
LEVEL は debug、info、notice、warning、error、critical、alert、emergency のいずれかです。
フラグを指定しない場合、ログレベルは一切要求されません。サーバーが出力内容を決定し、そのすべてが記録されます。--log-level は画面に表示する内容を絞り込むとともに、ログ機能を備えていることを通知するサーバーには logging/setLevel として送信されます。そのようなサーバーは低いレベルの出力を停止する場合があり、その場合はログファイルにも記録されません。この機能を備えていないサーバーはすべての内容を送信し、ここで絞り込みが行われます。
サーバーへの接続に失敗すると、エラーメッセージにログファイルの場所が示されます。終了するまでにサーバーが出力した内容はすべてそこに記録されており、たいていはそれが本当の原因です。
メモ
ollmcp 自体の出力は、サーバーのログファイルと同じ場所にある
~/.config/ollmcp/logs/<session>/ollmcp.logに書き込まれます。毎回の実行で記録されるため、--debugは不要です。また、応答ストリームが途中で終了したときに画面に表示される警告が示すファイルです。現在も作業中です。現時点では主にプロバイダーとストリーミングのエラーが記録されており、今後さらに多くの内容が記録される予定です。
対応している推論プロバイダー
警告
Ollama 以外のプロバイダーは実験的です。 Ollama 以外のプロバイダーへの対応は最近追加されたばかりで、現在も安定化を進めています。まだ正常に動作しない機能がある可能性があります。
ollmcp は Ollama と、any-llm が公開するあらゆる OpenAI 互換プロバイダーで動作します。--provider で選択してください。キーは --api-key または $OLLMCP_API_KEY(選択したすべてのプロバイダーで利用可能)、あるいは以下に示すプロバイダー固有の環境変数で指定してください。$OLLMCP_API_KEY とプロバイダー固有の環境変数はディスクに書き込まれません。設定ファイルに保存されるのは、--api-key で渡されたキーだけです。
プロバイダー(--provider) | API キーの環境変数 |
|---|---|
ollama(デフォルト) | -(ローカル) |
atlascloud | ATLASCLOUD_API_KEY |
azureopenai | AZURE_OPENAI_API_KEY |
dashscope | DASHSCOPE_API_KEY |
databricks | DATABRICKS_TOKEN |
deepinfra | DEEPINFRA_API_KEY |
deepseek | DEEPSEEK_API_KEY |
fireworks | FIREWORKS_API_KEY |
gateway | GATEWAY_API_KEY |
inception | INCEPTION_API_KEY |
llama | LLAMA_API_KEY |
llamacpp | -(ローカル) |
llamafile | -(ローカル) |
lmstudio | LM_STUDIO_API_KEY |
minimax | MINIMAX_API_KEY |
moonshot | MOONSHOT_API_KEY |
mzai | ANY_LLM_KEY |
nebius | NEBIUS_API_KEY |
openai | OPENAI_API_KEY |
openrouter | OPENROUTER_API_KEY |
perplexity | PERPLEXITY_API_KEY |
portkey | PORTKEY_API_KEY |
qiniu | QINIU_API_KEY |
sambanova | SAMBANOVA_API_KEY |
vllm | VLLM_API_KEY |
zai | ZAI_API_KEY |
メモ
ローカルの OpenAI 互換サーバー(
ollama、llamacpp、llamafile、lmstudio、vllm)は通常、API キーなしで動作します。--hostを使って ollmcp の接続先を指定してください。any-llm が提供する OpenAI 互換ではないプロバイダー(例:anthropic、gemini、mistral、groq、cohere)には、まだ対応していません。
警告
機能検出の制限: ollmcp が Ollama から読み取るのは、モデルごとの実際の機能(
tools、vision、thinking)のみです。Ollama 以外のすべてのプロバイダーでは、現時点でこれら3つの機能がすべて利用可能と仮定され、モデル一覧やバッジにそのように表示されます。そのため、実際には対応していないモデルが、ツール、ビジョン、または思考に対応していると表示される場合があります。モデルが機能に対応していない場合、その機能を使おうとするとプロバイダーの API がエラーを返します。
API キーの解決順序
選択したプロバイダーについて、ollmcp は優先順位の高いものから低いものへ、次の順序で API キーを解決します。
--api-key/-kフラグ。$OLLMCP_API_KEY環境変数(プロバイダーに依存せず、--providerで選択したプロバイダーに適用されます)。~/.config/ollmcp/config.jsonに保存されたプロバイダーごとのキー(--api-keyを使って一度渡された場合にのみ存在します)。- any-llm によって検出される、プロバイダー固有のネイティブ環境変数(例:
OPENAI_API_KEY、OPENROUTER_API_KEY)。
警告
保存されたプロバイダーごとのキー(3)は、プロバイダー固有のネイティブ環境変数(4)より優先されます。そのため、以前に誤ったキーや期限切れのキーを保存していた場合、
OPENAI_API_KEY(または同等の環境変数)を設定するだけでは上書きされません。修正するには、--api-keyで正しいキーを渡すか、~/.config/ollmcp/config.json内のそのプロバイダーのプロファイルから古いapiKeyを削除してください。
使用例
クライアントを実行する最も簡単な方法:
ollmcp
ヒント
これにより、
ollmcp mcp addで登録したすべてのサーバーに接続し、保存済みの設定ファイルにあるモデルを使用します。設定されていない場合は、Ollama で最初に利用可能なモデルを使用します。Claude Desktop の設定にあるサーバーも含めるには、--claude-desktopを渡してください。
単一のサーバーに接続する:
ollmcp --mcp-server /path/to/weather.py --model llama3.2:3b
# Or using short flags:
ollmcp -s /path/to/weather.py -m llama3.2:3b
複数のサーバーに接続する:
ollmcp --mcp-server /path/to/weather.py --mcp-server /path/to/filesystem.js
# Or using short flags:
ollmcp -s /path/to/weather.py -s /path/to/filesystem.js
ヒント
--modelを指定しない場合は、保存済みの設定ファイルにあるモデルが使用されます。設定されていない場合は、Ollama で最初に利用可能なモデルが自動的に選択されます(モデルがインストールされていない場合は、取得方法が案内されます)。
JSON 設定ファイルを使用する:
ollmcp --servers-json /path/to/servers.json --model llama3.2:1b
# Or using short flags:
ollmcp -j /path/to/servers.json -m llama3.2:1b
ヒント
JSON ファイルの構成方法については、サーバー設定形式のセクションを参照してください。
カスタムの Ollama ホストを使用する:
ollmcp --host http://localhost:22545 --servers-json /path/to/servers.json
# Or using short flags:
ollmcp -H http://localhost:22545 -j /path/to/servers.json
別の LLM プロバイダー(OpenAI または OpenAI 互換 API)を使用する:
ollmcp --provider openai --api-key $OPENAI_API_KEY --model gpt-5.5
# OpenAI-compatible providers (e.g. OpenRouter, DeepSeek); override the endpoint with --host if needed:
ollmcp --provider openrouter --api-key $OPENROUTER_API_KEY -m openrouter/free
ヒント
プロバイダーの設定(モデル、ホスト、API キー)はプロバイダーごとに記憶されます。
/save-configで保存すると、通常のollmcpコマンドで最後に使用したプロバイダーが再開されます。詳しくは設定管理を参照してください。
URL で SSE または Streamable HTTP サーバーに接続する:
ollmcp --mcp-server-url http://localhost:8000/sse --model qwen2.5:latest
# Or using short flags:
ollmcp -u http://localhost:8000/sse -m qwen2.5:latest
複数の URL サーバーに接続する:
ollmcp --mcp-server-url http://localhost:8000/sse --mcp-server-url http://localhost:9000/mcp
# Or using short flags:
ollmcp -u http://localhost:8000/sse -u http://localhost:9000/mcp
ローカルスクリプトと URL サーバーを組み合わせる:
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --model qwen3:1.7b
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp -m qwen3:1.7b
ほかのソースと一緒に Claude Desktop のサーバーを含める:
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --claude-desktop
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp --claude-desktop
ツール呼び出しの仕組み
- クライアントは、利用可能なツールのリストとともにクエリを Ollama に送信します
- Ollama がツールを使用すると判断した場合、クライアントは次の処理を行います。
- 書式設定された引数とシンタックスハイライトを使って、ツールの実行内容を表示します
- Human-in-the-Loop が有効な場合、ツール呼び出しを確認して承認できる確認プロンプトを表示します
- モデルの応答からツール名と引数を抽出します
- 承認された場合、または HIL が無効な場合に限り、これらの引数を使って適切な MCP サーバーを呼び出します
- 構造化された読みやすい形式でツールの応答を表示します(画像や未対応メディアの概要を含みます)
- ツールが画像を返し、現在のモデルがビジョンに対応している場合は、次の LLM メッセージに画像を添付します。対応していない場合は警告を表示します
- ツールの結果を Ollama に送り返します
- エージェントモードの場合、モデルがさらにツール呼び出しを要求するたびに処理を繰り返します
- 最後に、クライアントは次の処理を行います。
- ツールの結果を反映したモデルの最終応答を表示します
エージェントモード
会話中に複数のツール呼び出しを要求するモデルもあります。クライアントは、ツールを反復実行できるエージェントモードに対応しています。
- モデルがツール呼び出しを要求すると、クライアントはそれを実行し、結果をモデルに送り返します
- モデルが最終回答を返すか、設定されたループ上限に達するまで、この処理を繰り返します
/loop-limit(/ll)コマンドを使って、反復の最大回数を設定できます- 無限ループを防ぐため、ループ上限のデフォルトは
7です
ループ制限に達した場合
クライアントは何も通知せずに停止するのではなく、一時停止して、続行方法を尋ねます。
| 選択肢 | キー | 説明 |
|---|---|---|
| 続行 | c (デフォルト) | 反復をもう1バッチ(現在の制限と同じ数)追加します |
| 数を指定 | n | 許可する追加の反復回数を正確に指定します |
| 無制限 | u | 上限を解除し、モデルがツールのリクエストを停止するまで実行します |
| まとめる | w | ここまでに収集した内容を要約して最終回答を出すよう、モデルに依頼します。制限に達する前に収集したツールの結果はすべて保持されます |
| 中止 | a | ターン全体を破棄します(履歴には何も保存されません) |
メモ
Agent Mode の使用を防ぎたい場合は、ループ制限を
1に設定してください。
Agent Mode のクイックデモ:

インタラクティブコマンド
チャット中は、次のコマンドを使用します。
重要
新機能: 組み込みのインタラクティブコマンドを実行するには、先頭に
/が必要になりました。
/help、/model、/tools、/promptsなどを使用します。helpやmodelのように/を付けないコマンド名は、コマンドとして実行されなくなりました。- プロンプトの呼び出しにも
/を使用します。衝突を避けるため、/server:prompt_nameの使用を推奨します。

| コマンド | ショートカット | 説明 |
|---|---|---|
abort | a | モデルの生成中に、現在の応答生成を中止します |
/clear, /new | /cc | 会話履歴とコンテキストをクリアします |
/cls | /clear-screen | ターミナル画面をクリアします |
/context | /c | コンテキストの保持を切り替えます |
/context-info | /ci | コンテキストの統計情報を表示します |
/export-history | /eh | チャット履歴を JSON ファイルにエクスポートします |
/full-history | /fh | 会話履歴全体を表示します |
/help | /h | ヘルプと使用可能なコマンドを表示します |
/import-history | /ih | JSON ファイルからチャット履歴をインポートします |
/human-in-the-loop | /hil | ツール実行時の Human-in-the-Loop 確認を切り替えます |
/load-config | /lc | ファイルからツールとモデルの設定を読み込みます |
/loop-limit | /ll | ツールループの最大反復回数(エージェントモード)を設定します。デフォルト:7 |
/model | /m | 別の Ollama モデルを一覧表示して選択します |
/model-config | /mc | 高度なモデルパラメーターとシステムプロンプトを設定します |
/display-mode | /dm | 回答の表示モードとして、プレーン、Markdown、両方、Markdown(ブロック)を選択します |
/input-mode | /im | チャット入力モードとして、単一行または複数行を選択します |
/prompts | /pr | 使用可能なすべての MCP プロンプトを参照して表示します |
/server:prompt_name | /prompt_name | プロンプトを呼び出します(修飾形式を推奨) |
/resources | /res | 使用可能なすべての MCP リソースを参照して表示します |
@uri | - | URI で特定のリソースを読み込みます(例:@server://info) |
/quit, /exit, /bye | /q, Ctrl+C, または Ctrl+D | クライアントを終了します |
/reload-servers | /rs | 現在の設定ですべての MCP サーバーを再読み込みします |
/reset-config | /rc | 設定をデフォルトにリセットします(すべてのツールが有効) |
/save-config | /sc | 現在のツールとモデルの設定をファイルに保存します |
/show-metrics | /sm | パフォーマンスメトリクスの表示を切り替えます |
/show-thinking | /st | 思考テキストの表示を切り替えます(デフォルトで表示) |
/thinking-mode | /tm | 対応モデルで思考モードを切り替えます |
/reasoning-effort | /re | 思考モードがオンの場合の推論レベル(auto/minimal/low/medium/high/xhigh)を設定します。デフォルト:medium |
/show-tool-execution | /ste | ツール実行の表示を切り替えます |
/tools | /t | ツール選択インターフェースを開きます |
MCP ツール
ツールとサーバーの選択インターフェースでは、特定のツールを有効または無効にできます。

- 数字をカンマで区切って入力すると(例:
1,3,5)、特定のツールを切り替えられます - 数字の範囲を入力すると(例:
5-8)、連続する複数のツールを切り替えられます - S + 数字を入力すると(例:
S1)、特定のサーバーにあるすべてのツールを切り替えられます aまたはall- すべてのツールを有効にしますnまたはnone- すべてのツールを無効にしますdまたはdesc- ツールの説明を表示/非表示にしますjまたはjson- デバッグ用に、有効なツールの詳細なツール JSON スキーマを表示しますsまたはsave- 変更を保存してチャットに戻りますqまたはquit- 変更をキャンセルしてチャットに戻ります
MCP プロンプト
MCP プロンプトは、サーバーが定義する再利用可能な会話の開始文とコンテキストテンプレートを提供します。サーバーは、説明、必須引数、事前にフォーマットされたメッセージを含むプロンプトを公開できます。これにより、特定の種類の会話をすばやく開始したり、構造化されたコンテキストをチャットに挿入したりできます。
機能
- 📋 プロンプトの閲覧:接続されたサーバーで利用可能なすべてのプロンプトを、説明や引数の要件とともに表示します
- ⚡️ すばやい呼び出し:スラッシュ構文を使ってプロンプトを呼び出します(
/server:prompt_nameを推奨) - 🔤 オートコンプリート:
/を入力すると、あいまい一致によるプロンプト候補が表示されます - 📝 引数の収集:対話型プロンプトが、必須パラメーターの入力を案内します
- 👁️ プレビュー:プロンプトの内容を挿入する前に確認し、用途に合っていることを確かめられます
- 🎯 柔軟な挿入:すぐに実行するか、挿入のみ(モデルを起動せずに履歴へ追加)を選択できます
- 🧠 コンテキスト対応:プロンプトがユーザーまたはアシスタントのメッセージで終わるかに応じて、動作を自動的に調整します
- 🔄 安全なロールバック:中断した場合やエラーが発生した場合に、履歴を自動的にクリーンアップします
- 💬 テキストコンテンツ:テキストベースのプロンプトメッセージをサポートします(画像/音声/リソースのサポートは近日公開)
MCP プロンプトの使用方法
利用可能なプロンプトを表示:
/prompts # or '/pr'
サーバーごとにグループ化されたすべてのプロンプトが表示され、名前、必須の引数、説明を確認できます。
プロンプトを呼び出す:
/server:prompt_name
たとえば、docs という名前のサーバーが「summarize」プロンプトを提供している場合:
/docs:summarize
接続されているサーバー間でプロンプト名が一意であれば、短縮形を使用できます:
/summarize
複数のサーバーが同じプロンプト名を公開している場合、クライアントは修飾形式を使用するよう案内し、有効な /server:prompt_name の候補を提示します。
オートコンプリート:
/を入力すると、説明付きの利用可能なプロンプトがすべて表示されます- 入力を続けると、あいまい検索でプロンプトが絞り込まれます
- 矢印キーで移動し、Enter キーを押して選択します
ヒント
MCP サーバーに接続すると、プロンプトは自動的に検出されます。サーバーがプロンプトをサポートしている場合は、すぐに
promptsリストとオートコンプリートで利用できます。
ワークフロー:
/server:prompt_nameを入力する(推奨)か、オートコンプリートから選択します- プロンプトに引数が必要な場合は、入力を求められます
- 注入される内容を示すプロンプトのプレビューを確認します
- プロンプトの使用方法を選択します:
- y/yes(デフォルト):プロンプトをモデルに送信し、応答を取得します
- user message で終わるプロンプトの場合:そのメッセージをクエリとして使用します
- assistant message で終わるプロンプトの場合:「Please respond based on the above context.」をクエリとして追加します
- i/inject:モデルを起動せずにプロンプトを会話履歴に追加します(その後、自分でクエリを入力できます)
- n/no:キャンセルしてチャットに戻ります
- y/yes(デフォルト):プロンプトをモデルに送信し、応答を取得します
- 選択内容に応じてプロンプトが注入されます
- モデルの生成中に中断した場合(「a」を押す)、変更は自動的にロールバックされます
例:

警告
コンテンツタイプの制限:現在、MCP プロンプトがサポートしているのはテキストコンテンツのみです。以下のコンテンツタイプはまだサポートされておらず、自動的にスキップされます:
- 🖼️ 画像 - プロンプト内の画像コンテンツ
- 🎵 音声 - プロンプト内の音声コンテンツ
- 📦 リソース - 埋め込みリソースのコンテンツ
MCP リソース
MCP リソースを使用すると、MCP サーバーが公開するコンテキストデータ(ファイル、ドキュメント、構造化データなど)にアクセスできます。サーバーはメタデータ(名前、説明、MIME タイプ)を付けてリソースを公開できます。これらのリソースを参照し、会話のコンテキストに読み込めます。
機能
- 📋 リソースを参照:接続されているサーバーで利用可能なすべてのリソースについて、URI、名前、MIME タイプ、説明を確認できます
- 📖 リソースを読み込む:
@uri構文を使って、単独で、またはクエリ内にインラインでリソースのコンテンツを読み込めます - 📝 テキストコンテンツ:テキストベースのリソース(Markdown、コード、ログなど)を完全にサポートします
- 🖼️ 画像のビジョンサポート:画像リソース(
image/*)は、自動的に base64 画像としてビジョン対応モデルに転送されます - 🎯 コンテキストの注入:リソースのコンテンツはバッファリングされ、次のクエリとともにコンテキストとして注入されます
- 🔍 オートコンプリート:
@を入力すると、あいまい検索で利用可能なリソースとテンプレートの候補が表示されます - 🛡️ バイナリデータの安全な処理:画像以外のバイナリコンテンツ(音声、動画、PDF、アーカイブ)は検出され、情報メッセージとともに適切にスキップされます
MCP リソースの使用方法
利用可能なリソースを一覧表示する:
/resources # or '/res'
サーバーごとにグループ化されたすべてのリソースとテンプレートが表示され、URI、名前、MIME タイプ、説明を確認できます。バイナリリソースには [binary] タグ、テンプレートには [template] タグが付いています。
リソースを読み込む:
@<uri>
たとえば、ファイルリソースを読み込むには、次のようにします。
@file:///path/to/document.md
@uri の使用方法は 2 通りあります。
1. 単独で使用(バッファリングしてから質問): @uri を単独で入力します。リソースが取得され、バッファリングされます。次に、次のプロンプトで質問を入力します。リソースの内容はコンテキストとして自動的に挿入されます。
2. インラインで使用(1 回のターンで完結): 質問文の任意の場所に @uri を含めます。リソースが取得され、質問が 1 ステップで直ちに処理されます。
単独での使用例:
qwen3/show-thinking/6-tools❯ @server://info
✅ Read resource 'get_server_info' (197 chars)

Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.

1 resource(s) buffered. Type your query, or include @another_uri inline.

qwen3/show-thinking/6-tools❯ Next question here
インラインでの使用例:
qwen3/show-thinking/6-tools❯ summarize the key features from @server://info
✅ Read resource 'get_server_info' (197 chars)

Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.
[model response]
ヒント
MCP サーバーに接続すると、リソースは自動的に検出されます。サーバーがリソースに対応していれば、すぐに
resourcesリストと@の自動補完から利用できます。
メモ
🖼️ 画像(
image/*)には対応しています。base64 データとして、ビジョン対応モデルに直接渡されます。 バイナリコンテンツ:以下のリソースタイプはコンテキストとしてサポートされておらず、説明メッセージとともにスキップされます。
- 🎵 音声 -
audio/*MIME タイプ- 📹 動画 -
video/*MIME タイプ- 📄 PDF -
application/pdf- 🗜️ アーカイブ -
application/zip、application/octet-stream
回答の表示モード
/display-mode(/dm)コマンドを使うと、モデルの回答がストリーミング中にどのように表示されるかを選択できます。
- プレーン:回答をプレーンテキストで一度だけストリーミングし、最後に Markdown として再描画しません
- ✨新機能 Markdown(デフォルト):書式付き Markdown を行ごとにストリーミングします。リアルタイム表示される末尾の少数行より前の行は一度だけ出力され、再描画されません。そのため、絵文字の使用時やターミナルのサイズ変更時も安定して表示されます
- 両方:まずプレーンテキストでストリーミングし、その後、完成した回答を Markdown として再度表示します
- Markdown(ブロック):回答を Markdown としてブロック単位で表示します。追記のみで、段落、リスト、表、コードブロックは完成時に一度だけ出力され、再描画されないため、行が重複することはありません
チャット中に /display-mode または /dm を使うと、インタラクティブな選択メニューが開きます。
モードを切り替える理由:
- プレーンは、再描画やちらつきを最小限に抑えたい場合に最適です
- Markdownは、行ごとのストリーミングと一貫した Markdown の書式を両立します。再描画されるのは最大でも末尾の数行だけなので、絵文字の使用時やサイズ変更時も表示の乱れを限定できます
- 両方では、すばやいストリーミング表示に加えて、完成後に整った Markdown 表示が得られます
- **Markdown(ブロック)**は、ストリーミング中に書式付き Markdown を表示する最も慎重な方法です。ただし、更新は行ごとではなくブロックごとになります
ヒント
選択した表示モードは
/save-configで保存され、/load-configで復元されます。そのため、ワークフローごとに異なる表示設定を維持できます。
入力モード
/input-mode(/im)コマンドでは、チャットメッセージの入力方法を設定できます。
- 単一行(デフォルト):メッセージを入力したら、Enter を押してすぐに送信します
- 複数行:Enter を押して改行し、入力が完了したら Esc を押してから Enter を押すと、メッセージ全体を送信します。これにより、複数の段落やコードブロックを含む、より複雑なメッセージを入力できます
- Ctrl+J でも複数行モードで改行できます。さまざまなターミナルで確実に使える代替手段です
チャット中に /input-mode または /im を使うと、インタラクティブな選択メニューが開きます。
重要
複数行モードの送信ショートカットは、ターミナルエミュレーターや OS のキーボード処理によって異なる場合があります。このクライアントでは、複数行モードで幅広く使える送信ショートカットとして Esc を押してから Enter を使用します。Shift+Enter や Meta+Enter が使えるターミナルもありますが、保証はされません。
モデルの選択
モデル選択インターフェースには、Ollama のインストール環境で利用可能なすべてのモデルが表示されます。

- 使用するモデルの番号を入力します
sまたはsave- モデルの選択を保存してチャットに戻りますqまたはquit- モデルの選択をキャンセルしてチャットに戻ります
モデルの詳細設定
/model-config (/mc) コマンドを実行すると、モデルの詳細設定インターフェースが開き、モデルが応答を生成する方法を細かく調整できます。

システムプロンプト
- System Prompt:モデルの役割と動作を設定し、応答を導きます。
主要なパラメーター
- Context Window (num_ctx):モデルが使用するチャット履歴の量を設定します。メモリ使用量とパフォーマンスのバランスを調整してください。
- Keep Tokens:重要なトークンが削除されないようにします
- Max Tokens:応答の長さを制限します(0 = 自動)
- Seed:出力を再現可能にします(ランダムにするには -1 に設定します)
- Temperature:ランダム性を制御します(0 = 決定的、高いほど創造的)
- Top K / Top P / Min P / Typical P:多様性を制御するサンプリング設定
- Repeat Last N / Repeat Penalty:繰り返しを減らします
- Presence/Frequency Penalty:新しいトピックを促し、繰り返しを減らします
- Stop Sequences:カスタムの停止位置を設定します(最大8個)
- Batch Size (num_batch):リクエストの内部バッチ処理を制御します。値を大きくするとスループットが向上する場合がありますが、メモリ使用量も増加します。
コマンド
- パラメーター番号
1-15を入力して設定を編集します spを入力してシステムプロンプトを編集しますu1、u2などを使用してパラメーターを解除するか、uallを使用してすべてをリセットしますh/help:パラメーターの詳細とヒントを表示しますundo:変更を元に戻しますs/save:変更を適用しますq/quit:キャンセルします
設定例
- 事実重視:
temperature: 0.0-0.3、top_p: 0.1-0.5、seed: 42 - 創造的:
temperature: 1.0+、top_p: 0.95、presence_penalty: 0.2 - 繰り返しを抑制:
repeat_penalty: 1.1-1.3、presence_penalty: 0.2、frequency_penalty: 0.3 - バランス重視:
temperature: 0.7、top_p: 0.9、typical_p: 0.7 - 再現可能:
seed: 42、temperature: 0.0 - 大きなコンテキスト: より多くのコンテキストを必要とする複雑な会話では、
num_ctx: 8192以上に設定します
ヒント
すべてのパラメーターはデフォルトで未設定のため、Ollama 独自の最適化された値が使用されます。詳細と推奨設定については、設定メニューで
helpを使用してください。変更は設定とともに保存されます。
思考モードと推論の強度
/thinking-mode (/tm) を使用すると、対応モデル(例:qwen3、deepseek-r1、拡張思考機能を備えた Claude)で思考モードを有効にし、拡張推論を行えます。/show-thinking (/st) を使用すると、応答内に推論プロセスを表示するかどうかを切り替えられます。
/reasoning-effort (/re) を使用すると、思考モードがオンのときにモデルが適用する推論の強度を制御できます。
| レベル | 説明 |
|---|---|
auto | プロバイダーのデフォルトの強度(クラウドでは推奨) |
minimal | 最速で、推論が最も少ない |
low | 軽い推論 |
medium | バランス重視 — デフォルト |
high | より徹底した推論 |
xhigh | 最大の推論強度 |
メモ
プロバイダーやモデルによっては、推論の強度設定が無視される場合があります。
開発時のサーバー再読み込み
/reload-servers コマンド(/rs)は、MCP サーバーの開発中に特に便利です。クライアントアプリケーション全体を再起動せずに、接続中のすべてのサーバーを再読み込みできます。
主なメリット:
- 🔄 ホットリロード:MCP サーバーのコード変更をすぐに反映できます
- 🛠️ 開発ワークフロー:反復的な開発やテストに最適です
- 📝 設定の更新:サーバーの JSON 設定や Claude の設定に加えた変更を自動的に取り込みます
- 🎯 状態の保持:再読み込み後も、ツールの有効/無効の設定を維持します
- ⚡️ 時間の節約:クライアントを再起動してすべてを再設定する必要がありません
使用するタイミング:
- MCP サーバーの実装を変更した後
- JSON ファイル内のサーバー設定を更新したとき
- Claude の MCP 設定を変更した後
- 最新バージョンのサーバーでテストしていることを確認するためのデバッグ中
チャットインターフェースで /reload-servers または /rs と入力すると、クライアントは次の処理を行います。
- 現在接続しているすべての MCP サーバーとの接続を切断します
- 同じパラメーター(
ollmcp mcp addで追加したサーバー、サーバーのパス、設定ファイル、--claude-desktop)を使って再接続します - 以前のツールの有効/無効の設定を復元します
- 更新されたサーバーとツールの状態を表示します
この機能により、MCP サーバーの構築やテストにおける開発体験が大幅に向上します。
Human-in-the-Loop(HIL)によるツール実行
Human-in-the-Loop 機能は、ツールの実行前に内容を確認して承認できるようにすることで、安全性をさらに高めます。特に次のような場合に便利です。
- 🛡️ 安全性:実行前に、破壊的な操作の可能性がある処理を確認できます
- 🔍 学習:モデルがどのツールを使おうとしているか、またその理由を把握できます
- 🎯 制御:承認したツールのみを選択して実行できます
- 🚫 防止:望ましくないツール呼び出しの実行を止められます
- 🔄 セッションモード:現在のクエリセッション中は、すべてのツールを自動承認します
- 🛑 クエリの中止:履歴に保存せず、クエリ全体を中止します
HIL の確認画面
HIL が有効な場合、各ツールの実行前に確認プロンプトが表示されます。
例:

HIL の確認オプション
確認プロンプトが表示されたら、次のオプションを選択できます。
- y/yes:このツール呼び出しを実行します
- n/no:このツール呼び出しをスキップして、クエリを続行します
- s/session:追加の確認なしで、現在のクエリにおけるこのツール呼び出しと以降のすべてのツール呼び出しを実行します
- d/disable:HIL の確認を恒久的に無効にします(
/hilコマンドで再度有効にできます) - a/abort:履歴に保存せず、クエリ全体を直ちに中止します
ヒント
モデルが複数のツールを順番に実行する必要がある場合は、session オプションが特に便利です。個別に毎回確認する代わりに、現在のクエリセッション中のすべてのツールを承認できます。HIL は次のクエリで自動的にリセットされます。
ヒューマン・イン・ザ・ループ(HIL)の設定
- デフォルトの状態:安全のため、HIL の確認はデフォルトで有効です
- 切り替えコマンド:
/human-in-the-loopまたは/hilを使用して有効/無効を切り替えます - 設定の保存:HIL の設定は構成とともに保存されます
- すぐに無効化:確認時に「disable」を選択すると、恒久的に無効になります
- セッション中の自動承認:確認時に「session」を選択すると、現在のクエリで使用するすべてのツールが承認されます
- クエリの中止:確認時に「abort」を選択すると、保存せずにクエリをただちに停止します
- 再有効化:いつでも
/hilコマンドを使用して、確認を再度有効にできます
メリット:
- 安全性の向上:誤ったツール実行や意図しないツール実行を防ぎます
- 状況の把握:モデルが実行しようとしている操作を把握できます
- 選択的な制御:操作ごとに許可するものを選択できます
- 柔軟なワークフロー:複数のツールを使うクエリにはセッションモードを、機密性の高い操作には個別承認を利用できます
- 問題のない中止:会話履歴に影響を与えず、問題のあるクエリをただちに停止できます
- 安心感:自動化された操作をすべて確認し、制御できます
パフォーマンス指標
パフォーマンス指標機能では、各クエリの後に、枠で囲まれたパネルにモデルの詳細なパフォーマンスデータが表示されます。指標には、Ollama のレスポンスから直接取得した所要時間、トークン数、生成速度が表示されます。
表示される指標:
total duration:レスポンス全体の生成にかかった合計時間(秒)load duration:モデルの読み込みにかかった時間(ミリ秒)prompt eval count:入力プロンプトのトークン数prompt eval duration:入力プロンプトの評価にかかった時間(ミリ秒)eval count:レスポンスで生成されたトークン数eval duration:レスポンスのトークン生成にかかった時間(秒)prompt eval rate:入力プロンプトの処理速度(トークン/秒)eval rate:レスポンスのトークン生成速度(トークン/秒)
例:

パフォーマンス指標の設定
- デフォルトの状態:出力をすっきりさせるため、指標はデフォルトで無効です
- 切り替えコマンド:
/show-metricsまたは/smを使用して、指標の表示を有効/無効にします - 設定の保存:指標の設定は構成とともに保存されます
メリット:
- パフォーマンスの監視:モデルの効率とレスポンス時間を追跡できます
- トークンの追跡:分析のために、実際のトークン消費量を監視できます
- ベンチマーク:異なるモデル間でパフォーマンスを比較できます
メモ
データソース:すべての指標は Ollama のレスポンスから直接取得するため、正確性と信頼性が確保されます。
履歴の管理
履歴管理機能では、会話履歴の表示、エクスポート、インポートができます。次のような用途に便利です。
- 📜 全履歴の表示:現在のセッションのすべての会話を確認できます
- 💾 エクスポート:バックアップや分析のために、会話を JSON ファイルに保存できます
- 📥 インポート:以前の会話履歴を読み込み、中断したところから続けられます
- 🔄 移植性:セッション間で会話を共有または転送できます
履歴コマンド
履歴をすべて表示:
/full-history # or '/fh'
現在のセッションの会話履歴をすべて、クエリと応答の両方を含む形式で表示します。
履歴をエクスポート:
/export-history # or '/eh'
現在のチャット履歴を JSON ファイルにエクスポートします。カスタムファイル名を指定するか、デフォルトのタイムスタンプベースの名前(例:ollmcp_chat_history_2026-01-05_143022.json)を使用できます。ファイルは ~/.config/ollmcp/history/ ディレクトリに保存されます。このコマンドには、ファイルの上書き防止機能が含まれています。
履歴をインポート:
/import-history # or '/ih'
以前にエクスポートした会話履歴を JSON ファイルからインポートします。このコマンドは、互換性を確保するために JSON 構造を検証します。インポートした履歴は、現在の会話コンテキストに追加されます。
履歴の保存先:
- エクスポート先:
~/.config/ollmcp/history/ - デフォルトのファイル名形式:
ollmcp_chat_history_YYYY-MM-DD_HHMMSS.json - JSON 形式では、クエリと応答の両方が適切な構造検証とともに含まれます
利点:
- セッションの継続性:異なるセッション間で会話を再開できます
- バックアップ:重要な会話の記録を保持できます
- 分析:外部での分析やレビューのために履歴をエクスポートできます
- 共有:会話のコンテキストをチームメンバーと共有できます
- テスト:開発やデバッグのためにテスト用の会話をインポートできます
ヒント
エクスポート時にファイル名を指定しない場合、誤って上書きしないよう、システムがタイムスタンプ付きのファイル名を自動生成します。
オートコンプリートとプロンプト機能
Typer シェルオートコンプリート
- CLI は Typer を介して、すべてのオプションと引数のシェルオートコンプリートをサポートします
- 有効にするには、
ollmcp --install-completionを実行し、使用しているシェルの手順に従ってください - グループ化されたオプションと一般的なオプションのすべてで、タブ補完を利用できます
FZF 形式のオートコンプリート
- コマンドとプロンプトのスラッシュ名前空間オートコンプリート(
/) - メニューにコマンドの説明を表示
- 入力の大文字と小文字を区別しない照合
- 一貫性を保つため、コマンドリストを一元管理
- 通常のテキストクエリの入力時に、アクションのオートコンプリート候補が表示されないよう意図的に設計されています
MCP プロンプトのオートコンプリート
/を入力してプロンプトのオートコンプリートを起動- プロンプト名と説明をあいまい検索
/server:prompt_nameのような修飾付きプロンプト参照をサポート- メニューにプロンプトの説明を表示
- プロンプトの引数はプロンプトの呼び出し時に収集されます(オートコンプリート行には表示されません)
- ターミナルの幅に応じて説明を省略表示
コンテキストプロンプト
チャットプロンプトでは、一目で分かる明確なコンテキスト情報を表示するようになりました。
- モデル:現在使用中の Ollama モデルを表示
- 思考モード:「思考モード」が有効かどうかを表示(対応モデルの場合)
- ツール:有効なツールの数を表示
プロンプトの例:
qwen3/show-thinking/12-tools❯
qwen3モデル名/show-thinking思考モードのインジケーター(有効な場合。無効の場合は/thinking、または表示されません)/12-tools有効なツールの数(単数の場合は/1-tool)❯プロンプト記号
これにより、クエリを入力する前に現在のコンテキストを簡単に確認できます。
ヒント
プロンプト記号の後に
/を入力すると、利用可能な MCP プロンプトのオートコンプリート候補が表示されます。
設定の管理
ヒント
フラグを付けずに
ollmcpを実行すると、~/.config/ollmcp/config.jsonが存在する場合、そこからデフォルト設定が自動的に読み込まれます。
クライアントはセッション間で設定を保存し、読み込みます。
/save-configを使用する際、設定名を指定するか、デフォルトを使用できます- 設定は
~/.config/ollmcp/ディレクトリに保存されます - デフォルト設定は
~/.config/ollmcp/config.jsonとして保存されます - 名前付き設定は
~/.config/ollmcp/{name}.jsonとして保存されます
プロバイダーごとのプロファイル
接続設定はプロバイダーごとに保存されるため、プロバイダーを切り替えても、別のプロバイダーのモデル、ホスト、API キーが再利用されることはありません。各プロバイダーは、それぞれ次の設定を保持します。
- モデルの選択
- ホスト/API ベース URL
- API キー
設定には defaultProvider も記録されます。--provider フラグを指定せずに ollmcp を実行すると、そのプロバイダーのプロファイルが読み込まれます。新規インストール時は ollama が設定されています。/save-config を実行するたびに、現在使用中のプロバイダーが新しいデフォルトになるため、ollmcp をそのまま実行すると、最後に使用していた状態から再開できます。いつでも --provider <name> を渡して別のプロバイダーのプロファイルに切り替えて読み込めます。また、--model/--host/--api-key を指定すると、その実行時に保存済みの値が上書きされます。
メモ
--api-keyで渡したキーのみが、平文で~/.config/ollmcp/config.jsonに保存されます。$OLLMCP_API_KEY環境変数またはプロバイダー固有の環境変数(例:OPENROUTER_API_KEY)を介して指定したキーは、ディスクに書き込まれることはありません。キーを永続化したくない場合は、いずれかを使用してください。
以下の設定は、すべてのプロバイダーで共有されます。
- 高度なモデルパラメーター(システムプロンプト、温度、サンプリング設定など)
- すべてのツールの有効/無効状態
- コンテキスト保持設定
- 思考モード設定
- 回答表示モードの設定
- ツール実行表示の設定
- パフォーマンス指標表示の設定
- Human-in-the-Loop 確認設定
~/.config/ollmcp/config.json の例:
{
  "defaultProvider": "openai",
  "providers": {
    "ollama": { "host": "http://localhost:11434", "model": "qwen3:1.7b", "apiKey": "" },
    "openai": { "host": "", "model": "gpt-5.5", "apiKey": "sk-..." }
  },
  "enabledTools": {},
  "modelConfig": {},
  "...": "shared settings"
}
ヒント
古いフラット形式の設定ファイル(トップレベルに
host/model/provider/apiKeyがあるもの)は、このバージョンを初めて実行したときに自動的に移行され、次回の/save-configでプロバイダーごとの形式に書き換えられます。
サーバー設定の形式
JSON 設定ファイルは、STDIO、SSE、Streamable HTTP のサーバータイプに対応しています(MCP 1.10.1)。
{
  "mcpServers": {
    "stdio-server": {
      "command": "command-to-run",
      "args": ["arg1", "arg2", "..."],
      "env": {
        "ENV_VAR1": "value1",
        "ENV_VAR2": "value2"
      },
      "disabled": false
    },
    "sse-server": {
      "type": "sse",
      "url": "http://localhost:8000/sse",
      "headers": {
        "Authorization": "Bearer your-token-here"
      },
      "disabled": true
    },
    "http-server": {
      "type": "streamable_http",
      "url": "http://localhost:8000/mcp",
      "headers": {
        "X-API-Key": "your-api-key-here"
      },
      "disabled": false
    }
  }
}
メモ
MCP 1.10.1 のトランスポートサポート:クライアントは、パフォーマンスと信頼性が向上した最新の Streamable HTTP トランスポートに対応しました。タイプを指定せずに URL を指定すると、クライアントはデフォルトで Streamable HTTP トランスポートを使用します。
ヒント:MCP サーバー設定の保存場所と動作する例
MCP サーバー設定ファイルをどこに保存するか、また TUI の保存/読み込み機能をどう使うかは、よく混乱を招く点です。ほかのユーザーの役に立った、簡潔で実用的なガイドを紹介します。
- TUI の
/save-config//load-config(または/sc//lc)コマンドは、有効にしたツール、選択したモデル、思考モード、表示モードなど、TUI の設定を保存するためのものです。クライアントに MCP サーバー接続を登録するために使う必要はありません。 - MCP サーバーの JSON ファイル(上記の
mcpServersオブジェクト)は、TUI の設定ディレクトリの外、または分かりやすいサブフォルダーに保存することをお勧めします。例:
~/.config/ollmcp/mcp-servers/config.json
その後、起動時に -j/--servers-json を使って、そのファイルを ollmcp に指定できます。
重要
HTTP ベースの MCP サーバーでは、
"type": "http"、"streamable-http"、"streamable_http"はすべて受け付けられ、同じように扱われます。また、一般的なエンドポイントについては、下記の一般的な MCP エンドポイントパスのセクションも確認してください。
最小限の動作例として、~/.config/ollmcp/mcp-servers/config.json が次のようになっているとします。
{
  "mcpServers": {
    "github": {
      "type": "streamable_http",
      "url": "https://api.githubcopilot.com/mcp/",
      "headers": {
        "Authorization": "Bearer mytoken"
      }
    }
  }
}
ヒント
GitHub MCP サーバーを使用する場合は、
"mytoken"を実際の GitHub API トークンに置き換えてください。
このファイルを用意したら、次のように接続できます。
ollmcp -j ~/.config/ollmcp/mcp-servers/config.json
このよくある落とし穴に関連する GitHub の Issue はこちらです:https://github.com/jonigl/mcp-client-for-ollama/issues/112#issuecomment-3446569030
デモ
動作する設定をすばやく再現するのに役立つ、短いデモ(asciicast)です。この例では、Streamable HTTP プロトコルを使用する MCP サーバーの例を使用しています。

一般的な MCP エンドポイントパス
Streamable HTTP MCP サーバーは通常、/mcp(例:https://host/mcp)に MCP エンドポイントを公開します。一方、SSE サーバーでは一般的に /sse(例:https://host/sse)が使用されます。以下は、MCP 仕様(2025-06-18)からの抜粋です。
サーバーは、POST メソッドと GET メソッドの両方をサポートする単一の HTTP エンドポイントパス(以下、MCP エンドポイントと呼びます)を提供しなければなりません。たとえば、https://example.com/mcp のような URL が該当します。
詳細については、MCP 仕様バージョン 2025-06-18 - トランスポートをご覧ください。
メモ
リモート MCP サーバーの HTTPS 証明書は、
certifiバンドルではなく、オペレーティングシステムの信頼ストアに対して検証されます。MCP サーバーがプライベート CA や企業 CA の背後にある場合、またはシステム CA ストアのない最小構成のコンテナーで ollmcp を実行している場合、ollmcp に言及しないエラーとともに TLS ハンドシェイクが失敗します。解決するには、SSL_CERT_FILE(バンドルファイル)またはSSL_CERT_DIR(ディレクトリ)を CA の場所に設定してください。export SSL_CERT_FILE=/path/to/corporate-ca.pem
互換性のあるモデル
以下の Ollama モデルは、ツールの使用に適しています。
- gemma4
- qwen3.5
- lfm2.5-thinking
- llama3.2
- mistral
ツール使用機能を備えた Ollama モデルの全一覧については、Ollama の公式モデルページをご覧ください。
ツールから返された画像も処理できるモデルについては、Ollama のビジョンモデルページをご覧ください。
Ollama Cloud モデル
Ollama 用 MCP クライアントは、Ollama Cloud モデルにも対応しました。これにより、ローカルの MCP ツールを活用しながら、ツール呼び出し機能を備えた高性能なクラウドホストモデルを使用できます。Cloud モデルは高性能なローカル GPU がなくても実行できるため、個人用コンピューターには収まらない大規模モデルにもアクセスできます。
対応する Ollama Cloud モデルの例:
gpt-oss:20b-cloudgpt-oss:120b-clouddeepseek-v3.1:671b-cloudqwen3-coder:480b-cloud
このクライアントで Ollama Cloud モデルを使用するには:
-
まず、Cloud モデルをプルします。
ollama pull gpt-oss:120b-cloud -
選択した Cloud モデルを指定してクライアントを実行します。
ollmcp --model gpt-oss:120b-cloud
メモ
モデル
deepseek-v3.1:671b-cloudは、思考モードをオフにした場合にのみツールの使用に対応します。ollmcpでは、/thinking-modeまたは/tmを入力して思考モードを切り替えられます。
Ollama Cloud の詳細については、Ollama Cloud のドキュメントをご覧ください。
スポンサー
このプロジェクトは、以下の支援を受けています。
Atlas Cloud
Atlas Cloud は、動画、画像、LLM のワークロード向けに、厳選された 300 以上のモデルへ統一的にアクセスできる単一の AI API を提供する、マルチモーダル AI 推論プラットフォームです。
追加設定なしで ollmcp と連携します。
ollmcp --provider atlascloud --api-key YOUR_ATLASCLOUD_API_KEY
# or export the key once and skip the flag:
export ATLASCLOUD_API_KEY=YOUR_ATLASCLOUD_API_KEY
ollmcp --provider atlascloud
ストリーミングとツール呼び出しに完全対応しており、対話型の /model コマンドを使って Atlas Cloud の任意のモデルを参照・選択できます。
スポンサーになる
ここにロゴを掲載しませんか?GitHub Sponsors を通じてプロジェクトをご支援ください ❤️
MCP サーバーについて詳しく知るには?
公式の MCP サーバーリポジトリで、MCP サーバーのコレクションを確認できます。
このリポジトリには、Model Context Protocol のリファレンス実装、コミュニティが構築したサーバー、LLM のツール機能を強化する追加リソースが含まれています。
関連プロジェクト
- Ollama MCP Bridge - Ollama の前段に配置され、複数の MCP サーバーのツールをすべてのチャットリクエストに自動的に追加する Python API レイヤーです。このプロジェクトは、起動時にすべての MCP サーバーを事前に読み込み、そのツールを Ollama API にシームレスに統合する透過的なプロキシソリューションを提供します。
- MCP Server with Streamable HTTP Example - ストリーム可能な HTTP プロトコルの使用方法を示す MCP サーバーの例です。
セキュリティ
接続する MCP サーバーは信頼できるものとして扱い、そのツールやリソースの応答はモデルに届く信頼できないコンテンツとして扱われます。信頼モデル、間接的なプロンプトインジェクションへの対処方法、脆弱性の報告方法については、SECURITY.md をご覧ください。
ライセンス
このプロジェクトは MIT License の下でライセンスされています。詳細は LICENSE ファイルをご覧ください。
謝辞
- ローカル LLM ランタイムを提供する Ollama
- 仕様とサンプルを提供する Model Context Protocol
- 複数の LLM プロバイダーに対応する単一のインターフェースを提供する any-llm
- ターミナルのユーザーインターフェースを提供する Rich
- モダンな CLI 体験を提供する Typer
- インタラクティブなコマンドラインインターフェースを提供する Prompt Toolkit
- 高速な Python パッケージマネージャーと仮想環境管理を提供する uv
- デモの録画に使用した Asciinema
❤️ を込めて jonigl が作成
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。