local-delegate について
local-delegateは、テキスト処理をローカルのOpenAI互換LLMに委任するMCPサーバーです。Claudeの利用枠を節約したい利用者向けに、ファイルをサーバー側で読み込み、大きな入力をClaudeのコンテキストに入れずに結果を返します。
主な機能
- 01要約、分類、項目抽出
- 02翻訳とコード解説
- 03サーバー側でのファイル読み込み
- 04長文書の分割処理
- 05stdioと共有HTTPデーモン
活用シーン
- 01Claudeのコンテキストを使わず大規模ログを要約
- 02ローカルファイルから構造化項目を抽出
- 03長文書を分割して翻訳
- 04仕様からボイラープレートコードを生成
MCP 対応
stdioまたは共有HTTPデーモン経由でMCPツールを提供します。MCPクライアントはOpenAI互換エンドポイントに処理を委任できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx local-delegate-mcpLOCAL_DELEGATE_BASE_URLOpenAI-compatible endpoint (llama-swap, Ollama, LM Studio, vLLM). Default http://127.0.0.1:9292/v1LOCAL_DELEGATE_API_KEYシークレットBearer token for the endpoint, if it requires one.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
11掲載時のツール一覧 · 今日に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| path | any | いいえ | |
| text | any | いいえ | |
| focus | any | いいえ | |
| max_words | integer | いいえ |
詳細
翻訳後に原文が更新されています。最新の内容は原文をご確認ください。
local-delegate
Claude のサブスクリプション枠を節約するため、機械的なテキスト→テキストのタスクをローカルの LLM に委任します。
あらゆる OpenAI 互換エンドポイント(llama-swap、Ollama、LM Studio、vLLM)に対応する汎用クライアントとして動作する MCP サーバー(stdio または共有 HTTP デーモン)です。


zahirinatzuke.github.io/local-delegate — その機能と理由を1ページで紹介しています(スペイン語/英語)。ソースは site/ にあります。
デモ
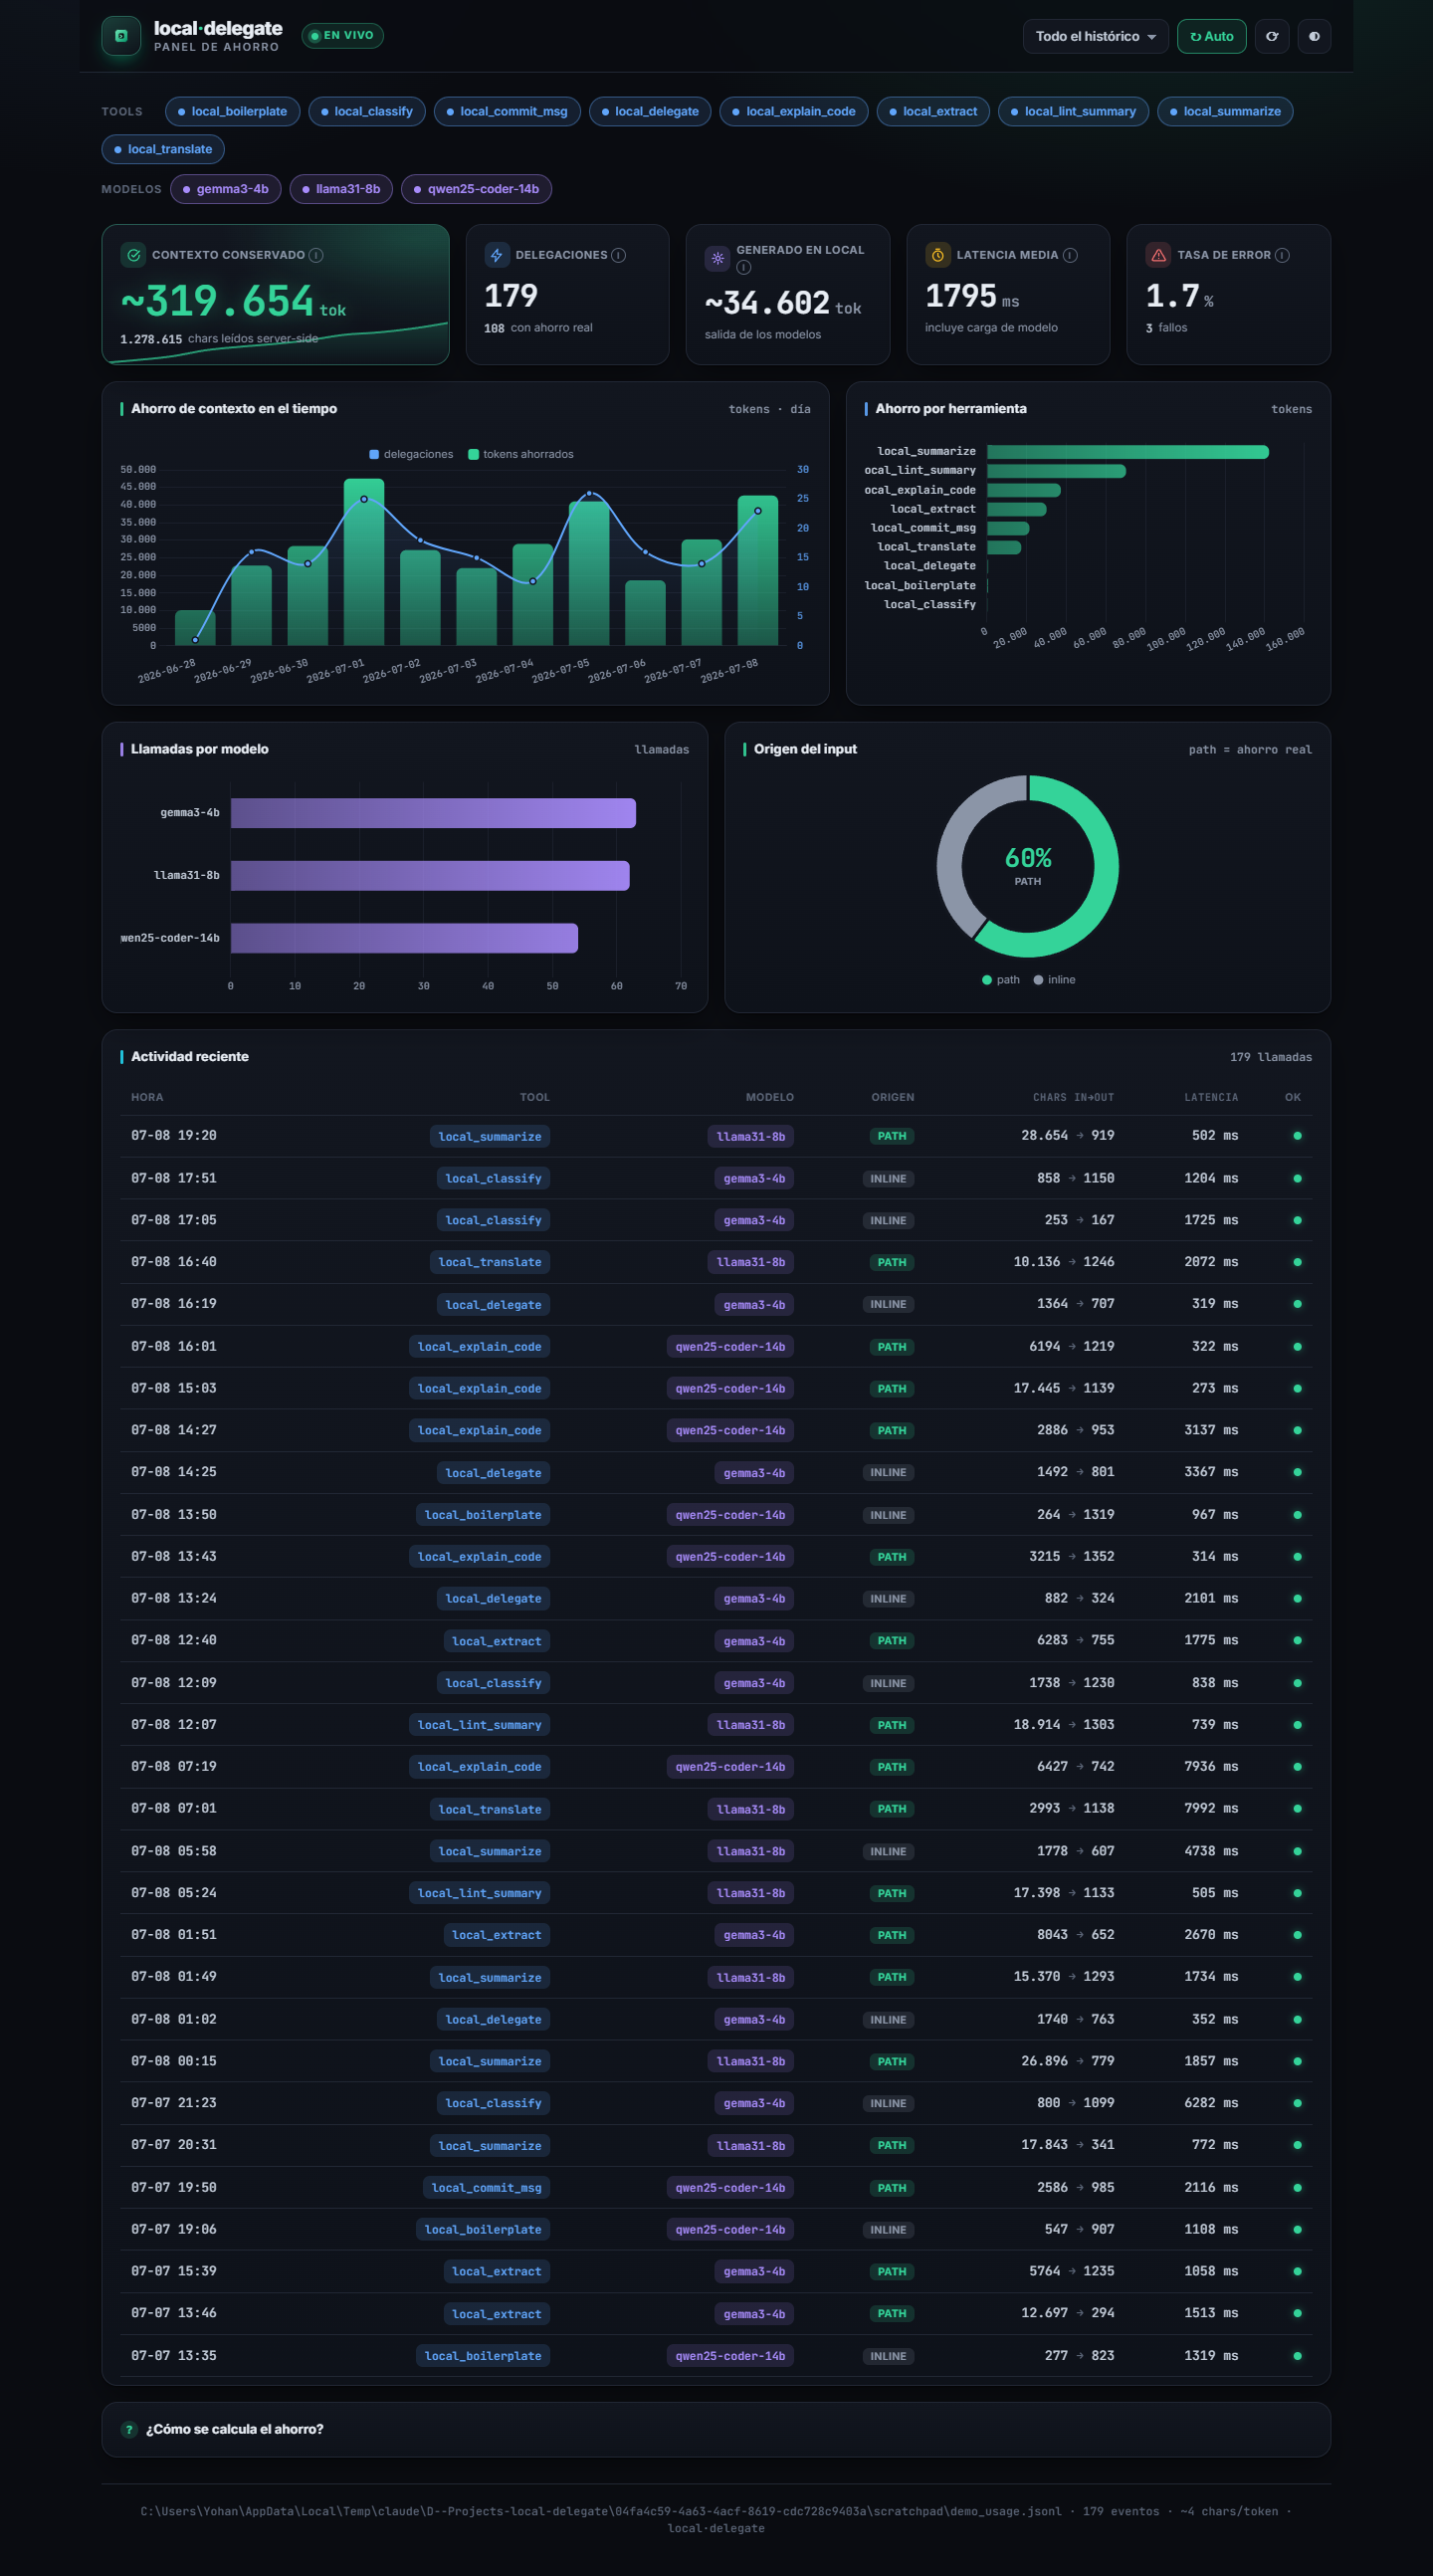
埋め込みダッシュボード(サンプルデータ):ローカルバックエンドの状態(マウント済みモデル、進捗をチャンク単位で表示する実行中の委任、MCP ツール)、プロセスごとの使用量を含むシステム RAM/VRAM、節約できたコンテキストトークン、ツールとモデルごとの節約量、計算を実行した場所(このマシンまたはリモートバックエンド)、ローカル時間でページ分割された最近のアクティビティを表示します。http://127.0.0.1:9393 で配信されます。
なぜ使うのか?
Claude が巨大なログの要約、分類、フィールドの抽出、定型コードの生成を行うと、機械的な作業にサブスクリプション枠を消費します。local-delegate は、ローカルの LLM で実行する MCP ツールとしてこれらのタスクを公開します。text の代わりに path を渡すと、ファイルはサーバー側で読み込まれるため、大きな内容がClaude のコンテキストに入ることはありません。返されるのは短い結果だけなので、ドキュメントがコンテキストウィンドウを占有することも、Claude が処理することもありません。
すぐにインストール
uv を使えば、インストールは不要です。uvx がパッケージをダウンロードし、隔離された環境で実行します。
MCP の設定(Claude Desktop/Claude Code)に、stdio 互換モードで追加します。
{
  "mcpServers": {
    "local-delegate": {
      "command": "uvx",
      "args": ["local-delegate-mcp"]
    }
  }
}
完全なテンプレートは examples/ をご覧ください。
または、1つのコマンドでパッケージにすべてを設定させることもできます。MCP エントリ、フック、スキル、およびグローバルな CLAUDE.md/AGENTS.md に記述する委任ルールが設定されます。
uv tool install local-delegate-mcp          # deja `local-delegate` en el PATH
local-delegate install --dry-run            # muestra exactamente qué tocaría
local-delegate install                      # aplica
uvx local-delegate-mcp install を使えば、何もインストールせずに試すこともできます。ただし、uvx はコマンドを利用可能な状態で残しません。一時的な環境を作成し、終了時に削除するため、その後 local-delegate doctor を実行すると「command not found」と応答します。この状況を検出すると、install 自体が警告します。
この操作は冪等で、編集したファイルの .bak を作成し、他の設定には触れません。local-delegate uninstall で元に戻せます。詳細とオプションはインテグレーションのインストールをご覧ください。
同じマシンで複数のセッションやクライアントを使う場合は、デーモンを1つだけ起動することをおすすめします。
uvx local-delegate-mcp serve
デーモンは http://127.0.0.1:9393/mcp で MCP を、http://127.0.0.1:9393/ でダッシュボードを提供します。Codex、Claude Code、opencode、および Streamable HTTP 対応クライアントは、MCP プロセスを重複して起動せずに同じ URL を共有できます。llama-swap をローカルで使う場合は、追加の [llamaswap] を指定し、LLAMASWAP_CONFIG をその config.yaml に設定すると、デーモンがさらにバックエンドを順番に割り当てます。モデルが互いにアンロードされるような2つの委任は競合せず、2つ目は待機します(パネルにはローカル待機として表示されます)。詳しい手順は共有デーモンをご覧ください。
委譲ではターン待ち時間と推論時間が加わることがあり、一部のクライアントはそれより早く打ち切ります。Codex は MCP ツールの呼び出しをすべて 60 秒で打ち切ります(config.toml の [mcp_servers.local-delegate] にある tool_timeout_sec で延長できますが、このブロックを書き換える install/update のたびに再設定が必要です)。Claude Code は HTTP 呼び出しを応答がない状態が 5 分続くと打ち切ります(CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT 環境変数で延長でき、install 後も維持されます)。詳しくは統合のインストールをご覧ください。
クライアントのローカルパスを維持したまま別のマシンの GPU を使うには、リモートバックエンドを参照するローカル MCP を使ってください:Mac → PC ガイドと技術的な完全レシピ。
「安定性」のために古いバージョンを固定しないでください。 バージョンを固定(
==X.Y.Z)すると、その wheel が宣言していた依存関係の範囲も固定され、時間とともに問題が生じます。0.12.2 より前のバージョンはmcpに上限を設けていなかったため、現在は SDK 2.x がインストールされ、import 時に失敗します。固定が必要なら、現行バージョンを固定し、新しいバージョンが出たら更新してください。
Windows でログイン時のタスクとして登録する場合は、パッケージをインストールした環境の pythonw.exe を使い、-m local_delegate serve --log-level warning を実行してください。pythonw はコンソールやタスクバーのボタンを表示しません。このタスクは Windows ユーザーに属し、Codex や Claude には属しません。ローカルのどのクライアントも同じデーモンを共有します。ダッシュボードでは、その単一のプロセスが DAEMON MCP バッジで示されます。接続中のセッションは HTTP クライアントであり、追加の MCP プロセスではありません。
Windows で更新する際は、uv tool install --force の前にデーモンを停止してください。 デーモンの実行中は、環境内のファイルが開かれているため再インストールが途中で失敗し、環境が壊れることがあります。起動プロセスが切り離されているため、schtasks /End だけでは不十分です。デーモンの pythonw プロセスを停止してからインストールし、再度起動してください。その後、local-delegate update を実行すると、古くなったフック、スキル、CLAUDE.md/AGENTS.md のブロックが復元されます。
0.36.0 はスペイン語または英語で表示され、システム言語に従います。 システムが英語の場合は、表示も英語になります。スペイン語のまま使うには、
LOCAL_DELEGATE_LANG=es local-delegate install(またはupdate)を実行してください。_local_delegateのキーとツールのマーカーは英語に変わります(互換性のない変更です)。一覧は変更履歴と言語をご覧ください。
0.35.0 では、コマンド、変数、スキル、データファイルの名前が英語に変更されました。 古い名前は警告付きで 0.37.x まで引き続き使用できますが、0.38.0 で削除されます。以前のバージョンに戻すことはサポートされていません。完全な一覧は変更履歴をご覧ください。
要件
Python 3.11 以降 — uvx を使う場合、自分でインストールする必要はなく、uvx が解決します。独自の環境に pip でインストールする場合にのみ必要です。
また、すでに稼働していて、LOCAL_DELEGATE_BASE_URL(既定値は http://127.0.0.1:9292/v1)からアクセスできる OpenAI 互換エンドポイントが必要です。以下のいずれでも使えます。
- llama-swap — Blackwell GPU を使うレシピをご覧ください。
- Ollama —
http://127.0.0.1:11434/v1。 - LM Studio、vLLM、または OpenAI API に対応する任意のサーバー。
パッケージは既定ではバックエンドを起動しません(LOCAL_DELEGATE_AUTOSTART=0)。llama-swap の自動起動はオプトインです(設定表をご覧ください)。
使用する llama-server/llama-swap のバージョンや、ワークスペースの構成については、バックエンドのバージョンとリファレンスワークスペースをご覧ください(動作確認済みの推奨設定であり、必須ではありません)。local-delegate doctor は、インストール済みのバージョンをこれらのバージョンと照合し、さらにフック、スキル、メモリ、MCP エントリ、デーモンといった周辺設定も、何も書き込まずに確認します(各チェックの内容)。
ツール
text の代わりに path を渡すと、MCP がファイルをサーバー側で読み込みます。内容は Claude のコンテキストに入らないため、その分の節約になります。
| ツール | 内容 | モデルの役割(デフォルト) |
|---|---|---|
local_summarize | テキストまたはファイルを要約します。保持する内容(例:「設定値」)を指定する focus は任意です | 機械的/長文(自動) |
local_classify | リストからラベルを1つ返します | 機械的 |
local_extract | フィールドを抽出し、パースが必要な文字列ではなく検証済みオブジェクトを返します | 機械的/長文(自動) |
local_boilerplate | 仕様からコードを生成して target に書き込み、受領通知だけを返します | コード |
local_delegate | 汎用のテキスト→テキスト処理を行います | 機械的(または指定した役割) |
local_lint_summary | lint/テスト/CI のログを要約します | 機械的/長文(自動) |
local_commit_msg | 差分からコミットメッセージを作成します | コード |
local_translate | テキストまたはファイルを翻訳します | 機械的/長文(自動) |
local_explain_code | コードを文章で説明します | コード |
local_describe_image | 画像を説明するか、画像についての質問に回答します(画像→テキスト) | ビジョン |
local_status | 読み取り専用の診断を行います:バックエンド、カタログ、ログ、VRAM、システム RAM | —(チャットバックエンドは呼び出しません) |
ローカルモデルはツール呼び出しを行いません。サーバーがプロンプトとガードレールを組み立て、エンドポイントに POST し、テキストのみを返します。
長いドキュメント。 local_translate(および長い入力を受け取る local_delegate)は、自然な区切り(Markdown の見出し、段落、行)でテキストを分割し、max_tokens の上限を守りながら1回の呼び出しにつき1つのチャンクを処理します。出力は順番どおりに連結され、チャンクの境目でも書式が保たれます。20,000文字以上のドキュメントも、途中で切れずに最後まで返されます。ログには chunks: N が記録され、実行中はダッシュボードに進捗(trozo 3/7)が表示されます。
非常に大きなドキュメントの要約。 入力がモデルの上限に収まらない場合、local_summarize と local_lint_summary はマップリデュースを行います。各パートを要約した後、必要に応じて複数のレベルで要約を重ねます。以前は入力が切り詰められていました。巨大な CI ログでは最初の部分だけが要約され、残りは黙って破棄されていましたが、エラーがよく見つかるのはまさにその部分です。現在は全体を読み込みます。max_tokens によって切り詰められたチャンクがある場合は、結果にその旨が示され、ログには finish_reason: length が記録されます。
0.36.1 以降、1回の呼び出しに収まらないログを処理する場合、local_lint_summary は名前が最も多く挙がった上位10ファイルだけを入力として受け取り、残りが何件あるかを示します。また、最終的な要約の数値はモデルではなくプログラムが設定します。
0.36.0 以降は、local_commit_msg、local_explain_code(最上位の def/class ごとに処理し、最後のステップで名前の一覧を渡します)、local_extract(各チャンクから部分オブジェクトを作成し、最後のステップでスキーマを使って結合します)も、入力全体を読み込みます。
設定
すべて環境変数で設定し、ハードコードされた値はありません。デフォルトのモデル ID はあくまでデフォルトなので、使用するバックエンドのものに変更してください。
| 変数 | デフォルト | 説明 |
|---|---|---|
LOCAL_DELEGATE_BASE_URL | http://127.0.0.1:9292/v1 | OpenAI 互換のエンドポイント |
LOCAL_DELEGATE_API_KEY | (空) | エンドポイントで必要な場合の Bearer トークン |
LOCAL_DELEGATE_BACKEND_ORIGIN | auto | local/remote は計算元を強制し、auto はホストから推測します。トンネル(ssh -L、ポートフォワード)経由でバックエンドに接続する場合は設定してください。ループバック経由ではローカルと判定されます |
LOCAL_DELEGATE_TIMEOUT | 180 | HTTP タイムアウト(秒) |
LOCAL_DELEGATE_MAX_CONCURRENT_REQUESTS | 2 | プロセスあたりの最大バックプレッシャー。デーモンのすべてのクライアントで共有されます |
LOCAL_DELEGATE_ASK | 1 | 失敗させる代わりに、ユーザーに尋ねます(elicitation 経由)。バックエンド停止、モデルがカタログにない、output_format が空の場合に適用されます。0 で無効になります |
LOCAL_DELEGATE_ASK_TIMEOUT | 30 | 応答を待つ秒数。時間切れになると、ツールは尋ねなかった場合と同様に続行します |
LOCAL_DELEGATE_LOG_DIR | (ユーザーデータディレクトリ) | 月ごとにローテーションされる usage-YYYYMM.jsonl と clients.jsonl のディレクトリ |
LOCAL_DELEGATE_LOG | (空 = ローテーション有効) | 設定すると、ローテーションしない明示的な usage.jsonl のパスになります(互換性用) |
LOCAL_DELEGATE_MODEL_MECHANICAL | gemma3-4b | 分類、抽出、短い要約に使用するモデル |
LOCAL_DELEGATE_MODEL_LONG | gemma4-26b-a4b | 長文書用モデル |
LOCAL_DELEGATE_MODEL_CODE | qwen36-35b-a3b | コード用モデル |
LOCAL_DELEGATE_MODEL_VISION | gemma4-12b | local_describe_image 用の画像認識モデル |
LOCAL_DELEGATE_MAX_IMAGE_MB | 8 | local_describe_image の画像サイズ上限 |
LOCAL_DELEGATE_DUMP_CHUNK_NOTES | (空:無効) | 分割処理される各操作で、各ステップの出力を保存するローカルフォルダー。計測専用で、マシンの外部に送信されることはありません |
LOCAL_DELEGATE_LONG_INPUT_CHARS | 6000 | 機械処理↔長文処理の閾値 |
LOCAL_DELEGATE_CHUNK_CHARS | 3500 | 長文書を分割する際のチャンクサイズ(local_translate、local_delegate) |
LOCAL_DELEGATE_CHUNK_MAX_TOKENS | 2048 | チャンクあたりの max_tokens 上限 |
LOCAL_DELEGATE_CHUNK_MIN_CHARS | 400 | 最小チャンクサイズ:これより小さい場合は再分割しません |
LOCAL_DELEGATE_JSON_SCHEMA | auto | local_extract のスキーマ付き response_format:auto/on/off |
LOCAL_DELEGATE_FEEDBACK | 1 | source=path の場合、節約額の行を結果に追加します(0 で無効)。local_extract では JSON が壊れるためテキストには追加せず、_local_delegate 内に格納します |
LOCAL_DELEGATE_ALLOWED_DIRS | (空 = 制限なし) | path で許可するルート。; で区切ります |
LOCAL_DELEGATE_WEB | 1 | stdio モードに組み込まれた Web インターフェース(無効にするには 0) |
LOCAL_DELEGATE_WEB_HOST / _PORT | 127.0.0.1 / 9393 | Web インターフェースまたはデーモンのホスト/ポート |
LOCAL_DELEGATE_WEB_FONTS | 1 | Google Fonts からブランド書体を読み込みます(0 = サードパーティへのリクエストなし) |
LOCAL_DELEGATE_AUTOSTART | 0 | llama-swap の自動起動(オプトイン) |
LLAMASWAP_EXE / LLAMASWAP_CONFIG / LLAMASWAP_LISTEN | — | AUTOSTART=1 の場合のみ使用します。さらに LLAMASWAP_CONFIG は追加機能 [llamaswap] とともに、デーモンのターン制御とアフィニティを有効にします |
LLAMASWAP_WATCH_CONFIG | 0 | 1 にすると、自動起動したバックエンドに -watch-config を追加します |
LOCAL_DELEGATE_FALLBACK | 1 | モデル間のフォールバック:ある役割のモデルがそのモデル側の原因で失敗した場合、チェーン内の次のモデルが応答します(_MAX_HOPS=2。_<ROL> を含むチェーンについては Wiki を参照)。0 で無効になります |
LOCAL_DELEGATE_COOLDOWN | 1 | モデルのクールダウン:連続して3回失敗すると(_FAILURES)、120秒間停止し(_S)、最大900秒まで倍増します(_MAX_S)。0 で無効になります |
LOCAL_DELEGATE_COST_FALLBACK | (空 = サブエージェントでは claude-opus-5-5) | モデルが割り当てられていない委任を、どのモデルとスレッドで評価するかを指定します:modelo または modelo:main|subagent。無効な値でも問題は発生しません。パネルは宣言されたモデルを使い、その旨を表示します |
LOCAL_DELEGATE_COMMIT_LANGUAGE | (空 = 現在の言語) | local_commit_msg のメッセージの言語:es、en、fr、pt、de、it または任意の名称。空の場合は製品の現在の言語、diff の場合は diff 内のテキストの主な言語になります |
LOCAL_DELEGATE_OUTPUT_LANGUAGE | (空 = 現在の言語) | 自由記述のテキストツール(local_summarize、local_lint_summary、local_explain_code、local_describe_image)がモデルに応答を求める言語:fr、pt、português… インターフェースや local_commit_msg は変更しません |
LOCAL_DELEGATE_TURN_MAX_S | 600 | llama-swap で競合するモデル間のデーモンのターン制御:キューの先頭がこの秒数待機しており、かつバックエンドへの呼び出しが開始も完了もせずにデーモンがさらに同じ秒数経過している場合、ターンを与えます(ログでは turn: "forced") |
LOCAL_DELEGATE_SLOW_THRESHOLD | 0.5 | モデルの通常速度に対してこの割合を下回る速度で生成した場合、呼び出しは「低速」と見なされます(ログでは slow、パネルでは「低速 ×0,37」) |
LOCAL_DELEGATE_AFFINITY_MARGIN_S | 5 | アフィニティ:読み込み済みモデルは、TTL がこの秒数以上残っている場合にのみ再利用されます |
節約の指標
MCP は月ごとにローテーションするログに各呼び出しを記録し、範囲選択機能と進行中の委任の表示機能を備えた ダッシュボード を
http://127.0.0.1:9393 で提供します。
保持されたコンテキスト = サーバー側で読み込まれた入力(成功した source=path の呼び出し)から、ツールが返した内容を差し引いたものです。MCP が内容を分割しても、委任ごとに 1 回だけ 数えます。
文字数で測定し、トークナイザーのファミリーとコンテンツの種類(文章、コード、ログ、構造化データ、diff)ごとに測定した密度テーブルを使って Claude のトークン に換算します。.md と .json では換算量が異なり、Haiku 4.5 と Opus 5.5 でも異なります。画像はその数値には含まれず、別に表示されます。画像の寸法がなければ、Claude が消費するトークン数を知る方法がないためです。対して、ローカルコスト = すべての呼び出しで GPU が実際に消費したトークン数です。分割された委任では、各部分でシステムプロンプトが繰り返されます。その差が分割にかかったコストです。ここではバックエンドが報告する実際のトークン数を使います。報告がない場合、chars ÷ 4 は ローカル モデルの予備値にすぎません。詳細はWikiをご覧ください。
パネルには、API 価格に基づく推定額 も表示されます。同じコンテキストを Claude が定価で読み込んだ場合の費用で、下限額と、その内容がキャッシュから再度読み込まれたであろうリクエストを考慮した推定額の範囲で示されます。実際に節約した金額ではありません。サブスクリプションは定額制です。どのモデルに各委任を割り当てるか、後続のリクエスト数、適用した密度など、前提を明示した推定であり、同じファイルを再読込した分は差し引きません。その横には、異なるウィンドウの statusline から少なくとも 3 回測定するまで「未調整」と表示され、調整が完了するまでパーセンテージを表示しない クォータ のブロックがあります。過去の記録にモデルを割り当て、この 2 つのブロックにデータを反映するには、ときどき local-delegate recompute-cost を実行してください(ローカルでトランスクリプトを読み取り、集計値のみを書き込みます)。doctor は、トランスクリプトがまもなくなくなる委任があれば警告します。
テストは集計対象外です。スクリプトの mcp クライアントによる委任、ベンチマークによる委任、およびテストウィンドウ中に発生した委任は、パネルと local_status から除外されます。MCP またはデーモンに対して実環境でテストする前に、期間を指定して、表示された ID を保存してください。
local-delegate test-window start --label "prueba del lunes"   # imprime el id
local-delegate test-window stop <id>
local-delegate test-window list                               # ventanas y filas en cada una
パネルのバーにある テスト ボタンを押すと、除外された項目が再表示されます。その ⓘ には、除外された項目数が表示されます。
パネルはブラウザーの言語に応じてスペイン語または英語で表示され、ヘッダーの ES/EN セレクターで切り替えられます(そのブラウザーに設定が保存されます)。Savings & metricsをご覧ください。
範囲、グラフの日付、表の時刻にはお使いのタイムゾーンが使われます(ログは UTC で記録されます。UTC は曖昧さのない時刻であり、変換は表示上のものです)。ダッシュボードでは、計算を実行した場所も区別されます。バックエンドがループバックで待ち受けている場合は local、推論を別のマシンで行った場合は remote です。たとえば、この Mac が PC の GPU を使う場合が該当します。v0.11.0 より前のイベントにはこのフィールドがないため、n/d と表示されます。
範囲/対象外
local-delegate は意図的にテキスト/画像→テキストに限定されています。プロンプト(またはマルチモーダルのペイロード)を組み立て、/chat/completions に POST して、テキストのみを返します。意図的に行わないことは次のとおりです。
- ローカルでのツール呼び出し。 ローカルモデルはツールを呼び出したり、コードを実行したりしません。これは引き続き Claude が行います。これを追加すると、このパッケージは並列のオーケストレーターになってしまいますが、それは目的ではありません。
- 画像の生成または編集。
local_describe_imageは画像→テキスト専用です(説明、表示されているテキストの読み取り、具体的な質問への回答)。画像の生成や編集は行いません。 - 音声。 文字起こしには、音声をここに無理に組み込むのではなく、コンパニオンの
whisper-transcribe-mcpを使用します。 - サブスクリプションの置き換え。 目的は、範囲を限定した機械的な手順を委譲して利用枠を温存することであり、すべての作業をローカルモデルに振り分けることではありません。
クライアントとの統合:フック、スキル、メモリー
local-delegate install を実行すると、HOME で統合一式が設定されます。
| コンポーネント | 場所 | 機能 |
|---|---|---|
| MCP エントリー | Claude Code の設定/~/.codex/config.toml/~/.config/opencode/opencode.json[c] | サーバーを登録します(uvx を使った stdio、またはデーモンへの HTTP) |
| フック | ~/.claude/hooks/local-delegate/ + settings.json | 委譲を提案します。読み取り用のフックは、設定を有効にするとドキュメント全体の読み取りを拒否することもできます。もう一つは、どのエージェントが各委譲を要求したかを記録します |
| スキル | ~/.claude/skills/local-delegation/ および ~/.config/opencode/skill/local-delegation/ | 基本原則とツールのカタログ |
| メモリー | ~/.claude/CLAUDE.md、~/.codex/AGENTS.md、~/.config/opencode/AGENTS.md 内の管理対象ブロック | 常に読み込まれる短いメモとしてルールを記載します |
デフォルトでは、インストール済みのクライアントのみ設定されます。--clients claude|codex|opencode を使って手動で選択することもできます。フックに対応しているのは Claude Code のみです。opencode は TypeScript のプラグインで拡張できますが、これは別の仕組みであり、Claude Desktop はフックにまったく対応していません。各要素は個別に除外できます(--no-hooks、--no-skill、--no-memory、--no-mcp)。
すべてスペイン語または英語で出力されます。install と update は、実行時のセッション言語(LOCAL_DELEGATE_LANG=es|en、またはシステムの言語)を language.json に保存し、デーモンとフックでも使えるようにします。また、スキル、メモリーブロック、サブエージェントのカタログもその言語で書き込みます。優先順位とシステム設定に戻す方法については、
言語を参照してください。
自動でインストールされるフックは 2 つだけです。UserPromptSubmit(機械的な意図)と record_call.py(local-delegate のツールに対する PreToolUse)です。これらは通知もブロックも行わず、各委譲をどのエージェントがどの程度の労力で要求したかを記録し、相当するモデルのコストを割り当てます。読み取り用の 2 つ(PreToolUse/Read と PreToolUse/Bash|PowerShell)は、--enable-read-hook を指定するまで無効です。このオプションを指定すると両方が登録され、有効になります(uninstall で無効になります)。これらが一組なのは、2 つの経路に対する 1 つのルールだからです。Read ツールを閉じて cat informe.md を使えるままにしても、動作は変わらず、場所が移るだけです。
この 2 つは警告を出します。読み取りの拒否は別の機能で、初期状態では無効です(LD_HOOK_READ_BLOCK)。ローカルバックエンドが応答している場合に限り、大きな .md または .txt の全体読み取りを対象とします。拒否メッセージには、使用可能なツールと緊急時の代替手段が示されます。範囲を区切った読み取りがブロックされることはありません。この機能が用意されている理由は、提案だけでは行動が変わらないことが 4 回の測定で確認されているためです。
統合のインストールおよび
docs/recipes/claude-code-hooks.mdを参照してください。
llama-swap のグループ(オプション)
pip install "local-delegate-mcp[llamaswap]" を実行すると、llama-swap の グループ(交代で使うプールと、希望した場合に限り読み込み状態を維持するモデル)を管理する CLI が利用可能になります。VRAM とシステム RAM のガードレールが組み込まれています(--ram-gb はオプションです。llama-server
は計算処理が 100% GPU で行われる場合も GGUF を RAM にマッピングするため、VRAM に収まるカタログでも、32 GB 未満のマシンでは RAM を使い切ることがあります)。
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --swap gemma3-4b,gemma4-26b-a4b,qwen36-35b-a3b --vram-gb 16 --ram-gb 32
local-delegate llamaswap residency            # qué se queda cargado y con qué TTL; no escribe
local-delegate llamaswap residency --none --ttl gemma3-4b=120   # volver a «ningún residente»
推奨は常駐モデルなしです。デーモンの順番制御により、競合するモデルはバックエンドを奪い合わずに共有できます。また、そのツールに承認済みのセルがあれば、読み込み済みのモデルを活用できます(Tools を参照)。常駐はオプトインです。
init-llamaswap --resident ID または llamaswap residency --pin ID を実行すると、そのモデルは persistent グループに配置され、ttl: 0 が設定されます。これにより、VRAM が永久に確保されます(--pin は --vram-model ID=GiB で各モデルの実測 VRAM を指定するよう求め、残りのモデルの最悪ケースと合わせて収まらない場合は拒否します)。--ttl-resident のデフォルト値は 0 です。persistent の TTL が 0 より大きい場合、モデルは同様にアンロードされるため、実際には常駐しません。
このパッケージが独自に config.yaml を変更することは決してありません。これらのコマンドは、ユーザーが実行した場合にのみ動作します。init-llamaswap は書き込み前にガードレールを実行し、VRAM に収まらない場合、または --ram-gb を指定していて RAM に収まらない場合は、何も書き込みません。また、--force を指定しない限り上書きせず、<config>.<AAAAMMDD-HHMMSS>.bak というコピーを残します。llamaswap residency は変更が必要な行だけを編集し、同じ形式で日付付きのコピーを残します。処理中の委譲がある場合(--now を除く)は書き込みを行わず、再読み込み時に llama-swap が行ったことを報告します。詳細、llama-swap のコードで検証済みの groups の仕様、および適用手順については、docs/recipes/llama-swap-groups.md を参照してください。
リンク
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。