关于 bricksentry
bricksentry 在 Databricks 流水线变更上线前检查数据影响、下游依赖和回滚方案,面向数据工程师与 AI Agent。它提供确定性的策略判定,也支持本地 DuckDB 演示和 Databricks 工作流。
主要功能
- 01基于键的数据差异与架构检查
- 02Unity Catalog 下游影响分析
- 03策略判定与回滚 SQL
- 04命令行、Python API、MCP 服务和 GitHub Action
- 05在沙箱中预览写入语句
适用场景
- 01在拉取请求中审查流水线变更
- 02编辑表前检查下游影响
- 03预览写入且不触及生产环境
- 04为 Agent 提供确定性的安全检查
MCP 相关
其 MCP 服务提供工具,用于查询下游资产、生成回滚方案、在一次性克隆上预览写入、评估变更、解释差异并判断变更是否可发布。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx bricksentry-mcpBRICKSENTRY_CONFIGPath to your bricksentry.yml (backend, tables and policy).DATABRICKS_HOSTDatabricks workspace URL, when using the Databricks backend.DATABRICKS_TOKEN密钥Databricks access token, when using the Databricks backend.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
欢迎使用 bricksentry




AI 时代的数据变更安全检查。
为 Databricks 工作流及编辑这些工作流的 AI Agent 提供变更安全保障:在变更上线前,了解它会如何影响你的数据。
30 秒即可试用 · 运行 Databricks 笔记本 · 文档:bricksentry.org · LinkedIn
由 Databricks Champion Brahmareddy 构建。基于 Apache-2.0 开源。
名称的由来? Bricks 加上 entry。你的表和工作流是 lakehouse 的砖块,而对它们的每次变更都是一条记录。bricksentry 会检查每条记录、报告其影响,并在变更落地前把好关。
30 秒即可试用(无需 Databricks)
pip install "bricksentry[duckdb]"
bricksentry demo
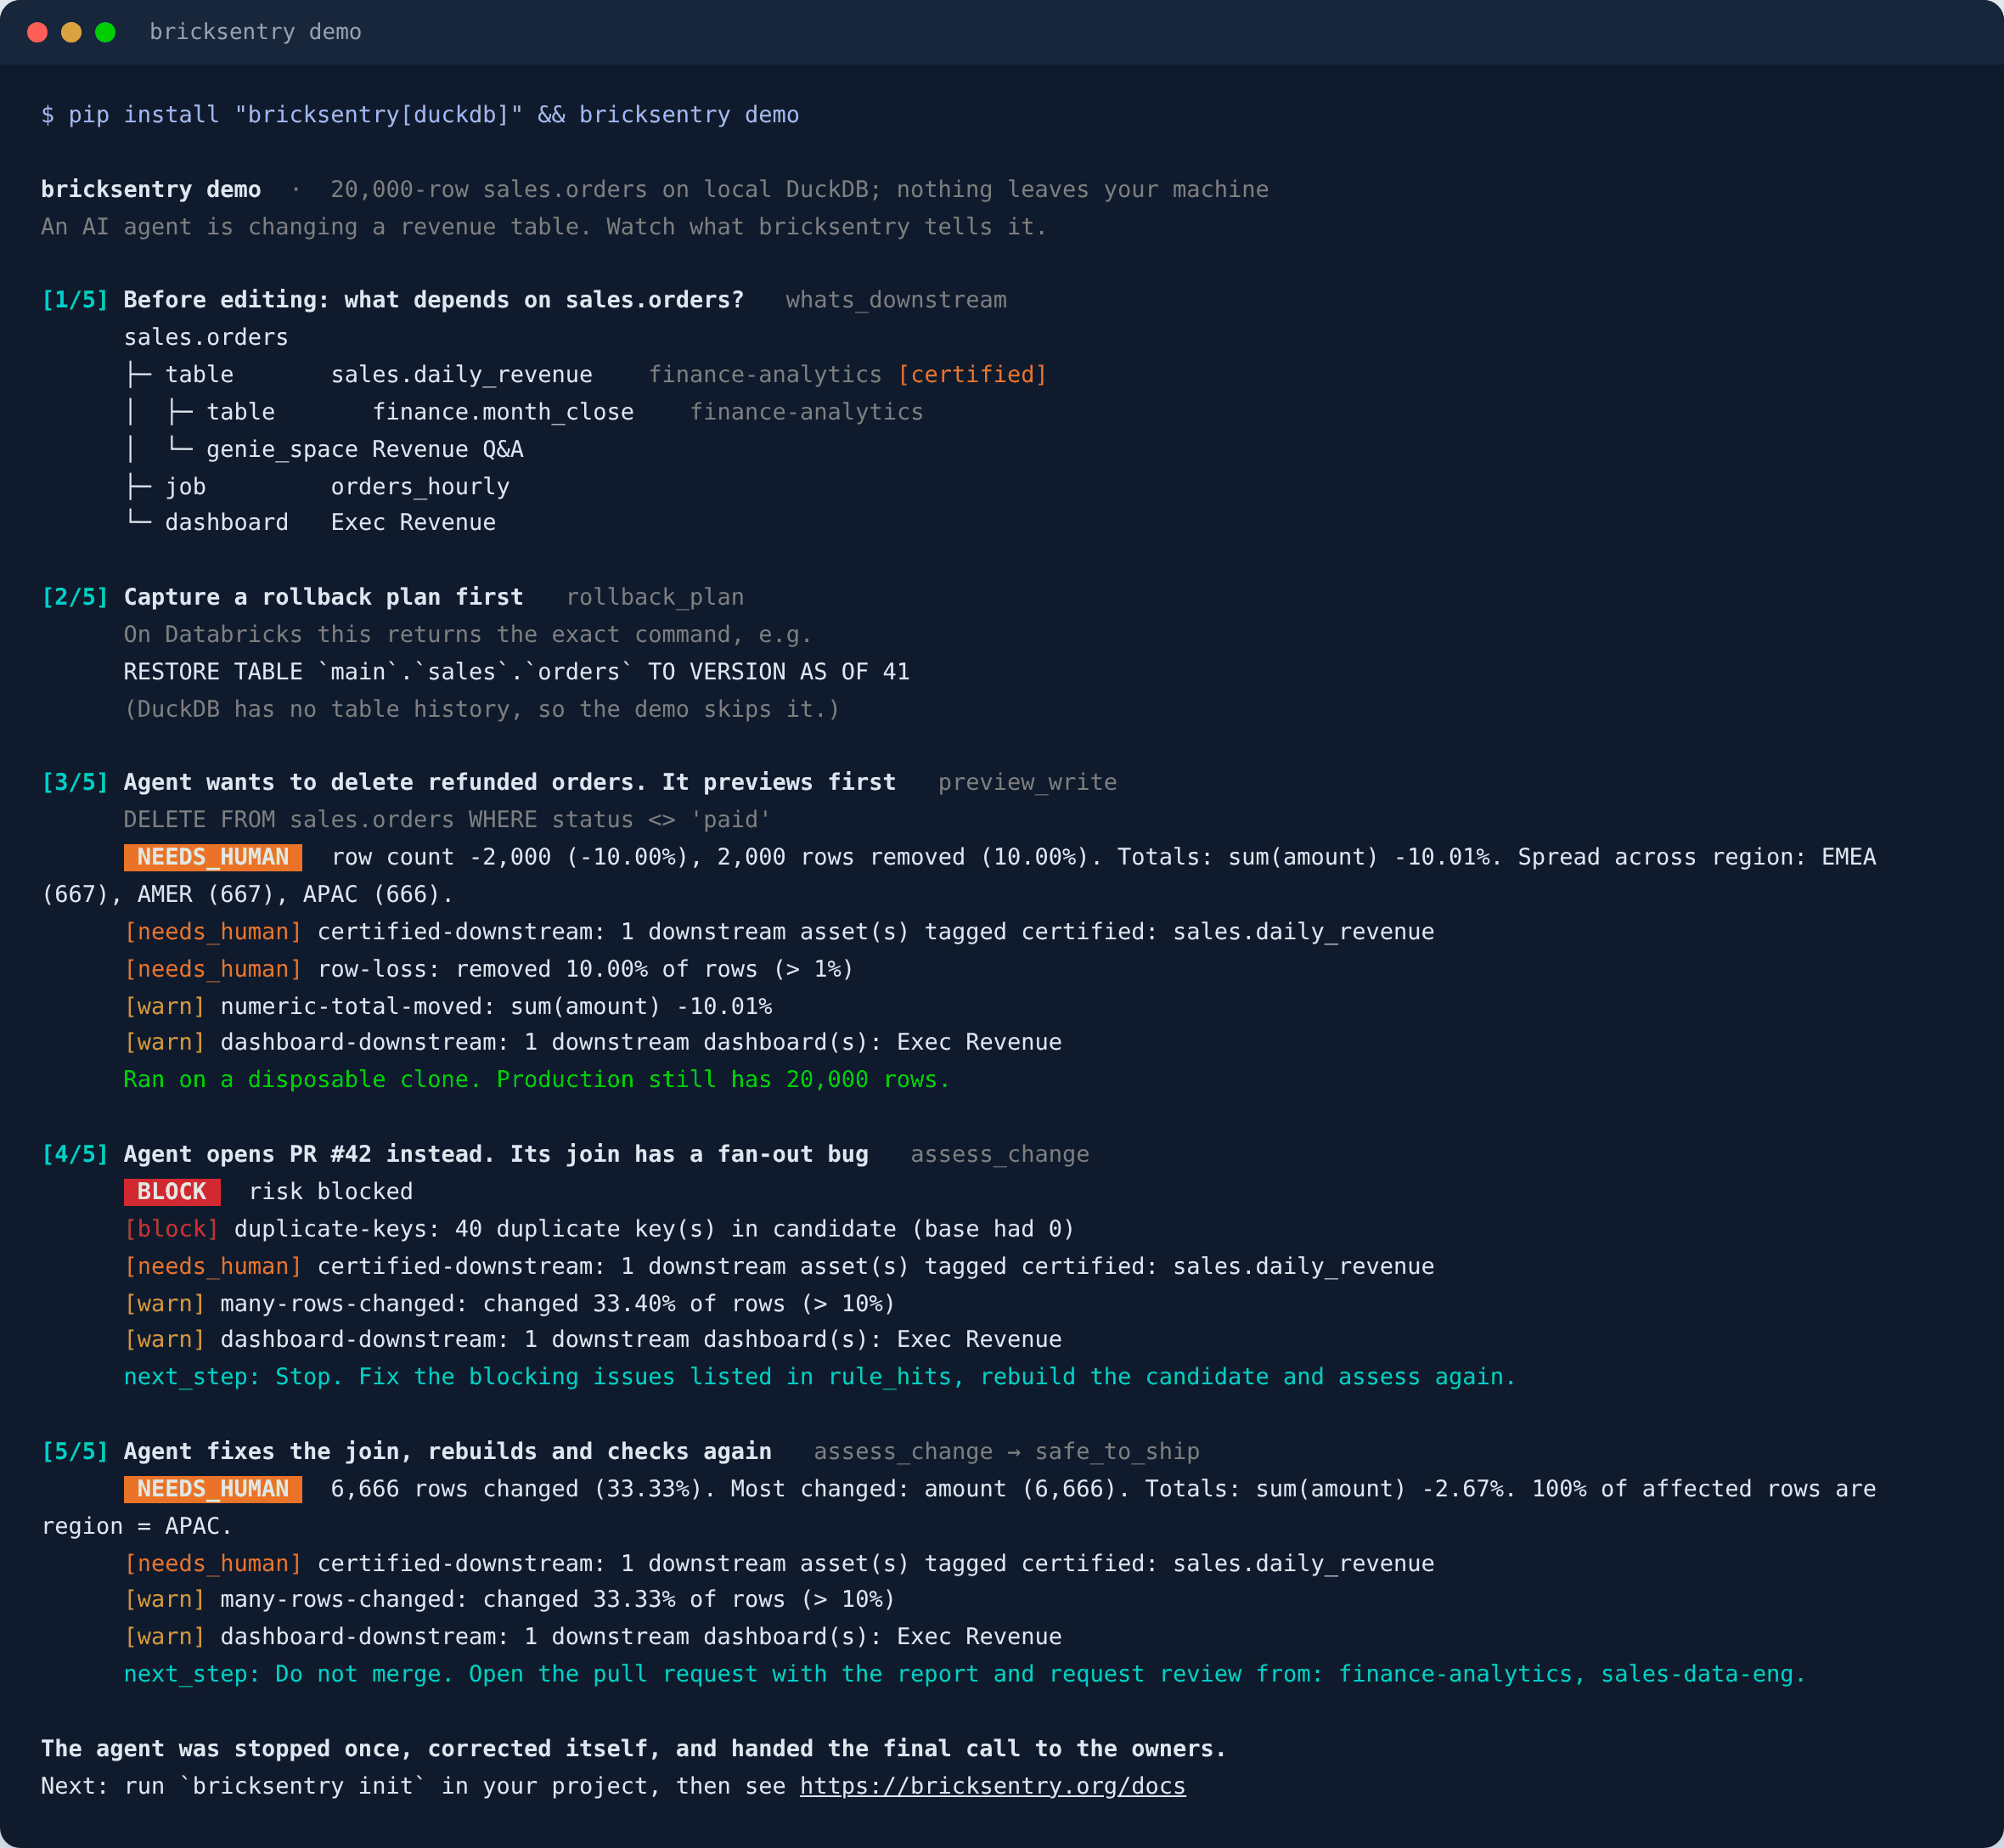
AI Agent 修改一张包含 20,000 行的收入表。bricksentry 在克隆表上预览它的 DELETE 操作(不触及生产数据),因一条连接导致 40 个订单重复而阻止其拉取请求,并将修复后的版本转给下游认证表的负责人。所有操作都在本地通过 DuckDB 运行。
在 Databricks 工作区中运行
上次工作流运行做了什么?(10 分钟,只读)
**检查我的表笔记本:**在工作区中,前往 Workspace → Import → URL 并粘贴
https://raw.githubusercontent.com/bricksentry/bricksentry/main/examples/databricks/bricksentry_check_my_table.py
将检查我的表笔记本指向工作流写入的 Delta 表。它会从表的历史记录中找到最新的数据变更(WRITE、MERGE、UPDATE 或 DELETE),将其与之前的版本进行比较,并显示审核者在变更上线前会看到的评估结果:新增、删除和变更的行、重复键、发生变化的汇总值、依赖该表的内容,以及用于撤销变更的 RESTORE 命令。它只会读取你的表;比较操作使用临时架构中的两个浅克隆,并在结束时删除它们。
如果它发现了问题,请分享发现(无需提供表名)。真实结果将决定接下来要构建什么。
使用演示数据的引导体验
**Databricks 快速入门笔记本:**在工作区中,前往 Workspace → Import → URL 并粘贴
https://raw.githubusercontent.com/bricksentry/bricksentry/main/examples/databricks/bricksentry_quickstart.py
快速入门笔记本 会在你选择的架构中创建一个小型演示表,并在 Databricks 上运行同一套流程:Unity Catalog 影响范围分析、真实的 RESTORE 回滚计划、在浅克隆表上预览、拦截拉取请求并修复。随后,它会以只读方式检查你自己的一个表,并在结束后清理所创建的内容。
你需要一个 SQL 仓库、对所选架构的 CREATE TABLE 权限,以及对 system.access.table_lineage 的 SELECT 权限,才能分析影响范围。Jupyter 版本见 bricksentry_quickstart.ipynb。
功能
在变更进入生产环境之前,bricksentry 会通过拉取请求评论向人类提供答案,并以结构化 JSON 形式向 Agent 提供答案,解答三个问题:
- **数据会受到什么影响?**基于键的数据差异:新增、删除和变更的行、架构变更、各列变更、数值汇总、重复键,以及变更集中在何处(“受影响的行中有 100% 的 region = APAC”)。
- **谁会受到影响?**基于 Unity Catalog 血缘关系分析下游影响范围:表、作业、笔记本、Lakeflow 管道、仪表板和查询,以及相应的所有者和标签。精确到列:变更触及了哪些列、这些列是否带有标签(例如
pii),以及它们会影响哪些下游列。 - **是否安全,以及如何撤销?**确定性的策略判定(
pass·warn·needs_human·block),以及准确的RESTORE TABLE … VERSION AS OF n回滚命令。
针对你的 Databricks 工作区:
pip install "bricksentry[databricks,mcp]"
bricksentry init        # writes bricksentry.yml and policy.yml
项目缘由
如今,我们的大部分管道代码都由 AI 编写,但检查这些代码对数据的影响却没有跟上。代码审查无法发现悄无声息的 3% 营收变化,也看不出会导致行数倍增的联接操作。能发现这些问题的工具大多只支持 dbt,或者需要付费平台。Databricks 上的大多数工作都通过 PySpark 笔记本、Jobs 和 Lakeflow 管道完成,bricksentry 正是为这类工作打造的:
- Unity Catalog 运行时血缘关系,而非 SQL 解析,因此也涵盖 PySpark 笔记本和作业。
- SQL 下推:所有差异计算都在你的 SQL 仓库上运行,因此无需 Spark 会话,调用成本也足够低,适合 Agent 循环。
- 一个引擎,三种形式:CLI 和 GitHub Action · Python API · MCP 服务。
面向 AI Agent:MCP 服务
连接 Agent 的最快方式是使用 bricksentry-mcp 软件包,它会安装带有 MCP 和 Databricks 扩展的 bricksentry。使用 uv 时,无需预先安装任何内容:
# Claude Code
claude mcp add bricksentry -- uvx bricksentry-mcp --config /full/path/to/bricksentry.yml
{
  "mcpServers": {
    "bricksentry": {
      "command": "uvx",
      "args": ["bricksentry-mcp", "--config", "/full/path/to/bricksentry.yml"]
    }
  }
}
此 JSON 适用于 Claude 桌面应用、Cursor 和其他 MCP 客户端。请使用 bricksentry.yml 的完整路径,因为客户端会从自己的工作目录启动服务。如果应用找不到 uvx,请使用它的完整路径(which uvx)。若要通过仓库共享此配置,运行 claude mcp add -s project ... 会将配置写入 .mcp.json;当 Claude Code 从仓库根目录启动时,相对路径即可生效。还没有配置文件?运行 uvx --from bricksentry bricksentry init 即可生成初始配置。
如果已经通过 pip 安装了 bricksentry?运行 pip install "bricksentry[mcp,databricks]",然后改用 bricksentry mcp --config /full/path/to/bricksentry.yml。添加 --transport streamable-http 可供远程 Agent 使用。
bricksentry 已列入官方 MCP Registry,名称为 io.github.bricksentry/bricksentry。
| 工具 | Agent 可获取的内容 |
|---|---|
whats_downstream(table, depth, columns?) | 包含所有者和标签的下游资产。编辑前先调用。传入要修改的列,即可查看它们所影响的下游列及其标签。 |
rollback_plan(table) | 还原 SQL。在进行任何修改前先保存。 |
preview_write(sql, target, keys?) | 在一次性浅克隆上执行一次写入,绝不访问生产环境,并返回差异和判定结果。 |
assess_change(tables, candidates?, pr?) | 比较生产环境与此次更改构建的候选版本,同时检查数据血缘和策略。返回判定结果和 id。 |
explain_diff(assessment_id or table) | 通俗易懂的摘要。 |
safe_to_ship(assessment_id) | 返回 safe_to_ship、原因,以及明确的 next_step 供后续执行。 |
专为 Agent 设计:
- 判定结果绝非由 LLM 给出。 由
policy.yml中的规则决定,因此同一项更改始终得到相同的答案。 - 默认只读。 只有
preview_write会写入,且只写入沙盒克隆。它接受单条 INSERT / MERGE / UPDATE / DELETE / CREATE OR REPLACE 语句,目标必须是克隆;并且会拒绝 DROP、TRUNCATE、ALTER、GRANT 和多条语句。 - 错误会以
{"error": ...}的形式返回,Agent 可以据此恢复,而不会崩溃。 - 成本有上限: 使用确定性哈希抽样(
sample_pct)、限制样本数量,并按深度和回溯时间窗口限制数据血缘。全表校验和会保护抽样结果:如果样本显示没有变化,但表之间存在差异,就会对每一行重新运行差异比较,避免漏掉单行更改。 - 评估结果会保存为 JSON(默认位于
~/.bricksentry/assessments),因此explain_diff和safe_to_ship可以在其他进程或新建的Sentry中使用。
这些工具也以普通 Python 函数的形式提供于 bricksentry.agent_tools,因此无需 MCP 即可在 LangGraph、OpenAI Agents SDK 或 Databricks Agent Framework 中使用。
若要查看完整流程,请运行 bricksentry demo(参见本页顶部)。运行 bricksentry demo --report report.md 还会生成审核者可见的拉取请求评论。
在工作区中托管(Databricks Apps)
将 MCP 服务作为 Databricks App 运行,让工作区中的每个 Agent 都能通过 HTTPS 访问,无需管理令牌:它以应用的服务主体身份运行,可读取的内容由 Unity Catalog 授权决定。deploy/databricks-app 是一个可直接部署的应用(包含 app.yaml、Asset Bundle 和授权配置),只需运行两条命令即可完成部署:
databricks bundle deploy --var warehouse_id=<your-sql-warehouse-id>
databricks bundle run bricksentry_mcp
Agent 通过 https://<app-url>/mcp 连接。该套件使用 --read-only 启动服务,因此不会包含 preview_write,应用也就不会写入数据。在其他任何主机上,运行 bricksentry mcp --transport streamable-http --host 0.0.0.0 --port 8000 即可提供相同的端点。Unity Catalog MCP Services 面向托管在 Databricks 之外的服务,因此推荐使用 Databricks App 在 Databricks 内运行 bricksentry;请参阅套件的 README。
面向数据工程师:CLI 和 CI
bricksentry init                                        # starter bricksentry.yml + policy.yml
bricksentry init --policy finance                       # ...or start from a policy template
bricksentry policies                                    # list the policy templates
bricksentry impact main.sales.orders                    # blast radius
bricksentry diff main.sales.orders main.sales_pr_42.orders
bricksentry preview main.sales.orders --sql "MERGE INTO {{target}} t USING updates u ON t.order_id = u.order_id WHEN MATCHED THEN UPDATE SET *"
bricksentry assess --from-git origin/main --pr 42 --format markdown --fail-on needs_human
bricksentry rollback main.sales.orders
退出码:低于 --fail-on 时为 0,达到或超过该级别时为 1,配置错误时为 2。
在 GitHub Actions 中。 将 PR 对应版本的管道构建到每个 PR 专属的 schema 中(例如,使用 Databricks Asset Bundle 的 ci 目标),然后添加:
- run: pip install "bricksentry[databricks]"
- run: >
    bricksentry assess
    --from-git origin/${{ github.base_ref }}
    --pr ${{ github.event.pull_request.number }}
    --comment --output bricksentry-report.md
    --fail-on needs_human
  env:
    GITHUB_TOKEN: ${{ github.token }}
    DATABRICKS_HOST: ${{ secrets.DATABRICKS_HOST }}
    DATABRICKS_CLIENT_ID: ${{ secrets.DATABRICKS_CLIENT_ID }}
    DATABRICKS_CLIENT_SECRET: ${{ secrets.DATABRICKS_CLIENT_SECRET }}
    DATABRICKS_WAREHOUSE_ID: ${{ secrets.DATABRICKS_WAREHOUSE_ID }}
它会根据 PR 中的文件检测已更改的表,并发布或更新一条 PR 评论,如下方针对演示中扇出错误的示例:
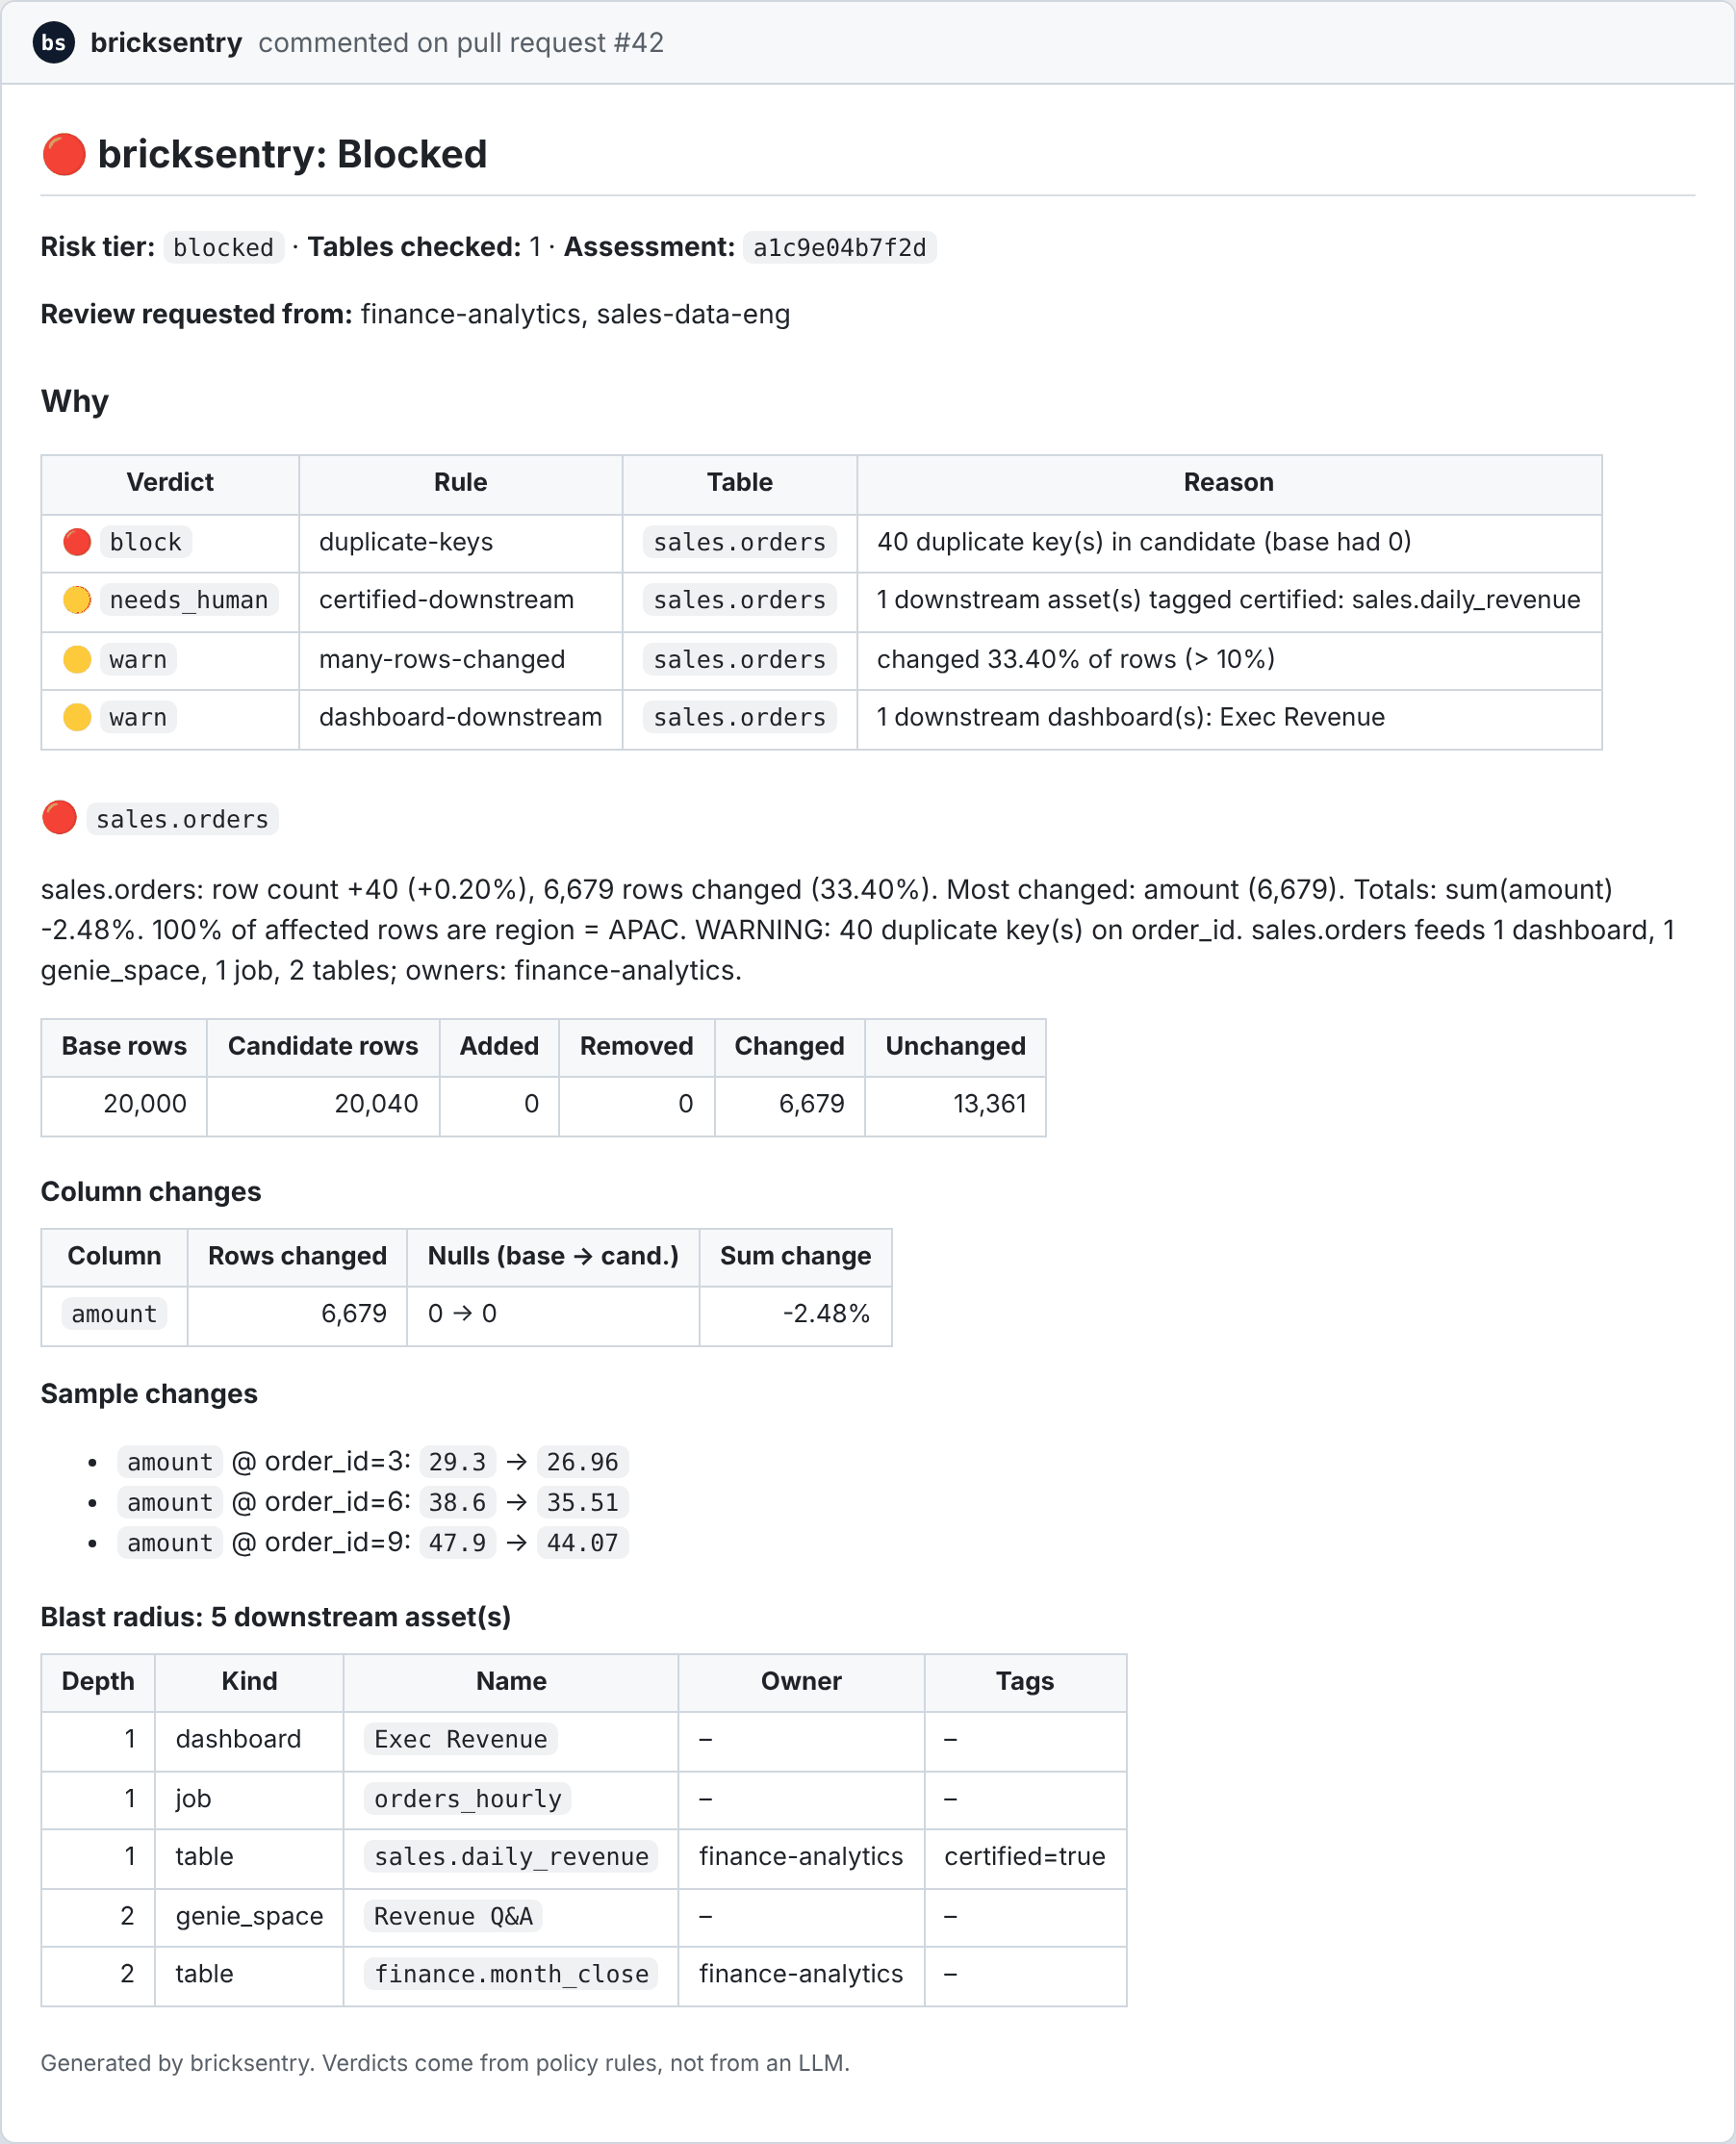
检出代码时使用 fetch-depth: 0,并为作业授予 pull-requests: write 权限。
也可以使用捆绑的 GitHub Action,它还会将报告写入作业摘要:
- uses: bricksentry/[email protected]
  with:
    config: bricksentry.yml
    fail-on: needs_human
可复制到 .github/workflows/bricksentry.yml 的完整工作流:
name: bricksentry
on: pull_request

permissions:
  contents: read
  pull-requests: write

jobs:
  check-data:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      # Build this PR's version of your pipeline into a per-PR schema first,
      # for example: databricks bundle deploy -t ci && databricks bundle run -t ci
      - uses: bricksentry/[email protected]
        with:
          config: bricksentry.yml
          fail-on: needs_human
          slack-webhook: ${{ secrets.SLACK_WEBHOOK_URL }}    # optional
          teams-webhook: ${{ secrets.TEAMS_WEBHOOK_URL }}    # optional
        env:
          DATABRICKS_HOST: ${{ secrets.DATABRICKS_HOST }}
          DATABRICKS_CLIENT_ID: ${{ secrets.DATABRICKS_CLIENT_ID }}
          DATABRICKS_CLIENT_SECRET: ${{ secrets.DATABRICKS_CLIENT_SECRET }}
          DATABRICKS_WAREHOUSE_ID: ${{ secrets.DATABRICKS_WAREHOUSE_ID }}
要让检查成为合并的硬性门槛,请在分支保护规则中将此作业标记为必需状态检查。这样,无论作者还是 Agent 作出什么决定,只要判定结果为 needs_human 或 block,就会阻止合并。
Slack 和 Teams 中的提醒
当判定结果为 needs_human 或更严重时,bricksentry 可以发送简短提醒,其中包含判定结果、触发的规则、应由谁审核,以及返回检查运行位置的链接。
# bricksentry.yml
notify:
  on: needs_human                         # alert at this verdict or worse
  slack_webhook: env:SLACK_WEBHOOK_URL    # Slack incoming webhook
  teams_webhook: env:TEAMS_WEBHOOK_URL    # Teams Workflows "webhook request" URL
  mentions:                               # optional: @-mention reviewers in Slack
    finance-analytics: S0123ABCD          # a user group id (starts with S)
    [email protected]: U0456EFGH              # a member id (starts with U)
然后用一条命令检查设置。它会发送一条明确标注的示例提醒,不会读取任何表:
bricksentry test-alert
- 请妥善保管 Webhook URL。 将其放在 CI 密钥或环境变量中(也可以使用
BRICKSENTRY_SLACK_WEBHOOK和BRICKSENTRY_TEAMS_WEBHOOK),切勿写入文件;bricksentry 会在发现文件中包含 Webhook URL 时发出警告。 - 返回运行位置的链接。 在 GitHub Actions 中,提醒会链接到 PR 或运行记录。在 Databricks 作业中,它会链接到作业运行记录。在其他环境中,请设置
BRICKSENTRY_RUN_URL(或notify.run_url)。 - 提及用户。 所有者信息来自 Unity Catalog。在
mentions下将所有者映射到 Slack ID 后,提醒就会 @提及他们;未映射的所有者会以文本形式显示。可在 Slack 中打开某人的个人资料或用户组菜单,选择“Copy member ID”/“Copy group ID”来查找 ID。 - 运行不会因此中断。 设置了 Webhook 后,
assess和preview会自动发送提醒(--no-notify可关闭此功能);在 Python 中调用sentry.notify(assessment)。如果 Slack 或 Teams 繁忙,提醒会重试一次;失败时会报告错误,但不会泄露 Webhook URL,且判定结果始终有效。
Python API
from bricksentry import Sentry

s = Sentry()                                   # reads ./bricksentry.yml
a = s.assess(["main.sales.orders"], pr="42")
print(a.verdict, a.notify)
print(a.tables[0].summary)

s.preview_write("DELETE FROM main.sales.orders WHERE status = 'test'", "main.sales.orders")
配置
backend: {type: databricks, warehouse_id: abc123}      # auth: standard Databricks SDK chain
sandbox_schema: main.bricksentry_sandbox
candidate_pattern: "{catalog}.{schema}_pr_{pr}.{table}"
sample_pct: 10                                         # sample_guard re-checks the whole table (on by default)
assessment_store: ~/.bricksentry/assessments           # or false to keep assessments in memory
lineage: {type: databricks, depth: 3, lookback_days: 90, column_depth: 2}   # also: exclude, exclude_dropped
tables:
  main.sales.orders:
    keys: [order_id]
    segment_by: [region]
    measures: [amount, quantity]   # totals worth checking (see below)
    paths: ["src/pipelines/orders/**", "resources/orders_job.yml"]
policy: policy.yml            # or builtin:<template>, see "Policy templates" below
不使用 Unity Catalog(本地 DuckDB 工作、测试或其他平台)时,请改为在配置中提供血缘关系。边表示某个表被哪些对象读取;列边和标签是可选的:
lineage:
  type: static
  edges:
    main.sales.orders: [main.sales.daily_revenue, "dashboard:Revenue Overview", "job:finance_close"]
  owners:
    main.sales.daily_revenue: finance-team
  tags:
    main.sales.daily_revenue: {certified: "true"}
  column_edges:                       # "table.column" -> downstream "table.column"s
    main.sales.orders.amount: [main.sales.daily_revenue.revenue]
  column_tags:                        # table -> column -> tags
    main.sales.orders: {customer_email: {pii: ""}}
拼写错误会被捕获:对于 sample_pc 这类未知键,系统会打印一条警告,指出正确的键(did you mean 'sample_pct'?),而不是静默忽略。
检查哪些总和。 sum_change_pct_gt 规则和摘要会检查度量:默认情况下,检查除键和名称看起来像 ID、代码、年份及其他日期部分、坐标、评分、分数或比率的列之外的所有数值列(sum(established_year) 下降 10% 只能说明行被删除了)。为某个表列出 measures,即可精确选择要检查的列;也可以设置 measures: all 来检查所有数值列。指定列的规则(when: {column: rating, sum_change_pct_gt: 1})始终会检查该列。
策略示例
一个精简的 policy.yml,每种严重级别各包含一条规则。pass 是默认值:没有规则匹配时,变更会得到此结果。
default: pass                       # no rule matched -> pass
notify_owners_on: needs_human       # tag downstream owners from this level up

rules:
  - name: type-change               # a column changed type -> warn
    when: {column_type_changed: true}
    then: warn

  - name: revenue-moved             # total revenue moved more than 2% -> a human signs off
    when: {column: amount, sum_change_pct_gt: 2}
    then: needs_human

  - name: duplicate-keys            # a join fanned out and duplicated keys -> block the PR
    when: {duplicate_keys: true}
    then: block
| 变更 | 判定 |
|---|---|
| 修复筛选条件,导致 40 行发生变化,其他方面均无变化 | pass |
order_date 从 STRING 变为 DATE | warn |
修复定价问题,使 SUM(amount) 变化 3.1% | needs_human |
新增的联接导致 40 个 order_id 重复 | block |
如果多条规则匹配,则采用严重程度最高的规则。完整的入门策略位于 examples/databricks/policy.yml,运行 bricksentry init 也会为你生成一个策略。
策略模板
从现成的策略开始,而不是从头编写:
| 模板 | 适用场景 |
|---|---|
agent-safe | AI Agent 编写的变更:任何超出小幅、干净变更范围的内容都会交由人工处理 |
default | 均衡策略:阻止重复键;行数减少、列被删除、涉及 PII 或下游认证数据时交由人工处理 |
strict | 对生产至关重要的工作流:小幅变更也需要人工处理,检查失败则阻止变更 |
pii | 包含个人数据的表:任何涉及带有 pii 标签的表或向其提供数据的表的变更,都需要人工处理 |
certified | 仪表板和 AI 所依赖的认证表或 gold 表 |
finance | 收入和金额表:总和不能悄然变化,并阻止重复计数 |
直接使用 policy: builtin:finance,或运行 bricksentry init --policy finance 创建可编辑副本。运行 bricksentry policies finance 可打印该策略。标签来自 Unity Catalog,因此请为表添加 pii 或 certified 标签,以应用对应模板。
策略条件
table(glob) · tag · downstream_tag · downstream_kind · downstream_count_gt · removed_pct_gt · added_pct_gt · changed_pct_gt · row_count_change_pct_gt · row_count_drop_pct_gt · column_removed · column_added · column_type_changed · duplicate_keys · null_keys · sum_change_pct_gt / null_increase_gt(可选带 column)· changed_column(glob)· changed_column_tag · downstream_column_tag · any_change · diff_error · lineage_error
列条件只检查变更涉及的列(值发生变化、新增 NULL、被删除或更改类型的列):changed_column_tag: pii 在其中一列带有 Unity Catalog 的 pii 标签时匹配;downstream_column_tag: certified 则在其中一列向带有 certified 标签的列提供数据时匹配,追踪范围为 system.access.column_lineage 中最多 lineage.column_depth 跳(默认值为 2;0 表示关闭)。默认策略会在 pii 列发生变化时要求人工处理;strict、agent-safe 和 certified 也会标记会影响认证列的变更。
when 中的所有条件都必须满足。匹配规则中严重程度最高的一条决定判定结果。加载时会拒绝未知条件,因此拼写错误不会导致规则被静默禁用。
Databricks 所需权限
- SQL 仓库上的
CAN USE权限。 - 对要评估的表及其候选表拥有
SELECT权限。 - 对
system.access.table_lineage拥有SELECT权限(如需查看列级影响,还需对system.access.column_lineage拥有SELECT权限),并对system.information_schema拥有SELECT权限,以获取所有者、表标签和列标签。没有血缘访问权限时,bricksentry 仍会执行差异比较,并添加lineage-unavailable警告(影响范围未知),而不是猜测。 - 对
sandbox_schema拥有CREATE TABLE权限,以便使用preview_write。
已知限制(v0.1.x)
- 血缘在运行时记录。 新建表目前还没有下游历史记录。Unity Catalog 不会捕获 RDD 操作,而 UDF 会隐藏列级映射;列血缘记录的是源到目标的派生关系,因此仅用于筛选或连接的列可能不会出现。
- 必须有键。 尚无法对没有稳定键的表逐行执行差异比较(计划支持聚合配置文件模式)。
- 变更表检测使用配置中的路径 glob。 目前还不会解析 Asset Bundles。
- 目前仅在一个 Databricks 工作区上完成验证(无服务器,2026 年 11 月,使用 200 万行的表和 0.1.4):血缘、Delta 回滚计划、浅克隆上的预览、所有判定等级,以及检测单行变更的采样保护。自动化测试使用 DuckDB 和模拟的 SDK,因此如果你的环境中表现不同,请提交问题。
路线图
首要任务:在更多工作区进行验证。 经典和无服务器计算、AWS、Azure 和 GCP,以及系统表访问受限的工作区。如果你运行快速入门笔记本,请分享你的体验,无论是否运行成功。
接下来:支持 dbt,让 Databricks 上的 dbt 模型也能进行相同的差异比较、影响范围分析和判定(计划在 0.2 中推出)· 支持解析 Asset Bundle,以自动检测表 · 为无键表提供聚合差异比较 · 在判定中加入 Lakeflow 期望 · 提供用于定期漂移检查的 bricksentry watch · Databricks App UI。
贡献
来自真实流水线的错误报告最有帮助。请参阅 CONTRIBUTING.md,如需私下报告漏洞,请参阅 SECURITY.md。
许可证
Apache-2.0。由 Brahma(Databricks Champion)创建并维护。
商标
bricksentry 是一个独立的开源项目,与 Databricks, Inc. 或 Functional Software, Inc.(Sentry)无关联,未获其认可,也未受其赞助。Databricks、Unity Catalog 和 Lakeflow 是 Databricks, Inc. 的商标。Delta Lake 是 Linux Foundation 的商标,Apache Spark 和 PySpark 是 Apache Software Foundation 的商标。其他所有名称均为其各自所有者的商标,此处仅用于说明兼容性。谢谢。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。